कोर्स
Llama 3 के साथ फाइन-ट्यूनिंग
2 घंटा
4.1K
Llama 3.2 परिवार ऐसे शक्तिशाली मॉडलों का सेट पेश करता है जो विज़न और भाषा समझ को जोड़ते हैं। दो सबसे बड़े मॉडल, 11B और 90B, विशेष रूप से उन जटिल कार्यों के लिए बनाए गए हैं जहाँ दृश्य और पाठ्य जानकारी को साथ में समझना होता है।
ये मॉडल चार्ट्स, ग्राफ़ और तालिकाएँ पढ़ने और विश्लेषित करने में उत्कृष्ट हैं, जिससे वे उन इनसाइट्स को निकालने के लिए उपयुक्त हो जाते हैं जिनमें केवल-टेक्स्ट मॉडल संघर्ष करते हैं। उदाहरण के लिए, कोई व्यवसाय-मालिक पूछ सकता है, “पिछले साल किस महीने में सबसे अधिक लाभ हुआ?” और Llama 3.2 लाभप्रदता चार्ट देखकर सही उत्तर देगा।
इसके अलावा, मॉडल विवरणों के आधार पर तस्वीरों में वस्तुओं का पता लगा सकते हैं। मानचित्र पर स्थलों को पहचानना हो या ग्राफ़ में रुझान, Llama 3.2 इसे आसानी से संभाल सकता है।
Llama 3.2 न केवल Claude 3 Haiku और GPT4o-mini जैसे शीर्ष प्रतिस्पर्धियों की बराबरी करता है, बल्कि विज़न इन्स्ट्रक्शन-ट्यून बेंचमार्क्स पर दिखाए अनुसार इमेज़ रिकग्निशन और विज़ुअल समझ जैसे कार्यों में उतना ही अच्छा प्रदर्शन करता है। टेक्स्ट और इमेज दोनों के साथ काम करने की इसकी क्षमता अधिक प्राकृतिक और लचीली बातचीत को संभव बनाती है, जहाँ दृश्य और लिखित जानकारी मिश्रित होती है—इसे कई प्रकार के उपयोग मामलों के लिए उपयुक्त बनाती है।
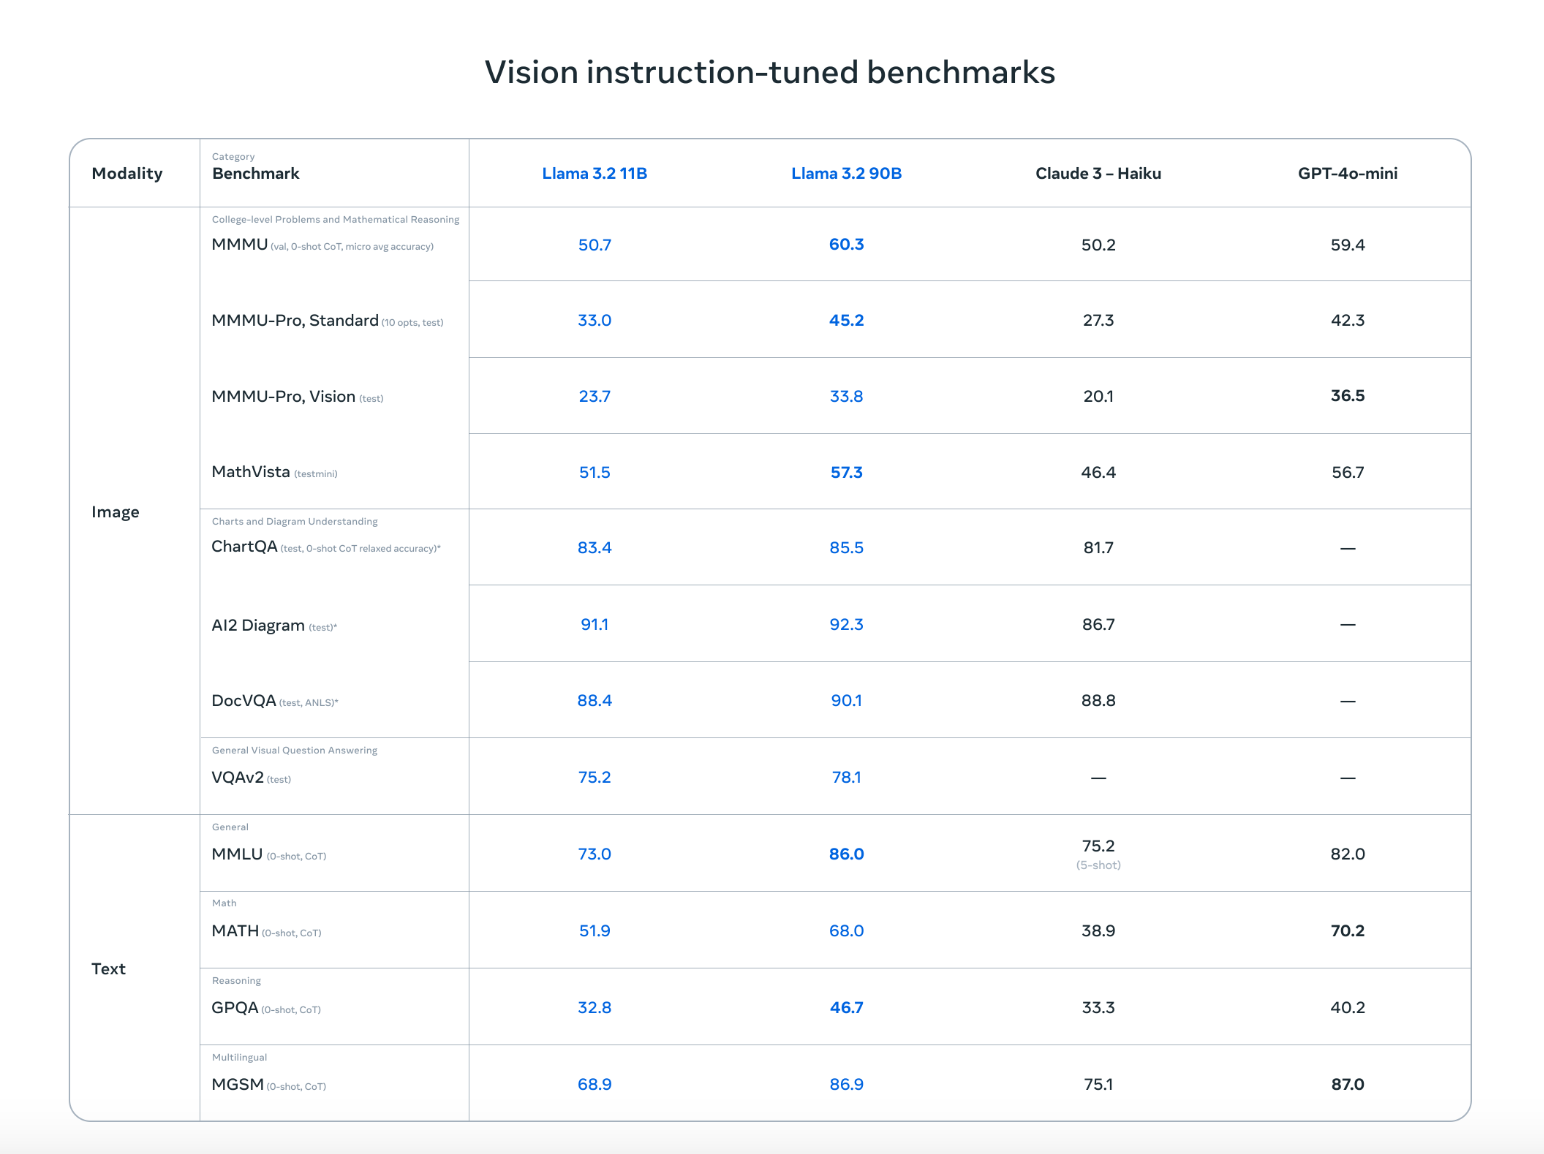
स्रोत: Meta AI
इन उन्नत क्षमताओं के साथ, Llama 3.2 Vision मॉडल RAG एप्लिकेशंस के लिए नई संभावनाएँ खोलते हैं। वे PDFs जैसे जटिल डेटा स्रोतों से इनसाइट्स निकालना काफी आसान बनाते हैं, दृश्यों और टेक्स्ट को जोड़कर अधिक सटीक और उपयोगी परिणाम देते हैं।
Llama 3.2 Vision के साथ RAG एप्लिकेशन सेटअप करने के लिए, हमें Llama 3.2 Vision मॉडल डाउनलोड करना होगा, वातावरण सेट करना होगा, आवश्यक लाइब्रेरीज़ इंस्टॉल करनी होंगी, और एक रिट्रीवल सिस्टम बनाना होगा। नीचे Llama 3.2 Vision और ColPali का उपयोग करके RAG एप्लिकेशन लागू करने के लिए एक सरल, चरण-दर-चरण मार्गदर्शिका दी गई है।
कृपया ध्यान दें कि निम्नलिखित चरणों का परीक्षण Colab Pro नोटबुक पर A100 इंस्टेंस के साथ किया गया था।
सबसे पहले, सुनिश्चित करें कि आवश्यक डिपेंडेंसीज़ इंस्टॉल हैं:
!pip install byaldi
!sudo apt-get install -y poppler-utils
!pip install -q git+https://github.com/huggingface/transformers.git qwen-vl-utils flash-attn optimum auto-gptq bitsandbytes
!pip install ollama
!pip install colab-xterm
byaldi लाइब्रेरी मल्टीमॉडल दस्तावेज़ों के भीतर इंडेक्सिंग और सर्चिंग के लिए आवश्यक है, जबकि poppler-utils जैसे अन्य टूल PDF हैंडलिंग के लिए आवश्यक हैं।
ColPali एक ऐसी विधि है जो केवल निकाले गए टेक्स्ट पर निर्भर रहने के बजाय दस्तावेज़ पृष्ठों (जैसे स्कैन किए गए PDFs) की छवियों को सीधे एम्बेड करके डॉक्युमेंट रिट्रीवल को बेहतर बनाती है। PaliGemma जैसे उन्नत विज़न-लैंग्वेज मॉडल्स और लेट-इंटरैक्शन रिट्रीवल मैकेनिज़्म का उपयोग करते हुए, ColPali जटिल दृश्य तत्वों (तालिकाएँ, छवियाँ, और ग्राफ़) को अधिक सटीक और तेज़ डॉक्युमेंट सर्च के लिए कुशलता से संभालता है।
हम अपने PDFs को एम्बेडिंग्स में एन्कोड करने के लिए ColPali का उपयोग करेंगे। आप ColPali के RAGMultiModalModel को इस प्रकार लोड कर सकते हैं:
import os
import base64
from byaldi import RAGMultiModalModel

RAG = RAGMultiModalModel.from_pretrained("vidore/colpali-v1.2", verbose=1)हम प्रसिद्ध Attention is All You Need पेपर को डाउनलोड करेंगे और RAGMultiModalModel का उपयोग करके उसके लिए इंडेक्स बनाएँगे। यह चरण दस्तावेज़ को प्रोसेस करता है, तेज़ रिट्रीवल के लिए दृश्य और पाठ्य डेटा निकालता है।
!wget <https://arxiv.org/pdf/1706.03762>
!mkdir docs
!mv 1706.03762 docs/attention.pdf
RAG.index(
input_path="./docs/attention.pdf",
index_name="attention",
store_collection_with_index=True, # Store base64 representation of images
overwrite=True
)Added page 1 of document 0 to index.
Added page 2 of document 0 to index.
Added page 3 of document 0 to index.
Added page 4 of document 0 to index.
Added page 5 of document 0 to index.
Added page 6 of document 0 to index.
Added page 7 of document 0 to index.
Added page 8 of document 0 to index.
Added page 9 of document 0 to index.
Added page 10 of document 0 to index.
Added page 11 of document 0 to index.
Added page 12 of document 0 to index.
Added page 13 of document 0 to index.
Added page 14 of document 0 to index.
Added page 15 of document 0 to index.
Index exported to .byaldi/attention
Index exported to .byaldi/attention
{0: 'docs/attention.pdf'}एक बार जब आप दस्तावेज़ को इंडेक्स कर लेते हैं, तो आप इस प्रकार उससे प्रासंगिक सामग्री आसानी से प्राप्त कर सकते हैं:
query = "What's the BLEU score of the transformer architecture in EN-DE"
results = RAG.search(query, k=1)
results
[{'doc_id': 0, 'page_num': 8, 'score': 19.0, 'metadata': {}, 'base64': 'iVBORw0KGgoAAAANSUhEUgAABqQAAAiYCAIAAAA+NVHkAAEAAElEQVR4nOzdd1gUx/8H8KGDoC....'}]यह इंडेक्स किए गए PDF से सबसे अच्छी मेल खाने वाला पृष्ठ या दृश्य तत्व वापस लाता है।
प्राप्त पृष्ठ को विज़ुअलाइज़ करने के लिए, हम छवि को फ़ाइल में सेव कर सकते हैं और इस प्रकार प्रदर्शित कर सकते हैं:
from IPython.display import Image

def see_image(image_base64):
    image_bytes = base64.b64decode(image_base64)
    filename = 'image.jpg'
    with open(filename, 'wb') as f:
        f.write(image_bytes)
    display(Image(filename))

# For multiple retrieved pages
for res in results:
    see_image(res['base64'])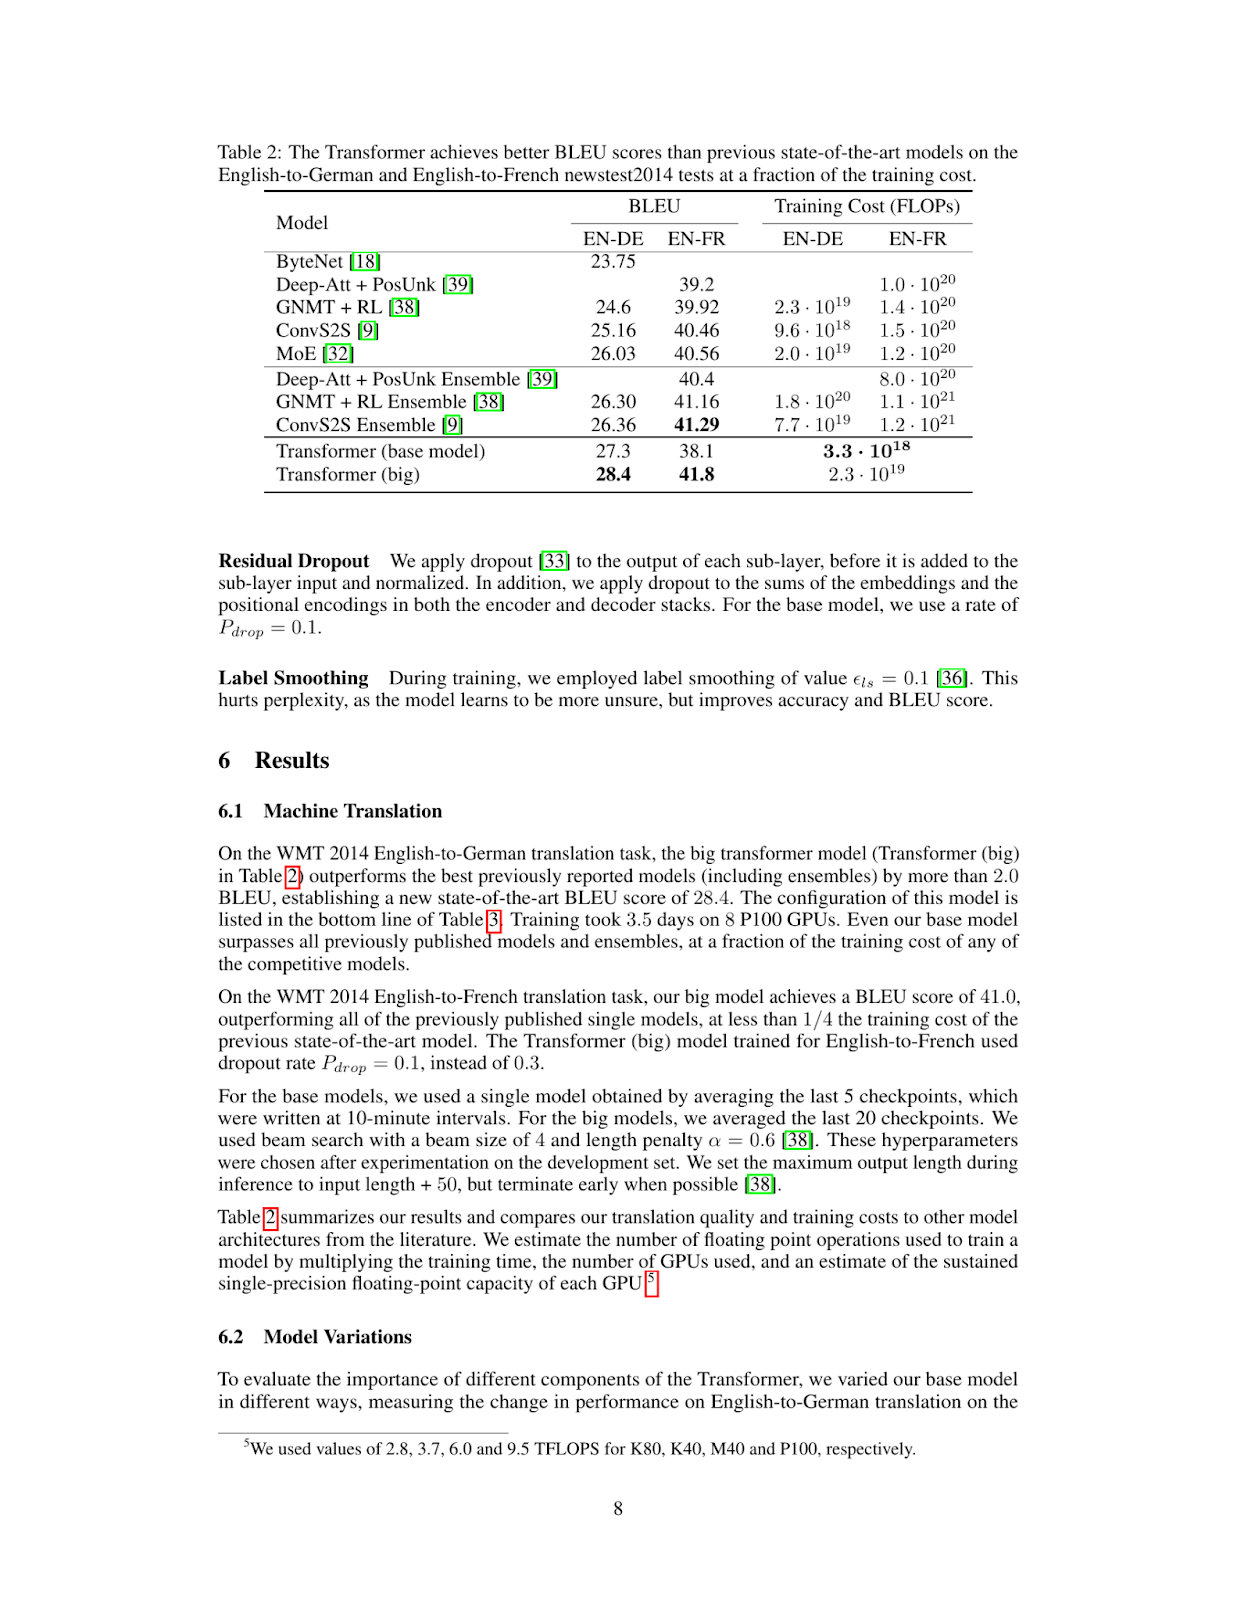
जैसा कि आप देख सकते हैं, प्राप्त पृष्ठ में वह जानकारी है जिसकी हमें इस प्रश्न का उत्तर देने के लिए आवश्यकता है: What's the BLEU score of the transformer architecture in EN-DE। अगला चरण उपयोगकर्ता के प्रश्न के साथ इस छवि को हमारे Llama 3.2 Vision मॉडल में देना है।
Llama 3.2 Vision मॉडल को इंस्टॉल और सेट करने के लिए, हम Colab Pro नोटबुक (A100 इंस्टेंस) में Ollama का उपयोग करेंगे। आप नोटबुक में Ollama चलाएँगे और उपयोग के लिए Llama 3.2 Vision मॉडल डाउनलोड करेंगे।
%load_ext colabxterm
%xterm
%xterm नोटबुक के भीतर एक टर्मिनल बनाएगा, जहाँ आप इस कमांड curl -fsSL <https://ollama.com/install.sh> | sh का उपयोग करके Ollama डाउनलोड कर सकते हैं और फिर निम्न कमांड चलाकर Llama 3.2 11B Vision मॉडल डाउनलोड और रन कर सकते हैं।
ollama serve & ollama run llama3.2-visionजब आप Llama 3.2 11B Vision मॉडल सफलतापूर्वक डाउनलोड और रन कर लेते हैं, तो हम ollama लाइब्रेरी का उपयोग करके इस प्रकार उससे कनेक्ट कर सकते हैं। ध्यान दें कि यहाँ हमने प्राप्त पृष्ठ को image.jpg के रूप में सेव किया है, जिसे हम उपयोगकर्ता के प्रश्न के साथ Llama 3.2 11B Vision मॉडल में इनपुट दे रहे हैं।
import ollama
response = ollama.chat(
    model='llama3.2-vision',
    messages=[{
        'role': 'user',
        'content': "What's the BLEU score of the transformer architecture in EN-DE",
        'images': ['image.jpg']
    }]
)
print(response['message']['content'])
The table shows that the BLEU score for the transformer (base model) on the EN-DE task is 27.3. The BLEU score for the transformer (big) on the same task is 28.4.
Therefore, the BLEU score of the transformer architecture in EN-DE is **28.4**.हम ColPali रिट्रीवल और Ollama इन्फ़रेंस कोड को नीचे दिए गए inference फ़ंक्शन में एक साथ जोड़ सकते हैं। यह फ़ंक्शन दस्तावेज़ से सबसे प्रासंगिक पृष्ठ लाता है, उसे क्वेरी के साथ विज़न मॉडल को पास करता है और उत्तर लौटाता है।
def inference(question: str):
    results = RAG.search(question, k=1)  # Retrieve relevant data
    see_image(results[0]['base64'])  # Save and display image

    response = ollama.chat(
        model='llama3.2-vision',
        messages=[{
            'role': 'user',
            'content': question,
            'images': ['image.jpg']
        }]
    )

    return response['message']['content']

# Example queries
inference_result = inference("Please explain figure 1")
print(inference_result)
The Transformer model is a type of neural network architecture that was introduced in the paper "Attention Is All You Need" by Vaswani et al. in 2017. It has since become one of the most widely used architectures for natural language processing tasks, such as machine translation, text summarization, and question answering.
**What is a Transformer?**
A Transformer is a type of neural network that uses self-attention mechanisms to process input sequences, such as sentences or paragraphs. Unlike traditional recurrent neural networks (RNNs), which rely on sequential processing of inputs, Transformers can process all input elements simultaneously using parallelized attention modules.
**How does the Transformer work?**
The Transformer consists of an encoder and a decoder. The encoder takes in a sequence of tokens (e.g., words or characters) as input and produces a continuous representation of the input sequence. This representation is then fed into the decoder, which generates output sequences one token at a time.
**Key Components:**
* **Self-Attention Mechanism:** This mechanism allows the model to attend to different parts of the input sequence simultaneously and weigh their importance.
* **Multi-Head Attention:** The Transformer uses multiple attention heads to process different aspects of the input sequence in parallel, improving the model's ability to capture complex relationships between tokens.
* **Positional Encoding:** To incorporate positional information into the input sequence, the Transformer uses a positional encoding scheme that adds a learned vector to each token based on its position in the sequence.
**Advantages:**
* **Parallelization:** The Transformer can process all input elements simultaneously, making it much faster than traditional RNNs.
* **Flexibility:** The Transformer can handle sequences of varying lengths and is particularly effective for tasks involving long-range dependencies.
**Applications:**
The Transformer has been widely adopted in various natural language processing applications, including:
* Machine Translation
* Text Summarization
* Question Answering
* Sentiment Analysis
In summary, the Transformer model is a powerful neural network architecture that uses self-attention mechanisms to process input sequences efficiently and effectively. Its ability to parallelize attention modules has made it a popular choice for many natural language processing tasks.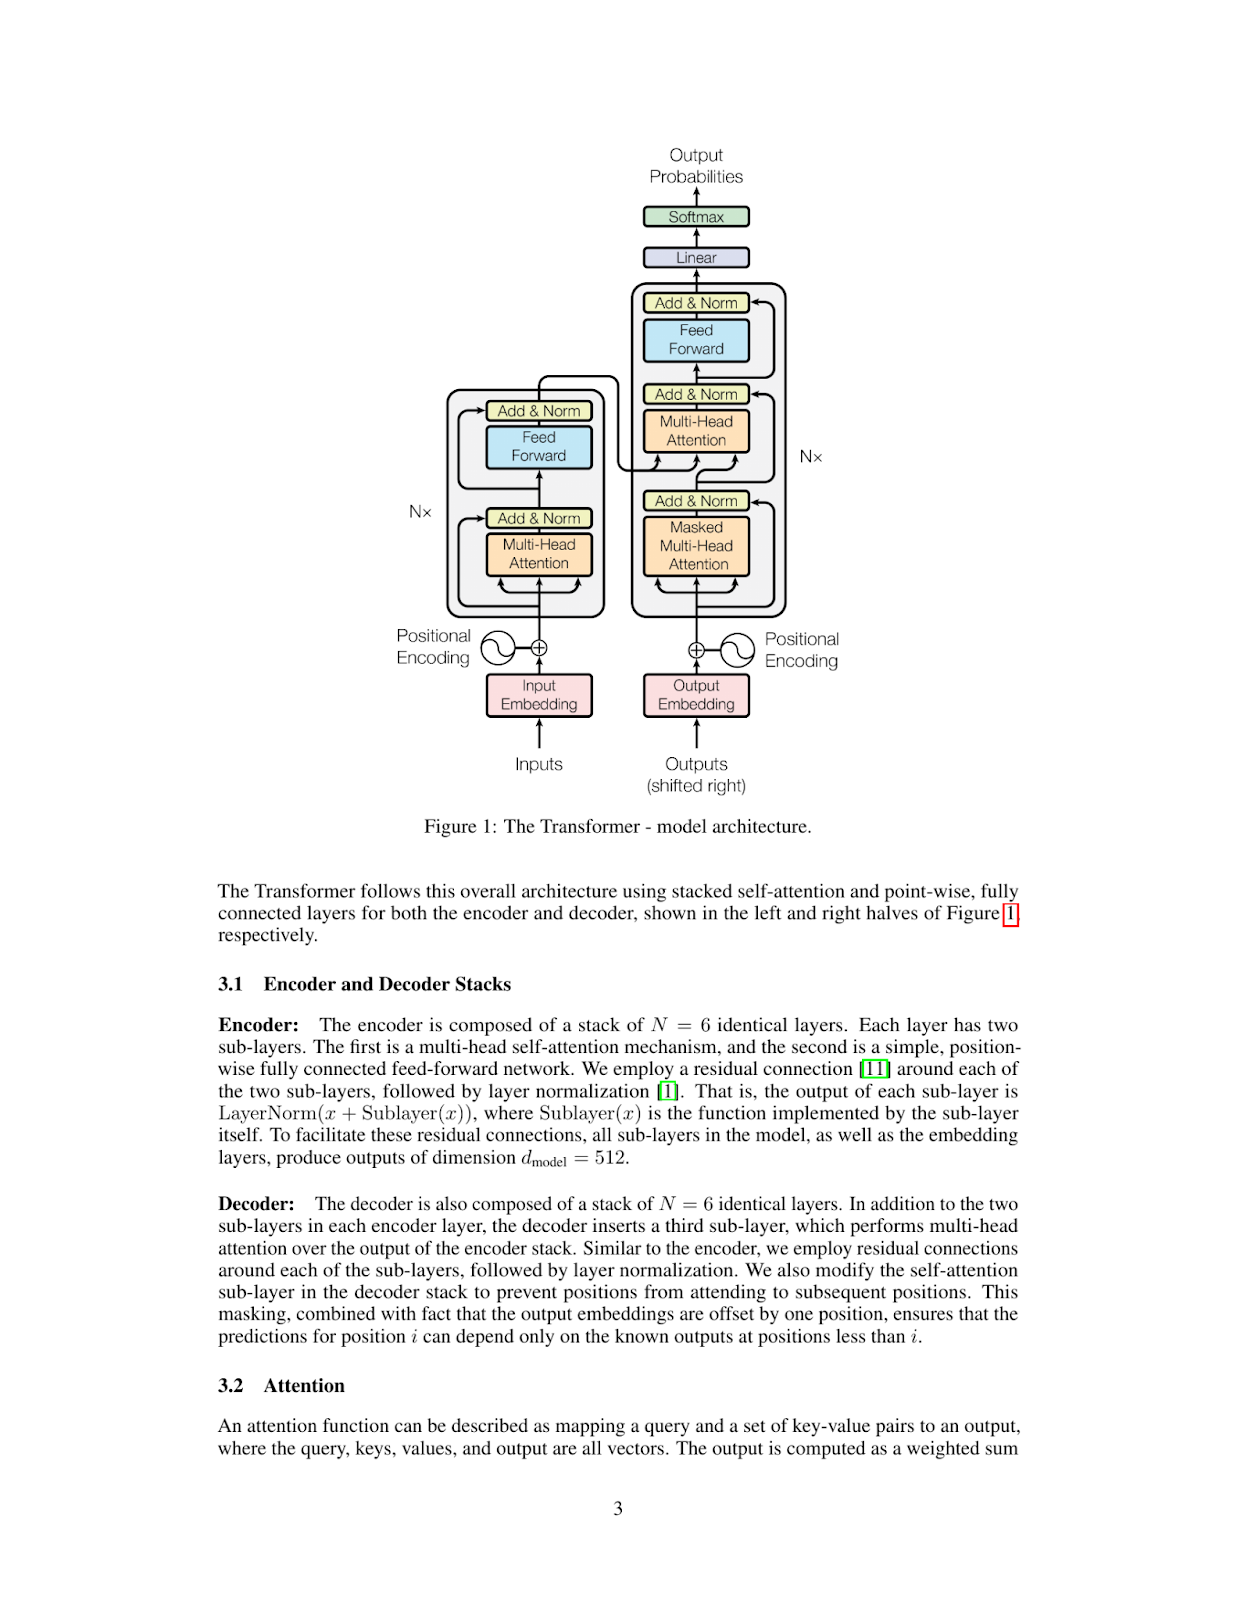
आइए एक और क्वेरी आज़माते हैं:
inference_result = inference("What's the maximum path length of recurrent layer type")
print(inference_result)
The table provided in the image shows that for a Recurrent Layer, the Maximum Path Length is O(n). This means that as the number of nodes (n) in the network increases, the maximum path length also increases linearly with it.
Therefore, the maximum path length of a recurrent layer type is O(n).
*Answer*: O(n)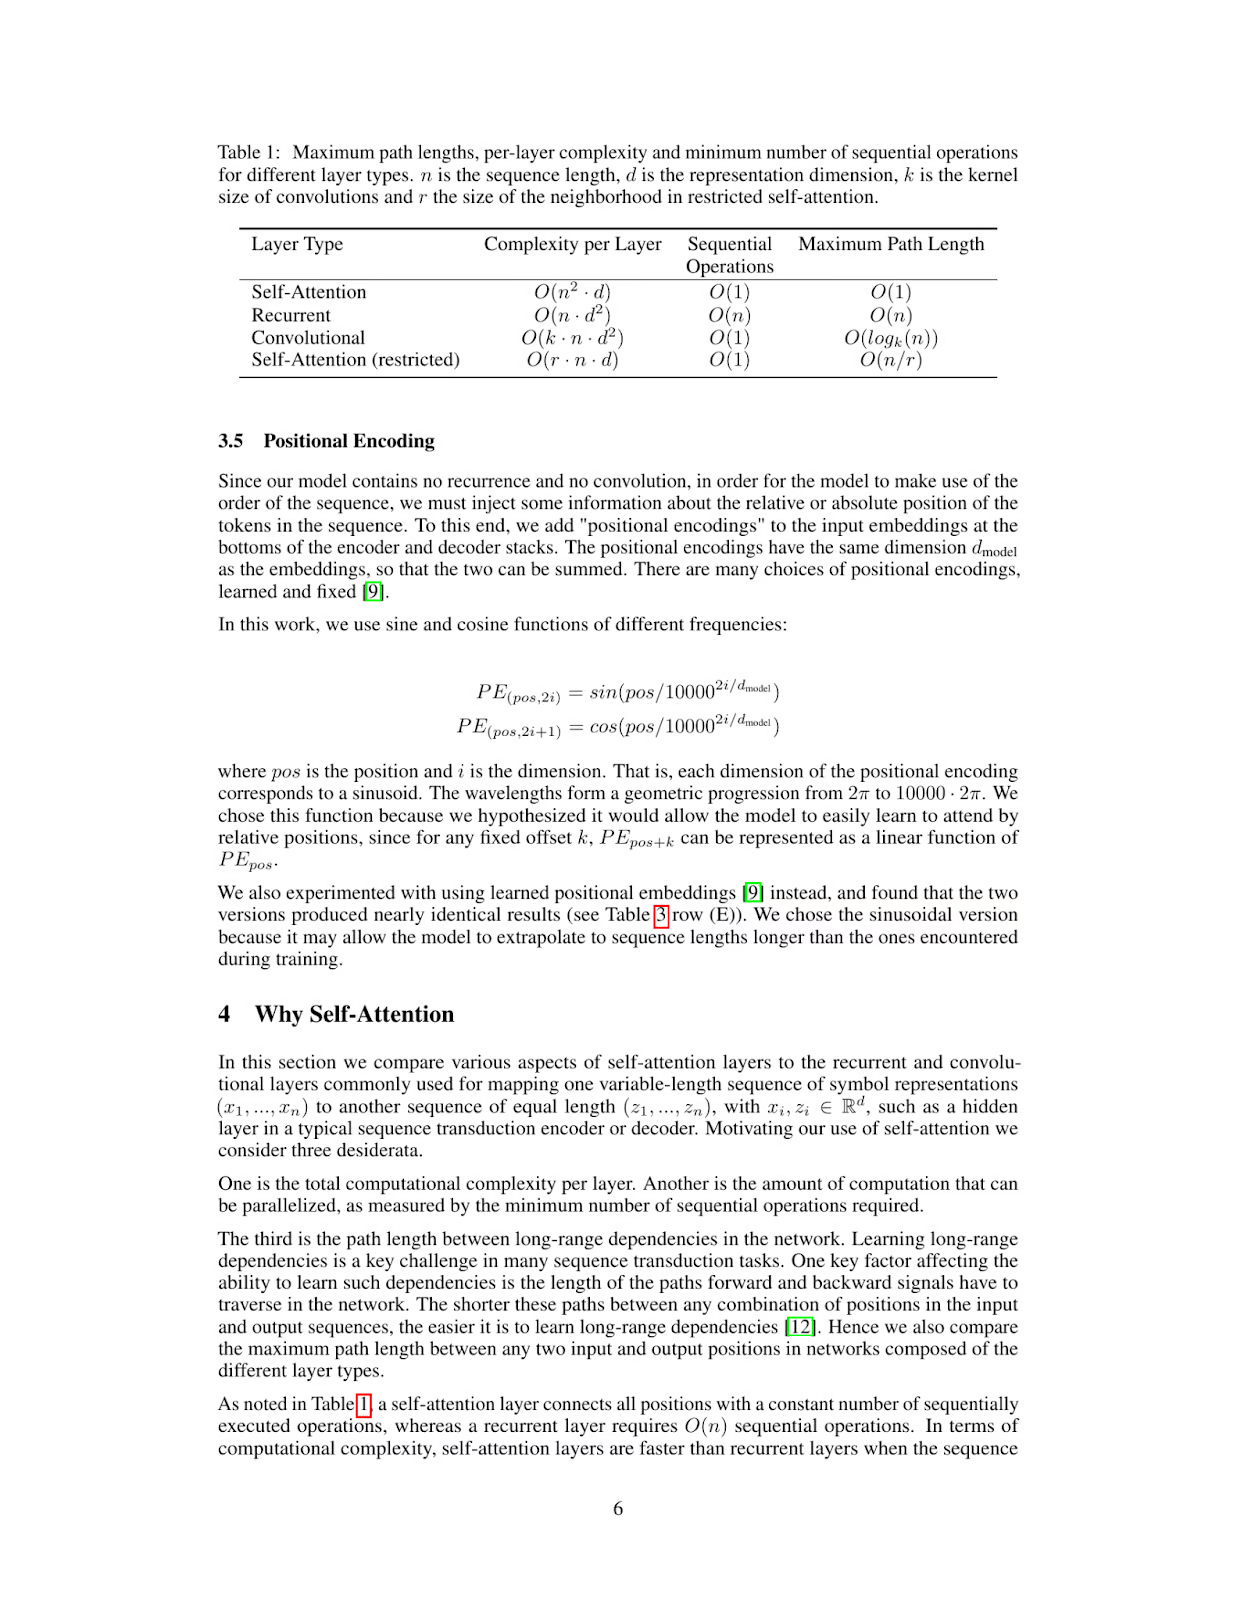
Llama 3.2 Vision की दृश्य और पाठ्य समझ को संयोजित करने की क्षमता इसे विभिन्न वास्तविक-world अनुप्रयोगों के लिए उपयुक्त बनाती है।
स्वास्थ्य सेवा में, Llama 3.2 Vision रोगियों के रिकॉर्ड के साथ-साथ एक्स-रे और एमआरआई जैसी चिकित्सीय छवियों का विश्लेषण करके निदान की सटीकता में सुधार कर सकता है। दृश्य और पाठ्य डेटा का यह संयोजन डॉक्टरों को अधिक सूचित निर्णय लेने में सहायता देता है और नैदानिक अनुसंधान को तेज करता है, जिससे अंततः रोगी देखभाल को लाभ होता है।
Llama 3.2 Vision उत्पाद छवियों, टेक्स्ट समीक्षाओं और ग्राहक प्रश्नों को मिलाकर ग्राहक की खरीदारी अनुभव को भी बेहतर बना सकता है। इससे अधिक व्यक्तिगत सिफारिशें और अनुकूलित खरीदारी यात्रा संभव होती है, जिससे जुड़ाव और संतुष्टि दोनों में सुधार होता है।
कानूनी उद्योग में, Llama 3.2 Vision पेशेवरों को कॉन्ट्रैक्ट्स, केस लॉ और स्कैन किए गए दस्तावेज़ों से जानकारी जल्दी प्राप्त करने और उसका सार निकालने में मदद करता है। यह अदालत के डायग्राम या दस्तावेज़ एनोटेशंस जैसे जटिल दृश्य तत्वों की भी व्याख्या कर सकता है, जिससे कानूनी विश्लेषण और निर्णय लेने के लिए मूल्यवान इनसाइट्स मिलते हैं।
अंत में, Llama 3.2 Vision आरेखों और चार्ट्स जैसे दृश्य सहायताओं की व्याख्या करके और उन्हें स्पष्ट, रीयल-टाइम पाठ्य व्याख्याओं से जोड़कर सीखने के वातावरण में मदद कर सकता है। इससे शैक्षणिक सामग्री अधिक इंटरैक्टिव बनती है और छात्रों व पेशेवरों दोनों को अधिक प्रभावी ढंग से सीखने में मदद मिलती है।
ColPali और Llama 3.2 Vision मॉडल्स के साथ, आप एक शक्तिशाली RAG सिस्टम बना सकते हैं जो जटिल दृश्य और पाठ्य डेटा वाले PDFs को समझने और उन पर तर्क करने में सक्षम हो। यह संयोजन दस्तावेज़ विश्लेषण से लेकर स्वचालित रिपोर्ट जनरेशन तक के अनुप्रयोगों के लिए संभावनाएँ खोलता है, जिससे यह मल्टीमॉडल AI वर्कफ़्लोज़ के लिए अत्यंत उपयोगी बनता है।
इन पाठ्यक्रमों के साथ AI सीखें!
कोर्स
लर्निंग पाथ
लर्निंग पाथ