

RAG için Neden Llama 3.2 Vision Modellerini Seçmelisiniz?
Llama 3.2 ailesi, görsel ve dil anlayışını birleştiren güçlü bir model seti sunar. En büyük iki model olan 11B ve 90B, görsel ve metinsel bilgilerin birlikte anlaşılması gereken karmaşık görevler için özel olarak tasarlanmıştır.
Bu modeller, grafikler, diyagramlar ve tabloları okuma ve analiz etmede çok iyidir; bu da yalnızca metne dayalı geleneksel modellerin zorlandığı içgörüleri çıkarmak için onları mükemmel kılar. Örneğin, bir işletme sahibi “Geçen yıl kârın en yüksek olduğu ay hangisiydi?” diye sorabilir ve Llama 3.2 kârlılık grafiğine bakarak doğru yanıtı verir.
Ayrıca modeller, açıklamalara göre resimlerdeki nesneleri bulabilir. Bir haritadaki simge yapılara bakmak ya da bir grafikteki eğilimleri belirlemek fark etmeksizin, Llama 3.2 bunu kolayca halleder.
Llama 3.2 yalnızca Claude 3 Haiku ve GPT4o-mini gibi üst düzey rakiplerle yarışmakla kalmaz, görselleri tanıma ve anlamada, görsel yönergelere ayarlanmış kıyaslamalarda gösterildiği gibi, onlarla aynı düzeyde performans gösterir. Hem metin hem görsellerle çalışabilmesi, görsel ve yazılı bilgiyi harmanlayan daha doğal ve esnek konuşmaları yönetmesini sağlar; bu da onu çok geniş bir kullanım yelpazesi için ideal kılar.
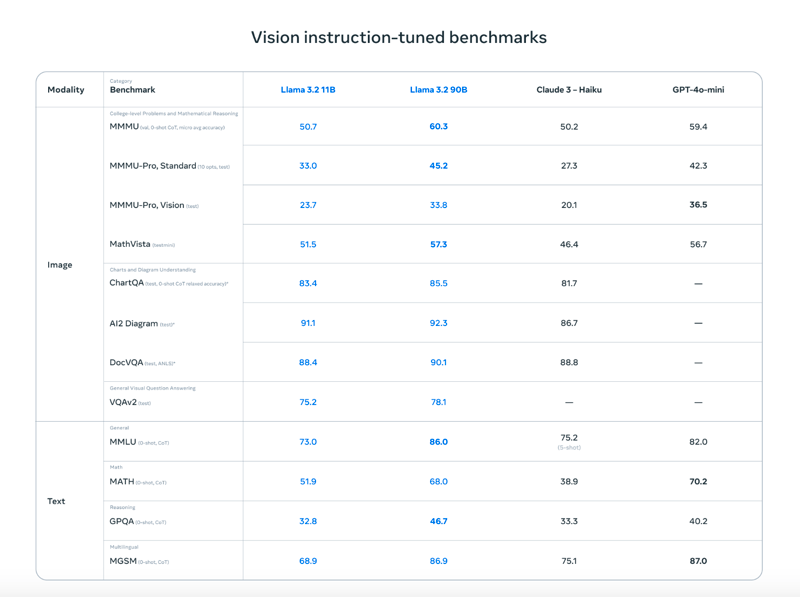
Kaynak: Meta AI
Bu gelişmiş özelliklerle Llama 3.2 Vision modelleri, RAG uygulamaları için yeni olanaklar sunar. PDF gibi karmaşık veri kaynaklarından içgörü elde etmeyi, görseller ve metni birleştirerek daha doğru ve kullanışlı sonuçlar üretmeyi çok daha kolay hâle getirirler.
Ollama ve ColPali ile Llama 3.2 Vision kullanarak RAG nasıl uygulanır
Llama 3.2 Vision ile bir RAG uygulaması kurmak için Llama 3.2 Vision modelini indirmeniz, ortamı kurmanız, gerekli kütüphaneleri yüklemeniz ve bir getirme sistemi oluşturmanız gerekir. Aşağıda, Llama 3.2 Vision ve ColPali kullanarak bir RAG uygulaması gerçekleştirmenize yardımcı olacak basit, adım adım bir rehber bulacaksınız.
Aşağıdaki adımların A100 örneğine sahip bir Colab Pro defterinde test edildiğini lütfen unutmayın.
Adım 1: Bağımlılıkları indirin
Öncelikle gerekli bağımlılıkların yüklü olduğundan emin olun:
!pip install byaldi
!sudo apt-get install -y poppler-utils
!pip install -q git+https://github.com/huggingface/transformers.git qwen-vl-utils flash-attn optimum auto-gptq bitsandbytes
!pip install ollama
!pip install colab-xtermbyaldi kütüphanesi çok modlu belgelerde indeksleme ve arama için gereklidir; poppler-utils gibi diğer araçlar ise PDF işlemleri için gereklidir.
Adım 2: ColPali RAG modelini yükleyin
ColPali, yalnızca çıkarılan metne güvenmek yerine taranmış PDF’ler gibi belge sayfalarının görüntülerini doğrudan gömerek belge getirmeyi iyileştiren bir yöntemdir. PaliGemma gibi gelişmiş görsel-dil modelleri ve geç etkileşimli getirme mekanizması kullanan ColPali, daha doğru ve hızlı belge araması için karmaşık görsel öğeleri (tablolar, görseller ve grafikler) verimli bir şekilde işler.
PDF’lerimizi gömme vektörlerine dönüştürmek için ColPali kullanacağız. ColPali RAGMultiModalModel’i şu şekilde yükleyebilirsiniz:
import os
import base64
from byaldi import RAGMultiModalModel
RAG = RAGMultiModalModel.from_pretrained("vidore/colpali-v1.2", verbose=1)Adım 3: Örnek bir PDF belgeyi indeksleyin
Ünlü Attention is All You Need makalesini indirip, RAGMultiModalModel kullanarak bunun için bir indeks oluşturacağız. Bu adım, hızlı getirme için belgedeki görsel ve metinsel veriyi işler.
!wget <https://arxiv.org/pdf/1706.03762>
!mkdir docs
!mv 1706.03762 docs/attention.pdfRAG.index(
input_path="./docs/attention.pdf",
index_name="attention",
store_collection_with_index=True, # Store base64 representation of images
overwrite=True
)Added page 1 of document 0 to index.
Added page 2 of document 0 to index.
Added page 3 of document 0 to index.
Added page 4 of document 0 to index.
Added page 5 of document 0 to index.
Added page 6 of document 0 to index.
Added page 7 of document 0 to index.
Added page 8 of document 0 to index.
Added page 9 of document 0 to index.
Added page 10 of document 0 to index.
Added page 11 of document 0 to index.
Added page 12 of document 0 to index.
Added page 13 of document 0 to index.
Added page 14 of document 0 to index.
Added page 15 of document 0 to index.
Index exported to .byaldi/attention
Index exported to .byaldi/attention
{0: 'docs/attention.pdf'}Adım 4: İndekslenen belgede arama yapın
Belgeyi indeksledikten sonra, ilgili içeriği aşağıdaki gibi kolayca getirebilirsiniz:
query = "What's the BLEU score of the transformer architecture in EN-DE"
results = RAG.search(query, k=1)
results[{'doc_id': 0, 'page_num': 8, 'score': 19.0, 'metadata': {}, 'base64': 'iVBORw0KGgoAAAANSUhEUgAABqQAAAiYCAIAAAA+NVHkAAEAAElEQVR4nOzdd1gUx/8H8KGDoC....'}]Bu, indekslenen PDF’den en iyi eşleşen sayfayı veya görsel öğeyi getirir.
Adım 5: Getirilen görseli gösterin
Getirilen sayfayı görselleştirmek için, görseli bir dosyaya kaydedip aşağıdaki gibi görüntüleyebiliriz:
from IPython.display import Image
def see_image(image_base64):
image_bytes = base64.b64decode(image_base64)
filename = 'image.jpg'
with open(filename, 'wb') as f:
f.write(image_bytes)
display(Image(filename))
# For multiple retrieved pages
for res in results:
see_image(res['base64'])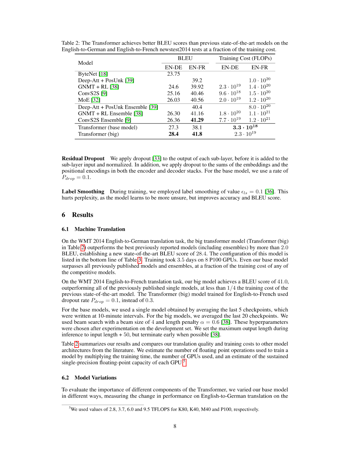
Gördüğünüz gibi, getirilen sayfa What's the BLEU score of the transformer architecture in EN-DE sorusunu yanıtlamak için gereken bilgiyi içeriyor. Sıradaki adım, bu görseli kullanıcının sorusuyla birlikte Llama 3.2 Vision modeline vermek.
Adım 6: Akıl yürütme için Llama 3.2 vision modelini kurun
Llama 3.2 Vision modelini kurmak ve ayarlamak için A100 örneğine sahip bir Colab Pro defterinde Ollama kullanacağız. Ollama’yı defter içinde çalıştıracak ve kullanım için Llama 3.2 Vision modelini indireceksiniz.
%load_ext colabxterm
%xterm%xterm defter içinde bir terminal oluşturur; ardından bu komutu kullanarak Ollama’yı indirebilirsiniz: curl -fsSL <https://ollama.com/install.sh> | sh ve daha sonra Llama 3.2 11B Vision modelini indirmek ve çalıştırmak için şu komutu çalıştırın.
ollama serve & ollama run llama3.2-visionAdım 7: Çıkarım yapın
Llama 3.2 11B Vision modelini başarıyla indirip çalıştırdıktan sonra, şimdi ollama kütüphanesini kullanarak ona aşağıdaki gibi bağlanabiliriz. Burada getirilen sayfayı image.jpg olarak kaydettiğimizi ve bunu kullanıcının sorusuyla birlikte Llama 3.2 11B Vision modeline girdi olarak verdiğimizi unutmayın.
import ollama
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': "What's the BLEU score of the transformer architecture in EN-DE",
'images': ['image.jpg']
}]
)
print(response['message']['content'])The table shows that the BLEU score for the transformer (base model) on the EN-DE task is 27.3. The BLEU score for the transformer (big) on the same task is 28.4.
Therefore, the BLEU score of the transformer architecture in EN-DE is **28.4**.Adım 8: Hepsini bir araya getirin
ColPali getirmeyi ve Ollama çıkarım kodunu aşağıdaki inference işlevinde birleştirebiliriz. Bu işlev, belgeden en ilgili sayfayı getirir, sorguyla birlikte görsel modele iletir ve bir yanıt döndürür.
def inference(question: str):
results = RAG.search(question, k=1) # Retrieve relevant data
see_image(results[0]['base64']) # Save and display image
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': question,
'images': ['image.jpg']
}]
)
return response['message']['content']
# Example queries
inference_result = inference("Please explain figure 1")
print(inference_result)The Transformer model is a type of neural network architecture that was introduced in the paper "Attention Is All You Need" by Vaswani et al. in 2017. It has since become one of the most widely used architectures for natural language processing tasks, such as machine translation, text summarization, and question answering.
**What is a Transformer?**
A Transformer is a type of neural network that uses self-attention mechanisms to process input sequences, such as sentences or paragraphs. Unlike traditional recurrent neural networks (RNNs), which rely on sequential processing of inputs, Transformers can process all input elements simultaneously using parallelized attention modules.
**How does the Transformer work?**
The Transformer consists of an encoder and a decoder. The encoder takes in a sequence of tokens (e.g., words or characters) as input and produces a continuous representation of the input sequence. This representation is then fed into the decoder, which generates output sequences one token at a time.
**Key Components:**
* **Self-Attention Mechanism:** This mechanism allows the model to attend to different parts of the input sequence simultaneously and weigh their importance.
* **Multi-Head Attention:** The Transformer uses multiple attention heads to process different aspects of the input sequence in parallel, improving the model's ability to capture complex relationships between tokens.
* **Positional Encoding:** To incorporate positional information into the input sequence, the Transformer uses a positional encoding scheme that adds a learned vector to each token based on its position in the sequence.
**Advantages:**
* **Parallelization:** The Transformer can process all input elements simultaneously, making it much faster than traditional RNNs.
* **Flexibility:** The Transformer can handle sequences of varying lengths and is particularly effective for tasks involving long-range dependencies.
**Applications:**
The Transformer has been widely adopted in various natural language processing applications, including:
* Machine Translation
* Text Summarization
* Question Answering
* Sentiment Analysis
In summary, the Transformer model is a powerful neural network architecture that uses self-attention mechanisms to process input sequences efficiently and effectively. Its ability to parallelize attention modules has made it a popular choice for many natural language processing tasks.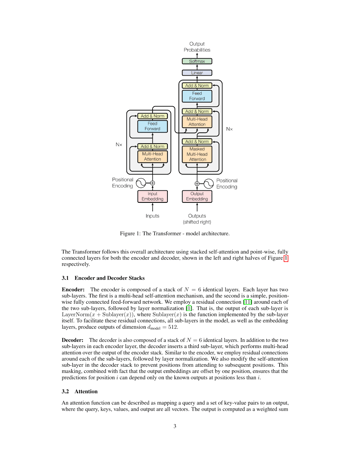
Bir başka sorguyu deneyelim:
inference_result = inference("What's the maximum path length of recurrent layer type")
print(inference_result)The table provided in the image shows that for a Recurrent Layer, the Maximum Path Length is O(n). This means that as the number of nodes (n) in the network increases, the maximum path length also increases linearly with it.
Therefore, the maximum path length of a recurrent layer type is O(n).
*Answer*: O(n)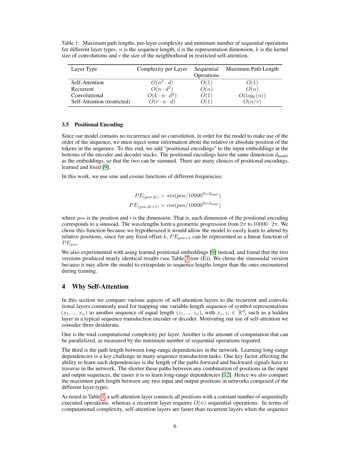
Llama 3.2 Vision: Gerçek Dünya Uygulamaları
Llama 3.2 Vision’ın hem görsel hem metinsel anlayışı birleştirme yeteneği, onu çeşitli gerçek dünya uygulamaları için ideal kılar.
Sağlık alanında Llama 3.2 Vision, röntgen ve MR gibi tıbbi görüntüleri hasta kayıtlarıyla birlikte analiz ederek tanısal doğruluğu artırabilir. Görsel ve metinsel verinin bu birleşimi, doktorların daha bilinçli kararlar almasını destekler ve klinik araştırmaları hızlandırır; nihayetinde hasta bakımına fayda sağlar.
Llama 3.2 Vision, ürün görsellerini, metin yorumlarını ve müşteri sorgularını birleştirerek müşteri alışveriş deneyimini de geliştirebilir. Bu, daha kişiselleştirilmiş öneriler ve uyarlanmış bir alışveriş yolculuğu sağlar; etkileşimi ve memnuniyeti artırır.
Hukuk sektöründe Llama 3.2 Vision, sözleşmeler, içtihatlar ve taranmış belgelerden bilgiyi hızla getirme ve özetleme konusunda profesyonellere yardımcı olur. Mahkeme diyagramları veya belge açıklamaları gibi karmaşık görselleri bile yorumlayabilir; hukuki analiz ve karar alma için değerli içgörüler sunar.
Son olarak Llama 3.2 Vision, diyagramlar ve grafikler gibi görsel yardımcıları yorumlayıp bunları net, gerçek zamanlı metinsel açıklamalarla ilişkilendirerek öğrenme ortamlarına katkıda bulunabilir. Bu, eğitim içeriğini daha etkileşimli hâle getirir ve hem öğrencilerin hem profesyonellerin daha etkili öğrenmesine yardımcı olur.
Sonuçlar
ColPali ve Llama 3.2 Vision Modelleri ile, karmaşık görsel ve metinsel veri içeren PDF’leri anlayıp bunlar üzerinde akıl yürütebilen güçlü bir RAG sistemi kurabilirsiniz. Bu kombinasyon, belge analizinden otomatik rapor oluşturmaya kadar uzanan uygulamalar için yeni imkânlar sunarak çok modlu yapay zekâ iş akışları için son derece kullanışlıdır.

Ryan, LLM'ler kullanarak yapay zeka uygulamaları geliştirme konusunda uzmanlaşmış kıdemli bir veri bilimcisidir. Imperial College London'da Doğal Dil İşleme ve Bilgi Grafiklerinde doktora adayıdır ve aynı kurumda Bilgisayar Bilimleri alanında yüksek lisansını tamamlamıştır. Veri bilimi dışında, haftalık Substack bülteni The Limitless Playbook'u yayımlar; burada dünyanın önde gelen düşünürlerinden uygulanabilir tek bir fikri paylaşır ve zaman zaman temel yapay zeka kavramları hakkında yazar.



Geleneksel RAG yaklaşımları, PDF gibi görsel açıdan zengin belgelerde zorlanır. Görseller, tablolar ve grafikler gibi karmaşık görsel öğeleri sıklıkla yorumlayamazlar; bu da bu formatlardan faydalı içgörüler çıkarmayı zorlaştırır.
İşte burada Llama 3.2 görsel modelleri devreye girer. Bu gelişmiş çok modlu modeller güçlü görsel akıl yürütme yetenekleri ekleyerek yapay zekâ sistemlerinin hem metni hem de görsel veriyi işlemesine olanak tanır. Llama 3.2 Vision ile RAG artık PDF’lerin karmaşıklığını, ayrıntılı tabloları analiz etmekten grafikleri yorumlamaya kadar ele alabilir; daha doğru ve anlamlı yanıtlar sunar.
Bu yazıda, Llama 3.2 Vision’ın bu zorluklar için neden ideal bir çözüm olduğunu açıklayacak ve Llama 3.2 11B Vision modeliyle ColPali kullanarak nasıl uygulayacağınızı adım adım göstereceğim.