

Vì sao chọn các mô hình Llama 3.2 Vision cho RAG?
Họ Llama 3.2 giới thiệu một bộ mô hình mạnh mẽ kết hợp hiểu biết về thị giác và ngôn ngữ. Hai mô hình lớn nhất, 11B và 90B, được thiết kế riêng để xử lý các tác vụ phức tạp nơi thông tin trực quan và văn bản cần được hiểu cùng nhau.
Các mô hình này vượt trội trong việc đọc và phân tích biểu đồ, đồ thị và bảng, khiến chúng trở nên hoàn hảo để trích xuất thông tin chi tiết mà các mô hình chỉ dựa vào văn bản truyền thống thường gặp khó. Ví dụ, một chủ doanh nghiệp có thể hỏi, “Tháng nào năm ngoái có lợi nhuận cao nhất?” và Llama 3.2 sẽ nhìn vào biểu đồ lợi nhuận và đưa ra câu trả lời chính xác.
Ngoài ra, các mô hình còn có thể định vị đối tượng trong hình ảnh dựa trên mô tả. Dù là xác định địa danh trên bản đồ hay nhận diện xu hướng trong biểu đồ, Llama 3.2 đều xử lý dễ dàng.
Llama 3.2 không chỉ sánh ngang các đối thủ hàng đầu như Claude 3 Haiku và GPT4o-mini, mà còn đạt hiệu năng tương đương trong các tác vụ như nhận dạng hình ảnh và hiểu nội dung thị giác như được chứng minh qua các thước đo đánh giá tinh chỉnh cho hướng dẫn thị giác. Khả năng làm việc với cả văn bản và hình ảnh giúp nó xử lý các cuộc hội thoại tự nhiên, linh hoạt hơn khi pha trộn thông tin trực quan và chữ viết, khiến nó phù hợp với nhiều trường hợp sử dụng.
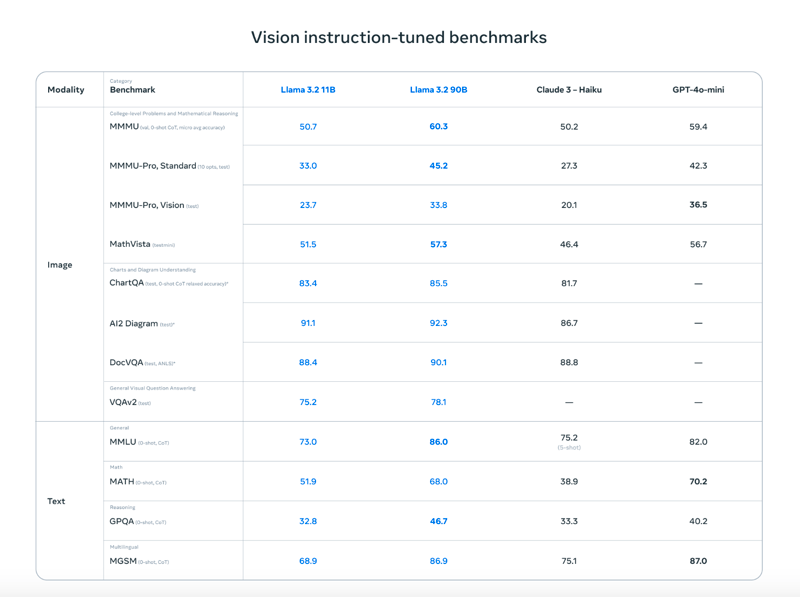
Nguồn: Meta AI
Với những tính năng tiên tiến này, các mô hình Llama 3.2 Vision mở ra những khả năng mới cho các ứng dụng RAG. Chúng giúp việc rút trích thông tin từ các nguồn dữ liệu phức tạp như PDF trở nên dễ dàng hơn nhiều, kết hợp hình ảnh và văn bản để cho ra kết quả chính xác và hữu ích hơn.
Cách triển khai RAG với Llama 3.2 Vision bằng Ollama và ColPali
Để thiết lập một ứng dụng RAG với Llama 3.2 Vision, chúng ta cần tải mô hình Llama 3.2 Vision, cấu hình môi trường, cài đặt các thư viện cần thiết và tạo hệ thống truy hồi. Dưới đây là hướng dẫn đơn giản, từng bước để giúp bạn triển khai ứng dụng RAG sử dụng Llama 3.2 Vision và ColPali.
Lưu ý rằng các bước sau được kiểm thử trên sổ tay Colab Pro với máy A100.
Bước 1: Tải các phụ thuộc
Trước tiên, hãy đảm bảo bạn đã cài đặt các phụ thuộc cần thiết:
!pip install byaldi
!sudo apt-get install -y poppler-utils
!pip install -q git+https://github.com/huggingface/transformers.git qwen-vl-utils flash-attn optimum auto-gptq bitsandbytes
!pip install ollama
!pip install colab-xtermThư viện byaldi là thiết yếu để lập chỉ mục và tìm kiếm trong tài liệu đa phương thức, trong khi các công cụ khác như poppler-utils là cần thiết để xử lý PDF.
Bước 2: Nạp mô hình ColPali RAG
ColPali là một phương pháp tăng cường truy hồi tài liệu bằng cách nhúng trực tiếp hình ảnh các trang tài liệu, như PDF quét, thay vì chỉ dựa vào văn bản trích xuất. Sử dụng các mô hình ngôn ngữ - thị giác tiên tiến như PaliGemma và cơ chế truy hồi tương tác muộn, ColPali xử lý hiệu quả các thành phần trực quan phức tạp (bảng, hình ảnh và biểu đồ) để tìm kiếm tài liệu chính xác và nhanh hơn.
Chúng ta sẽ dùng ColPali để mã hóa PDF thành các embedding. Bạn có thể nạp RAGMultiModalModel của ColPali như sau:
import os
import base64
from byaldi import RAGMultiModalModel
RAG = RAGMultiModalModel.from_pretrained("vidore/colpali-v1.2", verbose=1)Bước 3: Lập chỉ mục một tài liệu PDF mẫu
Chúng ta sẽ tải bài báo nổi tiếng Attention is All You Need và tạo chỉ mục cho nó bằng RAGMultiModalModel. Bước này xử lý tài liệu, trích xuất dữ liệu trực quan và văn bản để truy hồi nhanh.
!wget <https://arxiv.org/pdf/1706.03762>
!mkdir docs
!mv 1706.03762 docs/attention.pdfRAG.index(
input_path="./docs/attention.pdf",
index_name="attention",
store_collection_with_index=True, # Store base64 representation of images
overwrite=True
)Added page 1 of document 0 to index.
Added page 2 of document 0 to index.
Added page 3 of document 0 to index.
Added page 4 of document 0 to index.
Added page 5 of document 0 to index.
Added page 6 of document 0 to index.
Added page 7 of document 0 to index.
Added page 8 of document 0 to index.
Added page 9 of document 0 to index.
Added page 10 of document 0 to index.
Added page 11 of document 0 to index.
Added page 12 of document 0 to index.
Added page 13 of document 0 to index.
Added page 14 of document 0 to index.
Added page 15 of document 0 to index.
Index exported to .byaldi/attention
Index exported to .byaldi/attention
{0: 'docs/attention.pdf'}Bước 4: Tìm kiếm trong tài liệu đã lập chỉ mục
Sau khi lập chỉ mục tài liệu, bạn có thể dễ dàng truy hồi nội dung liên quan từ tài liệu như sau:
query = "What's the BLEU score of the transformer architecture in EN-DE"
results = RAG.search(query, k=1)
results[{'doc_id': 0, 'page_num': 8, 'score': 19.0, 'metadata': {}, 'base64': 'iVBORw0KGgoAAAANSUhEUgAABqQAAAiYCAIAAAA+NVHkAAEAAElEQVR4nOzdd1gUx/8H8KGDoC....'}]Điều này truy hồi trang hoặc thành phần trực quan khớp nhất từ PDF đã lập chỉ mục.
Bước 5: Hiển thị hình ảnh đã truy hồi
Để trực quan hóa trang đã truy hồi, ta có thể lưu hình ảnh ra tệp và hiển thị như sau:
from IPython.display import Image
def see_image(image_base64):
image_bytes = base64.b64decode(image_base64)
filename = 'image.jpg'
with open(filename, 'wb') as f:
f.write(image_bytes)
display(Image(filename))
# For multiple retrieved pages
for res in results:
see_image(res['base64'])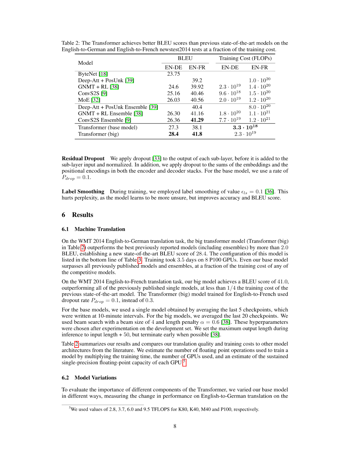
Như bạn thấy, trang đã truy hồi chứa thông tin chúng ta cần để trả lời câu hỏi What's the BLEU score of the transformer architecture in EN-DE. Bước tiếp theo là đưa hình ảnh này vào mô hình Llama 3.2 Vision cùng với câu hỏi của người dùng.
Bước 6: Thiết lập mô hình Llama 3.2 Vision để suy luận
Để cài đặt và thiết lập mô hình Llama 3.2 Vision, chúng ta sẽ dùng Ollama trong sổ tay Colab Pro với máy A100. Bạn sẽ chạy Ollama trong sổ tay và tải mô hình Llama 3.2 Vision để sử dụng.
%load_ext colabxterm
%xterm%xterm sẽ tạo một terminal trong sổ tay, tại đó bạn có thể tải Ollama bằng lệnh curl -fsSL <https://ollama.com/install.sh> | sh và sau đó chạy lệnh sau để tải và chạy mô hình Llama 3.2 11B Vision.
ollama serve & ollama run llama3.2-visionBước 7: Thực hiện suy luận
Khi bạn đã tải và chạy thành công mô hình Llama 3.2 11B Vision, giờ ta có thể kết nối tới nó bằng thư viện ollama như sau. Lưu ý ở đây chúng ta đã lưu trang truy hồi vào image.jpg, và chúng ta đưa tệp này cùng với câu hỏi của người dùng vào mô hình Llama 3.2 11B Vision.
import ollama
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': "What's the BLEU score of the transformer architecture in EN-DE",
'images': ['image.jpg']
}]
)
print(response['message']['content'])The table shows that the BLEU score for the transformer (base model) on the EN-DE task is 27.3. The BLEU score for the transformer (big) on the same task is 28.4.
Therefore, the BLEU score of the transformer architecture in EN-DE is **28.4**.Bước 8: Ghép tất cả lại với nhau
Chúng ta có thể kết hợp phần truy hồi của ColPali và mã suy luận với Ollama vào hàm inference dưới đây. Hàm này truy hồi trang liên quan nhất từ tài liệu, chuyển nó cho mô hình thị giác cùng với truy vấn, và trả về câu trả lời.
def inference(question: str):
results = RAG.search(question, k=1) # Retrieve relevant data
see_image(results[0]['base64']) # Save and display image
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': question,
'images': ['image.jpg']
}]
)
return response['message']['content']
# Example queries
inference_result = inference("Please explain figure 1")
print(inference_result)The Transformer model is a type of neural network architecture that was introduced in the paper "Attention Is All You Need" by Vaswani et al. in 2017. It has since become one of the most widely used architectures for natural language processing tasks, such as machine translation, text summarization, and question answering.
**What is a Transformer?**
A Transformer is a type of neural network that uses self-attention mechanisms to process input sequences, such as sentences or paragraphs. Unlike traditional recurrent neural networks (RNNs), which rely on sequential processing of inputs, Transformers can process all input elements simultaneously using parallelized attention modules.
**How does the Transformer work?**
The Transformer consists of an encoder and a decoder. The encoder takes in a sequence of tokens (e.g., words or characters) as input and produces a continuous representation of the input sequence. This representation is then fed into the decoder, which generates output sequences one token at a time.
**Key Components:**
* **Self-Attention Mechanism:** This mechanism allows the model to attend to different parts of the input sequence simultaneously and weigh their importance.
* **Multi-Head Attention:** The Transformer uses multiple attention heads to process different aspects of the input sequence in parallel, improving the model's ability to capture complex relationships between tokens.
* **Positional Encoding:** To incorporate positional information into the input sequence, the Transformer uses a positional encoding scheme that adds a learned vector to each token based on its position in the sequence.
**Advantages:**
* **Parallelization:** The Transformer can process all input elements simultaneously, making it much faster than traditional RNNs.
* **Flexibility:** The Transformer can handle sequences of varying lengths and is particularly effective for tasks involving long-range dependencies.
**Applications:**
The Transformer has been widely adopted in various natural language processing applications, including:
* Machine Translation
* Text Summarization
* Question Answering
* Sentiment Analysis
In summary, the Transformer model is a powerful neural network architecture that uses self-attention mechanisms to process input sequences efficiently and effectively. Its ability to parallelize attention modules has made it a popular choice for many natural language processing tasks.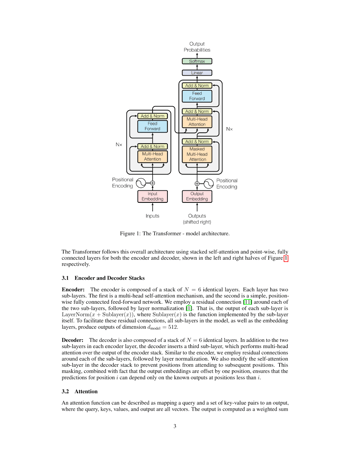
Hãy thử một truy vấn khác:
inference_result = inference("What's the maximum path length of recurrent layer type")
print(inference_result)The table provided in the image shows that for a Recurrent Layer, the Maximum Path Length is O(n). This means that as the number of nodes (n) in the network increases, the maximum path length also increases linearly with it.
Therefore, the maximum path length of a recurrent layer type is O(n).
*Answer*: O(n)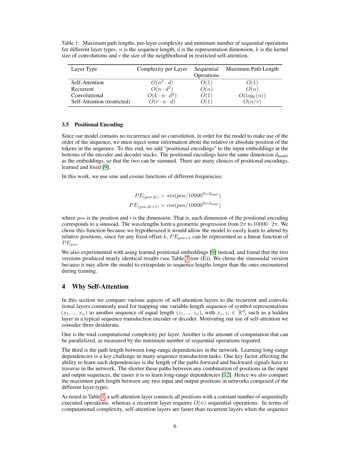
Llama 3.2 Vision: Ứng dụng thực tế
Khả năng kết hợp cả hiểu biết trực quan và văn bản của Llama 3.2 Vision khiến nó lý tưởng cho nhiều ứng dụng thực tế.
Trong lĩnh vực chăm sóc sức khỏe, Llama 3.2 Vision có thể cải thiện độ chính xác chẩn đoán bằng cách phân tích hình ảnh y khoa, như X-quang và MRI, cùng với hồ sơ bệnh nhân. Sự kết hợp dữ liệu trực quan và văn bản này hỗ trợ bác sĩ đưa ra quyết định sáng suốt hơn và đẩy nhanh nghiên cứu lâm sàng, cuối cùng mang lại lợi ích cho chăm sóc bệnh nhân.
Llama 3.2 Vision cũng có thể nâng cao trải nghiệm mua sắm của khách hàng bằng cách kết hợp hình ảnh sản phẩm, đánh giá bằng văn bản và truy vấn của khách. Điều này cho phép đưa ra khuyến nghị cá nhân hóa và hành trình mua sắm phù hợp hơn, cải thiện mức độ tương tác và sự hài lòng.
Trong ngành pháp lý, Llama 3.2 Vision giúp các chuyên gia nhanh chóng truy hồi và tóm tắt thông tin từ hợp đồng, án lệ và tài liệu quét. Nó thậm chí có thể diễn giải các yếu tố trực quan phức tạp như sơ đồ tòa án hoặc chú giải tài liệu, cung cấp thông tin giá trị cho phân tích và ra quyết định pháp lý.
Cuối cùng, Llama 3.2 Vision có thể hỗ trợ môi trường học tập bằng cách diễn giải các phương tiện trực quan như sơ đồ và biểu đồ, đồng thời liên kết chúng với phần giải thích bằng văn bản rõ ràng, theo thời gian thực. Điều này khiến nội dung giáo dục trở nên tương tác hơn, giúp cả học sinh và chuyên gia học hiệu quả hơn.
Kết luận
Với ColPali và các mô hình Llama 3.2 Vision, bạn có thể xây dựng một hệ thống RAG mạnh mẽ có khả năng hiểu và suy luận trên các PDF chứa dữ liệu trực quan và văn bản phức tạp. Sự kết hợp này mở khóa các khả năng cho những ứng dụng từ phân tích tài liệu đến tạo báo cáo tự động, rất hữu ích cho quy trình AI đa phương thức.

Ryan là trưởng nhóm khoa học dữ liệu, chuyên xây dựng các ứng dụng AI sử dụng LLM. Anh là nghiên cứu sinh Tiến sĩ về Xử lý Ngôn ngữ Tự nhiên và Đồ thị Tri thức tại Imperial College London, nơi anh cũng hoàn thành bằng Thạc sĩ Khoa học Máy tính. Ngoài lĩnh vực khoa học dữ liệu, anh viết bản tin Substack hàng tuần, The Limitless Playbook, nơi anh chia sẻ một ý tưởng có thể áp dụng ngay từ các tư tưởng gia hàng đầu thế giới và đôi khi viết về những khái niệm cốt lõi của AI.
Các cách tiếp cận RAG truyền thống gặp khó khăn với tài liệu giàu yếu tố trực quan như PDF. Chúng thường không thể diễn giải các thành phần thị giác phức tạp như hình ảnh, bảng và biểu đồ, khiến việc trích xuất thông tin hữu ích từ các định dạng này trở nên khó khăn hơn.
Đây là lúc các mô hình thị giác Llama 3.2 phát huy tác dụng. Những mô hình đa phương thức tiên tiến này bổ sung khả năng suy luận hình ảnh mạnh mẽ, cho phép hệ thống AI xử lý cả văn bản và dữ liệu thị giác. Với Llama 3.2 Vision, RAG giờ có thể xử lý độ phức tạp của PDF, từ phân tích bảng chi tiết đến diễn giải biểu đồ, mang lại câu trả lời chính xác và ý nghĩa hơn.
Trong bài viết này, tôi sẽ giải thích vì sao Llama 3.2 Vision là giải pháp lý tưởng cho những thách thức này và hướng dẫn bạn cách triển khai nó với ColPali bằng mô hình Llama 3.2 11B Vision.