

Waarom kiezen voor Llama 3.2-visionmodellen voor RAG?
De Llama 3.2-familie introduceert een krachtige reeks modellen die visie en taalbegrip combineren. De twee grootste modellen, 11B en 90B, zijn speciaal ontworpen om complexe taken aan te kunnen waarbij visuele en tekstuele informatie samen begrepen moeten worden.
Deze modellen blinken uit in het lezen en analyseren van diagrammen, grafieken en tabellen, waardoor ze ideaal zijn voor het ophalen van inzichten waar traditionele tekst-only modellen moeite mee hebben. Zo kan een ondernemer vragen: “Welke maand had vorig jaar de hoogste winst?” en Llama 3.2 bekijkt de winstgevendheidsgrafiek en geeft het juiste antwoord.
Daarnaast kunnen de modellen objecten in afbeeldingen lokaliseren op basis van beschrijvingen. Of het nu gaat om het herkennen van herkenningspunten op een kaart of het identificeren van trends in een grafiek, Llama 3.2 doet het moeiteloos.
Llama 3.2 evenaart niet alleen toppers als Claude 3 Haiku en GPT4o-mini, het presteert net zo goed bij taken zoals beeldherkenning en visueel begrip, zoals blijkt uit de vision instruction-tuned benchmarks. Doordat het met zowel tekst als beelden werkt, kan het natuurlijkere, flexibelere gesprekken aan die visuele en geschreven informatie combineren, waardoor het ideaal is voor een breed scala aan use-cases.
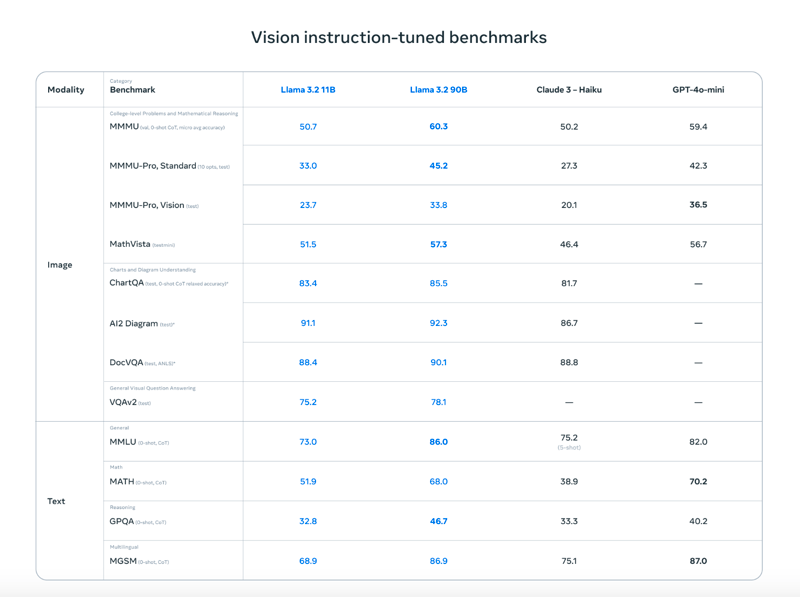
Bron: Meta AI
Met deze geavanceerde features openen Llama 3.2-visionmodellen nieuwe mogelijkheden voor RAG-applicaties. Ze maken het veel eenvoudiger om inzichten te halen uit complexe databronnen zoals pdf’s, door visuele en tekstuele informatie te combineren voor nauwkeurigere en nuttigere resultaten.
RAG implementeren met Llama 3.2 Vision via Ollama en ColPali
Om een RAG-applicatie met Llama 3.2 Vision op te zetten, moeten we het Llama 3.2-visionmodel downloaden, de omgeving inrichten, de benodigde libraries installeren en een retrievalsysteem maken. Hieronder vind je een eenvoudige, stapsgewijze gids om een RAG-applicatie te bouwen met Llama 3.2 Vision en ColPali.
Houd er rekening mee dat de volgende stappen zijn getest in een Colab Pro-notebook met een A100-instance.
Stap 1: Download de afhankelijkheden
Zorg eerst dat je de vereiste dependencies hebt geïnstalleerd:
!pip install byaldi
!sudo apt-get install -y poppler-utils
!pip install -q git+https://github.com/huggingface/transformers.git qwen-vl-utils flash-attn optimum auto-gptq bitsandbytes
!pip install ollama
!pip install colab-xtermDe byaldi-bibliotheek is essentieel voor het indexeren en doorzoeken van multimodale documenten, terwijl andere tools zoals poppler-utils nodig zijn voor het verwerken van pdf’s.
Stap 2: Laad het ColPali RAG-model
ColPali is een methode die documentretrieval verbetert door direct afbeeldingen van documentpagina’s (zoals gescande pdf’s) te embedden in plaats van alleen te vertrouwen op geëxtraheerde tekst. Met geavanceerde vision-language modellen zoals PaliGemma en een late interaction-retrievalmechanisme verwerkt ColPali complexe visuele elementen (tabellen, afbeeldingen en grafieken) efficiënt voor nauwkeurigere en snellere documentzoekopdrachten.
We gebruiken ColPali om onze pdf’s te encoden naar embeddings. Je kunt het ColPali-RAGMultiModalModel als volgt laden:
import os
import base64
from byaldi import RAGMultiModalModel
RAG = RAGMultiModalModel.from_pretrained("vidore/colpali-v1.2", verbose=1)Stap 3: Indexeer een voorbeeld-pdf
We downloaden het beroemde paper Attention is All You Need en maken er een index voor met het RAGMultiModalModel. Deze stap verwerkt het document en extraheert visuele en tekstuele data voor snelle retrieval.
!wget <https://arxiv.org/pdf/1706.03762>
!mkdir docs
!mv 1706.03762 docs/attention.pdfRAG.index(
input_path="./docs/attention.pdf",
index_name="attention",
store_collection_with_index=True, # Store base64 representation of images
overwrite=True
)Added page 1 of document 0 to index.
Added page 2 of document 0 to index.
Added page 3 of document 0 to index.
Added page 4 of document 0 to index.
Added page 5 of document 0 to index.
Added page 6 of document 0 to index.
Added page 7 of document 0 to index.
Added page 8 of document 0 to index.
Added page 9 of document 0 to index.
Added page 10 of document 0 to index.
Added page 11 of document 0 to index.
Added page 12 of document 0 to index.
Added page 13 of document 0 to index.
Added page 14 of document 0 to index.
Added page 15 of document 0 to index.
Index exported to .byaldi/attention
Index exported to .byaldi/attention
{0: 'docs/attention.pdf'}Stap 4: Doorzoek het geïndexeerde document
Zodra je het document hebt geïndexeerd, kun je eenvoudig relevante inhoud uit het document ophalen zoals hieronder:
query = "What's the BLEU score of the transformer architecture in EN-DE"
results = RAG.search(query, k=1)
results[{'doc_id': 0, 'page_num': 8, 'score': 19.0, 'metadata': {}, 'base64': 'iVBORw0KGgoAAAANSUhEUgAABqQAAAiYCAIAAAA+NVHkAAEAAElEQVR4nOzdd1gUx/8H8KGDoC....'}]Dit haalt de best passende pagina of visueel element op uit de geïndexeerde pdf.
Stap 5: Toon de opgehaalde afbeelding
Om de opgehaalde pagina te visualiseren, kunnen we de afbeelding naar een bestand opslaan en als volgt weergeven:
from IPython.display import Image
def see_image(image_base64):
image_bytes = base64.b64decode(image_base64)
filename = 'image.jpg'
with open(filename, 'wb') as f:
f.write(image_bytes)
display(Image(filename))
# For multiple retrieved pages
for res in results:
see_image(res['base64'])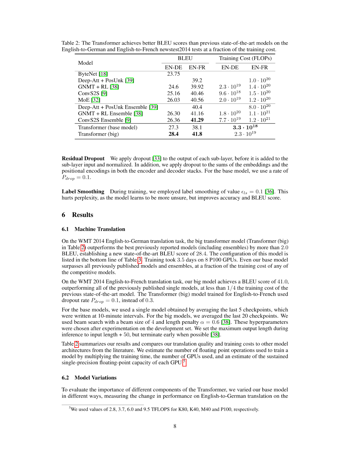
Zoals je ziet, bevat de opgehaalde pagina de informatie die we nodig hebben om de vraag What's the BLEU score of the transformer architecture in EN-DE te beantwoorden. De volgende stap is om deze afbeelding samen met de vraag van de gebruiker aan ons Llama 3.2-visionmodel te voeren.
Stap 6: Richt het Llama 3.2-visionmodel in voor redeneren
Om het Llama 3.2-visionmodel te installeren en in te richten, gebruiken we Ollama in een Colab Pro-notebook met een A100-instance. Je draait Ollama in het notebook en downloadt het Llama 3.2-visionmodel voor gebruik.
%load_ext colabxterm
%xterm%xterm maakt een terminal in het notebook, waarna je Ollama kunt downloaden met dit commando curl -fsSL <https://ollama.com/install.sh> | sh en vervolgens het volgende commando kunt uitvoeren om het Llama 3.2 11B-visionmodel te downloaden en te draaien.
ollama serve & ollama run llama3.2-visionStap 7: Voer inferentie uit
Zodra je het Llama 3.2 11B-visionmodel succesvol hebt gedownload en gestart, kunnen we er verbinding mee maken met de ollama-bibliotheek zoals hieronder. Let op: we hebben de opgehaalde pagina opgeslagen als image.jpg en voeren die hier samen met de vraag van de gebruiker in het Llama 3.2 11B-visionmodel.
import ollama
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': "What's the BLEU score of the transformer architecture in EN-DE",
'images': ['image.jpg']
}]
)
print(response['message']['content'])The table shows that the BLEU score for the transformer (base model) on the EN-DE task is 27.3. The BLEU score for the transformer (big) on the same task is 28.4.
Therefore, the BLEU score of the transformer architecture in EN-DE is **28.4**.Stap 8: Alles samenvoegen
We kunnen de ColPali-retrieval en de Ollama-inferentiecode samenvoegen in de onderstaande inference-functie. Deze functie haalt de meest relevante pagina uit het document, geeft die door aan het visionmodel samen met de query en retourneert een antwoord.
def inference(question: str):
results = RAG.search(question, k=1) # Retrieve relevant data
see_image(results[0]['base64']) # Save and display image
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': question,
'images': ['image.jpg']
}]
)
return response['message']['content']
# Example queries
inference_result = inference("Please explain figure 1")
print(inference_result)The Transformer model is a type of neural network architecture that was introduced in the paper "Attention Is All You Need" by Vaswani et al. in 2017. It has since become one of the most widely used architectures for natural language processing tasks, such as machine translation, text summarization, and question answering.
**What is a Transformer?**
A Transformer is a type of neural network that uses self-attention mechanisms to process input sequences, such as sentences or paragraphs. Unlike traditional recurrent neural networks (RNNs), which rely on sequential processing of inputs, Transformers can process all input elements simultaneously using parallelized attention modules.
**How does the Transformer work?**
The Transformer consists of an encoder and a decoder. The encoder takes in a sequence of tokens (e.g., words or characters) as input and produces a continuous representation of the input sequence. This representation is then fed into the decoder, which generates output sequences one token at a time.
**Key Components:**
* **Self-Attention Mechanism:** This mechanism allows the model to attend to different parts of the input sequence simultaneously and weigh their importance.
* **Multi-Head Attention:** The Transformer uses multiple attention heads to process different aspects of the input sequence in parallel, improving the model's ability to capture complex relationships between tokens.
* **Positional Encoding:** To incorporate positional information into the input sequence, the Transformer uses a positional encoding scheme that adds a learned vector to each token based on its position in the sequence.
**Advantages:**
* **Parallelization:** The Transformer can process all input elements simultaneously, making it much faster than traditional RNNs.
* **Flexibility:** The Transformer can handle sequences of varying lengths and is particularly effective for tasks involving long-range dependencies.
**Applications:**
The Transformer has been widely adopted in various natural language processing applications, including:
* Machine Translation
* Text Summarization
* Question Answering
* Sentiment Analysis
In summary, the Transformer model is a powerful neural network architecture that uses self-attention mechanisms to process input sequences efficiently and effectively. Its ability to parallelize attention modules has made it a popular choice for many natural language processing tasks.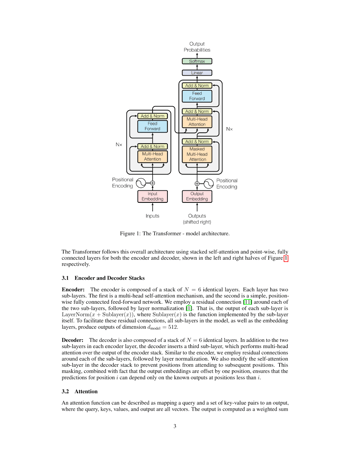
Laten we nog een query proberen:
inference_result = inference("What's the maximum path length of recurrent layer type")
print(inference_result)The table provided in the image shows that for a Recurrent Layer, the Maximum Path Length is O(n). This means that as the number of nodes (n) in the network increases, the maximum path length also increases linearly with it.
Therefore, the maximum path length of a recurrent layer type is O(n).
*Answer*: O(n)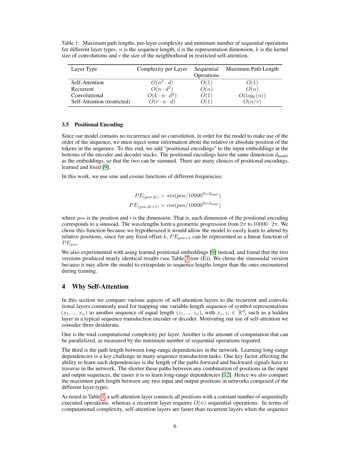
Llama 3.2 Vision: toepassingen in de praktijk
Het vermogen van Llama 3.2 Vision om visueel en tekstueel begrip te combineren maakt het ideaal voor allerlei realistische toepassingen.
In de zorg kan Llama 3.2 Vision de diagnostische nauwkeurigheid verbeteren door medische beelden, zoals röntgenfoto’s en MRI’s, te analyseren naast patiëntendossiers. Deze combinatie van visuele en tekstuele data ondersteunt artsen bij beter onderbouwde beslissingen en versnelt klinisch onderzoek, wat uiteindelijk de patiëntenzorg ten goede komt.
Llama 3.2 Vision kan ook de winkelervaring van klanten verbeteren door productafbeeldingen, tekstrecensies en klantvragen te combineren. Dit maakt persoonlijkere aanbevelingen en een op maat gemaakte winkelreis mogelijk, wat betrokkenheid en tevredenheid vergroot.
In de juridische sector helpt Llama 3.2 Vision professionals snel informatie op te halen en samen te vatten uit contracten, jurisprudentie en gescande documenten. Het kan zelfs complexe visuals interpreteren, zoals zittingsschema’s of documentannotaties, en zo waardevolle inzichten bieden voor juridische analyse en besluitvorming.
Tot slot kan Llama 3.2 Vision leeromgevingen ondersteunen door visuele hulpmiddelen zoals diagrammen en grafieken te interpreteren en te koppelen aan duidelijke, realtime tekstuele uitleg. Dit maakt leermateriaal interactiever en helpt zowel studenten als professionals effectiever te leren.
Conclusies
Met ColPali en Llama 3.2-visionmodellen kun je een krachtig RAG-systeem bouwen dat pdf’s met complexe visuele en tekstuele data kan begrijpen en erover kan redeneren. Deze combinatie ontsluit mogelijkheden voor toepassingen van documentanalyse tot geautomatiseerde rapportgeneratie en is zeer nuttig voor multimodale AI-workflows.

Ryan is lead data scientist en gespecialiseerd in het bouwen van AI-toepassingen met LLM’s. Hij is promovendus in Natural Language Processing en Knowledge Graphs aan Imperial College London, waar hij ook zijn master in Computer Science heeft behaald. Buiten data science om schrijft hij een wekelijkse Substack-nieuwsbrief, The Limitless Playbook, waarin hij één toepasbaar idee van ’s werelds beste denkers deelt en af en toe schrijft over kernconcepten in AI.


Traditionele RAG-methoden hebben moeite met visueel rijke documenten zoals pdf’s. Ze kunnen vaak geen complexe visuele elementen interpreteren, zoals afbeeldingen, tabellen en grafieken, waardoor het lastiger wordt om nuttige inzichten uit deze formaten te halen.
Daar komen de Llama 3.2-visionmodellen om de hoek kijken. Deze geavanceerde multimodale modellen voegen krachtige visuele redeneercapaciteiten toe, waardoor AI-systemen zowel tekst als visuele data kunnen verwerken. Met Llama 3.2 Vision kan RAG nu de complexiteit van pdf’s aan, van het analyseren van gedetailleerde tabellen tot het interpreteren van grafieken, wat leidt tot nauwkeurigere en relevantere antwoorden.
In dit artikel leg ik uit waarom Llama 3.2 Vision de ideale oplossing is voor deze uitdagingen en laat ik zien hoe je het implementeert met ColPali met behulp van het Llama 3.2 11B Vision-model.