
Khóa học
Machine Learning với mô hình dựa trên cây trong Python
5 giờ
119.7K
Trong machine learning, nền tảng cho một mô hình thành công được xây dựng trên chất lượng dữ liệu mà mô hình được huấn luyện. Dù tâm điểm thường thuộc về các thuật toán và mô hình phức tạp, công đoạn ít được nhắc đến nhưng đóng vai trò quan trọng lại là tiền xử lý dữ liệu. Tiền xử lý dữ liệu là bước quan trọng biến dữ liệu thô thành các đặc trưng được dùng cho machine learning hiệu quả.
Các thuật toán machine learning thường được huấn luyện với giả định rằng mọi đặc trưng đóng góp ngang nhau vào dự đoán cuối cùng. Tuy nhiên, giả định này không còn đúng khi các đặc trưng khác nhau về phạm vi và đơn vị đo, từ đó ảnh hưởng đến tầm quan trọng của chúng.
Lúc này, normalization – một bước thiết yếu trong tiền xử lý dữ liệu – đóng vai trò đảm bảo tính đồng nhất về độ lớn số của các đặc trưng. Sự đồng nhất này tránh việc các đặc trưng có giá trị lớn lấn át những đặc trưng hay biến khác.
Trong bài viết này, chúng ta sẽ đi sâu vào normalization, một kỹ thuật thu nhỏ thang đo đặc trưng, giúp cân bằng “cán cân” giữa các đặc trưng.
Normalization là một dạng cụ thể của thu nhỏ thang đo đặc trưng, chuyển phạm vi giá trị của các đặc trưng về một thang chuẩn. Normalization, cũng như bất kỳ kỹ thuật thu nhỏ dữ liệu nào, chỉ cần thiết khi tập dữ liệu có các đặc trưng với phạm vi khác nhau. Normalization bao gồm nhiều kỹ thuật khác nhau, phù hợp với các phân phối dữ liệu và yêu cầu mô hình khác nhau.
Normalization không chỉ giới hạn ở dữ liệu số. Tuy nhiên, trong bài viết này, chúng ta sẽ tập trung vào các ví dụ số. Hãy xem hướng dẫn Textacy của Datacamp’s Textacy: Giới thiệu về làm sạch và chuẩn hoá dữ liệu văn bản trong Python nếu bạn dự định tiền xử lý dữ liệu văn bản cho machine learning.
Dữ liệu đã được normalize giúp tăng hiệu suất mô hình và cải thiện độ chính xác. Nó hỗ trợ các thuật toán dựa vào khoảng cách, như k-nearest neighbors hoặc support vector machines, bằng cách ngăn đặc trưng có thang đo lớn chi phối quá trình học.
Normalization còn tăng tính ổn định trong quá trình tối ưu, thúc đẩy hội tụ nhanh hơn khi huấn luyện dựa trên gradient. Nó giảm thiểu hiện tượng gradient biến mất hoặc bùng nổ, giúp mô hình đạt nghiệm tối ưu hiệu quả hơn.
Dữ liệu đã normalize cũng dễ diễn giải, từ đó dễ hiểu hơn. Khi tất cả đặc trưng của một tập dữ liệu nằm trên cùng một thang đo, việc xác định và trực quan hóa mối quan hệ giữa các đặc trưng cũng trở nên dễ dàng, và có thể so sánh một cách ý nghĩa.
Hãy xét một ví dụ đơn giản để làm rõ tầm quan trọng của việc normalize dữ liệu. Chúng ta cố gắng dự đoán giá nhà dựa trên các đặc trưng như diện tích, số phòng ngủ và khoảng cách tới siêu thị, v.v. Tập dữ liệu có các đặc trưng đa dạng với thang đo khác nhau, chẳng hạn:
Khi bạn đưa dữ liệu này trực tiếp vào mô hình machine learning mà không tiền xử lý, thuật toán có thể gán trọng số lớn hơn cho các đặc trưng có thang đo lớn, như diện tích. Trong quá trình huấn luyện, thuật toán giả định rằng thay đổi về tổng diện tích có tác động đáng kể đến giá nhà. Thuật toán có thể bỏ qua những sắc thái của các đặc trưng nhỏ hơn tương đối, như số phòng ngủ và khoảng cách tới siêu thị. Sự thiên lệch này có thể dẫn đến hiệu suất mô hình kém tối ưu và dự đoán sai lệch.
Bằng cách normalize các đặc trưng, chúng ta đảm bảo mỗi đặc trưng đóng góp tương xứng vào quá trình học của mô hình. Mô hình từ đó học mẫu hình trên tất cả đặc trưng hiệu quả hơn, dẫn đến biểu diễn chính xác hơn về các mối quan hệ tiềm ẩn trong dữ liệu.
Min-Max scaling và Z-score normalization (standardization) là hai kỹ thuật nền tảng. Ngoài ra, chúng ta cũng sẽ bàn về decimal scaling normalization, log scaling normalization và robust scaling, những kỹ thuật giải quyết các thách thức đặc thù trong tiền xử lý dữ liệu.
Min-max scaling thường được gọi đơn giản là ‘normalization.’ Nó chuyển các đặc trưng về một khoảng xác định, thường là từ 0 đến 1. Công thức cho min-max scaling là:
Xnormalized = X – Xmin / Xmax – Xmin
Trong đó X là giá trị đặc trưng ngẫu nhiên cần normalize. Xmin là giá trị nhỏ nhất của đặc trưng trong tập dữ liệu, và Xmax là giá trị lớn nhất.
Min-max scaling phù hợp khi:
Z-score normalization (standardization) giả định dữ liệu có phân phối Gaussian (hình chuông) và biến đổi đặc trưng để có trung bình (μ) bằng 0 và độ lệch chuẩn (σ) bằng 1. Công thức cho standardization là:
Xstandardized = X−μ / σ
Kỹ thuật này đặc biệt hữu ích khi làm việc với các thuật toán giả định dữ liệu phân phối chuẩn, như nhiều mô hình tuyến tính. Khác với min-max scaling, giá trị đặc trưng không bị giới hạn trong một khoảng cụ thể khi standardization. Về bản chất, kỹ thuật này biểu diễn các đặc trưng theo số độ lệch chuẩn so với trung bình.
Trước khi đi sâu vào các kỹ thuật biến đổi dữ liệu khác, hãy so sánh normalization (min-max scaling) và standardization.
|
Normalization |
Standardization |
|
Mục tiêu là đưa giá trị của một đặc trưng vào một khoảng cụ thể, thường từ 0 đến 1 |
Mục tiêu là biến đổi giá trị của một đặc trưng để có trung bình 0 và độ lệch chuẩn 1 |
|
Nhạy cảm với outlier và phạm vi dữ liệu |
Ít nhạy cảm với outlier hơn do sử dụng trung bình và độ lệch chuẩn |
|
Hữu ích khi cần giữ nguyên khoảng giá trị gốc |
Hiệu quả khi các thuật toán giả định phân phối chuẩn tắc |
|
Không đưa ra giả định về phân phối dữ liệu |
Giả định phân phối chuẩn hoặc xấp xỉ chuẩn |
|
Phù hợp với các thuật toán mà giá trị tuyệt đối và quan hệ giữa chúng quan trọng (ví dụ: k-nearest neighbors, neural networks) |
Đặc biệt hữu ích cho các thuật toán giả định dữ liệu phân phối chuẩn, như hồi quy tuyến tính và support vector machines |
|
Giữ được khả năng diễn giải các giá trị gốc trong khoảng đã chỉ định |
Làm thay đổi giá trị gốc, khiến việc diễn giải khó hơn do thay đổi thang đo và đơn vị |
|
Có thể giúp hội tụ nhanh hơn, đặc biệt trong các thuật toán dựa trên gradient descent |
Cũng góp phần hội tụ nhanh hơn, nhất là với các thuật toán nhạy với thang đo đầu vào |
|
Trường hợp sử dụng: Xử lý ảnh, mạng nơ-ron, các thuật toán nhạy với thang đo đặc trưng |
Trường hợp sử dụng: Hồi quy tuyến tính, support vector machines, các thuật toán giả định phân phối chuẩn |
Mục tiêu của decimal scaling normalization là thu nhỏ giá trị đặc trưng theo lũy thừa của 10, đảm bảo giá trị tuyệt đối lớn nhất của mỗi đặc trưng nhỏ hơn 1. Nó hữu ích khi phạm vi giá trị của tập dữ liệu đã biết, nhưng phạm vi này khác nhau giữa các đặc trưng. Công thức cho decimal scaling normalization là:
Xdecimal = X / 10d
Trong đó X là giá trị đặc trưng gốc, và d là số nguyên nhỏ nhất sao cho giá trị tuyệt đối lớn nhất của đặc trưng nhỏ hơn 1.
Ví dụ, nếu giá trị tuyệt đối lớn nhất của một đặc trưng là 3500, thì d sẽ là 3, và đặc trưng sẽ được chia cho 103.
Decimal scaling normalization có lợi khi làm việc với các tập dữ liệu mà độ lớn tuyệt đối của giá trị quan trọng hơn thang đo cụ thể của chúng.
Log scaling normalization chuyển dữ liệu sang thang đo logarit bằng cách lấy log của từng điểm dữ liệu. Nó đặc biệt hữu ích khi xử lý dữ liệu trải dài qua nhiều bậc độ lớn. Công thức cho log scaling normalization là:
Xlog = log(X)
Kỹ thuật này hữu ích với dữ liệu có dạng tăng trưởng hay suy giảm theo hàm mũ. Nó nén thang đo của tập dữ liệu, giúp mô hình dễ nắm bắt các mẫu và mối quan hệ trong dữ liệu hơn. Quy mô dân số qua các năm là ví dụ điển hình về tập dữ liệu mà một số đặc trưng thể hiện tăng trưởng theo hàm mũ. Log scaling normalization có thể giúp các đặc trưng này dễ mô hình hóa hơn.
Robust scaling normalization hữu ích khi làm việc với tập dữ liệu có outlier. Nó sử dụng trung vị và khoảng tứ phân vị (IQR) thay vì trung bình và độ lệch chuẩn để xử lý outlier. Công thức cho robust scaling là:
Xrobust = X – median/ IQR
Vì robust scaling ít bị ảnh hưởng bởi outlier, nó phù hợp với các tập dữ liệu có giá trị lệch hoặc bất thường.
Chúng ta đã bàn về normalization và lý do nó hữu ích trong machine learning. Dù mạnh mẽ, normalization cũng có những thách thức. Từ xử lý outlier đến lựa chọn kỹ thuật phù hợp với dữ liệu, giải quyết các vấn đề này là thiết yếu để phát huy tối đa tiềm năng của mô hình.
Outlier là các điểm dữ liệu lệch đáng kể so với chuẩn, làm sai lệch hiệu quả của các kỹ thuật normalization. Nếu không xử lý outlier, các biến đổi có thể bị lệch. Bạn có thể dùng kỹ thuật robust scaling đã thảo luận ở trên để xử lý outlier.
Một chiến lược khác là áp dụng trimming hoặc winsorizing, tức xác định và cắt ngưỡng hoặc chặn trên/dưới mọi giá trị đặc trưng vượt quá một ngưỡng xác định về một giá trị cố định.
Chúng ta đã bàn về các kỹ thuật hữu ích nhất, nhưng còn nhiều lựa chọn khác. Chọn kỹ thuật phù hợp đòi hỏi hiểu biết tinh tế về tập dữ liệu. Khi tiền xử lý dữ liệu, bạn cần thử nhiều kỹ thuật normalization và đánh giá tác động của chúng lên hiệu suất mô hình. Việc thử nghiệm cho phép quan sát mỗi phương pháp ảnh hưởng tới quá trình học thế nào.
Bạn cần hiểu sâu về đặc điểm dữ liệu. Cân nhắc liệu các giả định của một kỹ thuật normalization cụ thể có phù hợp với phân phối và mẫu hình hiện diện trong tập dữ liệu hay không.
Normalization có thể thách thức khi làm việc với dữ liệu thưa, nơi nhiều giá trị đặc trưng bằng 0. Áp dụng trực tiếp các kỹ thuật tiêu chuẩn có thể gây hệ quả ngoài ý muốn. Có các biến thể của những kỹ thuật đã nêu được thiết kế riêng cho dữ liệu thưa, như ‘sparse min-max scaling.’
Trước khi normalization, hãy cân nhắc nội suy hoặc xử lý giá trị thiếu trong tập dữ liệu. Đây thường là một trong những bước đầu khi bạn khám phá và làm sạch dữ liệu để sử dụng cho mô hình machine learning.
Nhớ xem khóa học Feature Engineering for Machine Learning của DataCamp, nơi bạn sẽ thực hành cách chuẩn bị mọi loại dữ liệu cho chính mô hình machine learning của mình. Trong khóa học, bạn sẽ làm việc với khảo sát Nhà phát triển Stack Overflow và các bài diễn văn nhậm chức của tổng thống Mỹ trong lịch sử để hiểu cách tốt nhất tiền xử lý và xây dựng đặc trưng từ dữ liệu phân loại, liên tục và phi cấu trúc.
Trong machine learning, overfitting xảy ra khi mô hình không chỉ học các mẫu hình cơ bản trong dữ liệu huấn luyện mà còn “học” cả nhiễu và dao động ngẫu nhiên. Điều này dẫn đến mô hình hoạt động rất tốt trên dữ liệu huấn luyện nhưng không khái quát hóa được cho dữ liệu mới, chưa thấy.
Bản thân normalization có thể không gây overfitting. Tuy nhiên, khi normalization kết hợp với các yếu tố khác như độ phức tạp mô hình hoặc thiếu regularization, nó có thể góp phần gây overfitting. Khi tham số normalization được tính trên toàn bộ tập dữ liệu (bao gồm cả tập validation hoặc test), có thể dẫn đến rò rỉ dữ liệu. Mô hình vô tình học thông tin từ tập validation hoặc test, làm suy giảm khả năng khái quát hóa.
Vì vậy, để giảm rủi ro overfitting, hãy normalize trên tập huấn luyện và áp dụng cùng tham số đó cho tập validation và test. Điều này đảm bảo mô hình học cách khái quát từ dữ liệu huấn luyện mà không bị ảnh hưởng bởi thông tin trong validation hoặc test.
Bạn cần triển khai các kỹ thuật regularization phù hợp để phạt những mô hình quá phức tạp. Regularization giúp ngăn mô hình khớp với nhiễu trong dữ liệu huấn luyện. Sử dụng các kỹ thuật đánh giá đúng đắn, như cross-validation, để đánh giá hiệu suất mô hình trên dữ liệu chưa thấy. Nếu phát hiện overfitting trong quá trình đánh giá, có thể điều chỉnh như giảm độ phức tạp mô hình hoặc tăng regularization.
Scikit-learn là một thư viện Python linh hoạt được thiết kế để đơn giản hóa những phức tạp của machine learning. Nó cung cấp bộ công cụ phong phú cho tiền xử lý dữ liệu, chọn đặc trưng, giảm chiều, xây dựng và huấn luyện mô hình, đánh giá mô hình, tinh chỉnh siêu tham số, tuần tự hóa mô hình, xây dựng pipeline, v.v. Thiết kế dạng mô-đun khuyến khích thử nghiệm và khám phá, giúp người dùng chuyển mượt mà từ khái niệm cơ bản đến phương pháp nâng cao.
Chúng ta sẽ dùng scikit-learn để thực hành những gì đã học. Ta sẽ dùng Iris dataset kinh điển và phổ biến. Tập dữ liệu này do nhà sinh học kiêm thống kê người Anh Ronald A. Fisher giới thiệu năm 1936. Iris gồm các đo đạc của bốn đặc trưng từ ba loài hoa iris: setosa, versicolor và virginica.
Có bốn đặc trưng được đo cho mỗi bông: chiều dài đài hoa (sepal length), chiều rộng đài hoa (sepal width), chiều dài cánh hoa (petal length) và chiều rộng cánh hoa (petal width) – đều tính bằng cm. Có 150 bản ghi trong tập, với 50 mẫu cho mỗi loài. Iris thường được dùng cho bài toán phân loại, nơi mục tiêu là dự đoán đúng loài trong ba lớp. Tuy nhiên, hôm nay, chúng ta sẽ dùng tập này để minh hoạ sự biến đổi dữ liệu khi áp dụng normalization (min-max scaling) và standardization.
Bạn có thể chạy mã Python bên dưới trong workspace của Datacamp để tự khám phá tập dữ liệu.
Bắt đầu bằng việc import các thư viện cần thiết….
import numpy as np
import pandas as pd
# To import the dataset
from sklearn.datasets import load_iris
# To be used for splitting the dataset into training and test sets
from sklearn.model_selection import train_test_split
# To be used for min-max normalization
from sklearn.preprocessing import MinMaxScaler
# To be used for Z-normalization (standardization)
from sklearn.preprocessing import StandardScaler

# Load the iris dataset from Scikit-learn package
iris = load_iris()

# This prints a summary of the characteristics, statistics of the dataset
print(iris.DESCR)

# Divide the data into features (X) and target (Y)
# Data is converted to a panda’s dataframe
X = pd.DataFrame(iris.data)

# Separate the target attribute from rest of the data columns
Y = iris.target

# Take a look at the dataframe
X.head()

# This prints the shape of the dataframe (150 rows and 4 columns)
X.shape()
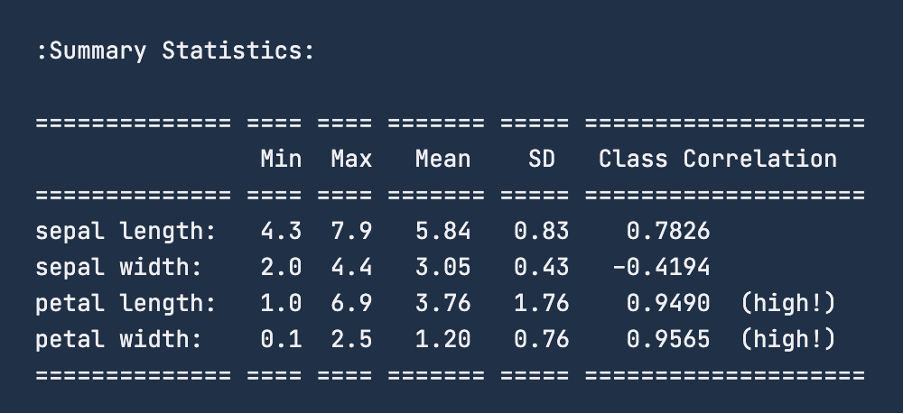
Khi bạn xem thống kê tóm tắt cho dữ liệu bằng print(iris.DESCR), hình dưới đây là phần tóm tắt bạn nhận được. Với đặc trưng ‘sepal length’, phạm vi là 4.3 – 7.9 cm. Tương tự, ‘sepal width’ có phạm vi 2 – 4.4 cm. ‘petal length’ có phạm vi 1 – 6.9 cm và cuối cùng ‘petal width’ có phạm vi 0.1 – 2.5 cm.
Trước khi áp dụng normalization, thực hành tốt là chia tập dữ liệu thành tập huấn luyện và tập kiểm tra. Chúng ta sẽ dùng train_test_split từ sklearn.model_selection. Chúng ta không tách tập validation vì không thực hiện huấn luyện mô hình thực sự trong bài này. Ta sẽ chia 80-20, tức tập huấn luyện có 120 dòng và tập kiểm tra có 30 điểm dữ liệu còn lại.
# To divide the dataset into training and test sets

X_train, X_test, y_train, y_test = train_test_split(X, Y ,test_size=0.2)
Một bước thường làm sau khi tải dữ liệu và chia train-test là làm sạch dữ liệu, nội suy xử lý thiếu và xử lý outlier. Tuy nhiên, vì trọng tâm bài viết là normalization – ta sẽ bỏ qua các bước này và xem normalization hoạt động.
Giờ ta sẽ biến đổi dữ liệu về khoảng 0 – 1 cm bằng kỹ thuật min-max normalization. Để normalize dữ liệu, ta dùng MinMaxScaler từ thư viện sklearn và áp dụng cho tập dữ liệu; các thư viện cần thiết đã import ở trên.
# Good practice to keep original dataframes untouched for reusability
X_train_n = X_train.copy()
X_test_n = X_test.copy()

# Fit min-max scaler on training data
norm = MinMaxScaler().fit(X_train_n)

# Transform the training data
X_train_norm = norm.transform(X_train_n)

# Use the same scaler to transform the testing set
X_test_norm = norm.transform(X_test_n)
Chúng ta có thể in dữ liệu huấn luyện để xem sự biến đổi xảy ra. Tuy nhiên, hãy chuyển bộ dữ liệu này thành một pandas dataframe rồi xem mô tả thống kê bằng chức năng describe().
X_train_norm_df = pd.DataFrame(X_train_norm)

     	# Assigning original feature names for ease of read
X_train_norm_df.columns = iris.feature_names

X_train_norm_df.describe()
Kết quả normalization sẽ như sau:
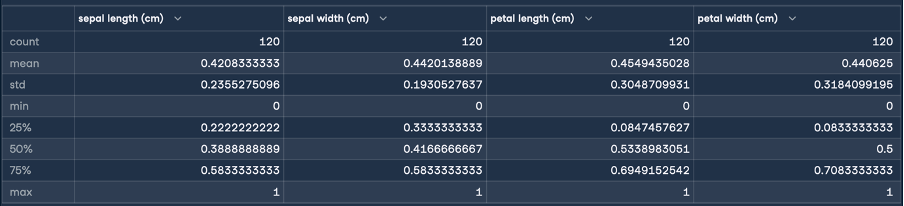
Tại đây, các thống kê min và max cho thấy phạm vi của các đặc trưng đều đã được chuyển về khoảng 0 – 1 cm. Đây chính là biến đổi chúng ta hướng tới! Bây giờ, ta sẽ thực hiện standardization (Z-score normalization) theo cùng các bước như với normalization:
X_train_s = X_train.copy()
X_test_s = X_test.copy()

# Fit the standardization scaler onto the training data
stan = StandardScaler().fit(X_train_s)

# Transform the training data
X_train_stan = stan.transform(X_train_s)

# Use the same scaler to transform the testing set
X_test_stan = stan.transform(X_test_s)

     	# Convert the transformed data into pandas dataframe
X_train_stan_df = pd.DataFrame(X_train_stan)

     	# Assigning original feature names for ease of read
X_train_stan_df.columns = iris.feature_names

     	# Check out the statistical description
X_train_stan_df.describe()
Kết quả standardization sẽ như sau:
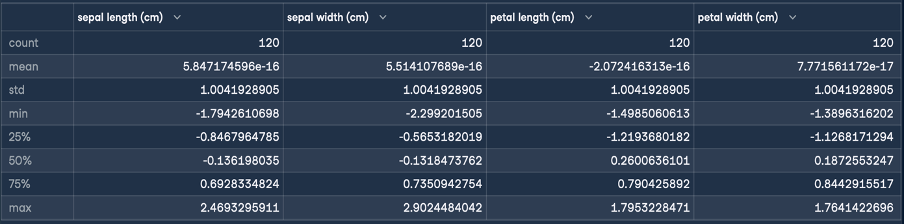
Mục tiêu của Z-normalization là biến đổi giá trị của một đặc trưng để có trung bình bằng 0 và độ lệch chuẩn bằng 1. Như bạn thấy trong phần mô tả dataframe, trung bình của cả bốn đặc trưng là các số nhỏ gần 0 và độ lệch chuẩn là 1.
Giờ ta có thể đưa dữ liệu đã biến đổi này vào một thuật toán machine learning để huấn luyện.
Trong bài viết này, chúng ta đã đi qua min-max scaling, Z-normalization, decimal scaling và log scaling. Mỗi kỹ thuật đều có thế mạnh và tính hữu dụng riêng. Bạn cũng đã đọc về một số sai lầm thường gặp và thực tiễn tốt khi thực hiện normalization. Cuối cùng, chúng ta đã áp dụng một phần kiến thức mới với scikit-learn.
Để tìm hiểu thêm về các khái niệm và quy trình đã đề cập, hãy xem các khóa học Feature Engineering for Machine Learning in Python và Textacy: Giới thiệu về làm sạch và chuẩn hoá dữ liệu văn bản trong Python.
Học Machine Learning!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
