
Corso
Machine Learning con modelli ad alberi in Python
5 ore
119.7K
Nel machine learning, le basi per modelli di successo si costruiscono sulla qualità dei dati su cui vengono addestrati. Sebbene i riflettori siano spesso puntati su algoritmi e modelli complessi e sofisticati, l'eroe silenzioso è spesso il pre-processing dei dati. Il pre-processing è un passaggio importante che trasforma i dati grezzi in feature poi utilizzate per un machine learning efficace.
Gli algoritmi di machine learning vengono spesso addestrati partendo dall'assunzione che tutte le feature contribuiscano in egual misura alla previsione finale. Tuttavia, questa assunzione cade quando le feature differiscono per intervallo e unità di misura, influenzandone così l'importanza.
Entra in gioco la normalizzazione: un passaggio fondamentale del pre-processing che assicura l'uniformità delle magnitudini numeriche delle feature. Questa uniformità evita che le feature con valori più grandi dominino rispetto alle altre variabili.
In questo articolo approfondiremo la normalizzazione, una tecnica di feature scaling che offre un modo per riequilibrare le scale delle feature.
La normalizzazione è una forma specifica di feature scaling che trasforma l'intervallo delle feature in una scala standard. La normalizzazione, e più in generale qualsiasi tecnica di ridimensionamento, è necessaria solo quando il dataset contiene feature con intervalli diversi. La normalizzazione comprende tecniche diverse, pensate per differenti distribuzioni dei dati e requisiti dei modelli.
La normalizzazione non è limitata ai soli dati numerici. Tuttavia, in questo articolo ci concentreremo su esempi numerici. Se stai pianificando di fare pre-processing su dati testuali per il machine learning, dai un'occhiata al tutorial di Datacamp Textacy: un'introduzione alla pulizia e normalizzazione dei dati testuali in Python.
Dati normalizzati migliorano le prestazioni e l'accuratezza del modello. Aiutano gli algoritmi che si basano su metriche di distanza, come k-nearest neighbors o le support vector machines, evitando che le feature con scale maggiori dominino il processo di apprendimento.
La normalizzazione favorisce la stabilità nel processo di ottimizzazione, promuovendo una convergenza più rapida durante l'addestramento basato su gradienti. Mitiga problemi legati a gradienti che svaniscono o esplodono, permettendo ai modelli di raggiungere soluzioni ottimali in modo più efficiente.
I dati normalizzati sono anche più facili da interpretare e quindi più semplici da comprendere. Quando tutte le feature di un dataset sono sulla stessa scala, diventa più semplice identificare e visualizzare le relazioni tra le diverse feature e fare confronti significativi.
Prendiamo un semplice esempio per evidenziare l'importanza di normalizzare i dati. Stiamo provando a predire i prezzi delle case in base a varie feature come metratura, numero di camere da letto e distanza dal supermercato, ecc. Il dataset contiene feature eterogenee con scale diverse, ad esempio:
Se fornisci questi dati direttamente a un modello di machine learning senza alcun pre-processing, l'algoritmo potrebbe attribuire più peso alle feature con scale grandi, come la metratura. Durante l'addestramento, l'algoritmo assume che una variazione della metratura abbia un impatto significativo sui prezzi delle case. Potrebbe trascurare le sfumature di feature relativamente piccole, come il numero di camere da letto e la distanza dal supermercato. Questo sbilanciamento può portare a prestazioni subottimali e previsioni distorte.
Normalizzando le feature, possiamo fare in modo che ciascuna contribuisca proporzionalmente al processo di apprendimento del modello. Il modello può ora apprendere pattern su tutte le feature in modo più efficace, arrivando a una rappresentazione più accurata delle relazioni sottostanti nei dati.
Il min-max scaling e la normalizzazione Z-score (standardizzazione) sono le due tecniche fondamentali di normalizzazione. Oltre a queste, parleremo anche di normalizzazione tramite scaling decimale, normalizzazione logaritmica e scaling robusto, che affrontano sfide specifiche nel pre-processing dei dati.
Il min-max scaling è spesso semplicemente chiamato "normalizzazione". Trasforma le feature in un intervallo specificato, tipicamente tra 0 e 1. La formula per il min-max scaling è:
Xnormalized = X – Xmin / Xmax – Xmin
Dove X è un valore casuale della feature da normalizzare. Xmin è il valore minimo della feature nel dataset e Xmax è il valore massimo.
Il min-max scaling è una buona scelta quando:
La normalizzazione Z-score (standardizzazione) assume una distribuzione gaussiana (a campana) dei dati e trasforma le feature in modo che abbiano media (μ) pari a 0 e deviazione standard (σ) pari a 1. La formula per la standardizzazione è:
Xstandardized = X−μ / σ
Questa tecnica è particolarmente utile con algoritmi che assumono dati distribuiti normalmente, come molti modelli lineari. A differenza del min-max scaling, nella standardizzazione i valori delle feature non sono vincolati a un intervallo specifico. Questa tecnica di normalizzazione rappresenta sostanzialmente le feature in termini del numero di deviazioni standard dalla media.
Prima di approfondire altre tecniche di trasformazione dei dati, confrontiamo normalizzazione (min-max scaling) e standardizzazione.
|
Normalizzazione |
Standardizzazione |
|
L'obiettivo è portare i valori di una feature entro un intervallo specifico, spesso tra 0 e 1 |
L'obiettivo è trasformare i valori di una feature affinché abbiano media 0 e deviazione standard 1 |
|
Sensibile agli outlier e all'intervallo dei dati |
Meno sensibile agli outlier grazie all'uso di media e deviazione standard |
|
Utile quando è essenziale mantenere l'intervallo originale |
Efficace quando gli algoritmi assumono una distribuzione normale standard |
|
Non fa assunzioni sulla distribuzione dei dati |
Assume una distribuzione normale o un'approssimazione vicina |
|
Adatta per algoritmi in cui contano i valori assoluti e le loro relazioni (es. k-nearest neighbors, reti neurali) |
Particolarmente utile per algoritmi che assumono dati distribuiti normalmente, come regressione lineare e support vector machines |
|
Mantiene l'interpretabilità dei valori originali entro l'intervallo specificato |
Altera i valori originali, rendendo l'interpretazione più impegnativa a causa del cambio di scala e unità |
|
Può portare a una convergenza più rapida, soprattutto in algoritmi basati su discesa del gradiente |
Contribuisce anch'essa a una convergenza più rapida, in particolare in algoritmi sensibili alla scala delle feature in input |
|
Casi d'uso: elaborazione di immagini, reti neurali, algoritmi sensibili alle scale delle feature |
Casi d'uso: regressione lineare, support vector machines, algoritmi che assumono distribuzione normale |
L'obiettivo dello scaling decimale è ridimensionare i valori delle feature per una potenza di 10, assicurando che il valore assoluto più grande in ciascuna feature diventi inferiore a 1. È utile quando l'intervallo dei valori in un dataset è noto, ma l'intervallo varia tra le feature. La formula per lo scaling decimale è:
Xdecimal = X / 10d
Dove X è il valore originale della feature e d è il più piccolo intero tale che il valore assoluto più grande della feature diventi inferiore a 1.
Per esempio, se il valore assoluto più grande in una feature è 3500, allora d sarebbe 3 e la feature verrebbe scalata di 103.
Lo scaling decimale è vantaggioso quando si lavora con dataset in cui l'ampiezza assoluta dei valori conta più della loro specifica scala.
La normalizzazione logaritmica converte i dati in una scala logaritmica, prendendo il log di ciascun dato. È particolarmente utile quando si lavora con dati che coprono diversi ordini di grandezza. La formula per la normalizzazione logaritmica è:
Xlog = log(X)
Questa normalizzazione è utile con dati che seguono un pattern di crescita o decadimento esponenziale. Comprime la scala del dataset, rendendo più facile per i modelli catturare pattern e relazioni nei dati. La dimensione della popolazione nel corso degli anni è un buon esempio di dataset in cui alcune feature mostrano crescita esponenziale. La normalizzazione logaritmica può rendere queste feature più adatte alla modellazione.
Lo scaling robusto è utile quando si lavora con dataset che hanno outlier. Utilizza mediana e intervallo interquartile (IQR) invece di media e deviazione standard per gestire gli outlier. La formula per lo scaling robusto è:
Xrobust = X – mediana / IQR
Poiché lo scaling robusto è resistente all'influenza degli outlier, è adatto a dataset con valori asimmetrici o anomali.
Abbiamo parlato della normalizzazione e del perché è utile nel machine learning. Sebbene potente, la normalizzazione non è priva di sfide. Dalla gestione degli outlier alla scelta della tecnica più appropriata in base al tuo dataset, affrontare questi aspetti è essenziale per liberare tutto il potenziale del tuo modello di machine learning.
Gli outlier sono punti dati che si discostano significativamente dalla norma e distorcono l'efficacia delle tecniche di normalizzazione. Se non gestisci gli outlier, possono portare a trasformazioni distorte. Puoi ricorrere alla tecnica di scaling robusto di cui abbiamo parlato per gestirli.
Un'altra strategia è applicare trimming o winsorizing, in cui identifichiamo e tagliamo o limitiamo tutti i valori delle feature al di sopra (o al di sotto) di una certa soglia a un valore fisso.
Abbiamo trattato le tecniche di normalizzazione più utili, ma ce ne sono molte altre tra cui scegliere. La selezione della tecnica appropriata richiede una comprensione sfumata del dataset. Durante il pre-processing, dovresti provare più tecniche di normalizzazione e valutarne l'impatto sulle prestazioni del modello. La sperimentazione ti permette di osservare come ciascun metodo influenza il processo di apprendimento.
Devi acquisire una profonda comprensione delle caratteristiche dei dati. Valuta se le assunzioni di una specifica tecnica di normalizzazione siano in linea con la distribuzione e i pattern presenti nel dataset.
La normalizzazione può essere impegnativa quando si lavora con dati sparsi, in cui molti valori delle feature sono zero. Applicare direttamente le tecniche standard può portare a conseguenze indesiderate. Esistono versioni delle tecniche discusse sopra progettate specificamente per dati sparsi, come lo "sparse min-max scaling".
Prima della normalizzazione, valuta l'imputazione o la gestione dei valori mancanti nel dataset. Questo è spesso uno dei primi passaggi quando esplori e pulisci i dati per l'uso nei modelli di machine learning.
Assicurati di dare un'occhiata al corso di DataCamp Feature Engineering for Machine Learning, che ti offre esperienza pratica su come preparare qualsiasi dato per i tuoi modelli di machine learning. Nel corso lavorerai con il sondaggio degli sviluppatori di Stack Overflow e con storici discorsi di insediamento dei presidenti USA per capire come pre-processare e ingegnerizzare al meglio feature da dati categoriali, continui e non strutturati.
Nel machine learning, l'overfitting si verifica quando un modello impara non solo i pattern sottostanti nei dati di training, ma cattura anche rumore e fluttuazioni casuali. Questo può portare a un modello che funziona molto bene sui dati di training ma non generalizza su nuovi dati.
La sola normalizzazione potrebbe non causare overfitting. Tuttavia, quando è combinata con altri fattori, come la complessità del modello o una regolarizzazione insufficiente, può contribuire all'overfitting. Quando i parametri di normalizzazione sono calcolati usando l'intero dataset (inclusi validation o test set), si può incorrere in leakage. Il modello potrebbe imparare involontariamente informazioni dai set di validazione o test, compromettendo la sua capacità di generalizzare.
Per mitigare il rischio di overfitting, normalizza il training set e applica gli stessi parametri di normalizzazione ai set di validazione e test. In questo modo il modello impara a generalizzare dai dati di training senza essere influenzato dalle informazioni presenti nei set di validazione o test.
Devi implementare adeguate tecniche di regolarizzazione per penalizzare i modelli eccessivamente complessi. La regolarizzazione aiuta a evitare che il modello aderisca al rumore nei dati di training. Usa tecniche di validazione adeguate, come la cross-validation, per valutare le prestazioni su dati non visti. Se si rileva overfitting in validazione, si possono apportare modifiche, come ridurre la complessità del modello o aumentare la regolarizzazione.
Scikit-learn è una libreria Python versatile progettata per semplificare le complessità del machine learning. Fornisce un ricco set di strumenti e funzionalità per pre-processing dei dati, selezione delle feature, riduzione della dimensionalità, costruzione e addestramento dei modelli, valutazione, tuning degli iperparametri, serializzazione dei modelli, costruzione di pipeline, ecc. Il suo design modulare incoraggia sperimentazione ed esplorazione, permettendo agli utenti di passare senza soluzione di continuità dai concetti fondamentali alle metodologie avanzate.
Useremo scikit-learn per mettere in pratica quanto appreso. Utilizzeremo il classico e diffusissimo "Iris dataset". Questo dataset è stato introdotto dal biologo e statistico britannico Ronald A. Fisher nel 1936. L'Iris dataset comprende misurazioni di quattro feature di tre diverse specie di iris: setosa, versicolor e virginica.
Per ogni fiore sono misurate quattro feature: lunghezza e larghezza del sepalo, lunghezza e larghezza del petalo, tutte in centimetri. Nel dataset ci sono 150 istanze (campioni), con 50 campioni per ciascuna delle tre specie. L'Iris dataset è di solito usato per compiti di classificazione, dove l'obiettivo è predire la specie corretta tra le tre classi. Oggi, però, lo useremo per mostrare la trasformazione dei dati applicando normalizzazione (min-max scaling) e standardizzazione.
Puoi eseguire il codice Python discusso di seguito nello workspace di Datacamp per esplorare il dataset in prima persona.
Iniziamo importando le librerie necessarie…
import numpy as np
import pandas as pd
# To import the dataset
from sklearn.datasets import load_iris
# To be used for splitting the dataset into training and test sets
from sklearn.model_selection import train_test_split
# To be used for min-max normalization
from sklearn.preprocessing import MinMaxScaler
# To be used for Z-normalization (standardization)
from sklearn.preprocessing import StandardScaler

# Load the iris dataset from Scikit-learn package
iris = load_iris()

# This prints a summary of the characteristics, statistics of the dataset
print(iris.DESCR)

# Divide the data into features (X) and target (Y)
# Data is converted to a panda’s dataframe
X = pd.DataFrame(iris.data)

# Separate the target attribute from rest of the data columns
Y = iris.target

# Take a look at the dataframe
X.head()

# This prints the shape of the dataframe (150 rows and 4 columns)
X.shape()
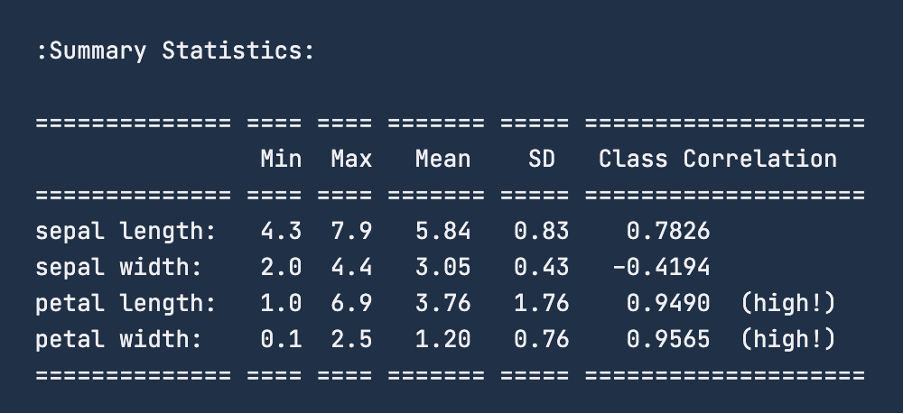
Quando controlli le statistiche riassuntive dei dati usando print(iris.DESCR), l'immagine seguente è il riepilogo che otterrai. Per la feature "sepal length", l'intervallo è 4,3 – 7,9 centimetri. Allo stesso modo, per "sepal width" l'intervallo è 2 – 4,4 centimetri. Per "petal length" l'intervallo è 1 – 6,9 centimetri e infine per "petal width" l'intervallo è 0,1 – 2,5 centimetri.
Prima di applicare la normalizzazione, è buona pratica dividere il dataset in training e test set. Useremo la funzionalità train_test_split da sklearn.model_selection per farlo. Non ricaveremo un validation set poiché in questo esercizio non eseguiremo una vera modellazione di machine learning. Faremo una suddivisione 80-20 del dataset, il che significa che il training set avrà 120 righe e il test conterrà i restanti 30 punti dati.
# To divide the dataset into training and test sets

X_train, X_test, y_train, y_test = train_test_split(X, Y ,test_size=0.2)
Un passaggio usuale dopo il caricamento e la suddivisione dei dati in training e test è eseguire pulizia, imputazione dei valori mancanti e gestione degli outlier. Tuttavia, poiché il focus dell'articolo è sulla normalizzazione, salteremo questi passaggi e passeremo direttamente a vederla in azione.
Trasformeremo ora questi dati per farli rientrare nell'intervallo 0 – 1 centimetro usando la tecnica di min-max normalization. Per normalizzare i dati, useremo la funzionalità MinMaxScaler della libreria sklearn e la applicheremo al nostro dataset; abbiamo già importato le librerie necessarie in precedenza.
# Good practice to keep original dataframes untouched for reusability
X_train_n = X_train.copy()
X_test_n = X_test.copy()

# Fit min-max scaler on training data
norm = MinMaxScaler().fit(X_train_n)

# Transform the training data
X_train_norm = norm.transform(X_train_n)

# Use the same scaler to transform the testing set
X_test_norm = norm.transform(X_test_n)
Possiamo stampare i dati di training per vedere la trasformazione avvenuta. Tuttavia, convertiamo prima l'insieme in un dataframe pandas e poi verifichiamone la descrizione statistica usando la funzionalità describe().
X_train_norm_df = pd.DataFrame(X_train_norm)

     	# Assigning original feature names for ease of read
X_train_norm_df.columns = iris.feature_names

X_train_norm_df.describe()
Questo produrrà il seguente risultato per la normalizzazione:
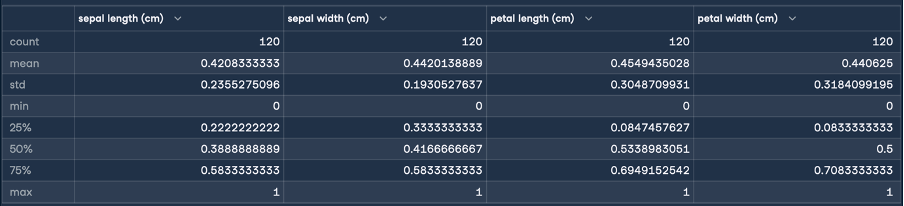
Qui, le statistiche min e max indicano che gli intervalli delle feature sono stati tutti trasformati nell'intervallo 0 – 1 centimetro. Questa è la trasformazione che volevamo! Ora eseguiremo la standardizzazione (normalizzazione Z-score) seguendo gli stessi passaggi usati per la normalizzazione:
X_train_s = X_train.copy()
X_test_s = X_test.copy()

# Fit the standardization scaler onto the training data
stan = StandardScaler().fit(X_train_s)

# Transform the training data
X_train_stan = stan.transform(X_train_s)

# Use the same scaler to transform the testing set
X_test_stan = stan.transform(X_test_s)

     	# Convert the transformed data into pandas dataframe
X_train_stan_df = pd.DataFrame(X_train_stan)

     	# Assigning original feature names for ease of read
X_train_stan_df.columns = iris.feature_names

     	# Check out the statistical description
X_train_stan_df.describe()
Questo produrrà il seguente risultato per la standardizzazione:
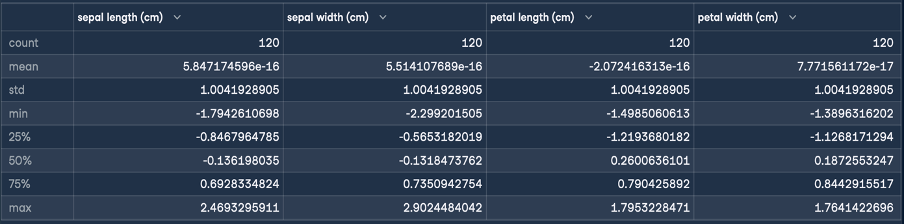
L'obiettivo della Z-normalization è trasformare i valori di una feature affinché abbiano media 0 e deviazione standard 1. Come puoi vedere dalla descrizione del dataframe generato, la media per tutte e quattro le feature è un numero piccolo vicino a zero e la deviazione standard è 1.
Ora possiamo prendere questi dati trasformati e fornirli a un algoritmo di machine learning per l'addestramento.
In questo articolo abbiamo esplorato min-max scaling, Z-normalization, scaling decimale e normalizzazione logaritmica. Ogni tecnica ha rivelato i propri punti di forza e utilità. Hai anche letto di alcuni errori comuni e buone pratiche quando si esegue la normalizzazione. Infine, abbiamo messo in pratica parte di queste conoscenze con scikit-learn.
Per approfondire i concetti e i processi trattati, consulta i nostri corsi su Feature Engineering for Machine Learning in Python e Textacy: un'introduzione alla pulizia e normalizzazione dei dati testuali in Python.
Impara il Machine Learning!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



