
Kurs
Python ile Ağaç Tabanlı Modellerle Machine Learning
5 sa
119.7K
Makine öğreniminde başarılı modellerin temeli, eğitildikleri verinin kalitesi üzerine kurulur. Işık genellikle karmaşık, sofistike algoritma ve modellere tutulsa da, perde arkasındaki asıl kahraman çoğu zaman veri ön işlemedir. Veri ön işleme, ham veriyi etkili makine öğrenimi için kullanılacak özelliklere dönüştüren önemli bir adımdır.
Makine öğrenimi algoritmaları çoğunlukla tüm özelliklerin nihai tahmine eşit derecede katkıda bulunduğu varsayımıyla eğitilir. Ancak bu varsayım, özellikler aralık ve birim açısından farklılık gösterdiğinde geçersiz olur ve bu da önem derecelerini etkiler.
İşte normalizasyon – özelliklerin sayısal büyüklüklerinde birlik sağlayan, veri ön işlemenin hayati bir adımı. Bu birlik, daha büyük değerlere sahip özelliklerin diğer özelliklere veya değişkenlere baskın gelmesini engeller.
Bu yazıda, özellik ölçekleme tekniklerinden biri olan normalizasyona dalacağız; bu teknik, özelliklerin terazisini dengelemenin bir yolunu sunar.
Normalizasyon, özelliklerin aralığını standart bir ölçeğe dönüştüren belirli bir özellik ölçekleme biçimidir. Normalizasyon ve genel olarak herhangi bir veri ölçekleme tekniği yalnızca veri kümenizde farklı aralıklara sahip özellikler olduğunda gereklidir. Normalizasyon, farklı veri dağılımları ve model gereksinimlerine uyarlanmış çeşitli teknikleri kapsar.
Normalizasyon yalnızca sayısal verilerle sınırlı değildir. Ancak bu yazıda sayısal örneklere odaklanacağız. Metin verileri üzerinde makine öğrenimi için ön işleme yapmayı planlıyorsanız, Datacamp’in Textacy: Python ile metin verisi temizleme ve normalizasyona giriş eğitimine göz atmayı unutmayın.
Normalize edilmiş veriler model performansını artırır ve bir modelin doğruluğunu iyileştirir. en yakın komşular veya destek vektör makineleri gibi uzaklık metriklerine dayanan algoritmalara, daha büyük ölçekli özelliklerin öğrenme sürecine hükmetmesini engelleyerek yardımcı olur.
Normalizasyon, optimizasyon sürecinde kararlılığı destekler ve gradyan tabanlı eğitim sırasında daha hızlı yakınsamayı teşvik eder. Sönen veya taşan gradyanlarla ilgili sorunları azaltarak modellerin en iyi çözümlere daha verimli şekilde ulaşmasını sağlar.
Normalize edilmiş veriler yorumlaması da kolaydır ve dolayısıyla anlaşılması daha rahattır. Bir veri kümesinin tüm özellikleri aynı ölçekte olduğunda, farklı özellikler arasındaki ilişkileri belirlemek ve görselleştirmek, ayrıca anlamlı karşılaştırmalar yapmak kolaylaşır.
Veri normalizasyonunun önemini vurgulamak için basit bir örnek ele alalım. Konut fiyatlarını metrekare, yatak odası sayısı, süpermarkete uzaklık gibi çeşitli özelliklere göre tahmin etmeye çalışıyoruz. Veri kümesi, şu gibi farklı ölçeklerde çeşitli özellikler içeriyor:
Bu veriyi herhangi bir ön işleme yapmadan doğrudan bir makine öğrenimi modeline verdiğinizde, algoritma metrekare gibi büyük ölçekli özelliklere daha fazla ağırlık verebilir. Eğitim sırasında algoritma, toplam metrekaredeki bir değişikliğin konut fiyatları üzerinde önemli bir etkisi olacağını varsayabilir. Algoritma, görece küçük olan yatak odası sayısı ve süpermarkete uzaklık gibi özelliklerin nüanslarını göz ardı edebilir. Bu kaymış vurgu, optimalin altında model performansına ve yanlı tahminlere yol açabilir.
Özellikleri normalize ederek, her bir özelliğin modelin öğrenme sürecine orantılı olarak katkıda bulunmasını sağlayabiliriz. Model artık tüm özellikler arasında kalıpları daha etkili şekilde öğrenebilir; bu da verideki temel ilişkilerin daha doğru temsil edilmesine yol açar.
Min-maks ölçekleme ve Z-skor normalizasyonu (standardizasyon) normalizasyon için iki temel tekniktir. Bunların yanı sıra, veri ön işlemeye özgü zorlukları ele alan ondalık ölçekleme normalizasyonu, log ölçekleme normalizasyonu ve sağlam (robust) ölçeklemeyi de ele alacağız.
Min-maks ölçekleme çoğu zaman basitçe ‘normalizasyon’ olarak adlandırılır. Özellikleri genellikle 0 ile 1 arasında olmak üzere belirtilen bir aralığa dönüştürür. Min-maks ölçeklemenin formülü:
Xnormalized = X – Xmin / Xmax – Xmin
Burada X, normalize edilecek rastgele bir özellik değeridir. Xmin veri kümesindeki minimum özellik değeri, Xmax ise maksimum özellik değeridir.
Min-maks ölçekleme şu durumlarda iyi bir seçimdir:
Z-skor normalizasyonu (standardizasyon), verinin Gauss (çan eğrisi) dağılımına sahip olduğunu varsayar ve özellikleri ortalaması (μ) 0 ve standart sapması (σ) 1 olacak şekilde dönüştürür. Standardizasyonun formülü:
Xstandardized = X−μ / σ
Bu teknik, birçok doğrusal model gibi verilerin normal dağıldığını varsayan algoritmalarla çalışırken özellikle yararlıdır. Min-maks ölçekleme tekniğinin aksine, standardizasyonda özellik değerleri belirli bir aralıkla sınırlandırılmaz. Bu normalizasyon tekniği temelde özellikleri, ortalamadan kaç standart sapma uzakta oldukları cinsinden temsil eder.
Diğer veri dönüşüm tekniklerine dalmadan önce, normalizasyon (min-maks ölçekleme) ve standardizasyonun bir karşılaştırmasını yapalım.
|
Normalizasyon |
Standardizasyon |
|
Amaç, bir özelliğin değerlerini genellikle 0 ile 1 arasında olmak üzere belirli bir aralığa getirmektir |
Amaç, bir özelliğin değerlerini ortalaması 0 ve standart sapması 1 olacak şekilde dönüştürmektir |
|
Aykırı değerlere ve verinin aralığına duyarlıdır |
Ortalama ve standart sapma kullanımı nedeniyle aykırı değerlere daha az duyarlıdır |
|
Özgün aralığın korunmasının önemli olduğu durumlarda kullanışlıdır |
Algoritmaların standart normal dağılım varsaydığı durumlarda etkilidir |
|
Verinin dağılımı hakkında bir varsayımda bulunulmaz |
Normal bir dağılımı veya ona yakın bir yaklaşımı varsayar |
|
Mutlak değerlerin ve aralarındaki ilişkilerin önemli olduğu algoritmalar için uygundur (örn. en yakın komşular, sinir ağları) |
Özellikle doğrusal regresyon ve destek vektör makineleri gibi verilerin normal dağıldığını varsayan algoritmalar için yararlıdır |
|
Belirtilen aralık içinde özgün değerlerin yorumlanabilirliğini korur |
Ölçek ve birimlerdeki kayma nedeniyle özgün değerleri değiştirir, bu da yorumlamayı daha zor hale getirir |
|
Özellikle gradyan inişine dayanan algoritmalarda daha hızlı yakınsamaya yol açabilir |
Girdi özelliklerinin ölçeğine duyarlı algoritmalarda özellikle daha hızlı yakınsamaya katkıda bulunur |
|
Kullanım alanları: Görüntü işleme, sinir ağları, özellik ölçeklerine duyarlı algoritmalar |
Kullanım alanları: Doğrusal regresyon, destek vektör makineleri, normal dağılım varsayan algoritmalar |
Ondalık ölçekleme normalizasyonunun amacı, her bir özellikteki en büyük mutlak değerin 1'den küçük olmasını sağlayacak şekilde özellik değerlerini 10'un bir kuvvetiyle ölçeklemektir. Bir veri kümesindeki değerlerin aralığı bilindiğinde ancak aralık özellikler arasında değiştiğinde kullanışlıdır. Ondalık ölçekleme normalizasyonunun formülü:
Xdecimal = X / 10d
Burada X özgün özellik değeridir ve d, özellikteki en büyük mutlak değerin 1'den küçük olmasını sağlayan en küçük tamsayıdır.
Örneğin, bir özellikteki en büyük mutlak değer 3500 ise d değeri 3 olur ve özellik 103 ile ölçeklenir.
Ondalık ölçekleme normalizasyonu, değerlerin mutlak büyüklüğünün belirli ölçeklerinden daha önemli olduğu veri kümeleriyle çalışırken avantaj sağlar.
Log ölçekleme normalizasyonu, her veri noktasının logunu alarak veriyi logaritmik bir ölçeğe dönüştürür. Birkaç mertebe büyüklüğe yayılan verilerle çalışırken özellikle kullanışlıdır. Log ölçekleme normalizasyonunun formülü:
Xlog = log(X)
Bu normalizasyon, üssel büyüme veya azalma desenini izleyen verilerde işe yarar. Veri kümesinin ölçeğini sıkıştırır ve modellerin verideki kalıpları ve ilişkileri yakalamasını kolaylaştırır. Yıllar içinde nüfus büyüklüğü, bazı özelliklerin üssel büyüme sergilediği bir veri kümesine iyi bir örnektir. Log ölçekleme normalizasyonu, bu özellikleri modellere daha uygun hale getirebilir.
Sağlam ölçekleme normalizasyonu, aykırı değeri olan veri kümeleriyle çalışırken kullanışlıdır. Aykırı değerleri ele almak için ortalama ve standart sapma yerine medyan ve çeyrekler arası aralığı (IQR) kullanır. Sağlam ölçeklemenin formülü:
Xrobust = X – median/ IQR
Sağlam ölçekleme aykırı değerlerin etkisine dayanıklı olduğundan, bu durum onu çarpık veya anormal değerlere sahip veri kümeleri için uygun kılar.
Normalizasyonu ve makine öğreniminde neden yararlı olduğunu tartıştık. Güçlü olmasına rağmen, normalizasyon zorluklardan ari değildir. Aykırı değerleri ele almaktan veri kümenize en uygun tekniği seçmeye kadar, bu konuları çözmek makine öğrenimi modelinizin tam potansiyelini açığa çıkarmak için kritik önemdedir.
Aykırı değerler, veri kümenizdeki normdan önemli ölçüde sapan ve normalizasyon tekniklerinin etkinliğini bozan veri noktalarıdır. Verinizdeki aykırı değerleri ele almazsanız, bunlar çarpık dönüşümlere yol açabilir. Aykırı değerleri ele almak için daha önce tartıştığımız sağlam ölçekleme normalizasyon tekniğini kullanabilirsiniz.
Bir diğer strateji, belirli bir değerin üzerindeki (veya altındaki) tüm özellik değerlerini sabit bir değerde kırptığımız veya sınırlandırdığımız trimming veya winsorizing uygulamaktır.
En faydalı normalizasyon tekniklerini tartıştık, ancak seçilebilecek daha birçok teknik var. Uygun tekniği seçmek, veri kümesini incelikli biçimde anlamayı gerektirir. Veri ön işlerken, birden fazla normalizasyon tekniğini denemeli ve bunların model performansı üzerindeki etkisini değerlendirmelisiniz. Deney yapmak, her yöntemin öğrenme sürecini nasıl etkilediğini gözlemlemenizi sağlar.
Verinin özelliklerini derinlemesine anlamanız gerekir. Belirli bir normalizasyon tekniğinin varsayımlarının, veri kümesinde mevcut dağılım ve desenlerle uyumlu olup olmadığını değerlendirin.
Birçok özellik değerinin sıfır olduğu seyrek verilerle çalışırken normalizasyon zorlayıcı olabilir. Standart normalizasyon tekniklerini doğrudan uygulamak istenmeyen sonuçlara yol açabilir. Yukarıda tartıştığımız normalizasyon tekniklerinin, özellikle ‘seyrek min-maks ölçekleme’ gibi seyrek veri için tasarlanmış sürümleri vardır.
Normalizasyondan önce, veri kümenizdeki eksik değerleri atama veya ele alma konusunu göz önünde bulundurun. Bu, veri kümenizi keşfederken ve makine öğrenimi modellerinde kullanım için temizlerken genellikle ilk adımlardan biridir.
Kategorik, sürekli ve yapılandırılmamış verilerden özellikleri en iyi şekilde nasıl ön işler ve türetirsiniz öğrenmek için, DataCamp’in uygulamalı deneyim sunan Makine Öğrenimi için Özellik Mühendisliği kursuna mutlaka göz atın. Kursta, Stack Overflow Geliştirici anketi ve ABD başkanlarının tarihî yemin töreni konuşmalarıyla çalışarak herhangi bir veriyi kendi makine öğrenimi modellerinize nasıl hazırlayacağınızı öğreneceksiniz.
Makine öğreniminde aşırı öğrenme, bir modelin eğitim verilerindeki temel desenlerin yanı sıra gürültüyü ve rastgele dalgalanmaları da öğrendiğinde ortaya çıkar. Bu, eğitim verisinde olağanüstü iyi performans gösteren ancak yeni, görülmemiş verilere genelleyemeyen bir modele yol açabilir.
Tek başına normalizasyon aşırı öğrenmeye neden olmayabilir. Ancak normalizasyon, modelin karmaşıklığı veya yetersiz düzenlileştirme gibi diğer faktörlerle birleştiğinde aşırı öğrenmeye katkıda bulunabilir. Normalizasyon parametreleri tüm veri kümesi (doğrulama veya test setleri dahil) kullanılarak hesaplandığında veri sızıntısına yol açabilir. Model, doğrulama veya test setlerinden istemeden bilgi öğrenebilir ve genelleme yeteneğini zedeleyebilir.
Bu nedenle, aşırı öğrenme riskini azaltmak için eğitim setini normalize edin ve aynı normalizasyon parametrelerini doğrulama ve test setlerine uygulayın. Bu, modelin doğrulama veya test setlerindeki bilgilerden etkilenmeden eğitim verisinden genellemeyi öğrenmesini sağlar.
Aşırı karmaşık modelleri cezalandırmak için uygun düzenlileştirme tekniklerini uygulamalısınız. Düzenlileştirme, modelin eğitim verisindeki gürültüyü uydurmasını engellemeye yardımcı olur. Modelin görülmemiş verilerdeki performansını değerlendirmek için çapraz doğrulama gibi uygun doğrulama tekniklerini kullanın. Doğrulama sırasında aşırı öğrenme tespit edilirse, model karmaşıklığını azaltma veya düzenlileştirmeyi artırma gibi ayarlamalar yapılabilir.
Scikit-learn, makine öğreniminin inceliklerini basitleştirmek üzere tasarlanmış çok yönlü bir Python kütüphanesidir. Veri ön işleme, özellik seçimi, boyut indirgeme, model kurma ve eğitme, model değerlendirme, hiperparametre ayarı, model serileştirme, işlem hattı (pipeline) oluşturma vb. için zengin araç ve işlevler sunar. Modüler tasarımı, kullanıcıların temel kavramlardan ileri yöntemlere sorunsuzca geçiş yapmasına olanak tanıyarak deneyi ve keşfi teşvik eder.
Öğrendiklerimizi uygulamaya dökmek için scikit-learn kullanacağız. Klasik ve yaygın olarak kullanılan `Iris veri kümesini` kullanacağız. Bu veri kümesi 1936 yılında Britanyalı biyolog ve istatistikçi Ronald A. Fisher tarafından tanıtıldı. Iris veri kümesi, üç farklı iris çiçeği türünden (setosa, versicolor ve virginica) dört özelliğin ölçümlerini içerir.
Her çiçek için dört özellik ölçülmüştür: çanak yaprağı uzunluğu, çanak yaprağı genişliği, taç yaprağı uzunluğu ve taç yaprağı genişliği – hepsi santimetre cinsinden. Veri kümesinde üç türün her birinden 50 örnek olmak üzere 150 örnek (örneklem) vardır. Iris veri kümesi genellikle sınıflandırma görevleri için kullanılır; amaç üç sınıf arasından doğru türü tahmin etmektir. Ancak bugün, normalizasyon (min-maks ölçekleme) ve standardizasyon uygulandığında verinin nasıl dönüştüğünü göstermek için bu veri kümesini kullanacağız.
Aşağıda tartışılan Python kodunu veri kümesini kendiniz keşfetmek için Datacamp’in çalışma alanında çalıştırabilirsiniz.
Gerekli kütüphaneleri içe aktararak başlayalım….
import numpy as np
import pandas as pd
# To import the dataset
from sklearn.datasets import load_iris
# To be used for splitting the dataset into training and test sets
from sklearn.model_selection import train_test_split
# To be used for min-max normalization
from sklearn.preprocessing import MinMaxScaler
# To be used for Z-normalization (standardization)
from sklearn.preprocessing import StandardScaler

# Load the iris dataset from Scikit-learn package
iris = load_iris()

# This prints a summary of the characteristics, statistics of the dataset
print(iris.DESCR)

# Divide the data into features (X) and target (Y)
# Data is converted to a panda’s dataframe
X = pd.DataFrame(iris.data)

# Separate the target attribute from rest of the data columns
Y = iris.target

# Take a look at the dataframe
X.head()

# This prints the shape of the dataframe (150 rows and 4 columns)
X.shape()
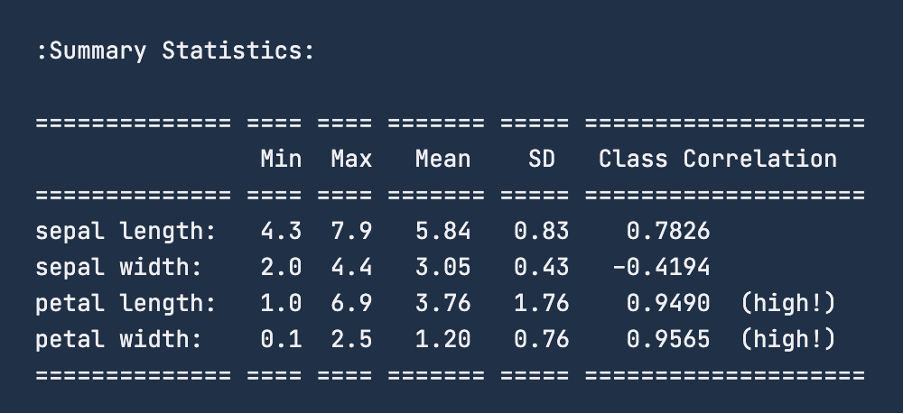
print(iris.DESCR) kullanarak veriye ilişkin özet istatistikleri kontrol ettiğinizde, aşağıdaki görseldeki gibi bir özet alırsınız. ‘Sepal length’ (çanak yaprağı uzunluğu) özelliği için aralık 4,3 – 7,9 santimetredir. Benzer şekilde ‘sepal width’ (çanak yaprağı genişliği) için aralık 2 – 4,4 santimetredir. ‘Petal length’ (taç yaprağı uzunluğu) için aralık 1 – 6,9 santimetre, son olarak ‘petal width’ (taç yaprağı genişliği) için aralık 0,1 – 2,5 santimetredir.
Normalizasyon uygulamadan önce, veri kümesini eğitim ve test setlerine ayırmak iyi bir uygulamadır. Bunu yapmak için sklearn.model_selection içindeki train_test_split işlevini kullanacağız. Bu alıştırmada gerçek bir makine öğrenimi modellemesi yapmayacağımız için bir doğrulama seti ayırmıyoruz. Veri kümesini %80-%20 oranında böleceğiz; bu da eğitim setinde 120 satır, testte ise kalan 30 veri noktası olacağı anlamına gelir.
# To divide the dataset into training and test sets

X_train, X_test, y_train, y_test = train_test_split(X, Y ,test_size=0.2)
Veriyi yükledikten ve eğitim-test setlerine ayırdıktan sonra genellikle bir sonraki adım veri temizleme, eksik değerleri ele almak için veri atama ve aykırı değerleri ele almaktır. Ancak bu yazının odağı normalizasyon olduğundan – bu ön işleme adımlarını atlayacak ve normalizasyonu uygulamada görmeye geçeceğiz.
Şimdi bu veriyi min-maks normalizasyon tekniğini kullanarak 0 – 1 santimetre aralığına dönüştüreceğiz. Veriyi normalize etmek için sklearn kütüphanesindeki MinMaxScaler işlevini kullanacak ve veri kümemize uygulayacağız; gerekli kütüphaneleri zaten içe aktarmıştık.
# Good practice to keep original dataframes untouched for reusability
X_train_n = X_train.copy()
X_test_n = X_test.copy()

# Fit min-max scaler on training data
norm = MinMaxScaler().fit(X_train_n)

# Transform the training data
X_train_norm = norm.transform(X_train_n)

# Use the same scaler to transform the testing set
X_test_norm = norm.transform(X_test_n)
Dönüşümü görmek için eğitim verilerini yazdırabiliriz. Ancak, önce kümeyi bir pandas veri çerçevesine dönüştürelim ve ardından describe() işlevini kullanarak istatistiksel özetini inceleyelim.
X_train_norm_df = pd.DataFrame(X_train_norm)

     	# Assigning original feature names for ease of read
X_train_norm_df.columns = iris.feature_names

X_train_norm_df.describe()
Bu, normalizasyon için aşağıdaki sonucu verir:
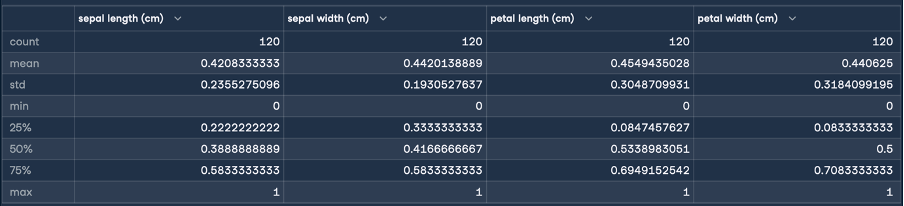
Burada, min ve max istatistikleri, tüm özelliklerin aralıklarının 0 – 1 santimetre aralığına dönüştürüldüğünü gösterir. Hedeflediğimiz dönüşüm buydu! Şimdi normalizasyonda yaptığımız adımları izleyerek standardizasyonu (Z-skor normalizasyonu) uygulayacağız:
X_train_s = X_train.copy()
X_test_s = X_test.copy()

# Fit the standardization scaler onto the training data
stan = StandardScaler().fit(X_train_s)

# Transform the training data
X_train_stan = stan.transform(X_train_s)

# Use the same scaler to transform the testing set
X_test_stan = stan.transform(X_test_s)

     	# Convert the transformed data into pandas dataframe
X_train_stan_df = pd.DataFrame(X_train_stan)

     	# Assigning original feature names for ease of read
X_train_stan_df.columns = iris.feature_names

     	# Check out the statistical description
X_train_stan_df.describe()
Bu, standardizasyon için aşağıdaki sonucu verir:
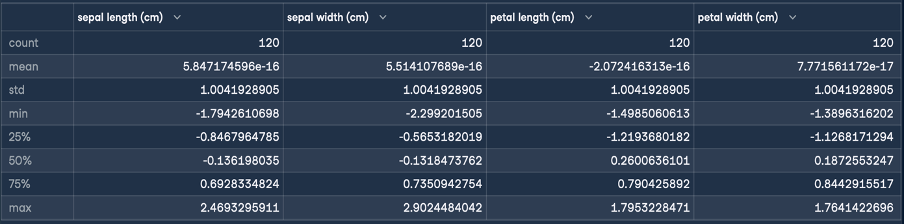
Z-normalizasyonunun amacı, bir özelliğin değerlerini ortalaması 0 ve standart sapması 1 olacak şekilde dönüştürmektir. Oluşturulan veri çerçevesinin açıklamasından da görebileceğiniz gibi, dört özelliğin tamamı için ortalama sıfıra yakın küçük bir sayı ve standart sapma 1'dir.
Artık bu dönüştürülmüş veriyi alıp bir makine öğrenimi algoritmasına eğitim için verebiliriz.
Bu yazıda, min-maks ölçekleme, Z-normalizasyonu, ondalık ölçekleme ve log ölçekleme normalizasyonlarını inceledik. Her bir teknik kendi benzersiz güçlü yönlerini ve kullanım alanlarını ortaya koydu. Normalizasyon yaparken karşılaşılan bazı yaygın tuzaklar ve en iyi uygulamalar hakkında da okudunuz. Son olarak, bu yeni edindiğimiz bilgilerin bir kısmını scikit-learn ile uygulayarak noktaladık.
Ele aldığımız kavram ve süreçler hakkında daha fazla bilgi edinmek için Python ile Makine Öğrenimi için Özellik Mühendisliği ve Textacy: Python'da Metin Verisi Temizleme ve Normalizasyona Giriş kurslarımıza göz atın.
Makine Öğrenimi Öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



