
Cursus
Machine Learning met boomgebaseerde modellen in Python
5 uur
119.7K
In machine learning staat het succes van modellen op het fundament van de kwaliteit van de data waarop ze zijn getraind. Terwijl de spotlights vaak schijnen op complexe, geavanceerde algoritmen en modellen, is de onbezongen held vaak de datapreprocessing. Datapreprocessing is een belangrijke stap die ruwe data omzet in features die vervolgens worden gebruikt voor effectieve machine learning.
Machinelearning-algoritmen worden vaak getraind met de aanname dat alle features evenveel bijdragen aan de uiteindelijke voorspelling. Die aanname gaat echter niet op wanneer features verschillen in bereik en eenheid, waardoor hun belangrijkheid wordt beïnvloed.
Daar komt normalisatie om de hoek kijken – een cruciale stap in datapreprocessing die zorgt voor uniformiteit in de numerieke grootten van features. Deze uniformiteit voorkomt dat features met grotere waarden de overhand krijgen ten opzichte van andere features of variabelen.
In dit artikel duiken we in normalisatie, een techniek voor feature scaling die helpt om de verhoudingen tussen features in balans te brengen.
Normalisatie is een specifieke vorm van feature scaling die het bereik van features transformeert naar een standaardschaal. Normalisatie en elke andere vorm van dataschaling is alleen nodig wanneer je dataset features met uiteenlopende bereiken bevat. Normalisatie omvat diverse technieken die zijn afgestemd op verschillende datadistributies en modelvereisten.
Normalisatie is niet beperkt tot alleen numerieke data. In dit artikel richten we ons echter op numerieke voorbeelden. Bekijk zeker Datacamp’s Textacy: Een introductie tot het opschonen en normaliseren van tekstdata in Python als je van plan bent preprocessing uit te voeren op tekstdata voor machine learning.
Genormaliseerde data verbetert de modelprestaties en verhoogt de nauwkeurigheid van een model. Het helpt algoritmen die vertrouwen op afstandsmaatstaven, zoals k-nearest neighbors of support vector machines, door te voorkomen dat features met grotere schalen het leerproces domineren.
Normalisatie bevordert stabiliteit in het optimalisatieproces en zorgt voor snellere convergentie tijdens op gradiënt gebaseerde training. Het verzacht problemen met verdwijnende of exploderende gradiënten, waardoor modellen efficiënter optimale oplossingen bereiken.
Genormaliseerde data is ook makkelijker te interpreteren en dus eenvoudiger te begrijpen. Wanneer alle features van een dataset op dezelfde schaal staan, wordt het bovendien makkelijker om relaties tussen verschillende features te identificeren en te visualiseren en zinvolle vergelijkingen te maken.
Laten we een eenvoudig voorbeeld nemen om het belang van normalisatie te benadrukken. We proberen woningprijzen te voorspellen op basis van diverse features zoals woonoppervlak, aantal slaapkamers en afstand tot de supermarkt, enzovoort. De dataset bevat uiteenlopende features met verschillende schalen, zoals:
Als je deze data zonder enige preprocessing direct aan een machinelearningmodel voert, kan het algoritme meer gewicht geven aan features met grote schalen, zoals woonoppervlak. Tijdens de training gaat het algoritme ervan uit dat een verandering in totaal woonoppervlak een aanzienlijke impact heeft op woningprijzen. Het algoritme kan de nuances van relatief kleine features, zoals het aantal slaapkamers en de afstand tot de supermarkt, over het hoofd zien. Deze scheve nadruk kan leiden tot suboptimale modelprestaties en bevooroordeelde voorspellingen.
Door de features te normaliseren zorgen we ervoor dat elke feature evenredig bijdraagt aan het leerproces van het model. Het model kan nu effectiever patronen over alle features heen leren, wat leidt tot een nauwkeurigere weergave van de onderliggende relaties in de data.
Min-max-scaling en Z-score-normalisatie (standaardisatie) zijn de twee fundamentele technieken voor normalisatie. Daarnaast bespreken we ook decimale schaalnormalisatie, log-schaalnormalisatie en robuuste schaling, die elk unieke uitdagingen in datapreprocessing aanpakken.
Min-max-scaling wordt vaak simpelweg ‘normalisatie’ genoemd. Het transformeert features naar een opgegeven bereik, meestal tussen 0 en 1. De formule voor min-max-scaling is:
Xgenormaliseerd = X – Xmin / Xmax – Xmin
Waarbij X een willekeurige featurewaarde is die moet worden genormaliseerd. Xmin is de minimale featurewaarde in de dataset en Xmax is de maximale featurewaarde.
Min-max-scaling is een goede keuze wanneer:
Z-score-normalisatie (standaardisatie) gaat uit van een Gaussiaanse (klokvormige) verdeling van de data en transformeert features zodat ze een gemiddelde (μ) van 0 en een standaarddeviatie (σ) van 1 hebben. De formule voor standaardisatie is:
Xgestandaardiseerd = X−μ / σ
Deze techniek is bijzonder nuttig bij algoritmen die uitgaan van normaal verdeelde data, zoals veel lineaire modellen. In tegenstelling tot min-max-scaling worden featurewaarden bij standaardisatie niet beperkt tot een specifiek bereik. Deze normalisatietechniek drukt features in feite uit in het aantal standaarddeviaties dat ze van het gemiddelde afliggen.
Voordat we ingaan op andere datatransformatietechnieken, vergelijken we normalisatie (min-max-scaling) en standaardisatie.
|
Normalisatie |
Standaardisatie |
|
Doel is om de waarden van een feature binnen een specifiek bereik te brengen, vaak tussen 0 en 1 |
Doel is om de waarden van een feature te transformeren naar een gemiddelde van 0 en een standaarddeviatie van 1 |
|
Gevoelig voor uitbijters en het bereik van de data |
Minder gevoelig voor uitbijters door gebruik van gemiddelde en standaarddeviatie |
|
Nuttig wanneer het behoud van het oorspronkelijke bereik essentieel is |
Effectief wanneer algoritmen uitgaan van een standaardnormale verdeling |
|
Er wordt geen aanname gedaan over de distributie van de data |
Gaat uit van een normale verdeling of een benadering daarvan |
|
Geschikt voor algoritmen waarbij de absolute waarden en hun verhoudingen belangrijk zijn (bijv. k-nearest neighbors, neurale netwerken) |
Met name nuttig voor algoritmen die uitgaan van normaal verdeelde data, zoals lineaire regressie en support vector machines |
|
Behouden van de interpreteerbaarheid van de oorspronkelijke waarden binnen het opgegeven bereik |
Verandert de oorspronkelijke waarden, waardoor interpretatie lastiger wordt door de verschuiving in schaal en eenheden |
|
Kan leiden tot snellere convergentie, vooral bij algoritmen die op gradiëntafdaling steunen |
Draagt ook bij aan snellere convergentie, met name bij algoritmen die gevoelig zijn voor de schaal van inputfeatures |
|
Use cases: beeldverwerking, neurale netwerken, algoritmen die gevoelig zijn voor featureschalen |
Use cases: lineaire regressie, support vector machines, algoritmen die uitgaan van een normale verdeling |
Het doel van decimale schaalnormalisatie is om de featurewaarden met een macht van 10 te schalen, zodat de grootste absolute waarde in elke feature kleiner wordt dan 1. Dit is nuttig wanneer het waardebereik in een dataset bekend is, maar het bereik per feature verschilt. De formule voor decimale schaalnormalisatie is:
Xdecimaal = X / 10d
Waarbij X de oorspronkelijke featurewaarde is en d het kleinste gehele getal is zodanig dat de grootste absolute waarde in de feature kleiner wordt dan 1.
Als de grootste absolute waarde in een feature bijvoorbeeld 3500 is, dan is d gelijk aan 3 en wordt de feature geschaald door 103.
Decimale schaalnormalisatie is voordelig bij datasets waarbij de absolute orde van grootte belangrijker is dan de specifieke schaal.
Log-schaalnormalisatie zet data om naar een logaritmische schaal door van elk datapunt de log te nemen. Dit is met name nuttig bij data die zich over meerdere ordes van grootte uitstrekt. De formule voor log-schaalnormalisatie is:
Xlog = log(X)
Deze normalisatie is handig bij data die een exponentieel groei- of afnamepatroon volgt. Ze comprimeert de schaal van de dataset, waardoor modellen gemakkelijker patronen en relaties in de data kunnen vastleggen. Bevolkingsomvang door de jaren heen is een goed voorbeeld van een dataset waarin sommige features exponentiële groei vertonen. Log-schaalnormalisatie kan deze features beter modelleerbaar maken.
Robuuste schaling is nuttig bij datasets met uitbijters. Het gebruikt de mediaan en de interkwartielafstand (IQR) in plaats van het gemiddelde en de standaarddeviatie om uitbijters te hanteren. De formule voor robuuste schaling is:
Xrobuust = X – mediaan/ IQR
Omdat robuuste schaling bestand is tegen de invloed van uitbijters, is het geschikt voor datasets met scheve of afwijkende waarden.
We hebben besproken wat normalisatie is en waarom het nuttig is in machine learning. Hoewel krachtig, is normalisatie niet zonder uitdagingen. Van het omgaan met uitbijters tot het kiezen van de meest geschikte techniek op basis van je dataset: het aanpakken van deze punten is essentieel om het volledige potentieel van je machinelearningmodel te benutten.
Uitbijters zijn datapunten in je dataset die sterk afwijken van de norm en de effectiviteit van normalisatietechnieken verstoren. Als je uitbijters in je data niet aanpakt, kunnen ze leiden tot scheve transformaties. Je kunt de eerder besproken techniek voor robuuste schaling gebruiken om met uitbijters om te gaan.
Een andere strategie is trimmen of winsoriseren, waarbij we alle featurewaarden boven (of onder) een bepaalde waarde identificeren en respectievelijk afkappen of begrenzen tot een vaste waarde.
We hebben de meest bruikbare normalisatietechnieken besproken, maar er zijn er nog veel meer om uit te kiezen. De juiste techniek selecteren vereist een genuanceerd begrip van de dataset. Tijdens datapreprocessing moet je meerdere normalisatietechnieken proberen en hun impact op de modelprestaties beoordelen. Door te experimenteren kun je zien hoe elke methode het leerproces beïnvloedt.
Je moet een diep begrip krijgen van de kenmerken van de data. Overweeg of de aannames van een specifieke normalisatietechniek aansluiten bij de distributie en patronen in de dataset.
Normaliseren kan lastig zijn bij sparse data, waarbij veel featurewaarden nul zijn. Het direct toepassen van standaard normalisatietechnieken kan tot onbedoelde gevolgen leiden. Er bestaan varianten van de hierboven besproken technieken die specifiek voor sparse data zijn ontworpen, zoals ‘sparse min-max-scaling.’
Overweeg vóór normalisatie om ontbrekende waarden in je dataset te imputeren of te behandelen. Dit is vaak een van de eerste stappen wanneer je je dataset verkent en schoonmaakt voor gebruik in machinelearningmodellen.
Bekijk zeker DataCamp’s cursus Feature Engineering for Machine Learning, waarin je hands-on leert hoe je elke dataset voorbereidt voor je eigen machinelearningmodellen. In de cursus werk je met de Stack Overflow Developers-enquête en historische Amerikaanse inaugurale toespraken van presidenten om te begrijpen hoe je features het beste preprocesst en opstelt uit categorische, continue en ongestructureerde data.
In machine learning treedt overfitting op wanneer een model niet alleen de onderliggende patronen in de trainingsdata leert, maar ook ruis en willekeurige fluctuaties oppikt. Dit kan leiden tot een model dat uitzonderlijk goed presteert op de trainingsdata, maar niet generaliseert naar nieuwe, ongeziene data.
Normalisatie op zichzelf veroorzaakt mogelijk geen overfitting. Maar wanneer normalisatie wordt gecombineerd met andere factoren, zoals modelcomplexiteit of onvoldoende regularisatie, kan het bijdragen aan overfitting. Wanneer normalisatieparameters worden berekend met de volledige dataset (inclusief validatie- of testsets), kan datalek optreden. Het model kan onbedoeld informatie leren uit de validatie- of testsets, wat het generaliserend vermogen ondermijnt.
Om het risico op overfitting te beperken, normaliseer je daarom de trainingsset en pas je dezelfde normalisatieparameters toe op de validatie- en testsets. Zo leert het model te generaliseren op basis van de trainingsdata zonder beïnvloed te worden door informatie in de validatie- of testsets.
Implementeer passende regularisatietechnieken om te complexe modellen te bestraffen. Regularisatie helpt voorkomen dat het model ruis in de trainingsdata gaat fitten. Gebruik geschikte validatietechnieken, zoals cross-validatie, om de prestaties van het model op ongeziene data te beoordelen. Als tijdens de validatie overfitting wordt geconstateerd, kun je bijsturen, bijvoorbeeld door de modelcomplexiteit te verlagen of de regularisatie te verhogen.
Scikit-learn is een veelzijdige Python-bibliotheek die is ontworpen om de complexiteit van machine learning te vereenvoudigen. Het biedt een rijk arsenaal aan tools en functionaliteit voor datapreprocessing, featureselectie, dimensionale reductie, het bouwen en trainen van modellen, modelevaluatie, hyperparametertuning, modelserialisatie, pipeline-constructie, enzovoort. Het modulaire ontwerp stimuleert experimenteren en verkennen, waardoor gebruikers naadloos kunnen overstappen van basisconcepten naar geavanceerde methodologieën.
We gebruiken scikit-learn om in de praktijk te brengen wat we hebben geleerd. We gebruiken de klassieke en veelgebruikte `Iris-dataset.` Deze dataset werd in 1936 geïntroduceerd door de Britse bioloog en statisticus Ronald A. Fisher. De Iris-dataset bevat metingen van vier features van drie verschillende soorten irisbloemen: setosa, versicolor en virginica.
Voor elke bloem zijn vier features gemeten: kelklengte, kelkbreedte, kroonbladlengte en kroonbladbreedte – allemaal in centimeters. De dataset bevat 150 instanties (samples), met 50 samples van elk van de drie soorten. De Iris-dataset wordt meestal gebruikt voor classificatietaken, waarbij het doel is om de juiste soort te voorspellen uit de drie klassen. Vandaag gebruiken we deze dataset echter om de transformatie van de data te laten zien bij toepassing van normalisatie (min-max-scaling) en standaardisatie.
Je kunt de hieronder besproken Python-code uitvoeren in Datacamp’s workspace om de dataset zelf te verkennen.
Laten we beginnen met het importeren van de libraries die we nodig hebben….
import numpy as np
import pandas as pd
# To import the dataset
from sklearn.datasets import load_iris
# To be used for splitting the dataset into training and test sets
from sklearn.model_selection import train_test_split
# To be used for min-max normalization
from sklearn.preprocessing import MinMaxScaler
# To be used for Z-normalization (standardization)
from sklearn.preprocessing import StandardScaler

# Load the iris dataset from Scikit-learn package
iris = load_iris()

# This prints a summary of the characteristics, statistics of the dataset
print(iris.DESCR)

# Divide the data into features (X) and target (Y)
# Data is converted to a panda’s dataframe
X = pd.DataFrame(iris.data)

# Separate the target attribute from rest of the data columns
Y = iris.target

# Take a look at the dataframe
X.head()

# This prints the shape of the dataframe (150 rows and 4 columns)
X.shape()
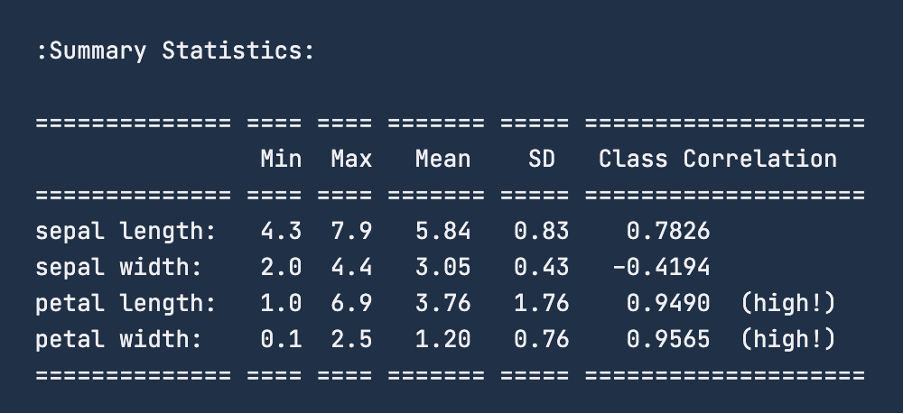
Wanneer je de samenvattende statistieken voor de data bekijkt met print(iris.DESCR), krijg je onderstaande samenvatting. Voor de feature ‘kelklengte’ is het bereik 4,3 – 7,9 centimeter. Evenzo is voor ‘kelkbreedte’ het bereik 2 – 4,4 centimeter. Voor ‘kroonbladlengte’ is het bereik 1 – 6,9 centimeter en tot slot is voor ‘kroonbladbreedte’ het bereik 0,1 – 2,5 centimeter.
Voordat we normalisatie toepassen, is het goed gebruik om de dataset op te splitsen in trainings- en testsets. We gebruiken de functionaliteit train_test_split uit sklearn.model_selection om dat te doen. We maken geen validatieset omdat we in deze oefening geen daadwerkelijk machinelearningmodel gaan trainen. We maken een 80-20-splitsing van de dataset, wat betekent dat de trainingsset 120 rijen bevat en de testset de overige 30 datapunten.
# To divide the dataset into training and test sets

X_train, X_test, y_train, y_test = train_test_split(X, Y ,test_size=0.2)
Een gebruikelijke stap na het laden en opsplitsen van de data in een train-test-set is het uitvoeren van datacleaning, imputatie voor ontbrekende waarden en het aanpakken van uitbijters. Omdat dit artikel zich richt op normalisatie, slaan we deze preprocessingstappen over en gaan we direct kijken naar normalisatie in actie.
We transformeren deze data nu naar het bereik 0 – 1 centimeter met behulp van min-max-normalisatie. Om de data te normaliseren gebruiken we de functionaliteit MinMaxScaler uit de sklearn-bibliotheek en passen die toe op onze dataset; we hebben de benodigde libraries al eerder geïmporteerd.
# Good practice to keep original dataframes untouched for reusability
X_train_n = X_train.copy()
X_test_n = X_test.copy()

# Fit min-max scaler on training data
norm = MinMaxScaler().fit(X_train_n)

# Transform the training data
X_train_norm = norm.transform(X_train_n)

# Use the same scaler to transform the testing set
X_test_norm = norm.transform(X_test_n)
We kunnen de trainingsdata afdrukken om de transformatie te zien. Laten we de set echter eerst omzetten naar een pandas-dataframe en vervolgens de statistische beschrijving bekijken met de functionaliteit describe().
X_train_norm_df = pd.DataFrame(X_train_norm)

     	# Assigning original feature names for ease of read
X_train_norm_df.columns = iris.feature_names

X_train_norm_df.describe()
Dit levert het volgende resultaat op voor normalisatie:
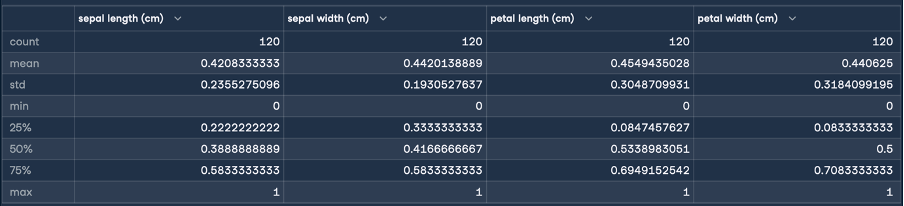
Hier geven de min- en max-statistieken aan dat de bereiken van de features allemaal zijn getransformeerd naar een bereik van 0 – 1 centimeter. Dit is precies de transformatie waar we op mikten! We voeren nu standaardisatie (Z-score-normalisatie) uit door dezelfde stappen te volgen als bij normalisatie:
X_train_s = X_train.copy()
X_test_s = X_test.copy()

# Fit the standardization scaler onto the training data
stan = StandardScaler().fit(X_train_s)

# Transform the training data
X_train_stan = stan.transform(X_train_s)

# Use the same scaler to transform the testing set
X_test_stan = stan.transform(X_test_s)

     	# Convert the transformed data into pandas dataframe
X_train_stan_df = pd.DataFrame(X_train_stan)

     	# Assigning original feature names for ease of read
X_train_stan_df.columns = iris.feature_names

     	# Check out the statistical description
X_train_stan_df.describe()
Dit levert het volgende resultaat op voor standaardisatie:
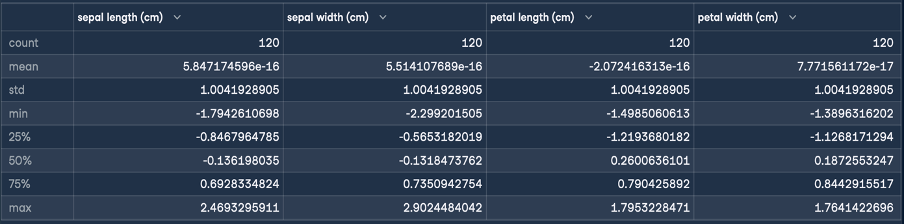
Het doel van Z-normalisatie is om de waarden van een feature te transformeren naar een gemiddelde van 0 en een standaarddeviatie van 1. Zoals je in de beschrijving van het dataframe ziet, is het gemiddelde voor alle vier de features een klein getal dicht bij nul en is de standaarddeviatie 1.
We kunnen deze getransformeerde data nu voeden aan een machinelearningalgoritme voor training.
In dit artikel hebben we min-max-scaling, Z-normalisatie, decimale schaal en log-schaalnormalisaties doorgenomen. Elke techniek liet zijn unieke sterke punten en bruikbaarheid zien. Je las ook over enkele veelvoorkomende valkuilen en best practices bij het uitvoeren van normalisatie. Tot slot hebben we een deel van deze nieuwe kennis toegepast met scikit-learn.
Wil je meer leren over de concepten en processen die we hebben behandeld? Bekijk dan onze cursussen Feature Engineering for Machine Learning in Python en Textacy: An Introduction to Text Data Cleaning and Normalization in Python.
Leer machine learning!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

