
कोर्स
Python में Tree-Based Models के साथ Machine Learning
5 घंटा
119.3K
मशीन लर्निंग में सफल मॉडलों की बुनियाद उस डेटा की गुणवत्ता पर टिकी होती है जिस पर उन्हें प्रशिक्षित किया जाता है। जहां अक्सर जटिल, परिष्कृत एल्गोरिदम और मॉडलों पर रोशनी पड़ती है, वहीं असली नायक प्रायः डेटा प्रीप्रोसेसिंग होता है। डेटा प्रीप्रोसेसिंग वह महत्वपूर्ण चरण है जो कच्चे डेटा को ऐसे फीचर्स में बदलता है जिनका उपयोग प्रभावी मशीन लर्निंग के लिए किया जाता है।
मशीन लर्निंग एल्गोरिदम अक्सर यह मानकर प्रशिक्षित किए जाते हैं कि सभी फीचर अंतिम भविष्यवाणी में समान रूप से योगदान करते हैं। हालांकि, जब फीचर्स की रेंज और इकाई अलग-अलग होती हैं, तो यह मान्यता विफल हो जाती है और उनकी महत्ता प्रभावित होती है।
यहीं आता है नॉर्मलाइज़ेशन – डेटा प्रीप्रोसेसिंग का एक अहम चरण जो फीचर्स के संख्यात्मक परिमाणों में समानता सुनिश्चित करता है। यह समानता बड़े मान वाले फीचर्स को अन्य फीचर्स या वेरिएबल्स पर हावी होने से रोकती है।
इस लेख में, हम नॉर्मलाइज़ेशन पर गहराई से नज़र डालेंगे—एक फीचर स्केलिंग तकनीक जो फीचर्स के तराजू को संतुलित करने का मार्ग प्रदान करती है।
नॉर्मलाइज़ेशन फीचर स्केलिंग का एक विशिष्ट रूप है जो फीचर्स की रेंज को एक मानक स्केल में बदल देता है। नॉर्मलाइज़ेशन, और सामान्यतः कोई भी डेटा स्केलिंग तकनीक, तभी आवश्यक है जब आपके डेटासेट में फीचर्स की रेंजें अलग-अलग हों। नॉर्मलाइज़ेशन में विभिन्न डेटा वितरणों और मॉडल आवश्यकताओं के अनुरूप विविध तकनीकें शामिल हैं।
नॉर्मलाइज़ेशन सिर्फ संख्यात्मक डेटा तक सीमित नहीं है। हालांकि, इस लेख में हम संख्यात्मक उदाहरणों पर ही ध्यान देंगे। यदि आप मशीन लर्निंग के लिए टेक्स्ट डेटा पर प्रीप्रोसेसिंग करने की योजना बना रहे हैं, तो अवश्य देखें Datacamp का Textacy: Python में टेक्स्ट डेटा क्लीनिंग और नॉर्मलाइज़ेशन का परिचय ट्यूटोरियल।
नॉर्मलाइज़ किया हुआ डेटा मॉडल के प्रदर्शन को बढ़ाता है और सटीकता में सुधार करता है। यह दूरी-आधारित मेट्रिक्स पर निर्भर एल्गोरिदम, जैसे k-nearest neighbors या support vector machines, की सहायता करता है, ताकि बड़े स्केल वाले फीचर्स सीखने की प्रक्रिया पर हावी न हों।
नॉर्मलाइज़ेशन अनुकूलन प्रक्रिया में स्थिरता लाता है, जिससे ग्रेडिएंट-आधारित प्रशिक्षण के दौरान तेज अभिसरण को बढ़ावा मिलता है। यह वैनिशिंग या एक्सप्लोडिंग ग्रेडिएंट्स से संबंधित समस्याओं को कम करता है, जिससे मॉडल अधिक कुशलता से इष्टतम समाधानों तक पहुँच पाते हैं।
नॉर्मलाइज़ किया गया डेटा व्याख्यायित करना भी आसान होता है, इसलिए समझना सरल हो जाता है। जब किसी डेटासेट के सभी फीचर्स एक ही स्केल पर हों, तो विभिन्न फीचर्स के बीच संबंधों की पहचान और विज़ुअलाइज़ करना तथा सार्थक तुलना करना भी आसान हो जाता है।
आइए डेटा को नॉर्मलाइज़ करने के महत्व को रेखांकित करने के लिए एक सरल उदाहरण लेते हैं। हम विभिन्न फीचर्स जैसे स्क्वेयर फुटेज, बेडरूम की संख्या और सुपरमार्केट की दूरी आदि के आधार पर घर की कीमतों का पूर्वानुमान लगाने की कोशिश कर रहे हैं। डेटासेट में अलग-अलग स्केल वाले विविध फीचर्स शामिल हैं, जैसे:
जब आप इस डेटा को बिना किसी प्रीप्रोसेसिंग के सीधे मशीन लर्निंग मॉडल में देते हैं, तो एल्गोरिदम बड़े स्केल वाले फीचर्स, जैसे स्क्वेयर फुटेज, को अधिक वज़न दे सकता है। प्रशिक्षण के दौरान एल्गोरिदम मान सकता है कि कुल स्क्वेयर फुटेज में बदलाव का घर की कीमतों पर अधिक प्रभाव पड़ेगा। एल्गोरिदम अपेक्षाकृत छोटे फीचर्स, जैसे बेडरूम की संख्या और सुपरमार्केट की दूरी, की बारीकियों को नज़रअंदाज़ कर सकता है। यह तिरछा ज़ोर उप-इष्टतम प्रदर्शन और पक्षपाती भविष्यवाणियों का कारण बन सकता है।
फीचर्स को नॉर्मलाइज़ करके, हम सुनिश्चित कर सकते हैं कि प्रत्येक फीचर मॉडल की सीखने की प्रक्रिया में आनुपातिक रूप से योगदान दे। अब मॉडल सभी फीचर्स में पैटर्न अधिक प्रभावी ढंग से सीख सकता है, जिससे डेटा में अंतर्निहित संबंधों का अधिक सटीक निरूपण होता है।
मिन-मैक्स स्केलिंग और Z-स्कोर नॉर्मलाइज़ेशन (स्टैंडर्डाइज़ेशन) नॉर्मलाइज़ेशन की दो बुनियादी तकनीकें हैं। इनके अलावा, हम दशमलव स्केलिंग नॉर्मलाइज़ेशन, लॉग स्केलिंग नॉर्मलाइज़ेशन और रोबस्ट स्केलिंग पर भी चर्चा करेंगे, जो डेटा प्रीप्रोसेसिंग की विशिष्ट चुनौतियों को संबोधित करती हैं।
मिन-मैक्स स्केलिंग को अक्सर सरलता से ‘नॉर्मलाइज़ेशन’ भी कहा जाता है। यह फीचर्स को एक निर्दिष्ट रेंज में बदलता है, जो प्रायः 0 और 1 के बीच होती है। मिन-मैक्स स्केलिंग का सूत्र है:
Xnormalized = X – Xmin / Xmax – Xmin
जहां X वह यादृच्छिक फीचर मान है जिसे नॉर्मलाइज़ करना है। Xmin डेटासेट में न्यूनतम फीचर मान है, और Xmax अधिकतम फीचर मान है।
मिन-मैक्स स्केलिंग तब एक अच्छा विकल्प है जब:
Z-स्कोर नॉर्मलाइज़ेशन (स्टैंडर्डाइज़ेशन) डेटा के गौसियन (घंटी आकार) वितरण को मानकर फीचर्स को इस प्रकार रूपांतरित करता है कि उनका माध्य (μ) 0 और मानक विचलन (σ) 1 हो। स्टैंडर्डाइज़ेशन का सूत्र है:
Xstandardized = X−μ / σ
यह तकनीक विशेष रूप से तब उपयोगी होती है जब ऐसे एल्गोरिदम से निपटना हो जो सामान्य वितरण वाले डेटा को मानते हैं, जैसे कई रैखिक मॉडल। मिन-मैक्स स्केलिंग तकनीक के विपरीत, स्टैंडर्डाइज़ेशन में फीचर मान किसी विशेष रेंज तक सीमित नहीं होते। यह नॉर्मलाइज़ेशन तकनीक मूलतः फीचर्स को उस मानक विचलनों की संख्या के रूप में दर्शाती है, जितना वे माध्य से दूर हैं।
अन्य डेटा ट्रांसफॉर्मेशन तकनीकों में उतरने से पहले, आइए नॉर्मलाइज़ेशन (मिन-मैक्स स्केलिंग) और स्टैंडर्डाइज़ेशन की तुलना कर लें।
|
नॉर्मलाइज़ेशन |
स्टैंडर्डाइज़ेशन |
|
उद्देश्य किसी फीचर के मानों को एक विशिष्ट रेंज, प्रायः 0 से 1 के बीच, में लाना है |
उद्देश्य किसी फीचर के मानों को इस प्रकार रूपांतरित करना है कि उनका माध्य 0 और मानक विचलन 1 हो |
|
आउटलायर्स और डेटा रेंज के प्रति संवेदनशील |
माध्य और मानक विचलन के उपयोग के कारण आउटलायर्स के प्रति कम संवेदनशील |
|
जब मूल रेंज को बनाए रखना आवश्यक हो, तब उपयोगी |
जब एल्गोरिदम मानक सामान्य वितरण मानते हैं, तब प्रभावी |
|
डेटा के वितरण के बारे में कोई मान्यता नहीं ली जाती |
सामान्य वितरण या उसके निकट होने की मान्यता लेता है |
|
उन एल्गोरिदम के लिए उपयुक्त जहां परिमाणात्मक मान और उनके संबंध महत्वपूर्ण हैं (जैसे, k-nearest neighbors, न्यूरल नेटवर्क) |
विशेष रूप से उन एल्गोरिदम के लिए उपयोगी जो सामान्य वितरण वाले डेटा को मानते हैं, जैसे रैखिक प्रतिगमन और सपोर्ट वेक्टर मशीन |
|
निर्दिष्ट रेंज के भीतर मूल मानों की व्याख्येयता बनाए रखता है |
मूल मानों को बदल देता है, जिससे स्केल और इकाइयों में बदलाव के कारण व्याख्या अधिक चुनौतीपूर्ण हो जाती है |
|
तेज़ अभिसरण का कारण बन सकता है, विशेषकर उन एल्गोरिदम में जो ग्रेडिएंट डिसेंट पर निर्भर होते हैं |
इनपुट फीचर्स के स्केल के प्रति संवेदनशील एल्गोरिदम में विशेष रूप से तेज़ अभिसरण में योगदान देता है |
|
उपयोग के मामले: इमेज प्रोसेसिंग, न्यूरल नेटवर्क, फीचर स्केल के प्रति संवेदनशील एल्गोरिदम |
उपयोग के मामले: रैखिक प्रतिगमन, सपोर्ट वेक्टर मशीन, सामान्य वितरण मानने वाले एल्गोरिदम |
दशमलव स्केलिंग नॉर्मलाइज़ेशन का उद्देश्य फीचर मानों को 10 की किसी घात से स्केल करना है, ताकि प्रत्येक फीचर का सबसे बड़ा परिमित मान 1 से कम हो जाए। यह तब उपयोगी है जब डेटासेट में मानों की रेंज ज्ञात हो, लेकिन यह रेंज फीचर्स के बीच भिन्न हो। इसका सूत्र है:
Xdecimal = X / 10d
जहां X मूल फीचर मान है, और d वह सबसे छोटा पूर्णांक है जिससे फीचर का सबसे बड़ा परिमित मान 1 से कम हो जाए।
उदाहरण के लिए, यदि किसी फीचर में सबसे बड़ा परिमित मान 3500 है, तो d = 3 होगा, और फीचर को 103 से स्केल किया जाएगा।
जब उन डेटासेट्स से निपटना हो जहां मानों का निरपेक्ष परिमाण उनके विशिष्ट स्केल से अधिक मायने रखता हो, तब दशमलव स्केलिंग नॉर्मलाइज़ेशन लाभकारी है।
लॉग स्केलिंग नॉर्मलाइज़ेशन प्रत्येक डेटा पॉइंट का लघुगणक लेकर डेटा को लॉगरिदमिक स्केल में बदल देता है। यह विशेष रूप से तब उपयोगी है जब डेटा कई ऑर्डर्स ऑफ मैग्नीट्यूड में फैला हो। इसका सूत्र है:
Xlog = log(X)
यह नॉर्मलाइज़ेशन उन डेटा के साथ सहायक होता है जो घातीय वृद्धि या क्षय पैटर्न का अनुसरण करते हैं। यह डेटासेट के स्केल को संपीड़ित करता है, जिससे मॉडलों के लिए डेटा में पैटर्न और संबंधों को पकड़ना आसान हो जाता है। वर्षों के साथ जनसंख्या आकार ऐसा ही एक उदाहरण है जहां कुछ फीचर्स घातीय वृद्धि दिखाते हैं। लॉग स्केलिंग नॉर्मलाइज़ेशन ऐसे फीचर्स को मॉडलिंग के लिए अधिक अनुकूल बना सकता है।
रोबस्ट स्केलिंग नॉर्मलाइज़ेशन उन डेटासेट्स के साथ उपयोगी है जिनमें आउटलायर्स मौजूद हों। यह आउटलायर्स को संभालने के लिए माध्य के बजाय माध्यिका और इंटरक्वार्टाइल रेंज (IQR) का उपयोग करता है। रोबस्ट स्केलिंग का सूत्र है:
Xrobust = X – median/ IQR
चूंकि रोबस्ट स्केलिंग आउटलायर्स के प्रभाव के प्रति लचीला है, यह तिरछे या असामान्य मानों वाले डेटासेट्स के लिए उपयुक्त है।
हमने नॉर्मलाइज़ेशन और मशीन लर्निंग में इसके उपयोगी होने पर चर्चा की। शक्तिशाली होने के बावजूद, नॉर्मलाइज़ेशन चुनौतियों से मुक्त नहीं है। आउटलायर्स से निपटने से लेकर अपने डेटासेट के आधार पर सबसे उपयुक्त तकनीक चुनने तक—इन मुद्दों को संबोधित करना आपके मशीन लर्निंग मॉडल की पूरी क्षमता खोलने के लिए आवश्यक है।
आउटलायर्स आपके डेटासेट में वे डेटा पॉइंट होते हैं जो सामान्य से काफी भिन्न होते हैं और नॉर्मलाइज़ेशन तकनीकों की प्रभावशीलता को विकृत कर सकते हैं। यदि आप अपने डेटा में आउटलायर्स को नहीं संभालते, तो ये तिरछे रूपांतरणों का कारण बन सकते हैं। आउटलायर्स को संभालने के लिए आप ऊपर चर्चा की गई रोबस्ट स्केलिंग नॉर्मलाइज़ेशन तकनीक का उपयोग कर सकते हैं।
एक और रणनीति ट्रिमिंग या विंसोराइज़िंग लागू करना है, जिसमें हम किसी निश्चित मान से ऊपर (या नीचे) के सभी फीचर मानों की पहचान करते हैं और उन्हें काटते (क्लिप) या सीमाबद्ध (कैप) कर देते हैं।
हमने सबसे उपयोगी नॉर्मलाइज़ेशन तकनीकों पर चर्चा की है, लेकिन चुनने के लिए और भी कई हैं। उपयुक्त तकनीक का चयन करने के लिए डेटासेट की बारीक समझ आवश्यक है। डेटा प्रीप्रोसेसिंग करते समय, आपको कई नॉर्मलाइज़ेशन तकनीकों को आज़माना चाहिए और उनके मॉडल प्रदर्शन पर प्रभाव का आकलन करना चाहिए। प्रयोग आपको यह देखने देता है कि प्रत्येक विधि सीखने की प्रक्रिया को कैसे प्रभावित करती है।
आपको डेटा की विशेषताओं की गहरी समझ हासिल करनी होगी। विचार करें कि क्या किसी विशिष्ट नॉर्मलाइज़ेशन तकनीक की मान्यताएँ डेटासेट में मौजूद वितरण और पैटर्न के साथ मेल खाती हैं।
जब स्पार्स डेटा के साथ काम करना हो जहां कई फीचर मान शून्य हों, तब नॉर्मलाइज़ेशन चुनौतीपूर्ण हो सकता है। मानक नॉर्मलाइज़ेशन तकनीकों को सीधे लागू करने से अनपेक्षित परिणाम हो सकते हैं। ऊपर चर्चा की गई तकनीकों के ऐसे संस्करण मौजूद हैं जो खास तौर पर स्पार्स डेटा के लिए बनाए गए हैं, जैसे ‘स्पार्स मिन-मैक्स स्केलिंग।’
नॉर्मलाइज़ेशन से पहले, अपने डेटासेट में मिसिंग मानों का इम्प्यूटेशन या प्रबंधन करने पर विचार करें। यह अक्सर उन शुरुआती चरणों में से एक होता है जब आप अपने डेटासेट का अन्वेषण और उसे मशीन लर्निंग मॉडलों में उपयोग के लिए साफ करते हैं।
अवश्य देखें DataCamp का Feature Engineering for Machine Learning कोर्स, जो आपको अपने स्वयं के मशीन लर्निंग मॉडलों के लिए किसी भी डेटा को तैयार करने का हाथों-हाथ अनुभव देता है। इस कोर्स में, आप Stack Overflow Developers सर्वे और ऐतिहासिक अमेरिकी राष्ट्रपति शपथ ग्रहण भाषणों के साथ काम करेंगे, ताकि श्रेणीबद्ध, सतत और असंरचित डेटा से फीचर्स को सर्वोत्तम रूप से प्रीप्रोसेस और इंजीनियर करना समझ सकें।
मशीन लर्निंग में ओवरफिटिंग तब होता है जब कोई मॉडल प्रशिक्षण डेटा में अंतर्निहित पैटर्न के साथ-साथ शोर और यादृच्छिक उतार-चढ़ाव भी सीख लेता है। इससे ऐसा मॉडल बन सकता है जो प्रशिक्षण डेटा पर असाधारण प्रदर्शन करता है, पर नए, अनदेखे डेटा पर सामान्यीकरण करने में विफल रहता है।
केवल नॉर्मलाइज़ेशन आमतौर पर ओवरफिटिंग का कारण नहीं बनता। हालांकि, जब नॉर्मलाइज़ेशन अन्य कारकों, जैसे मॉडल की जटिलता या अपर्याप्त रेगुलराइज़ेशन, के साथ मिल जाता है, तो यह ओवरफिटिंग में योगदान कर सकता है। जब नॉर्मलाइज़ेशन के पैरामीटर पूरे डेटासेट (जिसमें वैलिडेशन या टेस्ट सेट भी शामिल हों) का उपयोग करके गणना किए जाते हैं, तो यह डेटा लीकेज का कारण बन सकता है। मॉडल अनजाने में वैलिडेशन या टेस्ट सेट से जानकारी सीख सकता है, जिससे इसकी सामान्यीकरण क्षमता प्रभावित होती है।
इसलिए, ओवरफिटिंग के जोखिम को कम करने के लिए, प्रशिक्षण सेट पर नॉर्मलाइज़ करें और वही नॉर्मलाइज़ेशन पैरामीटर वैलिडेशन और टेस्ट सेट पर लागू करें। इससे सुनिश्चित होता है कि मॉडल प्रशिक्षण डेटा से सामान्यीकरण करना सीखे, बिना वैलिडेशन या टेस्ट सेट की जानकारी से प्रभावित हुए।
आपको अत्यधिक जटिल मॉडलों पर दंड लगाने के लिए उपयुक्त रेगुलराइज़ेशन तकनीकों को लागू करना चाहिए। रेगुलराइज़ेशन प्रशिक्षण डेटा में शोर को फिट होने से रोकने में मदद करता है। अनदेखे डेटा पर मॉडल के प्रदर्शन का आकलन करने के लिए क्रॉस-वैलिडेशन जैसी उपयुक्त वैलिडेशन तकनीकों का उपयोग करें। यदि वैलिडेशन के दौरान ओवरफिटिंग का पता चलता है, तो मॉडल की जटिलता कम करने या रेगुलराइज़ेशन बढ़ाने जैसे समायोजन किए जा सकते हैं।
Scikit-learn एक बहुमुखी Python लाइब्रेरी है जिसे मशीन लर्निंग की जटिलताओं को सरल बनाने के लिए डिज़ाइन किया गया है। यह डेटा प्रीप्रोसेसिंग, फीचर चयन, डायमेंशनलिटी रिडक्शन, मॉडल बनाना और प्रशिक्षित करना, मॉडल मूल्यांकन, हाइपरपैरामीटर ट्यूनिंग, मॉडल सीरियलाइज़ेशन, पाइपलाइन निर्माण आदि के लिए समृद्ध टूल और कार्यक्षमताएँ प्रदान करती है। इसका मॉड्यूलर डिज़ाइन प्रयोग और अन्वेषण को प्रोत्साहित करता है, जिससे उपयोगकर्ता बुनियादी अवधारणाओं से उन्नत कार्यविधियों की ओर सहजता से बढ़ सकते हैं।
हम सीखी हुई बातों को व्यवहार में लाने के लिए scikit-learn का उपयोग करेंगे। हम क्लासिक और व्यापक रूप से उपयोग किए जाने वाले `Iris dataset` का उपयोग करेंगे। यह डेटासेट 1936 में ब्रिटिश जीवविज्ञानी और सांख्यिकीविद Ronald A. Fisher द्वारा प्रस्तुत किया गया था। Iris डेटासेट में तीन अलग-अलग प्रजातियों—setosa, versicolor और virginica—के फूलों के चार फीचर्स के मापन शामिल हैं।
प्रत्येक फूल के लिए चार फीचर्स मापे गए हैं: sepal length, sepal width, petal length और petal width—सभी सेंटीमीटर में। डेटासेट में 150 उदाहरण (नमूने) हैं, प्रत्येक प्रजाति से 50-50 नमूने। Iris डेटासेट आमतौर पर वर्गीकरण कार्यों के लिए उपयोग होता है, जहां लक्ष्य तीन क्लासों में से सही प्रजाति की भविष्यवाणी करना होता है। हालांकि, आज हम इस डेटासेट का उपयोग नॉर्मलाइज़ेशन (मिन-मैक्स स्केलिंग) और स्टैंडर्डाइज़ेशन लागू करने पर डेटा के रूपांतरण को दिखाने के लिए करेंगे।
आप नीचे चर्चा किया गया Python कोड Datacamp के workspace में चलाकर स्वयं डेटासेट का अन्वेषण कर सकते हैं।
आवश्यक लाइब्रेरीज़ आयात करने से शुरू करते हैं….
import numpy as np
import pandas as pd
# To import the dataset
from sklearn.datasets import load_iris
# To be used for splitting the dataset into training and test sets
from sklearn.model_selection import train_test_split
# To be used for min-max normalization
from sklearn.preprocessing import MinMaxScaler
# To be used for Z-normalization (standardization)
from sklearn.preprocessing import StandardScaler

# Load the iris dataset from Scikit-learn package
iris = load_iris()

# This prints a summary of the characteristics, statistics of the dataset
print(iris.DESCR)

# Divide the data into features (X) and target (Y)
# Data is converted to a panda’s dataframe
X = pd.DataFrame(iris.data)

# Separate the target attribute from rest of the data columns
Y = iris.target

# Take a look at the dataframe
X.head()

# This prints the shape of the dataframe (150 rows and 4 columns)
X.shape()
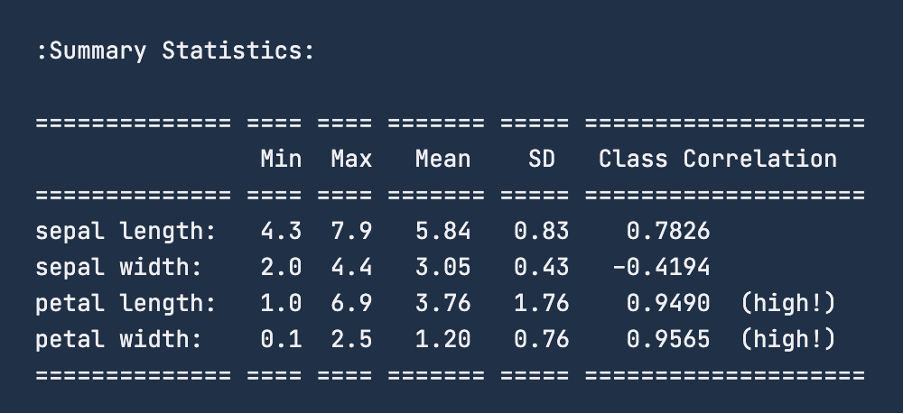
जब आप print(iris.DESCR) का उपयोग करके डेटा के सारांश आँकड़ों की जाँच करते हैं, तो नीचे दी गई छवि जैसा सारांश प्राप्त होगा। फीचर ‘sepal length’ के लिए रेंज 4.3 – 7.9 सेंटीमीटर है। इसी तरह ‘sepal width’ के लिए रेंज 2 – 4.4 सेंटीमीटर है। ‘petal length’ के लिए रेंज 1–6.9 सेंटीमीटर है और अंत में ‘petal width’ के लिए रेंज 0.1 – 2.5 सेंटीमीटर है।
नॉर्मलाइज़ेशन लागू करने से पहले, डेटासेट को प्रशिक्षण और टेस्ट सेट में विभाजित करना अच्छा अभ्यास है। हम ऐसा करने के लिए sklearn.model_selection की train_test_split कार्यक्षमता का उपयोग करेंगे। हम वैलिडेशन सेट अलग नहीं कर रहे हैं क्योंकि इस अभ्यास में हम वास्तविक मशीन लर्निंग मॉडलिंग नहीं करेंगे। हम डेटासेट का 80-20 विभाजन करेंगे, यानी प्रशिक्षण सेट में 120 पंक्तियाँ होंगी और टेस्ट सेट में शेष 30 डेटा पॉइंट्स।
# To divide the dataset into training and test sets

X_train, X_test, y_train, y_test = train_test_split(X, Y ,test_size=0.2)
डेटा लोड करने और उसे प्रशिक्षण-टेस्ट सेट में बाँटने के बाद, सामान्यतः अगला चरण डेटा क्लीनिंग, मिसिंग मानों के लिए इम्प्यूटिंग, और आउटलायर्स को संभालना होता है। हालांकि, चूंकि इस लेख का फोकस नॉर्मलाइज़ेशन है—हम इन प्रीप्रोसेसिंग चरणों को छोड़ते हुए सीधे नॉर्मलाइज़ेशन को कार्रवाई में देखेंगे।
अब हम इस डेटा को मिन-मैक्स नॉर्मलाइज़ेशन तकनीक का उपयोग करके 0 – 1 सेंटीमीटर की रेंज में बदलेंगे। डेटा को नॉर्मलाइज़ करने के लिए, हम sklearn लाइब्रेरी की MinMaxScaler कार्यक्षमता का उपयोग करेंगे और इसे अपने डेटासेट पर लागू करेंगे; आवश्यक लाइब्रेरीज़ हम पहले ही आयात कर चुके हैं।
# Good practice to keep original dataframes untouched for reusability
X_train_n = X_train.copy()
X_test_n = X_test.copy()

# Fit min-max scaler on training data
norm = MinMaxScaler().fit(X_train_n)

# Transform the training data
X_train_norm = norm.transform(X_train_n)

# Use the same scaler to transform the testing set
X_test_norm = norm.transform(X_test_n)
हम प्रशिक्षण डेटा को प्रिंट करके हुए रूपांतरण को देख सकते हैं। हालांकि, पहले सेट को pandas डेटाफ़्रेम में बदलते हैं और फिर describe() कार्यक्षमता का उपयोग करके इसका सांख्यिकीय विवरण देखते हैं।
X_train_norm_df = pd.DataFrame(X_train_norm)

     	# Assigning original feature names for ease of read
X_train_norm_df.columns = iris.feature_names

X_train_norm_df.describe()
नॉर्मलाइज़ेशन के लिए परिणाम इस प्रकार मिलेगा:
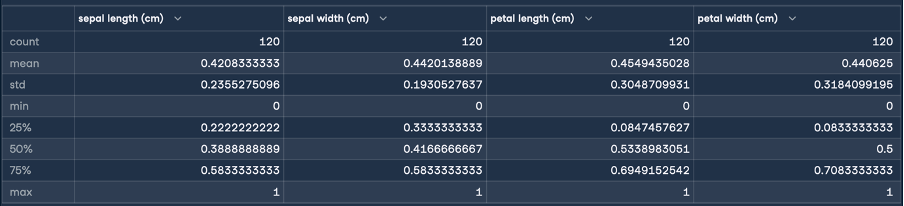
यहां min और max आँकड़े दर्शाते हैं कि सभी फीचर्स की रेंज 0 – 1 सेंटीमीटर में बदल दी गई है। यही वह रूपांतरण था जिसकी हमें तलाश थी! अब हम नॉर्मलाइज़ेशन की तरह ही चरणों का पालन करते हुए स्टैंडर्डाइज़ेशन (Z-स्कोर नॉर्मलाइज़ेशन) करेंगे:
X_train_s = X_train.copy()
X_test_s = X_test.copy()

# Fit the standardization scaler onto the training data
stan = StandardScaler().fit(X_train_s)

# Transform the training data
X_train_stan = stan.transform(X_train_s)

# Use the same scaler to transform the testing set
X_test_stan = stan.transform(X_test_s)

     	# Convert the transformed data into pandas dataframe
X_train_stan_df = pd.DataFrame(X_train_stan)

     	# Assigning original feature names for ease of read
X_train_stan_df.columns = iris.feature_names

     	# Check out the statistical description
X_train_stan_df.describe()
स्टैंडर्डाइज़ेशन के लिए परिणाम इस प्रकार मिलेगा:
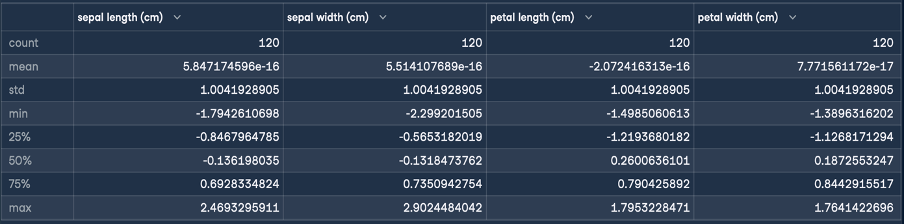
Z-नॉर्मलाइज़ेशन का उद्देश्य किसी फीचर के मानों को इस प्रकार बदलना है कि उनका माध्य 0 और मानक विचलन 1 हो। जैसा कि तैयार किए गए डेटाफ़्रेम के वर्णन से दिख रहा है, सभी चार फीचर्स का माध्य शून्य के निकट छोटा मान है और मानक विचलन 1 है।
अब हम इस रूपांतरित डेटा को लेकर किसी मशीन लर्निंग एल्गोरिदम में प्रशिक्षण के लिए दे सकते हैं।
इस लेख में, हमने मिन-मैक्स स्केलिंग, Z-नॉर्मलाइज़ेशन, दशमलव स्केलिंग और लॉग स्केलिंग नॉर्मलाइज़ेशन की यात्रा की। प्रत्येक तकनीक ने अपनी अनूठी ताकत और उपयोगिता दिखाई। आपने नॉर्मलाइज़ेशन करते समय आने वाली कुछ सामान्य गलतियों और सर्वोत्तम प्रथाओं के बारे में भी पढ़ा। अंत में, हमने scikit-learn के साथ इस नयी अर्जित जानकारी के कुछ हिस्सों को लागू करके समापन किया।
जिन अवधारणाओं और प्रक्रियाओं को हमने कवर किया है, उनके बारे में अधिक जानने के लिए हमारे कोर्स देखें: Feature Engineering for Machine Learning in Python और Textacy: An Introduction to Text Data Cleaning and Normalization in Python।
मशीन लर्निंग सीखें!
कोर्स
कोर्स
कोर्स