
Program
Pengembangan Aplikasi Kecerdasan Buatan
21 jam
OpenAI’s o4-mini adalah tambahan terbaru untuk seri o yang berfokus pada penalaran. Dalam tutorial ini, saya akan memandu Anda membangun sebuah peninjau makalah penelitian menggunakan API o4-mini dari OpenAI. Alat ini akan:
Kita juga akan melengkapi asisten ulasan kita dengan dukungan alat statistik, sehingga model dapat menghitung p-value, ukuran efek, dan interval kepercayaan sesuai kebutuhan.
Kami menjaga pembaca tetap mendapat informasi terbaru seputar AI melalui The Median, buletin Jumat gratis kami yang merangkum cerita kunci mingguan. Berlangganan dan tetap tajam hanya dalam beberapa menit setiap minggu:
o4-mini dari OpenAI adalah model penalaran berkinerja tinggi dan hemat biaya yang mampu melakukan analisis mendalam untuk tugas-tugas seperti pemrograman, matematika, dan penalaran ilmiah. Meskipun lebih kecil daripada model o3, model ini secara konsisten meraih hasil terdepan di berbagai tolok ukur seperti AIME 2024/2025 dan GPQA.
Berkat kecepatan dan keterjangkauannya, model ini ideal untuk tugas seperti meninjau makalah penelitian, menghasilkan penjelasan kode, atau membantu soal matematika kompetitif. Kekuatan utamanya adalah:
Untuk mempelajari lebih lanjut, baca blog pengantar tentang o4-mini.
Kita akan membangun peninjau makalah penelitian berbasis Python yang dapat:
Proyek ini sepenuhnya lokal dan menggunakan API OpenAI.
Untuk menggunakan o4-mini, Anda memerlukan kunci API dari OpenAI. Berikut caranya:
Sekarang, Anda siap melakukan autentikasi dan mulai memanggil API dari Python.
Mari mulai dengan memasang beberapa dependensi dan menyiapkan sebuah variabel lingkungan untuk kunci API kita.
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”Setelah dependensi siap, mari beralih ke fungsi-fungsi pembantu. Fungsi-fungsi ini dipanggil oleh LLM menggunakan pemanggilan alat saat diperlukan.
Impor berikut digunakan untuk menghitung uji t, galat baku, dan interval kepercayaan.
from scipy.stats import ttest_ind, sem, t
import numpy as npFungsi ini melakukan uji t Welch antara dua kelompok sampel independen. Ini menguji hipotesis bahwa rerata kedua kelompok berbeda secara statistik.
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
Fungsi recalculate_p_value() mengembalikan p-value, dibulatkan hingga empat tempat desimal, yang menunjukkan probabilitas bahwa perbedaan yang diamati terjadi secara kebetulan. Ini membantu LLM memvalidasi klaim signifikansi statistik dalam makalah penelitian.
Cohen’s d adalah ukuran terstandar dari ukuran efek antara dua kelompok. Perhitungan dimulai dengan menghitung rerata dan simpangan baku masing-masing kelompok. Lalu menggunakan simpangan baku gabungan untuk menormalkan perbedaan antar rerata.
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
Fungsi ini mengembalikan nilai Cohen’s d, dibulatkan hingga empat tempat desimal. Ini membantu LLM memahami signifikansi praktis (bukan hanya statistik) dari perbedaan kelompok. Hal ini sangat berharga terutama saat ukuran sampel besar dan p-value saja tidak cukup informatif.
Sekarang kita mendefinisikan pembantu untuk menghitung interval kepercayaan bagi satu kelompok sampel. Interval kepercayaan berguna untuk memahami keandalan rerata yang diestimasi—dengan kata lain, seberapa besar ketidakpastian di sekitar nilai rata-rata.
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
Berikut keluaran fungsi ini:
mean: Nilai rata-rata dari data masukan.confidence_interval: Daftar yang merepresentasikan batas bawah dan atas tempat rerata sesungguhnya kemungkinan berada, berdasarkan tingkat kepercayaan yang ditentukan.confidence: Tingkat kepercayaan yang digunakan untuk interval.Kita menutup fungsi pembantu dengan fungsi sederhana yang merangkum rerata, simpangan baku, dan ukuran sampel.
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
Ini membantu LLM menafsirkan distribusi data yang mendasari, menyediakan konteks penting untuk mengevaluasi hasil. Dengan mengekspos deskriptor statistik seperti rerata, simpangan baku, dan jumlah, alat pembantu kita memperkuat kemampuan model untuk menalar eksperimen dan klaim dalam makalah penelitian.
Di bagian ini, kita akan membangun peninjau makalah penelitian berbasis Python yang menggunakan API o4-mini dari OpenAI dan menyertakan dukungan alat untuk analisis statistik, memungkinkan model melakukan evaluasi ketat dan kritik berbasis data.
Kita memulai kode utama dengan beberapa pustaka penting untuk mengekstrak konten PDF, melakukan tokenisasi, dan berkomunikasi dengan OpenAI API.
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
Sekarang mari kita bangun alur lengkapnya langkah demi langkah.
Kita mulai dengan membaca teks mentah dari makalah penelitian. Pustaka fitz memungkinkan kita mengiterasi semua halaman dan menggabungkan teks yang diekstrak menjadi satu string.
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
Ini menjadi fondasi. Kita akan melakukan tokenisasi dan pemecahan (chunking) teks mentah sebelum mengirimkannya ke model.
Catatan: Saya telah membuat makalah penelitian palsu untuk keperluan demo yang sengaja mengandung cacat logika dan rancangan eksperimen.
LLM memiliki batas konteks, jadi kita memecah dokumen panjang menjadi potongan yang dapat dikelola. Kita menggunakan Tiktoken untuk melakukan tokenisasi teks berdasarkan skema pengodean model.
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
Begini cara kerjanya:
tiktoken untuk men-tokenisasi seluruh teks dokumen menggunakan cl100k_base tokenizer, yang kompatibel dengan model OpenAI modern seperti GPT-4, GPT-4o, dan o4-mini.max_tokens. Ini memastikan setiap potongan tetap dalam batas ukuran input maksimum yang diizinkan model, yang penting untuk mencegah galat kelebihan token saat inferensi.encoding.decode(). Ini mempertahankan perumusan dan pemformatan alami sehingga model menerima konteks yang koheren selama pemrosesan.Langkah pemecahan ini penting untuk mencegah pemotongan selama inferensi dan memastikan tidak ada teks penting yang terlewat karena kelebihan beban.
Sebelum model dapat memanggil fungsi eksternal, kita perlu mendefinisikan pemetaan antara nama fungsi (yang terlihat oleh model) dan fungsi Python aktual yang akan dijalankan. Pemetaan ini bertindak sebagai jembatan antara panggilan alat model dan basis kode lokal kita.
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
Setiap kunci dalam kamus ini berkorespondensi dengan nama fungsi yang mungkin dirujuk model saat pemanggilan alat, dan setiap nilai adalah fungsi Python aktual yang diimpor dari modul statistics_helper.
Untuk meningkatkan penalaran model, kita mendaftarkan alat yang dapat dipanggil LLM melalui function calling. Alat-alat ini menangani analisis statistik seperti menghitung ulang p-value, interval kepercayaan, dan ukuran efek.
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
Definisi alat di atas memungkinkan LLM memahami:
description)name)LLM secara cerdas memutuskan kapan memanggil alat, seperti menghitung ulang p-value, berdasarkan konteks ulasan. Ketika menemukan klaim statistik atau hasil yang meragukan, ia dapat memanggil fungsi pembantu yang sesuai, menerima keluarannya, dan melanjutkan penalaran menggunakan hasil tersebut. Ini memungkinkan analisis yang lebih ketat dan berbasis bukti, di mana model tidak hanya mengkritik tetapi juga memverifikasi data yang mendasari.
Sekarang kita mendefinisikan logika inti yang mengirim setiap potongan teks ke model o4-mini. Jika model memanggil alat, kita menangani pemanggilan fungsi dan melanjutkan percakapan.
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
Fungsi review_text_chunk bertanggung jawab mengirim setiap potongan makalah ke LLM, beserta prompt sistem dan registri alat. Berikut cara kerjanya langkah demi langkah:
client.responses.create() yang memanfaatkan Responses API untuk penalaran. Dalam panggilan ini:
"o4-mini", dan flag reasoning={"effort": "high"} disetel tinggi, yang mendorong penalaran internal multi-langkah yang detail. Pengaturan ini memberi tahu model seberapa dalam ia harus “berpikir” sebelum menghasilkan jawaban akhir. Ini menyesuaikan jumlah token penalaran internal yang boleh digunakan model.tool_choice="auto" secara eksplisit karena Responses API memutuskan penggunaan alat secara otomatis.responses.create, menambahkan hasil alat sebagai pesan berperan "tool". Ini meniru kelanjutan proses penalaran.Mekanisme penalaran dan verifikasi multi-langkah inilah yang memberikan kemampuan ulasan yang ketat. Ini meniru cara peninjau manusia mungkin menemukan masalah, melakukan perhitungan cepat, dan menyesuaikan umpan baliknya sesuai temuan
Setelah semua komponen siap, kita menggunakan fungsi ini untuk memproses seluruh PDF. Fungsi ini mengikat semuanya.
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
Fungsi ini bertindak sebagai pembungkus untuk meninjau seluruh makalah penelitian:
Sekarang kita mendefinisikan titik masuk skrip. Ini memungkinkan program dijalankan langsung dari terminal dengan path file PDF sebagai input.
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
Blok ini melakukan hal-hal berikut:
argparse untuk menerima path ke PDF sebagai argumen baris perintah.review_full_pdf() untuk menghasilkan ulasan lengkap.paper_review_output.md) untuk penggunaan atau integrasi di masa depan.Untuk menjalankan kode ini, ketik perintah berikut di terminal:
python pdf_reviewer_assistant.py Fake_paper.pdf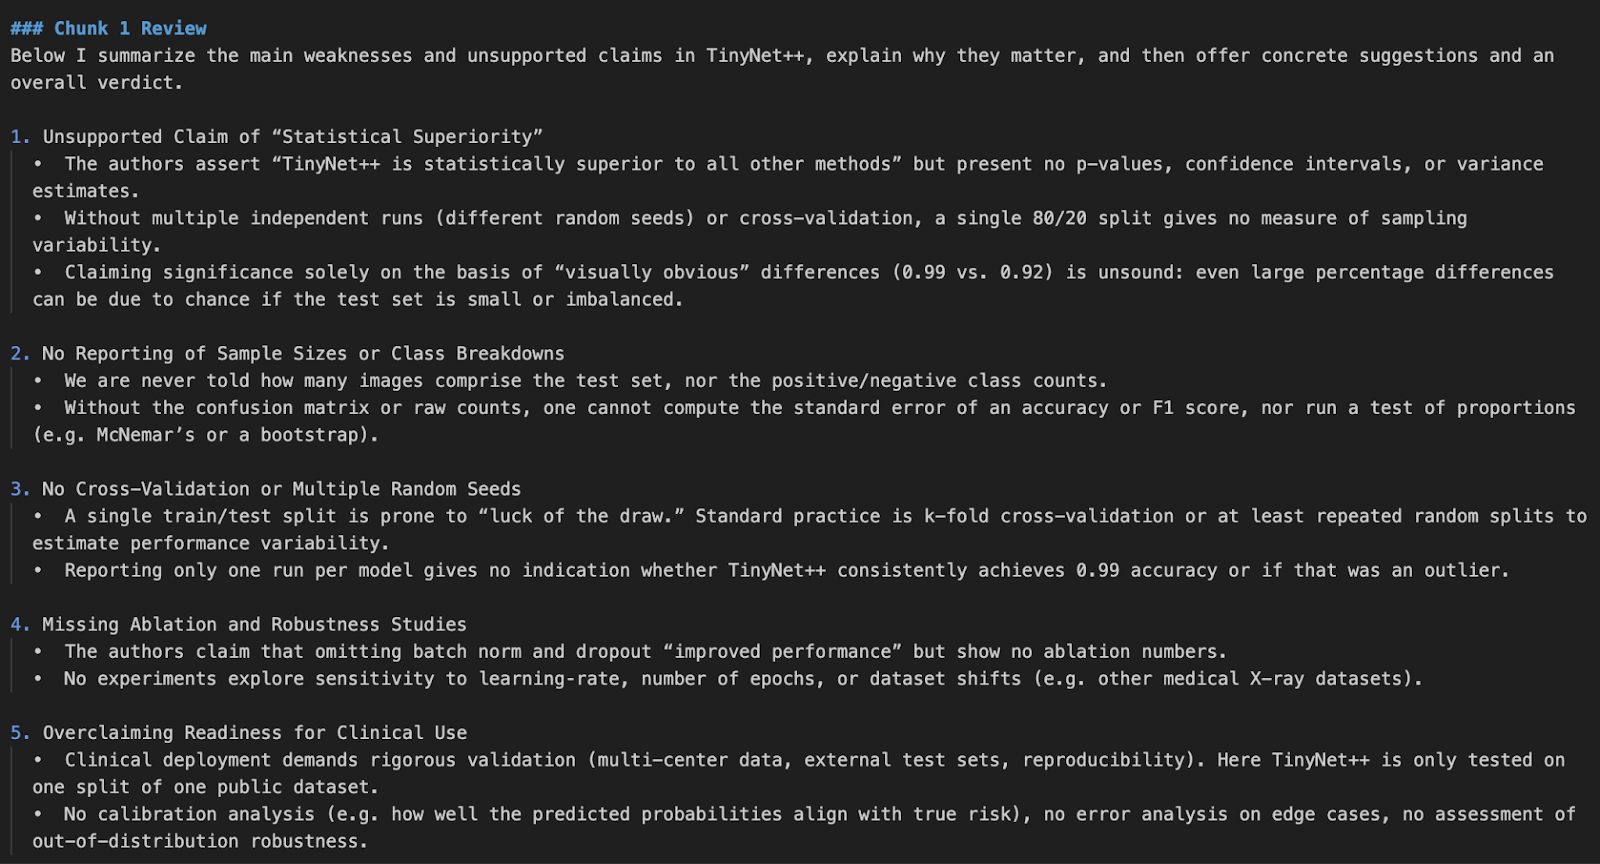
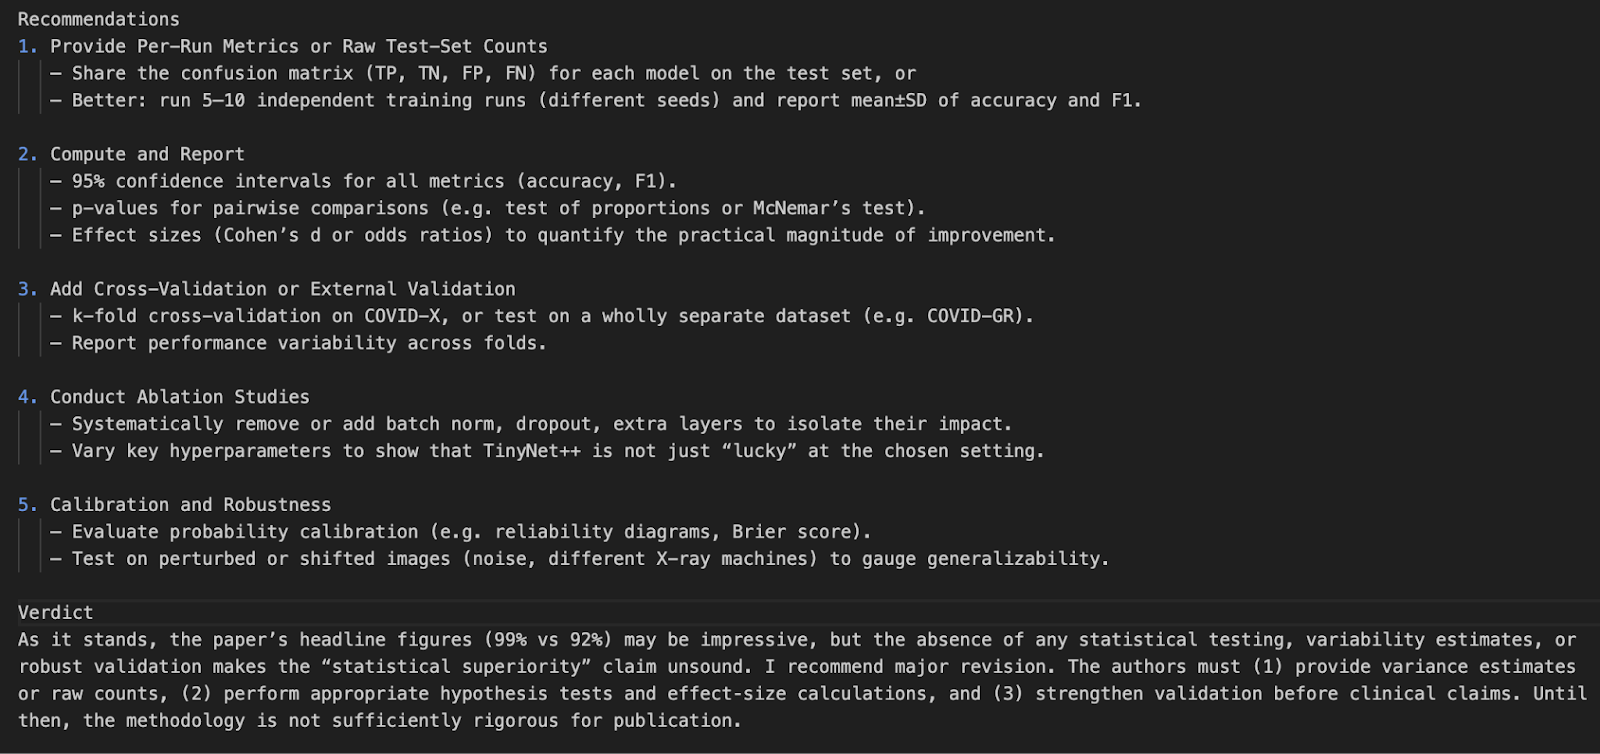
Dalam proyek ini, kita membuat peninjau makalah penelitian menggunakan API model o4-mini dari OpenAI. Kita meningkatkan kemampuan model dengan mengintegrasikan alat statistik waktu nyata, sehingga dapat menganalisis ulang p-value, interval kepercayaan, dan ukuran efek.
Demo ini menjadi landasan untuk integrasi di masa depan dengan antarmuka PDF, pemeriksa sitasi, atau bahkan alat asisten riset multimodal.
Untuk mempelajari lebih lanjut tentang rilis terbaru OpenAI, baca blog berikut:
Belajar AI dengan kursus-kursus ini!
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



