
学习路径
开发 AI 应用程序
21 小时
OpenAI 的o4-mini是 o 系列聚焦推理能力的最新模型。在本教程中,我将带您用 OpenAI 的 o4-mini API 构建一个科研论文审稿工具。该工具将:
我们还将为审稿助手增强统计工具支持,以便模型可按需计算 p 值、效应量和置信区间。
我们每周五发布免费通讯 The Median,以通俗方式解读本周 AI 重点动态,帮助读者把握最新进展。订阅即可每周花几分钟快速掌握要点:
OpenAI 的 o4-mini 是一款高性价比、高性能的推理模型,能够在编码、数学与科学推理等任务中进行深度分析。尽管体量小于o3 模型,它在 AIME 2024/2025、GPQA 等基准上仍能稳定获得最先进的结果。
凭借速度与价格优势,它非常适合用于审阅论文、生成代码讲解,或辅助解答竞赛级数学问题。其核心优势包括:
想进一步了解,请查看这篇关于o4-mini的入门博文。
我们将构建一个基于 Python 的论文审稿工具,可:
该项目完全本地运行,并使用 OpenAI 的 API。
使用 o4-mini 需要从 OpenAI 获取 API 密钥。操作如下:
现在,您就可以在 Python 中完成鉴权并开始调用 API 了。
先安装一些依赖,并为我们的 API 密钥设置一个环境变量。
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”依赖就绪后,接下来实现一些助手函数。模型在需要时会通过工具调用来触发这些函数。
这些导入用于计算 t 检验、标准误与置信区间。
from scipy.stats import ttest_ind, sem, t
import numpy as np此函数对两个独立样本组执行 Welch t 检验,用于检验两组均值是否在统计学上存在差异。
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
recalculate_p_value() 函数返回四舍五入到四位小数的 p 值,即观测到的差异由随机因素产生的概率。这有助于 LLM 验证论文中关于统计显著性的结论。
Cohen's d 是衡量两组效应量的标准化指标。它先计算各组均值与标准差,再用合并标准差对均值差进行归一化。
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
该函数返回四舍五入到四位小数的 Cohen's d。这帮助 LLM 评估差异的实践意义(不仅仅是统计显著)。当样本量较大、仅凭 p 值信息不足时尤为有用。
下面定义一个用于单一样本组置信区间计算的助手。置信区间可帮助理解估计均值的可靠性——也就是平均值周围的不确定性。
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
该函数返回如下内容:
mean:输入数据的平均值。confidence_interval:一个列表,表示在指定置信水平下,真实均值很可能落入的上下界。confidence:用于计算区间的置信水平。最后用一个简单助手汇总均值、标准差与样本量。
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
这有助于 LLM 解读底层数据分布,为评估结果提供必要背景。通过暴露均值、标准差与数量等统计量,我们的工具能强化模型对实验与论断的推理能力。
本节我们将构建使用 OpenAI o4-mini API 的 Python 论文审稿助手,并纳入统计分析工具支持,使模型能够进行更严谨、以数据为依据的评审与批注。
主代码从一些关键库开始,以提取 PDF 内容、进行分词,并与 OpenAI API 通信。
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
现在按步骤搭建完整的处理流程。
首先从论文中读取原始文本。借助 fitz 库,我们遍历所有页面并将提取的文本拼接为一个字符串。
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
这为后续步骤打下基础。接下来我们会进行分词与切块,再发送给模型处理。
注意:我生成了一份虚构论文用于演示,特意包含逻辑与实验设计层面的缺陷。
LLM 存在上下文长度限制,因此需要将长文档拆分为可管理的块。我们使用Tiktoken,按模型的编码方案对文本进行分词。
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
其工作流程如下:
tiktoken 通过 cl100k_base tokenizer 对全文进行分词,它与 GPT-4、GPT-4o、o4-mini 等现代 OpenAI 模型兼容。max_tokens 长度切分为多个片段,确保每个块都在模型允许的最大全文输入范围内,避免推理时发生 token 溢出错误。encoding.decode() 解码回可读文本,以保留自然表述与格式,让模型在处理时获得连贯的上下文。切块步骤能有效避免推理阶段的截断错误,确保不会因溢出而遗漏重要文本。
在模型调用外部函数前,需要定义从模型可见的函数名到实际 Python 函数的映射。该映射充当模型工具调用与本地代码之间的桥梁。
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
字典中的每个键对应模型在工具调用中可能引用的函数名,而每个值则是从 statistics_helper 模块导入的实际 Python 函数。
为增强模型推理,我们通过函数调用注册工具,支持 p 值重算、置信区间与效应量等统计分析。
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
上述工具定义让 LLM 明白:
description)name)LLM 会根据审稿情境智能决定是否调用工具,比如在遇到统计声明或可疑结果时,调用相应助手函数获取结果,并据此继续推理。这样可以实现更为严谨、扎实的分析,使模型不仅能提出批评,也能验证底层数据。
接下来定义核心逻辑,将每个文本块发送给 o4-mini 模型。若发生工具调用,我们将执行函数并继续对话。
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
review_text_chunk 函数负责将论文的每个文本块与系统提示及工具注册信息一起发送给 LLM。其步骤如下:
client.responses.create() 使用Responses API 将系统提示与文本块发送给模型。在本次调用中:
"o4-mini",并设置 reasoning={"effort": "high"},鼓励进行更细致的多步骤内部推理。该设置控制模型在生成最终答案前可使用的内部推理 token 数量。tool_choice="auto",Responses API 会自动决定工具使用。responses.create 调用,将工具结果作为 "tool" 角色消息附加回会话,模拟推理的延续。这种多步推理与校验机制赋予模型严谨的审稿能力,模拟人类审稿者先发现问题、再快速计算并据此调整反馈的过程。
各组件就绪后,使用该函数处理整份 PDF,将所有环节串联起来。
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
此函数是对整篇论文进行审阅的封装:
定义脚本的入口点,使程序可在终端中直接运行,并传入 PDF 路径作为输入。
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
该代码块将:
argparse 接收命令行参数中的 PDF 路径。review_full_pdf() 生成完整审稿结果。paper_review_output.md)保存,便于后续使用或集成。在终端中运行如下命令:
python pdf_reviewer_assistant.py Fake_paper.pdf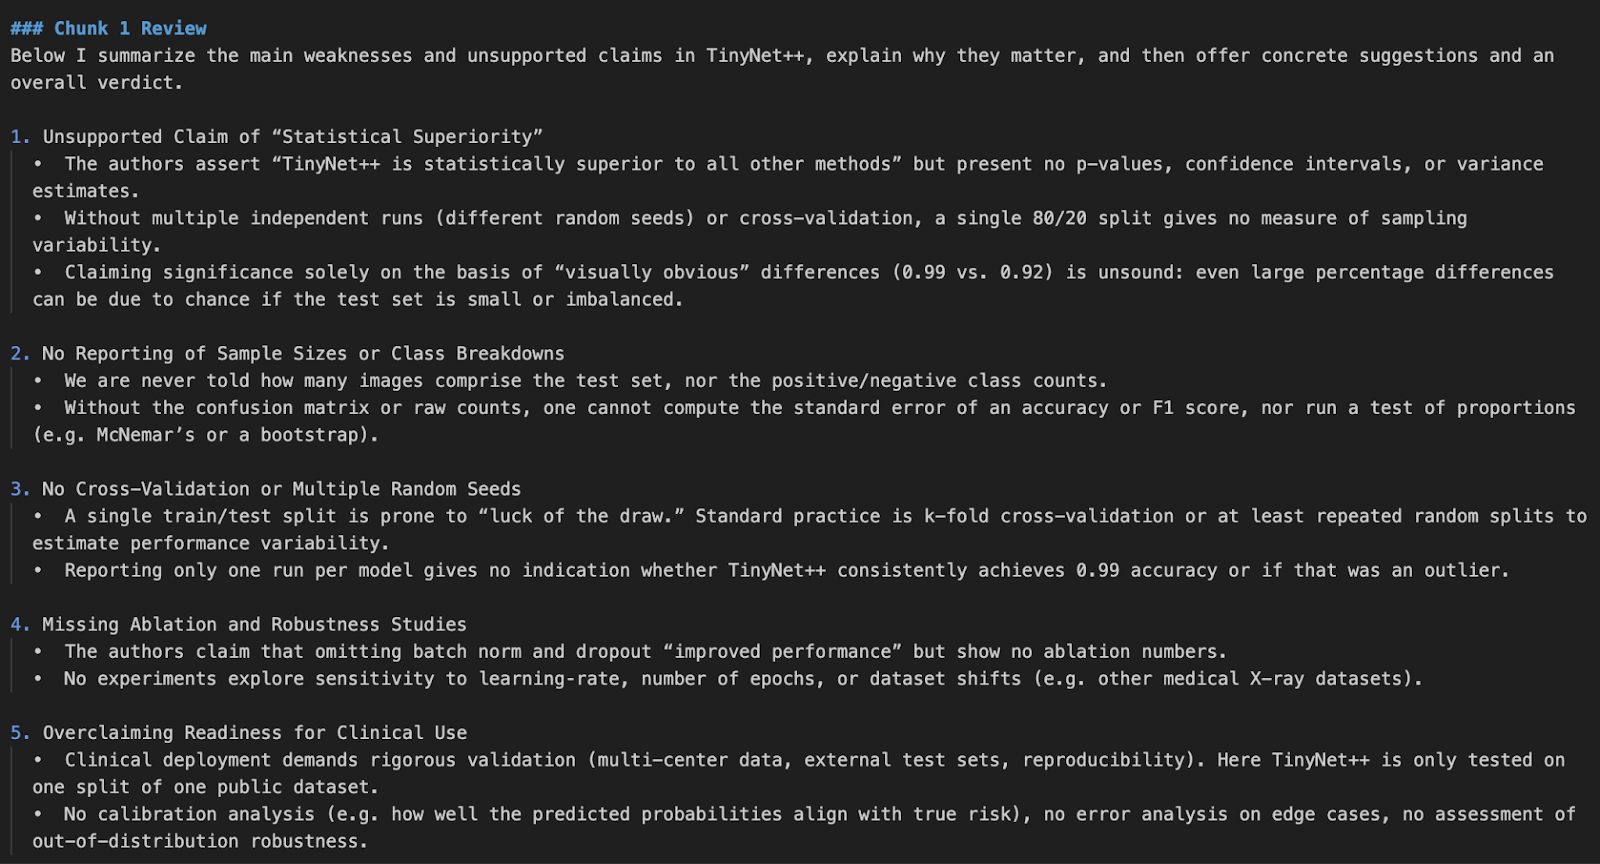
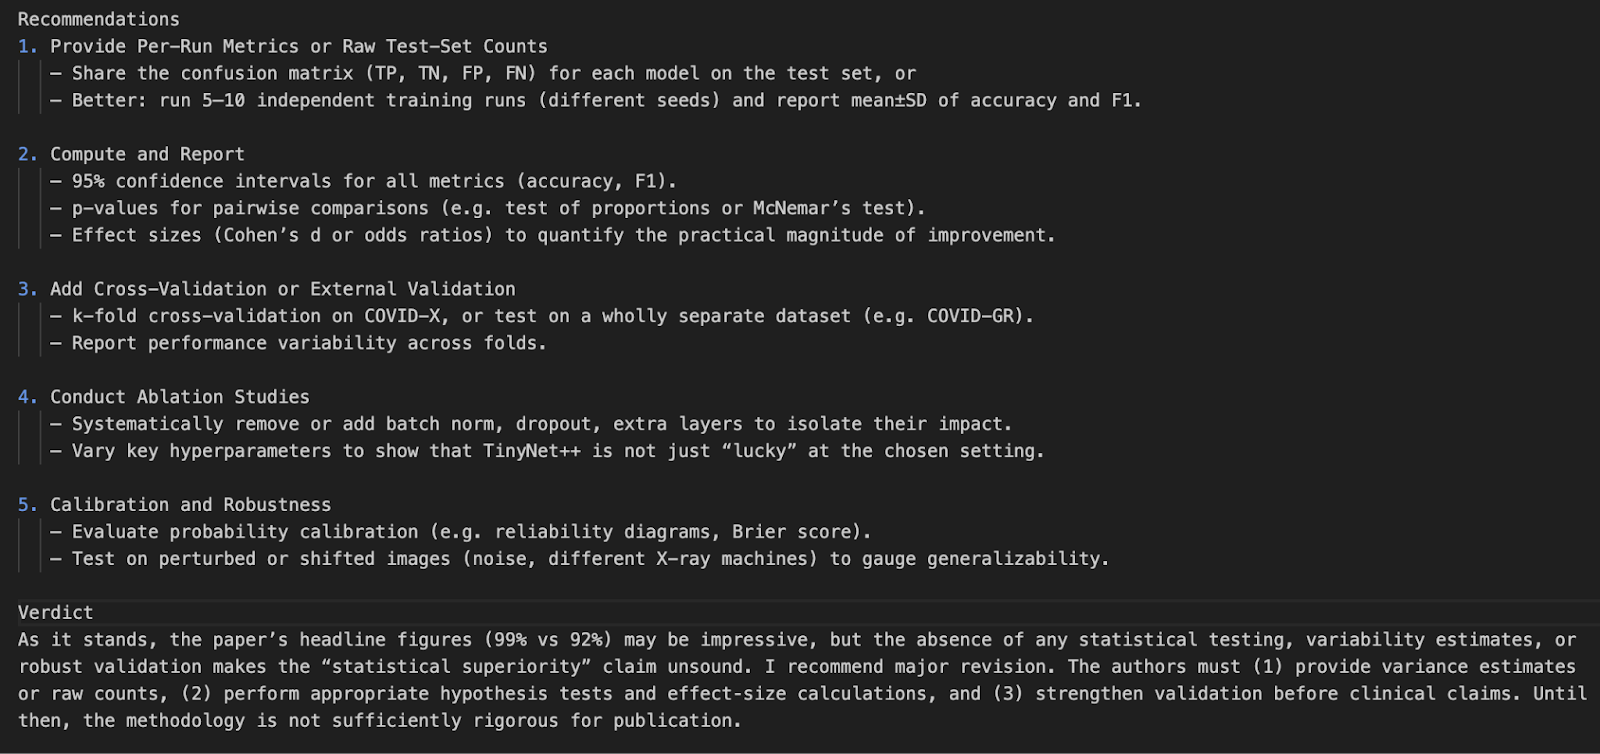
在本项目中,我们使用 OpenAI 的 o4-mini 模型 API 构建了论文审稿助手。通过集成实时统计工具,模型能够重新分析 p 值、置信区间与效应量。
该演示也为未来与 PDF 界面、引文校验,甚至多模态研究助手的集成奠定了基础。
想了解更多近期 OpenAI 发布内容,请查看以下博文:
通过这些课程学习 AI!
学习路径
课程
课程