
लर्निंग पाथ
एआई अनुप्रयोग विकसित करना
21 घंटा
OpenAI का o4-mini तर्क-क्षमता पर केंद्रित o-सीरीज़ के AI मॉडलों में नवीनतम जोड़ है। इस ट्यूटोरियल में, मैं आपको OpenAI के o4-mini API का उपयोग करके एक शोध-पत्र समीक्षक बनाना सिखाऊंगा। यह टूल:
हम अपने रिव्यू सहायक को सांख्यिकीय टूल सपोर्ट से भी उन्नत करेंगे, ताकि मॉडल आवश्यकता पड़ने पर p-value, effect size और confidence interval की गणना कर सके।
हम अपने पाठकों को AI की ताज़ा खबरों से अपडेट रखते हैं The Median के ज़रिए—यह हमारा निःशुल्क शुक्रवार न्यूज़लेटर है जो हफ्ते की अहम खबरों को संक्षेप में समझाता है। सब्सक्राइब करें और हर हफ्ते कुछ ही मिनटों में अपडेट रहें:
OpenAI का o4-mini एक किफायती, उच्च-प्रदर्शन तर्क मॉडल है जो कोडिंग, गणित और वैज्ञानिक तर्क जैसे कार्यों में गहन विश्लेषण करने में सक्षम है। o3 मॉडल से छोटा होने के बावजूद, यह AIME 2024/2025 और GPQA जैसे बेंचमार्क्स पर लगातार अत्याधुनिक परिणाम देता है।
गति और वहनीयता के कारण, यह शोध-पत्र समीक्षा, कोड व्याख्या तैयार करने, या प्रतियोगी गणित प्रश्नों में सहायता जैसे कार्यों के लिए आदर्श है। इसकी प्रमुख खूबियाँ हैं:
और जानने के लिए, o4-mini पर यह प्रारंभिक ब्लॉग देखें।
हम एक Python-आधारित शोध-पत्र समीक्षक बनाएंगे जो यह कर सके:
यह प्रोजेक्ट पूरी तरह लोकल है और OpenAI के API का उपयोग करता है।
o4-mini का उपयोग करने के लिए, आपको OpenAI से API कुंजी चाहिए। यह करें:
अब आप प्रमाणीकृत होकर Python से API कॉल करना शुरू कर सकते हैं।
कुछ निर्भरताएँ इंस्टॉल करने और हमारे API कुंजी के लिए एक environment variable सेट करने से शुरू करते हैं।
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”अब जबकि निर्भरताएँ सेट हो गई हैं, हेल्पर फ़ंक्शंस पर चलते हैं। ये फ़ंक्शंस आवश्यकता होने पर LLM द्वारा टूल कॉल्स के ज़रिए चलाए जाते हैं।
ये इंपोर्ट्स t-test, standard error, और confidence interval की गणना के लिए उपयोग किए जाते हैं।
from scipy.stats import ttest_ind, sem, t
import numpy as npयह फ़ंक्शन दो स्वतंत्र सैंपल समूहों के बीच Welch का t-test करता है। यह परिकल्पना की जाँच करता है कि दोनों समूहों के औसत सांख्यिकीय रूप से अलग हैं या नहीं।
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
recalculate_p_value() फ़ंक्शन p-value लौटाता है, चार दशमलव स्थान तक राउंड किया हुआ, जो यह दर्शाता है कि देखा गया अंतर संयोग से होने की कितनी संभावना है। इससे LLM को शोध-पत्र में सांख्यिकीय महत्व के दावों को सत्यापित करने में मदद मिलती है।
Cohen’s d दो समूहों के बीच effect size का मानकीकृत माप है। यह पहले प्रत्येक समूह के औसत और मानक विचलन की गणना करता है। फिर, मिश्रित मानक विचलन का उपयोग करके औसत के अंतर को सामान्यीकृत करता है।
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
यह फ़ंक्शन Cohen’s d का मान लौटाता है, चार दशमलव स्थान तक राउंड किया हुआ। यह LLM को समूहों के अंतर के व्यावहारिक महत्व (सिर्फ सांख्यिकीय नहीं) को समझने में मदद करता है—खासकर तब जब सैंपल आकार बड़ा हो और अकेले p-value पर्याप्त जानकारी न दे।
अब हम एक हेल्पर परिभाषित करते हैं जो किसी एक सैंपल समूह के लिए confidence interval निकालता है। Confidence interval इस बात को समझने में उपयोगी है कि किसी अनुमानित औसत के आसपास कितनी अनिश्चितता है—दूसरे शब्दों में, औसत मान के आसपास का भरोसेमंद दायरा।
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
यह फ़ंक्शन निम्नलिखित लौटाता है:
mean: इनपुट डेटा का औसत मान।confidence_interval: निचली और ऊपरी सीमाएँ दर्शाने वाली सूची, जिनके भीतर निर्दिष्ट confidence स्तर के आधार पर वास्तविक औसत आने की संभावना होती है।confidence: इंटरवल के लिए प्रयुक्त confidence स्तर।हम हेल्पर फ़ंक्शंस का समापन एक सरल हेल्पर से करते हैं जो mean, standard deviation, और sample size का सार प्रस्तुत करता है।
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
यह LLM को अंतर्निहित डेटा वितरण की व्याख्या करने में मदद करता है, जिससे परिणामों के आकलन के लिए आवश्यक संदर्भ मिलता है। mean, standard deviation और count जैसे सांख्यिकीय वर्णनों को उजागर करके, हमारे हेल्पर टूल्स मॉडल की शोध-पत्रों में पाए गए प्रयोगों और दावों पर तर्क करने की क्षमता को सुदृढ़ करते हैं।
इस भाग में, हम Python-आधारित शोध-पत्र समीक्षक बनाएंगे जो OpenAI के o4-mini API का उपयोग करता है और सांख्यिकीय विश्लेषण के लिए टूल सपोर्ट शामिल करता है, जिससे मॉडल कठोर मूल्यांकन और डेटा-समर्थित समालोचनाएँ कर सके।
हम अपने मुख्य कोड की शुरुआत कुछ आवश्यक लाइब्रेरीज़ से करते हैं ताकि PDF सामग्री निकाली जा सके, उसे टोकनाइज़ किया जा सके, और OpenAI API से संवाद किया जा सके।
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
आइए अब पूरी पाइपलाइन चरण-दर-चरण बनाते हैं।
हम शोध-पत्र से कच्चा टेक्स्ट पढ़ने से शुरू करते हैं। fitz लाइब्रेरी हमें सभी पृष्ठों पर इटररेट करने और निकाले गए टेक्स्ट को एक स्ट्रिंग में जोड़ने देती है।
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
यही आधार तैयार करता है। अब हम कच्चे टेक्स्ट को मॉडल को भेजने से पहले उसे टोकनाइज़ और चंक करेंगे।
नोट: मैंने डेमो के लिए जानबूझकर तर्क और प्रयोगात्मक डिज़ाइन में खामियाँ रखने वाला नकली शोध-पत्र बनाया है।
LLM में संदर्भ सीमा होती है, इसलिए हम लंबे दस्तावेज़ों को प्रबंधनीय चंक्स में तोड़ते हैं। हम Tiktoken का उपयोग मॉडल की एन्कोडिंग स्कीम के आधार पर टेक्स्ट को टोकनाइज़ करने के लिए करते हैं।
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
यह ऐसे काम करता है:
tiktoken का उपयोग करके पूरे दस्तावेज़ के टेक्स्ट को cl100k_base tokenizer से टोकनाइज़ करते हैं, जो GPT-4, GPT-4o, और o4-mini जैसे आधुनिक OpenAI मॉडलों के संगत है।max_tokens लंबाई के सेगमेंट्स में बाँटा जाता है। इससे सुनिश्चित होता है कि हर चंक मॉडल द्वारा अनुमत अधिकतम इनपुट आकार के भीतर रहे, जो इन्फरेंस के दौरान टोकन ओवरफ्लो त्रुटियों को रोकने के लिए आवश्यक है।encoding.decode() से वापस मानव-पठनीय टेक्स्ट में डिकोड किया जाता है। इससे स्वाभाविक वाक्य विन्यास और फ़ॉर्मैटिंग बनी रहती है ताकि मॉडल को सम cohérent संदर्भ मिले।यह चंकिंग चरण इन्फरेंस के दौरान कटऑफ़ त्रुटियों को रोकने के लिए आवश्यक है और सुनिश्चित करता है कि ओवरफ्लो के कारण कोई महत्वपूर्ण टेक्स्ट न छूटे।
मॉडल किसी बाहरी फ़ंक्शन को कॉल कर सके, उससे पहले हमें फ़ंक्शन नामों (जो मॉडल देखता है) और वास्तविक Python फ़ंक्शंस (जो चलेंगे) के बीच मैपिंग परिभाषित करनी होगी। यह मैपिंग मॉडल की टूल कॉल्स और हमारी लोकल कोडबेस के बीच पुल का काम करती है।
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
इस डिक्शनरी की प्रत्येक कुंजी उस फ़ंक्शन नाम से मेल खाती है जिसका संदर्भ मॉडल टूल कॉल के दौरान दे सकता है, और प्रत्येक मान statistics_helper मॉड्यूल से इंपोर्ट किया गया वास्तविक Python फ़ंक्शन है।
मॉडल की तर्क-क्षमता बढ़ाने के लिए, हम ऐसे टूल रजिस्टर करते हैं जिन्हें LLM function calling के ज़रिए कॉल कर सकता है। ये टूल p-value पुनर्गणना, confidence interval, और effect size जैसी सांख्यिकीय विश्लेषण की ज़िम्मेदारी संभालते हैं।
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
उपरोक्त टूल परिभाषा LLM को यह समझने देती है:
description)name)LLM रिव्यू के संदर्भ के आधार पर बुद्धिमानी से तय करता है कि कब किसी टूल को कॉल करना है, जैसे p-value की पुनर्गणना। जब उसे कोई सांख्यिकीय दावा या संदिग्ध परिणाम मिलता है, तो वह उपयुक्त हेल्पर फ़ंक्शन को कॉल कर सकता है, आउटपुट प्राप्त कर सकता है, और उसी परिणाम का उपयोग करते हुए अपनी तर्क-प्रक्रिया जारी रख सकता है। इससे अधिक कठोर और आधार-सत्यापित विश्लेषण संभव होता है, जहाँ मॉडल केवल आलोचना ही नहीं करता बल्कि अंतर्निहित डेटा का सत्यापन भी करता है।
अब हम मुख्य लॉजिक परिभाषित करते हैं जो प्रत्येक टेक्स्ट चंक को o4-mini मॉडल को भेजता है। यदि यह कोई टूल कॉल करता है, तो हम फ़ंक्शन कॉल को संभालते हैं और बातचीत जारी रखते हैं।
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
review_text_chunk फ़ंक्शन प्रत्येक चंक को सिस्टम प्रॉम्प्ट और टूल रजिस्ट्री के साथ LLM को भेजने के लिए ज़िम्मेदार है। यह चरण-दर-चरण ऐसे काम करता है:
client.responses.create() से भेजा जाता है, जो तर्क के लिए Responses API का उपयोग करता है। इस कॉल में:
"o4-mini" सेट किया जाता है और reasoning={"effort": "high"} फ्लैग high पर सेट है, जो विस्तृत बहु-चरणीय आंतरिक तर्क को प्रोत्साहित करता है। यह सेटिंग मॉडल को बताती है कि अंतिम उत्तर देने से पहले उसे कितनी गहराई से “सोचना” चाहिए। यह मॉडल द्वारा उपयोग किए जा सकने वाले आंतरिक तर्क टोकन की संख्या को समायोजित करती है।tool_choice="auto" आवश्यक नहीं है क्योंकि Responses API टूल उपयोग का निर्णय स्वयं करता है।responses.create की दूसरी कॉल के माध्यम से "tool" भूमिका वाले संदेश के रूप में जोड़कर मॉडल को वापस भेजते हैं। यह तर्क-प्रक्रिया की निरंतरता का अनुकरण करता है।यही बहु-चरणीय तर्क और सत्यापन तंत्र मॉडल को कठोर समीक्षा क्षमता देता है। यह उसी तरह है जैसे कोई मानव समीक्षक समस्या देखे, त्वरित गणना करे, और उसके अनुसार अपनी प्रतिक्रिया समायोजित करे।
जब सभी घटक तैयार हो जाएँ, तो हम इस फ़ंक्शन का उपयोग पूरे PDF को प्रोसेस करने के लिए करते हैं। यह सबकुछ एक साथ बाँधता है।
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
यह फ़ंक्शन पूरे शोध-पत्र की समीक्षा करने वाला रैपर की तरह काम करता है:
अब हम स्क्रिप्ट का एंट्री प्वाइंट परिभाषित करते हैं। इससे प्रोग्राम को टर्मिनल से सीधे एक PDF फ़ाइल पाथ के साथ चलाया जा सकता है।
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
यह ब्लॉक निम्न करता है:
argparse का उपयोग करके कमांड-लाइन आर्ग्युमेंट के रूप में PDF का पाथ स्वीकार करता है।review_full_pdf() फ़ंक्शन कॉल करके पूरा रिव्यू जनरेट करता है।paper_review_output.md) में भविष्य के उपयोग या एकीकरण के लिए सहेजता है।इस कोड को चलाने के लिए, टर्मिनल में निम्न कमांड टाइप करें:
python pdf_reviewer_assistant.py Fake_paper.pdf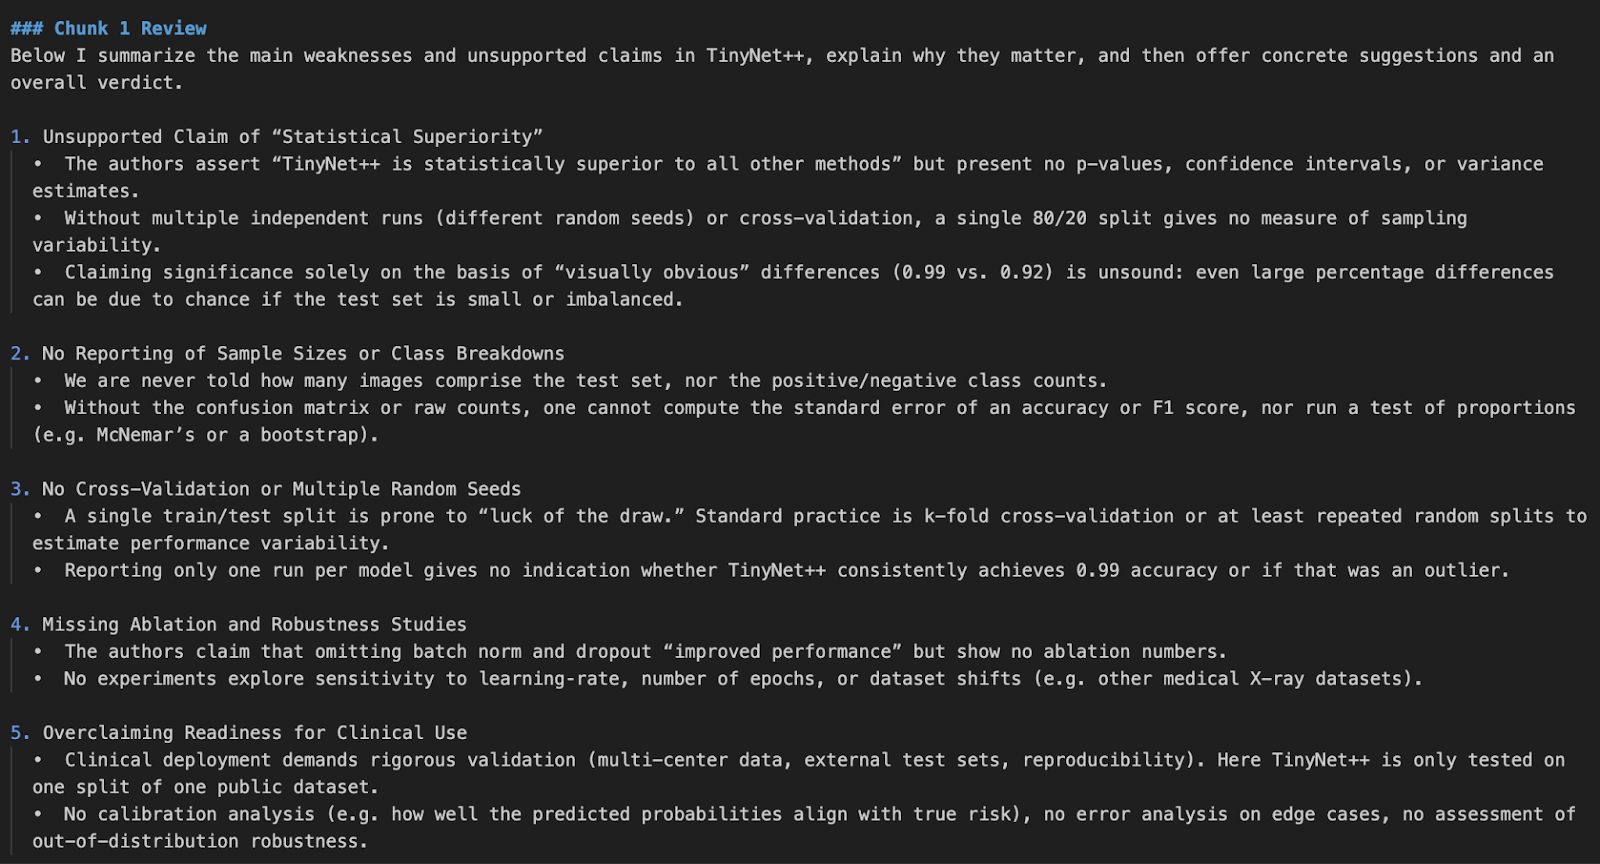
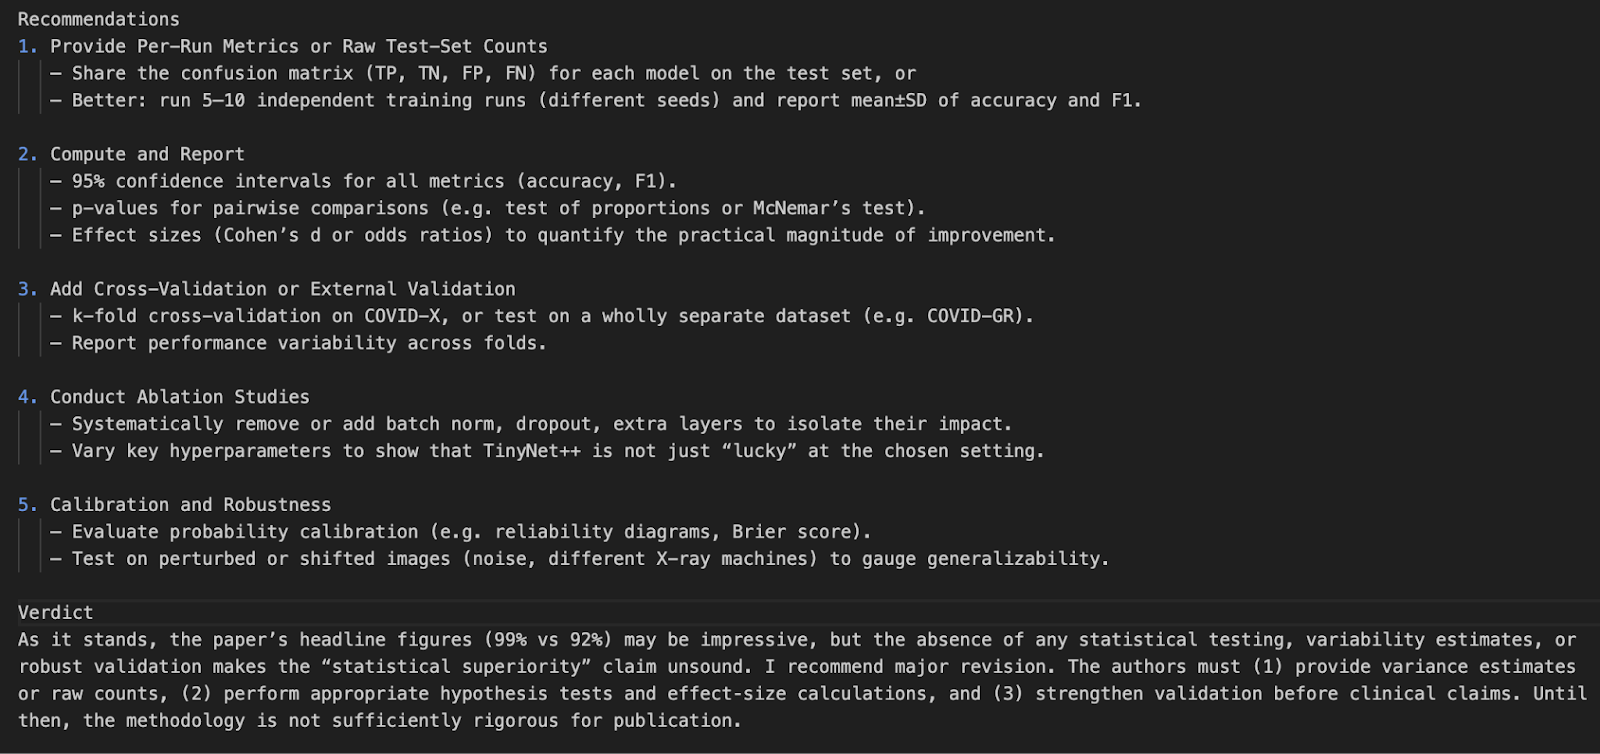
इस प्रोजेक्ट में, हमने OpenAI के o4-mini मॉडल API का उपयोग करके एक शोध-पत्र समीक्षक बनाया। हमने वास्तविक-समय सांख्यिकीय टूल्स को एकीकृत करके मॉडल की क्षमता बढ़ाई, जिससे यह p-value, confidence interval, और effect size का पुनःविश्लेषण कर सके।
यह डेमो भविष्य में PDF UI, citation चेकर, या यहाँ तक कि मल्टीमॉडल शोध सहायक टूल्स के साथ एकीकरण का मार्ग प्रशस्त करता है।
हाल के OpenAI रिलीज़ के बारे में और जानने के लिए, ये ब्लॉग देखें:
इन कोर्सेज़ के साथ AI सीखें!
लर्निंग पाथ
कोर्स
कोर्स