
Leerpad
AI-toepassingen ontwikkelen
21 uur
OpenAI’s o4-mini is de nieuwste toevoeging aan de o-serie van redeneergerichte AI-modellen. In deze tutorial laat ik je stap voor stap zien hoe je een beoordelaar voor wetenschappelijke artikelen bouwt met OpenAI’s o4-mini API. De tool zal:
We breiden onze review-assistent ook uit met ondersteuning voor statistische tools, zodat het model op aanvraag p-waardes, effectgroottes en betrouwbaarheidsintervallen kan berekenen.
We houden onze lezers op de hoogte van het laatste AI-nieuws met The Median, onze gratis nieuwsbrief op vrijdag die de belangrijkste verhalen van de week samenvat. Abonneer je en blijf scherp in een paar minuten per week:
OpenAI’s o4-mini is een kostenefficiënt, high-performance redeneermodel dat diepgaande analyses kan uitvoeren voor taken zoals programmeren, wiskunde en wetenschappelijke redeneringen. Ondanks dat het kleiner is dan het o3-model, behaalt het consistent state-of-the-art resultaten op benchmarks zoals AIME 2024/2025 en GPQA.
Dankzij de snelheid en betaalbaarheid is het ideaal voor taken zoals het beoordelen van wetenschappelijke artikelen, het genereren van codeuitleg of hulp bij competitieve wiskundevragen. De belangrijkste sterke punten zijn:
Wil je meer weten? Lees dan deze introductieblog over o4-mini.
We bouwen een Python-gebaseerde beoordelaar voor wetenschappelijke artikelen die het volgende kan:
Dit project draait volledig lokaal en gebruikt de API van OpenAI.
Om o4-mini te gebruiken, heb je een API-sleutel van OpenAI nodig. Zo doe je dat:
Nu kun je authenticeren en de API vanuit Python aanroepen.
Laten we beginnen met het installeren van een paar afhankelijkheden en het instellen van een omgevingsvariabele voor onze API-sleutel.
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”Nu de afhankelijkheden geregeld zijn, gaan we naar onze helperfuncties. Deze functies worden door het LLM aangeroepen via tool calls wanneer dat nodig is.
Deze imports worden gebruikt om t-toetsen, standaardfouten en betrouwbaarheidsintervallen te berekenen.
from scipy.stats import ttest_ind, sem, t
import numpy as npDeze functie voert een t-toets van Welch uit tussen twee onafhankelijke steekproefgroepen. Ze test de hypothese dat de gemiddelden van de twee groepen statistisch van elkaar verschillen.
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
De functie recalculate_p_value() retourneert de p-waarde, afgerond op vier decimalen, die aangeeft hoe waarschijnlijk het is dat het waargenomen verschil op toeval berust. Dit helpt het LLM claims over statistische significantie in het artikel te valideren.
Cohen’s d is een gestandaardiseerde maat voor effectgrootte tussen twee groepen. Eerst worden de gemiddelden en standaarddeviaties van elke groep berekend. Vervolgens wordt de gepoolde standaarddeviatie gebruikt om het verschil tussen gemiddelden te normaliseren.
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
De functie retourneert de Cohen’s d-waarde, afgerond op vier decimalen. Dit helpt het LLM de praktische significantie (niet alleen statistische) van groepsverschillen te begrijpen. Dat is vooral waardevol wanneer de steekproefgrootte groot is en p-waardes op zichzelf niet veelzeggend zijn.
We definiëren nu een helper om het betrouwbaarheidsinterval voor één steekproefgroep te berekenen. Betrouwbaarheidsintervallen zijn nuttig om de betrouwbaarheid van een geschat gemiddelde te begrijpen—met andere woorden, hoeveel onzekerheid er rond de gemiddelde waarde zit.
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
Dit is wat deze functie retourneert:
mean: De gemiddelde waarde van de invoergegevens.confidence_interval: Een lijst met de onder- en bovengrens waarbinnen het ware gemiddelde waarschijnlijk valt, op basis van het opgegeven betrouwbaarheidsniveau.confidence: Het gebruikte betrouwbaarheidsniveau voor het interval.We sluiten de helperfuncties af met een eenvoudige helper die het gemiddelde, de standaarddeviatie en de steekproefgrootte samenvat.
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
Dit helpt het LLM de onderliggende dataverdeling te interpreteren en biedt essentiële context voor het beoordelen van resultaten. Door statistische beschrijvingen zoals gemiddelde, standaarddeviatie en aantal bloot te leggen, versterken onze tools het redeneervermogen van het model bij experimenten en claims in artikelen.
In deze sectie bouwen we de Python-gebaseerde beoordelaar die OpenAI’s o4-mini API gebruikt en toolondersteuning voor statistische analyses bevat, zodat het model strenge evaluaties en onderbouwde kritieken kan leveren.
We beginnen onze hoofdcode met een paar essentiële libraries om PDF-inhoud te extraheren, te tokenizen en met de OpenAI API te communiceren.
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
Laten we nu stap voor stap de volledige pijplijn bouwen.
We beginnen met het uitlezen van ruwe tekst uit het artikel. Met de fitz-library kunnen we over alle pagina’s itereren en de geëxtraheerde tekst samenvoegen tot één string.
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
Dit legt de basis. We gaan de ruwe tekst nu tokenizen en in stukken opdelen voordat we die naar het model sturen.
Let op: ik heb een nep-wetenschappelijk artikel gegenereerd voor demodoeleinden, met opzet voorzien van fouten in logica en experimenteel ontwerp.
LLM’s hebben contextlimieten, dus we delen lange documenten op in behapbare stukken. We gebruiken Tiktoken om de tekst te tokenizen op basis van het coderingsschema van het model.
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
Zo werkt het:
tiktoken om de volledige documenttekst te tokenizen met de cl100k_base tokenizer, die compatibel is met moderne OpenAI-modellen zoals GPT-4, GPT-4o en o4-mini.max_tokens lengte. Dit zorgt ervoor dat elk stuk binnen de maximale invoergrootte van het model blijft, wat essentieel is om token-overflowfouten tijdens inferentie te voorkomen.encoding.decode(). Dit behoudt natuurlijke formuleringen en opmaak, zodat het model tijdens de verwerking samenhangende context krijgt.Deze chunkstap is essentieel om afkappingsfouten tijdens inferentie te voorkomen en garandeert dat er geen belangrijke tekst wegvalt door overflow.
Voordat het model externe functies kan aanroepen, moeten we een mapping definiëren tussen functienamen (zoals het model ze ziet) en de daadwerkelijke Python-functies die worden uitgevoerd. Deze mapping vormt de brug tussen de tool calls van het model en onze lokale codebase.
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
Elke sleutel in dit woordenboek komt overeen met een functienaam waarnaar het model kan verwijzen tijdens een toolaanroep, en elke waarde is de daadwerkelijke Python-functie die is geïmporteerd uit de module statistics_helper.
Om het redeneervermogen van het model te verbeteren, registreren we tools die het LLM kan aanroepen via function calling. Deze tools behandelen statistische analyses zoals p-waardeherberekening, betrouwbaarheidsintervallen en effectgroottes.
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
Met bovenstaande tooldefinitie kan het LLM begrijpen:
description)name)Het LLM beslist intelligent wanneer een tool moet worden aangeroepen, zoals het opnieuw berekenen van een p-waarde, op basis van de context van de review. Wanneer het een statistische claim of twijfelachtig resultaat tegenkomt, kan het de juiste helperfunctie aanroepen, de output ontvangen en zijn redenering met dat resultaat voortzetten. Dit maakt een grondigere en beter onderbouwde analyse mogelijk, waarbij het model niet alleen bekritiseert maar ook de onderliggende data verifieert.
We definiëren nu de kernlogica die elke tekstchunk naar het o4-mini-model stuurt. Als het een tool aanroept, handelen we de functieaanroep af en zetten we het gesprek voort.
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
De functie review_text_chunk is verantwoordelijk voor het sturen van elke chunk van het artikel naar het LLM, samen met een systeemprompt en toolregister. Zo werkt het stap voor stap:
client.responses.create() die de Responses API gebruikt voor redeneren. In deze aanroep:
"o4-mini", en de vlag reasoning={"effort": "high"} staat op hoog, wat gedetailleerde meerstapsinterne redenering stimuleert. Deze instelling geeft het model aan hoe diep het moet “nadenken” voordat het een eindantwoord genereert. Het bepaalt het aantal interne redeneertokens dat het model mag gebruiken.tool_choice="auto" nodig, omdat de Responses API automatisch beslist over toolgebruik.responses.create, waarbij we het toolresultaat als een bericht met de rol "tool" toevoegen. Dit simuleert een voortzetting van het redeneerproces.Dit meerstaps redeneer- en verificatiemechanisme geeft het model een strenge reviewcapaciteit. Het bootst na hoe een menselijke reviewer een probleem zou signaleren, een snelle berekening zou doen en vervolgens de feedback zou bijstellen
Als alle componenten klaar zijn, gebruiken we deze functie om een hele PDF te verwerken. Dit brengt alles samen.
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
Deze functie fungeert als wrapper om een volledig artikel te reviewen:
We definiëren nu het toegangspunt van het script. Dit maakt het mogelijk om het programma direct vanuit de terminal te draaien met een PDF-bestandspad als input.
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
Dit blok doet het volgende:
argparse om het pad naar een PDF te accepteren als command line-argument.review_full_pdf() aan om de volledige review te genereren.paper_review_output.md) voor later gebruik of integratie.Om deze code te draaien, typ je de volgende opdracht in de terminal:
python pdf_reviewer_assistant.py Fake_paper.pdf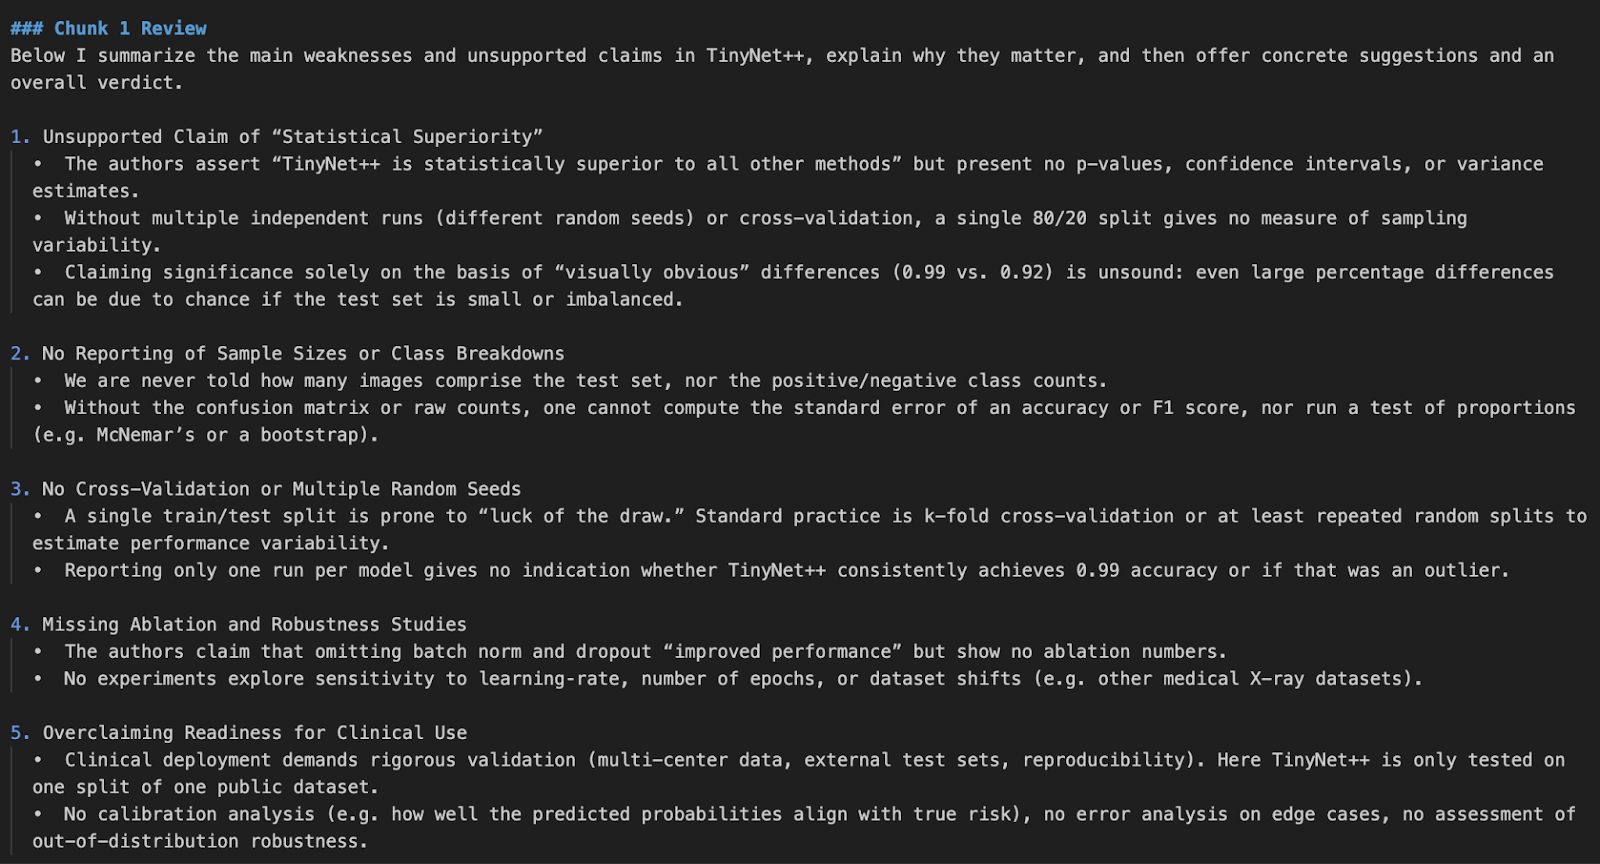
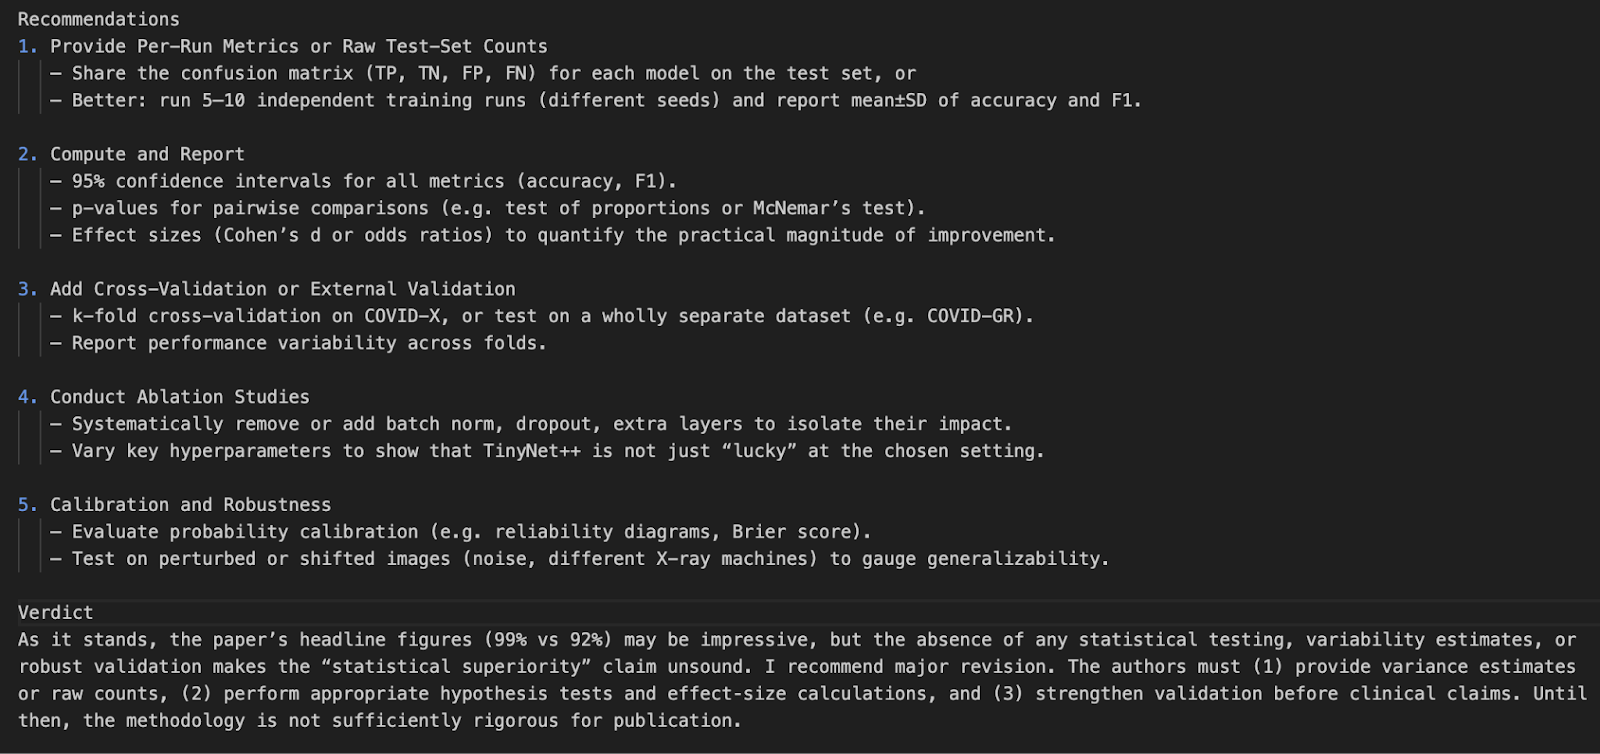
In dit project hebben we een beoordelaar voor wetenschappelijke artikelen gemaakt met de o4-mini model-API van OpenAI. We hebben het vermogen van het model uitgebreid met realtime statistische tools, zodat het p-waardes, betrouwbaarheidsintervallen en effectgroottes opnieuw kan analyseren.
Deze demo legt de basis voor toekomstige integraties met PDF-interfaces, citatiecheckers of zelfs multimodale onderzoeksassistenten.
Wil je meer weten over recente OpenAI-releases? Bekijk dan deze blogs:
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

