
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI o4-mini è l'ultimo arrivato nella serie o di modelli di IA incentrati sul ragionamento. In questo tutorial ti mostrerò come creare un revisore di articoli scientifici usando l'API o4-mini di OpenAI. Lo strumento:
Potenzieremo anche il nostro assistente di revisione con il supporto a strumenti statistici, così il modello potrà calcolare p-value, dimensioni dell'effetto e intervalli di confidenza su richiesta.
Teniamo aggiornati i nostri lettori sulle ultime novità dell'IA con The Median, la nostra newsletter gratuita del venerdì che spiega le notizie chiave della settimana. Iscriviti e resta sul pezzo in pochi minuti a settimana:
o4-mini di OpenAI è un modello di ragionamento ad alte prestazioni e conveniente, capace di analisi approfondite in compiti come coding, matematica e ragionamento scientifico. Pur essendo più piccolo del modello o3, raggiunge costantemente risultati allo stato dell'arte in benchmark come AIME 2024/2025 e GPQA.
Grazie alla sua velocità e al costo contenuto, è ideale per compiti come la revisione di articoli scientifici, la generazione di spiegazioni di codice o il supporto a quesiti di matematica competitiva. I suoi punti di forza principali sono:
Per saperne di più, dai un'occhiata a questo blog introduttivo su o4-mini.
Creeremo un revisore di articoli scientifici in Python che può:
Questo progetto è completamente locale e usa l'API di OpenAI.
Per usare o4-mini, ti serve una chiave API di OpenAI. Ecco come fare:
Ora sei pronto per autenticarti e iniziare a chiamare l'API da Python.
Iniziamo installando alcune dipendenze e impostando una variabile d'ambiente per la nostra chiave API.
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”Ora che le dipendenze sono a posto, passiamo alle funzioni di supporto. Queste funzioni vengono invocate dall'LLM tramite chiamate a strumenti quando necessario.
Questi import servono per calcolare t-test, errori standard e intervalli di confidenza.
from scipy.stats import ttest_ind, sem, t
import numpy as npQuesta funzione esegue il t-test di Welch tra due gruppi di campioni indipendenti. Verifica l'ipotesi che le medie dei due gruppi siano statisticamente diverse.
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
La funzione recalculate_p_value() restituisce il p-value, arrotondato a quattro decimali, che indica la probabilità che la differenza osservata sia avvenuta per caso. Questo aiuta l'LLM a validare le affermazioni di significatività statistica nell'articolo.
Cohen's d è una misura standardizzata della dimensione dell'effetto tra due gruppi. Parte calcolando le medie e le deviazioni standard di ciascun gruppo. Poi usa la deviazione standard combinata per normalizzare la differenza tra le medie.
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
La funzione restituisce il valore di Cohen's d, arrotondato a quattro decimali. Questo aiuta l'LLM a comprendere la rilevanza pratica (non solo statistica) delle differenze tra i gruppi. È particolarmente utile quando la dimensione del campione è grande e i soli p-value non sono informativi.
Ora definiamo un helper per calcolare l'intervallo di confidenza per un singolo gruppo di campioni. Gli intervalli di confidenza sono utili per comprendere l'affidabilità di una media stimata, in altre parole quanta incertezza circonda il valore medio.
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
Ecco cosa restituisce questa funzione:
mean: il valore medio dei dati in input.confidence_interval: una lista che rappresenta i limiti inferiore e superiore entro cui probabilmente ricade la vera media, in base al livello di confidenza specificato.confidence: il livello di confidenza usato per l'intervallo.Concludiamo le funzioni di supporto con un semplice helper che riassume media, deviazione standard e dimensione del campione.
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
Questo aiuta l'LLM a interpretare la distribuzione dei dati sottostanti, fornendo contesto essenziale per valutare i risultati. Esponendo descrittori statistici come media, deviazione standard e conteggio, i nostri strumenti di supporto rafforzano la capacità del modello di ragionare su esperimenti e affermazioni presenti negli articoli.
In questa sezione costruiremo il revisore in Python che usa l'API o4-mini di OpenAI e include il supporto a strumenti per l'analisi statistica, consentendo al modello di effettuare valutazioni rigorose e critiche basate sui dati.
Iniziamo il codice principale con alcune librerie essenziali per estrarre contenuti dai PDF, tokenizzarli e comunicare con l'API di OpenAI.
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
Costruiamo ora la pipeline completa passo dopo passo.
Iniziamo leggendo il testo grezzo dall'articolo. La libreria fitz ci permette di iterare su tutte le pagine e concatenare il testo estratto in un'unica stringa.
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
Questa è la base. Ora tokenizzeremo e suddivideremo il testo grezzo in blocchi prima di inviarlo al modello.
Nota: ho generato un finto articolo scientifico per scopi demo che contiene volutamente difetti di logica e di disegno sperimentale.
Gli LLM hanno limiti di contesto, quindi dividiamo i documenti lunghi in blocchi gestibili. Usiamo Tiktoken per tokenizzare il testo in base allo schema di codifica del modello.
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
Ecco come funziona:
tiktoken per tokenizzare l'intero testo del documento usando il tokenizer cl100k_base, compatibile con i modelli OpenAI moderni come GPT-4, GPT-4o e o4-mini.max_tokens. Questo assicura che ogni blocco resti entro la dimensione massima di input consentita dal modello, essenziale per prevenire errori di overflow dei token in inferenza.encoding.decode(). Questo preserva la naturalezza della formulazione e la formattazione, così il modello riceve contesto coerente durante l'elaborazione.Questo passaggio di suddivisione è essenziale per prevenire tagli durante l'inferenza e garantisce che nessun testo importante venga perso per overflow.
Prima che il modello possa invocare funzioni esterne, dobbiamo definire una mappatura tra i nomi delle funzioni (come visti dal modello) e le reali funzioni Python che verranno eseguite. Questa mappatura funge da ponte tra le chiamate agli strumenti del modello e il nostro codice locale.
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
Ogni chiave in questo dizionario corrisponde a un nome di funzione che il modello potrebbe richiamare durante l'invocazione dello strumento, e ogni valore è la reale funzione Python importata dal modulo statistics_helper.
Per migliorare il ragionamento del modello, registriamo strumenti che l'LLM può chiamare tramite function calling. Questi strumenti gestiscono analisi statistiche come il ricalcolo dei p-value, intervalli di confidenza e dimensioni dell'effetto.
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
La definizione degli strumenti sopra permette all'LLM di comprendere:
description)name)L'LLM decide in modo intelligente quando invocare uno strumento, ad esempio per ricalcolare un p-value, in base al contesto della revisione. Quando incontra un'affermazione statistica o un risultato dubbio, può chiamare la funzione di supporto appropriata, ricevere l'output e continuare il ragionamento usando quel risultato. Questo abilita un'analisi più rigorosa e fondata, in cui il modello non solo critica ma verifica anche i dati sottostanti.
Ora definiamo la logica principale che invia ogni blocco di testo al modello o4-mini. Se richiama uno strumento, gestiamo la chiamata alla funzione e proseguiamo la conversazione.
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
La funzione review_text_chunk è responsabile di inviare ciascun blocco dell'articolo all'LLM, insieme a un prompt di sistema e al registro degli strumenti. Ecco come funziona passo dopo passo:
client.responses.create() che utilizza la Responses API per il ragionamento. In questa chiamata:
"o4-mini" e il flag reasoning={"effort": "high"} è impostato su high, il che incoraggia un ragionamento interno dettagliato e multi-step. Questa impostazione indica al modello quanto a fondo dovrebbe "pensare" prima di generare una risposta finale. Regola il numero di token di ragionamento interni che il modello può usare.tool_choice="auto" poiché la Responses API decide automaticamente l'uso degli strumenti.responses.create, aggiungendo il risultato come messaggio con ruolo "tool". Questo simula una continuazione del processo di ragionamento.Questo meccanismo di ragionamento e verifica in più passaggi è ciò che conferisce al modello una capacità di revisione rigorosa. Imita il modo in cui un revisore umano potrebbe individuare un problema, fare un rapido calcolo e adeguare di conseguenza il proprio feedback
Una volta che tutti i componenti sono al loro posto, usiamo questa funzione per elaborare un intero PDF. Mette insieme tutto.
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
Questa funzione funge da wrapper per revisionare un intero articolo scientifico:
Ora definiamo il punto di ingresso dello script. Questo permette di eseguire il programma direttamente dal terminale passando il percorso del PDF come input.
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
Questo blocco fa quanto segue:
argparse per accettare il percorso di un PDF come argomento da riga di comando.review_full_pdf() per generare la revisione completa.paper_review_output.md) per usi futuri o integrazioni.Per eseguire questo codice, digita il seguente comando nel terminale:
python pdf_reviewer_assistant.py Fake_paper.pdf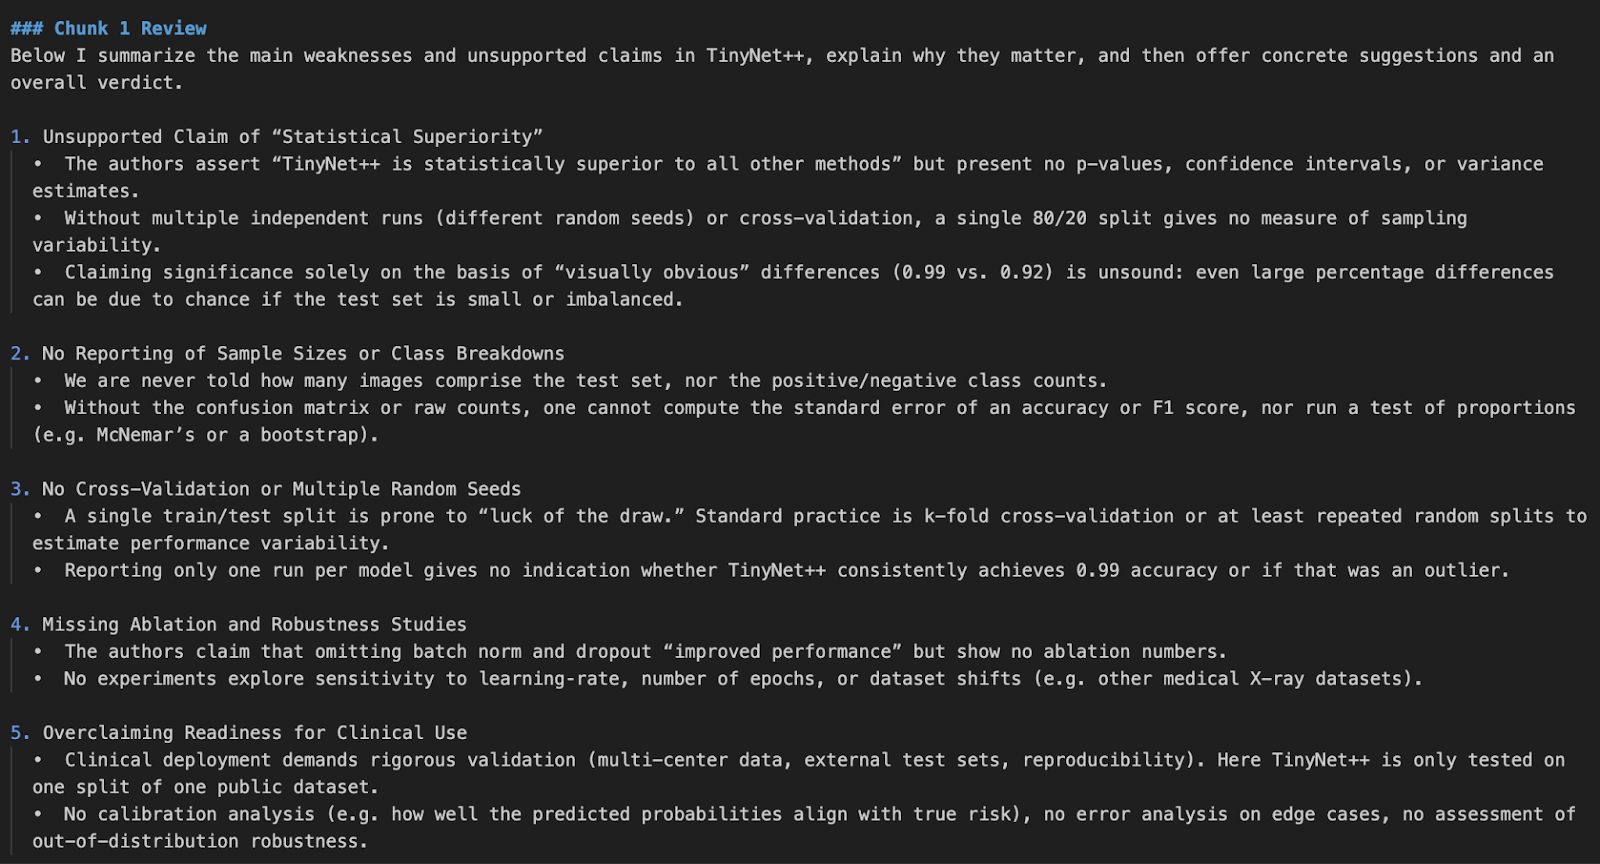
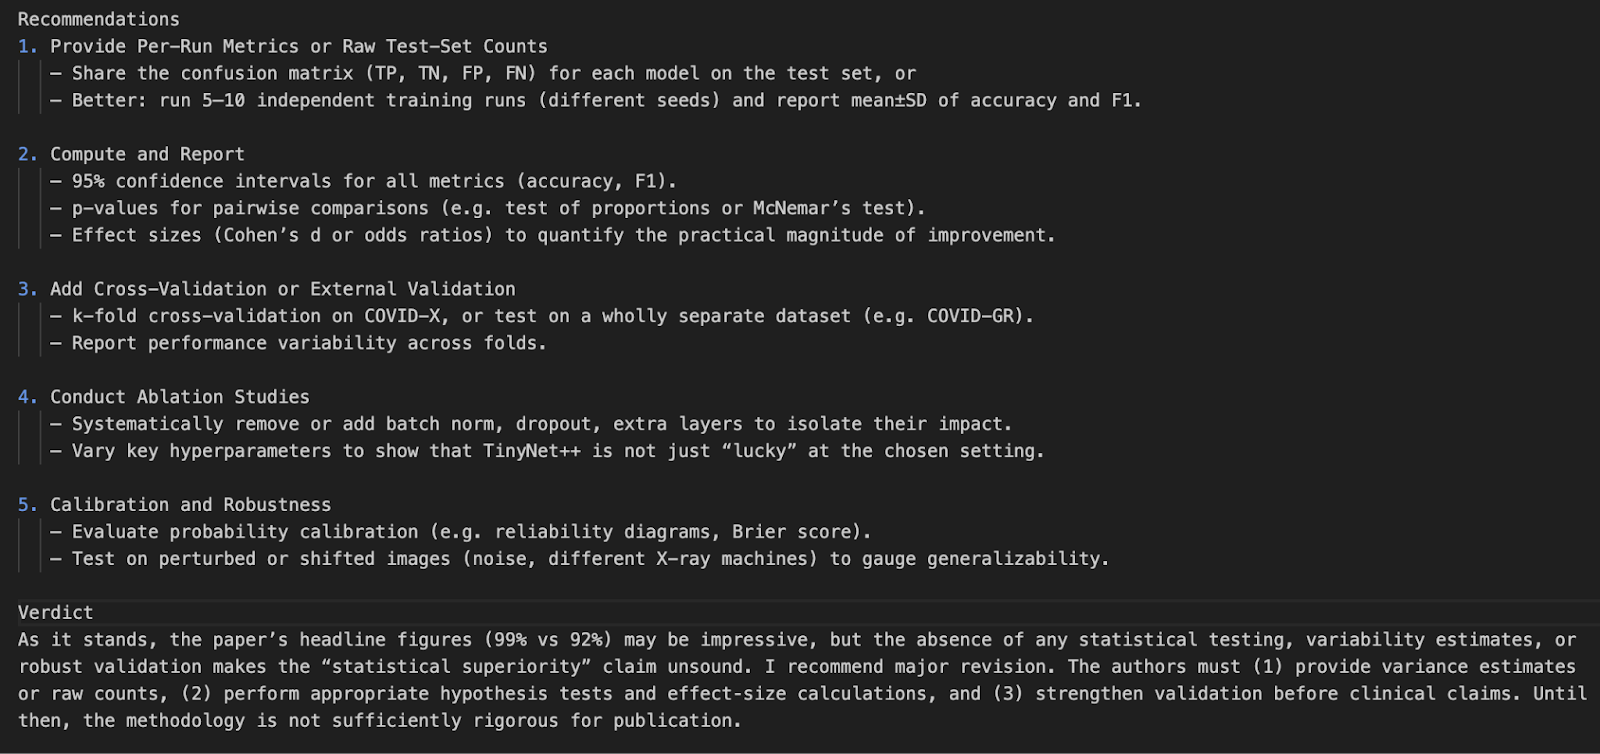
In questo progetto abbiamo creato un revisore di articoli scientifici usando l'API del modello o4-mini di OpenAI. Abbiamo migliorato le capacità del modello integrando strumenti statistici in tempo reale, permettendogli di rianalizzare p-value, intervalli di confidenza e dimensioni dell'effetto.
Questa demo apre la strada a future integrazioni con interfacce PDF, verificatori di citazioni o persino strumenti di assistenza alla ricerca multimodali.
Per saperne di più sulle recenti novità di OpenAI, dai un'occhiata a questi blog:
Impara l'IA con questi corsi!
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




