
Lộ trình
Phát triển các ứng dụng trí tuệ nhân tạo
21 giờ
o4-mini của OpenAI là bổ sung mới nhất cho dòng mô hình AI tập trung vào suy luận o-series. Trong hướng dẫn này, tôi sẽ hướng dẫn bạn cách xây dựng một trình phản biện bài báo khoa học bằng cách sử dụng API o4-mini của OpenAI. Công cụ sẽ:
Chúng ta cũng sẽ tăng cường trợ lý phản biện bằng hỗ trợ công cụ thống kê, để mô hình có thể tính p-value, kích thước hiệu ứng và khoảng tin cậy theo yêu cầu.
Chúng tôi luôn cập nhật cho độc giả về những điều mới nhất trong AI qua The Median, bản tin miễn phí phát hành thứ Sáu hằng tuần, tóm lược các câu chuyện quan trọng. Đăng ký để nắm bắt nhanh chỉ trong vài phút mỗi tuần:
o4-mini của OpenAI là mô hình suy luận hiệu năng cao, chi phí hợp lý, có khả năng phân tích sâu ở các tác vụ như lập trình, toán học và suy luận khoa học. Dù nhỏ hơn mô hình o3, nó vẫn liên tục đạt kết quả tiên tiến trên các benchmark như AIME 2024/2025 và GPQA.
Nhờ tốc độ và chi phí thấp, nó rất phù hợp cho các tác vụ như phản biện bài báo khoa học, tạo giải thích cho mã, hoặc hỗ trợ câu hỏi toán thi đấu. Các điểm mạnh chính gồm:
Để tìm hiểu thêm, hãy xem bài blog giới thiệu về o4-mini.
Chúng ta sẽ xây dựng một trình phản biện bài báo khoa học dựa trên Python có thể:
Dự án này chạy hoàn toàn cục bộ và sử dụng API của OpenAI.
Để dùng o4-mini, bạn cần khóa API từ OpenAI. Cách thực hiện:
Giờ bạn đã sẵn sàng xác thực và bắt đầu gọi API từ Python.
Bắt đầu bằng cách cài một vài phụ thuộc và thiết lập biến môi trường cho khóa API của chúng ta.
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”Sau khi xong phụ thuộc, chuyển sang các hàm trợ giúp. Những hàm này sẽ được LLM gọi thông qua tool calls khi cần.
Các import này dùng để tính kiểm định t, sai số chuẩn và khoảng tin cậy.
from scipy.stats import ttest_ind, sem, t
import numpy as npHàm này thực hiện kiểm định t của Welch giữa hai nhóm mẫu độc lập. Nó kiểm định giả thuyết rằng trung bình của hai nhóm khác biệt có ý nghĩa thống kê.
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
Hàm recalculate_p_value() trả về p-value, làm tròn đến bốn chữ số thập phân, biểu thị xác suất rằng khác biệt quan sát được xảy ra do ngẫu nhiên. Điều này giúp LLM kiểm chứng các tuyên bố về ý nghĩa thống kê trong bài báo.
Cohen’s d là thước đo kích thước hiệu ứng chuẩn hóa giữa hai nhóm. Bắt đầu bằng việc tính trung bình và độ lệch chuẩn của mỗi nhóm. Sau đó dùng độ lệch chuẩn gộp để chuẩn hóa chênh lệch trung bình.
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
Hàm trả về giá trị Cohen’s d, làm tròn đến bốn chữ số thập phân. Điều này giúp LLM hiểu ý nghĩa thực tiễn (không chỉ thống kê) của khác biệt giữa các nhóm. Đặc biệt hữu ích khi cỡ mẫu lớn và p-value đơn thuần chưa đủ thông tin.
Giờ ta định nghĩa hàm trợ giúp để tính khoảng tin cậy cho một nhóm mẫu. Khoảng tin cậy hữu ích để hiểu độ tin cậy của trung bình ước lượng — tức mức độ bất định quanh giá trị trung bình.
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
Hàm này trả về:
mean: Giá trị trung bình của dữ liệu đầu vào.confidence_interval: Danh sách biểu diễn cận dưới và cận trên trong đó trung bình thật có khả năng nằm, dựa trên mức tin cậy chỉ định.confidence: Mức tin cậy dùng cho khoảng.Kết thúc phần trợ giúp bằng một hàm đơn giản tóm tắt trung bình, độ lệch chuẩn và kích thước mẫu.
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
Điều này giúp LLM diễn giải phân phối dữ liệu nền, cung cấp ngữ cảnh thiết yếu để đánh giá kết quả. Bằng cách cung cấp các mô tả như trung bình, độ lệch chuẩn và số lượng, các công cụ trợ giúp của chúng ta tăng cường khả năng suy luận về thí nghiệm và tuyên bố trong bài báo.
Trong phần này, chúng ta sẽ xây dựng trình phản biện bài báo bằng Python sử dụng API o4-mini của OpenAI và bao gồm hỗ trợ công cụ phân tích thống kê, cho phép mô hình thực hiện đánh giá chặt chẽ và phản biện dựa trên dữ liệu.
Chúng ta bắt đầu mã chính với một số thư viện thiết yếu để trích xuất nội dung PDF, tokenize và giao tiếp với OpenAI API.
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
Giờ hãy xây dựng pipeline hoàn chỉnh từng bước.
Bắt đầu bằng cách đọc văn bản thô từ bài báo. Thư viện fitz cho phép lặp qua mọi trang và nối phần văn bản trích xuất thành một chuỗi.
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
Đây là nền tảng. Tiếp theo, chúng ta sẽ tokenize và chia khúc văn bản trước khi gửi tới mô hình.
Lưu ý: Tôi đã tạo một bài báo giả cho mục đích demo, cố ý chứa các lỗi logic và thiết kế thí nghiệm.
LLM có giới hạn ngữ cảnh, nên ta chia tài liệu dài thành các khúc dễ xử lý. Chúng ta dùng Tiktoken để tokenize văn bản theo lược đồ mã hóa của mô hình.
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
Cách hoạt động:
tiktoken để tokenize toàn bộ văn bản bằng cl100k_base tokenizer, tương thích với các mô hình OpenAI hiện đại như GPT-4, GPT-4o và o4-mini.max_tokens. Điều này đảm bảo mỗi khúc nằm trong kích thước đầu vào tối đa mà mô hình cho phép, tránh lỗi tràn token khi suy luận.encoding.decode(). Việc này giữ nguyên cách diễn đạt và định dạng tự nhiên để mô hình nhận được ngữ cảnh mạch lạc trong quá trình xử lý.Bước chia khúc này rất quan trọng để ngăn lỗi cắt cụt trong quá trình suy luận và đảm bảo không bỏ sót văn bản quan trọng do tràn.
Trước khi mô hình có thể gọi bất kỳ hàm bên ngoài nào, ta cần định nghĩa ánh xạ giữa tên hàm (mà mô hình nhìn thấy) và các hàm Python thực sự sẽ được thực thi. Ánh xạ này đóng vai trò cầu nối giữa tool calls của mô hình và mã cục bộ của chúng ta.
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
Mỗi khóa trong từ điển này tương ứng với tên hàm mà mô hình có thể tham chiếu trong quá trình gọi công cụ, và mỗi giá trị là hàm Python thực tế được import từ mô-đun statistics_helper.
Để tăng cường suy luận của mô hình, chúng ta đăng ký các công cụ mà LLM có thể gọi qua function calling. Các công cụ này xử lý phân tích thống kê như tính lại p-value, khoảng tin cậy và kích thước hiệu ứng.
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
Định nghĩa công cụ trên giúp LLM hiểu:
description)name)LLM sẽ tự quyết định khi nào cần gọi công cụ, ví dụ khi cần tính lại p-value, dựa trên ngữ cảnh phản biện. Khi gặp tuyên bố thống kê hoặc kết quả đáng ngờ, nó có thể gọi hàm trợ giúp phù hợp, nhận đầu ra, rồi tiếp tục suy luận dựa trên kết quả đó. Điều này cho phép phân tích chặt chẽ và có cơ sở hơn, nơi mô hình không chỉ phê bình mà còn kiểm chứng dữ liệu nền.
Giờ chúng ta định nghĩa logic cốt lõi gửi mỗi khúc văn bản tới mô hình o4-mini. Nếu mô hình gọi công cụ, ta xử lý lệnh gọi hàm và tiếp tục hội thoại.
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
Hàm review_text_chunk chịu trách nhiệm gửi mỗi khúc bài báo tới LLM, kèm system prompt và danh mục công cụ. Cách hoạt động từng bước:
client.responses.create() sử dụng Responses API cho suy luận. Trong lần gọi này:
"o4-mini" và cờ reasoning={"effort": "high"} được đặt ở mức cao, khuyến khích suy luận nội bộ nhiều bước chi tiết. Thiết lập này cho biết mức độ mô hình nên “suy nghĩ” trước khi tạo câu trả lời cuối cùng, điều chỉnh số token suy luận nội bộ được phép dùng.tool_choice="auto" vì Responses API tự quyết định việc dùng công cụ.responses.create, bổ sung kết quả công cụ như một thông điệp vai trò "tool". Điều này mô phỏng việc tiếp nối quá trình suy luận.Cơ chế suy luận và kiểm chứng nhiều bước này mang lại khả năng phản biện chặt chẽ cho mô hình. Nó mô phỏng cách một người phản biện sẽ phát hiện vấn đề, tính nhanh vài số liệu rồi điều chỉnh phản hồi tương ứng
Khi mọi thành phần đã sẵn sàng, chúng ta dùng hàm này để xử lý toàn bộ PDF. Nó liên kết tất cả lại với nhau.
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
Hàm này đóng vai trò bao bọc để phản biện toàn bộ bài báo:
Giờ ta định nghĩa điểm vào của script. Điều này cho phép chạy chương trình trực tiếp từ terminal với đường dẫn file PDF làm đầu vào.
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
Khối này thực hiện:
argparse để nhận đường dẫn đến PDF như một tham số dòng lệnh.review_full_pdf() để tạo bài phản biện đầy đủ.paper_review_output.md) để dùng sau hoặc tích hợp.Để chạy mã này, gõ lệnh sau trong terminal:
python pdf_reviewer_assistant.py Fake_paper.pdf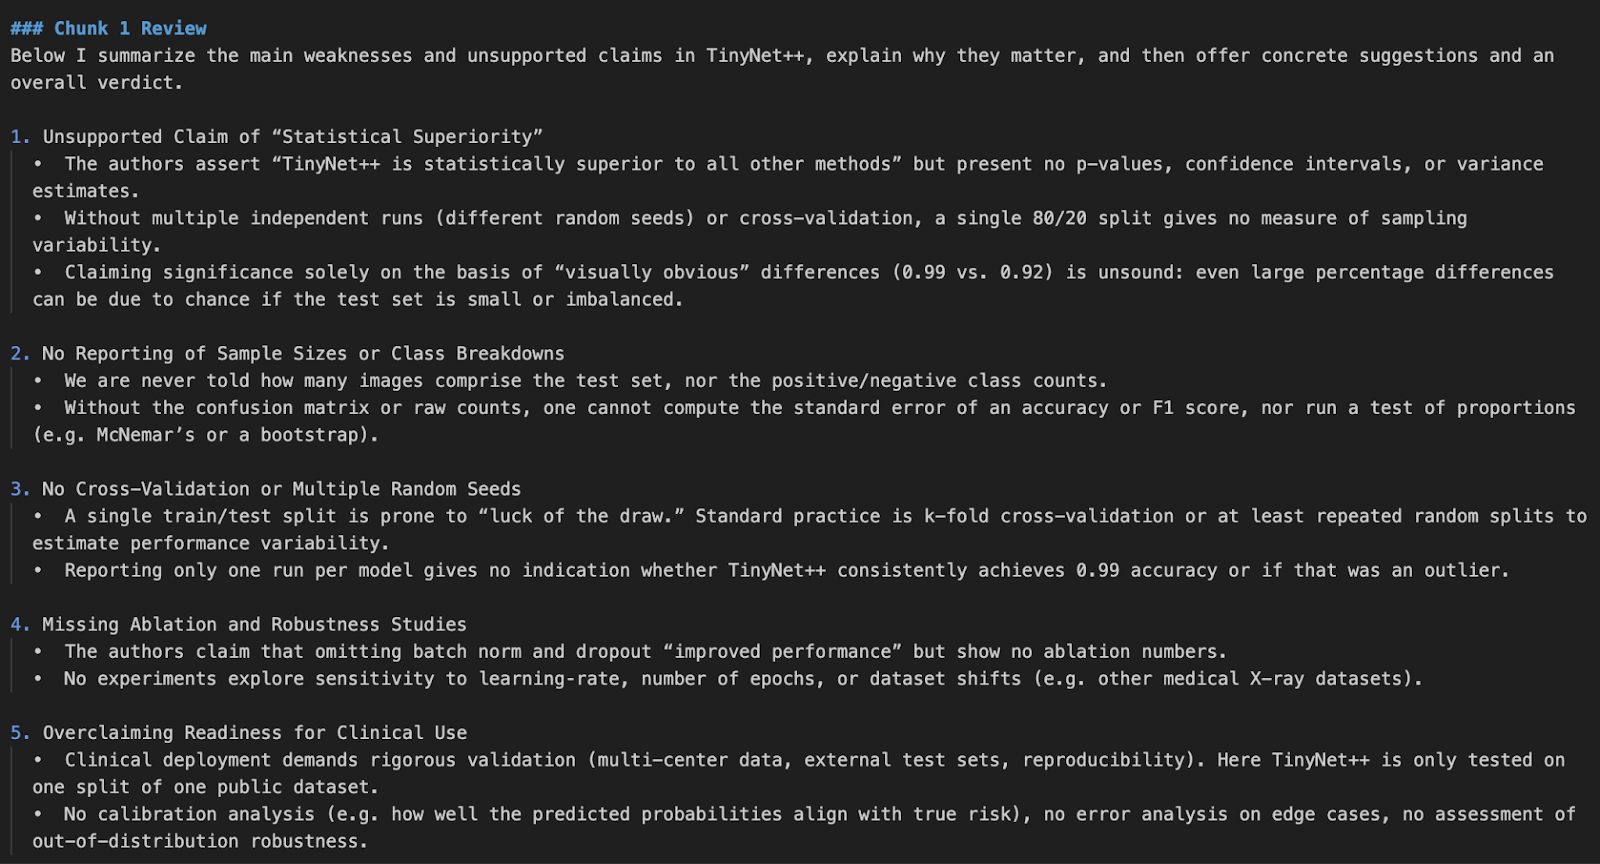
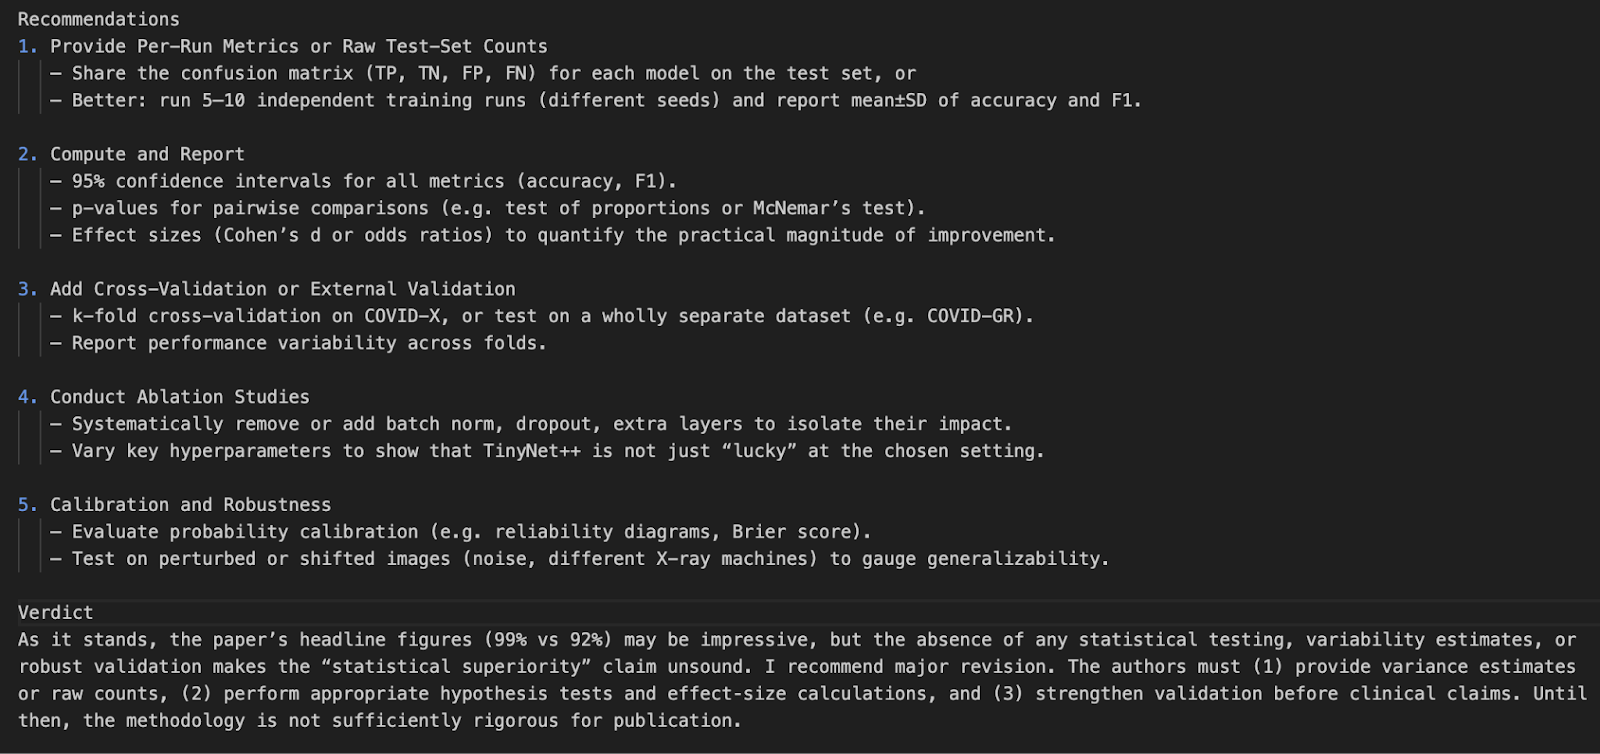
Trong dự án này, chúng ta đã tạo một trình phản biện bài báo khoa học bằng API mô hình o4-mini của OpenAI. Chúng ta đã tăng cường khả năng của mô hình bằng cách tích hợp các công cụ thống kê thời gian thực, cho phép phân tích lại p-value, khoảng tin cậy và kích thước hiệu ứng.
Bản demo này mở đường cho các tích hợp sau này với giao diện PDF, công cụ kiểm tra trích dẫn, hoặc thậm chí trợ lý nghiên cứu đa phương thức.
Để tìm hiểu thêm về các bản phát hành gần đây của OpenAI, hãy xem các blog này:
Học AI với các khóa học này!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
