
Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI’nin o4-mini modeli, akıl yürütmeye odaklanan o-serisinin en yeni üyesi. Bu eğitimde, OpenAI’nin o4-mini API’sini kullanarak bir araştırma makalesi değerlendiricisi nasıl oluşturulacağını adım adım göstereceğim. Araç şunları yapacak:
Ayrıca inceleme yardımcımızı istatistiksel araç desteğiyle güçlendireceğiz; böylece model talep üzerine p-değerleri, etki büyüklükleri ve güven aralıklarını hesaplayabilecek.
Okurlarımızı, haftanın öne çıkan haberlerini sade bir dille özetleyen ve her Cuma ücretsiz olarak gönderdiğimiz The Median bülteniyle yapay zekâdaki en son gelişmelerden haberdar ediyoruz. Abone olun, haftada yalnızca birkaç dakikada güncel kalın:
OpenAI’nin o4-mini modeli; kodlama, matematik ve bilimsel akıl yürütme gibi görevlerde derin analiz yapabilen, uygun maliyetli ve yüksek performanslı bir akıl yürütme modelidir. o3 modelinden daha küçük olmasına rağmen AIME 2024/2025 ve GPQA gibi kıyaslamalarda tutarlı biçimde son teknoloji sonuçlar elde ediyor.
Hızı ve uygun fiyatı sayesinde, araştırma makalelerini inceleme, kod açıklamaları üretme veya yarışma matematiği sorularında yardım etme gibi görevler için idealdir. Temel güçlü yönleri:
Daha fazla bilgi için o4-mini hakkında bu giriş yazısını inceleyin.
Python tabanlı, şu yeteneklere sahip bir araştırma makalesi değerlendiricisi oluşturacağız:
Bu proje tamamen yerel olarak çalışır ve OpenAI'nin API’sini kullanır.
o4-mini’yi kullanmak için OpenAI’den bir API anahtarına ihtiyacınız var. Yapmanız gerekenler:
Artık kimlik doğrulamaya ve Python’dan API çağrılarına başlamaya hazırsınız.
Önce birkaç bağımlılığı yükleyelim ve API anahtarımız için bir ortam değişkeni ayarlayalım.
pip install openai PyMuPDF tiktoken numpy
export OPENAI_API_KEY =” YOUR_KEY”Bağımlılıkları hallettiğimize göre yardımcı fonksiyonlara geçelim. Bu fonksiyonlar, gerektiğinde araç çağrılarıyla LLM tarafından tetiklenir.
Bu içe aktarımlar t-testlerini, standart hataları ve güven aralıklarını hesaplamak için kullanılır.
from scipy.stats import ttest_ind, sem, t
import numpy as npBu fonksiyon, iki bağımsız örneklem grubu arasında Welch t-testini uygular. İki grubun ortalamalarının istatistiksel olarak farklı olup olmadığını test eder.
def recalculate_p_value(group1, group2):
    t_stat, p_value = ttest_ind(group1, group2, equal_var=False)
    return {"p_value": round(p_value, 4)}
recalculate_p_value() fonksiyonu, gözlenen farkın tesadüfen meydana gelme olasılığını gösteren p-değerini dört ondalık basamağa yuvarlayarak döndürür. Bu, LLM’nin araştırma makalesindeki istatistiksel anlamlılık iddialarını doğrulamasına yardımcı olur.
Cohen’s d, iki grup arasındaki etki büyüklüğünün standartlaştırılmış bir ölçüsüdür. Önce her grubun ortalaması ve standart sapması hesaplanır. Ardından, ortalamalar arasındaki farkı normalize etmek için havuzlanmış standart sapma kullanılır.
def compute_cohens_d(group1, group2):
    mean1, mean2 = np.mean(group1), np.mean(group2)
    std1, std2 = np.std(group1, ddof=1), np.std(group2, ddof=1)
    pooled_std = np.sqrt((std1**2 + std2**2) / 2)
    d = (mean1 - mean2) / pooled_std
    return {"cohens_d": round(d, 4)}
Fonksiyon, Cohen’s d değerini dört ondalık basamağa yuvarlanmış olarak döndürür. Bu, LLM’nin grup farklarının yalnızca istatistiksel değil, pratik önemini de anlamasına yardımcı olur. Özellikle örneklem boyutu büyük olduğunda ve tek başına p-değerleri yeterince bilgilendirici olmadığında değerlidir.
Şimdi tek bir örneklem grubu için güven aralığını hesaplayan bir yardımcı fonksiyon tanımlıyoruz. Güven aralıkları, tahmini ortalamanın güvenilirliğini anlamak için kullanışlıdır; başka bir deyişle, ortalama değerin etrafındaki belirsizliğin miktarını gösterir.
def compute_confidence_interval(data, confidence=0.95):
    data = np.array(data)
    n = len(data)
    mean = np.mean(data)
    margin = sem(data) * t.ppf((1 + confidence) / 2., n-1)
    return {
        "mean": round(mean, 4),
        "confidence_interval": [round(mean - margin, 4), round(mean + margin, 4)],
        "confidence": confidence
    }
Bu fonksiyonun döndürdükleri şunlardır:
mean: Girdi verilerinin ortalama değeri.confidence_interval: Belirtilen güven düzeyine göre gerçek ortalamanın muhtemelen içinde yer aldığı alt ve üst sınırları gösteren bir liste.confidence: Aralık için kullanılan güven düzeyi.Yardımcı fonksiyonları, ortalama, standart sapma ve örneklem büyüklüğünü özetleyen basit bir yardımcıyla tamamlıyoruz.
def describe_group(data):
    data = np.array(data)
    return {
        "mean": round(np.mean(data), 4),
        "std_dev": round(np.std(data, ddof=1), 4),
        "n": len(data)
    }
Bu, LLM’nin temel veri dağılımını yorumlamasına yardımcı olur ve sonuçları değerlendirmek için gerekli bağlamı sağlar. Ortalama, standart sapma ve sayım gibi istatistiksel tanımlayıcıları sunarak, yardımcı araçlarımız modelin araştırma makalelerinde yer alan deneyler ve iddialar üzerinde akıl yürütme yeteneğini güçlendirir.
Bu bölümde, OpenAI’nin o4-mini API’sini kullanan ve istatistiksel analiz için araç desteği içeren Python tabanlı değerlendirme aracını oluşturacağız; böylece model titiz değerlendirmeler ve veriye dayalı eleştiriler yapabilecek.
Ana kodumuza, PDF içeriğini çıkarmak, belirteçlemek ve OpenAI API ile konuşmak için gerekli bazı kütüphanelerle başlıyoruz.
import os
import fitz
import openai
import json
import tiktoken
from statistics_helper import (
    recalculate_p_value,
    compute_cohens_d,
    compute_confidence_interval,
    describe_group
)
openai.api_key = os.getenv("OPENAI_API_KEY")
Şimdi tüm hattı adım adım oluşturalım.
Araştırma makalesinden ham metni okuyarak başlıyoruz. fitz kütüphanesi, tüm sayfalar üzerinde gezinmemize ve çıkarılan metni tek bir dizede birleştirmemize olanak tanır.
def extract_text_from_pdf(path):
    doc = fitz.open(path)
    full_text = "\n".join(page.get_text() for page in doc)
    return full_text
Bu temel adımı atmış oluyoruz. Şimdi modeli beslemeden önce ham metni belirteçleyip parçalara ayıracağız.
Not: Gösterim amacıyla, bilerek mantık ve deney tasarımında kusurlar içeren bir sahte araştırma makalesi oluşturdum.
LLM’lerin bağlam sınırları vardır; bu nedenle uzun belgeleri yönetilebilir parçalara böleriz. Metni modelin kodlama şemasına göre belirteçlemek için Tiktoken kullanıyoruz.
def chunk_text(text, max_tokens=12000, model="o4-mini"):
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)
    chunks = []
    for i in range(0, len(tokens), max_tokens):
        chunk = tokens[i:i + max_tokens]
        chunk_text = encoding.decode(chunk)
        chunks.append(chunk_text)
    return chunks
Nasıl çalışır:
tiktoken ile tam belge metnini, GPT-4, GPT-4o ve o4-mini gibi modern OpenAI modelleriyle uyumlu cl100k_base tokenizer kullanarak belirteçlere ayırırız.max_tokens uzunluğunda parçalara ayrılır. Bu, her parçanın modelin izin verdiği maksimum girdi boyutu içinde kalmasını sağlar; çıkarım sırasında belirteç taşması hatalarını önlemek için kritik önemdedir.encoding.decode() ile tekrar insan tarafından okunabilir metne dönüştürülür. Bu, doğal ifadeyi ve biçimlendirmeyi koruyarak modelin işlem sırasında tutarlı bağlam almasını sağlar.Bu parçalama adımı, çıkarım sırasında kesilme hatalarını önlemek için gereklidir ve taşma nedeniyle önemli metinlerin kaybolmamasını garanti eder.
Model herhangi bir harici fonksiyonu çağırmadan önce, fonksiyon adları (model tarafından görüldüğü şekliyle) ile çalıştırılacak gerçek Python fonksiyonları arasında bir eşleme tanımlamamız gerekir. Bu eşleme, modelin araç çağrıları ile yerel kod tabanımız arasında bir köprü görevi görür.
tool_function_map = {
    "recalculate_p_value": recalculate_p_value,
    "compute_cohens_d": compute_cohens_d,
    "compute_confidence_interval": compute_confidence_interval,
    "describe_group": describe_group,
}
Bu sözlükteki her anahtar, modelin araç çağrısı sırasında başvurabileceği bir fonksiyon adına; her değer ise statistics_helper modülünden içe aktarılan gerçek Python fonksiyonuna karşılık gelir.
Modelin akıl yürütmesini güçlendirmek için, LLM’nin fonksiyon çağırma yoluyla çağırabileceği araçları kaydediyoruz. Bu araçlar, p-değeri yeniden hesaplama, güven aralıkları ve etki büyüklüğü gibi istatistiksel analizleri yürütür.
tools = [
            {
                "type": "function",
                "name": "recalculate_p_value",
                "description": "Calculate p-value between two sample groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_cohens_d",
                "description": "Compute effect size (Cohen's d) between two groups",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "group1": {"type": "array", "items": {"type": "number"}},
                        "group2": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["group1", "group2"]
                }
            },
            {
                "type": "function",
                "name": "compute_confidence_interval",
                "description": "Compute confidence interval for a sample group",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}},
                        "confidence": {"type": "number", "default": 0.95}
                    },
                    "required": ["data"]
                }
            },
            {
                "type": "function",
                "name": "describe_group",
                "description": "Summarize sample mean, std deviation, and count",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "data": {"type": "array", "items": {"type": "number"}}
                    },
                    "required": ["data"]
                }
            }
        ]
Yukarıdaki araç tanımı LLM’nin şunları anlamasını sağlar:
description)name)LLM, incelemenin bağlamına göre, örneğin bir p-değerini yeniden hesaplamak gibi ne zaman bir aracı çağıracağına akıllıca karar verir. İstatistiksel bir iddia veya şüpheli bir sonuçla karşılaştığında uygun yardımcı fonksiyonu çağırabilir, çıktıyı alabilir ve akıl yürütmesine bu sonuçla devam edebilir. Bu, modelin yalnızca eleştirmekle kalmayıp aynı zamanda altta yatan veriyi de doğruladığı daha titiz ve temellendirilmiş bir analiz sağlar.
Şimdi her metin parçasını o4-mini modeline gönderen çekirdek mantığı tanımlıyoruz. Model bir araç çağırırsa, fonksiyon çağrısını ele alıp konuşmayı sürdürüyoruz.
def review_text_chunk(chunk):
    try:
        response = client.responses.create(
            model="o4-mini",
            reasoning={"effort": "high"},
            input=[
                {
                    "role": "system",
                    "content": (
                        "You are an expert AI research reviewer. Read the given chunk of a research paper and highlight weak arguments."
                        "unsupported claims, or flawed methodology. You can request tools to: Recalculate p-values, Compute confidence intervals, "
                        "Estimate effect size (Cohen's d), Describe sample statistics. Be rigorous and explain your reasoning. "
                        "Conclude with suggestions and a verdict."
                    )
                },
                {
                    "role": "user",
                    "content": chunk
                }
            ],
            tools = tools,
        )
        # Check for tool calls
        for item in response.output:
            if getattr(item, "type", None) == "function_call":
                fn_call = getattr(item, "function_call", {})
                fn_name = getattr(fn_call, "name", "")
                args = getattr(fn_call, "arguments", {})
                if fn_name in tool_function_map:
                    tool_result = tool_function_map[fn_name](**args)
                    # Send back tool result as continuation input
                    tool_response = client.responses.create(
                        model="o4-mini",
                        reasoning={"effort": "high"},
                        input=[
                            *response.output,
                            {
                                "role": "tool",
                                "name": fn_name,
                                "content": str(tool_result)
                            }
                        ],
                        max_output_tokens=3000
                    )
                    if hasattr(tool_response, "output_text") and tool_response.output_text:
                        return tool_response.output_text.strip()
        # If no tool was called, return original response
        if hasattr(response, "output_text") and response.output_text:
            return response.output_text.strip()
        if response.status == "incomplete":
            reason = getattr(response.incomplete_details, "reason", "unknown")
            return f" Incomplete response: {reason}"
        return " No valid output returned by the model."
    except Exception as e:
        return f" Error during chunk review: {e}"
review_text_chunk fonksiyonu, her bir makale parçasını sistem mesajı ve araç kaydıyla birlikte LLM’e göndermekten sorumludur. Adım adım işleyişi:
Responses API’yi kullanan client.responses.create() fonksiyonuyla modele gönderilir. Bu çağrıda:
"o4-mini" olarak ayarlanır ve reasoning={"effort": "high"} bayrağı yüksek olarak belirlenir; bu da ayrıntılı çok adımlı iç düşünmeyi teşvik eder. Bu ayar, modelin nihai yanıt üretmeden önce ne kadar derin “düşünmesi” gerektiğini belirtir ve modele ayrılan iç akıl yürütme belirteci sayısını ayarlar.tool_choice="auto" ayarına gerek yoktur; Responses API araç kullanımına otomatik karar verir.responses.create metoduna ikinci bir çağrıyla modele geri göndeririz. Bu, akıl yürütme sürecinin devamını simüle eder.Bu çok adımlı akıl yürütme ve doğrulama mekanizması, modele titiz inceleme yeteneği kazandırır. Bir insan değerlendiricinin bir sorunu fark edip hızlı bir hesaplama yapması ve geri bildirimini buna göre ayarlaması sürecini taklit eder.
Tüm bileşenler hazır olduğunda, tüm bir PDF’yi işlemek için bu fonksiyonu kullanırız. Her şeyi birbirine bağlar.
def review_full_pdf(pdf_path):
    raw_text = extract_text_from_pdf(pdf_path)
    chunks = chunk_text(raw_text)
    print(f"\n Extracted {len(chunks)} chunks from PDF\n")
    all_reviews = []
    for idx, chunk in enumerate(chunks):
        print(f"\n  Reviewing Chunk {idx + 1}/{len(chunks)}...")
        review = review_text_chunk(chunk)
        all_reviews.append(f"### Chunk {idx + 1} Review\n{review}")
    full_review = "\n\n".join(all_reviews)
    return full_review
Bu fonksiyon, tüm bir araştırma makalesini değerlendirmek için sarmalayıcı görevi görür:
Şimdi betiğin giriş noktasını tanımlıyoruz. Bu sayede program, bir PDF dosya yolu girdisiyle doğrudan terminalden çalıştırılabilir.
if __name__ == "__main__":
    import argparse
    parser = argparse.ArgumentParser(description="Review an academic paper PDF for weak arguments.")
    parser.add_argument("pdf_path", type=str, help="Path to the research paper PDF")
    args = parser.parse_args()
    review_output = review_full_pdf(args.pdf_path)
    print("\n Final Aggregated Review:\n")
    print(review_output)
    with open("paper_review_output.md", "w") as f:
        f.write(review_output)
    print("\n Review saved to paper_review_output.md")
Bu blok şunları yapar:
argparse kullanarak PDF yolunu komut satırı argümanı olarak alır.review_full_pdf() fonksiyonunu çağırarak tam incelemeyi üretir.paper_review_output.md) kaydeder.Bu kodu çalıştırmak için terminalde şu komutu yazın:
python pdf_reviewer_assistant.py Fake_paper.pdf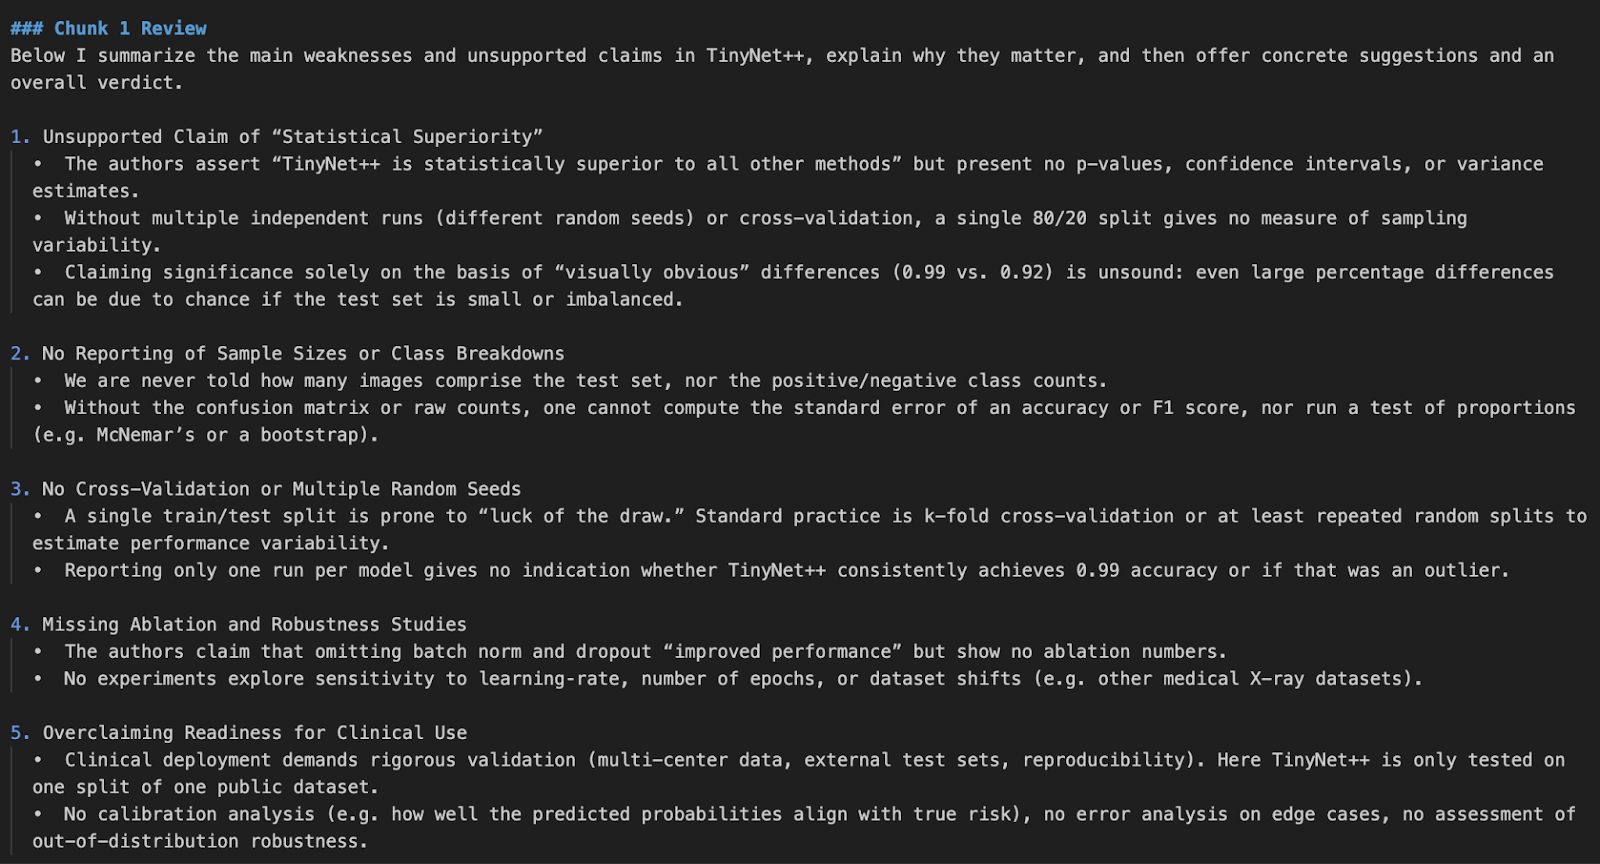
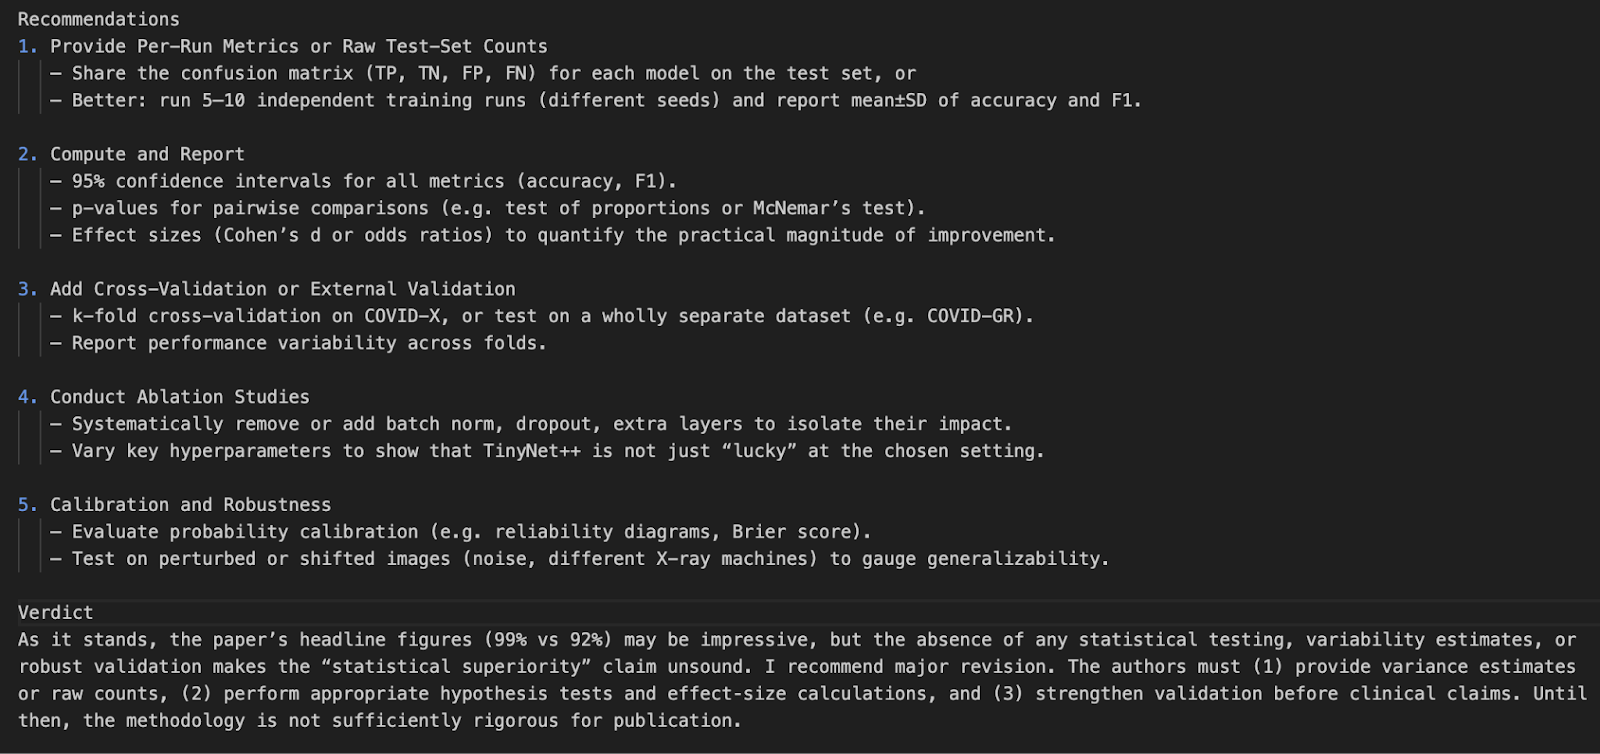
Bu projede, OpenAI’nin o4-mini model API’sini kullanarak bir araştırma makalesi değerlendiricisi oluşturduk. Modele gerçek zamanlı istatistiksel araçlar entegre ederek p-değerleri, güven aralıkları ve etki büyüklüklerini yeniden analiz etmesini sağladık.
Bu demo, PDF arayüzleri, atıf denetleyicileri veya hatta çok modlu araştırma asistanı araçlarıyla yapılacak gelecekteki entegrasyonlara zemin hazırlar.
Son OpenAI sürümleri hakkında daha fazla bilgi edinmek için şu bloglara göz atın:
Bu kurslarla yapay zekâyı öğrenin!
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




