
Kursus
Claude 101
2 Hr
21.4K
Dalam tutorial ini, saya akan menguji sebuah skenario: Beberapa menit setelah pembaruan perangkat lunak, HarborCart — toko yang akan saya gunakan untuk skenario ini — mulai mengalami kegagalan checkout. Sebagian pelanggan menunggu lebih dari 30 detik; yang lain melihat kesalahan server dan tidak bisa membayar. Penyedia pembayaran juga mengalami gangguan singkat, sehingga terlihat seperti penyebab yang jelas.
Namun gangguan penyedia tidak menjelaskan mengapa halaman keranjang dan pesanan juga ikut gagal. Menemukan kaitan yang hilang memerlukan log aplikasi, grafik, catatan permintaan, dan perubahan kode terbaru. Tutorial ini menguji apakah Claude Opus 5.5 dapat mengikuti bukti tersebut, menguji penjelasannya dalam kondisi terkontrol, dan hanya melaporkan apa yang didukung oleh bukti.
Sedikit latar belakang: Claude Opus 5.5 hadir awal pekan itu, tepat sebelum saya memulai proyek ini. Tinjauan Claude Opus 5.5 kami membahas peluncuran dan tolok ukur, jadi tutorial ini berfokus pada API dan membangun satu agen investigasi dari permintaan pertama hingga laporan terverifikasi.
Kita akan membahas cara:
Investigator HarborCart memisahkan lonjakan gateway pembayaran dari kebijakan retry yang memperkuatnya, lalu menguji penjelasan itu sebelum mengembalikan laporan.
Anda mengakses Claude Opus 5.5 melalui Messages API milik Anthropic dengan ID model claude-opus-5-5. Sesuai ikhtisar model, model ini menerima teks dan gambar, dengan jendela konteks 1M token dan output maksimum 128K. Adaptive thinking selalu aktif, dan effort bawaan adalah medium.
Harga standar adalah $4 per sejuta token input dan $20 per sejuta token output. Penulisan cache lima menit berbiaya $5 per sejuta dan pembacaan cache $0,20. Setelah prompt caching aktif, prefiks yang cocok ditagihkan pada tarif baca-cache yang lebih rendah itu.
Empat poin dari panduan migrasi terlihat langsung dalam proyek ini.
Pemaksaan tool_choice dengan any atau alat bernama mengembalikan error 400.
Effort bawaan turun dari high pada Claude Opus 5 menjadi medium.
Thinking tidak dapat dimatikan, dan blok thinking harus dikembalikan apa adanya di dalam loop alat.
Catatan yang ditulis model di antara pemanggilan alat tiba di dalam blok thinking, yang secara default kosong.
Agen hanya melakukan investigasi. Agen mendapatkan alat bukti hanya-baca dan tidak memiliki kredensial produksi. Setelah pengumpulan bukti, permintaan perencanaan terpisah mengusulkan pengujian kontrafaktual, dan Python memvalidasi serta menjalankan rencana effort medium.
Kode lengkap, generator bukti, dan aplikasi web tersedia di repositori GitHub ini.
HarborCart adalah toko fiksi. checkout-api-nya melayani halaman keranjang, status pesanan, dan POST /checkout, yang menagih ke gateway pembayaran pihak ketiga. Semua endpoint tersebut berbagi satu pool PostgreSQL berisi 15 koneksi per instance.
Sebuah deploy rilis, dan lima menit kemudian gateway mengembalikan 503 selama sekitar 90 detik. Latensi checkout naik melewati 30 detik saat pool berada di 15 dari 15. Menyalahkan penyedia pembayaran adalah keputusan mudah, dan gateway memang gagal.
Penyebab tersembunyinya satu langkah lebih dalam. Deploy mengizinkan tagihan POST yang gagal untuk retry hingga tiga kali, total empat percobaan tagihan, tanpa jeda saat handler masih memegang koneksi basis data. Tagihan gagal yang lambat kini menahan koneksi selama 30 detik atau lebih, hingga pool habis dan halaman keranjang yang tidak pernah memanggil gateway pun ikut gagal.
Saya menggunakan tiga istilah secara konsisten mulai di sini. Di sini, pemicu adalah kegagalan gateway sementara. Melakukan retry pada POST checkout sambil menahan koneksi basis data yang langka adalah mekanisme amplifikasi; kehabisan pool koneksi bersama adalah kegagalan sistem.
Agen memulai dengan peringatan, tangkapan layar pemantauan, dan diagram arsitektur. Sisanya masuk melalui alat: log, trace, lima metrik, metadata deployment, Git diff, dan runbook. Tiga penjelasan yang saling bersaing disisipkan ke dalam bukti: peringatan inventaris, peringatan frontend, dan kemungkinan saturasi CPU.
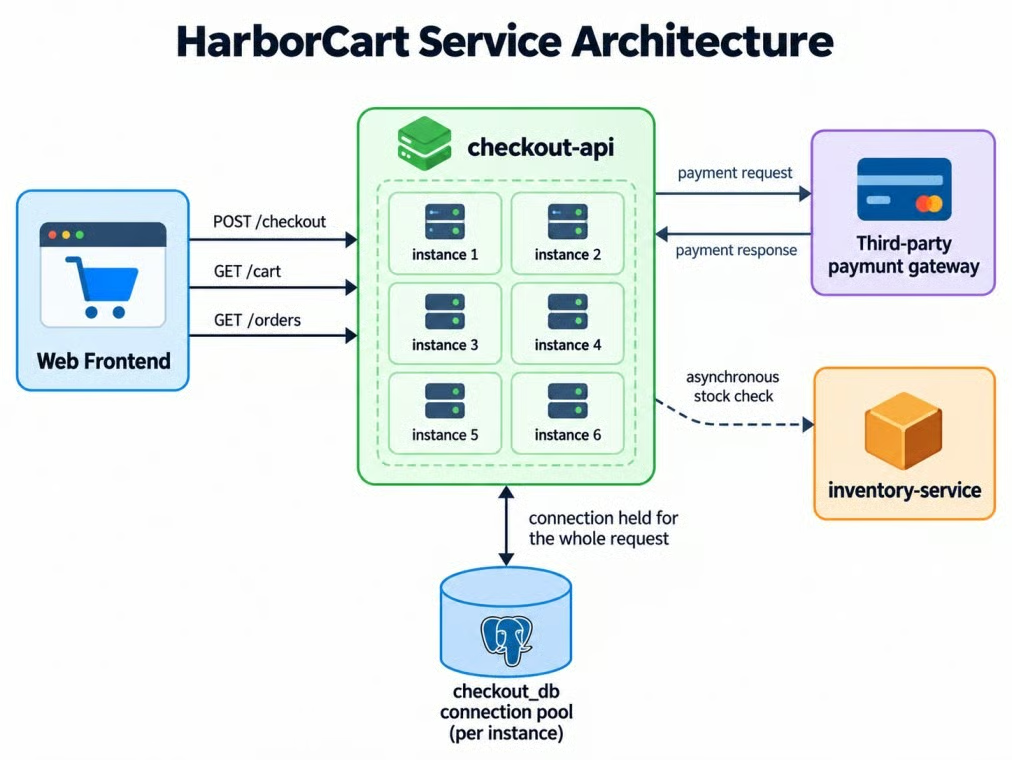
Jalur checkout HarborCart dan pool bersama. Gambar oleh Penulis.
Diagram menyatakan koneksi ditahan sepanjang permintaan. Diagram tidak menyatakan itu masalah; investigasi harus menyimpulkannya.
Tentukan keberhasilan sebelum membangun agen. Laporan yang benar harus:
POSTAnda memerlukan Python 3.10 atau lebih baru dan kunci API Anthropic dengan akses ke claude-opus-5-5. Perintah PowerShell ini mengkloning proyek dan memasang dependensi yang dipatok versinya, termasuk anthropic 1.8.0. Jika Anda menggunakan Amazon Bedrock, baca FAQ terlebih dahulu, karena beberapa fitur tidak dapat dipindahkan.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Di macOS atau Linux, aktifkan dengan source .venv/bin/activate dan salin dengan cp .env.example .env. Tambahkan kunci Anda ke .env, dan python-dotenv akan memuatnya untuk SDK; panduan variabel lingkungan kami menjelaskan polanya. Jika Anda sudah pernah memanggil Claude dari Python, lewati subbagian berikut, karena hanya untuk konfirmasi penyiapan.
Permintaan terkecil yang berguna mengonfirmasi kunci dan menunjukkan apa yang kembali.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
Dalam permintaan ini, respons berisi blok thinking dan text. Pilih blok berdasarkan tipe alih-alih membaca response.content[0].
Agen pemanggil alat memasangkan Messages API Claude dengan fungsi Python yang mengontrol akses data. Aplikasi mengikuti satu aturan: Claude memutuskan bukti apa yang dibutuhkan, dan Python memutuskan apa yang boleh diakses.
Panduan rekayasa harness agen kami membahas batasan alat yang lebih luas dan loop; HarborCart menjaga alatnya hanya-baca dan terbatas pada insiden ini.
Setiap alat membaca satu set bukti tetap dan mengembalikan hasil JSON yang terbatas. Kueri log dan trace mengembalikan maksimal 200 baris plus hitungan, dan kueri metrik mengembalikan maksimal 60 titik.
Pemanggilan alat terprogram tidak mendukung strict: true, jadi pisahkan alat menjadi dua. Pertahankan kontrol bukti dan alat penghenti investigasi tetap ketat dan hanya langsung. Log, trace, dan metrik hanya menggunakan eksekusi kode, yang memberi Claude satu jalur jelas untuk kueri bukti berukuran besar.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers membimbing model namun bukan batas keamanan. Python memeriksa pemanggil sebelum mengeksekusi setiap alat dan menolak panggilan kueri langsung. Panggilan terprogram juga melewati validasi ketat, sehingga fungsi kueri tetap memvalidasi argumennya sendiri.
Aplikasi menandai setiap hasil alat yang diterima, menolak temuan yang mengutip bukti yang tidak ada, dan menerima URL dokumentasi hanya saat pencarian web mengembalikannya. Python, bukan model, yang merekam output pemutaran ulang.
Seperti disebutkan di bagian migrasi, biarkan tool_choice pada auto. Nyatakan dalam prompt kapan alat berlaku, dan gunakan skema ketat saat argumen harus persis.
Loop mengirim percakapan, menjalankan blok tool_use apa pun, menambahkan hasilnya, dan mengulang. Tambahkan blok asisten tanpa perubahan, termasuk thinking, dan saat kode terprogram dijeda, teruskan ID container kembali hanya dengan blok tool_result.
Permintaan investigasi menyertakan visi, alat, pencarian web, effort, dan anggaran tugas, tetapi tanpa skema output. Ini menjaga hasil pencarian yang memiliki sitat tetap terpisah dari output JSON terstruktur, sementara prefiks permintaan yang stabil menjaga prompt caching tetap aktif:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Lampirkan dasbor dan diagram arsitektur pada pesan pengguna pertama sebagai PNG base64. Beri tahu Claude untuk memperlakukan apa pun yang dibacanya dari gambar sebagai hipotesis dan mengonfirmasinya dengan query_metrics.
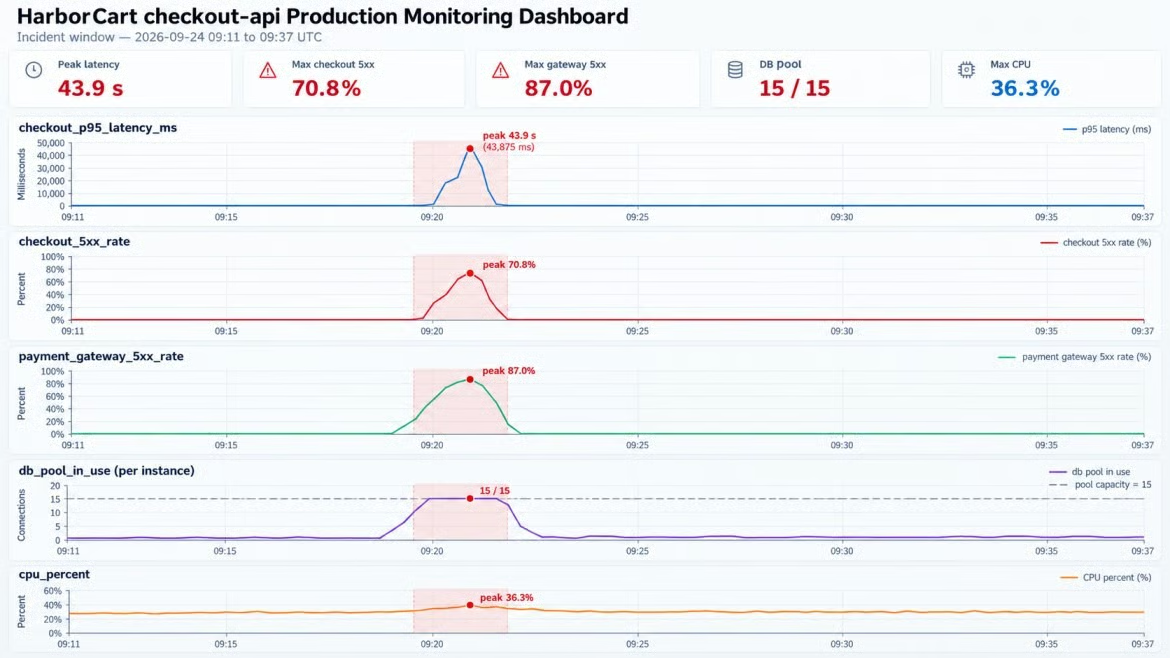
Dasbor menunjukkan saturasi pool, CPU datar. Gambar oleh Penulis.
Baik dasbor maupun kueri metrik menggunakan sumber data yang sama. CPU tetap sekitar 30% saat pool penuh, yang menyangkal "host sedang kelebihan beban" bahkan sebelum kueri apa pun dijalankan.
Tangkapan layar menunjukkan arah pencarian, tetapi deret numerik yang menentukan apakah pengamatan bertahan. Visi menghasilkan hipotesis; metrik mengujinya.
Untuk alur kerja yang berawal dari gambar, lihat tutorial visi agentik kami. HarborCart menggunakan visi hanya untuk memilih metrik berikutnya.
Pemanggilan alat terprogram memungkinkan Claude menulis Python yang berjalan dalam container eksekusi kode dan memanggil alat Anda sebagai fungsi. Hasil mentah tetap di sandbox, dan hanya output yang dicetak kode yang mencapai model.
Agen menulis skrip pendek yang mengambil trace yang gagal dan hanya mencetak hitungan per endpoint. Dalam satu investigasi lengkap, pemanggilan alat terprogram mengurangi bukti terserialisasi yang dikembalikan ke model sebesar 98,8%. Hasil alat 42,9 KB dan ringkasan 0,5 KB, ukuran byte alih-alih penghematan token input yang ditagihkan.
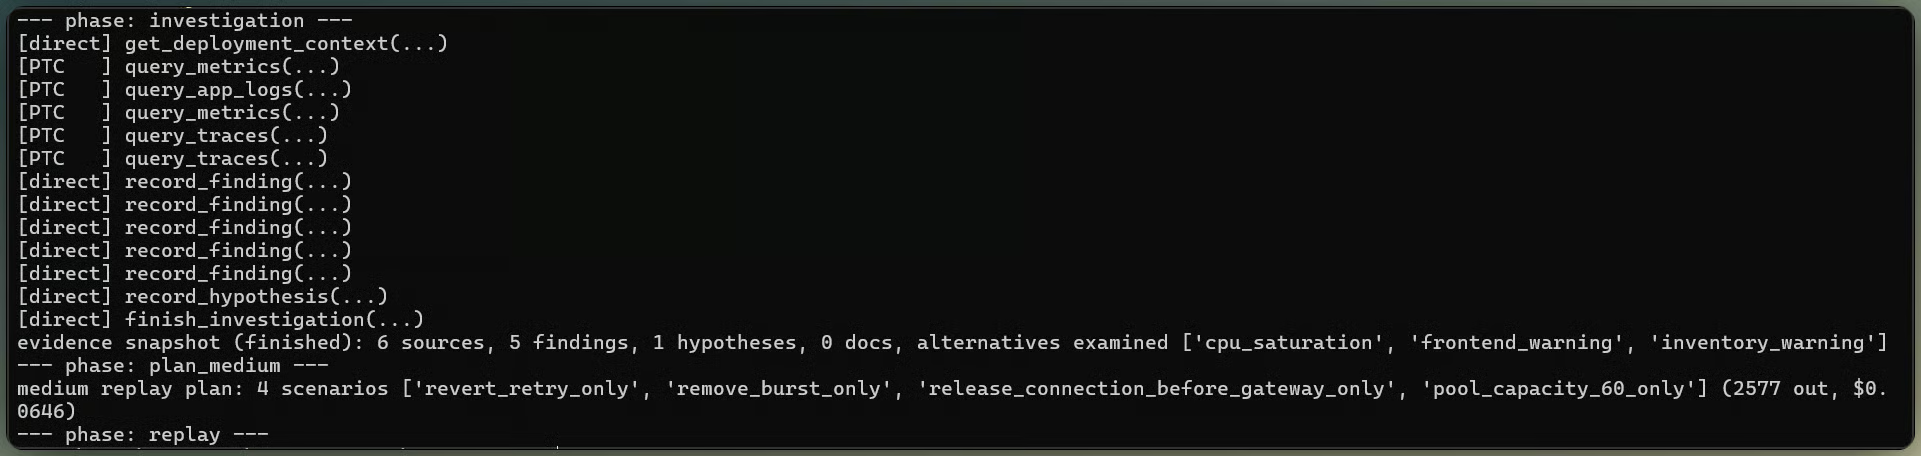
Panggilan alat mempersempit bukti insiden. Gambar oleh Penulis.
Aplikasi mengekspos pencarian web terbatas untuk semantik library retry. Claude tidak memanggilnya selama evaluasi akhir, jadi diagnosis yang diukur bertumpu pada diff, metrik, log, dan trace. Referensi urllib3 secara independen mengonfirmasi bahwa allowed_methods=None me-retry metode apa pun dan backoff_factor=0 menghapus jeda, tetapi halaman itu bukan bagian dari bukti terukur.
Pemutaran ulang kontrafaktual menjalankan ulang trafik insiden dengan satu penyebab yang dicurigai dihapus dan memeriksa apakah kegagalan hilang. Ini mengubah "garis-garis ini naik bersama" menjadi sebuah pengujian.
Pemutaran ulang menggunakan kembali pola trafik yang sama. Untuk perbandingan di bawah, tiap skenario mengubah satu kondisi, dan aplikasi mengontrol perubahan mana yang diizinkan.
Ringkasannya memisahkan 503 gateway dari timeout pool, dan 503 checkout dari pembacaan keranjang serta pesanan. Pemisahan itulah yang memungkinkan model membedakan pemicu dari penguat.
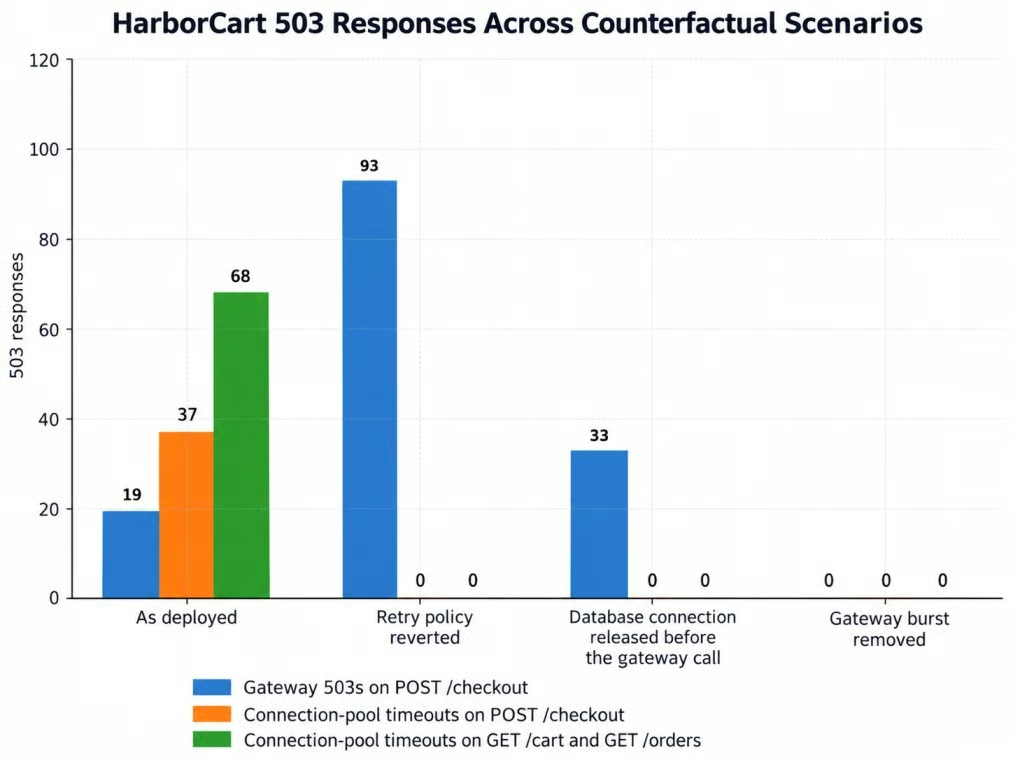
Setiap pemutaran ulang mengubah tepat satu hal. Gambar oleh Penulis.
Pemutaran ulang baseline menghasilkan 124 kali 503: 105 timeout pool, termasuk 68 kegagalan pada endpoint baca, dan 19 kesalahan gateway. Mengembalikan kebijakan retry menghapus semua timeout pool dan kegagalan baca tetapi memunculkan 93 kali 503 gateway pada checkout. Melepas koneksi sebelum panggilan gateway juga menghapus kegagalan pool sambil menyisakan 33 kali 503 gateway, dan menghapus lonjakan gateway menghasilkan tanpa kesalahan.
Pemutaran ulang memperlihatkan trade-off: rollback melindungi pool bersama tetapi membiarkan lebih banyak kegagalan checkout. Gunakan sebagai langkah sementara. Lalu tambahkan idempotency key agar tagihan berulang tidak menagih dua kali, dan hentikan penahanan koneksi selama panggilan gateway.
Prompt sistem meminta pemutaran ulang, tetapi prompt bukan mekanisme penegakan. Loop memeriksa apakah bukti pemutaran ulang ada dan menolak diagnosis yang tidak diuji.
Simpan pemeriksaan ini di Python. Prompt yang lebih tajam mungkin meningkatkan kepatuhan, tetapi tidak bisa menjaminnya.
Effort menentukan seberapa banyak Claude bernalar per langkah, dan anggaran tugas menentukan seberapa banyak pekerjaan yang harus dilakukan seluruh loop. Tutorial API Claude Opus 5 kami membandingkan kelima level effort; di sini, medium dan high menerima bukti pra-pemutaran ulang yang sama.
Produksi tetap di medium. Sebelum pemutaran ulang, aplikasi meminta effort medium dan high untuk merancang uji kausal dari bukti yang sama. Aplikasi hanya mengeksekusi rekomendasi medium; respons high hanya untuk perbandingan.
Permintaan high menggunakan perubahan output_config.effort per-pesan di balik mid-conversation-output-config-2026-07-01. Permintaan high tidak melihat jawaban medium.
Kedua level effort memilih hipotesis yang sama dan tiga skenario pemutaran ulang inti yang sama. High menggunakan rata-rata 2.631 token output dibanding 2.307 pada medium, dan berbiaya sekitar 11% lebih tinggi tanpa mengubah uji kausal.
Pilih anggaran tugas dari penggunaan yang diamati alih-alih menebak. Investigasi terbesar HarborCart tanpa batasan mengonsumsi 13.322 token terhitung, termasuk output model dan teks hasil alat yang dilihat Claude. Menambahkan margin 25% menjadi 16.653, di bawah minimum 20.000 token dari Anthropic, sehingga anggaran yang dikonfigurasi adalah 20.000.
Pertahankan jumlah giliran dan waktu berlalu sebagai batas aplikasi. Runner eksperimen berhenti memulai pekerjaan baru setelah pengeluaran tercatat mencapai $2,50. Ini bukan batas keras karena permintaan yang sudah berjalan dapat selesai di atasnya.
Jawaban akhir menggunakan output terstruktur. Skema datarnya mencakup putusan, penyebab, hipotesis yang ditolak, bukti, dan perbaikan. Biaya dan latensi tidak disertakan karena diukur oleh aplikasi.
Sitat pencarian web dan output_config.format tidak dapat berbagi satu permintaan: sitat memerlukan blok konten yang saling disisipkan, sedangkan skema memerlukan JSON. Karena itu, HarborCart melakukan investigasi tanpa skema output. HarborCart menyimpan temuan yang diikat ke sumbernya dan hasil pemutaran ulang, lalu hanya mengirim bukti terverifikasi tersebut ke permintaan kedua tanpa alat atau pencarian web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
Permintaan kedua hanya memerlukan bukti terverifikasi, sehingga tidak perlu melestarikan cache investigasi penuh.
Izinkan "inconclusive" pada kolom verdict. Sebuah laporan tidak boleh dipaksa menjadi diagnosis terverifikasi ketika pemutaran ulang bertentangan dengan penjelasannya.
Skema memvalidasi bentuk laporan, sedangkan pemutaran ulang memvalidasi diagnosis. Penolakan juga mengembalikan HTTP 200 dengan stop_reason: "refusal" dan mungkin tidak cocok dengan skema Anda, jadi periksa alasan penghentian sebelum mengurai.
Ketiga laporan akhir menemukan mekanisme kausal inti dan menyingkirkan tiga penjelasan alternatif. Dua memenuhi delapan pemeriksaan; yang ketiga mendapat skor 6/8 karena tidak menyebutkan perubahan konfigurasi retry POST secara eksplisit dan tidak mengutip deployment diff. Itulah mengapa penilaian offline tetap terpisah dari validasi skema: JSON valid dan diagnosis yang tepat masih dapat menghasilkan laporan yang tidak lengkap.
Laporan juga mengidentifikasi risiko kedua: me-retry tagihan dapat menagih pelanggan dua kali. RFC 9110 tidak mendefinisikan POST sebagai idempoten secara inheren dan menyarankan untuk tidak melakukan retry otomatis kecuali klien mengetahui operasi aman diulang. Idempotency key yang didukung penyedia pembayaran adalah cara umum untuk membuat retry tersebut lebih aman.
Tutorial Streamlit kami membahas penyiapan antarmuka. Antarmuka HarborCart menampilkan peristiwa investigasi, rencana pemutaran ulang medium dan high, hasil pemutaran ulang, laporan akhir, dan biaya. Untuk status di antara panggilan alat, panduan prompting Claude Opus 5.5 menjelaskan display: "updates"; aplikasi juga merender peristiwa alat ketika blok pembaruan kosong.
Belajar bersama DataCamp
Kursus
Kursus
Kursus