¡Última oportunidad! 50 % de descuento en todo
La oferta termina dentro de
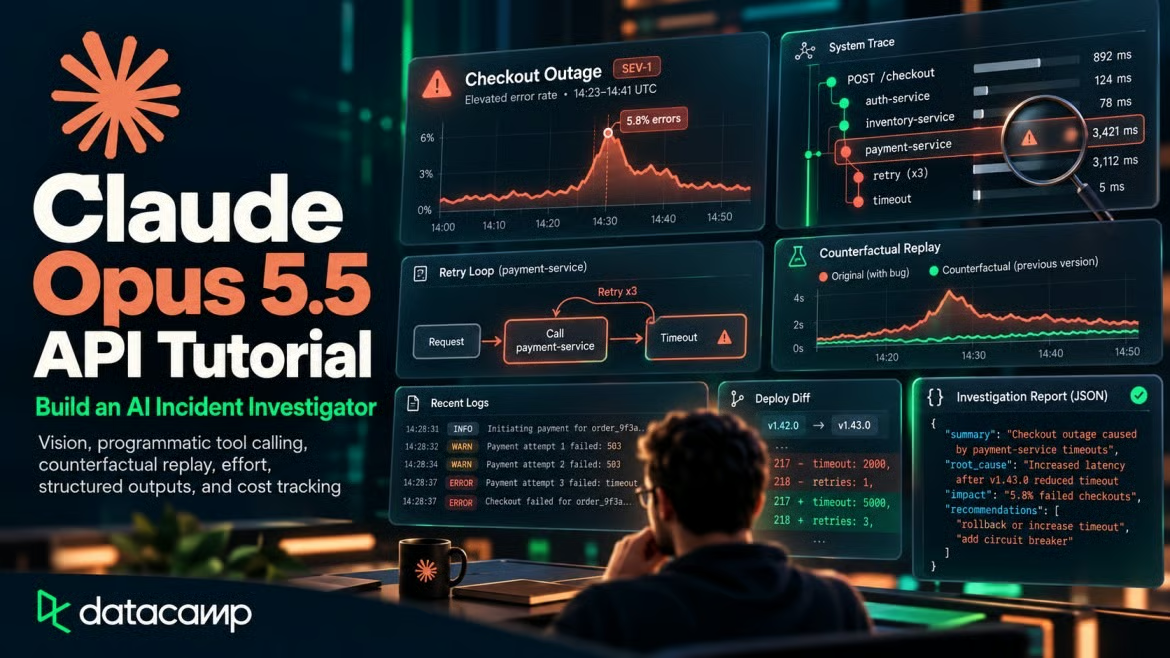
En este tutorial probaré un escenario: pocos minutos después de una actualización de software, HarborCart —una tienda ficticia que usaré aquí— empieza a registrar fallos en el checkout. Algunos clientes esperan más de 30 segundos; otros ven un error de servidor y no pueden pagar. El proveedor de pagos también sufre una breve caída, así que parece la causa evidente.
Pero la caída del proveedor no explica por qué también fallan las páginas del carrito y de pedidos. Para encontrar el eslabón perdido hacen falta logs de aplicación, gráficos, registros de peticiones y el cambio de código reciente. Este tutorial comprueba si Claude Opus 5.5 puede seguir esas pistas, poner a prueba su explicación en condiciones controladas y reportar solo lo que respalda la evidencia.
Un poco de contexto: Claude Opus 5.5 llegó a principios de esa semana, justo antes de que empezara este proyecto. Nuestro resumen de Claude Opus 5.5 cubre el lanzamiento y los benchmarks, así que aquí nos centramos en la API y construimos un agente de investigación de principio a fin: de la primera petición a un informe verificado.
Verás cómo:
El investigador de HarborCart separó el pico del gateway de pagos de la política de reintentos que lo amplificó, lo comprobó y luego devolvió un informe.
Accedes a Claude Opus 5.5 a través de la Messages API de Anthropic con el ID de modelo claude-opus-5-5. Según la visión general del modelo, admite texto e imágenes, con una ventana de contexto de 1M tokens y un máximo de salida de 128K. El razonamiento adaptativo está siempre activo y el effort por defecto es medium.
La tarifa estándar es de 4 $ por millón de tokens de entrada y 20 $ por millón de tokens de salida. Las escrituras en caché de cinco minutos cuestan 5 $ por millón y las lecturas 0,20 $. Una vez activado el almacenamiento en caché del prompt, los prefijos coincidentes se facturan a esa tarifa reducida de lectura de caché.
Cuatro puntos de la guía de migración aparecen directamente en este proyecto.
Forzar tool_choice con any o con una herramienta nombrada devuelve un error 400.
El effort por defecto bajó de high en Claude Opus 5 a medium.
El thinking no se puede desactivar y los bloques thinking deben devolverse sin cambios dentro de un bucle de herramientas.
Las notas que el modelo escribe entre llamadas a herramientas llegan dentro de bloques thinking, que están vacíos por defecto.
El agente solo investiga. Tiene herramientas de evidencia de solo lectura y ninguna credencial de producción. Tras recopilar la evidencia, peticiones de planificación separadas proponen pruebas contrafactuales, y Python valida y ejecuta el plan con effort medio.
El código completo, incluido el generador de evidencia y la app web, está en este repositorio de GitHub.
HarborCart es una tienda ficticia. Su checkout-api sirve las páginas del carrito, el estado de pedidos y POST /checkout, que carga a un gateway de pagos de terceros. Todos esos endpoints comparten un pool de 15 conexiones a PostgreSQL por instancia.
Se hace un despliegue y, cinco minutos después, el gateway devuelve 503 durante unos 90 segundos. La latencia del checkout supera los 30 segundos mientras el pool está al 15 de 15. Culpar al proveedor de pagos es lo fácil, y el gateway realmente falló.
La causa oculta va un paso más allá. El despliegue permitió que los cargos POST fallidos se reintentaran hasta tres veces, cuatro intentos en total, sin pausa mientras el handler mantiene su conexión a la base de datos. Ahora, los cargos que fallan lentamente retienen conexiones durante 30 segundos o más, hasta que el pool se agota y también fallan las páginas del carrito que nunca llaman al gateway.
Usaré tres términos de forma consistente a partir de aquí. El desencadenante es la caída temporal del gateway. Reintentar POST de checkout mientras se retienen conexiones de base de datos escasas es el mecanismo de amplificación; el agotamiento del pool de conexiones compartido es el fallo del sistema.
El agente empieza con la alerta, una captura del sistema de monitorización y un diagrama de arquitectura. Todo lo demás llega por herramientas: logs, trazas, cinco métricas, metadatos de despliegue, el diff de Git y un runbook. Se integran tres explicaciones alternativas como cebo en la evidencia: un aviso de inventario, un aviso del frontend y una posible saturación de CPU.
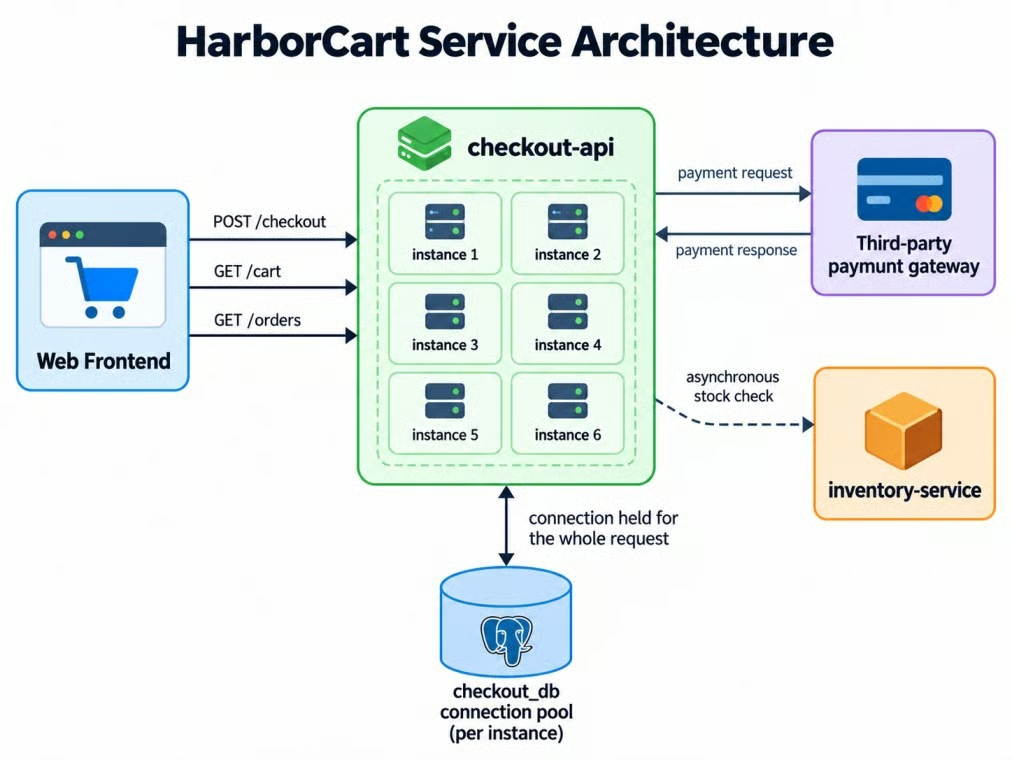
Ruta de checkout de HarborCart y pool compartido. Imagen del autor.
El diagrama indica que la conexión se mantiene durante toda la petición. No dice que sea un problema; la investigación tiene que deducirlo.
Define el éxito antes de construir el agente. Un informe correcto debe:
POSTNecesitas Python 3.10 o superior y una clave de la API de Anthropic con acceso a claude-opus-5-5. Estos comandos de PowerShell clonan el proyecto e instalan sus dependencias fijadas, incluida anthropic 1.8.0. Si usas Amazon Bedrock, lee primero las FAQs, porque varias funciones no son portables.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
En macOS o Linux, activa con source .venv/bin/activate y copia con cp .env.example .env. Añade tu clave a .env, y python-dotenv la cargará para el SDK; nuestra guía de variables de entorno explica el patrón. Si ya llamaste a Claude desde Python, salta la siguiente subsección: solo confirma la configuración.
La petición útil más pequeña confirma la clave y muestra qué vuelve.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
En esta petición, la respuesta contiene bloques thinking y text. Selecciona los bloques por tipo en lugar de leer response.content[0].
Los agentes con llamadas a herramientas combinan la Messages API de Claude con funciones de Python que controlan el acceso a los datos. La aplicación sigue una regla: Claude decide qué evidencia necesita y Python decide a qué puede acceder.
Nuestra guía de ingeniería del arnés de agentes cubre límites de herramientas y bucles más amplios; HarborCart mantiene sus herramientas de solo lectura y limitadas a este incidente.
Cada herramienta lee un conjunto fijo de evidencias y devuelve un resultado JSON limitado. Las consultas de logs y trazas devuelven como máximo 200 filas más un recuento, y las consultas de métricas devuelven como máximo 60 puntos.
Las llamadas programáticas a herramientas no admiten strict: true, así que divide las herramientas en dos. Mantén estrictos y de llamada directa los controles de evidencia y la herramienta que detiene la investigación. Logs, trazas y métricas usan solo ejecución de código, lo que da a Claude una ruta clara para consultas de evidencia grandes.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers orienta al modelo pero no es un límite de seguridad. Python comprueba el llamador antes de ejecutar cada herramienta y rechaza una llamada directa a consultas. Las llamadas programáticas también omiten la validación estricta, así que las funciones de consulta siguen validando sus propios argumentos.
La aplicación etiqueta cada resultado de herramienta aceptado, rechaza hallazgos que citen evidencia faltante y acepta URLs de documentación solo cuando la búsqueda web las devolvió. Python, no el modelo, registra las salidas de las repeticiones.
Como se señaló en la sección de migración, deja tool_choice en auto. Indica en el prompt cuándo aplica una herramienta y usa esquemas estrictos cuando los argumentos deben ser exactos.
El bucle envía la conversación, ejecuta los bloques de tool_use, añade los resultados y repite. Añade sin cambios los bloques del asistente, incluido el thinking, y mientras el código programático está en pausa, devuelve el ID de container solo con bloques tool_result.
La petición de investigación incluye visión, herramientas, búsqueda web, effort y presupuesto de tarea, pero no un esquema de salida. Así evitamos que resultados con citas de búsqueda se mezclen con salidas JSON estructuradas, mientras que el prefijo estable de la petición mantiene activo el almacenamiento en caché del prompt:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Adjunta el panel y el diagrama de arquitectura al primer mensaje de usuario como PNG en base64. Indícale a Claude que trate cualquier dato leído de una imagen como una hipótesis y que la confirme con query_metrics.
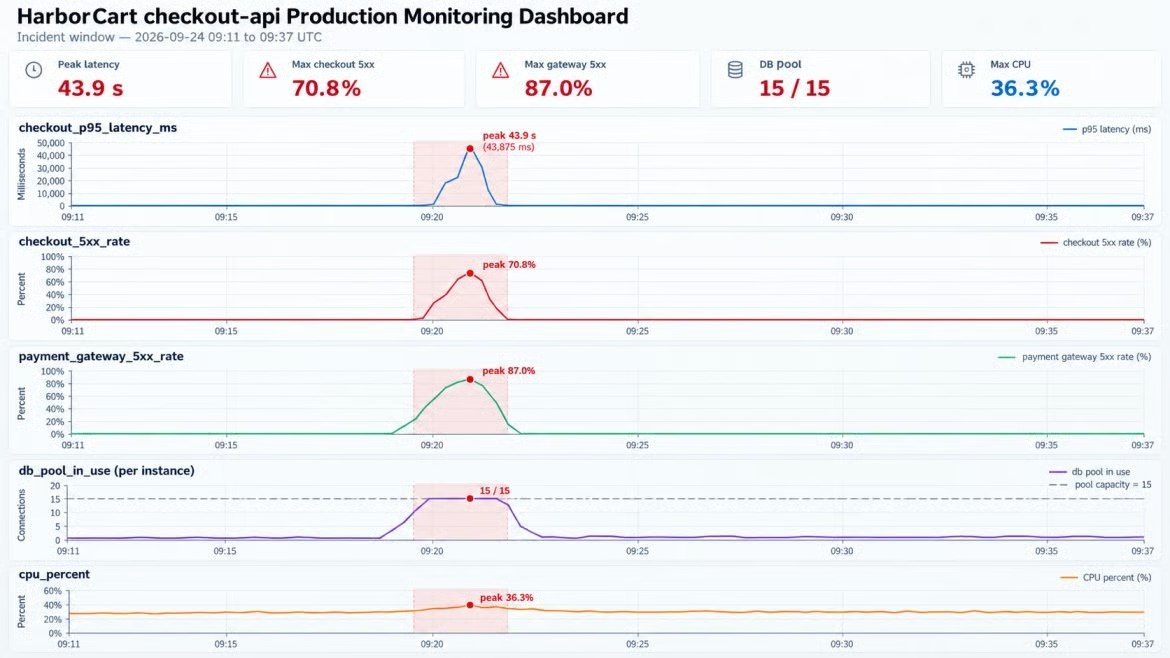
El panel muestra saturación del pool y CPU plana. Imagen del autor.
Tanto el panel como las consultas de métricas usan la misma fuente de datos. La CPU se mantiene cerca del 30% mientras el pool está lleno, lo que refuta "la máquina está sobrecargada" antes de ejecutar ninguna consulta.
La captura sugiere dónde mirar, pero la serie numérica decide si la observación se sostiene. La visión genera una hipótesis; las métricas la ponen a prueba.
Para flujos orientados a imagen, consulta nuestro tutorial de visión agentiva. HarborCart usa la visión solo para elegir la siguiente métrica.
La llamada programática permite a Claude escribir Python que se ejecuta en un contenedor y llama a tus herramientas como funciones. Los resultados en bruto permanecen en la sandbox y solo la salida impresa del código llega al modelo.
El agente escribe scripts cortos que extraen trazas fallidas e imprimen solo los recuentos por endpoint. En una investigación completa, la llamada programática redujo la evidencia serializada devuelta al modelo en un 98,8%. Los resultados de herramientas fueron 42,9 KB y los resúmenes 0,5 KB: medida en bytes, no ahorro directo de tokens facturados.
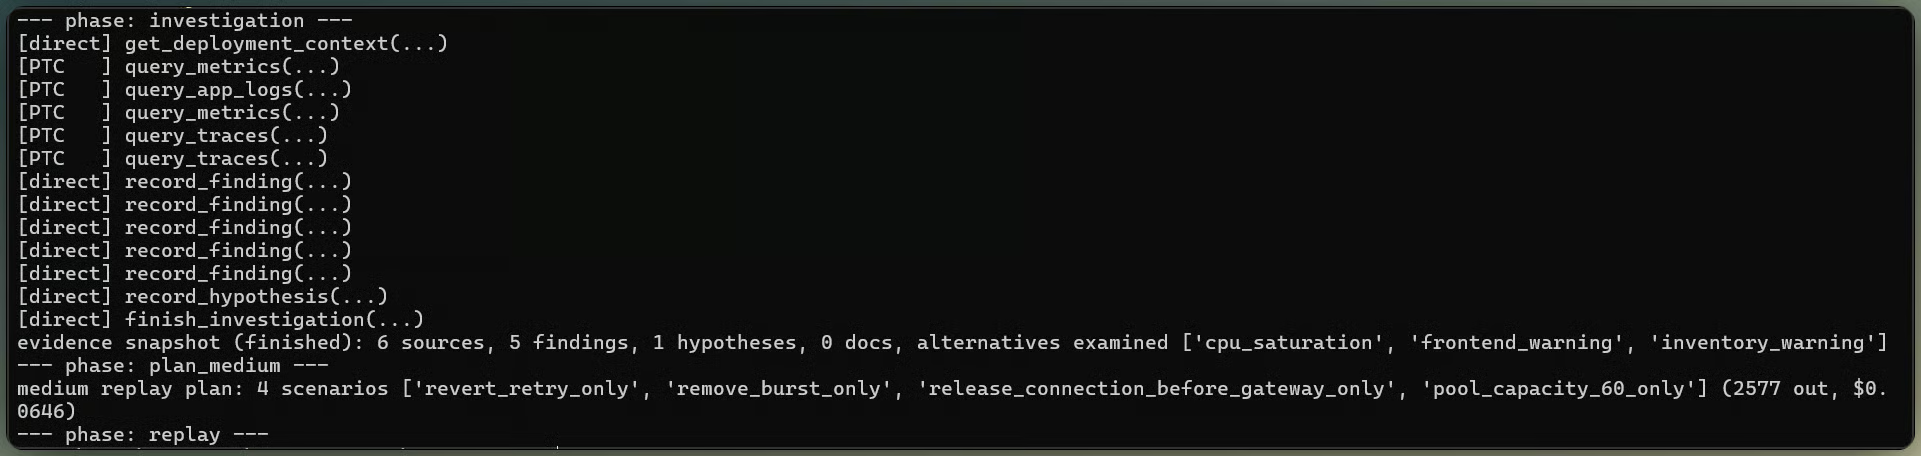
Las llamadas a herramientas acotan la evidencia del incidente. Imagen del autor.
La aplicación expone una búsqueda web restringida para la semántica de librerías de reintentos. Claude no la llamó en la evaluación final, por lo que el diagnóstico medido descansa en el diff, métricas, logs y trazas. La referencia de urllib3 confirma de forma independiente que allowed_methods=None reintenta cualquier verbo y backoff_factor=0 elimina la espera, pero esa página no forma parte de la evidencia medida.
Una repetición contrafactual vuelve a ejecutar el tráfico del incidente eliminando una causa sospechosa y comprueba si el fallo desaparece. Convierte "estas líneas suben juntas" en una prueba.
La repetición reutiliza el mismo patrón de tráfico. Para la comparación siguiente, cada escenario cambia una condición, y la aplicación controla qué cambios están permitidos.
El resumen separa los 503 del gateway de los timeouts del pool, y los 503 del checkout de las lecturas de carrito y pedidos. Esa separación es la que permite al modelo distinguir el desencadenante del amplificador.
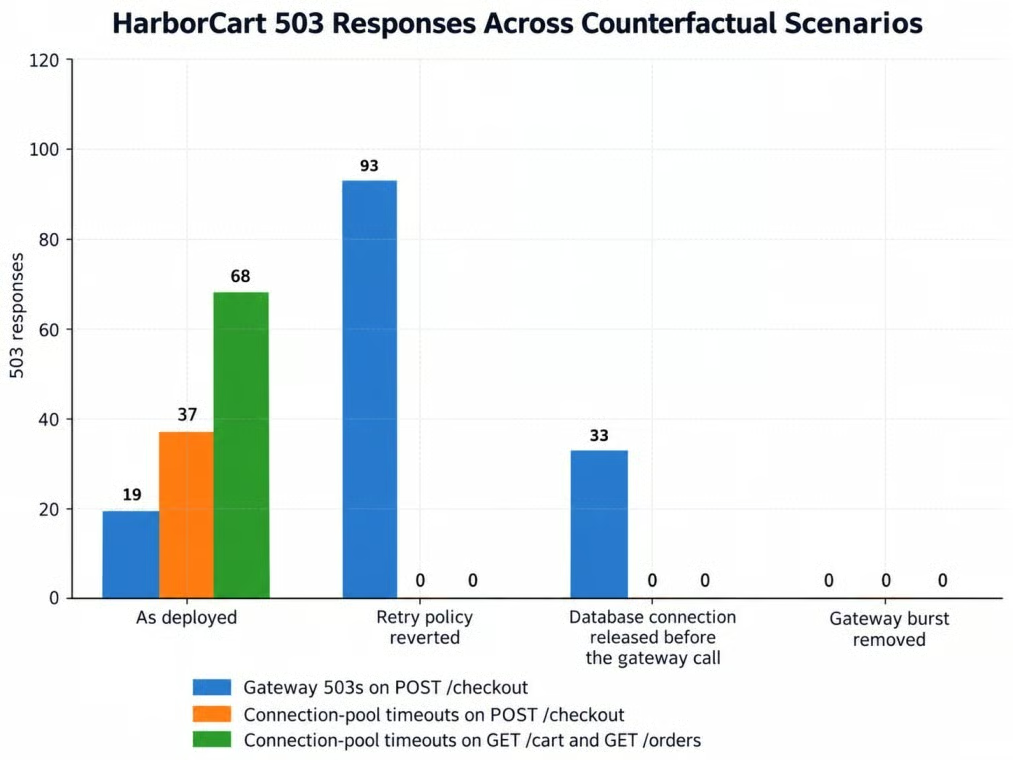
Cada repetición cambia exactamente una cosa. Imagen del autor.
La repetición base produjo 124 respuestas 503: 105 por timeouts del pool, incluidos 68 fallos en endpoints de lectura, y 19 errores del gateway. Revertir la política de reintentos eliminó todos los timeouts del pool y los fallos de lectura pero afloró 93 respuestas 503 del gateway en checkout. Liberar la conexión antes de la llamada al gateway también eliminó fallos del pool pero dejó 33 errores 503 del gateway, y eliminar el pico del gateway no produjo errores.
La repetición expone el compromiso: un rollback protege el pool compartido pero deja pasar más fallos de checkout. Úsalo como medida temporal. Luego añade una clave de idempotencia para que un cargo repetido no facture dos veces y deja de mantener la conexión durante la llamada al gateway.
El prompt del sistema pide una repetición, pero un prompt no es un mecanismo de cumplimiento. El bucle comprueba si existe evidencia de la repetición y rechaza un diagnóstico no probado.
Mantén esta comprobación en Python. Un prompt más estricto puede mejorar la adherencia, pero no garantiza nada.
El effort define cuánto razona Claude por paso, y un presupuesto de tarea fija cuánto trabajo debe llevar todo el bucle. Nuestro tutorial de la API Claude Opus 5 compara los cinco niveles de effort; aquí, medium y high reciben la misma evidencia previa a la repetición.
Producción se queda en medium. Antes de la repetición, la aplicación pide a medium y high diseñar una prueba causal con la misma evidencia. Solo ejecuta la recomendación de medium; la de high se usa solo como comparación.
La petición high usa un cambio por mensaje en output_config.effort habilitado por mid-conversation-output-config-2026-07-01. No ve la respuesta de medium.
Ambos niveles eligieron la misma hipótesis y los mismos tres escenarios centrales de repetición. High usó de media 2.631 tokens de salida frente a 2.307 en medium, y costó un ~11% más sin cambiar la prueba causal.
Elige el presupuesto de tarea a partir del uso observado, no a ojo. La investigación sin límite más grande de HarborCart consumió 13.322 tokens contados, incluyendo salida del modelo y texto de resultados de herramientas que Claude vio. Añadir un margen del 25% da 16.653, por debajo del mínimo de 20.000 de Anthropic, así que el presupuesto configurado es 20.000.
Mantén el número de turnos y el tiempo transcurrido como límites de la aplicación. El runner del experimento dejó de iniciar trabajo nuevo cuando el gasto registrado alcanzó 2,50 $. No es un tope duro porque una petición en curso puede terminar por encima.
La respuesta final usa salidas estructuradas. Su esquema plano cubre el veredicto, la causa, las hipótesis rechazadas, la evidencia y la solución. Coste y latencia quedan fuera porque la aplicación los mide.
Las citas de búsqueda web y output_config.format no pueden compartir una petición: las citas requieren bloques de contenido intercalados, mientras que el esquema exige JSON. Por eso HarborCart investiga sin esquema de salida. Almacena hallazgos ligados a sus fuentes y a los resultados de la repetición, y luego envía solo esa evidencia verificada a una segunda petición sin herramientas ni búsqueda web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
La segunda petición solo necesita la evidencia verificada, así que no hace falta conservar toda la caché de la investigación.
Permite "inconclusive" en el campo verdict. No conviene forzar un diagnóstico verificado si la repetición contradice la explicación.
El esquema valida la forma del informe, mientras que la repetición valida el diagnóstico. Un rechazo también devuelve HTTP 200 con stop_reason: "refusal" y puede no ajustarse a tu esquema, así que comprueba el motivo de parada antes de parsear.
Los tres informes finales hallaron el mecanismo causal central y descartaron las tres explicaciones alternativas. Dos cumplieron las ocho comprobaciones; el tercero logró 6/8 porque omitió el cambio explícito de configuración de reintentos en POST y no citó el diff del despliegue. Por eso la evaluación offline se mantiene separada de la validación de esquema: un JSON válido y el diagnóstico correcto pueden dar un informe incompleto.
Los informes también señalan un segundo riesgo: reintentar un cargo puede facturar dos veces a un cliente. RFC 9110 no define POST como inherentemente idempotente y desaconseja reintentos automáticos salvo que el cliente sepa que la operación es segura de repetir. Una clave de idempotencia compatible con el proveedor de pagos es una forma habitual de hacer esos reintentos más seguros.
Nuestro tutorial de Streamlit cubre la configuración de la interfaz. La interfaz de HarborCart muestra eventos de investigación, los planes de repetición medium y high, resultados de repetición, el informe final y el coste. Para el estado entre llamadas a herramientas, la guía de prompting de Claude Opus 5.5 describe display: "updates"; la app también muestra eventos de herramientas cuando un bloque de actualización está vacío.
Aprende con DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
Tutorial
Abid Ali Awan
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Duong Vu
11 min
Tutorial
Natassha Selvaraj
8 min