
Courses
Claude 101
2 giờ
21.4K
Trong hướng dẫn này, tôi sẽ kiểm thử một kịch bản: Vài phút sau khi cập nhật phần mềm, HarborCart — một cửa hàng tôi dùng cho kịch bản này — bắt đầu gặp lỗi khi thanh toán. Một số khách hàng chờ hơn 30 giây; số khác thấy lỗi máy chủ và không thể thanh toán. Nhà cung cấp dịch vụ thanh toán cũng gặp sự cố ngắn, nên có vẻ đây là nguyên nhân hiển nhiên.
Nhưng sự cố của nhà cung cấp không giải thích được vì sao trang giỏ hàng và đơn hàng cũng lỗi. Tìm mắt xích còn thiếu cần nhật ký ứng dụng, biểu đồ, bản ghi yêu cầu và thay đổi mã gần đây. Hướng dẫn này kiểm tra liệu Claude Opus 5.5 có thể lần theo bằng chứng đó, kiểm thử lời giải thích trong điều kiện kiểm soát và chỉ báo cáo điều gì được bằng chứng ủng hộ hay không.
Bối cảnh: Claude Opus 5.5 ra mắt đầu tuần đó, ngay trước khi tôi bắt đầu dự án này. Bài tổng quan Claude Opus 5.5 của chúng tôi đề cập đến buổi ra mắt và các điểm chuẩn, nên hướng dẫn này tập trung vào API và xây dựng một tác nhân điều tra từ yêu cầu đầu tiên đến báo cáo đã xác minh.
Chúng ta sẽ tìm hiểu cách:
Trình điều tra của HarborCart đã tách đợt lỗi đột ngột ở cổng thanh toán khỏi chính sách retry khuếch đại nó, sau đó kiểm thử lời giải thích trước khi trả về báo cáo.
Bạn truy cập Claude Opus 5.5 qua Messages API của Anthropic với ID mô hình claude-opus-5-5. Theo tổng quan mô hình, mô hình nhận văn bản và hình ảnh, có cửa sổ ngữ cảnh 1 triệu token và tối đa đầu ra 128K. Tư duy thích ứng luôn bật và effort mặc định là medium.
Mức giá tiêu chuẩn là $4 cho mỗi triệu token đầu vào và $20 cho mỗi triệu token đầu ra. Ghi cache 5 phút có giá $5 mỗi triệu và đọc cache $0,20. Khi bộ nhớ đệm prompt được kích hoạt, các tiền tố khớp được tính theo mức đọc cache thấp hơn.
Bốn điểm từ hướng dẫn di chuyển xuất hiện trực tiếp trong dự án này.
Ép buộc tool_choice với any hoặc tên công cụ sẽ trả về lỗi 400.
Effort mặc định giảm từ high trên Claude Opus 5 xuống medium.
Không thể tắt tư duy, và các khối thinking phải được gửi lại nguyên vẹn bên trong vòng lặp công cụ.
Các ghi chú mô hình viết giữa các lần gọi công cụ nằm trong khối thinking, mặc định trống.
Tác nhân chỉ điều tra. Nó nhận các công cụ bằng chứng chỉ-đọc và không có thông tin xác thực sản xuất. Sau khi thu thập bằng chứng, các yêu cầu lập kế hoạch riêng đề xuất kiểm thử phản sự kiện, và Python xác thực rồi chạy kế hoạch ở mức effort trung bình.
Mã hoàn chỉnh, gồm cả bộ tạo bằng chứng và web app, có trong kho GitHub này.
HarborCart là một cửa hàng hư cấu. checkout-api của nó phục vụ trang giỏ hàng, trạng thái đơn hàng và POST /checkout, thao tác tính phí qua cổng thanh toán bên thứ ba. Tất cả các endpoint đó dùng chung một pool PostgreSQL 15 kết nối cho mỗi instance.
Một lần deploy diễn ra, và năm phút sau cổng thanh toán trả về 503 trong khoảng 90 giây. Độ trễ thanh toán vượt 30 giây trong khi pool luôn 15/15. Đổ lỗi cho nhà cung cấp thanh toán là điều dễ dàng, và cổng thanh toán thực sự đã lỗi.
Nguyên nhân ẩn sâu hơn một bước. Lần deploy cho phép các khoản thu phí POST thất bại được retry tối đa ba lần, tổng cộng bốn lần thử tính phí, không tạm dừng trong khi handler vẫn giữ kết nối cơ sở dữ liệu. Các khoản phí thất bại chậm giờ giữ kết nối 30 giây hoặc hơn, đến khi pool cạn và các trang giỏ hàng vốn không gọi cổng thanh toán cũng lỗi.
Từ đây tôi dùng ba thuật ngữ nhất quán. Ở đây, tác nhân kích hoạt là sự cố tạm thời của cổng thanh toán. Việc retry POST thanh toán trong khi giữ kết nối cơ sở dữ liệu khan hiếm là cơ chế khuếch đại; cạn kiệt pool kết nối dùng chung là lỗi hệ thống.
Tác nhân bắt đầu với cảnh báo, ảnh chụp màn hình giám sát và sơ đồ kiến trúc. Mọi thứ khác đến qua công cụ: log, trace, năm số liệu, metadata triển khai, phần diff mã và runbook. Ba lời giải thích cạnh tranh được gieo vào bằng chứng: cảnh báo tồn kho, cảnh báo frontend và khả năng bão hòa CPU.
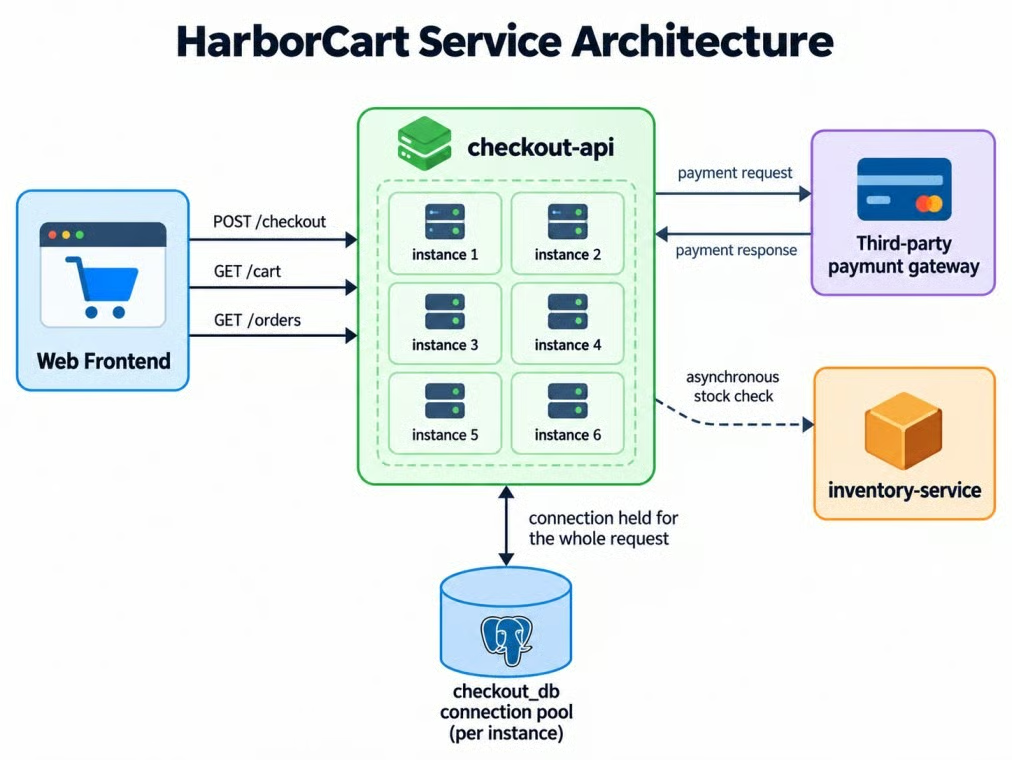
Đường đi thanh toán của HarborCart và pool dùng chung. Ảnh: Tác giả.
Sơ đồ cho biết kết nối được giữ trong suốt yêu cầu. Nó không nói đó là vấn đề; cuộc điều tra phải tự tìm ra điều đó.
Xác định tiêu chí thành công trước khi xây dựng tác nhân. Một báo cáo đúng phải:
POSTBạn cần Python 3.10 trở lên và khóa API Anthropic có quyền truy cập claude-opus-5-5. Các lệnh PowerShell này clone dự án và cài đặt các phụ thuộc được cố định phiên bản, bao gồm anthropic 1.8.0. Nếu bạn dùng Amazon Bedrock, hãy đọc phần Câu hỏi thường gặp trước, vì một số tính năng sẽ không thể chuyển.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Trên macOS hoặc Linux, kích hoạt với source .venv/bin/activate và sao chép bằng cp .env.example .env. Thêm khóa của bạn vào .env, và python-dotenv sẽ nạp nó cho SDK; hướng dẫn biến môi trường của chúng tôi giải thích mẫu này. Nếu bạn đã từng gọi Claude từ Python, hãy bỏ qua mục tiếp theo, vì nó chỉ xác nhận thiết lập.
Yêu cầu nhỏ nhất hữu ích sẽ xác nhận khóa và cho thấy những gì được trả về.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
Trong yêu cầu này, phản hồi chứa các khối thinking và text. Hãy chọn khối theo loại thay vì đọc response.content[0].
Các tác nhân gọi công cụ kết hợp Messages API của Claude với các hàm Python kiểm soát truy cập dữ liệu. Ứng dụng tuân một quy tắc: Claude quyết định cần bằng chứng gì, và Python quyết định được phép truy cập gì.
Bài hướng dẫn kỹ thuật khung tác nhân của chúng tôi đề cập đến ranh giới công cụ và vòng lặp rộng hơn; HarborCart giữ công cụ ở chế độ chỉ-đọc và giới hạn trong sự cố này.
Mỗi công cụ đọc một bộ bằng chứng cố định và trả về kết quả JSON giới hạn. Truy vấn log và trace trả về tối đa 200 dòng cộng số đếm, và truy vấn số liệu trả về tối đa 60 điểm.
Gọi công cụ theo lập trình không hỗ trợ strict: true, nên hãy tách công cụ thành hai nhóm. Giữ công cụ kiểm soát bằng chứng và công cụ dừng điều tra ở chế độ nghiêm ngặt và chỉ-direct. Log, trace và số liệu chỉ dùng thực thi mã, giúp Claude có một đường dẫn rõ ràng khi truy vấn bằng chứng lớn.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers hướng dẫn mô hình nhưng không phải rào chắn bảo mật. Python kiểm tra caller trước khi thực thi mỗi công cụ và từ chối lời gọi truy vấn trực tiếp. Lời gọi theo lập trình cũng bỏ qua xác thực nghiêm ngặt, nên các hàm truy vấn vẫn tự xác thực tham số của chúng.
Ứng dụng gắn thẻ mọi kết quả công cụ được chấp nhận, loại bỏ phát hiện trích dẫn bằng chứng thiếu, và chỉ chấp nhận URL tài liệu khi tìm kiếm web trả về chúng. Python, không phải mô hình, ghi lại đầu ra của phát lại.
Như đã nêu trong phần di chuyển, giữ tool_choice ở auto. Nêu rõ trong prompt khi nào công cụ áp dụng, và dùng schema nghiêm ngặt khi tham số phải chính xác.
Vòng lặp gửi cuộc hội thoại, chạy mọi khối tool_use, nối kết quả và lặp lại. Nối các khối của assistant nguyên vẹn, gồm cả thinking, và khi mã theo lập trình tạm dừng, truyền lại ID container chỉ với các khối tool_result.
Yêu cầu điều tra bao gồm vision, công cụ, tìm kiếm web, effort và ngân sách tác vụ, nhưng không có schema đầu ra. Điều này giữ kết quả tìm kiếm có trích dẫn tránh xa đầu ra JSON có cấu trúc trong khi tiền tố yêu cầu ổn định giữ bộ nhớ đệm prompt hoạt động:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Đính kèm bảng điều khiển và sơ đồ kiến trúc vào tin nhắn người dùng đầu tiên dưới dạng PNG base64. Hãy dặn Claude xem mọi thứ đọc được từ ảnh là giả thuyết và xác nhận bằng query_metrics.
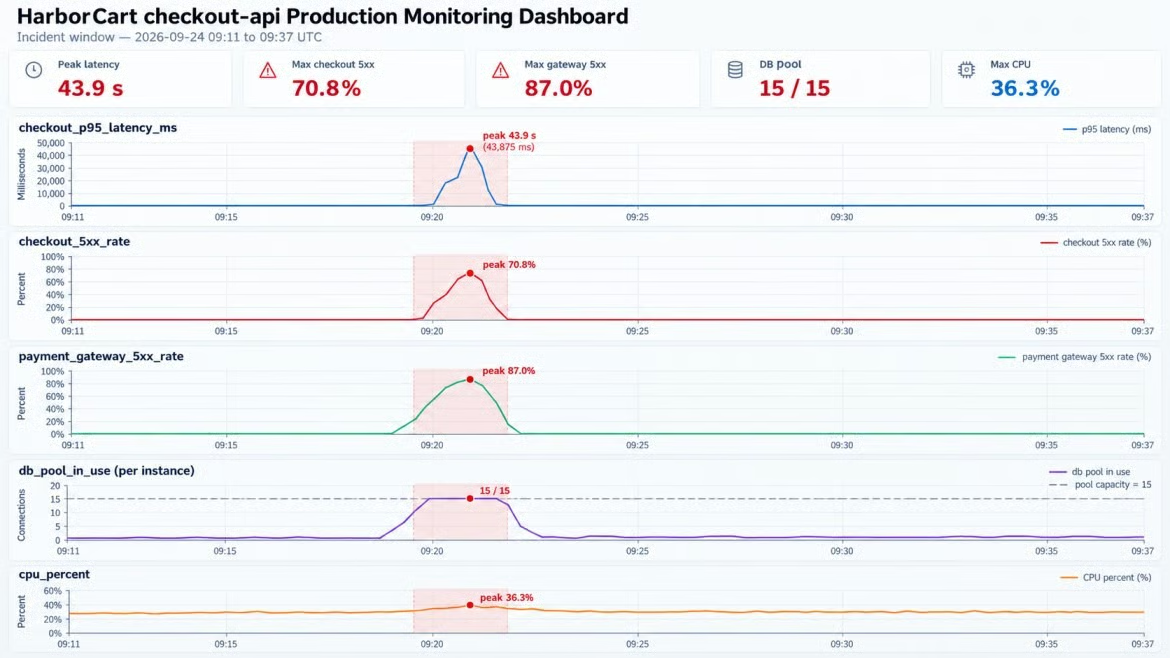
Bảng điều khiển cho thấy pool bão hòa, CPU phẳng. Ảnh: Tác giả.
Cả bảng điều khiển và truy vấn số liệu đều dùng cùng nguồn dữ liệu. CPU duy trì gần 30% khi pool đầy, điều này phản biện giả thuyết "máy chủ quá tải" trước khi chạy bất kỳ truy vấn nào.
Ảnh chụp gợi ý nơi cần xem, nhưng chuỗi số liệu mới quyết định quan sát có giữ vững hay không. Vision tạo giả thuyết; số liệu kiểm thử nó.
Với quy trình ưu tiên hình ảnh, xem hướng dẫn agentic vision của chúng tôi. HarborCart chỉ dùng vision để chọn số liệu tiếp theo.
Gọi công cụ theo lập trình cho phép Claude viết Python chạy trong container thực thi mã và gọi các công cụ của bạn như hàm. Kết quả thô ở lại sandbox, và chỉ đầu ra được in của mã mới đến mô hình.
Tác nhân viết các script ngắn lấy các trace lỗi và chỉ in số đếm theo endpoint. Trong một cuộc điều tra hoàn chỉnh, gọi công cụ theo lập trình đã giảm 98,8% bằng chứng tuần tự hóa trả về cho mô hình. Kết quả công cụ là 42,9 KB còn tóm tắt là 0,5 KB, đây là đo theo byte chứ không phải tiết kiệm token đầu vào bị tính phí.
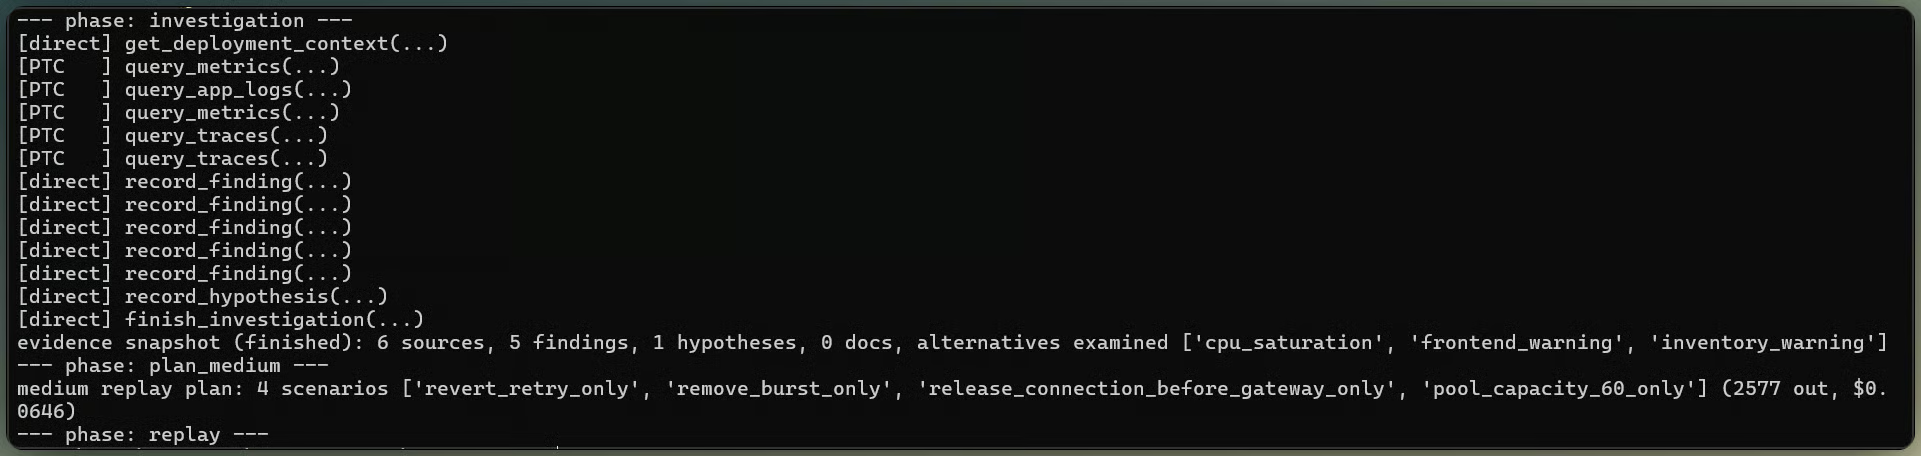
Các lần gọi công cụ thu hẹp bằng chứng sự cố. Ảnh: Tác giả.
Ứng dụng cung cấp tìm kiếm web hạn chế cho ngữ nghĩa thư viện retry. Claude đã không gọi nó trong lần đánh giá cuối, nên chẩn đoán đo lường dựa trên diff, số liệu, log và trace. Tài liệu urllib3 xác nhận độc lập rằng allowed_methods=None retry mọi verb và backoff_factor=0 loại bỏ thời gian chờ, nhưng trang đó không thuộc bộ bằng chứng đo lường.
Phát lại phản sự kiện chạy lại lưu lượng của sự cố nhưng loại bỏ một nguyên nhân nghi ngờ và kiểm tra xem lỗi có biến mất hay không. Nó biến "các đường này tăng cùng nhau" thành một kiểm thử.
Phát lại tái sử dụng cùng mẫu lưu lượng. Trong so sánh dưới đây, mỗi kịch bản thay đổi một điều kiện, và ứng dụng kiểm soát các thay đổi được phép.
Bản tóm tắt tách các lỗi 503 ở cổng thanh toán khỏi timeout của pool, và 503 khi thanh toán khỏi các lượt đọc giỏ hàng và đơn hàng. Sự phân tách đó giúp mô hình phân biệt tác nhân kích hoạt với bộ khuếch đại.
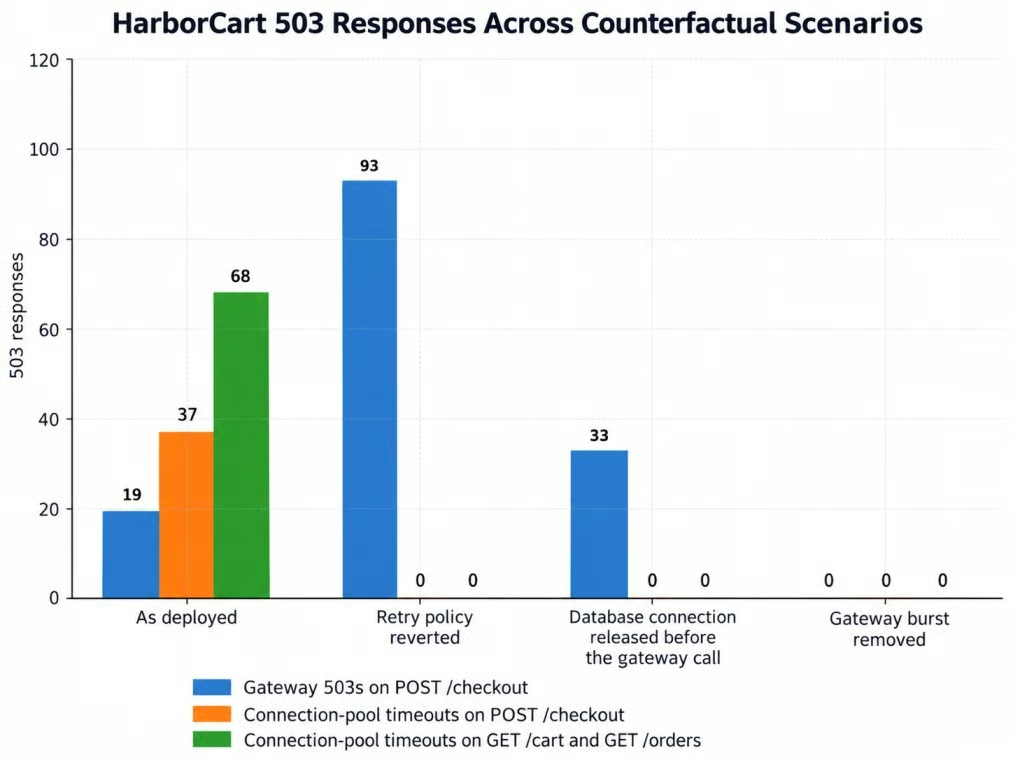
Mỗi lần phát lại chỉ thay đổi đúng một yếu tố. Ảnh: Tác giả.
Phát lại gốc tạo ra 124 phản hồi 503: 105 timeout pool, bao gồm 68 lỗi trên các endpoint đọc, và 19 lỗi cổng thanh toán. Hoàn nguyên chính sách retry loại bỏ mọi timeout pool và lỗi đọc nhưng làm lộ 93 lỗi 503 ở cổng thanh toán trên checkout. Giải phóng kết nối trước cuộc gọi cổng cũng loại bỏ lỗi pool trong khi còn 33 lỗi 503 ở cổng, và loại bỏ đợt lỗi cổng thì không có lỗi nào.
Phát lại bộc lộ đánh đổi: rollback bảo vệ pool dùng chung nhưng cho phép nhiều lỗi thanh toán lọt qua hơn. Dùng nó như biện pháp tạm thời. Sau đó thêm khóa idempotency để một lần thu phí lặp lại không tính tiền hai lần, và ngừng giữ kết nối trong cuộc gọi đến cổng.
System prompt yêu cầu có phát lại, nhưng prompt không phải cơ chế cưỡng chế. Vòng lặp kiểm tra xem có bằng chứng phát lại hay không và từ chối chẩn đoán chưa được kiểm thử.
Giữ kiểm tra này trong Python. Một prompt sắc bén hơn có thể cải thiện tuân thủ, nhưng không thể đảm bảo.
Effort quyết định mức Claude suy luận mỗi bước, và ngân sách tác vụ đặt lượng công việc cho cả vòng lặp. Hướng dẫn Claude Opus 5 API của chúng tôi so sánh cả năm mức effort; ở đây, medium và high nhận cùng bộ bằng chứng trước phát lại.
Sản xuất giữ ở medium. Trước phát lại, ứng dụng yêu cầu medium và high thiết kế kiểm thử nhân quả từ cùng bằng chứng. Chỉ khuyến nghị của medium được thực thi; phản hồi high chỉ dùng để so sánh.
Yêu cầu high dùng thay đổi output_config.effort theo từng tin nhắn thông qua mid-conversation-output-config-2026-07-01. Nó không thấy câu trả lời của medium.
Cả hai mức effort đều chọn cùng giả thuyết và ba kịch bản phát lại cốt lõi giống nhau. High dùng trung bình 2.631 token đầu ra so với 2.307 ở medium, và tốn khoảng 11% chi phí thêm mà không đổi kiểm thử nhân quả.
Chọn ngân sách tác vụ dựa trên sử dụng quan sát được thay vì đoán. Cuộc điều tra lớn nhất không giới hạn của HarborCart tiêu tốn 13.322 token được tính, bao gồm đầu ra mô hình và văn bản kết quả công cụ Claude thấy. Thêm biên 25% thành 16.653, dưới mức tối thiểu 20.000 token của Anthropic, nên ngân sách cấu hình là 20.000.
Giữ số lượt và thời gian trôi qua làm giới hạn của ứng dụng. Trình chạy thí nghiệm ngừng bắt đầu công việc mới sau khi chi tiêu ghi nhận đạt $2,50. Đây không phải trần cứng vì một yêu cầu đang xử lý có thể hoàn tất vượt mức đó.
Câu trả lời cuối dùng đầu ra có cấu trúc. Schema phẳng bao quát kết luận, nguyên nhân, giả thuyết bị bác bỏ, bằng chứng và cách khắc phục. Chi phí và độ trễ không đưa vào vì ứng dụng đo riêng.
Trích dẫn tìm kiếm web và output_config.format không thể dùng chung một yêu cầu: trích dẫn cần các khối nội dung xen kẽ, trong khi schema yêu cầu JSON. Vì vậy HarborCart điều tra mà không có schema đầu ra. Nó lưu phát hiện gắn với nguồn và kết quả phát lại, rồi chỉ gửi bằng chứng đã xác minh đó đến yêu cầu thứ hai không có công cụ hay tìm kiếm web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
Yêu cầu thứ hai chỉ cần bằng chứng đã xác minh, nên không cần giữ toàn bộ cache điều tra.
Cho phép "inconclusive" trong trường verdict. Báo cáo không nên bị ép đưa ra chẩn đoán đã xác minh khi phát lại mâu thuẫn với lời giải thích.
Schema xác thực hình dạng báo cáo, còn phát lại xác thực chẩn đoán. Một từ chối cũng trả HTTP 200 với stop_reason: "refusal" và có thể không khớp schema của bạn, nên hãy kiểm tra stop reason trước khi phân tích.
Cả ba báo cáo cuối cùng đều tìm ra cơ chế nhân quả cốt lõi và loại trừ ba lời giải thích thay thế. Hai báo cáo đạt đủ tám kiểm tra; báo cáo thứ ba đạt 6/8 vì bỏ sót cấu hình thay đổi retry cho POST và không trích dẫn phần diff triển khai. Đó là lý do chấm điểm ngoại tuyến tách biệt với xác thực schema: JSON hợp lệ và chẩn đoán đúng vẫn có thể tạo ra báo cáo chưa đầy đủ.
Các báo cáo cũng xác định một rủi ro thứ hai: retry một lần thu phí có thể tính tiền khách hàng hai lần. RFC 9110 không định nghĩa POST là tự idempotent và khuyên không nên retry tự động trừ khi client biết thao tác an toàn để lặp lại. Khóa idempotency do nhà cung cấp thanh toán hỗ trợ là một cách phổ biến để làm các retry đó an toàn hơn.
Bài hướng dẫn Streamlit của chúng tôi đề cập đến thiết lập giao diện. Giao diện của HarborCart hiển thị sự kiện điều tra, kế hoạch phát lại ở medium và high, kết quả phát lại, báo cáo cuối cùng và chi phí. Để xem trạng thái giữa các lần gọi công cụ, hướng dẫn prompting Claude Opus 5.5 mô tả display: "updates"; ứng dụng cũng hiển thị sự kiện công cụ khi khối cập nhật trống.
Học cùng DataCamp
Courses
Courses
Courses