course
Claude 101
2 timmar
21.4K
I den här handledningen testar jag ett scenario: Några minuter efter en mjukvaruuppdatering börjar HarborCart — en butik jag använder för det här scenariot — få fel i kassan. Vissa kunder väntar mer än 30 sekunder; andra ser ett serverfel och kan inte betala. Betalningsleverantören har också ett kort avbrott, så det ser ut som den uppenbara orsaken.
Men leverantörsavbrottet förklarar inte varför även varukorgs- och ordersidor fallerar. För att hitta den saknade länken behövs applikationsloggar, grafer, begärandeposter och den senaste kodändringen. Den här handledningen testar om Claude Opus 5.5 kan följa den beviskedjan, testa sin förklaring under kontrollerade förhållanden och bara rapportera det som stöds av bevisen.
Lite bakgrund: Claude Opus 5.5 kom tidigare samma vecka, precis innan jag började det här projektet. Vår översikt av Claude Opus 5.5 täcker lansering och benchmarking, så den här handledningen fokuserar på API:t och bygger en utredningsagent från första förfrågan till en verifierad rapport.
Vi går igenom hur du:
HarborCarts utredare skilde ut en topp i betalningsgatewayn från återförsökspolicyn som förstärkte den, och testade sedan förklaringen innan rapporten skickades tillbaka.
Du använder Claude Opus 5.5 via Anthropics Messages API med modell-ID claude-opus-5-5. Enligt modellöversikten tar den text och bilder, med ett kontextfönster på 1M token och 128K maxutdata. Adaptivt tänkande är alltid på, och standard-effort är medium.
Standard-prissättning är $4 per miljon indatatoken och $20 per miljon utdatatoken. Skrivningar till femminuterscachen kostar $5 per miljon och cacheläsningar $0,20. När prompt-cachning är aktiv faktureras matchande prefix till den lägre cacheläsningstaxan.
Fyra punkter från migrationsguiden märks direkt i det här projektet.
Tvingad tool_choice med any eller ett namngivet verktyg returnerar ett 400-fel.
Standardefforten sjönk från high i Claude Opus 5 till medium.
Tänkandet kan inte stängas av, och thinking-block måste skickas tillbaka oförändrade inuti en verktygsslinga.
Anteckningar som modellen skriver mellan verktygsanrop kommer i thinking-block, som är tomma som standard.
Agenten utreder bara. Den får skrivskyddade bevisverktyg och inga produktionsuppgifter. Efter bevisinhämtning föreslår separata planeringsförfrågningar kontrafaktiska tester, och Python validerar och kör planen med medium effort.
Den kompletta koden, inklusive bevisgenerator och webbapp, finns i detta GitHub-repo.
HarborCart är en fiktiv butik. Dess checkout-api betjänar varukorgssidor, orderstatus och POST /checkout, som debiterar en tredjepartsbetalningsgateway. Alla dessa slutpunkter delar en PostgreSQL-pool med 15 anslutningar per instans.
En deploy rullas ut, och fem minuter senare returnerar gatewayn 503:or i cirka 90 sekunder. Fördröjningen i kassan stiger över 30 sekunder medan poolen ligger på 15 av 15. Att skylla på betalningsleverantören är det enkla beslutet, och gatewayn fallerade faktiskt.
Den dolda orsaken ligger ett steg längre in. Deployen lät misslyckade POST-debiteringar försöka igen upp till tre gånger, totalt fyra försök, utan paus medan hanteraren fortfarande håller sin databasanslutning. Långsamma felande debiteringar håller nu anslutningar i 30 sekunder eller mer, tills poolen tar slut och varukorgssidor som aldrig anropar gatewayn också fallerar.
Jag använder tre begrepp konsekvent härifrån. Här är avtryckaren det tillfälliga gateway-felet. Att återförsöka checkout-POST:ar medan man håller knappa databasanslutningar är förstärkningsmekanismen; uttömningen av den delade anslutningspoolen är systemfelet.
Agenten börjar med larmet, en övervakningsskärmdump och ett arkitekturschema. Allt annat kommer via verktyg: loggar, spår, fem mätvärden, deploymetadata, Git-diffen och en handbok. Tre konkurrerande förklaringar planteras i bevisen: en varning om inventarier, en frontend-varning och möjlig CPU-mättnad.
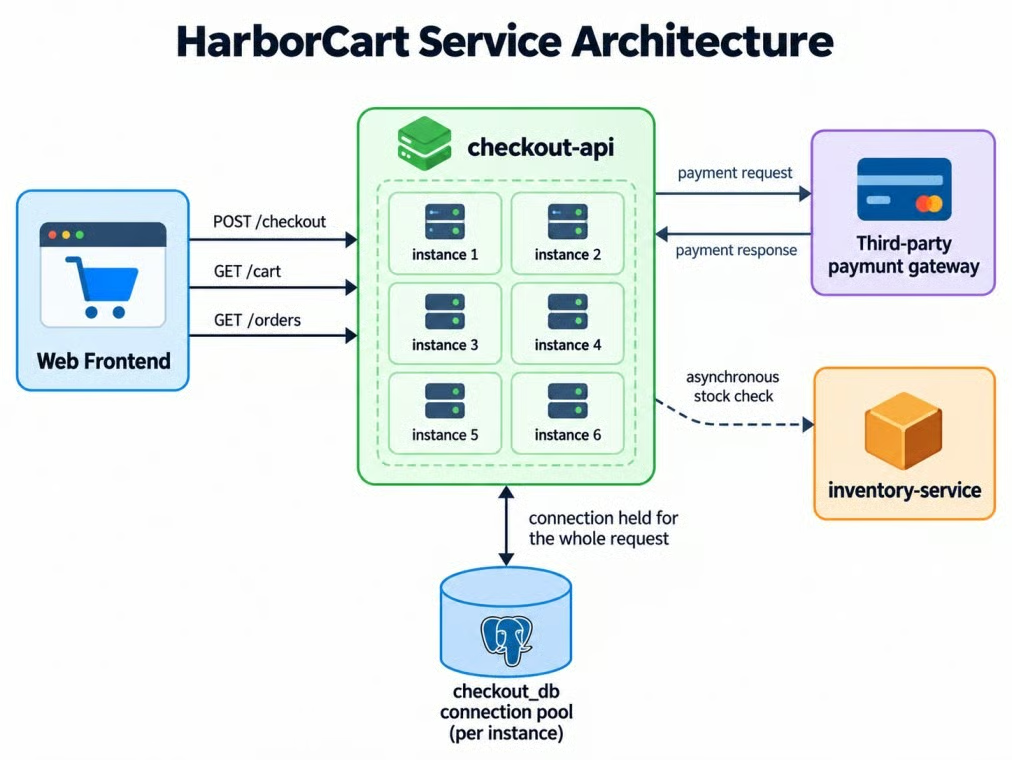
HarborCarts kassaflöde och delad pool. Bild av författaren.
Diagrammet säger att anslutningen hålls under hela begäran. Det säger inte att det är ett problem; utredningen måste komma fram till det.
Definiera framgång innan du bygger agenten. En korrekt rapport måste:
POST-återförsökDu behöver Python 3.10 eller nyare och en Anthropic API-nyckel med åtkomst till claude-opus-5-5. Dessa PowerShell-kommandon klonar projektet och installerar dess låsta beroenden, inklusive anthropic 1.8.0. Om du kör på Amazon Bedrock, läs först FAQ:erna eftersom flera funktioner inte går att porta.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
På macOS eller Linux, aktivera med source .venv/bin/activate och kopiera med cp .env.example .env. Lägg till din nyckel i .env, och python-dotenv laddar den åt SDK:t; vår guide till miljövariabler förklarar mönstret. Om du har anropat Claude från Python tidigare kan du hoppa över nästa delavsnitt, eftersom det bara bekräftar setupen.
Den minsta användbara förfrågan bekräftar nyckeln och visar vad som kommer tillbaka.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
I denna förfrågan innehåller svaret thinking- och text-block. Välj block efter typ i stället för att läsa response.content[0].
Verktygsanropande agenter parar ihop Claudes Messages API med Python-funktioner som styr dataåtkomsten. Applikationen följer en regel: Claude bestämmer vilka bevis den behöver, och Python bestämmer vad den får komma åt.
Vår guide till agent-harness engineering täcker bredare verktygsgränser och slingor; HarborCart håller sina verktyg skrivskyddade och begränsade till denna incident.
Varje verktyg läser en fast uppsättning bevis och returnerar ett begränsat JSON-resultat. Logg- och spårfrågor returnerar högst 200 rader plus en räkning, och metriksfrågor returnerar högst 60 datapunkter.
Programmatisk verktygsanropning stödjer inte strict: true, så dela upp verktygen i två. Håll beviskontrollerna och stoppverktyget för utredningen strikta och endast direktanropade. Loggar, spår och mätvärden använder enbart kodkörning, vilket ger Claude en tydlig väg för stora bevisfrågor.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers vägleder modellen men är inte en säkerhetsgräns. Python kontrollerar uppringaren innan varje verktyg körs och avvisar ett direkt anrop till en frågefunktion. Programmässiga anrop hoppar också över strikt validering, så frågefunktioner validerar fortfarande sina egna argument.
Applikationen taggar varje accepterat verktygsresultat, avvisar slutsatser som hänvisar till saknade bevis och accepterar dokumentations-URL:er bara när webbsökning returnerat dem. Python, inte modellen, registrerar uppspelningsutdata.
Som noterat i migrationsavsnittet, håll tool_choice på auto. Säg i prompten när ett verktyg är tillämpligt, och använd strikta scheman där argument måste vara exakta.
Slingan skickar konversationen, kör alla tool_use-block, bifogar resultaten och upprepar. Bifoga assistentens block oförändrade, inklusive thinking, och medan programmatisk kod är pausad skickar du tillbaka container-ID:t endast med tool_result-block.
Utredningsförfrågan inkluderar vision, verktyg, webbsökning, effort och uppgiftsbudget, men inget utdataschema. Det gör att sökresultat med källhänvisningar hålls borta från strukturerad JSON-utdata medan den stabila förfrågningsprefixen håller prompt-cachning aktiv:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Bifoga instrumentpanelen och arkitekturschemat till det första användarmeddelandet som base64-PNG:er. Säg åt Claude att behandla allt den läser från en bild som en hypotes och bekräfta det med query_metrics.
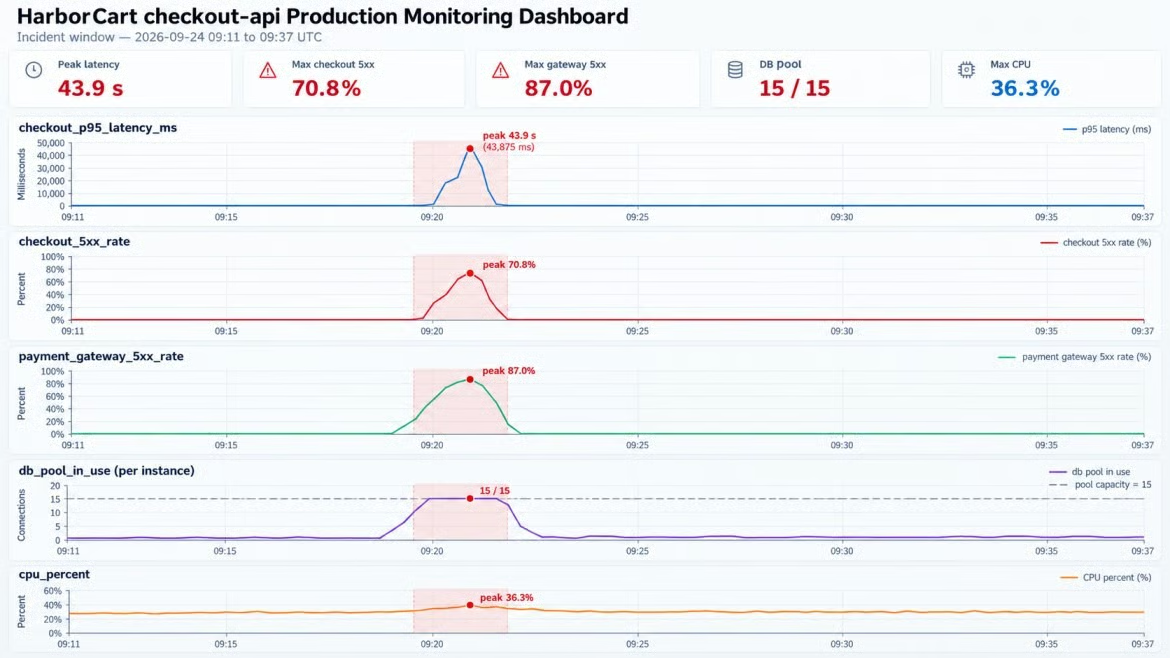
Instrumentpanelen visar poolsaturation, låg CPU. Bild av författaren.
Både instrumentpanelen och metriksfrågorna använder samma källdata. CPU ligger kring 30 % medan poolen är full, vilket talar emot "värden är överbelastad" innan någon fråga körs.
Skärmdumpen antyder var man ska leta, men den numeriska serien avgör om observationen håller. Vision genererar en hypotes; mätvärden testar den.
För bildförst-arbetsflöden, se vår handledning om agentisk vision. HarborCart använder vision bara för att välja nästa mätvärde.
Programmatisk verktygsanropning låter Claude skriva Python som körs i en kodkörningscontainer och anropa dina verktyg som funktioner. Råresultat stannar i sandlådan, och endast kodens utskrift når modellen.
Agenten skriver korta skript som hämtar felande spår och skriver ut endast antalet per slutpunkt. I en fullständig utredning minskade programmatisk verktygsanropning serialiserade bevis som skickades tillbaka till modellen med 98,8 %. Verktygsresultaten var 42,9 KB och sammanfattningarna 0,5 KB, ett mått i byte snarare än fakturerade indatatoken.
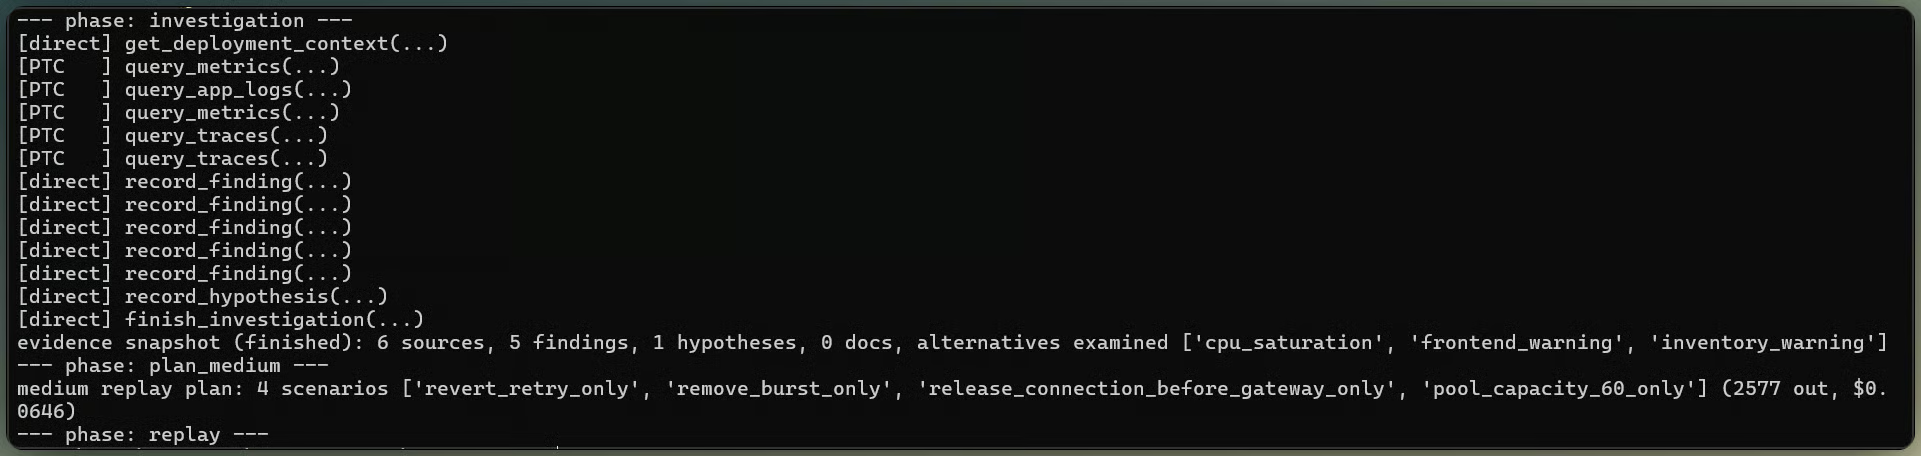
Verktygsanrop snävar in incidentens bevis. Bild av författaren.
Applikationen exponerar begränsad webbsökning för semantiken i återförsöksbiblioteket. Claude anropade den inte under den slutliga utvärderingen, så den uppmätta diagnosen vilar på diffen, mätvärden, loggar och spår. urllib3-referensen bekräftar oberoende att allowed_methods=None återförsöker alla verb och att backoff_factor=0 tar bort väntan, men den sidan ingår inte i de uppmätta bevisen.
En kontrafaktisk uppspelning kör om incidentens trafik med en misstänkt orsak borttagen och kontrollerar om felet försvinner. Den gör om "de här kurvorna stiger tillsammans" till ett test.
Uppspelningen återanvänder samma trafikmönster. För jämförelsen nedan ändrar varje scenario en enda förutsättning, och applikationen styr vilka ändringar som tillåts.
Sammanfattningen separerar gateway-503:or från pool-timeouts och checkout-503:or från läsningar av varukorg och order. Den uppdelningen är det som låter modellen skilja avtryckaren från förstärkaren.
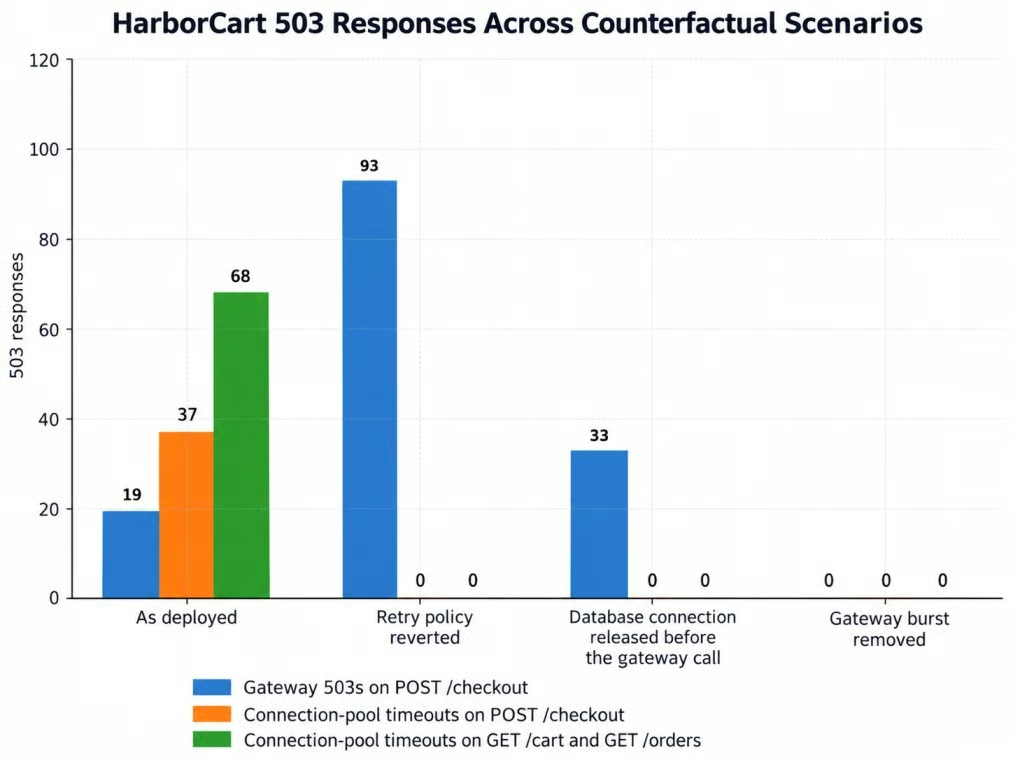
Varje uppspelning ändrar exakt en sak. Bild av författaren.
Grunduppspelningen gav 124 stycken 503:or: 105 pool-timeouts, inklusive 68 fel på lässlutpunkter, och 19 gateway-fel. Att återställa återförsökspolicyn tog bort alla pool-timeouts och läsfel men blottlade 93 gateway-503:or i checkout. Att släppa anslutningen före gateway-anropet tog också bort poolfel men lämnade 33 gateway-503:or, och att ta bort gateway-toppen gav inga fel.
Uppspelningen visar avvägningen: en rollback skyddar den delade poolen men släpper igenom fler fel i checkout. Använd den som tillfällig åtgärd. Lägg sedan till en idempotensnyckel så att en upprepad debitering inte kan debitera två gånger, och sluta hålla anslutningen under gateway-anropet.
Systemprompten ber om en uppspelning, men en prompt är ingen efterlevnadsmekanism. Slingan kontrollerar om uppspelningsbevis finns och avvisar en otestad diagnos.
Behåll denna kontroll i Python. En skarpare prompt kan förbättra efterlevnaden, men kan inte garantera den.
Effort sätter hur mycket Claude resonerar per steg, och en uppgiftsbudget anger hur mycket arbete hela slingan bör ta. Vår Claude Opus 5 API-handledning jämför alla fem effort-nivåerna; här får medium och hög samma bevis före uppspelning.
Produktion ligger kvar på medium. Före uppspelning ber applikationen medium och hög effort att utforma ett kausalt test från samma bevis. Den kör endast rekommendationen från medium; svaret från hög används bara för jämförelse.
Förfrågan med hög effort använder en per-meddelande-output_config.effort-ändring bakom mid-conversation-output-config-2026-07-01. Den ser inte mediumsvar.
Båda effort-nivåerna valde samma hypotes och samma tre kärnscenarier för uppspelning. Hög använde i snitt 2 631 utdatatoken jämfört med 2 307 på medium, och kostade cirka 11 % mer utan att ändra det kausala testet.
Välj uppgiftsbudget utifrån observerad användning i stället för gissning. HarborCarts största obegränsade utredning förbrukade 13 322 räknade token, inklusive modellutdata och text från verktygsresultat som Claude såg. Att lägga på 25 % marginal ger 16 653, under Anthropics miniminivå på 20 000 token, så den konfigurerade budgeten är 20 000.
Behåll antal varv och förlupen tid som applikationsgränser. Experimentskriptet slutade starta nytt arbete efter att den registrerade kostnaden nådde $2,50. Detta är inget hårt tak eftersom en redan pågående förfrågan kan slutföras över den nivån.
Det slutliga svaret använder strukturerade utdata. Dess platta schema täcker utslag, orsak, förkastade hypoteser, bevis och åtgärd. Kostnad och fördröjning lämnas utanför eftersom applikationen mäter dem.
Källhänvisningar från webbsökning och output_config.format kan inte dela en förfrågan: källhänvisningar behöver inflätade innehållsblock, medan schemat kräver JSON. HarborCart utreder därför utan utdataschema. Det lagrar fynd kopplade till sina källor och uppspelningsresultaten, och skickar sedan endast de verifierade bevisen till en andra förfrågan utan verktyg eller webbsökning.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
Den andra förfrågan behöver bara de verifierade bevisen, så det är onödigt att bevara hela utredningscachen.
Tillåt "inconclusive" i fältet verdict. En rapport ska inte tvingas till en verifierad diagnos när uppspelningen motsäger förklaringen.
Schemat validerar rapportens form, medan uppspelningen validerar diagnosen. En vägran returnerar också HTTP 200 med stop_reason: "refusal" och kanske inte matchar ditt schema, så kontrollera stop reason före tolkning.
Alla tre slutrapporterna hittade den kausala kärnmekanismen och uteslöt de tre alternativa förklaringarna. Två uppfyllde alla åtta kontroller; den tredje fick 6/8 eftersom den utelämnade den explicita POST-återförsökskonfigurationsändringen och inte hänvisade till deploy-diffen. Det är därför offlinepoängsättning hålls separat från schemavalidering: giltig JSON och rätt diagnos kan ändå ge en ofullständig rapport.
Rapporterna identifierar också en andra risk: att återförsöka en debitering kan debitera en kund två gånger. RFC 9110 definierar inte POST som inneboende idempotent och avråder från automatiska återförsök om inte klienten vet att operationen är säker att upprepa. En idempotensnyckel som stöds av betalningsleverantören är ett vanligt sätt att göra de återförsöken säkrare.
Vår Streamlit-handledning täcker uppsättningen av gränssnittet. HarborCarts gränssnitt visar utredningshändelser, planerna för uppspelning på medium och hög, uppspelningsresultat, slutrapport och kostnad. För status mellan verktygsanrop beskriver Claude Opus 5.5-promptguiden display: "updates"; appen visar också verktygshändelser när ett update-block är tomt.
Lär dig med DataCamp
course
course
course