Course
Claude 101
2 ч
21.4K
В этом руководстве мы разберём сценарий: через несколько минут после обновления ПО в HarborCart — вымышленном магазине для этого примера — начинаются сбои на этапе оплаты. Одни клиенты ждут более 30 секунд, другим показывается ошибка сервера, и они не могут заплатить. У платёжного провайдера тоже кратковременный сбой, так что причина вроде бы очевидна.
Но сбой провайдера не объясняет, почему также падают страницы корзины и заказа. Чтобы найти недостающее звено, нужны журналы приложения, графики, записи запросов и недавние изменения в коде. Это руководство проверяет, сможет ли Claude Opus 5.5 последовательно проанализировать эти данные, проверить свою гипотезу в контролируемых условиях и сообщить только то, что подтверждено доказательствами.
Немного предыстории: Claude Opus 5.5 вышел за несколько дней до начала этого проекта. Наш обзор Claude Opus 5.5 описывает запуск и бенчмарки, поэтому здесь мы сосредоточимся на API и соберём одного агента‑расследователя от первого запроса до проверенного отчёта.
Мы разберём, как:
Расследователь HarborCart отделил всплеск ошибок платёжного шлюза от политики повторов, которая его усилила, а затем проверил это объяснение перед возвратом отчёта.
Доступ к Claude Opus 5.5 — через Messages API Anthropic с идентификатором модели claude-opus-5-5. Согласно обзору модели, она принимает текст и изображения, имеет контекст 1M токенов и максимум 128K на вывод. Адаптивное рассуждение всегда включено, по умолчанию effort — medium.
Стандартная стоимость — $4 за миллион входных токенов и $20 за миллион выходных. Запись в кэш на пять минут стоит $5 за миллион, чтение из кэша — $0,20. Когда кэширование промптов активно, совпадающие префиксы тарифицируются по сниженной ставке чтения из кэша.
Четыре пункта из руководства по миграции напрямую затрагивают этот проект.
Принудительный tool_choice со значением any или именем инструмента возвращает ошибку 400.
Значение effort по умолчанию изменилось с high в Claude Opus 5 на medium.
Режим рассуждения нельзя отключить, а блоки thinking должны возвращаться без изменений внутри цикла инструментов.
Заметки, которые модель пишет между вызовами инструментов, приходят внутри блоков thinking, которые по умолчанию пусты.
Агент только расследует. У него есть инструменты для чтения и нет продакшн‑доступов. После сбора доказательств отдельные запросы планирования предлагают контрфактические тесты, а Python валидирует и запускает план уровня medium.
Полный код, генератор данных и веб‑приложение находятся в этом репозитории GitHub.
HarborCart — вымышленный магазин. Его checkout-api обслуживает страницы корзины, статус заказа и POST /checkout, который списывает средства через сторонний платёжный шлюз. Все эти эндпоинты используют общий пул PostgreSQL — 15 соединений на инстанс.
Происходит деплой, и через пять минут шлюз около 90 секунд отдаёт 503. Задержка оплаты растёт сверх 30 секунд, пул забит на 15 из 15. Обвинить платёжного провайдера — просто, и шлюз действительно падал.
Скрытая причина — на шаг глубже. Деплой разрешил повторные попытки неудачных списаний POST до трёх раз, итого четыре попытки, без паузы, пока обработчик держит соединение с БД. Медленные неудачные списания теперь удерживают соединения 30 секунд и более — пул исчерпывается, и падают даже страницы корзины, которые к шлюзу не обращаются.
Далее используем три термина последовательно. Здесь триггер — временный сбой шлюза. Повторы механизм усиления — это повторы POST при удержании дефицитных соединений с БД; а исчерпание общего пула — это системный сбой.
Агент начинает с алерта, скриншота мониторинга и диаграммы архитектуры. Всё остальное приходит через инструменты: логи, трейсы, пять метрик, метаданные деплоя, Git‑дифф и ранбук. В доказательства преднамеренно добавлены три конкурирующих объяснения: предупреждение об инвентаризации, предупреждение фронтенда и возможное насыщение CPU.
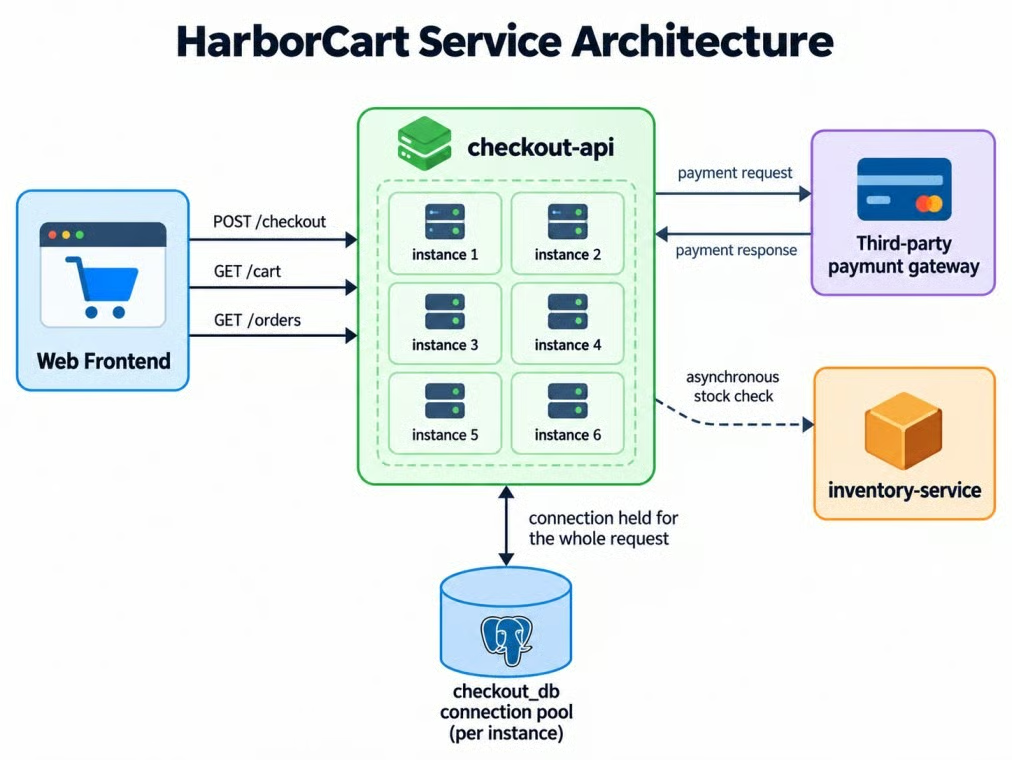
Путь оплаты HarborCart и общий пул. Изображение автора.
Диаграмма показывает, что соединение удерживается на весь запрос. Она не утверждает, что это проблема; расследование должно выяснить это самостоятельно.
Определите критерии успеха до сборки агента. Верный отчёт должен:
POST Нужен Python 3.10+ и ключ Anthropic с доступом к claude-opus-5-5. Эти команды PowerShell клонируют проект и установят закреплённые зависимости, включая anthropic 1.8.0. Если вы на Amazon Bedrock, сначала прочитайте FAQ — часть функций не перенесётся.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
На macOS или Linux активируйте через source .venv/bin/activate и копируйте с помощью cp .env.example .env. Добавьте ключ в .env — python-dotenv загрузит его для SDK; наш гайд по переменным окружения объясняет подход. Если вы уже вызывали Claude из Python, пропустите следующий подраздел — он лишь подтверждает настройку.
Минимально полезный запрос подтверждает ключ и показывает структуру ответа.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
В этом запросе ответ содержит блоки thinking и text. Выбирайте блоки по типу, а не через чтение response.content[0].
Агенты с вызовом инструментов соединяют Messages API Claude с Python‑функциями, контролирующими доступ к данным. Приложение следует правилу: Claude решает, какие доказательства ему нужны, а Python — к чему можно дать доступ.
Наше руководство по инженерии обвязки агента описывает более общие границы инструментов и циклы; HarborCart держит инструменты только для чтения и ограничивает их текущим инцидентом.
Каждый инструмент читает фиксированный набор данных и возвращает ограниченный JSON‑результат. Запросы логов и трейсинга возвращают максимум 200 строк плюс счётчик, а запросы метрик — максимум 60 точек.
Программные вызовы инструментов не поддерживают strict: true, поэтому разделите инструменты на два типа. Контроль доступа к данным и инструмент остановки расследования держите строгими и доступными только напрямую. Логи, трейсы и метрики — только через исполнение кода, чтобы у Claude был один понятный путь для больших запросов.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers направляет модель, но не является границей безопасности. Python проверяет вызывающего перед исполнением каждого инструмента и отклоняет прямые вызовы запроса. Программные вызовы также обходят строгую валидацию, поэтому функции запросов всё равно валидируют свои аргументы.
Приложение помечает каждый принятый результат инструмента, отклоняет выводы, которые ссылаются на отсутствующие доказательства, и принимает URL документации только если их вернул веб‑поиск. Выходы реплея пишет Python, а не модель.
Как отмечено в разделе миграции, оставляйте tool_choice в значении auto. В промпте укажите, когда применять инструмент, и используйте строгие схемы там, где аргументы должны быть точными.
Цикл отправляет диалог, выполняет блоки tool_use, добавляет результаты и повторяет. Добавляйте блоки ассистента без изменений, включая thinking, а пока программный код на паузе — передавайте ID container обратно только с блоками tool_result.
Запрос на расследование включает vision, инструменты, веб‑поиск, effort и бюджет задачи, но без выходной схемы. Это не допускает включение результатов поиска со ссылками в структурированный JSON‑вывод, а стабильный префикс запроса сохраняет кэширование промптов активным:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Приложите к первому пользовательскому сообщению дашборд и диаграмму архитектуры как base64 PNG. Попросите Claude считать всё, что он «читает» с изображения, гипотезой и подтверждать её через query_metrics.
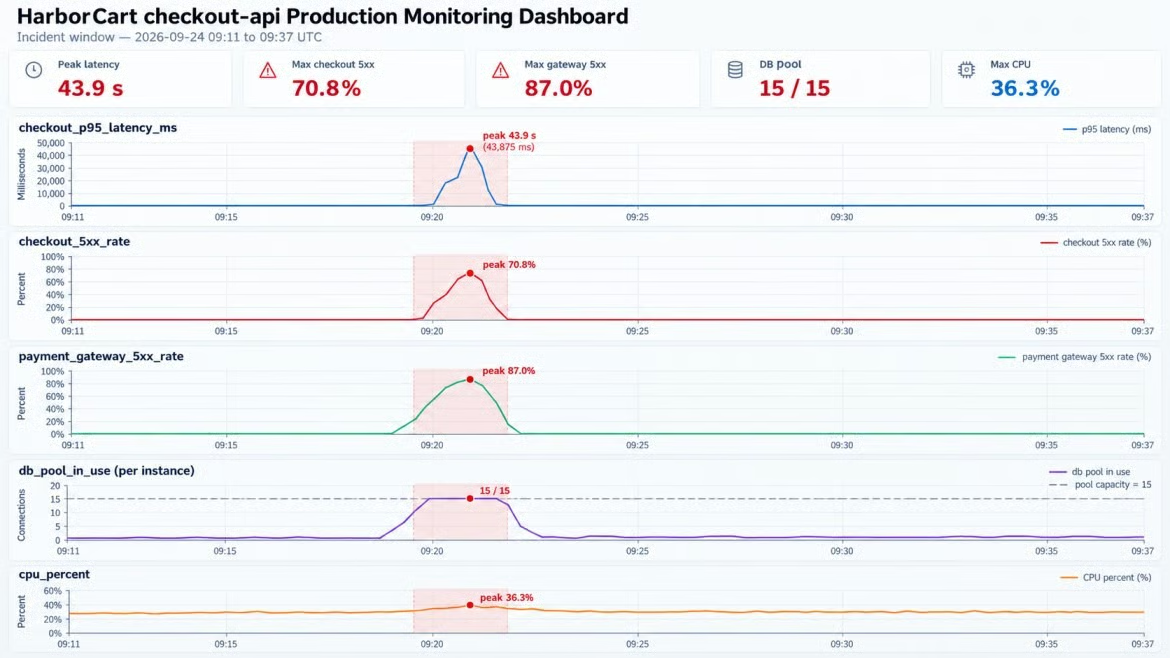
Дашборд показывает насыщение пула при ровном CPU. Изображение автора.
И дашборд, и запросы метрик используют одни и те же исходные данные. CPU держится около 30%, пока пул полон, что ещё до запросов говорит против версии «хост перегружен».
Скриншот подсказывает, куда смотреть, но числовой ряд решает, подтверждается ли наблюдение. Vision генерирует гипотезу; метрики проверяют её.
Для сценариев «сначала изображение» см. наш туториал по agentic vision. В HarborCart vision используется только для выбора следующей метрики.
Программный вызов инструментов позволяет Claude писать Python‑код, который выполняется в контейнере и вызывает ваши инструменты как функции. «Сырые» результаты остаются в песочнице, а к модели попадает только напечатанный вывод кода.
Агент пишет короткие скрипты, которые вытягивают сбойные трейсы и печатают только количества по эндпоинтам. В одном полном расследовании программные вызовы сократили объём сериализованных доказательств, возвращённых модели, на 98,8%. Результаты инструментов составили 42,9 КБ, а сводки — 0,5 КБ — это байты, а не сэкономленные токены тарификации.
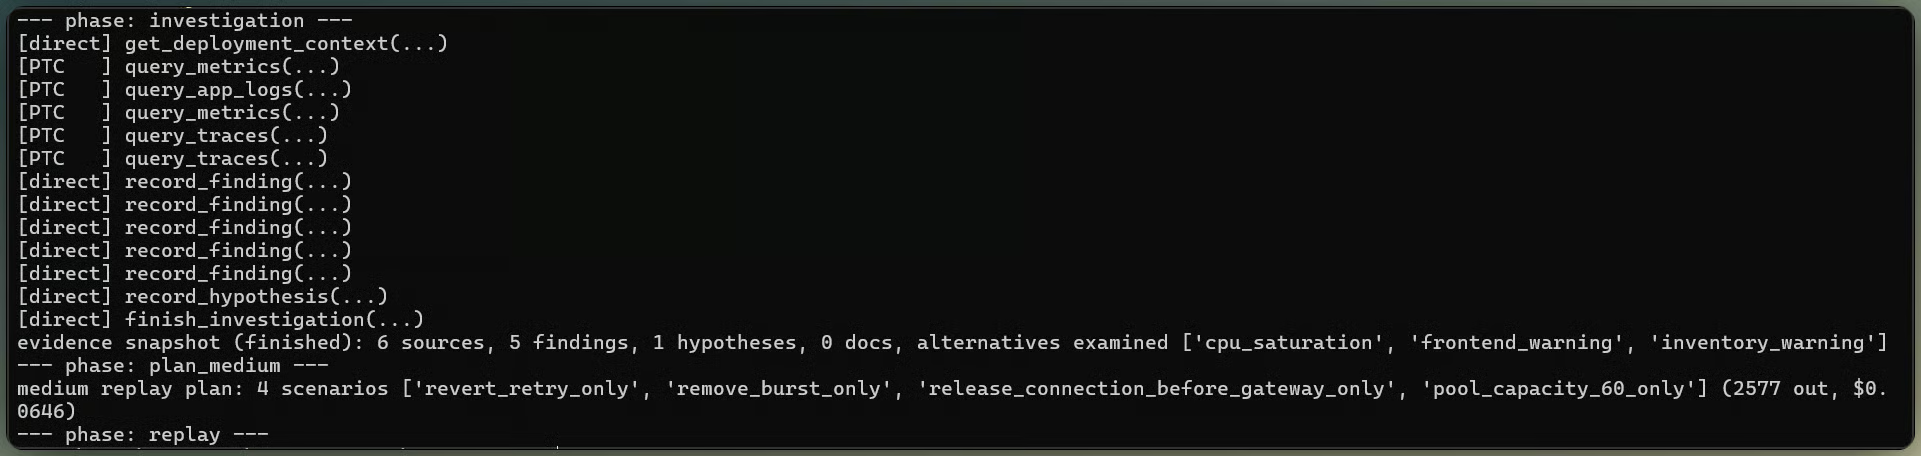
Вызовы инструментов сужают круг доказательств. Изображение автора.
Приложение предоставляет ограниченный веб‑поиск по семантике библиотеки повторов. Во время финальной оценки Claude им не пользовался, так что диагноз основан на диффе, метриках, логах и трейсе. Справочник urllib3 отдельно подтверждает, что allowed_methods=None ретраит любой глагол, а backoff_factor=0 убирает ожидание, но эта страница не входит в набор измеренных доказательств.
Контрфактический реплей повторно прокручивает трафик инцидента, убирая подозреваемую причину, и проверяет, исчезает ли сбой. Это превращает «эти линии растут вместе» в эксперимент.
Реплей использует тот же профиль трафика. В сравнении ниже каждый сценарий меняет одно условие, и приложение контролирует, какие изменения допустимы.
Сводка разделяет 503 шлюза и таймауты пула, а также 503 на оплате и чтения корзины/заказа. Именно это позволяет модели отличить триггер от усилителя.
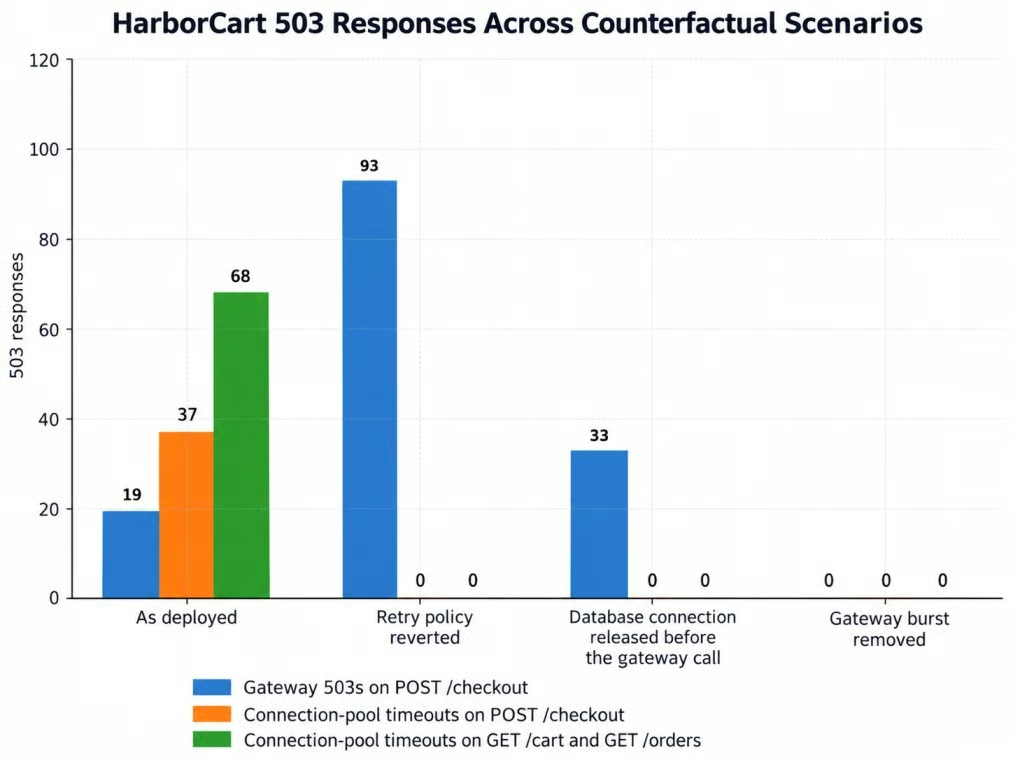
Каждый реплей меняет ровно одну вещь. Изображение автора.
Базовый реплей дал 124 ответа 503: 105 таймаутов пула, включая 68 сбоев на эндпоинтах чтения, и 19 ошибок шлюза. Откат политики повторов убрал все таймауты пула и ошибки чтения, но показал 93 шлюзовых 503 на оплате. Освобождение соединения до вызова шлюза также убрало сбои пула, оставив 33 шлюзовых 503, а удаление всплеска шлюза дало ноль ошибок.
Реплей показывает компромисс: откат защищает общий пул, но пропускает больше сбоев оплаты. Используйте как временную меру. Затем добавьте ключ идемпотентности, чтобы повторный платёж не списывал дважды, и перестаньте держать соединение во время вызова шлюза.
Системный промпт просит запустить реплей, но промпт — не механизм принуждения. Цикл проверяет наличие доказательств реплея и отклоняет неподтверждённый диагноз.
Держите эту проверку в Python. Более жёсткий промпт может повысить дисциплину, но не гарантирует её.
Effort определяет, сколько Claude рассуждает на шаг, а бюджет задачи — сколько работы должен занять весь цикл. Наш туториал по Claude Opus 5 API сравнивает все пять уровней effort; здесь medium и high получают один и тот же набор данных до реплея.
В продакшне остаётся medium. До реплея приложение просит уровни medium и high спроектировать причинный тест на одних и тех же данных. Исполняется только рекомендация medium; ответ high служит для сравнения.
Запрос high использует пометку output_config.effort на уровне сообщения за флагом mid-conversation-output-config-2026-07-01. Он не видит ответ medium.
Оба уровня выбрали одну и ту же гипотезу и три одинаковых базовых сценария реплея. В среднем high использовал 2 631 выходной токен против 2 307 у medium и стоил примерно на 11% дороже без изменения причинного теста.
Выбирайте бюджет задачи по наблюдаемому использованию, а не «на глаз». Крупнейшее неограниченное расследование HarborCart потребило 13 322 учитываемых токена, включая вывод модели и текст результатов инструментов, увиденный Claude. Добавим 25% запаса — получим 16 653, ниже минимальных 20 000 у Anthropic, поэтому настроен бюджет 20 000.
Лимиты по числу ходов и времени держите на уровне приложения. Запуск эксперимента переставал начинать новые работы после достижения записанных расходов $2,50. Это не жёсткий потолок: уже идущий запрос может завершиться выше него.
Итоговый ответ использует структурированные выводы. Его плоская схема охватывает вердикт, причину, отклонённые гипотезы, доказательства и фикс. Стоимость и задержка не включаются — их измеряет приложение.
Ссылки из веб‑поиска и output_config.format нельзя совмещать в одном запросе: для ссылок нужны чередующиеся блоки контента, а для схемы требуется JSON. Поэтому HarborCart расследует без выходной схемы. Он сохраняет выводы, привязанные к источникам и результатам реплея, а затем отправляет только проверенные данные во второй запрос — без инструментов и поиска.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
Второму запросу нужны только проверенные доказательства, поэтому сохранять полный кэш расследования не требуется.
Разрешите "inconclusive" в поле verdict. Отчёт не должен «выжимать» подтверждённый диагноз, если реплей ему противоречит.
Схема проверяет форму отчёта, а реплей — диагноз. Отказ тоже возвращает HTTP 200 со stop_reason: "refusal" и может не соответствовать вашей схеме, поэтому проверяйте причину остановки до парсинга.
Все три финальных отчёта нашли основной причинный механизм и отвергли три альтернативные версии. Два прошли все восемь проверок; третий получил 6/8, так как не указал явное изменение конфигурации ретраев POST и не сослался на дифф деплоя. Поэтому офлайн‑оценка отделена от валидации схемы: корректный JSON и верный диагноз всё ещё могут дать неполный отчёт.
Отчёты также выделяют второй риск: повтор платежа может списать средства дважды. RFC 9110 не определяет POST как по природе идемпотентный и не советует автоматические повторы, если клиент не уверен в безопасности операции. Ключ идемпотентности, поддерживаемый платёжным провайдером, — один из распространённых способов сделать повторы безопаснее.
Наш туториал по Streamlit описывает настройку интерфейса. Интерфейс HarborCart показывает события расследования, планы реплея для medium и high, результаты реплея, финальный отчёт и стоимость. Для статуса между вызовами инструментов гайд по промптам Claude Opus 5.5 описывает display: "updates"; приложение также рендерит события инструментов, когда блок обновлений пуст.
Учитесь с DataCamp
Course
Course
Course