
Curso
Claude 101
2 h
21.4K
Neste tutorial, vou testar um cenário: poucos minutos após uma atualização de software, a HarborCart — uma loja fictícia que vou usar aqui — começa a registrar falhas no checkout. Alguns clientes esperam mais de 30 segundos; outros veem um erro de servidor e não conseguem pagar. O provedor de pagamentos também enfrenta uma queda breve, então parece a causa mais óbvia.
Mas a indisponibilidade do provedor não explica por que as páginas de carrinho e de pedidos também falham. Encontrar o elo perdido exige logs da aplicação, gráficos, registros de requisições e a mudança recente de código. Este tutorial testa se o Claude Opus 5.5 consegue seguir essas evidências, validar sua explicação sob condições controladas e relatar apenas o que as evidências sustentam.
Contexto rápido: o Claude Opus 5.5 chegou no início daquela semana, pouco antes de eu começar este projeto. Nossa visão geral do Claude Opus 5.5 cobre o lançamento e os benchmarks, então este guia foca na API e constrói um agente de investigação do primeiro request até um relatório verificado.
Vamos ver como:
O investigador da HarborCart separou o estouro no gateway de pagamentos da política de retry que o amplificou, testou essa explicação e só então devolveu um relatório.
Você acessa o Claude Opus 5.5 pela Messages API da Anthropic com o ID de modelo claude-opus-5-5. Segundo a visão geral do modelo, ele aceita texto e imagens, com janela de contexto de 1M tokens e saída máxima de 128K. O pensamento adaptativo está sempre ativado e o effort padrão é medium.
A precificação padrão é de US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. Escritas em cache de 5 minutos custam US$ 5 por milhão e leituras de cache, US$ 0,20. Quando o prompt caching está ativo, prefixos correspondentes são cobrados pela tarifa menor de leitura de cache.
Quatro pontos do guia de migração aparecem diretamente neste projeto.
Forçar tool_choice com any ou uma ferramenta nomeada retorna erro 400.
O effort padrão caiu de high no Claude Opus 5 para medium.
O thinking não pode ser desativado, e blocos thinking devem voltar inalterados dentro do loop de ferramentas.
Anotações que o modelo escreve entre chamadas de ferramentas chegam dentro de blocos thinking, que são vazios por padrão.
O agente apenas investiga. Ele recebe ferramentas de evidência somente leitura e nenhum credencial de produção. Após coletar evidências, requests de planejamento separados propõem testes contrafactuais, e o Python valida e executa o plano com effort médio.
O código completo, incluindo gerador de evidências e web app, está neste repositório no GitHub.
A HarborCart é uma loja fictícia. Sua checkout-api atende as páginas do carrinho, status de pedido e POST /checkout, que aciona a cobrança em um gateway de pagamentos de terceiros. Todos esses endpoints compartilham um pool PostgreSQL de 15 conexões por instância.
Sai um deploy e, cinco minutos depois, o gateway retorna 503s por cerca de 90 segundos. A latência do checkout passa de 30 segundos enquanto o pool fica em 15 de 15. Culpar o provedor de pagamentos é a saída fácil, e o gateway de fato falhou.
A causa oculta está um passo adiante. O deploy permitiu que cobranças POST com falha tenham retry até três vezes, totalizando quatro tentativas, sem pausa, enquanto o handler mantém sua conexão de banco. Cobranças lentas e falhas agora seguram conexões por 30 segundos ou mais, até o pool esgotar, e páginas do carrinho que nunca chamam o gateway também caem.
Uso três termos de forma consistente daqui em diante. Aqui, o gatilho é a falha temporária do gateway. Repetir o POST do checkout enquanto segura conexões de banco escassas é o mecanismo de amplificação; o esgotamento do pool compartilhado é a falha do sistema.
O agente começa com o alerta, uma captura do monitoramento e um diagrama de arquitetura. Todo o resto vem via ferramentas: logs, traces, cinco métricas, metadados de deploy, o diff do Git e um runbook. Três explicações concorrentes são inseridas nas evidências: um alerta de inventário, um alerta no frontend e possível saturação de CPU.
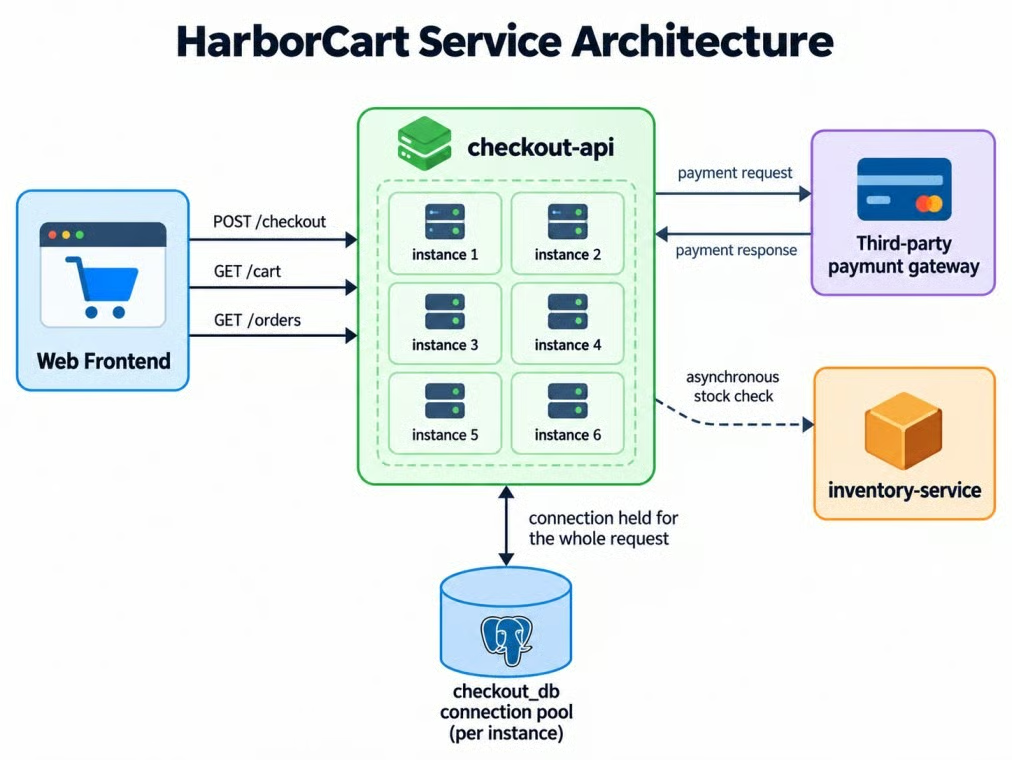
Caminho do checkout da HarborCart e pool compartilhado. Imagem do autor.
O diagrama indica que a conexão é mantida durante toda a requisição. Ele não diz que isso é um problema; a investigação precisa descobrir.
Defina sucesso antes de construir o agente. Um relatório correto deve:
POSTVocê precisa do Python 3.10 ou superior e de uma chave da Anthropic com acesso a claude-opus-5-5. Estes comandos no PowerShell clonam o projeto e instalam as dependências fixadas, incluindo anthropic 1.8.0. Se você usa Amazon Bedrock, leia as FAQs primeiro, porque vários recursos não são compatíveis.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
No macOS ou Linux, ative com source .venv/bin/activate e copie com cp .env.example .env. Adicione sua chave ao .env, e o python-dotenv carrega para o SDK; nosso guia de variáveis de ambiente explica o padrão. Se você já chamou o Claude em Python antes, pode pular a próxima subseção, que só confirma a configuração.
O menor request útil confirma a chave e mostra o que volta na resposta.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
Neste request, a resposta contém blocos thinking e text. Selecione blocos por tipo em vez de ler response.content[0].
Agentes de tool calling unem a Messages API do Claude a funções Python que controlam o acesso a dados. A aplicação segue uma regra: o Claude decide de que evidências precisa, e o Python decide ao que ele pode acessar.
Nosso guia de engenharia do harness de agentes cobre limites de ferramentas e loops mais amplos; a HarborCart mantém suas ferramentas somente leitura e limitadas a este incidente.
Cada ferramenta lê um conjunto fixo de evidências e retorna um JSON limitado. Consultas de log e trace retornam no máximo 200 linhas mais uma contagem, e consultas de métricas retornam no máximo 60 pontos.
Chamadas programáticas não suportam strict: true, então divida as ferramentas em duas. Mantenha os controles de evidência e a ferramenta de encerrar investigação com schema estrito e apenas chamada direta. Logs, traces e métricas usam apenas execução de código, o que dá ao Claude um caminho claro para consultas de evidências grandes.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers orienta o modelo, mas não é uma barreira de segurança. O Python checa o chamador antes de executar cada ferramenta e rejeita chamadas diretas a consultas. Chamadas programáticas também pulam validação estrita, então funções de consulta ainda validam seus próprios argumentos.
A aplicação etiqueta todo resultado de ferramenta aceito, rejeita conclusões que citem evidência ausente e aceita URLs de documentação apenas quando a busca na web as retornou. O Python, não o modelo, registra as saídas do replay.
Como observado na migração, mantenha tool_choice em auto. Diga no prompt quando uma ferramenta se aplica e use schemas estritos onde argumentos precisam ser exatos.
O loop envia a conversa, executa quaisquer blocos de tool_use, anexa os resultados e repete. Anexe inalterados os blocos do assistant, incluindo thinking, e, enquanto o código programático estiver pausado, devolva o ID do container apenas com blocos tool_result.
O request de investigação inclui visão, ferramentas, busca na web, effort e task budget, mas sem schema de saída. Isso impede que resultados com citações entrem em JSON estruturado, enquanto o prefixo estável mantém o prompt caching ativo:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Anexe o dashboard e o diagrama de arquitetura à primeira mensagem do usuário como PNGs base64. Diga ao Claude para tratar qualquer coisa lida da imagem como hipótese e confirmá-la com query_metrics.
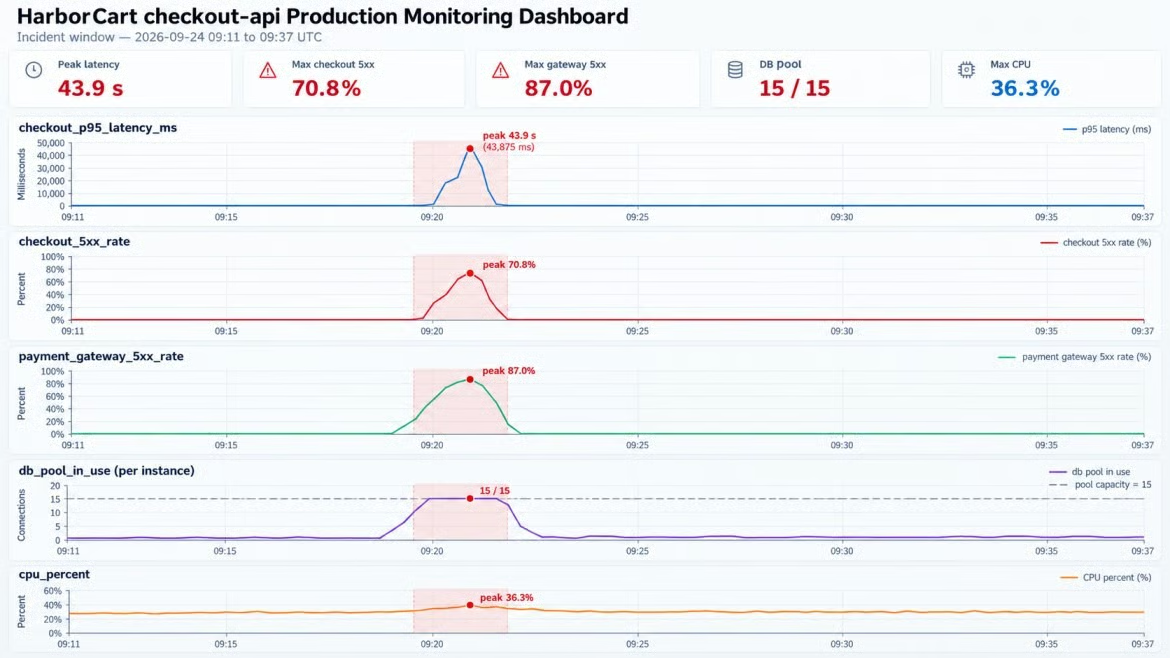
O painel mostra saturação do pool e CPU estável. Imagem do autor.
Tanto o dashboard quanto as consultas de métricas usam a mesma fonte de dados. A CPU fica perto de 30% enquanto o pool está cheio, o que enfraquece a hipótese de “host sobrecarregado” antes de qualquer consulta rodar.
A captura sugere onde olhar, mas as séries numéricas decidem se a observação se sustenta. A visão gera a hipótese; as métricas a testam.
Para fluxos image-first, veja nosso tutorial de visão agentic. A HarborCart usa visão apenas para escolher a próxima métrica.
Chamadas programáticas permitem que o Claude escreva Python que roda em um container de execução e chame suas ferramentas como funções. Resultados brutos ficam no sandbox, e só a saída impressa pelo código chega ao modelo.
O agente escreve scripts curtos que puxam traces com falha e imprimem apenas as contagens por endpoint. Em uma investigação completa, as chamadas programáticas reduziram em 98,8% as evidências serializadas devolvidas ao modelo. Os resultados das ferramentas somaram 42,9 KB e os resumos, 0,5 KB — uma medida em bytes, não em tokens faturados de entrada.
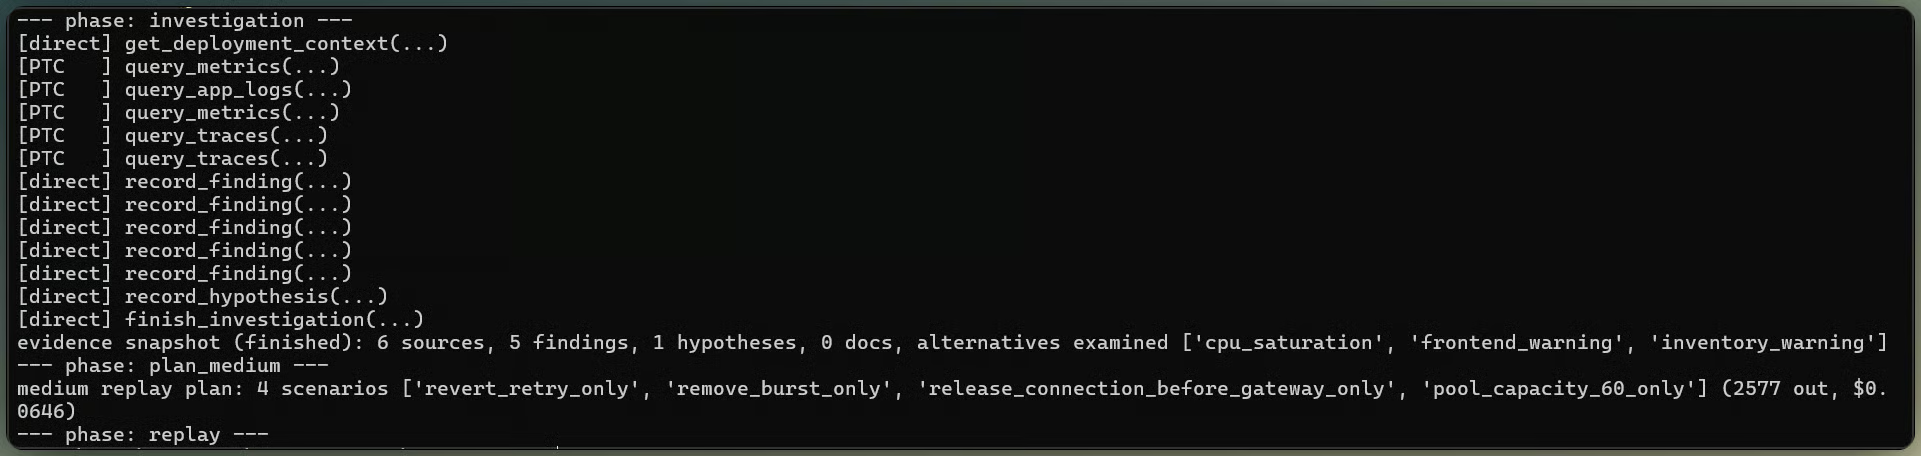
As chamadas de ferramenta afunilam as evidências do incidente. Imagem do autor.
A aplicação expõe busca web restrita para semântica da biblioteca de retry. O Claude não a chamou na avaliação final, então o diagnóstico medido se apoia no diff, métricas, logs e traces. A referência do urllib3 confirma de forma independente que allowed_methods=None faz retry de qualquer verbo e backoff_factor=0 remove a espera, mas essa página não faz parte das evidências medidas.
Um replay contrafactual reexecuta o tráfego do incidente removendo uma causa suspeita e verifica se a falha some. Ele transforma “essas linhas sobem juntas” em um teste.
O replay reutiliza o mesmo padrão de tráfego. Para a comparação abaixo, cada cenário muda uma única condição, e a aplicação controla quais mudanças são permitidas.
O resumo separa 503s do gateway de timeouts do pool, e 503s do checkout de leituras de carrinho e pedido. Essa divisão permite ao modelo distinguir gatilho de amplificador.
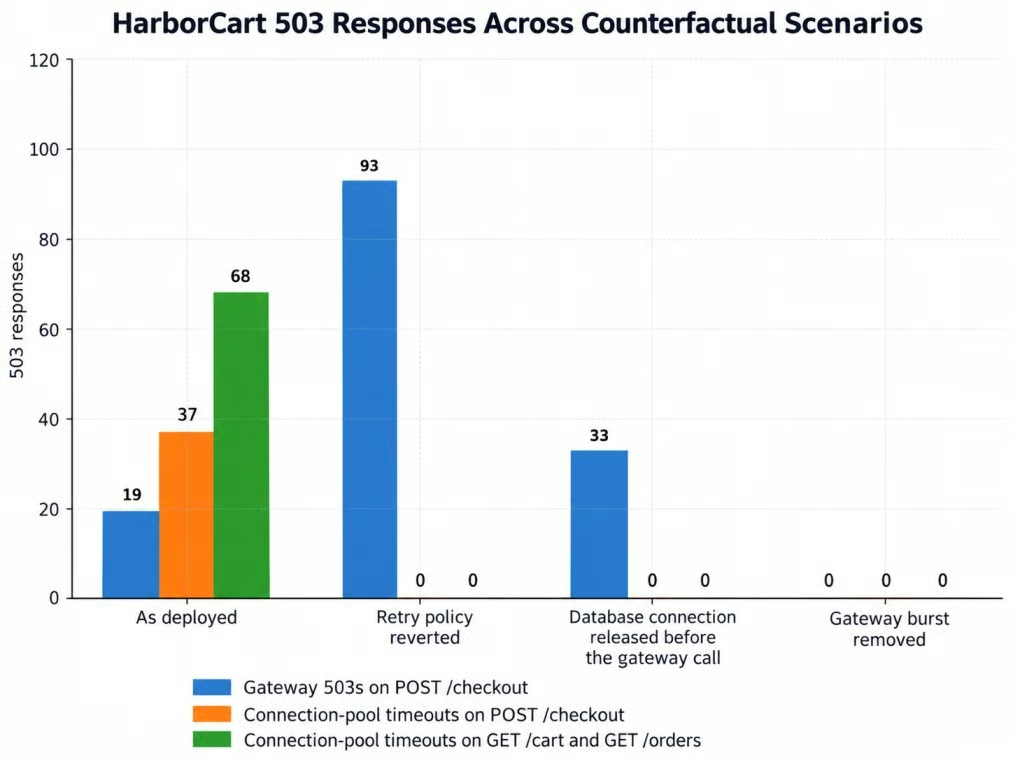
Cada replay muda exatamente uma coisa. Imagem do autor.
O replay de base produziu 124 erros 503: 105 timeouts de pool, incluindo 68 falhas em endpoints de leitura, e 19 erros de gateway. Reverter a política de retry removeu todos os timeouts de pool e falhas de leitura, mas expôs 93 503s de gateway no checkout. Liberar a conexão antes da chamada ao gateway também removeu falhas de pool, deixando 33 503s de gateway; e remover o pico do gateway zerou os erros.
O replay expõe o trade-off: um rollback protege o pool compartilhado, mas deixa mais falhas de checkout passarem. Use como paliativo. Depois, adicione uma chave de idempotência para evitar cobrança dupla em retries e pare de segurar a conexão durante a chamada ao gateway.
O system prompt pede um replay, mas prompt não é mecanismo de enforcement. O loop verifica se há evidência de replay e rejeita um diagnóstico não testado.
Mantenha essa checagem em Python. Um prompt mais rígido pode melhorar a adesão, mas não garante.
Effort define quanto o Claude raciocina por etapa, e um task budget define quanto trabalho o loop inteiro deve levar. Nosso tutorial do Claude Opus 5 compara os cinco níveis de effort; aqui, medium e high recebem as mesmas evidências pré-replay.
Produção fica em medium. Antes do replay, a aplicação pede que efforts médio e alto desenhem um teste causal com as mesmas evidências. Ela executa só a recomendação do médio; a resposta do alto serve apenas de comparação.
O request em high usa uma mudança por mensagem em output_config.effort via mid-conversation-output-config-2026-07-01. Ele não vê a resposta do médio.
Ambos os níveis escolheram a mesma hipótese e os mesmos três cenários centrais de replay. High usou em média 2.631 tokens de saída, contra 2.307 no médio, e custou cerca de 11% a mais sem mudar o teste causal.
Escolha o task budget a partir do uso observado, não por chute. A maior investigação sem limite da HarborCart consumiu 13.322 tokens contados, incluindo saída do modelo e texto de resultados de ferramentas vistos pelo Claude. Adicionar 25% de margem dá 16.653, abaixo do mínimo de 20.000 da Anthropic, então o budget configurado é 20.000.
Mantenha também limites de turnos e tempo decorrido na aplicação. O executor do experimento parou de iniciar trabalho novo quando o gasto registrado chegou a US$ 2,50. Não é um teto rígido, pois um request em andamento pode terminar acima disso.
A resposta final usa saídas estruturadas. Seu schema plano cobre veredito, causa, hipóteses rejeitadas, evidências e correção. Custo e latência ficam de fora porque a aplicação mede.
Citações de busca web e output_config.format não podem compartilhar o mesmo request: citações precisam de blocos intercalados, enquanto o schema exige JSON. A HarborCart, portanto, investiga sem schema de saída. Ela armazena achados atrelados às suas fontes e aos resultados do replay, e envia apenas essas evidências verificadas para um segundo request sem ferramentas nem busca na web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
O segundo request precisa apenas das evidências verificadas, então preservar o cache completo da investigação não é necessário.
Permita "inconclusive" no campo verdict. Um relatório não deve ser forçado a fechar um diagnóstico quando o replay o contradiz.
O schema valida a forma do relatório, enquanto o replay valida o diagnóstico. Uma recusa também retorna HTTP 200 com stop_reason: "refusal" e pode não bater com seu schema, então confira o stop reason antes de fazer o parse.
Os três relatórios finais encontraram o mecanismo causal central e descartaram as três explicações alternativas. Dois atenderam aos oito critérios; o terceiro marcou 6/8 porque omitiu a mudança explícita de configuração de retry em POST e não citou o diff do deploy. Por isso a avaliação offline fica separada da validação de schema: JSON válido e o diagnóstico certo ainda podem render um relatório incompleto.
Os relatórios também identificam um segundo risco: repetir a cobrança pode faturar o cliente duas vezes. A RFC 9110 não define POST como inerentemente idempotente e desaconselha retries automáticos, a menos que o cliente saiba que a operação é segura de repetir. Uma chave de idempotência suportada pelo provedor de pagamentos é um caminho comum para tornar esses retries mais seguros.
Nosso tutorial de Streamlit cobre a configuração da interface. A interface da HarborCart mostra eventos da investigação, os planos de replay em effort médio e alto, resultados do replay, o relatório final e o custo. Para status entre chamadas de ferramenta, o guia de prompting do Claude Opus 5.5 descreve display: "updates"; o app também renderiza eventos de ferramenta quando um bloco de update está vazio.
Aprenda com a DataCamp
Curso
Curso
Curso