
course
Claude 101
2 घंटा
21.4K
इस ट्यूटोरियल में, मैं एक परिदृश्य का परीक्षण करूँगा: सॉफ़्टवेयर अपडेट के कुछ मिनट बाद, HarborCart — एक स्टोर जिसका उपयोग मैं इस परिदृश्य के लिए करूँगा — में चेकआउट फेल्योर दिखने लगते हैं। कुछ ग्राहक 30 सेकंड से अधिक इंतज़ार करते हैं; अन्य लोगों को सर्वर त्रुटि दिखती है और वे भुगतान नहीं कर पाते। भुगतान प्रदाता में भी एक छोटा आउटेज है, तो वजह साफ़-साफ़ वही लगती है।
लेकिन प्रदाता का आउटेज यह नहीं समझाता कि कार्ट और ऑर्डर पेज भी क्यों फेल हो रहे हैं। लापता कड़ी ढूँढने के लिए एप्लिकेशन लॉग, चार्ट, रिक्वेस्ट रिकॉर्ड और हाल का कोड परिवर्तन चाहिए। यह ट्यूटोरियल जाँचता है कि Claude Opus 5.5 क्या उस साक्ष्य-श्रृंखला का पालन कर सकता है, नियंत्रित शर्तों में अपनी व्याख्या की परख कर सकता है, और सिर्फ वही रिपोर्ट कर सकता है जिसे साक्ष्य समर्थन करते हैं।
कुछ पृष्ठभूमि: Claude Opus 5.5 उसी सप्ताह की शुरुआत में आया, ठीक इससे पहले कि मैंने यह प्रोजेक्ट शुरू किया। हमारा Claude Opus 5.5 ओवरव्यू लॉन्च और बेंचमार्क कवर करता है, इसलिए यह ट्यूटोरियल API पर केंद्रित रहता है और पहली रिक्वेस्ट से लेकर सत्यापित रिपोर्ट तक एक इन्वेस्टिगेशन एजेंट बनाता है।
हम सीखेंगे कि कैसे:
HarborCart के इन्वेस्टिगेटर ने भुगतान गेटवे के बर्स्ट को उस रिट्राई पॉलिसी से अलग किया जिसने उसे बढ़ाया, फिर रिपोर्ट लौटाने से पहले उस व्याख्या का परीक्षण किया।
आप Anthropic के Messages API के जरिए मॉडल ID claude-opus-5-5 के साथ Claude Opus 5.5 तक पहुँचते हैं। मॉडल ओवरव्यू के अनुसार, यह टेक्स्ट और इमेज लेता है, 1M-टोकन कॉन्टेक्स्ट विंडो और 128K अधिकतम आउटपुट के साथ। Adaptive thinking हमेशा ऑन रहता है, और डिफ़ॉल्ट effort medium है।
मानक प्राइसिंग प्रति मिलियन इनपुट टोकन $4 और प्रति मिलियन आउटपुट टोकन $20 है। पाँच-मिनट कैश राइट्स की लागत प्रति मिलियन $5 और कैश रीड्स $0.20 है। जब प्रॉम्प्ट कैशिंग सक्रिय होती है, तो मिलते-जुलते प्रीफ़िक्स उसी कम कैश-रीड दर पर बिल होते हैं।
माइग्रेशन गाइड के चार बिंदु इस प्रोजेक्ट में सीधे दिखते हैं।
मजबूरन tool_choice को any या किसी नामित टूल पर सेट करने से 400 त्रुटि मिलती है।
डिफ़ॉल्ट effort Claude Opus 5 पर high से घटकर medium हो गया।
Thinking बंद नहीं किया जा सकता, और thinking ब्लॉक्स को टूल लूप के भीतर बिना बदले वापस भेजना चाहिए।
टूल कॉल्स के बीच मॉडल द्वारा लिखे गए नोट्स thinking ब्लॉक्स के अंदर आते हैं, जो डिफ़ॉल्ट रूप से खाली होते हैं।
एजेंट सिर्फ जाँच करता है। उसे केवल-पढ़ने वाले साक्ष्य टूल मिलते हैं और कोई प्रोडक्शन क्रेडेंशियल नहीं। साक्ष्य एकत्र करने के बाद, अलग प्लानिंग रिक्वेस्ट काउंटरफ़ैक्चुअल परीक्षण प्रस्तावित करती हैं, और Python मध्यम-प्रयास योजना को वैध ठहराता और चलाता है।
पूरा कोड, साक्ष्य जेनरेटर और वेब ऐप सहित, इस GitHub रिपॉजिटरी में है।
HarborCart एक काल्पनिक स्टोर है। इसका checkout-api कार्ट पेज, ऑर्डर स्टेटस, और POST /checkout सर्व करता है, जो किसी तृतीय-पक्ष पेमेंट गेटवे को चार्ज करता है। इन सभी एंडपॉइंट्स के पास प्रति इंस्टेंस 15 कनेक्शनों का एक साझा PostgreSQL पूल है।
एक डिप्लॉय शिप होता है, और पाँच मिनट बाद गेटवे लगभग 90 सेकंड तक 503s लौटाता है। चेकआउट लेटेंसी 30 सेकंड से ऊपर जाती है जबकि पूल 15 में से 15 पर अटका रहता है। भुगतान प्रदाता को दोष देना आसान निर्णय है, और गेटवे सचमुच फेल हुआ भी था।
छिपा हुआ कारण एक कदम और अंदर बैठा है। डिप्लॉय ने असफल POST चार्ज को अधिकतम तीन बार रिट्राई करने दिया, कुल चार चार्ज प्रयासों के लिए, बिना किसी विराम के जबकि हैंडलर अपना डेटाबेस कनेक्शन पकड़े रहता है। अब धीरे-धीरे फेल होते चार्ज 30 सेकंड या उससे अधिक के लिए कनेक्शन पकड़े रखते हैं, जब तक पूल खत्म नहीं हो जाता और वे कार्ट पेज भी फेल होने लगते हैं जो कभी गेटवे को कॉल नहीं करते।
यहाँ से मैं तीन शब्द लगातार उपयोग करूँगा। यहाँ ट्रिगर अस्थायी गेटवे फेल्योर है। गिने-चुने डेटाबेस कनेक्शनों को पकड़े रखते हुए चेकआउट POSTs को रिट्राई करना एम्प्लीफिकेशन मैकेनिज़्म है; साझा कनेक्शन-पूल का खत्म होना सिस्टम फेल्योर है।
एजेंट एलर्ट, एक मॉनिटरिंग स्क्रीनशॉट और एक आर्किटेक्चर डायग्राम से शुरू करता है। बाकी सब टूल्स के जरिए आता है: लॉग, ट्रेस, पाँच मैट्रिक्स, डिप्लॉयमेंट मेटाडेटा, Git डिफ्फ़ और एक रनबुक। तीन प्रतिस्पर्धी व्याख्याएँ साक्ष्य में सीड की गई हैं: एक इन्वेंटरी चेतावनी, एक फ्रंटएंड चेतावनी, और संभावित CPU सैचुरेशन।
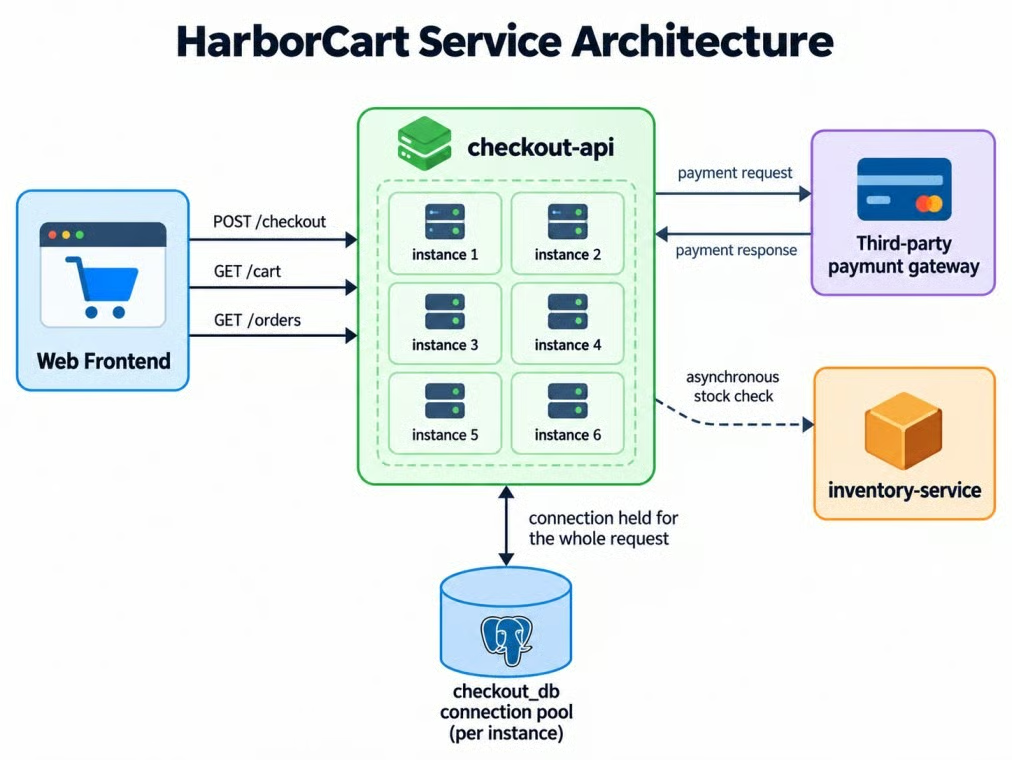
HarborCart चेकआउट पथ और साझा पूल। चित्र लेखक द्वारा।
डायग्राम बताता है कि कनेक्शन पूरे रिक्वेस्ट के लिए पकड़ा जाता है। यह नहीं कहता कि यह समस्या है; जाँच को उसे स्वयं निष्कर्षित करना होगा।
एजेंट बनाने से पहले सफलता परिभाषित करें। एक सही रिपोर्ट को यह करना चाहिए:
POST रिट्राई को अनुमति दीआपको Python 3.10 या नया और claude-opus-5-5 तक पहुँच वाला Anthropic API की चाहिए। ये PowerShell कमांड प्रोजेक्ट को क्लोन करते हैं और पिन की गई डिपेंडेंसीज़ इंस्टॉल करते हैं, जिनमें anthropic 1.8.0 शामिल है। यदि आप Amazon Bedrock पर हैं, तो पहले FAQs पढ़ें, क्योंकि कई फीचर्स पोर्ट नहीं होंगे।
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
macOS या Linux पर, source .venv/bin/activate से सक्रिय करें और cp .env.example .env से कॉपी करें। अपनी कुंजी .env में जोड़ें, और python-dotenv SDK के लिए उसे लोड करता है; हमारा एनवायरनमेंट वेरिएबल्स गाइड यह पैटर्न समझाता है। यदि आपने पहले Python से Claude को कॉल किया है, तो अगला उपखंड छोड़ दें, क्योंकि यह केवल सेटअप की पुष्टि करता है।
सबसे छोटी उपयोगी रिक्वेस्ट कुंजी की पुष्टि करती है और दिखाती है कि क्या वापस आता है।
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
इस रिक्वेस्ट में, प्रतिक्रिया में thinking और text ब्लॉक्स होते हैं। response.content[0] पढ़ने के बजाय प्रकार के आधार पर ब्लॉक्स चुनें।
टूल-कॉलिंग एजेंट Claude के Messages API को Python फ़ंक्शंस के साथ जोड़ते हैं जो डेटा एक्सेस नियंत्रित करते हैं। एप्लिकेशन एक नियम मानता है: Claude तय करता है कि उसे कौन-सा साक्ष्य चाहिए, और Python तय करता है कि उसे क्या एक्सेस करने की अनुमति है।
हमारा एजेंट हार्नेस इंजीनियरिंग गाइड व्यापक टूल सीमाएँ और लूप कवर करता है; HarborCart अपने टूल्स को केवल-पढ़ने तक और इस घटना तक सीमित रखता है।
हर टूल एक तय साक्ष्य सेट पढ़ता है और सीमित JSON परिणाम लौटाता है। लॉग और ट्रेस क्वेरी अधिकतम 200 पंक्तियाँ और एक काउंट लौटाती हैं, और मैट्रिक क्वेरी अधिकतम 60 पॉइंट लौटाती हैं।
प्रोग्रामैटिक टूल कॉलिंग strict: true को सपोर्ट नहीं करती, इसलिए टूल्स को दो हिस्सों में बाँटें। साक्ष्य नियंत्रण और इन्वेस्टिगेशन-स्टॉप टूल को सख्त और direct-only रखें। लॉग्स, ट्रेसेस और मैट्रिक्स केवल कोड एक्ज़ीक्यूशन का उपयोग करते हैं, जो बड़े साक्ष्य क्वेरी के लिए Claude को एक साफ़ रास्ता देता है।
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers मॉडल को मार्गदर्शन देता है पर यह सुरक्षा सीमा नहीं है। Python हर टूल चलाने से पहले कॉलर की जाँच करता है और direct क्वेरी कॉल को अस्वीकार करता है। प्रोग्रामैटिक कॉल्स सख्त वैलिडेशन भी छोड़ देती हैं, इसलिए क्वेरी फ़ंक्शंस अपने आर्ग्युमेंट्स खुद वैलिडेट करते हैं।
एप्लिकेशन हर स्वीकृत टूल परिणाम को टैग करता है, उस फ़ाइंडिंग को खारिज करता है जो ग़ायब साक्ष्य का हवाला देती है, और डॉक्युमेंटेशन URLs को तभी स्वीकारता है जब वेब सर्च ने उन्हें लौटाया हो। Python, मॉडल नहीं, रीप्ले आउटपुट रिकॉर्ड करता है।
जैसा कि माइग्रेशन सेक्शन में नोट किया गया है, tool_choice को auto पर रखें। प्रॉम्प्ट में कहें कि कोई टूल कब लागू होता है, और जहाँ आर्ग्युमेंट्स सटीक होने चाहिएँ, वहाँ सख्त स्कीमा उपयोग करें।
लूप बातचीत भेजता है, किसी भी tool_use ब्लॉक को चलाता है, परिणाम जोड़ता है, और दोहराता है। सहायक के ब्लॉक्स बिना बदले जोड़ें, thinking सहित, और जबकि प्रोग्रामैटिक कोड रुका है, केवल tool_result ब्लॉक्स के साथ container ID वापस पास करें।
इन्वेस्टिगेशन रिक्वेस्ट में विज़न, टूल्स, वेब सर्च, effort और task budget शामिल हैं, पर कोई आउटपुट स्कीमा नहीं। इससे उद्धरण-युक्त सर्च नतीजे स्ट्रक्चर्ड JSON आउटपुट से दूर रहते हैं, जबकि स्थिर रिक्वेस्ट प्रीफ़िक्स प्रॉम्प्ट कैशिंग को सक्रिय रखता है:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)डैशबोर्ड और आर्किटेक्चर डायग्राम को पहले यूज़र संदेश के साथ base64 PNG के रूप में संलग्न करें। Claude से कहें कि वह इमेज से जो भी पढ़े, उसे परिकल्पना माने और उसे query_metrics से कन्फर्म करे।
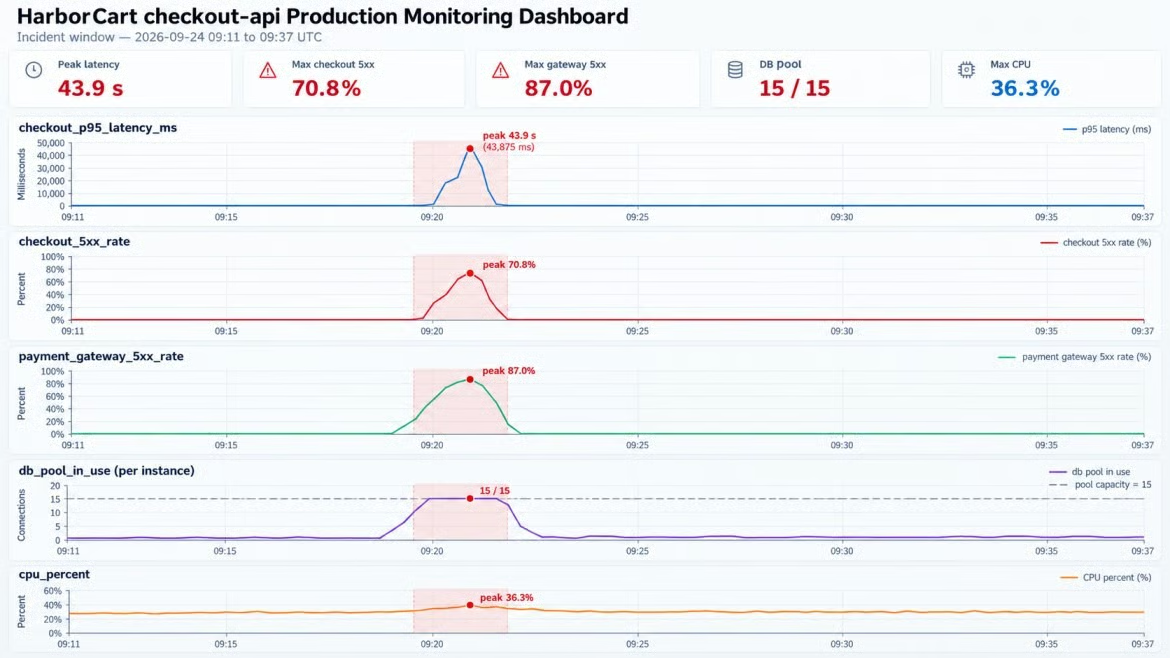
डैशबोर्ड पूल सैचुरेशन, सपाट CPU दिखाता है। चित्र लेखक द्वारा।
डैशबोर्ड और मैट्रिक क्वेरी दोनों एक ही स्रोत डेटा का उपयोग करते हैं। CPU पूल भरा होने पर भी लगभग 30% के पास रहता है, जो बिना कोई क्वेरी चलाए पहले से ही "होस्ट ओवरलोडेड है" के खिलाफ तर्क देता है।
स्क्रीनशॉट सुझाता है कि कहाँ देखना है, पर यह संख्यात्मक श्रृंखला तय करती है कि अवलोकन टिकता है या नहीं। विज़न परिकल्पना बनाता है; मैट्रिक्स उसे परखते हैं।
इमेज-फर्स्ट वर्कफ़्लो के लिए हमारा एजेंटिक विज़न ट्यूटोरियल देखें। HarborCart विज़न का उपयोग केवल अगला मैट्रिक चुनने के लिए करता है।
प्रोग्रामैटिक टूल कॉलिंग Claude को ऐसा Python लिखने देती है जो एक कोड एक्ज़ीक्यूशन कंटेनर में चलता है और आपके टूल्स को फ़ंक्शंस की तरह कॉल करता है। कच्चे परिणाम सैंडबॉक्स में रहते हैं, और सिर्फ कोड का प्रिंटेड आउटपुट मॉडल तक पहुँचता है।
एजेंट छोटे स्क्रिप्ट लिखता है जो फेल होती ट्रेसेस खींचती हैं और केवल एंडपॉइंट के हिसाब से काउंट प्रिंट करती हैं। एक पूर्ण जाँच में, प्रोग्रामैटिक टूल कॉलिंग ने मॉडल को लौटाए गए सीरियलाइज़्ड साक्ष्य को 98.8% तक घटा दिया। टूल परिणाम 42.9 KB थे और सार-संक्षेप 0.5 KB, जो बाइट मेट्रिक है न कि बिल योग्य इनपुट-टोकन बचत।
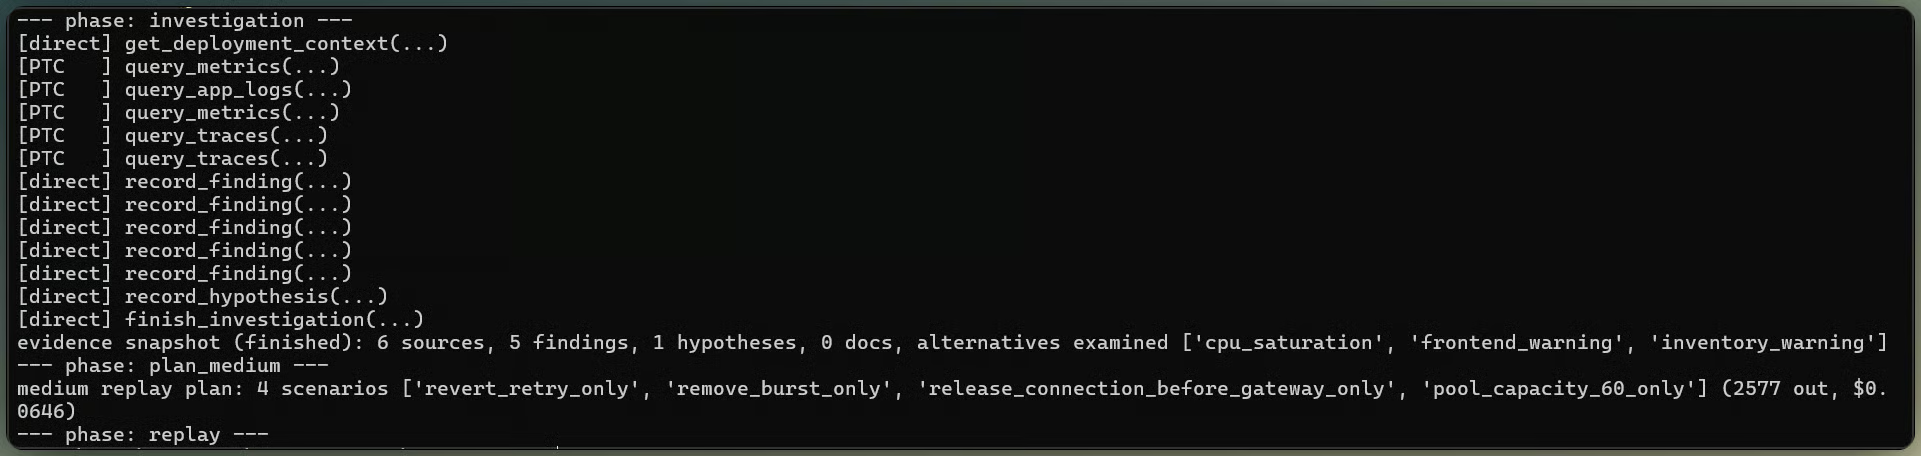
टूल कॉल्स घटना के साक्ष्य को संकुचित करती हैं। चित्र लेखक द्वारा।
एप्लिकेशन रिट्राई-लाइब्रेरी के सिमैंटिक्स के लिए प्रतिबंधित वेब सर्च उपलब्ध कराता है। Claude ने अंतिम मूल्यांकन के दौरान उसे कॉल नहीं किया, इसलिए मापा गया निदान डिफ्फ़, मैट्रिक्स, लॉग्स और ट्रेसेस पर टिकता है। urllib3 संदर्भ स्वतंत्र रूप से पुष्टि करता है कि allowed_methods=None किसी भी verb को रिट्राई करता है और backoff_factor=0 प्रतीक्षा हटाता है, पर वह पेज मापे गए साक्ष्य का हिस्सा नहीं है।
काउंटरफ़ैक्चुअल रीप्ले घटना के ट्रैफ़िक को एक संदिग्ध कारण हटाकर दोबारा चलाता है और जाँचता है कि फेल्योर गायब होता है या नहीं। यह "ये रेखाएँ साथ बढ़ती हैं" को एक परीक्षण में बदल देता है।
रीप्ले वही ट्रैफ़िक पैटर्न दोबारा उपयोग करता है। नीचे की तुलना के लिए, हर परिदृश्य एक शर्त बदलता है, और एप्लिकेशन नियंत्रित करता है कि कौन-सी बदलाएँ अनुमत हैं।
सारांश गेटवे 503s को पूल टाइमआउट्स से, और चेकआउट 503s को कार्ट और ऑर्डर रीड्स से अलग करता है। यही विभाजन मॉडल को ट्रिगर और एम्प्लीफायर में फर्क बताने देता है।
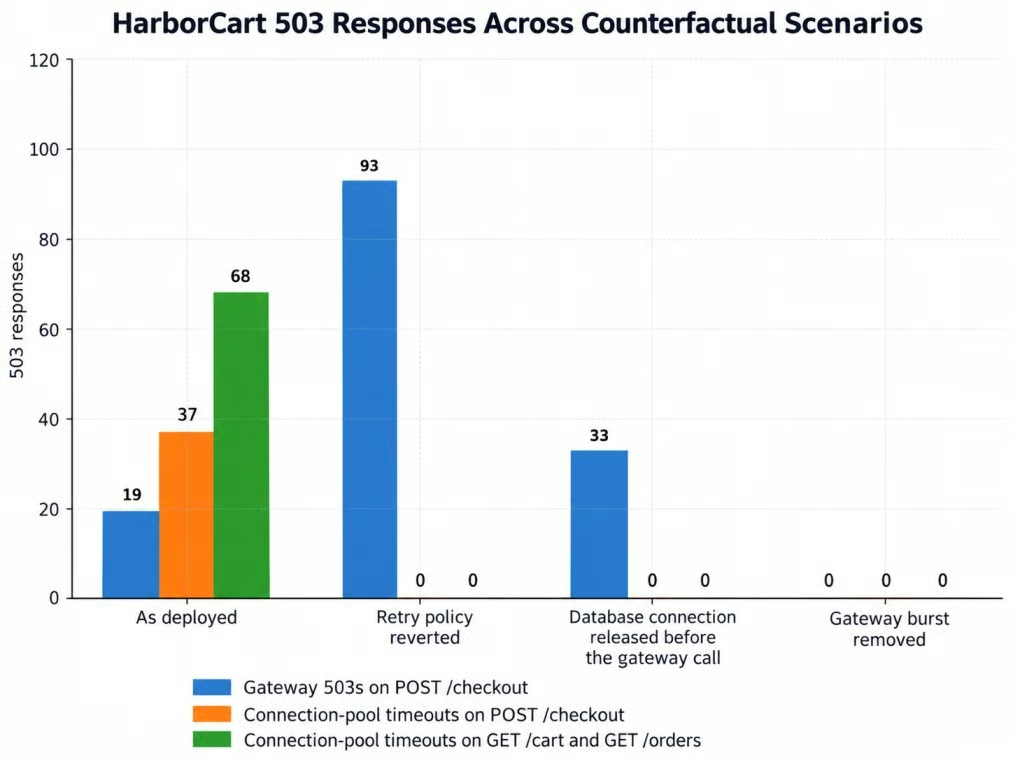
हर रीप्ले में ठीक एक चीज़ बदली जाती है। चित्र लेखक द्वारा।
बेसलाइन रीप्ले ने 124 503s पैदा किए: 105 पूल टाइमआउट्स, जिनमें 68 रीड एंडपॉइंट्स पर फेल्योर शामिल हैं, और 19 गेटवे त्रुटियाँ। रिट्राई पॉलिसी को रिवर्ट करने से हर पूल टाइमआउट और रीड फेल्योर हट गया पर चेकआउट पर 93 गेटवे 503s सामने आए। गेटवे कॉल से पहले कनेक्शन छोड़ना भी पूल फेल्योर हटाता है जबकि 33 गेटवे 503s रह जाते हैं, और गेटवे बर्स्ट हटाने पर कोई त्रुटि नहीं आई।
रीप्ले ट्रेड-ऑफ़ उजागर करता है: रोलबैक साझा पूल की रक्षा करता है पर अधिक चेकआउट फेल्योर गुजरने देता है। इसे एक स्टॉपगैप की तरह उपयोग करें। फिर एक idempotency key जोड़ें ताकि दोहराया गया चार्ज दो बार बिल न कर सके, और गेटवे कॉल के दौरान कनेक्शन पकड़े रहना बंद करें।
सिस्टम प्रॉम्प्ट रीप्ले का अनुरोध करता है, पर प्रॉम्प्ट प्रवर्तन तंत्र नहीं है। लूप जाँचता है कि रीप्ले साक्ष्य मौजूद है या नहीं और बिना जाँचे निदान को अस्वीकार करता है।
यह जाँच Python में रखें। तेज़तर प्रॉम्प्ट अनुपालन सुधार सकता है, पर इसकी गारंटी नहीं दे सकता।
Effort तय करता है कि Claude प्रति चरण कितना तर्क करेगा, और एक task budget तय करता है कि पूरा लूप कितना काम लेगा। हमारा Claude Opus 5 API ट्यूटोरियल सभी पाँच effort स्तरों की तुलना करता है; यहाँ, मीडियम और हाई को वही प्री-रीप्ले साक्ष्य मिलते हैं।
प्रोडक्शन medium पर रहता है। रीप्ले से पहले, एप्लिकेशन मीडियम और हाई effort से एक ही साक्ष्य से कारणात्मक परीक्षण डिज़ाइन करने के लिए कहता है। यह केवल मीडियम की सिफारिश निष्पादित करता है; हाई प्रतिक्रिया सिर्फ तुलना के लिए उपयोग होती है।
हाई रिक्वेस्ट एक per-message output_config.effort परिवर्तन का उपयोग करता है जो mid-conversation-output-config-2026-07-01 के पीछे है। यह मीडियम उत्तर नहीं देखता।
दोनों effort स्तरों ने वही परिकल्पना और वही तीन मूल रीप्ले परिदृश्य चुने। हाई ने औसतन 2,631 आउटपुट टोकन उपयोग किए जबकि मीडियम पर 2,307 थे, और कारणात्मक परीक्षण बदले बिना लगभग 11% अधिक लागत आई।
अनुमान लगाने की बजाय प्रेक्षित उपयोग से task budget चुनें। HarborCart की सबसे बड़ी अनबाउंडेड जाँच ने 13,322 गिने गए टोकन खपत किए, जिनमें मॉडल आउटपुट और वह टूल-रिज़ल्ट टेक्स्ट शामिल है जिसे Claude ने देखा। 25% मार्जिन जोड़ने से 16,653 होते हैं, जो Anthropic के 20,000-टोकन न्यूनतम से कम है, इसलिए कॉन्फ़िगर्ड बजट 20,000 है।
टर्न्स और बीता समय एप्लिकेशन सीमाओं के रूप में रखें। एक्सपेरिमेंट रनर ने रिकॉर्डेड खर्च $2.50 पहुँचने के बाद नया काम शुरू करना रोका। यह हार्ड कैप नहीं है क्योंकि प्रगति पर चल रही रिक्वेस्ट ऊपर खत्म हो सकती है।
अंतिम उत्तर structured outputs का उपयोग करता है। इसका फ्लैट स्कीमा verdict, cause, खारिज की गई परिकल्पनाएँ, साक्ष्य, और फ़िक्स को कवर करता है। लागत और लेटेंसी बाहर रहती हैं क्योंकि एप्लिकेशन उन्हें मापता है।
वेब सर्च उद्धरण और output_config.format एक रिक्वेस्ट साझा नहीं कर सकते: उद्धरणों को इंटरलीव्ड कंटेंट ब्लॉक्स चाहिएँ, जबकि स्कीमा को JSON चाहिए। इसलिए HarborCart बिना आउटपुट स्कीमा के जाँच करता है। यह फ़ाइंडिंग्स को उनके स्रोतों और रीप्ले परिणामों से जोड़कर संग्रहीत करता है, फिर सिर्फ वही सत्यापित साक्ष्य बिना टूल्स या वेब सर्च के दूसरी रिक्वेस्ट को भेजता है।
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
दूसरी रिक्वेस्ट को केवल सत्यापित साक्ष्य चाहिए, इसलिए पूरी इन्वेस्टिगेशन कैश को बनाए रखना आवश्यक नहीं है।
Allow "inconclusive" को verdict फ़ील्ड में अनुमति दें। जब रीप्ले उसकी व्याख्या से विरोधाभास रखता है, तो रिपोर्ट को सत्यापित निदान के लिए मजबूर नहीं किया जाना चाहिए।
स्कीमा रिपोर्ट के आकार को वैलिडेट करता है, जबकि रीप्ले निदान को वैलिडेट करता है। एक इंकार भी HTTP 200 के साथ stop_reason: "refusal" लौटाता है और हो सकता है आपके स्कीमा से मेल न खाए, इसलिए पार्स करने से पहले stop reason जाँचें।
तीनों अंतिम रिपोर्टों ने मूल कारणात्मक मैकेनिज़्म पाया और तीन वैकल्पिक व्याख्याओं को खारिज किया। दो ने सभी आठ जाँचें पूरी कीं; तीसरे ने 6/8 स्कोर किया क्योंकि उसने स्पष्ट POST-रिट्राई कॉन्फ़िगरेशन परिवर्तन छोड़ दिया और डिप्लॉयमेंट डिफ्फ़ का हवाला नहीं दिया। यही वजह है कि ऑफ़लाइन स्कोरिंग स्कीमा वैलिडेशन से अलग रहती है: वैध JSON और सही निदान के बावजूद रिपोर्ट अधूरी हो सकती है।
रिपोर्टें एक दूसरे जोखिम की भी पहचान करती हैं: किसी चार्ज को रिट्राई करना ग्राहक से दो बार बिल कर सकता है। RFC 9110 POST को स्वभावतः idempotent परिभाषित नहीं करता और स्वत: रिट्राई के विरुद्ध सलाह देता है जब तक क्लाइंट न जाने कि ऑपरेशन दोहराना सुरक्षित है। भुगतान प्रदाता द्वारा समर्थित एक idempotency key उन रिट्राई को सुरक्षित बनाने का एक आम तरीका है।
हमारा Streamlit ट्यूटोरियल इंटरफ़ेस सेटअप कवर करता है। HarborCart का इंटरफ़ेस इन्वेस्टिगेशन ईवेंट्स, मीडियम और हाई रीप्ले प्लान, रीप्ले परिणाम, अंतिम रिपोर्ट और लागत दिखाता है। टूल कॉल्स के बीच स्थिति के लिए, Claude Opus 5.5 प्रॉम्प्टिंग गाइड display: "updates" का वर्णन करता है; ऐप तब भी टूल ईवेंट्स रेंडर करता है जब अपडेट ब्लॉक खाली हो।
DataCamp के साथ सीखें
course
course
course