course
Claude 101
2 oră
21.4K
În acest tutorial, voi testa un scenariu: La câteva minute după un update software, HarborCart — un magazin pe care îl voi folosi pentru acest scenariu — începe să înregistreze erori la checkout. Unii clienți așteaptă mai mult de 30 de secunde; alții văd o eroare de server și nu pot plăti. Furnizorul de plăți are și el o întrerupere scurtă, deci pare cauza evidentă.
Dar întreruperea furnizorului nu explică de ce cedează și paginile de coș și comandă. Găsirea verigii lipsă necesită jurnale de aplicație, grafice, înregistrări ale cererilor și modificarea de cod recentă. Acest tutorial testează dacă Claude Opus 5.5 poate urmări aceste dovezi, își poate testa explicația în condiții controlate și poate raporta doar ceea ce susțin dovezile.
Un pic de context: Claude Opus 5.5 a apărut la începutul acelei săptămâni, chiar înainte să încep acest proiect. Prezentarea Claude Opus 5.5 acoperă lansarea și benchmark-urile, așa că acest tutorial rămâne pe API și construiește un singur agent de investigație, de la prima cerere până la un raport verificat.
Vom aborda cum să:
Investigatorul HarborCart a separat vârful de erori al gateway-ului de politica de retry care l-a amplificat, apoi a testat acea explicație înainte de a returna un raport.
Accesezi Claude Opus 5.5 prin Messages API de la Anthropic cu ID-ul modelului claude-opus-5-5. Conform prezentării modelului, primește text și imagini, cu o fereastră de context de 1M tokeni și maxim 128K output. Gândirea adaptivă este mereu activă, iar efortul implicit este medium.
Prețurile standard sunt 4 $ per milion de tokeni de input și 20 $ per milion de tokeni de output. Scrierile în cache pe cinci minute costă 5 $ per milion și citirile din cache 0,20 $. Odată ce prompt caching este activ, prefixele care se potrivesc sunt taxate la acel tarif mai mic de citire din cache.
Patru puncte din ghidul de migrare apar direct în acest proiect.
Forțarea tool_choice cu any sau un tool numit returnează o eroare 400.
Efortul implicit a scăzut de la high pe Claude Opus 5 la medium.
Gândirea nu poate fi dezactivată, iar blocurile thinking trebuie să se întoarcă neschimbate în interiorul unui loop de unelte.
Notițele pe care modelul le scrie între apelurile de unelte sosesc în blocuri thinking, care sunt goale în mod implicit.
Agentul doar investighează. Primește unelte cu acces doar în citire și fără credențiale de producție. După colectarea dovezilor, cereri de planificare separate propun teste contrafactuale, iar Python validează și rulează planul cu efort mediu.
Codul complet, generatorul de dovezi și aplicația web sunt în acest repository GitHub.
HarborCart este un magazin fictiv. checkout-api deservește paginile de coș, statusul comenzii și POST /checkout, care taxează un gateway de plăți terț. Toate aceste endpointuri împart același pool PostgreSQL de 15 conexiuni per instanță.
Are loc un deploy, iar cinci minute mai târziu gateway-ul returnează 503 timp de aproximativ 90 de secunde. Latența checkout-ului urcă peste 30 de secunde în timp ce pool-ul stă la 15 din 15. Să dai vina pe furnizorul de plăți e varianta simplă, iar gateway-ul chiar a eșuat.
Cauza ascunsă e cu un pas mai înăuntru. Deploy-ul a permis POST-urilor eșuate să încerce din nou de până la trei ori, pentru un total de patru încercări de taxare, fără pauză, cât timp handlerul ține încă conexiunea la bază. Debitarile care eșuează lent țin acum conexiunile peste 30 de secunde, până când pool-ul se epuizează și cedează și paginile de coș care nu apelează niciodată gateway-ul.
Folosesc trei termeni consecvent de aici. Aici, declanșatorul este eșecul temporar al gateway-ului. Reîncercarea POST-urilor de checkout în timp ce ții conexiuni de bază rare este mecanismul de amplificare; epuizarea pool-ului de conexiuni partajat este defecțiunea sistemului.
Agentul pornește cu alerta, o captură de monitorizare și o diagramă de arhitectură. Restul vine prin unelte: loguri, trasări, cinci metrici, metadata de deploy, diff-ul Git și un runbook. Trei explicații concurente sunt introduse în dovezi: un avertisment de inventar, un avertisment de frontend și posibila saturație a CPU.
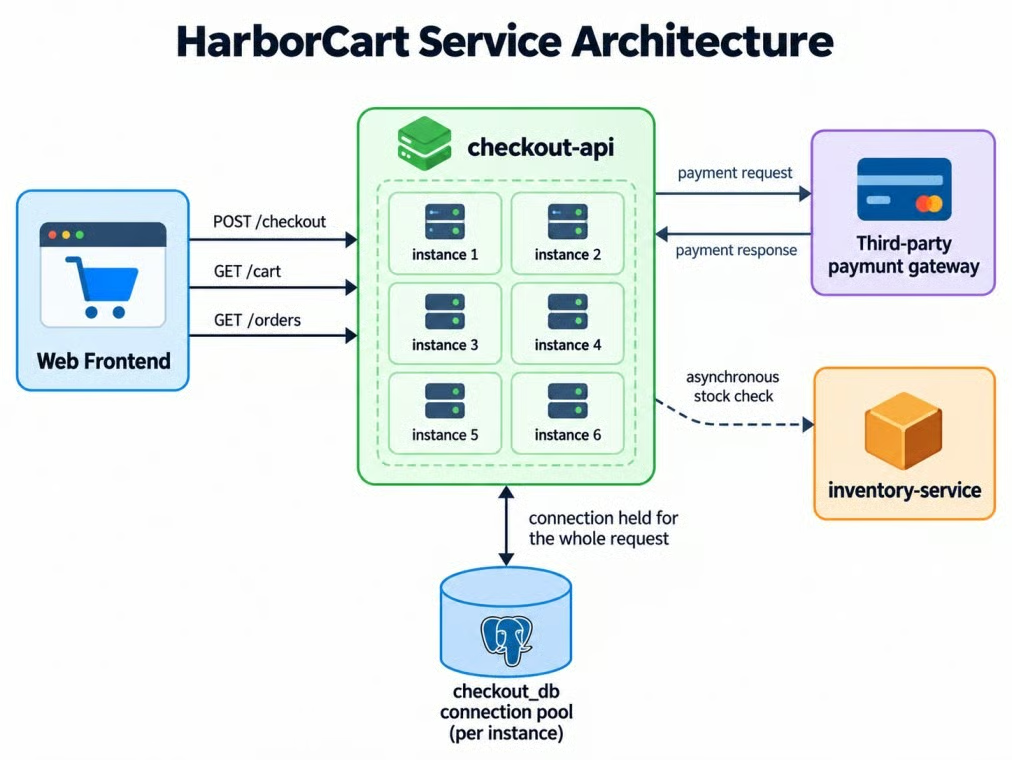
Traseul de checkout HarborCart și pool-ul partajat. Imagine de autor.
Diagrama spune că conexiunea este ținută pe tot parcursul cererii. Nu spune că asta e o problemă; investigația trebuie să deducă asta.
Definește succesul înainte să construiești agentul. Un raport corect trebuie să:
POST Ai nevoie de Python 3.10 sau mai nou și o cheie API Anthropic cu acces la claude-opus-5-5. Aceste comenzi PowerShell clonează proiectul și instalează dependențele blocate, inclusiv anthropic 1.8.0. Dacă folosești Amazon Bedrock, citește mai întâi FAQ-urile, pentru că mai multe funcții nu se pot porta.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Pe macOS sau Linux, activează cu source .venv/bin/activate și copiază cu cp .env.example .env. Adaugă cheia ta în .env, iar python-dotenv o încarcă pentru SDK; ghidul nostru despre variabile de mediu explică modelul. Dacă ai apelat Claude din Python înainte, sari peste următoarea subsecțiune, pentru că doar confirmă setup-ul.
Cea mai mică cerere utilă confirmă cheia și arată ce se întoarce.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
În această cerere, răspunsul conține blocuri thinking și text. Selectează blocurile după tip în loc să citești response.content[0].
Agenții cu tool calling îmbină Messages API al lui Claude cu funcții Python care controlează accesul la date. Aplicația urmează o singură regulă: Claude decide ce dovezi îi trebuie, iar Python decide la ce poate avea acces.
Ghidul nostru despre ingineria harness-ului pentru agenți acoperă limite mai largi ale uneltelor și loop-urilor; HarborCart își păstrează uneltele doar în citire și limitate la acest incident.
Fiecare unealtă citește un set fix de dovezi și returnează un rezultat JSON limitat. Interogările de log și trasări returnează cel mult 200 de rânduri plus un count, iar interogările de metrici returnează cel mult 60 de puncte.
Apelarea programatică a uneltelor nu suportă strict: true, așa că separă uneltele în două. Păstrează controalele dovezilor și unealta de oprire a investigației stricte și doar directe. Logurile, trasările și metricile folosesc doar execuție de cod, ceea ce îi dă lui Claude o singură cale clară pentru interogări de dovezi mari.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers ghidează modelul, dar nu este o limită de securitate. Python verifică apelantul înainte de a executa fiecare unealtă și respinge un apel direct de interogare. Apelurile programatice sar și peste validarea strictă, deci funcțiile de interogare tot își validează propriile argumente.
Aplicația etichetează fiecare rezultat de unealtă acceptat, respinge constatările care citează dovezi lipsă și acceptă URL-uri de documentație doar când căutarea web le-a returnat. Python, nu modelul, înregistrează rezultatele replay-ului.
După cum s-a menționat în secțiunea de migrare, păstrează tool_choice la auto. Spune în prompt când se aplică o unealtă și folosește scheme stricte acolo unde argumentele trebuie să fie exacte.
Loop-ul trimite conversația, rulează orice blocuri tool_use, anexează rezultatele și repetă. Anexează blocurile asistentului neschimbate, inclusiv thinking, iar cât timp codul programatic este în pauză, pasează înapoi ID-ul container doar cu blocuri tool_result.
Cererea de investigație include viziune, unelte, căutare web, efort și bugetul sarcinii, dar fără schemă de output. Asta ține rezultatele cu citări ale căutării departe de output-ul JSON structurat, în timp ce prefixul stabil al cererii păstrează activ caching-ul de prompt:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Atașează dashboard-ul și diagrama de arhitectură la primul mesaj al utilizatorului ca PNG-uri base64. Spune-i lui Claude să trateze orice citește dintr-o imagine ca ipoteză și să o confirme cu query_metrics.
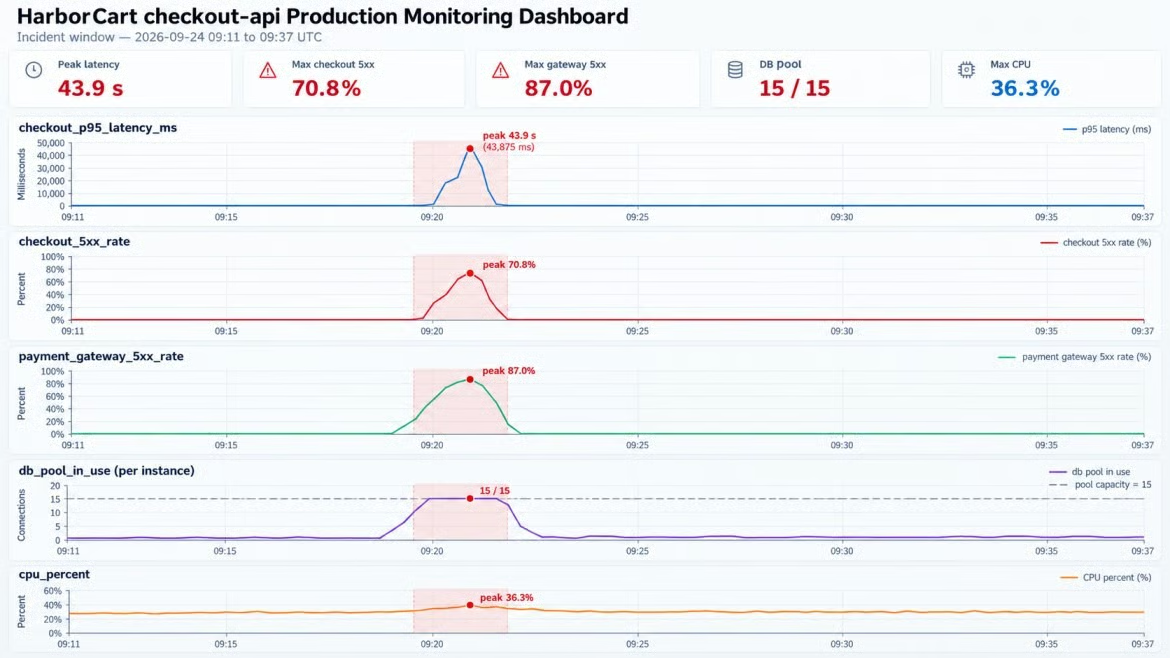
Dashboard-ul arată saturația pool-ului, CPU plat. Imagine de autor.
Atât dashboard-ul, cât și interogările de metrici folosesc aceleași date sursă. CPU rămâne aproape de 30% în timp ce pool-ul e plin, ceea ce argumentează împotriva ideii „gazda este supraîncărcată” înainte să ruleze vreo interogare.
Captura sugerează unde să te uiți, dar seriile numerice decid dacă observația se susține. Viziunea generează o ipoteză; metricile o testează.
Pentru fluxuri de lucru axate pe imagine, vezi tutorialul nostru despre viziune agentică. HarborCart folosește viziunea doar ca să aleagă următoarea metrică.
Apelarea programatică a uneltelor îi permite lui Claude să scrie Python care rulează într-un container de execuție a codului și apelează uneltele tale ca funcții. Rezultatele brute rămân în sandbox, iar doar output-ul printat al codului ajunge la model.
Agentul scrie scripturi scurte care extrag trasările eșuate și printează doar numărătorile pe endpoint. Într-o investigație completă, apelarea programatică a uneltelor a redus dovezile serializate returnate modelului cu 98,8%. Rezultatele uneltelor au fost 42,9 KB, iar rezumatele 0,5 KB, o măsură în octeți, nu economii de tokeni de input facturați.
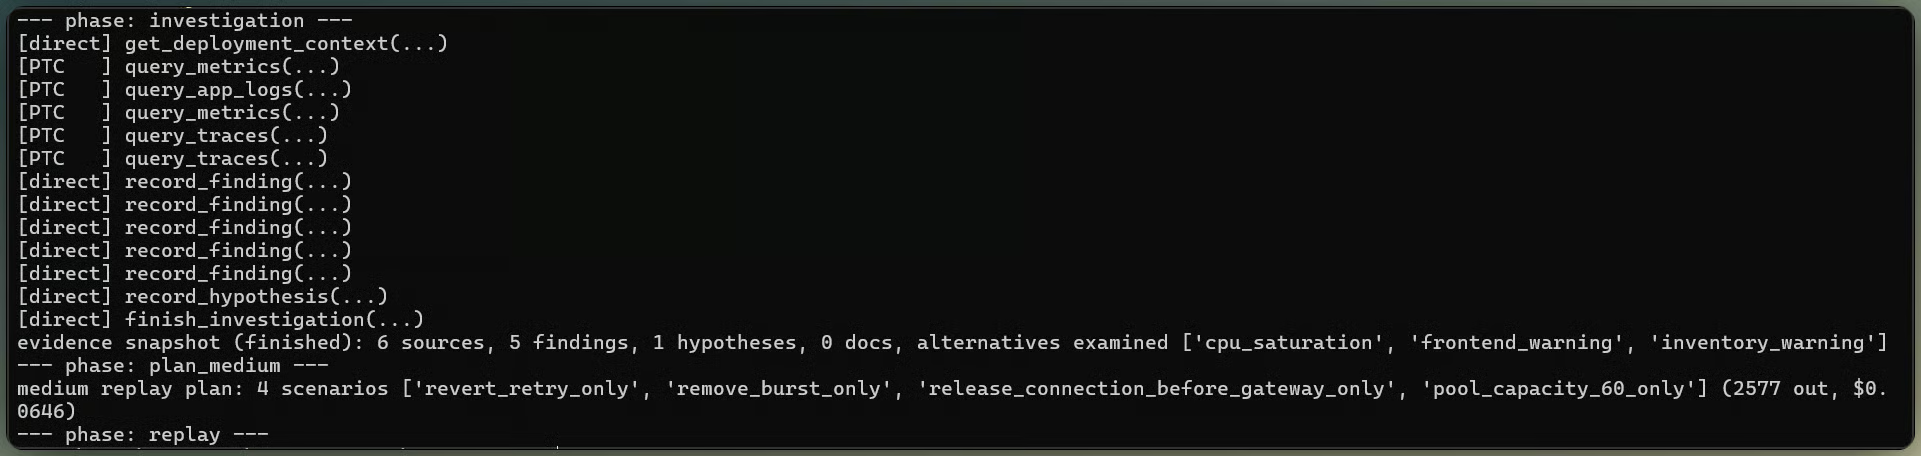
Apelurile uneltelor îngustează dovezile incidentului. Imagine de autor.
Aplicația expune o căutare web restricționată pentru semantica bibliotecii de retry. Claude nu a apelat-o în timpul evaluării finale, deci diagnosticul măsurat se bazează pe diff, metrici, loguri și trasări. Referința urllib3 confirmă independent că allowed_methods=None reîncearcă orice verb, iar backoff_factor=0 elimină așteptarea, dar acea pagină nu face parte din dovezile măsurate.
Un replay contrafactual rulează din nou traficul incidentului cu o cauză suspectată eliminată și verifică dacă defecțiunea dispare. Transformă „aceste linii cresc împreună” într-un test.
Replay-ul reutilizează același tipar de trafic. Pentru comparația de mai jos, fiecare scenariu schimbă o condiție, iar aplicația controlează ce schimbări sunt permise.
Rezumatul separă 503-urile gateway-ului de timeout-urile pool-ului, și 503-urile de la checkout de citirile de coș și comandă. Acea separare e ceea ce îi permite modelului să distingă declanșatorul de amplificator.
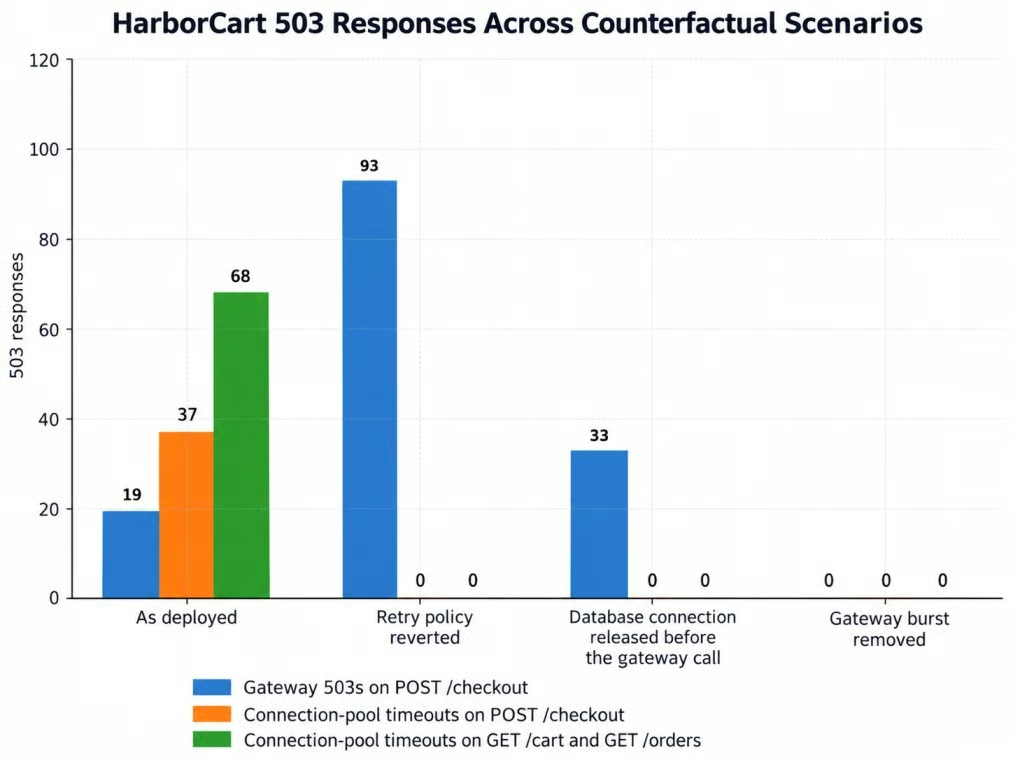
Fiecare replay schimbă exact un lucru. Imagine de autor.
Replay-ul de bază a produs 124 de 503: 105 timeout-uri ale pool-ului, inclusiv 68 de eșecuri pe endpointuri de citire, și 19 erori ale gateway-ului. Revenirea la politica de retry a eliminat toate timeout-urile pool-ului și eșecurile de citire, dar a scos la suprafață 93 de 503 de la gateway pe checkout. Eliberarea conexiunii înainte de apelul către gateway a eliminat și ea eșecurile pool-ului, lăsând 33 de 503 de la gateway, iar eliminarea vârfului de la gateway nu a produs erori.
Replay-ul expune compromis-ul: un rollback protejează pool-ul partajat, dar permite să treacă mai multe eșecuri de checkout. Folosește-l ca măsură temporară. Apoi adaugă o cheie de idempotentă pentru ca o taxare repetată să nu factureze de două ori și nu mai ține conexiunea în timpul apelului către gateway.
Promptul de sistem cere un replay, dar un prompt nu este un mecanism de aplicare. Loop-ul verifică dacă există dovezi de replay și respinge un diagnostic netestat.
Păstrează această verificare în Python. Un prompt mai ascuțit poate îmbunătăți conformitatea, dar nu o poate garanta.
Efortul stabilește cât de mult raționează Claude per pas, iar un buget de sarcină stabilește câtă muncă ar trebui să ia întregul loop. Tutorialul nostru pentru API-ul Claude Opus 5 compară toate cele cinci niveluri de efort; aici, medium și high primesc aceleași dovezi pre-replay.
Producția rămâne la medium. Înainte de replay, aplicația cere nivelurilor medium și high să proiecteze un test cauzal din aceleași dovezi. Execută doar recomandarea medium; răspunsul high este folosit doar pentru comparație.
Cererea high folosește o schimbare per-mesaj a output_config.effort în spatele mid-conversation-output-config-2026-07-01. Nu vede răspunsul medium.
Ambele niveluri de efort au selectat aceeași ipoteză și aceleași trei scenarii de replay de bază. High a folosit în medie 2.631 tokeni de output față de 2.307 la medium și a costat cu aproximativ 11% mai mult fără să schimbe testul cauzal.
Alege un buget de sarcină pe baza utilizării observate, nu ghicind. Cea mai mare investigație nelimitată a HarborCart a consumat 13.322 tokeni numărați, incluzând output-ul modelului și textul rezultatelor uneltelor văzute de Claude. Adăugând o marjă de 25% dă 16.653, sub minimul de 20.000 de la Anthropic, deci bugetul configurat este 20.000.
Păstrează turele și timpul scurs ca limite ale aplicației. Runner-ul de experimente a oprit pornirea de muncă nouă după ce cheltuiala înregistrată a ajuns la 2,50 $. Aceasta nu este o limită dură, pentru că o cerere deja în curs poate termina peste ea.
Răspunsul final folosește output-uri structurate. Schema sa plată acoperă verdictul, cauza, ipotezele respinse, dovezile și remedierea. Costul și latența rămân pe dinafară pentru că aplicația le măsoară.
Citările căutării web și output_config.format nu pot împărți aceeași cerere: citările au nevoie de blocuri de conținut intercalate, în timp ce schema cere JSON. De aceea HarborCart investighează fără o schemă de output. Stochează constatările legate de sursele lor și de rezultatele replay-ului, apoi trimite doar acele dovezi verificate către o a doua cerere fără unelte sau căutare web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
A doua cerere are nevoie doar de dovezile verificate, deci păstrarea completă a cache-ului investigației este inutilă.
Permite "inconclusive" în câmpul verdict. Un raport nu ar trebui forțat într-un diagnostic verificat când replay-ul îi contrazice explicația.
Schema validează forma raportului, în timp ce replay-ul validează diagnosticul. Un refuz întoarce și el HTTP 200 cu stop_reason: "refusal" și s-ar putea să nu se potrivească cu schema ta, așa că verifică motivul opririi înainte de parsare.
Toate cele trei rapoarte finale au găsit mecanismul cauzal de bază și au exclus cele trei explicații alternative. Două au îndeplinit toate cele opt verificări; al treilea a punctat 6/8 pentru că a omis schimbarea explicită de configurare a retry-ului pentru POST și nu a citat diff-ul de deploy. De aceea scorarea offline rămâne separată de validarea schemei: JSON valid și diagnosticul corect pot produce totuși un raport incomplet.
Rapoartele identifică și un al doilea risc: reîncercarea unei debitări poate factura un client de două ori. RFC 9110 nu definește POST ca fiind inerent idempotent și descurajează reîncercările automate decât dacă clientul știe că operația e sigură de repetat. O cheie de idempotentă suportată de furnizorul de plăți este o modalitate comună de a face acele reîncercări mai sigure.
Tutorialul nostru Streamlit acoperă configurarea interfeței. Interfața HarborCart arată evenimentele investigației, planurile de replay medium și high, rezultatele replay-ului, raportul final și costul. Pentru status între apelurile uneltelor, ghidul de prompting pentru Claude Opus 5.5 descrie display: "updates"; aplicația redă și evenimentele uneltelor când un bloc de update este gol.
Învață cu DataCamp
course
course
course