
Cursus
Claude 101
2 Hr
21.4K
In deze tutorial test ik een scenario: Enkele minuten na een software-update ziet HarborCart — een winkel die ik voor dit scenario gebruik — storingen bij het afrekenen. Sommige klanten wachten meer dan 30 seconden; anderen zien een serverfout en kunnen niet betalen. De betalingsprovider heeft ook een korte storing, dus dat lijkt de voor de hand liggende oorzaak.
Maar de providerstoring verklaart niet waarom ook de winkelwagen- en bestelpagina's falen. De ontbrekende schakel vinden vereist applicatielogs, grafieken, requestrecords en de recente codewijziging. Deze tutorial test of Claude Opus 5.5 die aanwijzingen kan volgen, de verklaring onder gecontroleerde omstandigheden kan testen en alleen rapporteert wat het bewijs ondersteunt.
Wat achtergrond: Claude Opus 5.5 verscheen eerder die week, net voordat ik met dit project begon. Onze Claude Opus 5.5-overzicht behandelt de lancering en benchmarks, dus deze tutorial focust op de API en bouwt één onderzoeksagent van de eerste aanvraag tot een geverifieerd rapport.
We behandelen hoe je:
HarborCarts onderzoeker scheidde de piek bij de betaalgateway van het retry-beleid dat die piek versterkte, en testte die uitleg vervolgens voordat hij een rapport teruggaf.
Je gebruikt Claude Opus 5.5 via de Messages API van Anthropic met het model-ID claude-opus-5-5. Volgens het modeloverzicht accepteert het tekst en afbeeldingen, met een contextvenster van 1M tokens en 128K maximale output. Adaptive thinking staat altijd aan, en de standaard effort is medium.
Standaard prijzen zijn $4 per miljoen inputtokens en $20 per miljoen outputtokens. Cache-writes van vijf minuten kosten $5 per miljoen en cache-reads $0,20. Zodra prompt caching actief is, worden overeenkomende prefixes afgerekend tegen dat lagere cache-read-tarief.
Vier punten uit de migratiegids komen direct in dit project terug.
Geforceerde tool_choice met any of een benoemde tool geeft een 400-fout.
De standaard effort daalde van high op Claude Opus 5 naar medium.
Thinking kan niet worden uitgezet, en thinking-blokken moeten ongewijzigd terug binnen een toollus.
Notities die het model tussen toolcalls schrijft, komen binnen in thinking-blokken, die standaard leeg zijn.
De agent doet alleen onderzoek. Hij krijgt read-only bewijstools en geen productiecredentials. Na het verzamelen van bewijs stellen aparte planningsrequests counterfactual tests voor, en Python valideert en draait het plan met medium effort.
De volledige code, inclusief bewijsgenerator en webapp, staat in deze GitHub-repository.
HarborCart is een fictieve winkel. De checkout-api bedient de winkelwagenpagina's, bestelstatus en POST /checkout, die een derde-partij betaalgateway aanroept. Al die endpoints delen één PostgreSQL-pool van 15 connecties per instance.
Er wordt gedeployed, en vijf minuten later geeft de gateway 503's gedurende ongeveer 90 seconden. De checkout-latency stijgt boven 30 seconden terwijl de pool op 15 van 15 zit. De betalingsprovider de schuld geven is de makkelijke keuze, en de gateway is inderdaad uitgevallen.
De verborgen oorzaak ligt één stap verder. De deploy liet mislukte POST-betalingen tot drie keer opnieuw proberen, voor in totaal vier pogingen, zonder pauze terwijl de handler zijn databaseconnectie blijft vasthouden. Traag falende betalingen houden nu connecties 30 seconden of langer vast, totdat de pool opraakt en winkelwagenpagina's die de gateway nooit aanroepen ook falen.
Ik gebruik vanaf hier drie termen consequent. Hier is de trigger de tijdelijke gatewaystoring. Het opnieuw proberen van checkout-POSTs terwijl schaarse databaseconnecties worden vastgehouden is het versterkingsmechanisme; het leeglopen van de gedeelde connectiepool is de systeemfout.
De agent start met de alert, een monitoring-screenshot en een architectuurdiagram. Alles daarbuiten komt via tools: logs, traces, vijf metrics, deploymentmetadata, de Git-diff en een runbook. Drie concurrerende verklaringen worden in het bewijs gezaaid: een inventory-waarschuwing, een frontend-waarschuwing en mogelijke CPU-saturatie.
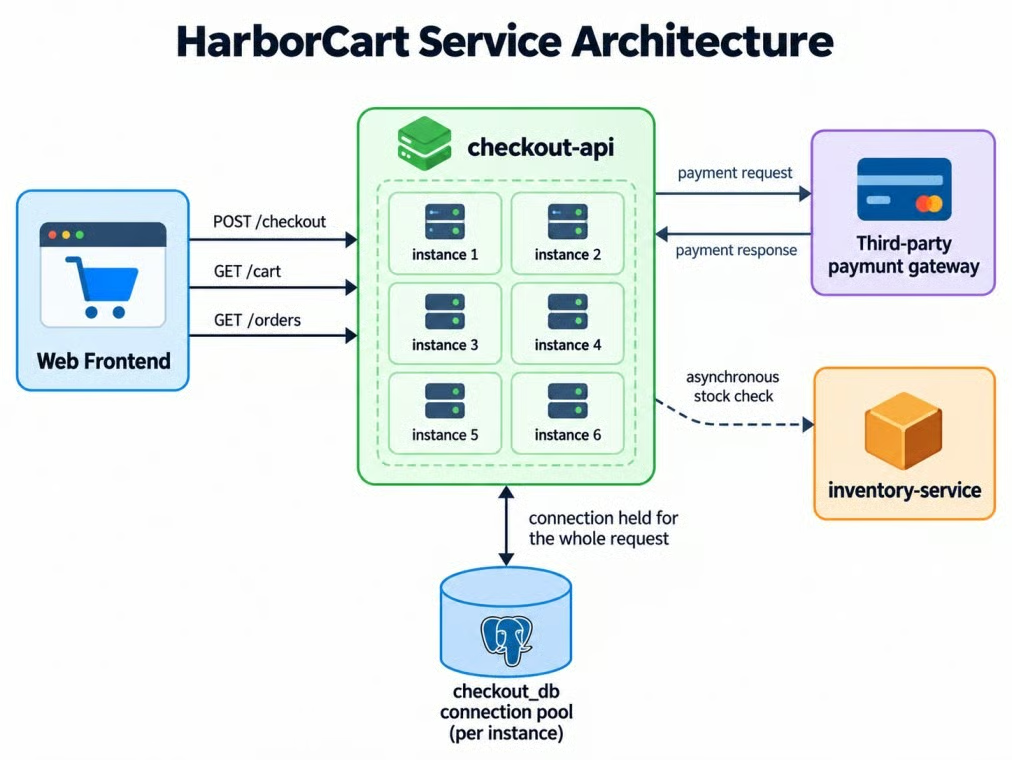
HarborCart-checkoutpad en gedeelde pool. Afbeelding door auteur.
Het diagram zegt dat de connectie de hele request wordt vastgehouden. Het zegt niet dat dat een probleem is; het onderzoek moet dat uitvinden.
Definieer succes vóórdat je de agent bouwt. Een correct rapport moet:
POST-retries toestondJe hebt Python 3.10 of nieuwer nodig en een Anthropic API-sleutel met toegang tot claude-opus-5-5. Deze PowerShell-commando's clonen het project en installeren de gepinde dependencies, inclusief anthropic 1.8.0. Als je op Amazon Bedrock zit, lees dan eerst de FAQ, want diverse features zijn niet te porten.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Op macOS of Linux activeer je met source .venv/bin/activate en kopieer je met cp .env.example .env. Voeg je sleutel toe aan .env, en python-dotenv laadt hem voor de SDK; onze gids voor omgevingsvariabelen legt het patroon uit. Als je Claude al eerder vanuit Python hebt aangeroepen, sla de volgende subsectie dan over, die bevestigt alleen de setup.
De kleinste nuttige request bevestigt de sleutel en laat zien wat er terugkomt.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
In deze request bevat de response thinking- en text-blokken. Selecteer blokken op type in plaats van response.content[0] te lezen.
Tool-calling agents combineren Claude's Messages API met Python-functies die de data-toegang sturen. De applicatie volgt één regel: Claude beslist welk bewijs hij nodig heeft, en Python beslist waartoe hij toegang mag hebben.
Onze gids voor agent-harness engineering behandelt bredere toolgrenzen en -lussen; HarborCart houdt zijn tools read-only en beperkt tot dit incident.
Elke tool leest een vaste set bewijs en geeft een beperkt JSON-resultaat terug. Log- en tracequeries geven maximaal 200 rijen plus een count, en metricqueries maximaal 60 punten.
Programmatische toolaanroepen ondersteunen geen strict: true, dus splits de tools in tweeën. Houd de bewijscontroles en de stoptool voor het onderzoek strikt en alleen direct aanroepbaar. Logs, traces en metrics gebruiken alleen code-executie, wat Claude één duidelijke weg geeft voor grote bewijsqueries.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers stuurt het model maar is geen beveiligingsgrens. Python controleert de aanroeper vóór het uitvoeren van elke tool en wijst een directe querycall af. Programmatische calls slaan strikte validatie ook over, dus queryfuncties valideren nog steeds hun eigen argumenten.
De applicatie tagt elk geaccepteerd toolresultaat, wijst bevindingen af die ontbreken op bewijs, en accepteert documentatie-URL's alleen wanneer webzoekopdrachten ze hebben opgeleverd. Python, niet het model, registreert replay-outputs.
Zoals in de migratiesectie vermeld, laat tool_choice op auto staan. Zeg in de prompt wanneer een tool van toepassing is en gebruik strikte schema's waar argumenten exact moeten zijn.
De lus stuurt het gesprek, draait eventuele tool_use-blokken, voegt de resultaten toe en herhaalt. Voeg de blokken van de assistant ongewijzigd toe, inclusief thinking, en terwijl programmatische code gepauzeerd is, geef je de container-ID alleen mee met tool_result-blokken.
De onderzoekrequest bevat vision, tools, webzoekopdrachten, effort en het taakbudget, maar geen outputschema. Dit houdt zoekresultaten met citaten weg van gestructureerde JSON-output terwijl het stabiele requestprefix de promptcache actief houdt:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Voeg het dashboard en het architectuurdiagram toe aan het eerste user-bericht als base64-PNG's. Zeg tegen Claude dat alles wat het uit een afbeelding leest als een hypothese moet worden behandeld en bevestigd met query_metrics.
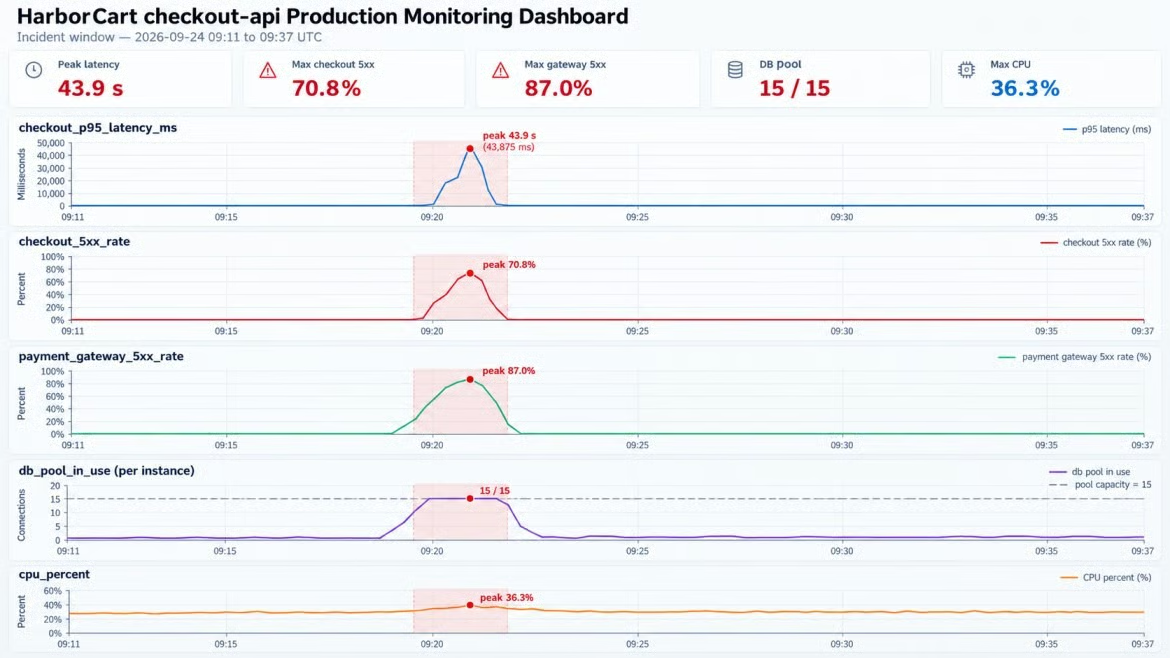
Dashboard toont poolsaturatie, vlakke CPU. Afbeelding door auteur.
Zowel het dashboard als de metricqueries gebruiken dezelfde brondata. CPU blijft rond 30% terwijl de pool vol is, wat al vóór enige query pleit tegen "de host is overbelast".
De screenshot suggereert waar je moet kijken, maar de numerieke reeks bepaalt of de observatie standhoudt. Vision genereert een hypothese; metrics testen die.
Voor image-first workflows, zie onze agentic vision-tutorial. HarborCart gebruikt vision alleen om de volgende metric te kiezen.
Programmatische toolaanroepen laten Claude Python schrijven dat draait in een code-executiecontainer en je tools als functies aanroept. Ruwe resultaten blijven in de sandbox, en alleen de geprinte output van de code bereikt het model.
De agent schrijft korte scripts die falende traces ophalen en alleen de aantallen per endpoint printen. In één volledig onderzoek verminderden programmatische toolaanroepen geserialiseerd bewijs dat naar het model terugging met 98,8%. De toolresultaten waren 42,9 KB en de samenvattingen 0,5 KB; een byte-meting i.p.v. gefactureerde inputtoken-besparing.
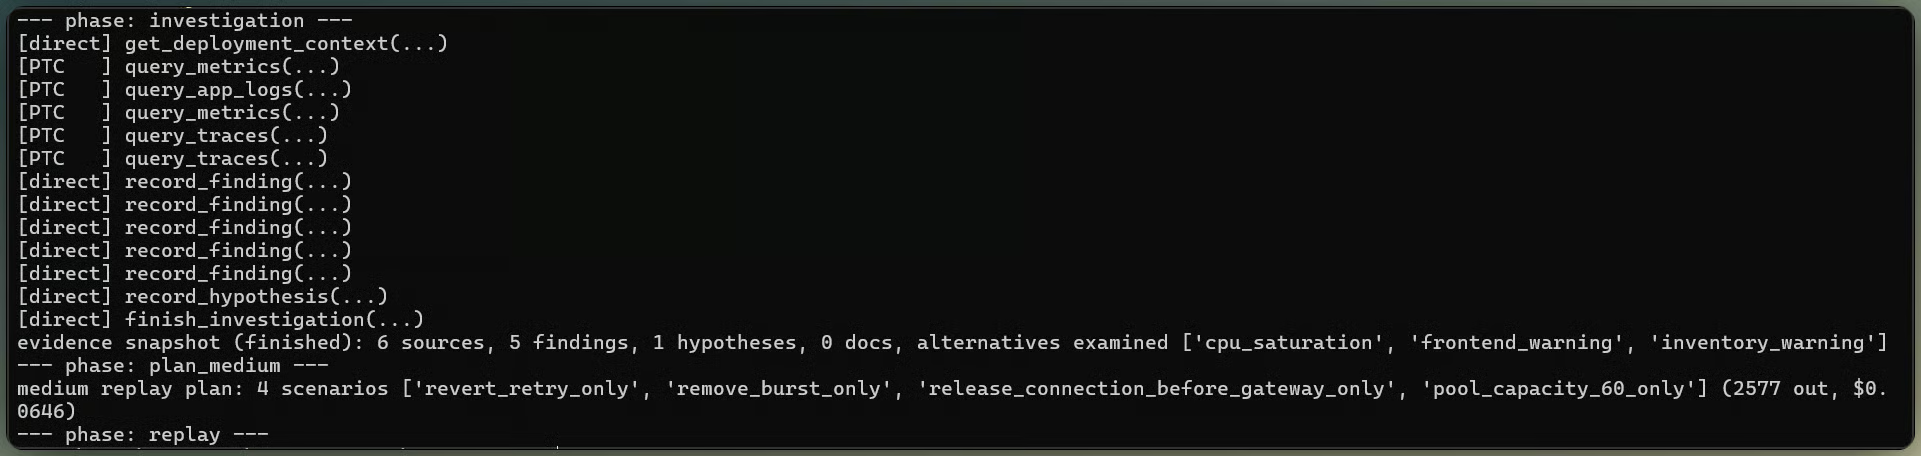
Toolcalls versmallen het incidentbewijs. Afbeelding door auteur.
De applicatie biedt beperkte webzoekopdrachten voor de semantiek van retry-libraries. Claude riep die niet aan tijdens de eindreview, dus de gemeten diagnose rust op de diff, metrics, logs en traces. De urllib3-referentie bevestigt onafhankelijk dat allowed_methods=None elke werkwoord herprobeert en backoff_factor=0 de wachttijd verwijdert, maar die pagina maakt geen deel uit van het gemeten bewijs.
Een counterfactual replay draait het verkeer van het incident opnieuw met één vermoedelijke oorzaak verwijderd en controleert of de fout verdwijnt. Het maakt van "deze lijnen stijgen samen" een test.
De replay hergebruikt hetzelfde verkeerspatroon. Voor de vergelijking hieronder verandert elk scenario één voorwaarde, en de applicatie bepaalt welke wijzigingen zijn toegestaan.
De samenvatting scheidt gateway-503's van pool-timeouts, en checkout-503's van leesacties op winkelwagen en bestelling. Die splitsing is wat het model helpt de trigger van de versterker te onderscheiden.
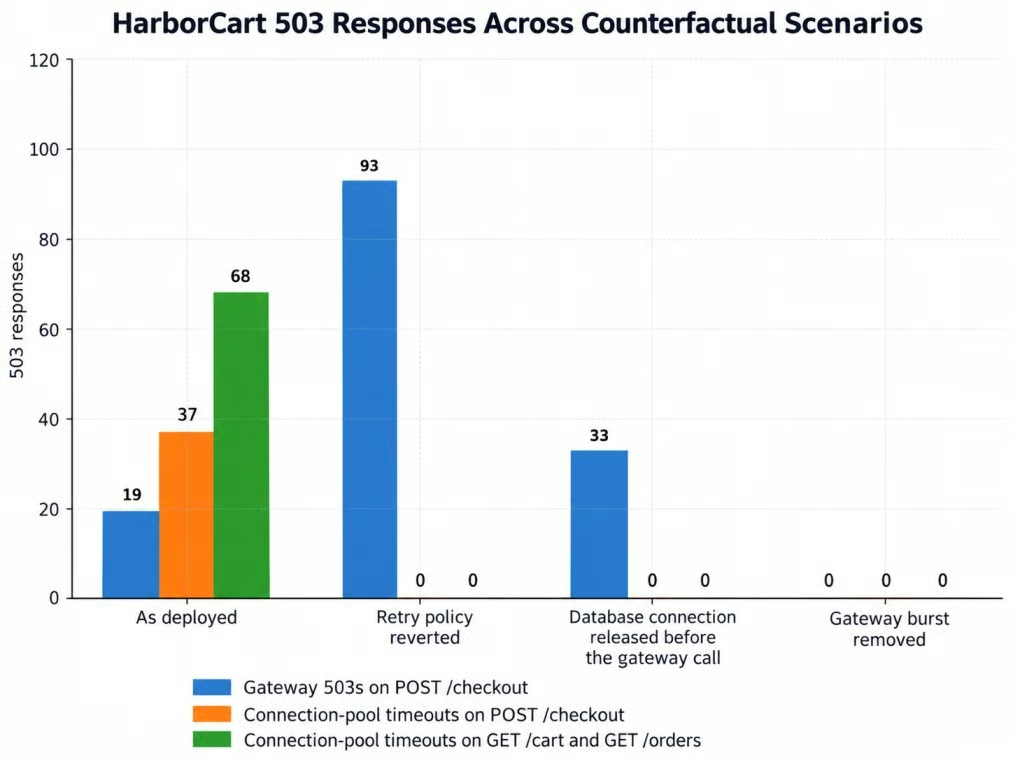
Elke replay verandert precies één ding. Afbeelding door auteur.
De baseline-replay gaf 124 keer 503: 105 pool-timeouts, inclusief 68 fouten op read-endpoints, en 19 gatewayfouten. Het terugdraaien van het retry-beleid verwijderde elke pool-timeout en read-fout maar bracht 93 gateway-503's bij checkout naar voren. De connectie vrijgeven vóór de gatewaycall verwijderde eveneens poolfouten maar liet 33 gateway-503's staan, en het verwijderen van de gatewaypiek leverde geen fouten op.
De replay laat de trade-off zien: een rollback beschermt de gedeelde pool maar laat meer checkout-fouten door. Gebruik het als tussenoplossing. Voeg daarna een idempotency key toe zodat een herhaalde betaling niet dubbel incasseert, en stop met het vasthouden van de connectie tijdens de gatewaycall.
De systemprompt vraagt om een replay, maar een prompt is geen handhavingsmechanisme. De lus controleert of replay-bewijs bestaat en wijst een ongeteste diagnose af.
Houd deze check in Python. Een scherpere prompt kan de naleving verbeteren, maar kan die niet garanderen.
Effort bepaalt hoeveel Claude per stap redeneert, en een taakbudget bepaalt hoeveel werk de hele lus mag kosten. Onze Claude Opus 5 API-tutorial vergelijkt alle vijf effortniveaus; hier ontvangen medium en high hetzelfde bewijs vóór de replay.
Productie blijft op medium. Voor de replay vraagt de applicatie medium en high effort om een causale test te ontwerpen op basis van hetzelfde bewijs. Alleen de medium-aanbeveling wordt uitgevoerd; het high-antwoord dient alleen voor vergelijking.
De high-request gebruikt een per-bericht output_config.effort-wijziging achter mid-conversation-output-config-2026-07-01. Het ziet het medium-antwoord niet.
Beide effortniveaus kozen dezelfde hypothese en dezelfde drie kern-replayscenario's. High gebruikte gemiddeld 2.631 outputtokens tegenover 2.307 bij medium, en kostte circa 11% meer zonder de causale test te veranderen.
Kies een taakbudget op basis van geobserveerd gebruik in plaats van te gokken. HarborCarts grootste onbegrensde onderzoek verbruikte 13.322 getelde tokens, inclusief modeloutput en toolresult-tekst die Claude zag. Een marge van 25% toevoegen geeft 16.653, onder Anthropic's minimum van 20.000 tokens, dus het geconfigureerde budget is 20.000.
Houd beurten en verstreken tijd aan als applicatielimieten. De experimenteer-runner stopte met nieuw werk starten nadat de geregistreerde uitgaven $2,50 bereikten. Dit is geen harde limiet omdat een al lopende request daarboven kan eindigen.
Het eindantwoord gebruikt gestructureerde outputs. Het platte schema dekt het oordeel, de oorzaak, verworpen hypothesen, bewijs en oplossing. Kosten en latency blijven erbuiten omdat de applicatie die meet.
Webzoekcitaten en output_config.format kunnen geen request delen: citaten hebben afgewisselde contentblokken nodig, terwijl het schema JSON vereist. HarborCart onderzoekt daarom zonder outputschema. Het slaat bevindingen op gekoppeld aan hun bronnen en de replayresultaten, en stuurt vervolgens alleen dat geverifieerde bewijs naar een tweede request zonder tools of webzoekopdrachten.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
De tweede request heeft alleen het geverifieerde bewijs nodig, dus het behouden van de volledige onderzoekscache is niet nodig.
Sta "inconclusive" toe in het veld verdict. Een rapport moet niet gedwongen worden tot een geverifieerde diagnose wanneer de replay de verklaring tegenspreekt.
Het schema valideert de vorm van het rapport, terwijl de replay de diagnose valideert. Een weigering geeft ook HTTP 200 terug met stop_reason: "refusal" en komt mogelijk niet overeen met je schema, dus check de stop reason vóór het parsen.
Alle drie de eindrapporten vonden het kern-causale mechanisme en sloten de drie alternatieve verklaringen uit. Twee voldeden aan alle acht checks; de derde scoorde 6/8 omdat hij de expliciete POST-retryconfiguratiewijziging wegliet en de deploymentdiff niet citeerde. Daarom blijft offline scoring gescheiden van schemavalidatie: geldige JSON en de juiste diagnose kunnen nog steeds een onvolledig rapport opleveren.
De rapporten signaleren ook een tweede risico: een betaling opnieuw proberen kan een klant twee keer laten betalen. RFC 9110 definieert POST niet als inherent idempotent en raadt automatische retries af tenzij de client weet dat de operatie veilig te herhalen is. Een idempotency key die door de betalingsprovider wordt ondersteund, is een gangbare manier om die retries veiliger te maken.
Onze Streamlit-tutorial behandelt de interface-setup. HarborCarts interface toont onderzoeksevenementen, de medium- en high-replayplannen, replayresultaten, het eindrapport en kosten. Voor status tussen toolcalls door beschrijft de Claude Opus 5.5 prompting-gids display: "updates"; de app rendert ook toolevents wanneer een updateblok leeg is.
Leer met DataCamp
Cursus
Cursus
Cursus