
Cours
Claude 101
2 h
21.4K
Dans ce tutoriel, je vais tester un scénario : quelques minutes après une mise à jour logicielle, HarborCart — une boutique fictive utilisée pour l’exemple — commence à enregistrer des échecs au paiement. Certains clients attendent plus de 30 secondes ; d’autres voient une erreur serveur et ne peuvent pas payer. Le prestataire de paiement subit également une courte panne, ce qui semble être la cause évidente.
Mais cette panne n’explique pas pourquoi les pages du panier et de commande échouent aussi. Pour trouver le chaînon manquant, il faut consulter les journaux applicatifs, les graphiques, les traces de requêtes et la dernière modification de code. Ce tutoriel vérifie si Claude Opus 5.5 peut suivre ces indices, éprouver son explication dans des conditions contrôlées et ne rapporter que ce que les preuves étayent.
Contexte : Claude Opus 5.5 est sorti plus tôt cette semaine, juste avant le démarrage de ce projet. Notre aperçu de Claude Opus 5.5 couvre le lancement et les benchmarks ; ce tutoriel se concentre donc sur l’API et construit un agent d’investigation, de la première requête jusqu’au rapport vérifié.
Nous verrons comment :
L’enquêteur d’HarborCart a distingué l’explosion d’erreurs du prestataire de paiement de la politique de retry qui l’a amplifiée, puis a testé cette explication avant de rendre un rapport.
Vous accédez à Claude Opus 5.5 via l’API Messages d’Anthropic avec l’identifiant de modèle claude-opus-5-5. D’après la présentation du modèle, il accepte texte et images, avec une fenêtre de contexte d’1 million de tokens et une sortie maximale de 128K. Le raisonnement adaptatif est toujours activé, et l’effort par défaut est medium.
La tarification standard est de 4 $ par million de tokens en entrée et 20 $ par million de tokens en sortie. Les écritures dans le cache 5 minutes coûtent 5 $ par million et les lectures de cache 0,20 $. Une fois le cache de prompt actif, les préfixes correspondants sont facturés au tarif de lecture du cache.
Quatre points du guide de migration se manifestent directement dans ce projet.
L’usage forcé de tool_choice avec any ou un outil nommé renvoie une erreur 400.
L’effort par défaut est passé de high sur Claude Opus 5 à medium.
Le raisonnement ne peut pas être désactivé, et les blocs thinking doivent être renvoyés inchangés dans une boucle d’outils.
Les notes que le modèle écrit entre des appels d’outils arrivent dans des blocs thinking, vides par défaut.
L’agent ne fait qu’enquêter. Il dispose d’outils de collecte de preuves en lecture seule et d’aucun identifiant de production. Après la collecte, des requêtes de planification séparées proposent des tests contrefactuels, et Python valide puis exécute le plan à effort moyen.
Le code complet, générateur de preuves et application web inclus, se trouve dans ce dépôt GitHub.
HarborCart est une boutique fictive. Son checkout-api sert les pages de panier, le statut de commande et POST /checkout, qui déclenche un débit via une passerelle de paiement tierce. Tous ces endpoints partagent un pool PostgreSQL de 15 connexions par instance.
Un déploiement a lieu, et cinq minutes plus tard, la passerelle renvoie des 503 pendant environ 90 secondes. La latence de checkout dépasse 30 secondes tandis que le pool est saturé à 15/15. Accuser le prestataire de paiement est tentant, et la passerelle a bel et bien échoué.
La cause cachée se situe un cran plus loin. Le déploiement a permis de réessayer les débits POST jusqu’à trois fois (soit quatre tentatives au total), sans pause, tandis que le gestionnaire conserve la connexion à la base. Des échecs lents retiennent désormais des connexions pendant 30 secondes ou plus, jusqu’à épuiser le pool, et les pages de panier qui n’appellent jamais la passerelle échouent aussi.
J’emploie trois termes de façon cohérente. Ici, le déclencheur est la panne temporaire de la passerelle. Le réessai des POST de paiement tout en retenant des connexions rares constitue le mécanisme d’amplification ; l’épuisement du pool partagé est la défaillance du système.
L’agent démarre avec l’alerte, une capture de monitoring et un schéma d’architecture. Tout le reste passe par des outils : journaux, traces, cinq métriques, métadonnées de déploiement, diff Git et runbook. Trois explications concurrentes sont semées dans les preuves : un avertissement d’inventaire, un avertissement frontend et une possible saturation CPU.
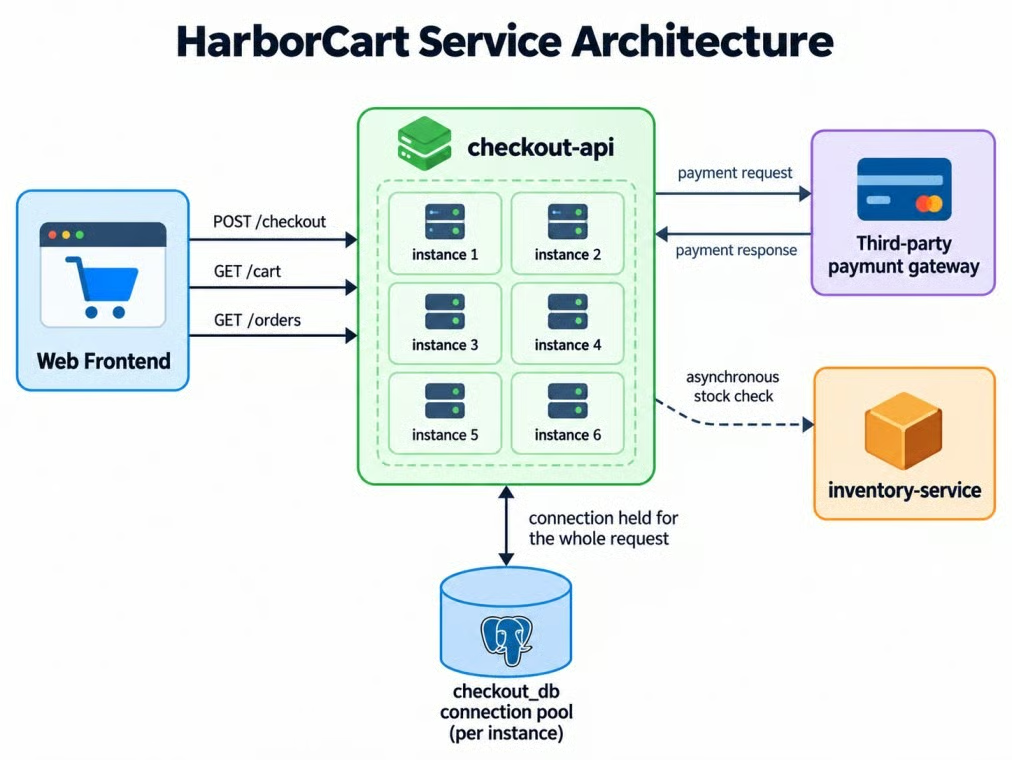
Chemin de checkout HarborCart et pool partagé. Image de l’auteur.
Le schéma indique que la connexion est conservée pendant toute la requête. Il ne dit pas que c’est un problème ; l’enquête doit l’établir.
Définissez le succès avant de construire l’agent. Un rapport correct doit :
POST réessayésVous avez besoin de Python 3.10 ou plus et d’une clé API Anthropic avec accès à claude-opus-5-5. Ces commandes PowerShell clonent le projet et installent ses dépendances épinglées, dont anthropic 1.8.0. Si vous êtes sur Amazon Bedrock, lisez d’abord la FAQ, car plusieurs fonctionnalités ne sont pas portables.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Sur macOS ou Linux, activez avec source .venv/bin/activate et copiez avec cp .env.example .env. Ajoutez votre clé dans .env, et python-dotenv la charge pour le SDK ; notre guide sur les variables d’environnement détaille le procédé. Si vous avez déjà appelé Claude depuis Python, passez la sous-section suivante, elle ne fait que valider l’installation.
La requête minimale utile confirme la clé et montre ce qui est renvoyé.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
Dans cette requête, la réponse contient des blocs thinking et text. Sélectionnez les blocs par type au lieu de lire response.content[0].
Les agents à appels d’outils associent l’API Messages de Claude à des fonctions Python qui contrôlent l’accès aux données. Une règle gouverne l’application : Claude décide des preuves nécessaires, Python décide de ce qui est accessible.
Notre guide d’ingénierie des harnais d’agent couvre les limites d’outils et les boucles plus larges ; HarborCart maintient ses outils en lecture seule et limités à cet incident.
Chaque outil lit un jeu fixe de preuves et renvoie un JSON restreint. Les requêtes de logs et de traces retournent au plus 200 lignes plus un total, et les requêtes de métriques au plus 60 points.
Les appels d’outils programmatiques ne prennent pas en charge strict: true, donc séparez les outils en deux. Conservez stricts et en appel direct uniquement les contrôles de preuve et l’outil d’arrêt d’enquête. Les logs, traces et métriques utilisent uniquement l’exécution de code, offrant à Claude une voie claire pour les requêtes de grande volumétrie.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers guide le modèle mais n’est pas une barrière de sécurité. Python vérifie l’appelant avant chaque exécution d’outil et rejette un appel direct aux requêtes. Les appels programmatiques contournent aussi la validation stricte, les fonctions de requête valident donc toujours leurs propres arguments.
L’application marque chaque résultat d’outil accepté, rejette les conclusions citant des preuves manquantes, et n’accepte des URL de documentation que lorsqu’elles proviennent d’une recherche web. C’est Python, pas le modèle, qui enregistre les sorties de relecture.
Comme noté dans la section migration, laissez tool_choice à auto. Indiquez dans le prompt quand un outil s’applique et utilisez des schémas stricts lorsque les arguments doivent être exacts.
La boucle envoie la conversation, exécute les blocs tool_use, ajoute les résultats et répète. Ajoutez les blocs de l’assistant inchangés, y compris le thinking, et pendant la pause du code programmatique, renvoyez l’identifiant container uniquement avec des blocs tool_result.
La requête d’enquête inclut la vision, les outils, la recherche web, l’effort et le budget de tâche, mais aucun schéma de sortie. Cela évite de mélanger des résultats cités provenant de la recherche avec une sortie JSON structurée, tout en conservant un préfixe de requête stable pour profiter du cache de prompt :
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Joignez le tableau de bord et le schéma d’architecture au premier message utilisateur sous forme de PNG encodés en base64. Indiquez à Claude de traiter toute information lue d’une image comme une hypothèse et de la confirmer via query_metrics.
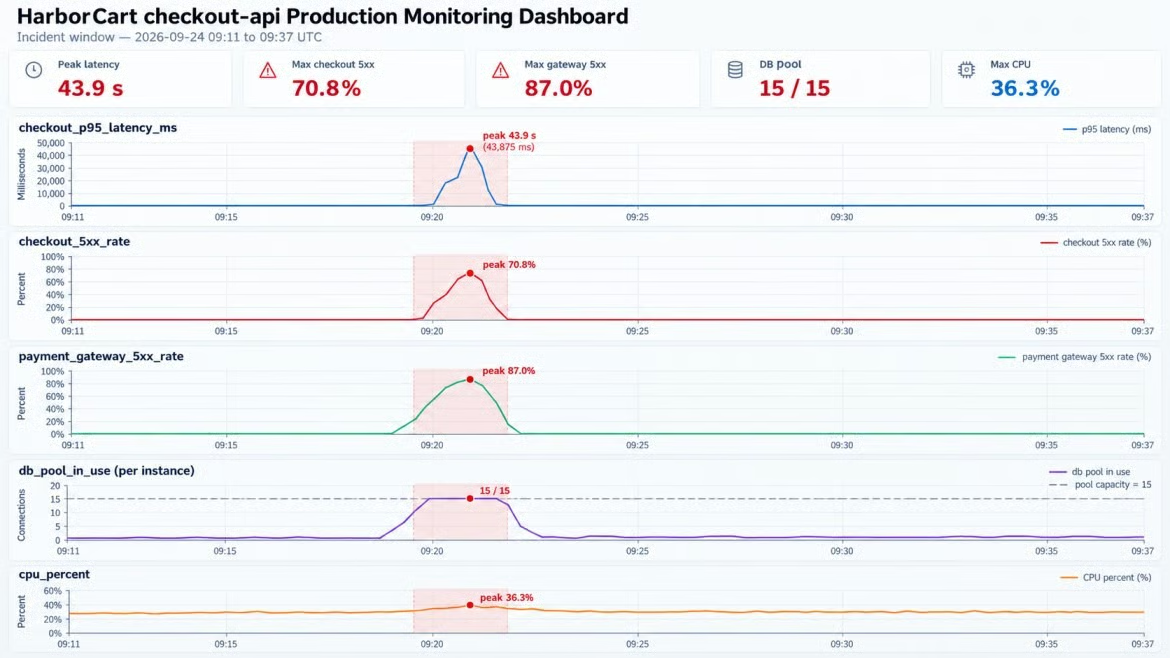
Le tableau de bord montre la saturation du pool, CPU stable. Image de l’auteur.
Le tableau de bord et les requêtes de métriques utilisent la même source de données. Le CPU reste proche de 30 % alors que le pool est plein, ce qui va à l’encontre de l’explication "l’hôte est surchargé" avant même de lancer une requête.
La capture d’écran suggère où regarder, mais la série numérique tranche si l’observation tient. La vision génère une hypothèse ; les métriques la testent.
Pour des workflows image-first, consultez notre tutoriel sur la vision agentique. HarborCart n’utilise la vision que pour choisir la prochaine métrique.
Les appels d’outils programmatiques permettent à Claude d’écrire du Python exécuté dans un conteneur et d’appeler vos outils comme des fonctions. Les résultats bruts restent dans le bac à sable, et seul le texte imprimé par le code est renvoyé au modèle.
L’agent écrit de courts scripts qui extraient les traces en échec et n’impriment que les comptes par endpoint. Lors d’une enquête complète, les appels programmatiques ont réduit de 98,8 % les preuves sérialisées renvoyées au modèle. Les résultats d’outils pesaient 42,9 KB et les synthèses 0,5 KB : une mesure en octets, plus qu’une économie de tokens facturés en entrée.
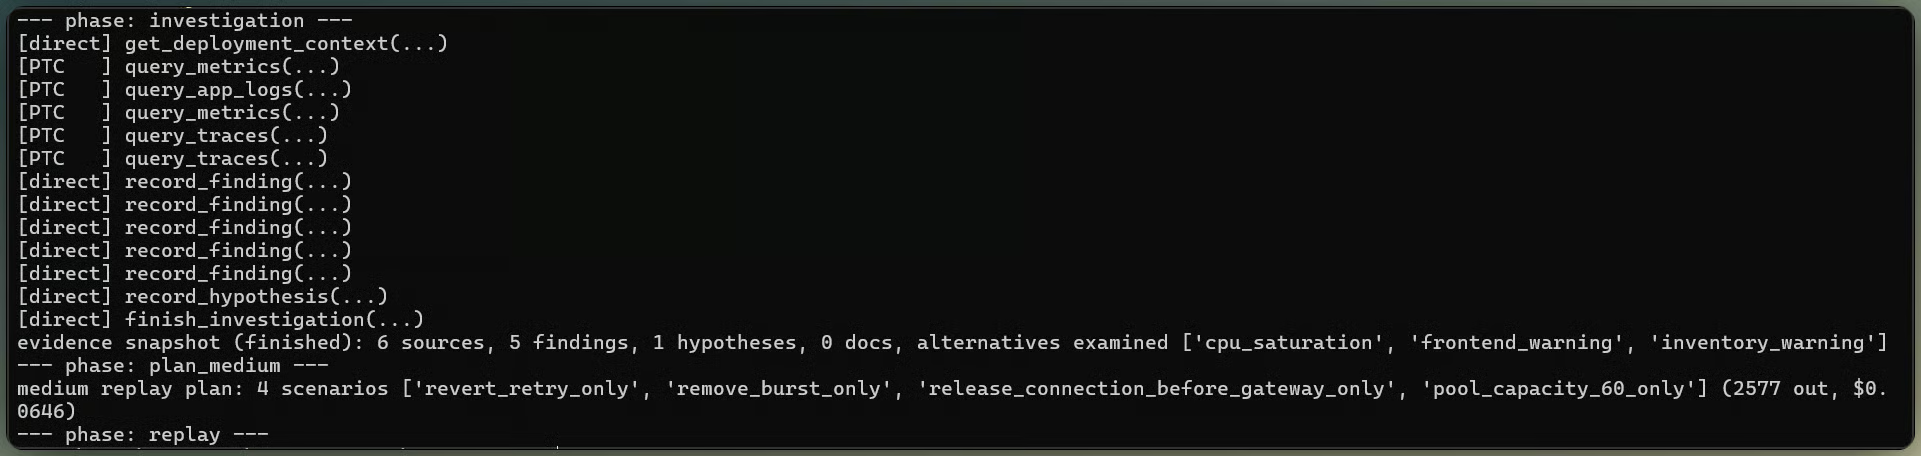
Les appels d’outil resserrent les preuves de l’incident. Image de l’auteur.
L’application expose une recherche web restreinte pour les sémantiques de bibliothèques de retry. Claude ne l’a pas utilisée lors de l’évaluation finale, le diagnostic mesuré repose donc sur le diff, les métriques, les logs et les traces. La référence urllib3 confirme indépendamment que allowed_methods=None réessaie n’importe quel verbe et que backoff_factor=0 supprime l’attente, mais cette page ne fait pas partie des preuves mesurées.
Une relecture contrefactuelle rejoue le trafic de l’incident en retirant une cause suspectée et vérifie si la panne disparaît. Elle transforme "ces courbes montent ensemble" en test.
La relecture réutilise le même profil de trafic. Pour la comparaison ci-dessous, chaque scénario ne change qu’une condition, et l’application contrôle les changements autorisés.
Le récapitulatif sépare les 503 de la passerelle des timeouts du pool, et les 503 de checkout des lectures panier/commande. Cette séparation permet au modèle de distinguer déclencheur et amplificateur.
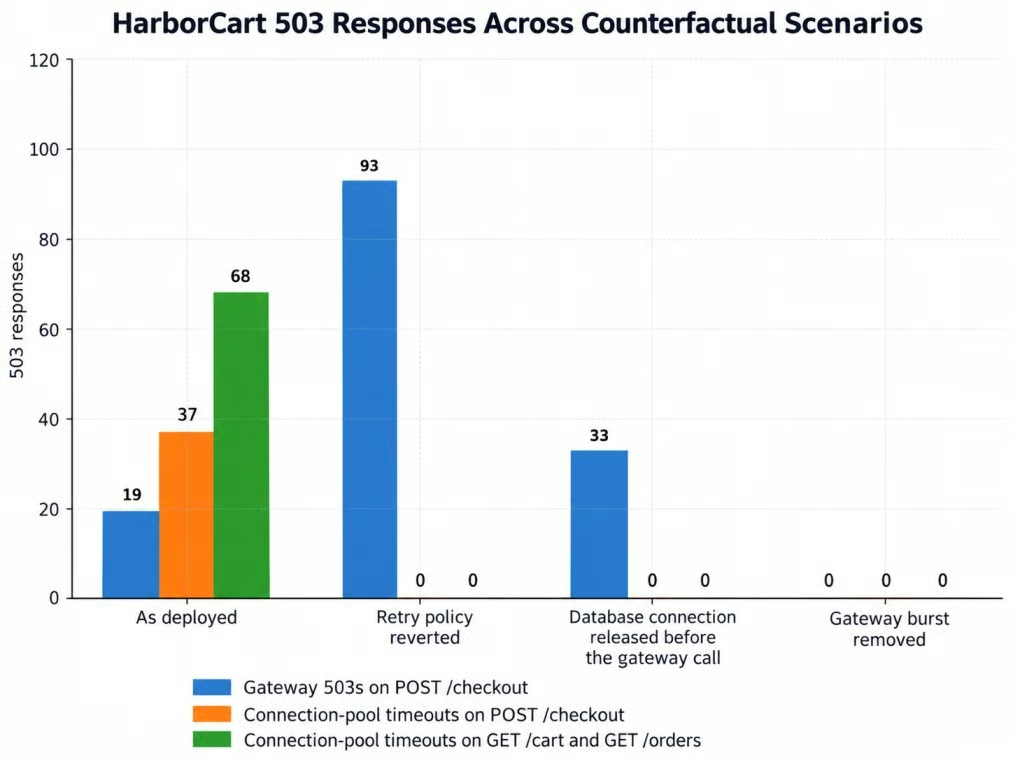
Chaque relecture change exactement un paramètre. Image de l’auteur.
La relecture de référence a produit 124 réponses 503 : 105 timeouts du pool, dont 68 échecs sur des endpoints de lecture, et 19 erreurs de passerelle. Revenir sur la politique de retry a supprimé tous les timeouts du pool et les échecs de lecture mais a fait apparaître 93 503 de passerelle sur checkout. Libérer la connexion avant l’appel à la passerelle a également éliminé les échecs de pool tout en laissant 33 503 de passerelle, et supprimer l’explosion de la passerelle n’a produit aucune erreur.
La relecture met en lumière le compromis : un rollback protège le pool partagé mais laisse passer plus d’échecs de checkout. Utilisez-le en mesure d’urgence. Ajoutez ensuite une clé d’idempotence pour éviter un double débit et cessez de retenir la connexion pendant l’appel à la passerelle.
Le prompt système demande une relecture, mais un prompt n’est pas un mécanisme d’application. La boucle vérifie l’existence de preuves de relecture et rejette un diagnostic non testé.
Conservez ce contrôle dans Python. Un prompt plus strict peut améliorer la conformité, sans la garantir.
L’effort détermine la quantité de raisonnement par étape et un budget de tâche fixe la quantité de travail pour l’ensemble de la boucle. Notre tutoriel Claude Opus 5 API compare les cinq niveaux d’effort ; ici, moyen et élevé reçoivent les mêmes preuves avant relecture.
La production reste en medium. Avant la relecture, l’application demande aux efforts moyen et élevé de concevoir un test causal à partir des mêmes preuves. Elle n’exécute que la recommandation en moyen ; la réponse en élevé sert de comparaison.
La requête en élevé utilise un changement output_config.effort par message, via mid-conversation-output-config-2026-07-01. Elle ne voit pas la réponse en moyen.
Les deux niveaux ont choisi la même hypothèse et les trois mêmes scénarios de relecture centraux. En moyenne, élevé a utilisé 2 631 tokens de sortie contre 2 307 en moyen, soit environ 11 % de coût supplémentaire sans changer le test causal.
Choisissez un budget de tâche d’après l’usage observé plutôt qu’au doigt mouillé. L’enquête non bornée la plus volumineuse d’HarborCart a consommé 13 322 tokens comptés, incluant les sorties du modèle et le texte des résultats d’outils vus par Claude. En ajoutant 25 % de marge, on obtient 16 653, sous le minimum de 20 000 d’Anthropic, le budget configuré est donc 20 000.
Conservez des limites d’applications en nombre de tours et temps écoulé. L’exécuteur d’expériences cessait de lancer de nouveaux travaux après 2,50 $ dépensés. Ce n’est pas un plafond dur, une requête en cours pouvant terminer au-dessus.
La réponse finale utilise des sorties structurées. Son schéma plat couvre le verdict, la cause, les hypothèses rejetées, les preuves et le correctif. Coût et latence restent hors du schéma car mesurés par l’application.
Les citations de recherche web et output_config.format ne peuvent pas partager une même requête : les citations exigent des blocs intercalés, tandis que le schéma impose du JSON. HarborCart enquête donc sans schéma de sortie. Il stocke les constats avec leurs sources et les résultats de relecture, puis n’envoie que ces preuves vérifiées à une seconde requête, sans outils ni recherche web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
La seconde requête n’a besoin que des preuves vérifiées, il est donc inutile de préserver le cache complet de l’enquête.
Autorisez "inconclusive" dans le champ verdict. Un rapport ne doit pas forcer un diagnostic vérifié si la relecture contredit l’explication.
Le schéma valide la forme du rapport, tandis que la relecture valide le diagnostic. Un refus renvoie aussi HTTP 200 avec stop_reason: "refusal" et peut ne pas correspondre à votre schéma, vérifiez donc la raison d’arrêt avant le parsing.
Les trois rapports finaux ont identifié le mécanisme causal central et écarté les trois explications alternatives. Deux ont satisfait aux huit vérifications ; le troisième a obtenu 6/8 car il a omis la configuration explicite de retry sur POST et n’a pas cité le diff de déploiement. D’où l’intérêt de dissocier la notation hors ligne de la validation de schéma : un JSON valide et un bon diagnostic peuvent aboutir à un rapport incomplet.
Les rapports pointent aussi un second risque : réessayer un débit peut facturer deux fois un client. RFC 9110 ne définit pas POST comme intrinsèquement idempotent et déconseille les retries automatiques sauf si le client sait que l’opération est sans risque. Une clé d’idempotence supportée par le prestataire est un moyen courant de sécuriser ces retries.
Notre tutoriel Streamlit explique la mise en place de l’interface. Celle d’HarborCart affiche les événements d’enquête, les plans de relecture moyen et élevé, les résultats de relecture, le rapport final et le coût. Pour le statut entre appels d’outils, le guide de prompting Claude Opus 5.5 décrit display: "updates" ; l’appli affiche aussi des événements d’outils quand un bloc de mise à jour est vide.
Formez-vous avec DataCamp
Cours
Cours
Cours