
Corso
Claude 101
2 h
21.4K
In questo tutorial testerò uno scenario: pochi minuti dopo un aggiornamento software, HarborCart — un negozio che userò per questo scenario — inizia a registrare errori al checkout. Alcuni clienti aspettano oltre 30 secondi; altri vedono un errore del server e non possono pagare. Anche il provider dei pagamenti sta avendo una breve interruzione, quindi sembra la causa più ovvia.
Ma l’interruzione del provider non spiega perché falliscono anche le pagine del carrello e degli ordini. Per trovare l’anello mancante servono i log dell’applicazione, i grafici, i record delle richieste e la modifica di codice recente. Questo tutorial verifica se Claude Opus 5.5 sa seguire quelle evidenze, testare la propria spiegazione in condizioni controllate e riportare solo ciò che le prove supportano.
Un po’ di contesto: Claude Opus 5.5 è arrivato all’inizio di quella settimana, proprio prima che iniziassi questo progetto. La nostra panoramica di Claude Opus 5.5 copre il lancio e i benchmark, quindi questo tutorial resta sull’API e costruisce un agente d’indagine dall’avvio fino a un report verificato.
Vedremo come:
L’investigatore di HarborCart ha separato il picco del gateway di pagamento dalla policy di retry che lo amplificava, poi ha testato quella spiegazione prima di restituire un report.
Accedi a Claude Opus 5.5 tramite la Messages API di Anthropic con l’ID modello claude-opus-5-5. Come indicato nella panoramica del modello, accetta testo e immagini, con una finestra di contesto da 1M token e output massimo 128K. Il ragionamento adattivo è sempre attivo e l’effort predefinito è medium.
Il listino standard è $4 per milione di token in input e $20 per milione di token in output. Le scritture in cache di cinque minuti costano $5 per milione e le letture di cache $0,20. Una volta attivata la prompt caching, i prefissi corrispondenti sono fatturati alla tariffa ridotta di lettura cache.
Quattro punti dalla guida alla migrazione compaiono direttamente in questo progetto.
L’uso forzato di tool_choice con any o uno strumento nominato restituisce un errore 400.
L’effort predefinito è sceso da high su Claude Opus 5 a medium.
Il thinking non può essere disattivato e i blocchi thinking devono tornare invariati all’interno di un loop di strumenti.
Le note che il modello scrive tra le chiamate agli strumenti arrivano dentro i blocchi thinking, che sono vuoti per impostazione predefinita.
L’agente fa solo indagine. Ha strumenti probatori in sola lettura e nessuna credenziale di produzione. Dopo la raccolta delle prove, richieste di pianificazione separate propongono test controfattuali, e Python convalida ed esegue il piano a effort medio.
Il codice completo, incluso generatore di evidenze e web app, è in questo repository GitHub.
HarborCart è un negozio fittizio. La sua checkout-api serve le pagine del carrello, lo stato degli ordini e POST /checkout, che addebita un gateway di pagamento di terze parti. Tutti quegli endpoint condividono un pool PostgreSQL di 15 connessioni per istanza.
Parte un deploy e cinque minuti dopo il gateway restituisce 503 per circa 90 secondi. La latenza del checkout supera i 30 secondi mentre il pool è a 15 su 15. Dare la colpa al provider dei pagamenti è la scelta facile, e il gateway è davvero andato in errore.
La causa nascosta è un passo più in là. Il deploy ha permesso ai tentativi di addebito POST falliti di ritentare fino a tre volte, per un totale di quattro tentativi, senza pausa mentre l’handler mantiene la sua connessione al database. Ora gli addebiti che falliscono lentamente tengono le connessioni per 30 secondi o più, finché il pool si esaurisce e falliscono anche le pagine del carrello che non chiamano mai il gateway.
Da qui uso tre termini in modo coerente. Qui, il grilletto è il guasto temporaneo del gateway. Ritentare i POST di checkout mentre si tengono connessioni al database scarse è il meccanismo di amplificazione; l’esaurimento del pool di connessioni condiviso è la failure di sistema.
L’agente parte dall’alert, da uno screenshot di monitoraggio e da un diagramma architetturale. Tutto il resto arriva tramite strumenti: log, trace, cinque metriche, metadati del deploy, il diff Git e una runbook. Tre spiegazioni alternative sono predisposte nelle evidenze: un avviso di inventario, un avviso del frontend e una possibile saturazione della CPU.
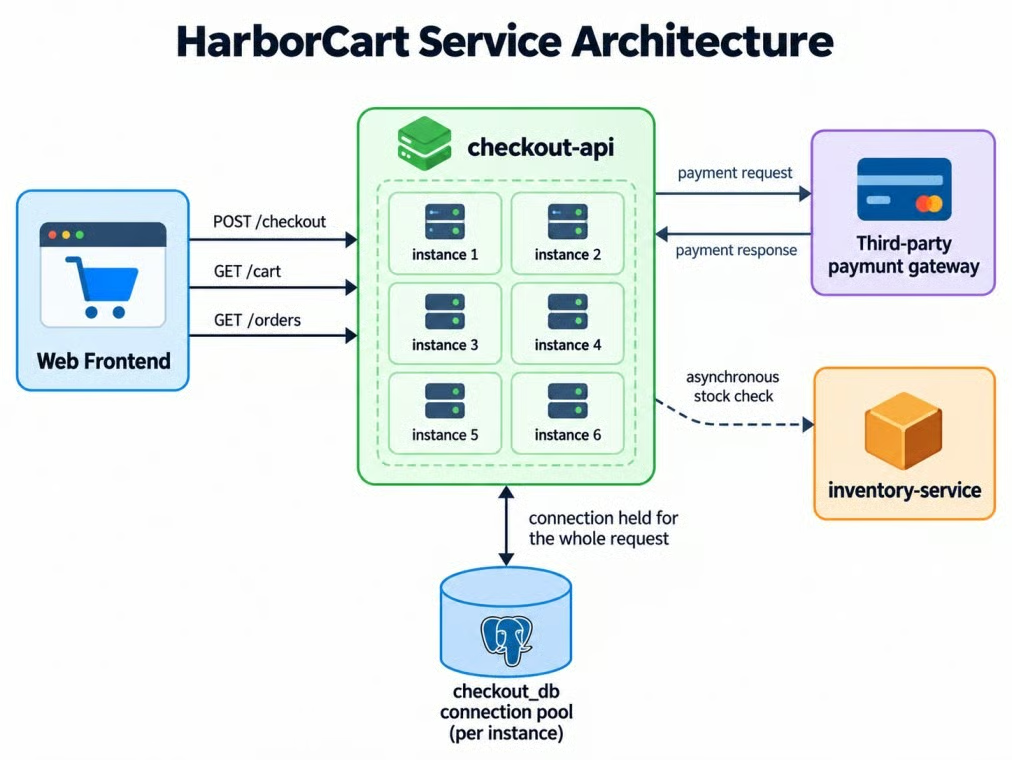
Percorso checkout di HarborCart e pool condiviso. Immagine dell’autore.
Il diagramma indica che la connessione viene mantenuta per tutta la richiesta. Non dice che sia un problema; l’indagine deve capirlo.
Definisci il successo prima di costruire l’agente. Un report corretto deve:
POSTTi serve Python 3.10 o superiore e una chiave API Anthropic con accesso a claude-opus-5-5. Questi comandi PowerShell clonano il progetto e installano le dipendenze bloccate, incluso anthropic 1.8.0. Se usi Amazon Bedrock, leggi prima le FAQ, perché diverse funzionalità non sono portabili.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Su macOS o Linux, attiva con source .venv/bin/activate e copia con cp .env.example .env. Aggiungi la tua chiave in .env, e python-dotenv la carica per l’SDK; la nostra guida alle variabili d’ambiente spiega il pattern. Se hai già chiamato Claude da Python, salta la prossima sottosezione, che serve solo a confermare la configurazione.
La richiesta utile più piccola conferma la chiave e mostra cosa ritorna.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
In questa richiesta, la risposta contiene blocchi thinking e text. Seleziona i blocchi per tipo invece di leggere response.content[0].
Gli agenti con tool calling abbinano la Messages API di Claude a funzioni Python che controllano l’accesso ai dati. L’applicazione segue una regola: Claude decide quali evidenze servono, e Python decide a cosa può accedere.
La nostra guida all’engineering dell’harness degli agenti copre confini e loop degli strumenti più ampi; HarborCart mantiene i suoi strumenti in sola lettura e limitati a questo incidente.
Ogni strumento legge un set fisso di evidenze e restituisce un risultato JSON limitato. Le query di log e trace restituiscono al massimo 200 righe più un conteggio, e le query di metriche restituiscono al massimo 60 punti.
La chiamata di strumenti programmatica non supporta strict: true, quindi separa gli strumenti in due gruppi. Mantieni i controlli delle evidenze e lo strumento di stop dell’indagine rigorosi e solo diretti. Log, trace e metriche usano solo esecuzione di codice, che dà a Claude un percorso chiaro per query di evidenze di grandi dimensioni.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers guida il modello ma non è un perimetro di sicurezza. Python controlla il chiamante prima di eseguire ciascuno strumento e rifiuta una chiamata diretta alle query. Le chiamate programmatiche saltano anche la validazione strict, quindi le funzioni di query convalidano comunque i propri argomenti.
L’applicazione etichetta ogni risultato di strumento accettato, rifiuta conclusioni che citano evidenze mancanti e accetta URL di documentazione solo quando la ricerca web li ha restituiti. Python, non il modello, registra gli output del replay.
Come notato nella sezione migrazione, mantieni tool_choice su auto. Indica nel prompt quando si applica uno strumento e usa schemi rigorosi dove gli argomenti devono essere esatti.
Il loop invia la conversazione, esegue eventuali blocchi tool_use, aggiunge i risultati e ripete. Aggiungi i blocchi dell’assistente invariati, thinking incluso, e mentre il codice programmatico è in pausa, passa l’ID del container indietro solo con blocchi tool_result.
La richiesta d’indagine include visione, strumenti, ricerca web, effort e budget del task, ma nessuno schema di output. Questo tiene lontani i risultati con citazioni dallo JSON strutturato mentre il prefisso di richiesta stabile mantiene attiva la cache del prompt:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Allega la dashboard e il diagramma architetturale al primo messaggio utente come PNG base64. Di’ a Claude di trattare tutto ciò che legge da un’immagine come un’ipotesi e confermarla con query_metrics.
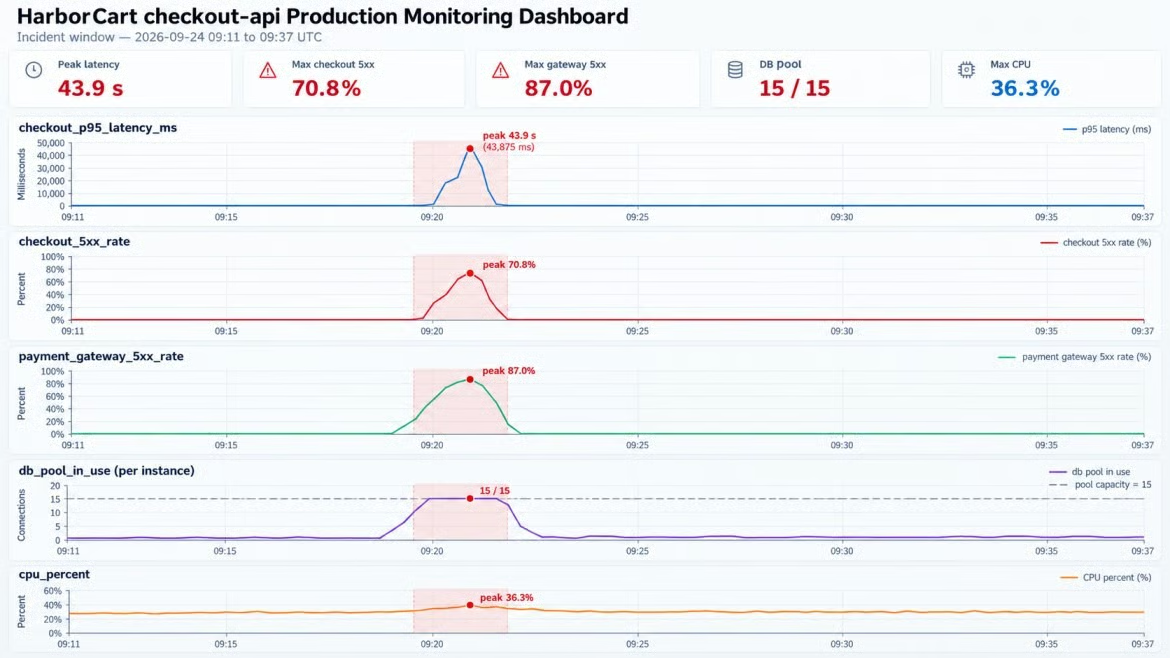
La dashboard mostra saturazione del pool, CPU piatta. Immagine dell’autore.
Sia la dashboard sia le query di metriche usano gli stessi dati sorgente. La CPU resta intorno al 30% mentre il pool è pieno, il che depone contro "l’host è sovraccarico" prima ancora che parta una query.
Lo screenshot suggerisce dove guardare, ma la serie numerica decide se l’osservazione regge. La visione genera un’ipotesi; le metriche la testano.
Per flussi di lavoro image-first, vedi il nostro tutorial sulla visione agentica. HarborCart usa la visione solo per scegliere la prossima metrica.
La chiamata programmatica degli strumenti consente a Claude di scrivere Python che gira in un container di esecuzione di codice e chiama i tuoi strumenti come funzioni. I risultati grezzi restano nella sandbox e solo l’output stampato dal codice raggiunge il modello.
L’agente scrive script brevi che estraggono le trace fallite e stampano solo i conteggi per endpoint. In un’indagine completa, la chiamata programmatica ha ridotto del 98,8% le evidenze serializzate restituite al modello. I risultati degli strumenti erano 42,9 KB e i riepiloghi 0,5 KB, una misura in byte piuttosto che un risparmio di token fatturati in input.
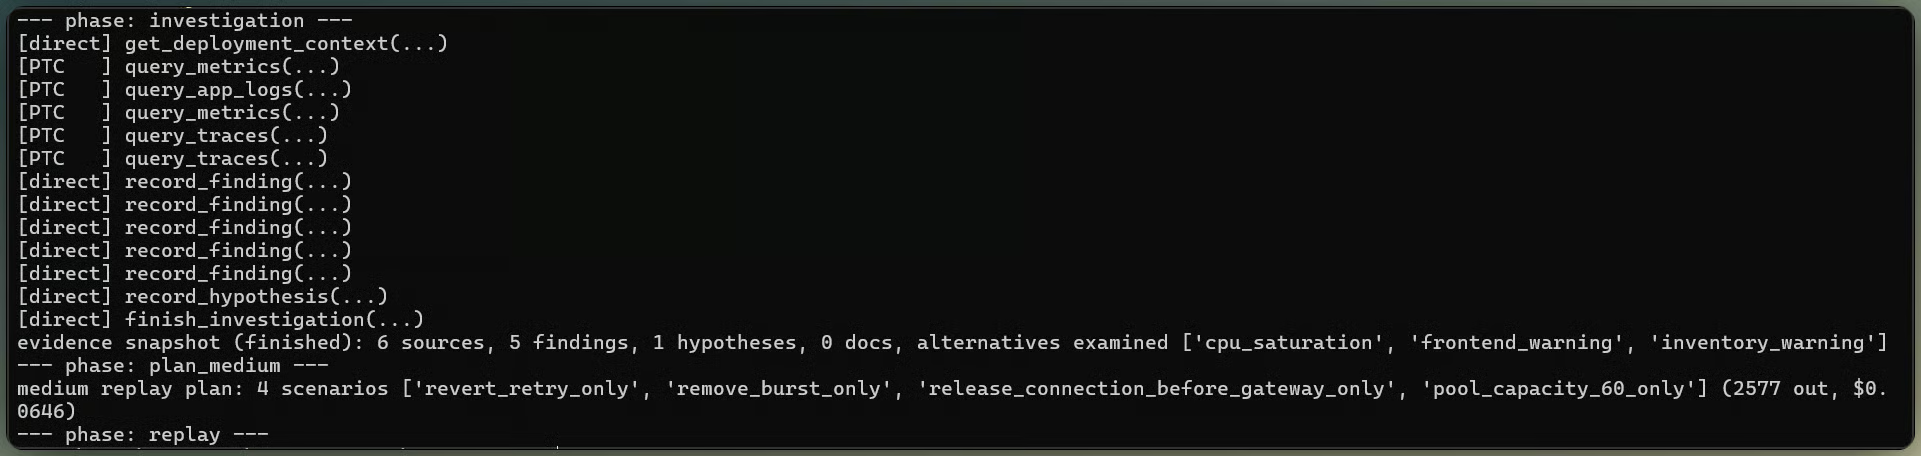
Le chiamate agli strumenti restringono le evidenze dell’incidente. Immagine dell’autore.
L’applicazione espone una ricerca web ristretta per le semantiche della libreria di retry. Claude non l’ha chiamata durante la valutazione finale, quindi la diagnosi misurata poggia su diff, metriche, log e trace. Il reference di urllib3 conferma indipendentemente che allowed_methods=None ritenta qualsiasi verbo e backoff_factor=0 rimuove l’attesa, ma quella pagina non fa parte delle evidenze misurate.
Un replay controfattuale riesegue il traffico dell’incidente rimuovendo una causa sospetta e verifica se il guasto scompare. Trasforma "queste linee salgono insieme" in un test.
Il replay riutilizza lo stesso pattern di traffico. Per il confronto sotto, ogni scenario cambia una sola condizione, e l’applicazione controlla quali cambi sono permessi.
Il riepilogo separa i 503 del gateway dai timeout del pool, e i 503 del checkout dalle letture di carrello e ordini. Quella suddivisione è ciò che consente al modello di distinguere il grilletto dall’amplificatore.
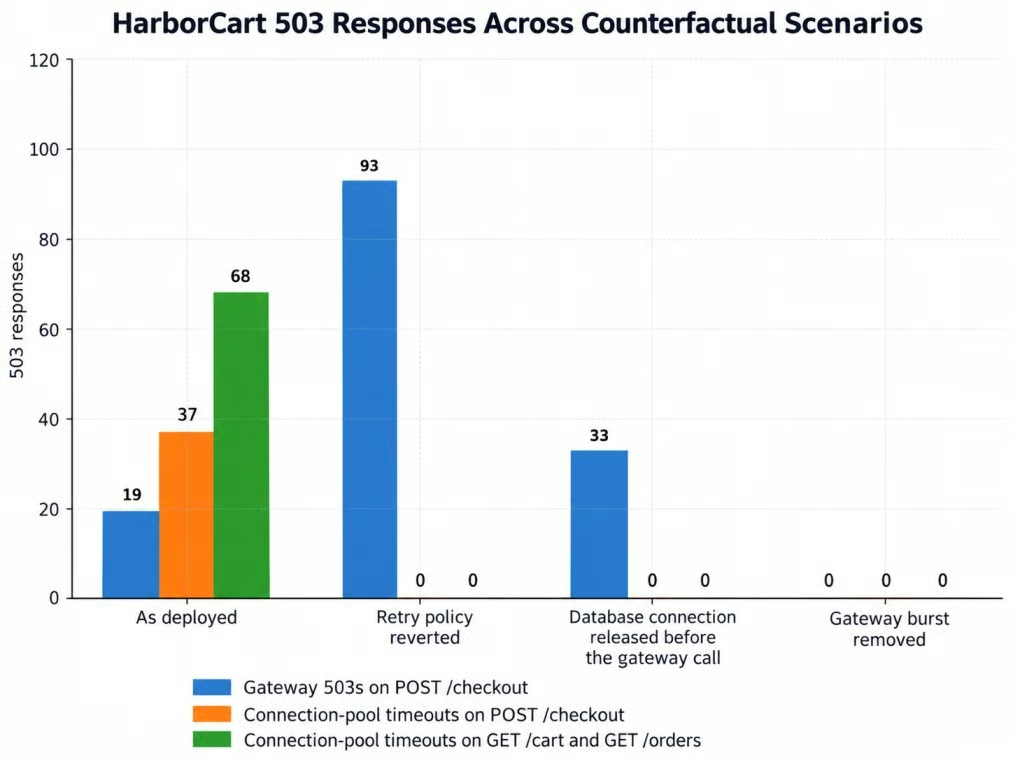
Ogni replay cambia esattamente una cosa. Immagine dell’autore.
Il replay di base ha prodotto 124 errori 503: 105 timeout del pool, inclusi 68 fallimenti sugli endpoint di lettura, e 19 errori del gateway. Il ripristino della policy di retry ha rimosso tutti i timeout del pool e i fallimenti in lettura ma ha fatto emergere 93 errori 503 del gateway sul checkout. Il rilascio della connessione prima della chiamata al gateway ha rimosso anch’esso le failure del pool lasciando 33 errori 503 del gateway, e la rimozione del picco del gateway non ha prodotto errori.
Il replay espone il compromesso: un rollback protegge il pool condiviso ma lascia passare più failure di checkout. Usalo come misura tampone. Poi aggiungi una chiave di idempotenza così un addebito ripetuto non può fatturare due volte, e smetti di tenere la connessione durante la chiamata al gateway.
Il system prompt chiede un replay, ma un prompt non è un meccanismo di enforcement. Il loop controlla se esistono evidenze di replay e rifiuta una diagnosi non testata.
Mantieni questo controllo in Python. Un prompt più netto può migliorare la conformità, ma non può garantirla.
L’effort imposta quanto Claude ragiona per step e un task budget imposta quanto lavoro dovrebbe richiedere l’intero loop. Il nostro tutorial sull’API Claude Opus 5 confronta tutti e cinque i livelli di effort; qui, medium e high ricevono le stesse evidenze pre-replay.
La produzione resta su medium. Prima del replay, l’applicazione chiede a effort medio e alto di progettare un test causale dalle stesse evidenze. Esegue solo la raccomandazione medium; la risposta high è usata solo per confronto.
La richiesta high usa una modifica output_config.effort per messaggio abilitata da mid-conversation-output-config-2026-07-01. Non vede la risposta medium.
Entrambi i livelli di effort hanno selezionato la stessa ipotesi e gli stessi tre scenari di replay centrali. High ha usato in media 2.631 token di output contro 2.307 a medium, ed è costato circa l’11% in più senza cambiare il test causale.
Scegli un task budget in base all’uso osservato invece che a stima. L’indagine più grande e senza limiti di HarborCart ha consumato 13.322 token conteggiati, inclusi output del modello e testo dei risultati degli strumenti visti da Claude. Aggiungendo un margine del 25% si arriva a 16.653, sotto il minimo di 20.000 token di Anthropic, quindi il budget configurato è 20.000.
Mantieni i turni e il tempo trascorso come limiti dell’applicazione. L’esecutore degli esperimenti ha smesso di avviare nuovo lavoro dopo aver raggiunto una spesa registrata di $2,50. Non è un tetto rigido perché una richiesta già in corso può finire oltre tale soglia.
La risposta finale usa output strutturati. Il suo schema piatto copre verdetto, causa, ipotesi rifiutate, evidenze e fix. Costi e latenza restano fuori perché li misura l’applicazione.
Citazioni dalla ricerca web e output_config.format non possono condividere una richiesta: le citazioni richiedono blocchi di contenuto intercalati, mentre lo schema richiede JSON. HarborCart quindi indaga senza uno schema di output. Memorizza i risultati legati alle loro fonti e ai risultati del replay, poi invia solo quelle evidenze verificate a una seconda richiesta senza strumenti o ricerca web.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
La seconda richiesta ha bisogno solo delle evidenze verificate, quindi preservare la cache completa dell’indagine non è necessario.
Consenti "inconclusive" nel campo verdict. Un report non dovrebbe essere forzato in una diagnosi verificata quando il replay contraddice la sua spiegazione.
Lo schema valida la forma del report, mentre il replay valida la diagnosi. Un rifiuto restituisce comunque HTTP 200 con stop_reason: "refusal" e potrebbe non rispettare il tuo schema, quindi controlla la stop reason prima del parsing.
Tutti e tre i report finali hanno trovato il meccanismo causale centrale ed escluso le tre spiegazioni alternative. Due hanno soddisfatto tutti e otto i controlli; il terzo ha segnato 6/8 perché ha omesso la modifica esplicita di configurazione del retry dei POST e non ha citato il diff del deploy. Ecco perché lo scoring offline resta separato dalla validazione dello schema: JSON valido e diagnosi corretta possono comunque produrre un report incompleto.
I report individuano anche un secondo rischio: ritentare un addebito può fatturare due volte a un cliente. RFC 9110 non definisce POST come intrinsecamente idempotente e sconsiglia retry automatici a meno che il client sappia che l’operazione è sicura da ripetere. Una chiave di idempotenza supportata dal provider di pagamenti è un modo comune per rendere più sicuri quei retry.
Il nostro tutorial su Streamlit copre il setup dell’interfaccia. L’interfaccia di HarborCart mostra gli eventi dell’indagine, i piani di replay medium e high, i risultati del replay, il report finale e il costo. Per lo stato tra le chiamate agli strumenti, la guida al prompting di Claude Opus 5.5 descrive display: "updates"; l’app rende anche gli eventi degli strumenti quando un blocco di aggiornamento è vuoto.
Impara con DataCamp
Corso
Corso
Corso