Courses
Claude 101
2小时
21.4K
在本教程中,我将测试这样一个场景:软件更新几分钟后,HarborCart(本文场景中的一家商店)开始出现结账失败。一些客户等待超过 30 秒;另一些看到服务器错误,无法支付。支付服务商此时也出现了短暂宕机,看起来是“显而易见”的原因。
但服务商宕机并不能解释购物车和订单页面也会失败。找出缺失的环节需要应用日志、图表、请求记录以及最近的代码变更。本教程将检验 Claude Opus 5.5 能否沿着这些证据推理、在可控条件下检验其解释,并且只报告证据所支持的结论。
背景:就在我启动这个项目的前一周,Claude Opus 5.5 发布了。我们的Claude Opus 5.5 概览涵盖了发布与基准测试,因此本教程聚焦 API,从首次请求到经验证的报告,构建一个调查代理。
我们将介绍如何:
HarborCart 的调查员把支付网关的突发故障与放大的重试策略区分开来,并在返回报告前对该解释进行了测试。
您通过 Anthropic 的 Messages API 使用 Claude Opus 5.5,模型 ID 为claude-opus-5-5。根据模型概览,它支持文本与图像,具备 100 万 token 的上下文窗口与 128K 的最大输出。自适应思考始终开启,默认 effort 为medium。
标准定价为每百万输入 token $4、每百万输出 token $20。5 分钟缓存写入为每百万 $5,缓存读取为 $0.20。启用提示缓存后,匹配前缀按较低的缓存读取费率计费。
迁移指南中的四点在本项目中直接体现:
使用 any或指定工具强制 tool_choice 会返回 400 错误。
默认 effort 从 Claude Opus 5 的high 降至medium。
思考不可关闭,且在工具循环中必须原样传回 thinking 块。
工具调用之间模型写下的笔记位于 thinking 块内,默认为空。
该代理只负责调查。它具备只读证据工具,没有生产凭据。完成证据收集后,使用独立的规划请求提出反事实测试,由 Python 校验并运行 medium-effort 的方案。
完整代码(含证据生成器和 Web 应用)见此GitHub 仓库。
HarborCart 是虚构商店。其checkout-api 提供购物车页面、订单状态以及 POST /checkout,该端点会调用第三方支付网关。这些端点共享每实例 15 个连接的 PostgreSQL 连接池。
一次部署发布后约五分钟,网关持续约 90 秒返回 503。结账延迟攀升至 30 秒以上,而连接池始终占满 15/15。将责任归咎于支付服务商是最容易的判断,而且网关确实失败了。
隐藏原因在更深一层。此次部署允许失败的 POST 扣款最多重试三次(共四次尝试),期间处理器始终占用数据库连接且无等待。缓慢失败的扣款现在会占用连接 30 秒或更久,直到连接池耗尽,进而导致从不调用网关的购物车页面也失败。
从这里起我使用三个术语。这里,触发因素是网关的临时故障;在占用稀缺数据库连接的同时重试结账 POST 是放大机制;共享连接池的耗尽是系统性失败。
代理从告警、一张监控截图与一张架构图开始。其他全部通过工具获取:日志、追踪、五项指标、部署元数据、Git diff 以及运行手册。我们在证据中预置了三个相互竞争的解释:库存告警、前端告警,以及可能的 CPU 饱和。
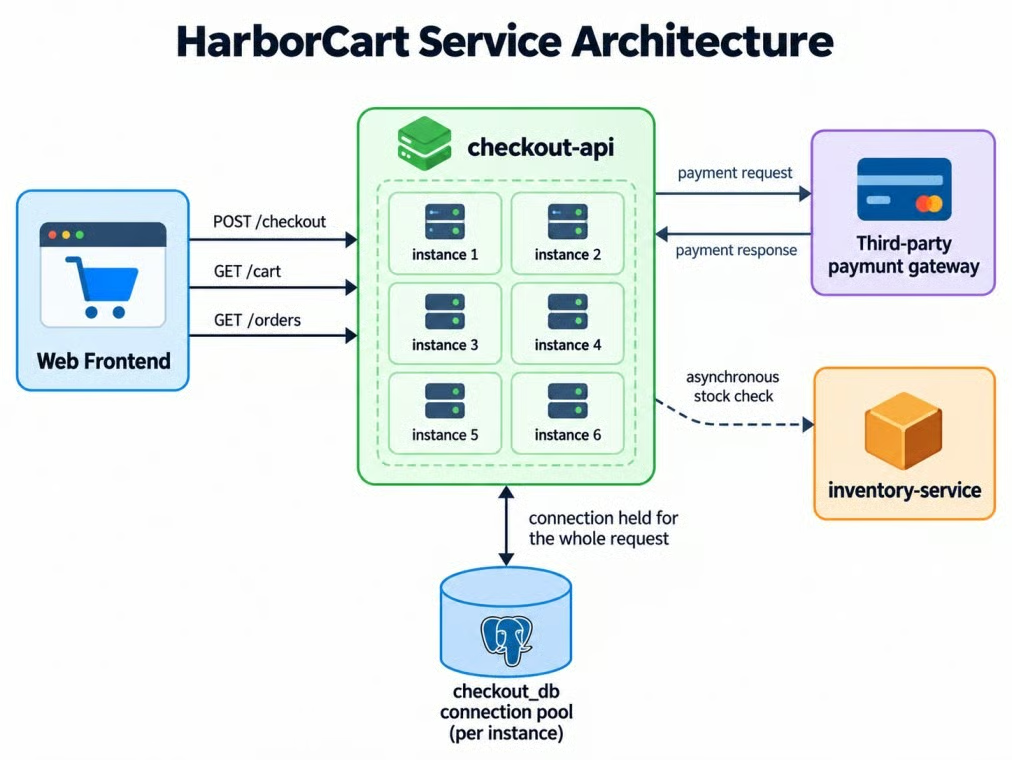
HarborCart 的结账路径与共享连接池。图片由作者提供。
该图表明连接在整个请求期间被持有。但它并未指出这是问题;调查需要自行得出这一点。
在构建代理前先定义成功标准。一份正确的报告必须:
POST 重试的重试策略变更您需要 Python 3.10 或更高版本,以及可访问 claude-opus-5-5 的 Anthropic API 密钥。以下 PowerShell 命令克隆项目并安装其固定依赖(包括 anthropic 1.8.0)。如果您使用 Amazon Bedrock,请先阅读常见问题,因为有些功能无法迁移。
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
在 macOS 或 Linux 上,使用 source .venv/bin/activate 激活,使用 cp .env.example .env 复制。将您的密钥加入 .env,python-dotenv 会为 SDK 加载它;我们的环境变量指南解释了这一做法。如果您此前已用 Python 调用过 Claude,可跳过下一小节,因为它只是在确认环境设置。
最小可用请求既能确认密钥有效,也能展示返回内容。
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
在该请求中,响应包含 thinking 与 text 块。请按类型选择块,而非直接读取 response.content[0]。
工具调用代理将 Claude 的 Messages API 与用于控制数据访问的 Python 函数配对。应用遵循一条规则:Claude 决定需要哪些证据,Python 决定它可以访问哪些证据。
我们的代理框架工程指南涵盖更广泛的工具边界与循环;HarborCart 将其工具保持为只读,并限定在本次事件范围内。
每个工具读取一组固定的证据并返回受限的 JSON 结果。日志与追踪查询最多返回 200 行及其计数;指标查询最多返回 60 个点。
编程式工具调用不支持 strict: true,因此将工具一分为二。将证据控制与结束调查的工具设为严格且仅可直接调用。日志、追踪与指标仅使用代码执行,这为 Claude 在进行大规模证据查询时提供唯一清晰的路径。
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers 用于引导模型,但不是安全边界。Python 在执行每个工具前会检查调用方,并拒绝直接的查询调用。编程式调用同样跳过严格校验,因此查询函数仍需自行校验参数。
应用会为每个被接受的工具结果打标签,拒绝引用缺失证据的发现,仅在网页搜索返回时接受文档 URL。记录回放输出的是 Python,而非模型。
如迁移部分所述,将 tool_choice 维持为 auto。在提示中说明何时适用工具,并在参数必须精确时用严格的模式定义。
该循环发送对话、运行任何 tool_use 块、追加结果并重复。原样追加助理的各块(包括 thinking),并在编程式代码暂停时,仅用 tool_result 块传回 container ID。
调查请求包含视觉、工具、网页搜索、effort 与任务预算,但无输出模式定义。这样可避免带引文的搜索结果与结构化 JSON 输出混用,同时稳定的请求前缀保持提示缓存生效:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)将仪表盘与架构图作为 base64 PNG 附在首条用户消息中。告知 Claude:从图像读到的任何信息都应视为假设,并用 query_metrics 进行确认。
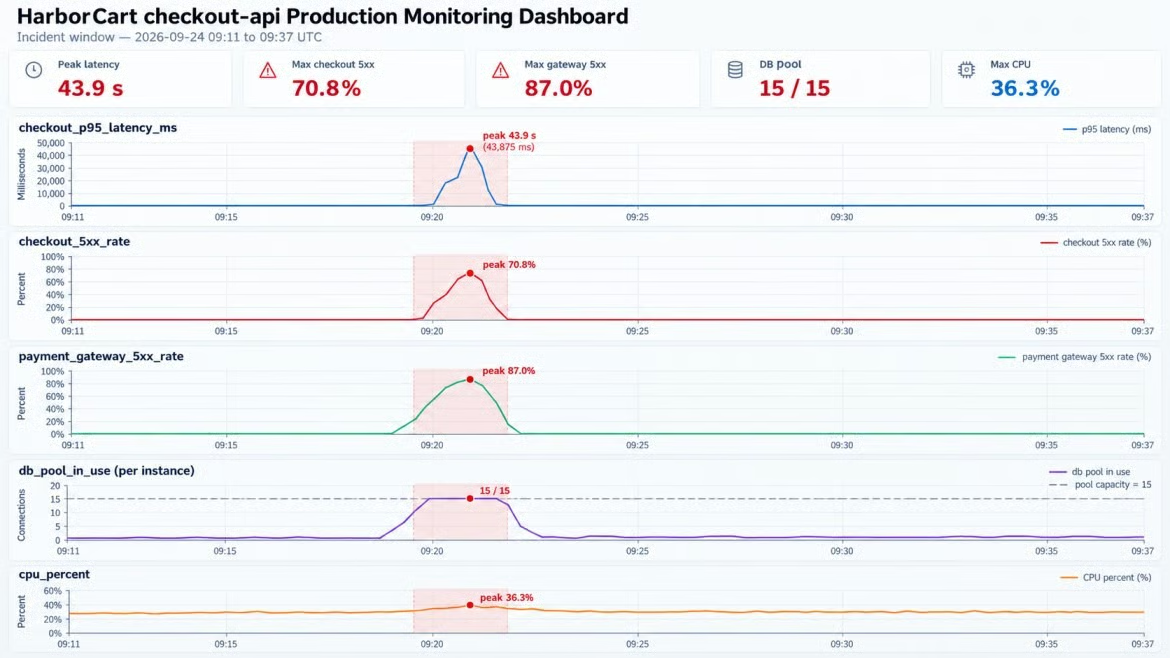
仪表盘显示连接池饱和而 CPU 持平。图片由作者提供。
仪表盘与指标查询使用相同数据源。池满期间 CPU 保持在约 30%,这在任何查询执行前就已对“主机过载”的说法不利。
截图提示了关注方向,但数值序列决定观察是否成立。视觉产生假设;指标对其进行检验。
关于以图像为先的工作流,参阅我们的智能体视觉教程。HarborCart 仅用视觉来选择下一个指标。
编程式工具调用允许 Claude 编写在代码执行容器中运行的 Python,并将您的工具作为函数调用。原始结果保留在沙箱中,只有代码的打印输出会返回给模型。
代理编写短脚本,提取失败的追踪并仅按端点输出计数。在一次完整调查中,编程式工具调用将返回给模型的序列化证据减少了 98.8%。工具结果为 42.9 KB,摘要为 0.5 KB;这是字节计量,而非按计费输入 token 计算的节省。
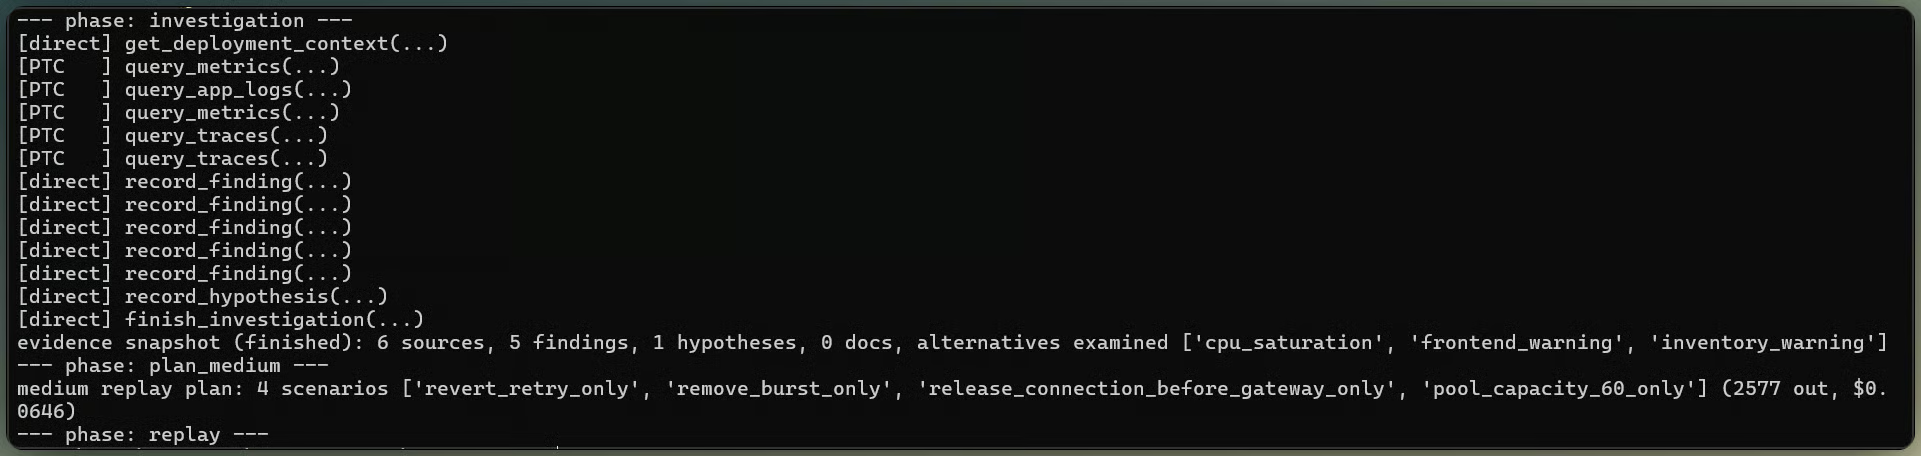
工具调用缩窄事件证据范围。图片由作者提供。
应用针对重试库语义开放了受限的网页搜索。在最终评估中 Claude 并未调用它,因此测得的诊断依托 diff、指标、日志与追踪。urllib3 参考独立确认 allowed_methods=None 会重试任何动词,且 backoff_factor=0 取消等待,但该页面不计入测量证据。
反事实回放在移除一个可疑原因的条件下重放事件流量,并检查失败是否消失。它把“这些曲线同时上升”转化为可检验的测试。
回放复用同样的流量模式。如下比较中,每种情景只改变一个条件,且应用控制允许的改动范围。
汇总将网关 503 与连接池超时区分开来,并将结账 503 与购物车、订单读取区分开来。正是这种划分让模型能区分触发因素与放大器。
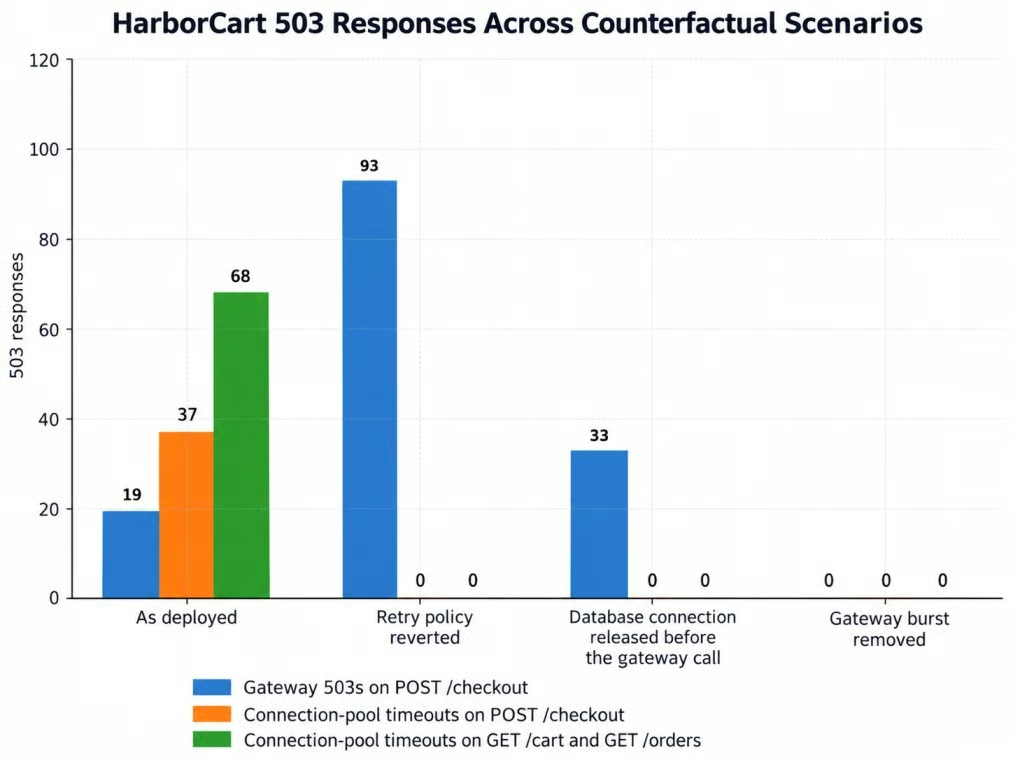
每次回放只改变一项条件。图片由作者提供。
基线回放产生了 124 个 503:其中 105 个为连接池超时,包括 68 个发生在读取端点;另有 19 个为网关错误。回滚重试策略消除了所有连接池超时与读取失败,但暴露出 93 个结账时的网关 503。将网关调用前释放连接同样消除了连接池失败,同时保留了 33 个网关 503;移除网关突发则没有错误。
回放揭示了权衡:回滚可以保护共享连接池,但会放行更多结账失败。可将其作为权宜之计。随后添加幂等键,避免重复扣款造成二次计费,并在网关调用期间停止持有连接。
系统提示会要求进行回放,但提示并非强制机制。循环会检查是否存在回放证据,并拒绝未经测试的诊断。
请在 Python 中保留此检查。更锋利的提示也许能提高遵从度,但无法保证。
Effort 决定 Claude 每步推理的深度,任务预算则限定整个循环的工作量。我们的Claude Opus 5 API 教程比较了五个 effort 等级;此处 medium 与 high 接收相同的回放前证据。
生产环境保持 medium。回放前,应用让 medium 与 high 基于相同证据设计因果测试。仅执行 medium 的建议;high 的响应仅用于比较。
high 请求通过 mid-conversation-output-config-2026-07-01 在每条消息上调整 output_config.effort。它看不到 medium 的答案。
两个 effort 等级都选择了相同的假设与三项核心回放情景。high 平均使用 2,631 个输出 token,相比 medium 的 2,307 多约 11% 成本,但未改变因果测试。
基于观测用量而非猜测来选择任务预算。HarborCart 最大的一次无限制调查消耗了 13,322 个计入 token(包括模型输出和工具结果文本)。加上 25% 余量为 16,653,低于 Anthropic 的 20,000 token 最低值,因此配置为 20,000。
将轮次与耗时作为应用限制。实验运行器在记录花费达到 $2.50 后停止启动新工作。这不是硬上限,因为进行中的请求可能在其上方完成。
最终答案使用结构化输出。其扁平的模式涵盖裁决、原因、被否定的假设、证据与修复。成本与延迟不纳入其中,因为由应用测量。
网页搜索引文与 output_config.format 无法共用一个请求:引文需要交错的内容块,而模式要求 JSON。因此 HarborCart 在调查阶段不使用输出模式。它将发现与其来源及回放结果绑定存储,然后仅将这些经验证的证据发送至第二个不带工具与网页搜索的请求。
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
第二个请求只需要经验证的证据,因此无需保留完整调查的缓存。
允许在 verdict 字段中填写 "inconclusive"。当回放与解释相矛盾时,不应强迫报告给出“已验证”的诊断。
模式只验证报告的结构,而回放验证诊断。拒绝同样会返回 HTTP 200 且 stop_reason: "refusal",并可能不符合您的模式,因此在解析前请检查 stop reason。
三份最终报告均找到了核心因果机制,并排除了三个备选解释。两份满足全部八项检查;第三份得分 6/8,因为漏写了明确的 POST 重试配置变更,且未引用部署 diff。这就是为何离线评分应独立于模式校验:即便 JSON 有效、诊断正确,报告仍可能不完整。
报告还指出第二个风险:重试扣款可能导致客户被重复计费。RFC 9110 未将 POST 定义为天然幂等,并建议除非客户端确信操作可安全重复,否则不要自动重试。由支付服务商支持的幂等键是提升此类重试安全性的常见方式之一。
我们的Streamlit 教程介绍了界面搭建。HarborCart 的界面展示调查事件、medium 与 high 的回放方案、回放结果、最终报告与成本。关于工具调用之间的状态,Claude Opus 5.5 提示指南描述了 display: "updates";当更新块为空时,应用也会渲染工具事件。
与 DataCamp 一起学习
Courses
Courses
Courses