Courses
Claude 101
2 ชม.
21.4K
ในบทช่วยสอนนี้ จะทดสอบสถานการณ์: ไม่กี่นาทีหลังอัปเดตซอฟต์แวร์ HarborCart — ร้านค้าสมมติที่ใช้ในสถานการณ์นี้ — เริ่มพบการชำระเงินล้มเหลว บางลูกค้ารอนานเกิน 30 วินาที บางรายพบข้อผิดพลาดฝั่งเซิร์ฟเวอร์และไม่สามารถจ่ายเงินได้ ผู้ให้บริการชำระเงินเองก็มีเหตุขัดข้องสั้น ๆ ดูเหมือนเป็นสาเหตุที่ชัดเจน
แต่เหตุขัดข้องของผู้ให้บริการไม่อธิบายว่าทำไมหน้าตะกร้าและคำสั่งซื้อจึงล้มเหลวด้วย การหาจุดเชื่อมโยงที่ขาดหายต้องใช้บันทึกแอปพลิเคชัน กราฟ บันทึกรายการคำขอ และโค้ดที่เพิ่งเปลี่ยนแปลง บทช่วยสอนนี้ทดสอบว่า Claude Opus 5.5 สามารถติดตามหลักฐานนั้น ทดสอบคำอธิบายภายใต้เงื่อนไขที่ควบคุมได้ และรายงานเฉพาะสิ่งที่หลักฐานรองรับได้หรือไม่
ข้อมูลพื้นฐานเล็กน้อย: Claude Opus 5.5 เปิดตัวเมื่อต้นสัปดาห์ ก่อนจะเริ่มโปรเจกต์นี้ ภาพรวม Claude Opus 5.5 ของเราครอบคลุมการเปิดตัวและผลทดสอบ ดังนั้นบทช่วยสอนนี้จะโฟกัสที่ API และสร้างเอเจนต์สืบสวนหนึ่งตัวตั้งแต่คำขอแรกไปจนถึงรายงานที่ตรวจสอบแล้ว
จะครอบคลุมวิธีการ:
ตัวสืบสวนของ HarborCart แยกการพุ่งของเกตเวย์ชำระเงินออกจากนโยบายรีไทรที่ขยายปัญหา แล้วทดสอบคำอธิบายนั้นก่อนส่งคืนรายงาน
เข้าถึง Claude Opus 5.5 ผ่าน Messages API ของ Anthropic ด้วยรหัสโมเดล claude-opus-5-5 ตามภาพรวมโมเดล โมเดลรับได้ทั้งข้อความและรูปภาพ มีหน้าต่างบริบท 1M โทเค็น และเอาต์พุตสูงสุด 128K เปิดโหมดคิดแบบปรับตัวเสมอ โดยค่าเริ่มต้น effort เป็น medium.
ราคา มาตรฐาน คือ $4 ต่อหนึ่งล้านโทเค็นอินพุต และ $20 ต่อหนึ่งล้านโทเค็นเอาต์พุต การเขียนแคชห้านาทีคิด $5 ต่อล้าน และการอ่านแคช $0.20 เมื่อ การแคชพรอมป์ต์ทำงานอยู่ คำนำที่ตรงกันจะถูกคิดในอัตราอ่านแคชที่ต่ำกว่า
สี่ประเด็นจาก คู่มือย้ายรุ่น ปรากฏให้เห็นโดยตรงในโปรเจกต์นี้
การบังคับ tool_choice ด้วย any หรือชื่อเครื่องมือ จะทำให้ได้ข้อผิดพลาด 400
ค่าเริ่มต้น effort ลดจาก high ใน Claude Opus 5 เหลือ medium.
ไม่สามารถปิดโหมดคิดได้ และบล็อก thinking ต้องถูกส่งกลับโดยไม่เปลี่ยนแปลงภายในลูปเครื่องมือ
บันทึกที่โมเดลเขียนระหว่างการเรียกเครื่องมือจะอยู่ในบล็อก thinking ซึ่งค่าเริ่มต้นว่าง
เอเจนต์ทำหน้าที่สืบสวนเท่านั้น ได้รับเครื่องมืออ่านอย่างเดียวและไม่มีข้อมูลประจำตัวของระบบโปรดักชัน หลังเก็บหลักฐาน จะมีคำขอวางแผนแยกต่างหากเพื่อเสนอการทดสอบแบบโต้แย้งข้อเท็จจริง และ Python จะตรวจสอบและรันแผนระดับ medium
โค้ดทั้งหมด รวมถึงตัวสร้างหลักฐานและเว็บแอป อยู่ใน ที่เก็บ GitHub นี้.
HarborCart เป็นร้านค่าสมมติ บริการ checkout-api ให้หน้าตะกร้า สถานะคำสั่งซื้อ และ POST /checkout ซึ่งตัดบัตรผ่านเกตเวย์ชำระเงินภายนอก เอ็นด์พอยน์ต์ทั้งหมดใช้พูลการเชื่อมต่อ PostgreSQL ร่วมกัน 15 การเชื่อมต่อ ต่ออินสแตนซ์
มีการดีพลอย และห้านาทีต่อมาเกตเวย์ตอบ 503 เป็นเวลาราว 90 วินาที ความหน่วงเช็คเอาต์พุ่งเกิน 30 วินาทีขณะที่พูลเต็มที่ 15 จาก 15 การโทษผู้ให้บริการชำระเงินเป็นคำตอบง่าย และเกตเวย์ก็ล้มเหลวจริง
สาเหตุที่ซ่อนอยู่ลึกเข้าไปอีกขั้น ดีพลอยให้นโยบายที่ทำให้การคิดเงินด้วย POST ที่ล้มเหลวถูกรีไทรได้สูงสุดสามครั้ง รวมเป็นสี่ครั้ง โดยไม่มีการพัก ขณะที่ตัวจัดการยังยึดการเชื่อมต่อฐานข้อมูลไว้ การคิดเงินที่ล้มเหลวช้าจึงยึดการเชื่อมต่อไว้นาน 30 วินาทีขึ้นไป จนพูลหมดและหน้าตะกร้าที่ไม่เคยเรียกเกตเวย์ก็ล้มเหลวด้วย
จะใช้สามคำอย่างสม่ำเสมอตั้งแต่ตรงนี้ โดย ตัวกระตุ้น คือความล้มเหลวของเกตเวย์ชั่วคราว การรีไทรคำขอ POST ชำระเงินขณะยึดการเชื่อมต่อฐานข้อมูลที่มีจำกัดคือ กลไกขยายปัญหา; การที่พูลการเชื่อมต่อร่วมกันหมดลงคือ ความล้มเหลวของระบบ.
เอเจนต์เริ่มจากการแจ้งเตือน สกรีนช็อตมอนิเตอร์ และแผนผังสถาปัตยกรรม ส่วนอื่น ๆ มาจากเครื่องมือ: ล็อก เทรซ เมตริกห้ารายการ ข้อมูลเมทาของการดีพลอย diff ของ Git และรันบุ๊ก ฝังคำอธิบายที่แข่งกันสามทางลงในหลักฐาน: คำเตือนสต๊อก คำเตือนฝั่งหน้าบ้าน และความเป็นไปได้ที่ CPU อิ่มตัว
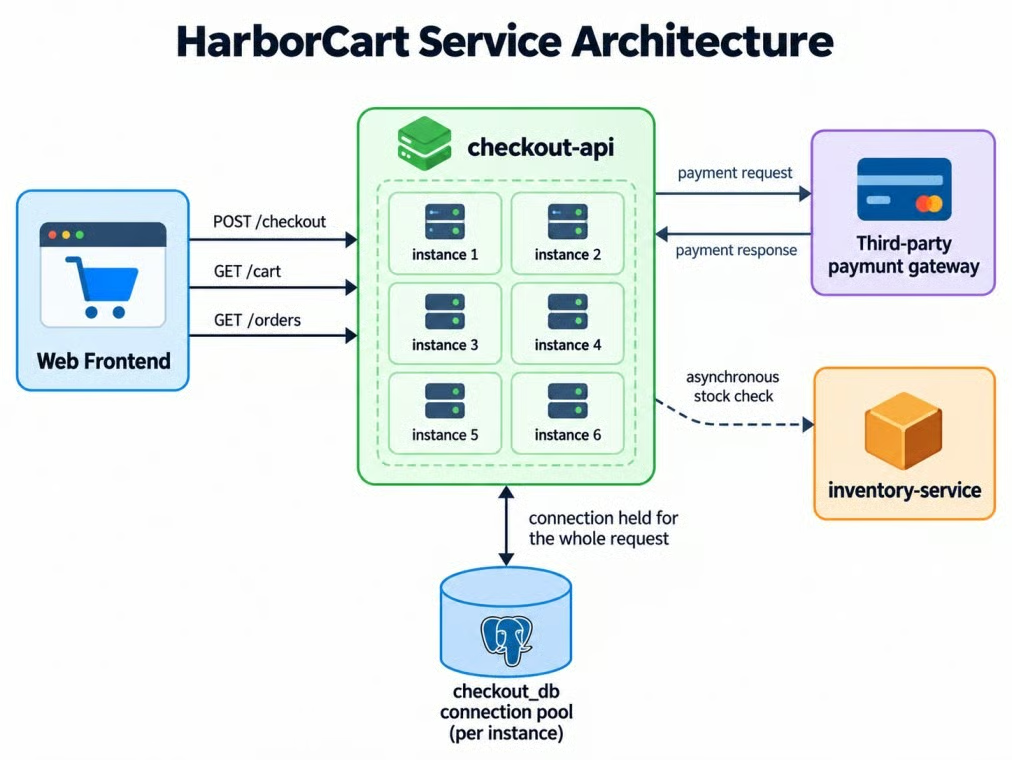
เส้นทางเช็คเอาต์ของ HarborCart และพูลที่แชร์ ภาพโดยผู้เขียน
แผนภาพระบุว่าการเชื่อมต่อถูกยึดไว้ตลอดคำขอ แต่ไม่ได้บอกว่านั่นเป็นปัญหา การสืบสวนต้องหาคำตอบเอง
กำหนดความสำเร็จก่อนสร้างเอเจนต์ รายงานที่ถูกต้องต้อง:
POST ถูกรีไทรได้ต้องใช้ Python 3.10 ขึ้นไป และคีย์ Anthropic API ที่เข้าถึง claude-opus-5-5 ได้ คำสั่ง PowerShell ต่อไปนี้โคลนโปรเจกต์และติดตั้งไลบรารีที่ปักหมุดไว้ รวมถึง anthropic 1.8.0 หากใช้ Amazon Bedrock โปรดอ่านคำถามที่พบบ่อยก่อน เพราะมีหลายฟีเจอร์ที่พอร์ตไม่ได้
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
บน macOS หรือ Linux ให้เปิดใช้งานด้วย source .venv/bin/activate และคัดลอกด้วย cp .env.example .env ใส่คีย์ลงใน .env และ python-dotenv จะโหลดให้กับ SDK ดู คู่มือ environment variables ของเรา อธิบายแพตเทิร์นนี้ หากเคยเรียก Claude จาก Python มาก่อน ข้ามหัวข้อถัดไปได้ เพราะมีแค่การยืนยันการตั้งค่า
คำขอที่เล็กที่สุดที่มีประโยชน์คือยืนยันคีย์และดูว่ามีอะไรกลับมา
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
ในคำขอนี้ การตอบกลับประกอบด้วยบล็อก thinking และ text เลือกบล็อกตามชนิดแทนการอ่าน response.content[0].
เอเจนต์ที่เรียกใช้เครื่องมือจะจับคู่ Messages API ของ Claude กับฟังก์ชัน Python ที่ควบคุมการเข้าถึงข้อมูล แอปพลิเคชันยึดกฎเดียว: Claude ตัดสินใจว่าต้องการหลักฐานอะไร และ Python ตัดสินใจว่าอนุญาตให้เข้าถึงอะไรได้บ้าง
ดู คู่มือการออกแบบโครงครอบเอเจนต์ ของเราสำหรับขอบเขตเครื่องมือและลูปที่กว้างกว่า HarborCart คงเครื่องมือแบบอ่านอย่างเดียวและจำกัดไว้แค่เหตุการณ์นี้
ทุกเครื่องมืออ่านชุดหลักฐานที่กำหนดตายตัวและส่งคืนผลลัพธ์ JSON ที่จำกัด การคิวรีล็อกและเทรซส่งคืนได้สูงสุด 200 แถวพร้อมจำนวน และคิวรีเมตริกส่งคืนได้สูงสุด 60 จุด
การเรียกใช้เครื่องมือแบบโปรแกรมยังไม่รองรับ strict: true ให้แยกเครื่องมือออกเป็นสองส่วน เก็บเครื่องมือควบคุมหลักฐานและเครื่องมือหยุดการสืบสวนให้เคร่งครัดและเรียกได้โดยตรงเท่านั้น ส่วนล็อก เทรซ และเมตริกใช้เฉพาะการรันโค้ด ซึ่งให้ทางเดียวที่ชัดเจนแก่ Claude สำหรับคิวรีหลักฐานขนาดใหญ่
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers เป็นตัวชี้นำโมเดลแต่ไม่ใช่ขอบเขตความปลอดภัย Python จะตรวจสอบผู้เรียกก่อนรันแต่ละเครื่องมือและปฏิเสธการเรียกคิวรีโดยตรง การเรียกแบบโปรแกรมยังข้ามการตรวจสคีมาที่เคร่งครัดด้วย ดังนั้นฟังก์ชันคิวรีจึงยังต้องตรวจสอบอาร์กิวเมนต์เอง
แอปพลิเคชันติดแท็กผลลัพธ์เครื่องมือทุกชิ้นที่ยอมรับ ปฏิเสธข้อค้นพบที่อ้างหลักฐานที่ไม่มีอยู่ และยอมรับ URL เอกสารเฉพาะเมื่อการค้นเว็บส่งคืนมา Python ไม่ใช่โมเดล เป็นผู้บันทึกผลลัพธ์การรีเพลย์
ตามที่ระบุไว้ในส่วนการย้ายรุ่น ให้คง tool_choice เป็น auto ระบุในพรอมป์ต์ว่าเมื่อใดที่เครื่องมือเหมาะสม และใช้สคีมาที่เคร่งครัดเมื่ออาร์กิวเมนต์ต้องถูกต้องเป๊ะ
ลูปจะส่งบทสนทนา รันบล็อก tool_use ใด ๆ ต่อท้ายผลลัพธ์ แล้วทำซ้ำ ต่อท้ายบล็อกของผู้ช่วยโดยไม่เปลี่ยนแปลง รวมถึง thinking และขณะพักการรันโค้ดแบบโปรแกรม ให้ส่งคืนรหัส container พร้อมเฉพาะบล็อก tool_result เท่านั้น
คำขอสืบสวนรวมวิสัยทัศน์ เครื่องมือ การค้นเว็บ effort และงบงาน แต่ไม่มีสคีมาเอาต์พุต วิธีนี้กันผลการค้นที่มีการอ้างอิงไม่ให้ปะปนในเอาต์พุต JSON แบบมีโครงสร้าง ขณะที่คำนำคำขอที่คงที่ช่วยให้การแคชพรอมป์ต์ทำงานต่อเนื่อง:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)แนบแดชบอร์ดและแผนผังสถาปัตยกรรมกับข้อความของผู้ใช้แรกในรูปแบบ base64 PNG บอก Claude ให้ถือว่าสิ่งที่อ่านจากรูปเป็นสมมติฐานและยืนยันด้วย query_metrics.
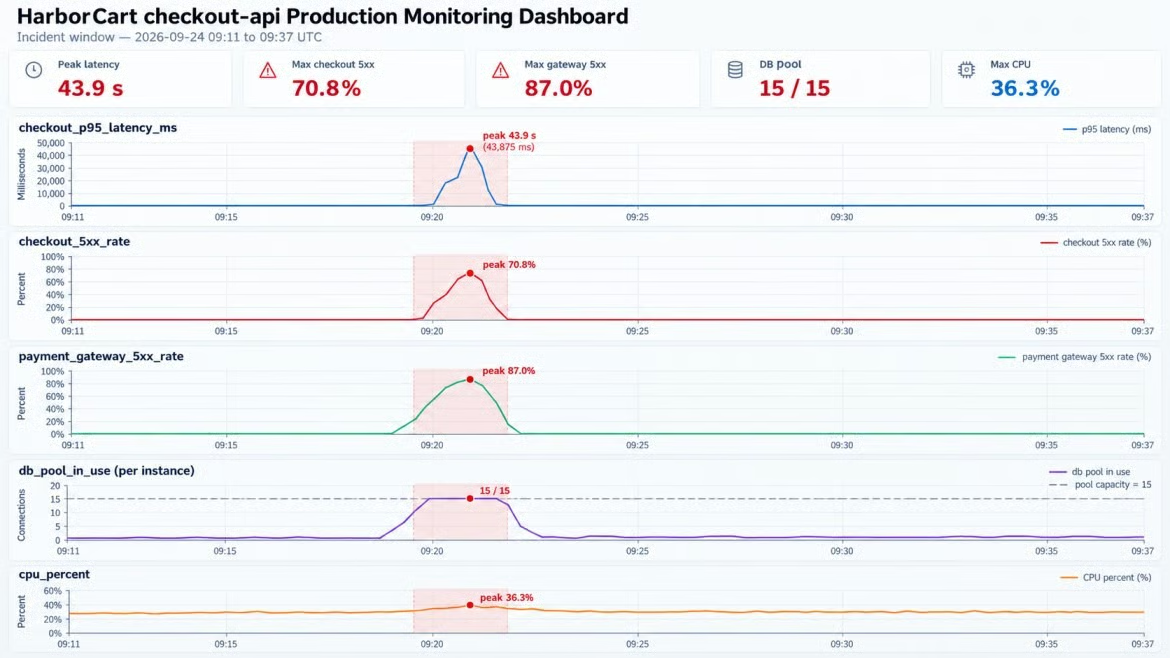
แดชบอร์ดแสดงพูลอิ่มตัว CPU คงที่ ภาพโดยผู้เขียน
ทั้งแดชบอร์ดและคิวรีเมตริกใช้แหล่งข้อมูลเดียวกัน CPU อยู่ราว 30% ขณะพูลเต็ม ซึ่งโต้แย้งประเด็น "โฮสต์โหลดเกิน" ก่อนจะมีการคิวรีใด ๆ
สกรีนช็อตช่วยชี้ทิศว่าจะดูตรงไหน แต่ซีรีส์ตัวเลขเป็นตัวตัดสินว่า observation นั้นยืนอยู่ได้หรือไม่ วิสัยทัศน์สร้างสมมติฐาน เมตริกทดสอบมัน
สำหรับเวิร์กโฟลว์ที่เริ่มจากภาพ ดู บทช่วยสอน agentic vision HarborCart ใช้วิสัยทัศน์เพื่อเลือกเมตริกถัดไปเท่านั้น
การเรียกใช้เครื่องมือแบบโปรแกรมให้ Claude เขียน Python ที่รันในคอนเทนเนอร์รันโค้ดและเรียกเครื่องมือของคุณเป็นฟังก์ชัน ผลลัพธ์ดิบอยู่ในแซนด์บ็อกซ์ และเฉพาะเอาต์พุตที่พิมพ์ของโค้ดเท่านั้นที่ถึงโมเดล
เอเจนต์เขียนสคริปต์สั้น ๆ เพื่อดึงเทรซที่ล้มเหลวและพิมพ์เฉพาะจำนวนตามเอ็นด์พอยน์ต์ ในหนึ่งการสืบสวนเต็มรูปแบบ การเรียกใช้เครื่องมือแบบโปรแกรมลดหลักฐานแบบซีเรียลไลซ์ที่ส่งคืนสู่โมเดลลง 98.8% ผลลัพธ์เครื่องมือ 42.9 KB เหลือสรุป 0.5 KB เป็นการวัดไบต์ ไม่ใช่โทเค็นอินพุตที่คิดเงิน
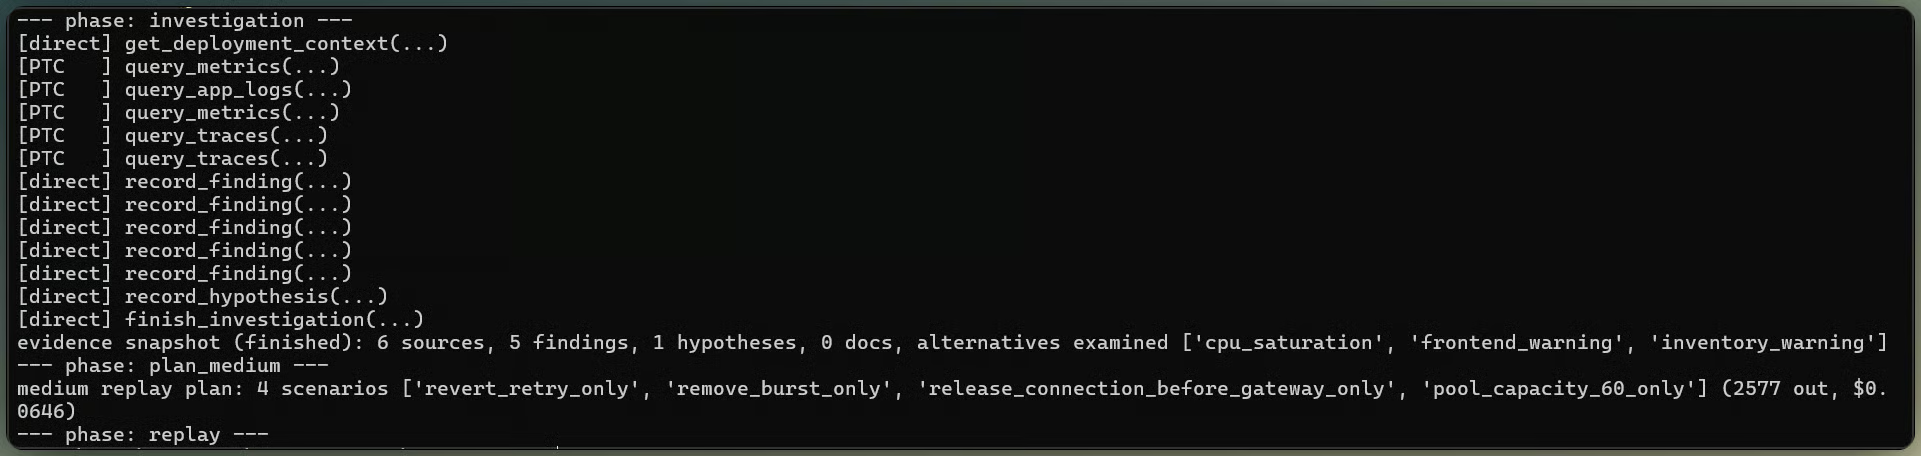
การเรียกเครื่องมือช่วยจำกัดหลักฐานของเหตุการณ์ ภาพโดยผู้เขียน
แอปพลิเคชันเปิดให้ค้นเว็บแบบจำกัดเพื่อดู semantics ของไลบรารีรีไทร Claude ไม่ได้เรียกใช้ระหว่างการประเมินขั้นสุดท้าย ดังนั้นการวินิจฉัยที่วัดผลจึงยืนอยู่บน diff เมตริก ล็อก และเทรซ อ้างอิง urllib3 ยืนยันอิสระว่า allowed_methods=None รีไทรได้ทุกเวิร์บ และ backoff_factor=0 ตัดเวลารอออก แต่หน้านั้นไม่ใช่ส่วนหนึ่งของหลักฐานที่วัดผล
การรีเพลย์แบบโต้แย้งข้อเท็จจริงคือการรันทราฟฟิกช่วงเกิดเหตุซ้ำ โดยตัดสาเหตุที่สงสัยออกหนึ่งอย่าง แล้วตรวจว่าความล้มเหลวหายไปหรือไม่ เปลี่ยนจาก "เส้นเหล่านี้ขึ้นพร้อมกัน" ให้กลายเป็นการทดสอบ
รีเพลย์ใช้รูปแบบทราฟฟิกเดียวกัน สำหรับการเปรียบเทียบด้านล่าง แต่ละสถานการณ์เปลี่ยนเงื่อนไขเพียงหนึ่งอย่าง และแอปควบคุมว่าอนุญาตให้เปลี่ยนอะไรได้บ้าง
สรุปแยก 503 จากเกตเวย์ออกจาก timeout ของพูล และแยก 503 ของเช็คเอาต์ออกจากการอ่านหน้าตะกร้าและคำสั่งซื้อ การแยกนี้ทำให้โมเดลแยกตัวกระตุ้นออกจากตัวขยายได้
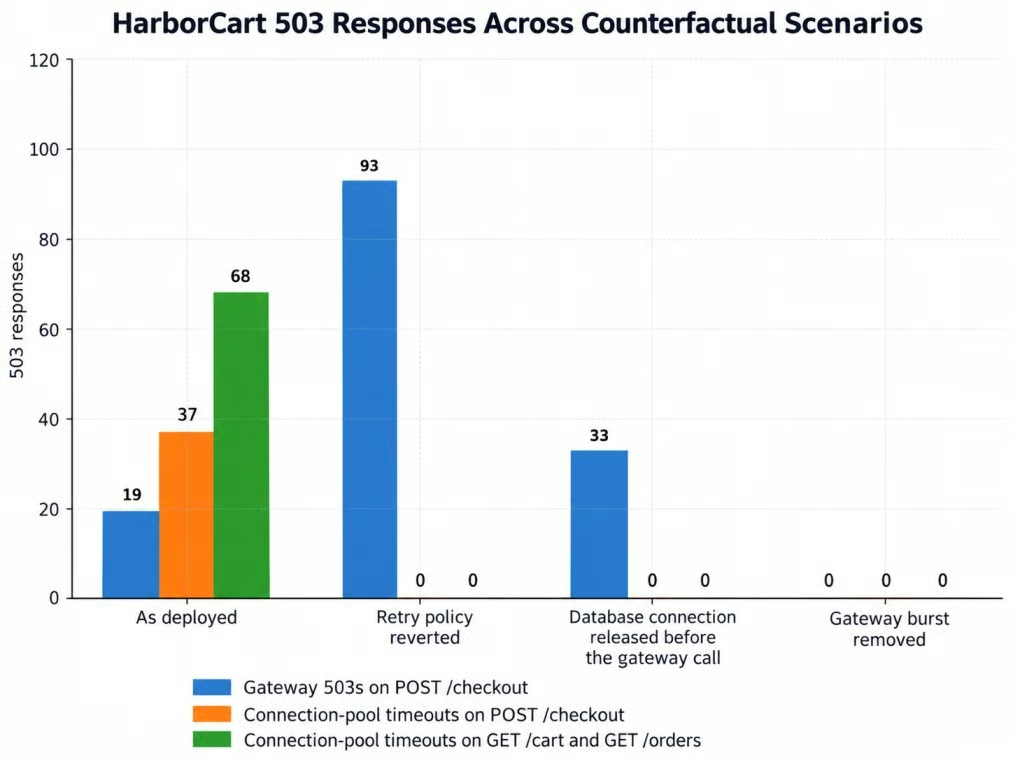
แต่ละรีเพลย์เปลี่ยนแค่เรื่องเดียว ภาพโดยผู้เขียน
รีเพลย์ฐานให้ 503 จำนวน 124 ครั้ง: timeout พูล 105 ครั้ง รวม 68 ความล้มเหลวบนเอ็นด์พอยน์ต์แบบอ่าน และข้อผิดพลาดเกตเวย์ 19 ครั้ง การย้อนนโยบายรีไทรลบ timeout พูลและความล้มเหลวการอ่านทั้งหมด แต่ทำให้เกิด 503 จากเกตเวย์ 93 ครั้งที่เช็คเอาต์ การปล่อยการเชื่อมต่อก่อนเรียกเกตเวย์ก็ลบความล้มเหลวของพูลเช่นกัน โดยเหลือ 503 จากเกตเวย์ 33 ครั้ง และการตัดการพุ่งของเกตเวย์ออกทำให้ไม่มีข้อผิดพลาด
รีเพลย์เผยให้เห็นข้อแลกเปลี่ยน: การย้อนกลับช่วยปกป้องพูลที่แชร์ แต่ปล่อยให้ความล้มเหลวของเช็คเอาต์ผ่านมากขึ้น ใช้เป็นมาตรการชั่วคราว จากนั้นเพิ่ม idempotency key เพื่อป้องกันการคิดเงินซ้ำซ้อน และหยุดการยึดการเชื่อมต่อระหว่างเรียกเกตเวย์
พรอมป์ต์ของระบบร้องขอการรีเพลย์ แต่พรอมป์ต์ไม่ใช่กลไกบังคับใช้ ลูปจะตรวจว่ามีหลักฐานการรีเพลย์หรือไม่ และปฏิเสธการวินิจฉัยที่ไม่ได้ทดสอบ
เก็บการตรวจนี้ไว้ใน Python การทำพรอมป์ต์ให้คมขึ้นอาจช่วยให้ทำตามได้ดีขึ้น แต่ไม่รับประกัน
Effort กำหนดว่ามีการไตร่ตรองต่อขั้นตอนมากเพียงใด และ งบงาน กำหนดว่างานทั้งลูปควรใช้ทรัพยากรเท่าไร บทช่วยสอน Claude Opus 5 API ของเราเปรียบเทียบระดับ effort ทั้งห้า ที่นี่ medium และ high ได้รับหลักฐานก่อนรีเพลย์ชุดเดียวกัน
โปรดักชันคงไว้ที่ medium ก่อนรีเพลย์ แอปถามทั้ง medium และ high ให้ออกแบบการทดสอบเชิงสาเหตุจากหลักฐานเดียวกัน และจะรันเฉพาะคำแนะนำของ medium ส่วนคำตอบ high ใช้เพื่อเปรียบเทียบเท่านั้น
คำขอ high ใช้การเปลี่ยน output_config.effort ต่อข้อความ ภายใต้ mid-conversation-output-config-2026-07-01 ซึ่งไม่เห็นคำตอบ medium
ทั้งสองระดับเลือกสมมติฐานเดียวกันและสามสถานการณ์รีเพลย์แกนเดียวกัน ระดับ high ใช้โทเค็นเอาต์พุตเฉลี่ย 2,631 เทียบกับ 2,307 ใน medium และมีค่าใช้จ่ายสูงกว่าราว 11% โดยไม่ได้เปลี่ยนการทดสอบเชิงสาเหตุ
เลือกงบงานจากการใช้งานที่สังเกตจริงแทนการเดา การสืบสวนที่ใหญ่ที่สุดของ HarborCart โดยไม่จำกัดใช้ไป 13,322 โทเค็นที่นับได้ รวมเอาต์พุตของโมเดลและข้อความผลลัพธ์เครื่องมือที่ Claude เห็น เพิ่มสำรอง 25% เป็น 16,653 ต่ำกว่าขั้นต่ำ 20,000 ของ Anthropic จึงตั้งงบไว้ที่ 20,000
คุมจำนวนเทิร์นและเวลาเป็นขีดจำกัดของแอป ตัวรันทดลองหยุดเริ่มงานใหม่เมื่อการใช้จ่ายที่บันทึกถึง $2.50 นี่ไม่ใช่เพดานแข็ง เพราะคำขอที่กำลังประมวลผลอาจจบสูงกว่านั้น
คำตอบสุดท้ายใช้งานเอาต์พุตแบบมีโครงสร้าง สคีมาแบบแบนครอบคลุมคำตัดสิน สาเหตุ สมมติฐานที่ปัดตก หลักฐาน และแนวทางแก้ ไม่รวมต้นทุนและความหน่วงเพราะแอปเป็นผู้วัด
การอ้างอิงจากการค้นเว็บและ output_config.format ไม่สามารถอยู่ในคำขอเดียวกันได้: การอ้างอิงต้องใช้บล็อกเนื้อหาสลับคั่น ขณะที่สคีมาต้องการ JSON ดังนั้น HarborCart จึงสืบสวนโดยไม่มีสคีมาเอาต์พุต เก็บข้อค้นพบผูกกับแหล่งที่มาและผลรีเพลย์ แล้วส่งเฉพาะหลักฐานที่ตรวจสอบแล้วไปยังคำขอที่สองที่ไม่มีเครื่องมือหรือการค้นเว็บ
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
คำขอที่สองต้องการเพียงหลักฐานที่ตรวจสอบแล้ว จึงไม่จำเป็นต้องรักษาแคชการสืบสวนเต็มไว้
อนุญาตให้มี "inconclusive" ในฟิลด์ verdict รายงานไม่ควรถูกบังคับให้วินิจฉัยแบบตรวจสอบได้เมื่อการรีเพลย์ขัดแย้งกับคำอธิบาย
สคีมาตรวจความถูกต้องของรูปแบบรายงาน ขณะที่การรีเพลย์ตรวจความถูกต้องของการวินิจฉัย กรณีปฏิเสธก็ยังส่ง HTTP 200 พร้อม stop_reason: "refusal" และอาจไม่ตรงกับสคีมาของคุณ จึงควรตรวจ stop reason ก่อนพาร์ส
รายงานสุดท้ายทั้งสามฉบับพบกลไกเชิงสาเหตุแกนกลางและปัดตกคำอธิบายทางเลือกทั้งสาม สองฉบับผ่านครบทั้งแปดข้อ; ฉบับที่สามได้ 6/8 เพราะละการระบุการเปลี่ยนคอนฟิก POST-retry ชัด ๆ และไม่อ้างอิง deployment diff นี่คือเหตุผลที่การให้คะแนนออฟไลน์ควรแยกจากการตรวจสคีมา: JSON ที่ถูกต้องและการวินิจฉัยที่ใช่ยังอาจให้รายงานที่ไม่ครบถ้วนได้
รายงานยังระบุความเสี่ยงที่สอง: การรีไทรการคิดเงินอาจเก็บเงินลูกค้าซ้ำ RFC 9110 ไม่ได้กำหนดให้ POST เป็น idempotent โดยกำเนิด และแนะนำให้หลีกเลี่ยงการรีไทรอัตโนมัติ เว้นแต่ไคลเอนต์จะรู้ว่าปลอดภัยที่จะทำซ้ำ การใช้ idempotency key ที่ผู้ให้บริการชำระเงินรองรับเป็นวิธีทั่วไปที่ทำให้การรีไทรเหล่านั้นปลอดภัยขึ้น
ดู บทช่วยสอน Streamlit ของเราสำหรับการตั้งค่าอินเทอร์เฟซ อินเทอร์เฟซของ HarborCart แสดงเหตุการณ์การสืบสวน แผนรีเพลย์ของ medium และ high ผลรีเพลย์ รายงานสุดท้าย และต้นทุน สำหรับสถานะระหว่างเรียกเครื่องมือ ดู คู่มือการพรอมป์ต์ Claude Opus 5.5 อธิบาย display: "updates"; แอปยังเรนเดอร์เหตุการณ์เครื่องมือเมื่อบล็อกอัปเดตว่าง
เรียนรู้กับ DataCamp
Courses
Courses
Courses