course
Claude 101
2 godz.
21.4K
W tym samouczku przetestuję scenariusz: Kilka minut po aktualizacji oprogramowania HarborCart — sklep, którego użyję w tym scenariuszu — zaczyna odnotowywać błędy podczas finalizacji zakupów. Część klientów czeka ponad 30 sekund, inni widzą błąd serwera i nie mogą zapłacić. Dostawca płatności ma też krótką awarię, więc wygląda to na oczywistą przyczynę.
Ale awaria dostawcy nie tłumaczy, czemu padają także strony koszyka i zamówienia. Aby znaleźć brakujące ogniwo, potrzebne są logi aplikacji, wykresy, rejestry żądań oraz ostatnia zmiana w kodzie. Ten samouczek sprawdza, czy Claude Opus 5.5 potrafi prześledzić ten materiał dowodowy, przetestować swoje wyjaśnienie w kontrolowanych warunkach i raportować wyłącznie to, co potwierdzają dowody.
Trochę tła: Claude Opus 5.5 pojawił się wcześniej w tym tygodniu, tuż przed startem tego projektu. Nasz przegląd Claude Opus 5.5 obejmuje premierę i benchmarki, więc ten samouczek skupia się na API i buduje jednego agenta śledczego: od pierwszego żądania po zweryfikowany raport.
Omówimy, jak:
Badacz HarborCart oddzielił burst w bramce płatności od polityki ponowień, która go spotęgowała, a następnie przetestował to wyjaśnienie, zanim zwrócił raport.
Do Claude Opus 5.5 uzyskujesz dostęp przez Messages API Anthropic z identyfikatorem modelu claude-opus-5-5. Zgodnie z omówieniem modelu przyjmuje tekst i obrazy, ma okno kontekstu 1M tokenów i maksymalny output 128K. Adaptacyjne myślenie jest zawsze włączone, a domyślny effort to medium.
Standardowe cenniki to $4 za milion tokenów wejściowych i $20 za milion wyjściowych. Zapisy do cache na 5 minut kosztują $5 za milion, a odczyty z cache $0,20. Gdy cacheowanie promptów jest aktywne, pasujące prefiksy są rozliczane według niższej stawki odczytu z cache.
Cztery punkty z przewodnika migracji mają bezpośredni wpływ na ten projekt.
Wymuszone tool_choice z any lub nazwanym narzędziem zwraca błąd 400.
Domyślny effort spadł z high w Claude Opus 5 do medium.
Myślenia nie da się wyłączyć, a bloki thinking muszą wracać niezmienione wewnątrz pętli narzędzi.
Notatki, które model zapisuje między wywołaniami narzędzi, trafiają do bloków thinking, które domyślnie są puste.
Agent tylko prowadzi dochodzenie. Dostaje narzędzia tylko do odczytu i żadnych poświadczeń produkcyjnych. Po zebraniu dowodów osobne żądania planistyczne proponują testy kontrfaktyczne, a Python weryfikuje i uruchamia plan o effort „medium”.
Pełny kod, generator dowodów i aplikacja webowa są w tym repozytorium na GitHubie.
HarborCart to fikcyjny sklep. Jego checkout-api obsługuje strony koszyka, status zamówienia oraz POST /checkout, który obciąża zewnętrzną bramkę płatności. Wszystkie te endpointy współdzielą jeden pulę połączeń PostgreSQL: 15 połączeń na instancję.
Wychodzi deploy i pięć minut później bramka zwraca 503 przez ok. 90 sekund. Latencja checkoutu przekracza 30 sekund, podczas gdy pula siedzi na 15 z 15. Obwinienie dostawcy płatności to oczywisty strzał, a bramka faktycznie padła.
Ukryta przyczyna jest o krok dalej. Deploy dopuścił, by nieudane obciążenia POST były ponawiane do trzech razy, czyli łącznie cztery próby, bez pauzy, podczas gdy handler wciąż trzyma swoje połączenie z bazą. Wolne, nieudane obciążenia teraz blokują połączenia przez 30 sekund lub dłużej, aż pula się wyczerpie i padną też strony koszyka, które w ogóle nie wywołują bramki.
Od tego miejsca używam trzech terminów konsekwentnie. Tutaj wyzwalacz to tymczasowa awaria bramki. Ponawianie żądań POST checkoutu podczas trzymania rzadkich połączeń z bazą to mechanizm amplifikacji; wyczerpanie współdzielonej puli połączeń to awaria systemu.
Agent startuje z alertem, zrzutem z monitoringu i diagramem architektury. Wszystko inne przychodzi przez narzędzia: logi, trace'y, pięć metryk, metadane wdrożenia, diff Gita i runbook. Do dowodów zasiane są trzy konkurencyjne wyjaśnienia: ostrzeżenie o stanie zapasów, ostrzeżenie frontendu oraz możliwe nasycenie CPU.
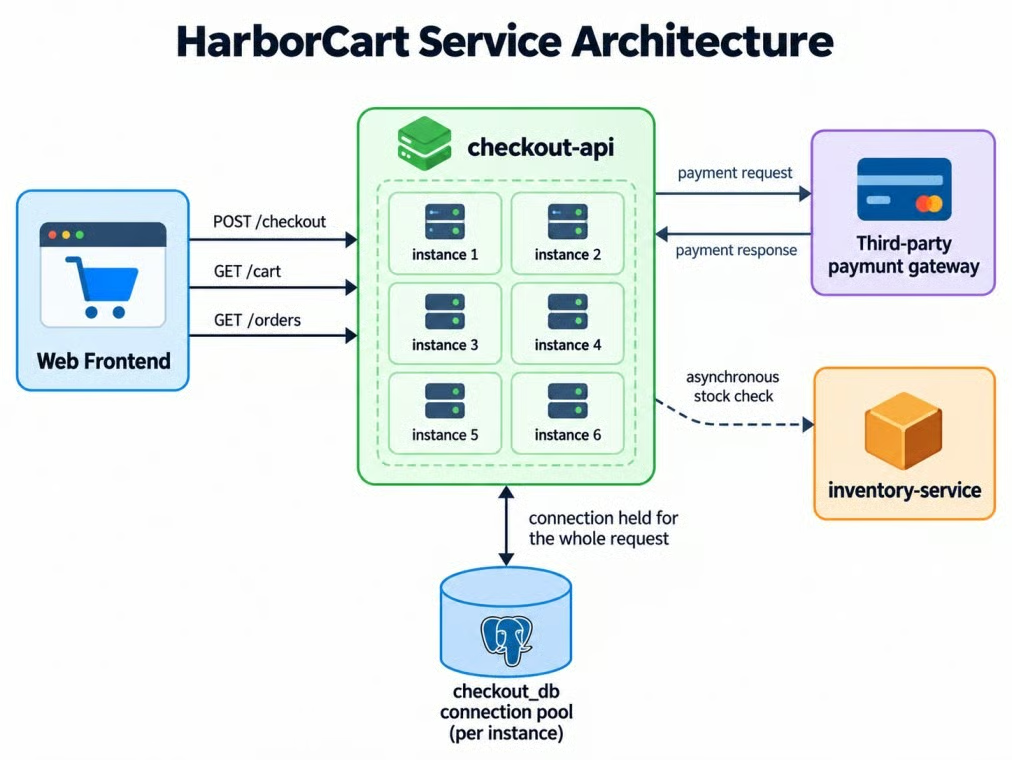
Ścieżka checkoutu HarborCart i współdzielona pula. Obraz autora.
Diagram mówi, że połączenie jest trzymane przez całe żądanie. Nie mówi, że to problem; dochodzenie musi to ustalić.
Zdefiniuj sukces przed budową agenta. Poprawny raport musi:
POST Potrzebujesz Pythona 3.10 lub nowszego oraz klucza API Anthropic z dostępem do claude-opus-5-5. Te polecenia PowerShell klonują projekt i instalują przypięte zależności, w tym anthropic 1.8.0. Jeśli korzystasz z Amazon Bedrock, najpierw przeczytaj FAQ, bo kilka funkcji nie da się przenieść.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Na macOS lub Linux aktywuj przez source .venv/bin/activate i skopiuj przez cp .env.example .env. Dodaj swój klucz do .env, a python-dotenv załaduje go dla SDK; nasz przewodnik po zmiennych środowiskowych wyjaśnia ten wzorzec. Jeśli wcześniej wołałeś Claude'a z Pythona, pomiń następną podsekcję, bo tylko potwierdza konfigurację.
Najmniejsze użyteczne żądanie potwierdza klucz i pokazuje, co wraca.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
W tym żądaniu odpowiedź zawiera bloki thinking i text. Wybieraj bloki po typie zamiast czytać response.content[0].
Agenci wywołujący narzędzia łączą Messages API Claude'a z funkcjami Pythona, które kontrolują dostęp do danych. Aplikacja stosuje jedną zasadę: Claude decyduje, jakich dowodów potrzebuje, a Python decyduje, do czego ma dostęp.
Nasz przewodnik po inżynierii „harnessu” dla agentów obejmuje szersze granice narzędzi i pętle; HarborCart trzyma narzędzia w trybie tylko do odczytu i ogranicza je do tego incydentu.
Każde narzędzie czyta stały zestaw dowodów i zwraca ograniczony wynik JSON. Zapytania logów i trace'ów zwracają maksymalnie 200 wierszy plus licznik, a zapytania metryk maksymalnie 60 punktów.
Programowe wywoływanie nie wspiera strict: true, więc rozdziel narzędzia na dwie grupy. Kontrolę dowodów i narzędzie kończące dochodzenie trzymaj restrykcyjne i tylko direct. Logi, trace'y i metryki używają wyłącznie wykonania kodu, co daje Claude'owi jedną, jasną ścieżkę dla dużych zapytań o dowody.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers podpowiada modelowi, ale nie jest granicą bezpieczeństwa. Python sprawdza wywołującego przed uruchomieniem każdego narzędzia i odrzuca wywołanie direct dla zapytań. Programowe wywołania też omijają restrykcyjną walidację, więc funkcje zapytań nadal same walidują swoje argumenty.
Aplikacja taguje każdy przyjęty wynik narzędzia, odrzuca ustalenia cytujące brakujące dowody i akceptuje URL-e dokumentacji tylko wtedy, gdy zwróciło je wyszukiwanie w sieci. Python, a nie model, zapisuje wyniki replayów.
Jak wspomniano w sekcji migracji, zostaw tool_choice na auto. Powiedz w promcie, kiedy narzędzie ma zastosowanie, i używaj restrykcyjnych schematów tam, gdzie argumenty muszą być dokładne.
Pętla wysyła rozmowę, uruchamia bloki tool_use, dokleja wyniki i powtarza. Doklejaj bloki asystenta bez zmian, łącznie z thinking, a gdy programowy kod jest wstrzymany, przekaż z powrotem ID container wyłącznie z blokami tool_result.
Żądanie dochodzeniowe zawiera wizję, narzędzia, wyszukiwanie w sieci, effort i budżet zadania, ale bez schematu wyjścia. Dzięki temu wyniki z cytowaniami z wyszukiwania nie trafiają do ustrukturyzowanego JSON-a, a stabilny prefiks żądania utrzymuje aktywny cache promptu:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Dołącz dashboard i diagram architektury do pierwszej wiadomości użytkownika jako PNG zakodowane w base64. Powiedz Claude'owi, by traktował wszystko, co odczyta z obrazu, jako hipotezę i potwierdzał to przez query_metrics.
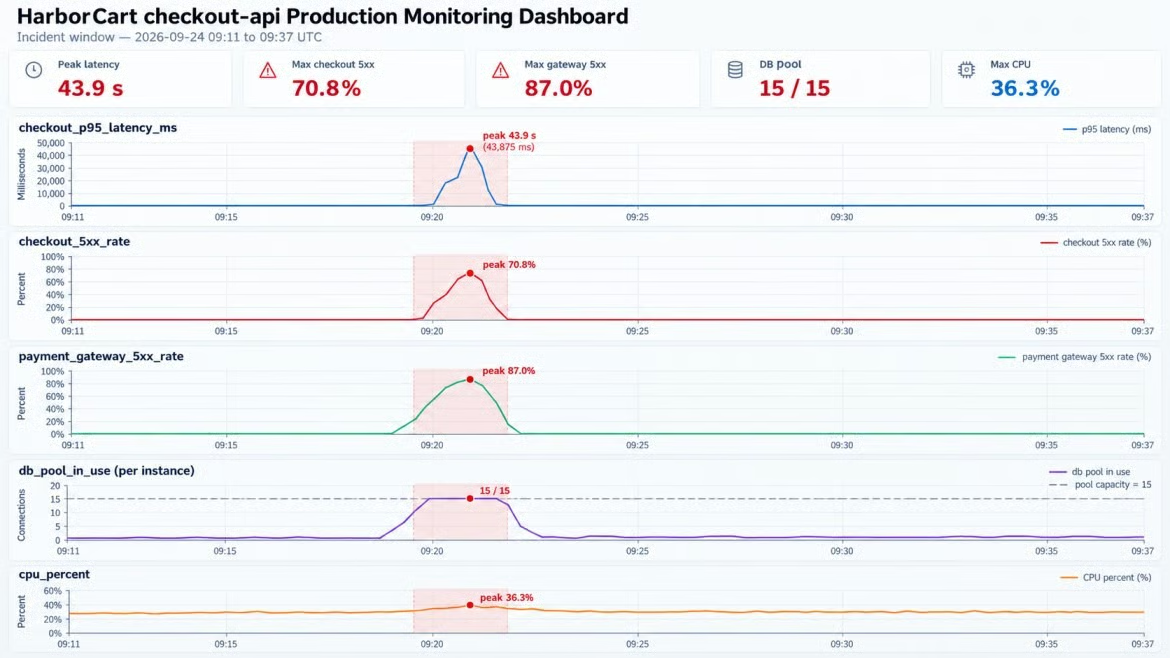
Dashboard pokazuje nasycenie puli, płaski CPU. Obraz autora.
Zarówno dashboard, jak i zapytania metryk używają tych samych danych źródłowych. CPU trzyma się blisko 30% przy pełnej puli, co przemawia przeciwko „host jest przeciążony” zanim ruszy jakiekolwiek zapytanie.
Zrzut podpowiada, gdzie patrzeć, ale o tym, czy obserwacja się broni, decyduje szereg liczbowy. Wizja generuje hipotezę; metryki ją testują.
Dla przepływów „image-first” zobacz nasz samouczek agentycznej wizji. HarborCart używa wizji tylko do wyboru następnej metryki.
Programowe wywoływanie narzędzi pozwala Claude'owi pisać Pythona uruchamianego w kontenerze wykonawczym i wywoływać twoje narzędzia jak funkcje. Surowe wyniki zostają w piaskownicy, a do modelu trafia tylko wydrukowany output kodu.
Agent pisze krótkie skrypty, które pobierają nieudane trace'y i drukują tylko liczniki per endpoint. W jednym pełnym dochodzeniu programowe wywoływanie zredukowało zserializowane dowody zwracane do modelu o 98,8%. Wyniki narzędzi miały 42,9 KB, a podsumowania 0,5 KB — to pomiar bajtów, nie oszczędność rozliczanych tokenów wejściowych.
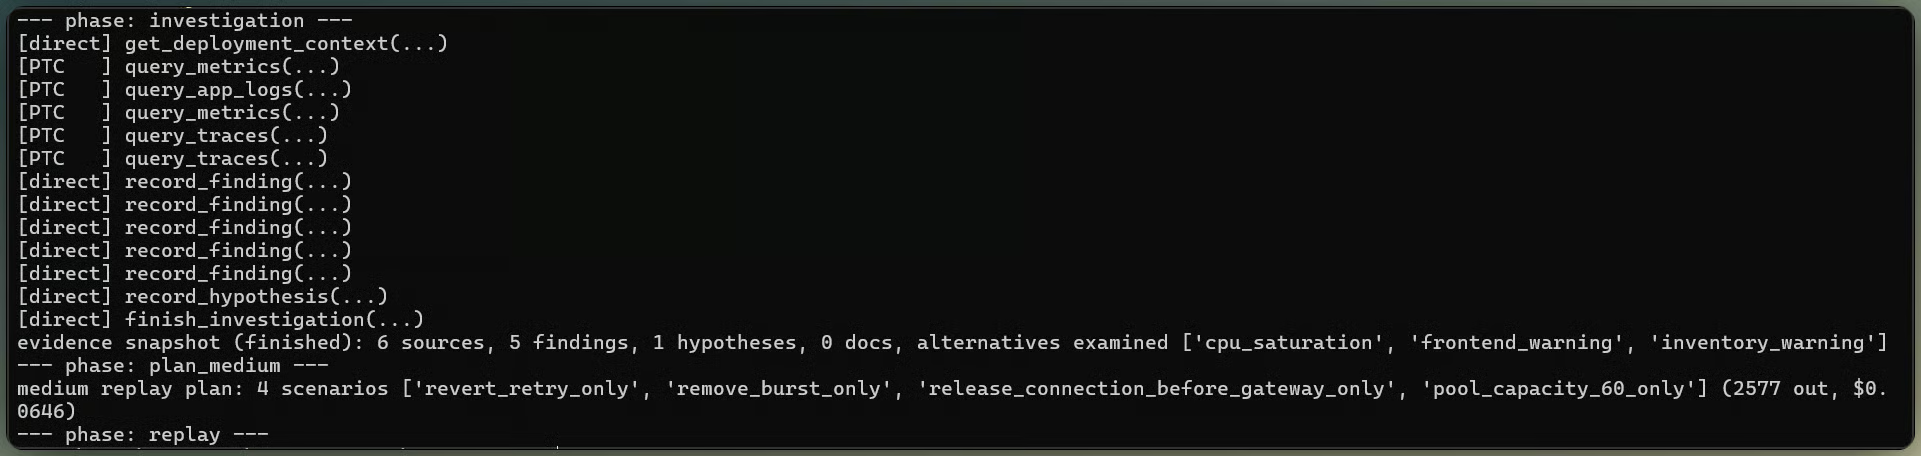
Wywołania narzędzi zawężają materiał dowodowy incydentu. Obraz autora.
Aplikacja udostępnia ograniczone wyszukiwanie w sieci dla semantyki biblioteki retry. Claude nie wywołał go podczas końcowej ewaluacji, więc zmierzona diagnoza opiera się na diffie, metrykach, logach i trace'ach. Dokumentacja urllib3 niezależnie potwierdza, że allowed_methods=None ponawia dla dowolnej metody, a backoff_factor=0 usuwa oczekiwanie, ale ta strona nie jest częścią mierzonego materiału dowodowego.
Kontrfaktyczny replay ponownie odtwarza ruch z incydentu z usuniętą jedną podejrzaną przyczyną i sprawdza, czy awaria znika. Zamienia „te linie rosną razem” w test.
Replay używa tego samego wzorca ruchu. W porównaniu poniżej każdy scenariusz zmienia jeden warunek, a aplikacja kontroluje, które zmiany są dozwolone.
Podsumowanie rozdziela 503 z bramki od timeoutów puli oraz 503 checkoutu od odczytów koszyka i zamówień. Ten podział pozwala modelowi odróżnić wyzwalacz od wzmacniacza.
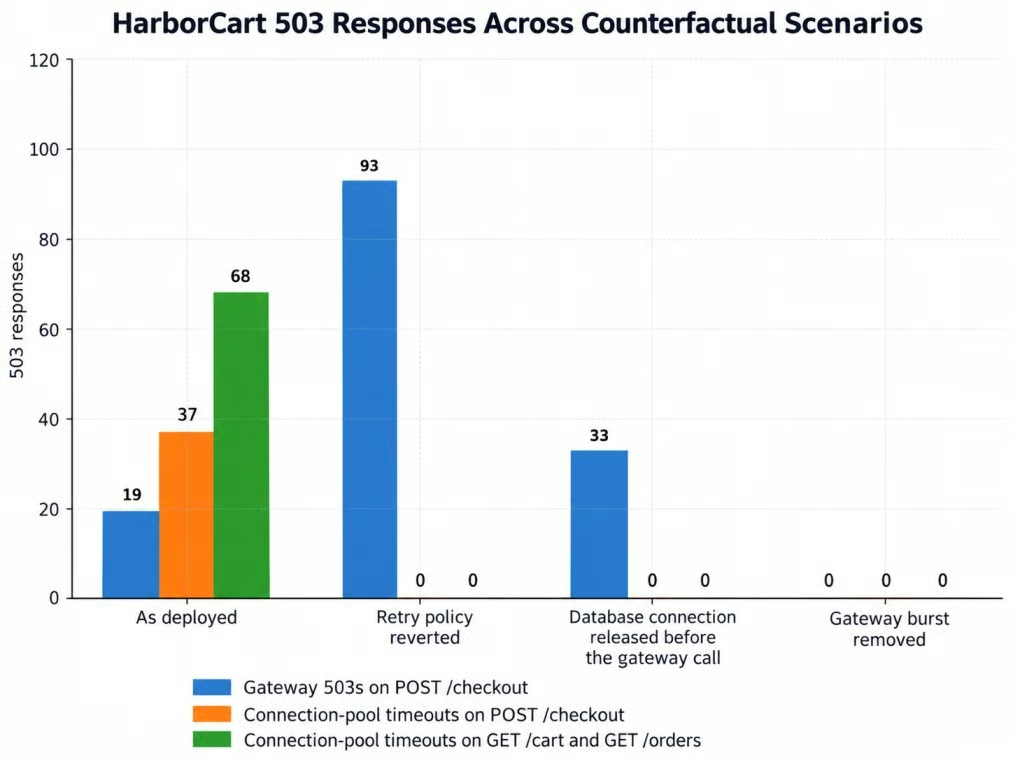
Każdy replay zmienia dokładnie jedną rzecz. Obraz autora.
Replay bazowy wygenerował 124 odpowiedzi 503: 105 timeoutów puli, w tym 68 porażek na endpointach odczytu, oraz 19 błędów bramki. Wycofanie polityki ponowień usunęło wszystkie timeouty puli i porażki odczytu, ale uwidoczniło 93 odpowiedzi 503 z bramki na checkout. Zwolnienie połączenia przed wywołaniem bramki także usunęło porażki puli, pozostawiając 33 odpowiedzi 503 z bramki, a usunięcie burstu bramki wyeliminowało błędy.
Replay ujawnia kompromis: rollback chroni współdzieloną pulę, ale przepuszcza więcej porażek checkoutu. Użyj go jako rozwiązania tymczasowego. Następnie dodaj klucz idempotencyjny, by powtórne obciążenie nie naliczyło podwójnie, i przestań trzymać połączenie podczas wywołania bramki.
System prompt prosi o replay, ale prompt nie jest mechanizmem egzekwowania. Pętla sprawdza, czy istnieją dowody z replayu i odrzuca nieweryfikowaną diagnozę.
Trzymaj tę kontrolę w Pythonie. Ostrzejszy prompt może poprawić zgodność, ale jej nie zagwarantuje.
Effort określa, ile Claude rozumuje na krok, a budżet zadania określa, ile pracy powinna zająć cała pętla. Nasz samouczek API Claude Opus 5 porównuje wszystkie pięć poziomów effort; tutaj medium i high dostają te same dowody przed replayem.
Produkcja zostaje na medium. Przed replayem aplikacja prosi poziomy medium i high, by zaprojektowały test przyczynowy z tych samych dowodów. Wykonuje tylko rekomendację medium; odpowiedź high służy wyłącznie do porównania.
Żądanie high używa zmiany output_config.effort per wiadomość pod mid-conversation-output-config-2026-07-01. Nie widzi odpowiedzi medium.
Oba poziomy wybrały tę samą hipotezę i te same trzy rdzeniowe scenariusze replayu. High zużył średnio 2631 tokenów wyjściowych wobec 2307 przy medium, i kosztował ~11% więcej, nie zmieniając testu przyczynowego.
Wybieraj budżet zadania z obserwacji, a nie z zgadywania. Największe, nieograniczone dochodzenie HarborCart zużyło 13 322 zliczone tokeny, wliczając output modelu i tekst wyników narzędzi, który widział Claude. Dodanie 25% marginesu daje 16 653, poniżej minimalnych 20 000 Anthropic, więc skonfigurowany budżet to 20 000.
Trzymaj liczbę tur i czas trwania jako ograniczenia aplikacji. Runner eksperymentu przestawał rozpoczynać nowe prace po osiągnięciu rejestrowanego wydatku $2,50. To nie jest twardy limit, bo żądanie już w toku może skończyć powyżej.
Ostateczna odpowiedź używa ustrukturyzowanych wyników. Płaski schemat obejmuje werdykt, przyczynę, odrzucone hipotezy, dowody i poprawkę. Koszt i latencja są poza nim, bo aplikacja je mierzy.
Cytowania z wyszukiwania i output_config.format nie mogą współdzielić żądania: cytowania wymagają przeplatanych bloków treści, a schema wymaga JSON-a. Dlatego HarborCart prowadzi dochodzenie bez schematu wyjścia. Przechowuje ustalenia powiązane z ich źródłami i wynikami replayu, a potem wysyła tylko te zweryfikowane dowody do drugiego żądania, bez narzędzi i wyszukiwania w sieci.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
Drugie żądanie potrzebuje tylko zweryfikowanych dowodów, więc zachowanie pełnego cache dochodzenia nie jest konieczne.
Pozwól na "inconclusive" w polu verdict. Raport nie powinien być wciskany w zweryfikowaną diagnozę, gdy replay przeczy wyjaśnieniu.
Schema weryfikuje kształt raportu, a replay weryfikuje diagnozę. Odmowa też zwraca HTTP 200 z stop_reason: "refusal" i może nie pasować do twojego schematu, więc sprawdź stop_reason przed parsowaniem.
Wszystkie trzy końcowe raporty znalazły rdzeniowy mechanizm przyczynowy i wykluczyły trzy alternatywne wyjaśnienia. Dwa spełniły wszystkie osiem kontroli; trzeci zdobył 6/8, bo pominął wyraźną zmianę konfiguracji retry dla POST i nie cytował diffu wdrożenia. Dlatego ocena offline pozostaje oddzielona od walidacji schematu: poprawny JSON i właściwa diagnoza mogą wciąż dać niekompletny raport.
Raporty wskazują też drugie ryzyko: ponawianie obciążenia może naliczyć klientowi podwójnie. RFC 9110 nie definiuje POST jako z natury idempotentnego i odradza automatyczne retry, chyba że klient wie, że operację można bezpiecznie powtórzyć. Klucz idempotencyjny wspierany przez dostawcę płatności to powszechny sposób, by te retrysy były bezpieczniejsze.
Nasz samouczek Streamlit omawia konfigurację interfejsu. Interfejs HarborCart pokazuje zdarzenia dochodzeniowe, plany replayu dla medium i high, wyniki replayu, końcowy raport i koszt. Dla statusu między wywołaniami narzędzi przewodnik po promptowaniu Claude Opus 5.5 opisuje display: "updates"; aplikacja renderuje też zdarzenia narzędzi, gdy blok aktualizacji jest pusty.
Ucz się z DataCamp
course
course
course