courses
Claude 101
2
21.4K
이 튜토리얼에서는 다음과 같은 시나리오를 테스트합니다. 소프트웨어 업데이트 몇 분 후, 이 글에서 사용할 가상의 상점 HarborCart에서 결제 실패가 발생하기 시작합니다. 일부 고객은 30초 넘게 기다리고, 일부는 서버 오류가 떠서 결제를 못 합니다. 결제 제공업체도 짧은 장애를 겪고 있어, 표면적으로는 그게 원인처럼 보입니다.
하지만 제공업체 장애만으로 장바구니와 주문 페이지까지 실패하는 이유는 설명되지 않습니다. 빠진 연결고리를 찾으려면 애플리케이션 로그, 차트, 요청 기록, 최근 코드 변경이 필요합니다. 이 튜토리얼은 Claude Opus 5.5가 그 증거를 따라가고, 통제된 조건에서 설명을 검증하며, 증거가 뒷받침하는 내용만 보고할 수 있는지 테스트합니다.
배경: Claude Opus 5.5는 이 프로젝트를 시작하기 직전 주에 공개되었습니다. 우리의 Claude Opus 5.5 개요는 출시와 벤치마크를 다루므로, 이 튜토리얼은 API에 집중해 첫 요청부터 검증된 보고서까지 하나의 조사 에이전트를 구축합니다.
다음 내용을 다룹니다:
HarborCart의 조사 에이전트는 결제 게이트웨이의 버스트와 이를 증폭시킨 재시도 정책을 분리해 파악한 뒤, 보고서를 반환하기 전에 그 설명을 테스트했습니다.
Claude Opus 5.5는 Anthropic의 Messages API에서 모델 ID claude-opus-5-5로 사용할 수 있습니다. 모델 개요에 따르면 텍스트와 이미지를 받아들이며, 100만 토큰 컨텍스트 윈도우와 128K 최대 출력이 제공됩니다. 적응형 사고는 항상 활성화되어 있고 기본 effort는 medium입니다.
표준 요금은 입력 토큰 백만 개당 $4, 출력 토큰 백만 개당 $20입니다. 5분 캐시 쓰기는 백만 개당 $5, 캐시 읽기는 $0.20입니다. 프롬프트 캐싱이 활성화되면, 일치하는 접두사는 더 낮은 캐시 읽기 요율이 적용됩니다.
이 프로젝트에 직접적으로 드러나는 사항이 마이그레이션 가이드에 네 가지로 정리되어 있습니다.
any 또는 지정 도구로 강제한 tool_choice는 400 오류를 반환합니다.
기본 effort가 Claude Opus 5의 high에서 medium로 낮아졌습니다.
Thinking은 끌 수 없고, thinking 블록은 툴 루프 내부에서 변경 없이 되돌려야 합니다.
툴 호출 사이에 모델이 작성하는 노트는 기본적으로 비어 있는 thinking 블록 안에 도착합니다.
에이전트는 조사만 수행합니다. 증거 수집 도구는 읽기 전용이며, 프로덕션 자격 증명은 없습니다. 증거 수집 후에는 별도의 계획 요청이 반사실적 테스트를 제안하고, Python이 이를 검증한 뒤 medium effort 계획을 실행합니다.
전체 코드(증거 생성기와 웹 앱 포함)는 GitHub 저장소에 있습니다.
HarborCart는 가상의 상점입니다. 그 checkout-api는 장바구니 페이지, 주문 상태, 그리고 서드파티 결제 게이트웨이에 청구하는 POST /checkout를 제공합니다. 이들 엔드포인트는 인스턴스당 15개의 PostgreSQL 연결을 공유하는 하나의 풀을 사용합니다.
배포 후 5분 뒤, 게이트웨이가 약 90초간 503을 반환합니다. 풀은 15/15로 꽉 찬 상태에서 결제 지연이 30초를 넘습니다. 결제 제공업체를 탓하기 쉽고, 실제로 게이트웨이는 실패했습니다.
숨은 원인은 한 단계 더 안쪽에 있습니다. 이번 배포로 실패한 POST 청구가 최대 3회까지, 총 4회 시도되도록 허용되었고, 핸들러는 그동안 데이터베이스 연결을 계속 보유합니다. 느리게 실패하는 청구가 이제 30초 이상 연결을 점유하고, 풀이 고갈되면 게이트웨이를 호출하지 않는 장바구니 페이지도 함께 실패합니다.
여기서 세 가지 용어를 일관되게 사용합니다. 방아쇠(trigger)는 일시적인 게이트웨이 장애입니다. 부족한 데이터베이스 연결을 쥔 채로 체크아웃 POST를 재시도하는 것은 증폭 메커니즘이고, 공유 연결 풀 고갈은 시스템 실패입니다.
에이전트는 알림, 모니터링 스크린샷, 아키텍처 다이어그램으로 시작합니다. 그 외의 모든 것은 도구를 통해 들어옵니다: 로그, 트레이스, 다섯 가지 지표, 배포 메타데이터, Git diff, 런북. 인벤토리 경고, 프론트엔드 경고, CPU 포화 가능성이라는 세 가지 대안 설명을 증거에 미리 심어 둡니다.
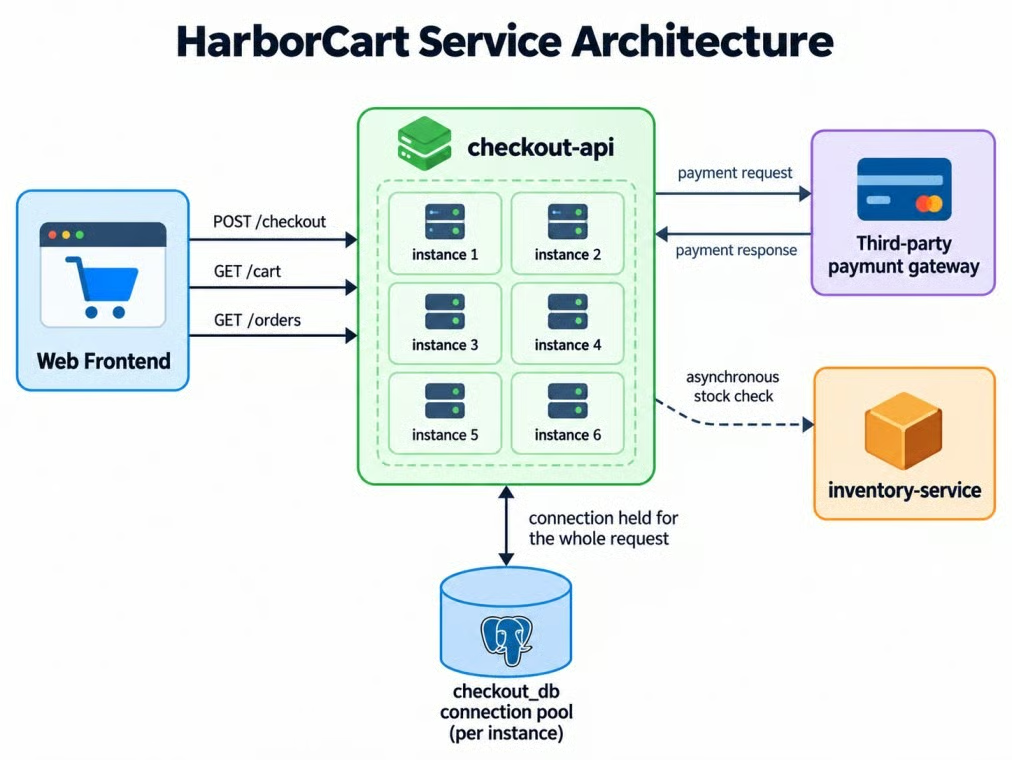
HarborCart 체크아웃 경로와 공유 풀. 이미지: 작성자.
다이어그램은 요청 전체 동안 연결이 유지된다고 말합니다. 하지만 그것이 문제라는 말은 없고, 조사가 그 결론에 도달해야 합니다.
에이전트를 만들기 전에 성공 기준을 정의하세요. 올바른 보고서는 다음을 충족해야 합니다.
POST 재시도를 허용한 재시도 변경을 명시Python 3.10 이상과 claude-opus-5-5 접근 권한이 있는 Anthropic API 키가 필요합니다. 다음 PowerShell 명령은 프로젝트를 클론하고, anthropic 1.8.0을 포함한 고정 의존성을 설치합니다. Amazon Bedrock을 사용 중이라면, 여러 기능이 이식되지 않으므로 먼저 FAQ를 읽으세요.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
macOS 또는 Linux에서는 source .venv/bin/activate로 활성화하고 cp .env.example .env로 복사하세요. 키를 .env에 추가하면 python-dotenv가 SDK를 위해 로드합니다. 우리의 환경 변수 가이드에서 이 패턴을 설명합니다. 이전에 Python에서 Claude를 호출해 보셨다면, 다음 절은 설정 확인만 하므로 건너뛰세요.
가장 작은 유용한 요청은 키를 확인하고 어떤 응답이 오는지 보여줍니다.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
이 요청에서 응답은 thinking와 text 블록을 포함합니다. response.content[0]를 읽는 대신 유형별로 블록을 선택하세요.
툴 호출 에이전트는 Claude의 Messages API와 데이터 접근을 제어하는 Python 함수를 결합합니다. 애플리케이션은 한 가지 원칙을 따릅니다. Claude는 필요한 증거를 결정하고, Python은 접근 권한을 결정합니다.
우리의 에이전트 하니스 엔지니어링 가이드는 더 넓은 도구 경계와 루프를 다룹니다. HarborCart는 도구를 읽기 전용으로 유지하고 이번 인시던트로 범위를 제한합니다.
각 도구는 고정된 증거 집합을 읽고 제한된 JSON 결과를 반환합니다. 로그와 트레이스 쿼리는 최대 200개 행과 카운트를 반환하며, 지표 쿼리는 최대 60개 포인트를 반환합니다.
프로그래매틱 툴 호출은 strict: true를 지원하지 않으므로, 도구를 둘로 나눕니다. 증거 제어와 조사 종료 도구는 엄격하고 direct-only로 유지하세요. 로그, 트레이스, 지표는 코드 실행만 사용하여, 대량 증거 쿼리에 대해 Claude에게 하나의 명확한 경로를 제공합니다.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
"input_schema": {...}},allowed_callers는 모델을 유도하지만 보안 경계는 아닙니다. Python은 각 도구 실행 전 호출자를 확인하고 직접 쿼리 호출을 거부합니다. 프로그래매틱 호출은 엄격한 검증도 건너뛰므로, 쿼리 함수는 여전히 자체 인자를 검증해야 합니다.
애플리케이션은 수락된 각 도구 결과에 태그를 달고, 누락된 증거를 인용하는 발견은 거부하며, 웹 검색으로 반환된 경우에만 문서 URL을 허용합니다. 리플레이 출력은 모델이 아닌 Python이 기록합니다.
마이그레이션 절에서 언급했듯이, tool_choice는 auto로 유지하세요. 어떤 도구가 적용되는지 프롬프트에서 말하고, 인자를 정확히 맞춰야 하는 경우에는 엄격한 스키마를 사용합니다.
루프는 대화를 전송하고, tool_use 블록을 실행하고, 결과를 추가한 뒤 반복합니다. 어시스턴트의 블록은 thinking 포함 변경 없이 추가하고, 프로그래매틱 코드가 일시 중지된 동안에는 container ID만을 tool_result 블록과 함께 전달하세요.
조사 요청에는 비전, 도구, 웹 검색, effort, 작업 예산이 포함되지만 출력 스키마는 없습니다. 이렇게 하면 인용이 포함된 검색 결과가 구조화된 JSON 출력과 섞이지 않고, 안정적인 요청 접두사로 프롬프트 캐싱을 유지합니다:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)대시보드와 아키텍처 다이어그램을 첫 사용자 메시지에 base64 PNG로 첨부하세요. Claude에게 이미지에서 읽은 모든 내용을 가설로 취급하고 query_metrics로 확인하라고 지시합니다.
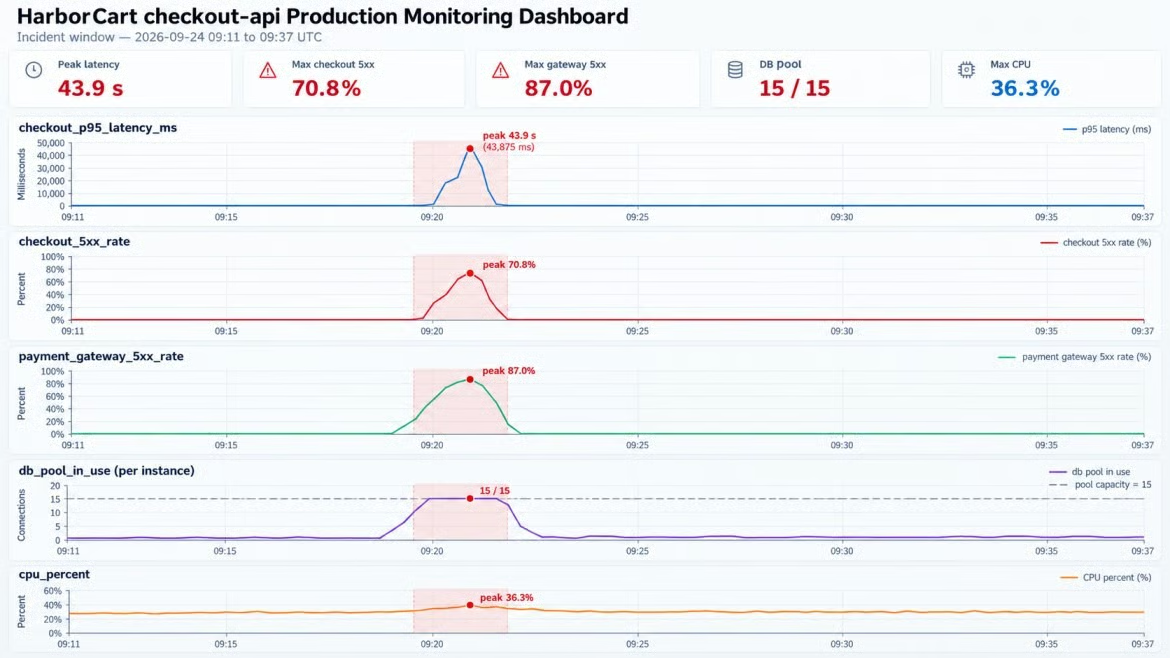
대시보드는 풀 포화, 평평한 CPU를 보여줍니다. 이미지: 작성자.
대시보드와 지표 쿼리는 동일한 원천 데이터를 사용합니다. 풀은 가득 찬 반면 CPU는 약 30%에 머물러, 어떤 쿼리도 실행하기 전에 "호스트 과부하" 가설에 반하는 근거를 제공합니다.
스크린샷은 볼 곳을 제안하지만, 관찰이 성립하는지는 수치 시계열이 결정합니다. 비전은 가설을 생성하고, 지표가 이를 테스트합니다.
이미지 우선 워크플로에 대해서는 에이전틱 비전 튜토리얼을 참고하세요. HarborCart는 다음 지표를 선택하는 데만 비전을 사용합니다.
프로그래매틱 툴 호출은 Claude가 코드 실행 컨테이너에서 실행되는 Python을 작성하고, 그 코드가 여러분의 도구를 함수처럼 호출하게 해 줍니다. 원시 결과는 샌드박스에 머물고, 코드가 출력한 내용만 모델에 전달됩니다.
에이전트는 실패한 트레이스를 가져오고 엔드포인트별 카운트만 출력하는 짧은 스크립트를 작성합니다. 한 차례 전체 조사에서, 프로그래매틱 툴 호출은 모델에 반환되는 직렬화 증거를 98.8% 줄였습니다. 툴 결과는 42.9 KB, 요약은 0.5 KB로, 청구되는 입력 토큰 절감이 아닌 바이트 기준입니다.
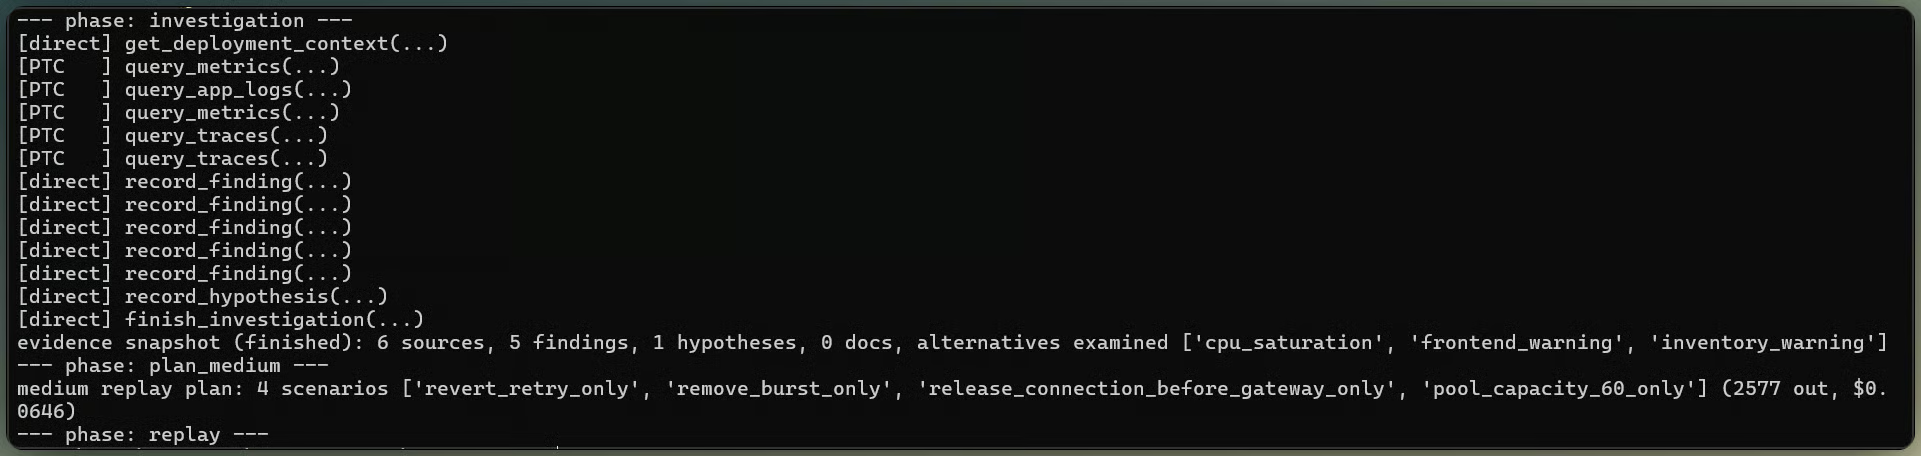
툴 호출로 인시던트 증거를 좁힙니다. 이미지: 작성자.
애플리케이션은 재시도 라이브러리 의미를 위한 제한된 웹 검색을 제공합니다. Claude는 최종 평가 중 이를 호출하지 않았으므로, 측정된 진단은 diff, 지표, 로그, 트레이스에 기반합니다. urllib3 레퍼런스는 allowed_methods=None가 모든 메서드를 재시도하고, backoff_factor=0가 대기 시간을 제거함을 독립적으로 확인하지만, 해당 페이지는 측정된 증거에는 포함되지 않습니다.
반사실적 리플레이는 의심되는 원인 하나를 제거한 상태로 인시던트 트래픽을 다시 실행하고 실패가 사라지는지 확인합니다. 이는 "이 선들이 함께 상승한다"를 실제 테스트로 바꿉니다.
리플레이는 동일한 트래픽 패턴을 재사용합니다. 아래 비교에서 각 시나리오는 한 가지 조건만 변경하며, 어떤 변경이 허용되는지는 애플리케이션이 제어합니다.
요약은 게이트웨이 503과 풀 타임아웃을 분리하고, 체크아웃 503과 장바구니/주문 읽기 실패를 구분합니다. 이 분리가 모델이 방아쇠와 증폭기를 구분하게 합니다.
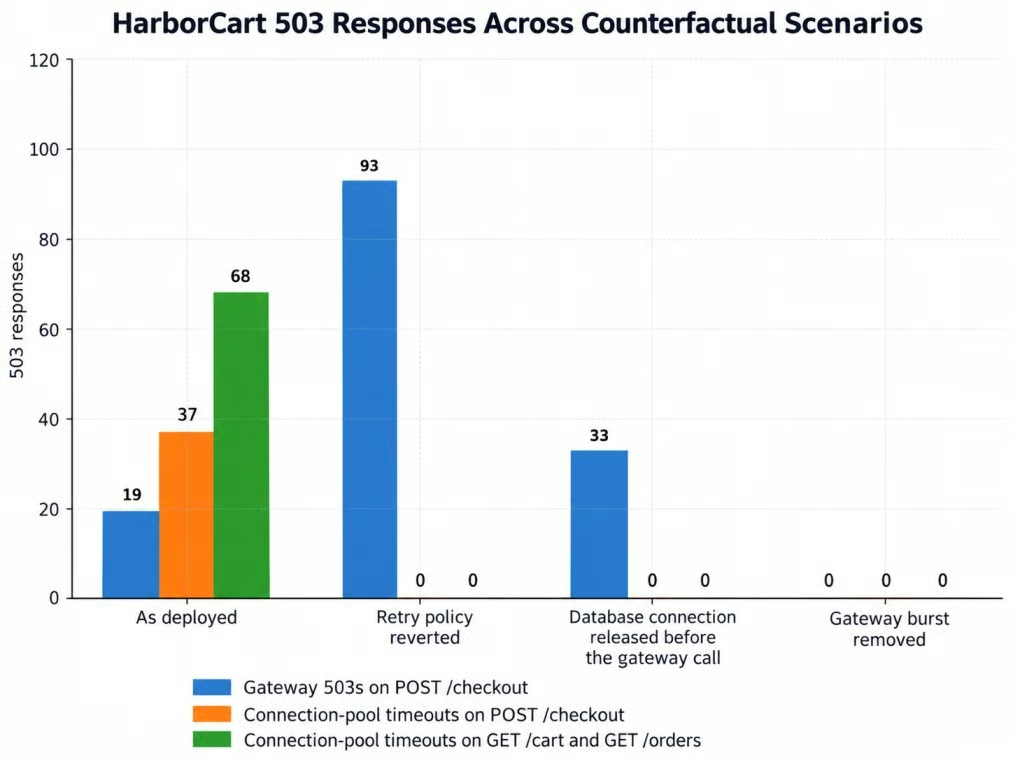
각 리플레이는 한 가지만 바꿉니다. 이미지: 작성자.
기준 리플레이에서는 503이 124건 발생했습니다. 풀 타임아웃 105건(읽기 엔드포인트 실패 68건 포함), 게이트웨이 오류 19건입니다. 재시도 정책을 되돌리니 모든 풀 타임아웃과 읽기 실패가 사라졌지만, 체크아웃에서 게이트웨이 503이 93건 나타났습니다. 게이트웨이 호출 전에 연결을 해제해도 풀 실패가 제거되고 게이트웨이 503은 33건 남았으며, 게이트웨이 버스트를 제거하면 오류가 없었습니다.
리플레이는 트레이드오프를 드러냅니다. 롤백은 공유 풀을 보호하지만 더 많은 체크아웃 실패를 허용합니다. 임시방편으로 사용하고, 이어서 중복 청구를 방지하기 위해 멱등성 키를 추가하고, 게이트웨이 호출 동안 연결을 잡아 두지 않도록 변경하세요.
시스템 프롬프트는 리플레이를 요청하지만, 프롬프트는 강제 수단이 아닙니다. 루프는 리플레이 증거의 존재를 확인하고, 테스트되지 않은 진단을 거부합니다.
이 검사는 Python에 두세요. 더 날카로운 프롬프트가 준수율을 높일 수는 있어도 보장하지는 못합니다.
Effort는 Claude가 단계별로 얼마나 사고할지 설정하고, 작업 예산은 전체 루프가 얼마나 많은 작업을 수행해야 하는지 설정합니다. Claude Opus 5 API 튜토리얼은 다섯 가지 effort를 비교합니다. 여기서는 medium과 high가 리플레이 전 같은 증거를 받습니다.
프로덕션은 medium에 유지합니다. 리플레이 이전에 애플리케이션은 medium과 high effort에 같은 증거로 인과 테스트 설계를 요청합니다. medium의 권고만 실행하고, high 응답은 비교용으로만 사용합니다.
high 요청은 mid-conversation-output-config-2026-07-01 뒤에서 메시지별 output_config.effort 변경을 사용합니다. medium의 답변은 보지 못합니다.
두 effort 수준 모두 같은 가설과 같은 세 가지 핵심 리플레이 시나리오를 선택했습니다. high는 평균 2,631 출력 토큰을 사용했고, medium은 2,307로 약 11% 더 비쌌지만 인과 테스트는 바뀌지 않았습니다.
추측하지 말고 관찰된 사용량으로 작업 예산을 선택하세요. HarborCart의 가장 큰 무제한 조사는 모델 출력과 Claude가 본 툴 결과 텍스트를 포함해 집계 토큰 13,322를 사용했습니다. 25% 마진을 더하면 16,653이 되어 Anthropic의 최소 20,000 토큰보다 낮으므로, 구성된 예산은 20,000입니다.
턴 수와 경과 시간은 애플리케이션 한도로 유지하세요. 실험 러너는 기록된 지출이 $2.50에 도달하면 새 작업 시작을 중단했습니다. 이미 진행 중인 요청은 이를 초과해 끝날 수 있으므로 절대 한도는 아닙니다.
최종 답변은 구조화된 출력을 사용합니다. 평평한 스키마는 판결, 원인, 기각된 가설, 증거, 수정안을 다룹니다. 비용과 지연은 애플리케이션이 측정하므로 제외합니다.
웹 검색 출처 표기와 output_config.format는 같은 요청에서 함께 사용할 수 없습니다. 출처 표기는 콘텐츠 블록의 교차 삽입이 필요하고, 스키마는 JSON을 요구하기 때문입니다. 따라서 HarborCart는 출력 스키마 없이 조사하고, 출처에 묶인 발견과 리플레이 결과를 저장한 다음, 도구와 웹 검색 없이 검증된 증거만 두 번째 요청에 전달합니다.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
두 번째 요청에는 검증된 증거만 필요하므로, 전체 조사 캐시를 보존할 필요가 없습니다.
"inconclusive"를 verdict 필드에서 허용하세요. 리플레이가 설명을 반박하는데도 검증된 진단으로 억지로 만들면 안 됩니다.
스키마는 보고서의 형태를 검증하고, 리플레이는 진단을 검증합니다. 거부 응답도 stop_reason: "refusal"로 HTTP 200을 반환하며 스키마와 일치하지 않을 수 있으니, 파싱 전에 stop reason을 확인하세요.
세 개의 최종 보고서 모두 핵심 인과 메커니즘을 찾고 세 가지 대안 설명을 배제했습니다. 이 중 두 개는 여덟 가지 점검을 모두 충족했고, 하나는 POST 재시도 구성 변경을 명시하지 않고 배포 diff를 인용하지 않아 6/8을 기록했습니다. 이 때문에 오프라인 채점은 스키마 검증과 분리됩니다. 올바른 JSON과 올바른 진단이라도 불완전한 보고서가 나올 수 있기 때문입니다.
보고서는 또한 두 번째 위험을 지적합니다. 청구를 재시도하면 고객이 두 번 과금될 수 있습니다. RFC 9110은 POST를 본질적으로 멱등이라 정의하지 않으며, 클라이언트가 작업을 반복해도 안전하다는 걸 알지 못한다면 자동 재시도를 권장하지 않습니다. 결제 제공업체가 지원하는 멱등성 키는 이러한 재시도를 더 안전하게 만드는 일반적인 방법입니다.
우리의 Streamlit 튜토리얼은 인터페이스 설정을 다룹니다. HarborCart의 인터페이스는 조사 이벤트, medium과 high의 리플레이 계획, 리플레이 결과, 최종 보고서, 비용을 보여줍니다. 툴 호출 사이 상태 표시를 위해, Claude Opus 5.5 프롬프트 가이드는 display: "updates"를 설명하며, 앱은 업데이트 블록이 비어 있을 때 툴 이벤트도 렌더링합니다.
DataCamp와 함께 배우세요
courses
courses
courses