Courses
Claude 101
2時間
21.4K
このチュートリアルでは、あるシナリオを検証します。ソフトウェア更新の数分後、HarborCart(このシナリオで使用する架空のストア)でチェックアウトの失敗が発生し始めます。ある顧客は30秒以上待たされ、別の顧客はサーバーエラーで支払いができません。ちょうどその頃、決済プロバイダーでも短時間の障害が発生しており、表面的にはそれが明白な原因に見えます。
しかし、そのプロバイダーの障害だけでは、カートや注文ページまで失敗する理由を説明できません。欠けているつながりを見つけるには、アプリケーションログ、チャート、リクエスト記録、そして最近のコード変更が必要です。このチュートリアルは、Claude Opus 5.5がその証拠をたどり、統制された条件下で説明を検証し、証拠が裏付ける範囲のみを報告できるかを試すものです。
背景として:Claude Opus 5.5は、私がこのプロジェクトを始める直前の週に登場しました。当社のClaude Opus 5.5 概要ではローンチとベンチマークを扱っているため、本チュートリアルではAPIに焦点を当て、最初のリクエストから検証済みレポートまで、一つの調査エージェントを構築します。
以下を取り上げます。
HarborCartの調査エージェントは、決済ゲートウェイのバーストと、それを増幅したリトライポリシーを切り分け、その説明をテストしたうえでレポートを返しました。
Claude Opus 5.5にはAnthropicのMessages APIから、モデルIDclaude-opus-5-5でアクセスします。モデル概要によると、テキストと画像を受け取り、コンテキストは100万トークン、最大出力は128Kです。アダプティブ思考は常時有効で、既定のeffortはmediumです。
標準の料金は入力トークン100万あたり$4、出力トークン100万あたり$20です。5分キャッシュの書き込みは100万あたり$5、キャッシュ読み出しは$0.20です。プロンプトキャッシュが有効になると、一致するプレフィックスは低いキャッシュ読み取りレートで課金されます。
このプロジェクトに直接関わる点を移行ガイドから4つ挙げます。
anyまたは特定ツール名での強制的なtool_choiceは400エラーになる。
既定のeffortが、Claude Opus 5のhighからmediumに下がった。
Thinkingはオフにできず、thinkingブロックはツールループの中で変更せずに戻す必要がある。
ツール呼び出しの合間にモデルが書くノートはthinkingブロック内に入り、既定では空。
エージェントは調査のみに徹します。読み取り専用の証拠ツールを与え、本番認証情報は付与しません。証拠収集の後、別のプランニングリクエストで反事実テストを提案し、Pythonが妥当性を確認してmedium effortの計画を実行します。
完全なコード(証拠ジェネレーターとWebアプリ含む)はこのGitHubリポジトリにあります。
HarborCartは架空のストアです。checkout-apiはカートページ、注文ステータス、そしてPOST /checkoutを提供し、これはサードパーティの決済ゲートウェイに課金します。これらすべてのエンドポイントは、インスタンスあたり15接続のPostgreSQLプールを共有しています。
デプロイ後5分でゲートウェイが約90秒間503を返し始めます。チェックアウトのレイテンシは30秒超に達し、プールは常に15/15。決済プロバイダーのせいにするのは簡単で、実際ゲートウェイは失敗していました。
隠れた原因はその一歩先にあります。今回のデプロイで、失敗したPOST課金が最大3回までリトライ(合計4回試行)できるようになり、ハンドラーはその間ずっとデータベース接続を保持したままでした。遅く失敗する課金が30秒以上接続を占有し、プールが枯渇して、ゲートウェイを呼ばないカートページまで失敗するようになりました。
ここから一貫して3つの用語を使います。ここでのトリガーは一時的なゲートウェイ障害。希少なデータベース接続を保持したままチェックアウトPOSTをリトライすることが増幅メカニズムで、共有コネクションプールの枯渇がシステム障害です。
エージェントは、アラート、監視のスクリーンショット、アーキテクチャ図から開始します。その他はツール経由で取得します:ログ、トレース、5つのメトリクス、デプロイメタデータ、Gitの差分、ランブック。証拠には、在庫警告、フロントエンド警告、CPU飽和の可能性という3つの競合する説明があらかじめ含まれています。
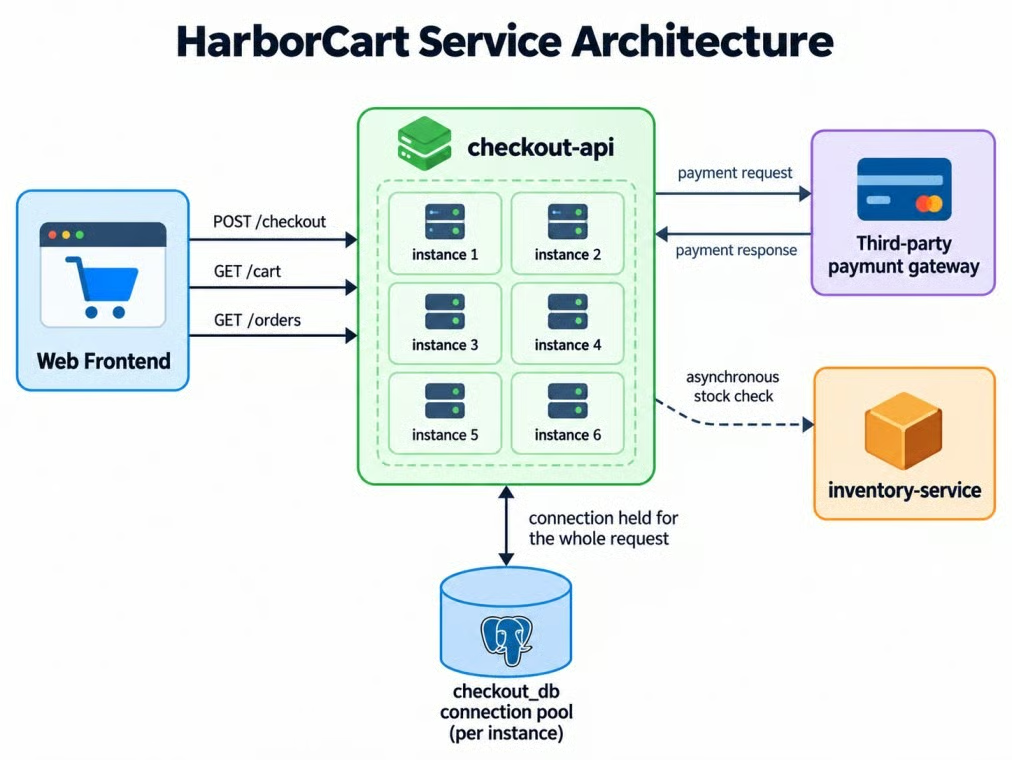
HarborCartのチェックアウト経路と共有プール。画像:筆者作成。
図では、接続がリクエスト全体で保持されると示されています。これ自体が問題だとは書いていません。調査でそれを突き止める必要があります。
エージェントを作る前に成功条件を定義します。正しいレポートは次を満たす必要があります。
POSTの設定変更を特定するPython 3.10以降と、claude-opus-5-5へのアクセス権を持つAnthropicのAPIキーが必要です。以下のPowerShellコマンドでプロジェクトをクローンし、固定版依存関係(anthropic 1.8.0を含む)をインストールします。Amazon Bedrockを使う場合は、いくつかの機能が移植できないため、先にFAQをお読みください。
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .envmacOSやLinuxでは、source .venv/bin/activateで有効化し、cp .env.example .envでコピーします。キーを.envに追加すると、python-dotenvがSDK用に読み込みます。当社の環境変数ガイドでこのパターンを解説しています。PythonからClaudeを呼んだことがある場合、次の小節はセットアップ確認に過ぎないので飛ばして構いません。
最小限ながら有用なリクエストで、キーの確認と返ってくる内容を示します。
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")このリクエストでは、レスポンスにthinkingとtextのブロックが含まれます。response.content[0]を読むのではなく、型でブロックを選別してください。
ツール呼び出しエージェントは、ClaudeのMessages APIと、データアクセスを制御するPython関数を組み合わせます。アプリケーションは1つの原則に従います:どの証拠が必要かはClaudeが判断し、何にアクセスできるかはPythonが決めます。
より広いツール境界やループについては当社のエージェント・ハーネス設計ガイドをご覧ください。HarborCartではツールをインシデントに限定し、読み取り専用に保ちます。
各ツールは所定の証拠を読み、限定的なJSON結果を返します。ログとトレースのクエリは最大200行と件数、メトリクスのクエリは最大60ポイントを返します。
プログラムによるツール呼び出しはstrict: trueをサポートしないため、ツールを2系統に分けます。証拠の制御と調査終了ツールは厳密・直接呼び出し専用にします。ログ、トレース、メトリクスはコード実行のみを用い、大規模な証拠クエリに対してClaudeに明確な経路を与えます。
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
"input_schema": {...}},allowed_callersはモデルを誘導しますが、セキュリティ境界ではありません。Pythonは各ツールの実行前に呼び出し元を検査し、直接のクエリ呼び出しを拒否します。プログラム呼び出しは厳密な検証も回避するため、クエリ関数側でも引数の妥当性検証を行います。
アプリケーションは受理したツール結果にタグを付け、不在の証拠を引用する所見は却下し、ウェブ検索で取得した場合にのみドキュメントURLを受け付けます。リプレイの出力はモデルではなくPythonが記録します。
移行セクションで述べた通り、tool_choiceはautoに保ちましょう。どの場面でツールが該当するかはプロンプトで明示し、引数を厳密にすべき箇所では厳密スキーマを使います。
ループは会話を送信し、tool_useブロックを実行して結果を追加し、繰り返します。アシスタントのブロックはthinkingを含め変更せずに追加し、プログラムコードの実行が一時停止中は、containerIDをtool_resultブロックのみと共に返します。
調査のリクエストには、ビジョン、ツール、ウェブ検索、effort、タスク予算を含め、出力スキーマは含めません。これにより、出典付きの検索結果を構造化JSON出力から切り離しつつ、安定したリクエストプレフィックスでプロンプトキャッシュを維持できます。
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)ダッシュボードとアーキテクチャ図を、最初のユーザーメッセージにbase64のPNGとして添付します。Claudeには、画像から読み取った内容は仮説として扱い、query_metricsで確認するよう指示します。
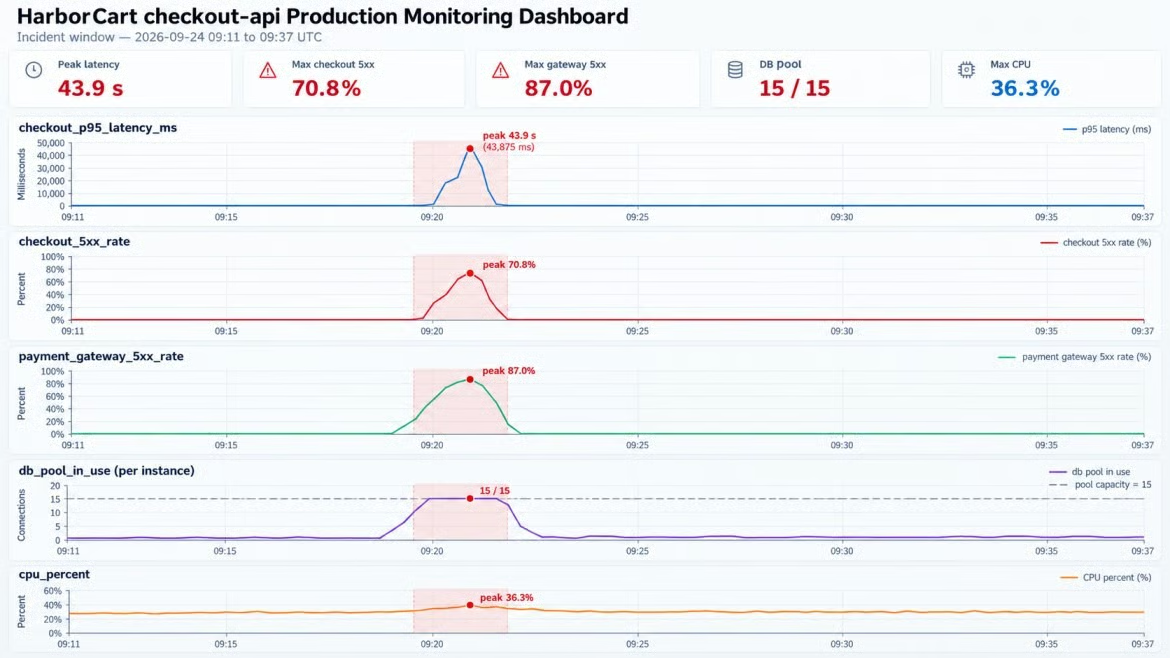
ダッシュボードはプール飽和、CPUは横ばいを示す。画像:筆者作成。
ダッシュボードとメトリクスクエリは同じデータソースを使います。プールが満杯の間もCPUは約30%に留まっており、クエリ実行前から「ホストの過負荷」説に反する材料になります。
スクリーンショットは当たりを付ける材料に過ぎず、観察が成り立つかは数値系列で判断します。ビジョンで仮説を立て、メトリクスで検証します。
画像主導のワークフローについては当社のエージェンティック・ビジョンのチュートリアルをご覧ください。HarborCartでは、次に見るべきメトリクスを選ぶ目的に限ってビジョンを使います。
プログラムによるツール呼び出しでは、Claudeがコード実行コンテナ内で走るPythonを書き、あなたのツールを関数として呼びます。生の結果はサンドボックス内に留まり、コードの標準出力だけがモデルに届きます。
エージェントは、失敗トレースを取得してエンドポイント別の件数だけを出力する短いスクリプトを書きます。ある完全な調査では、プログラム呼び出しにより、モデルへ返す直列化証拠が98.8%削減されました。ツール結果は42.9 KB、要約は0.5 KBでした(請求上の入力トークン節約ではなくバイト数の測定)。
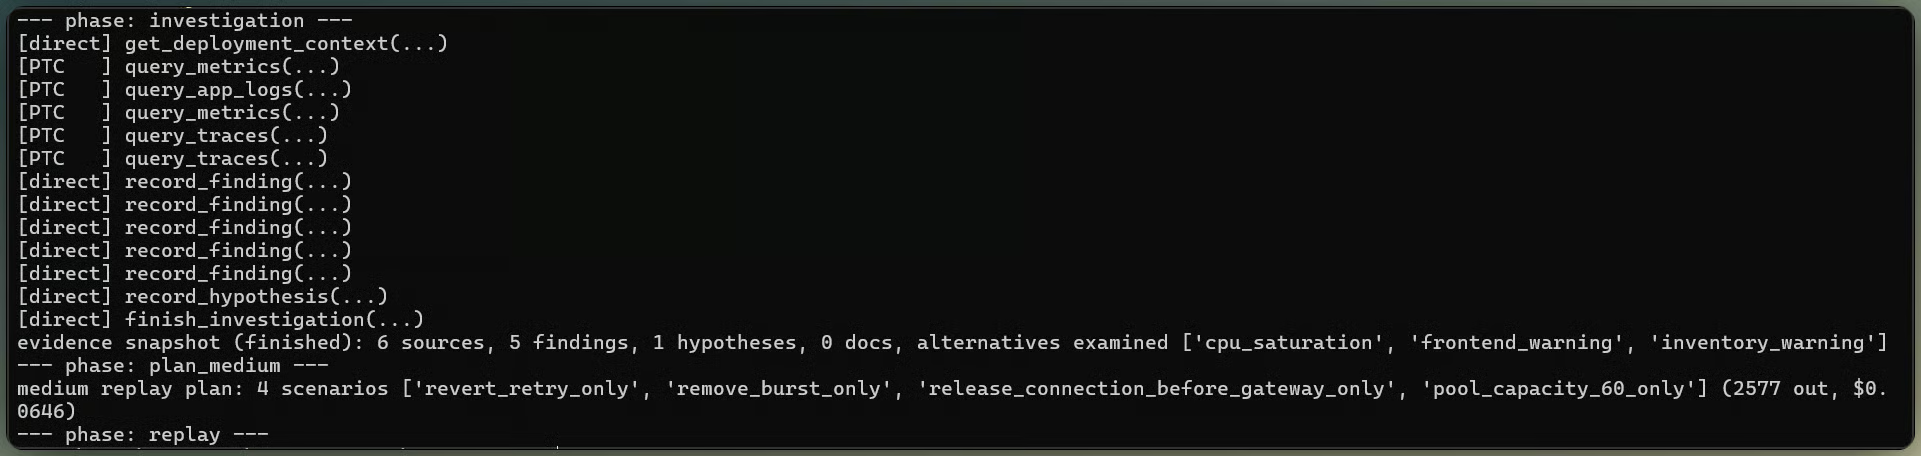
ツール呼び出しでインシデント証拠を絞り込む。画像:筆者作成。
アプリケーションは、リトライライブラリのセマンティクス用に制限付きウェブ検索を公開します。最終評価ではClaudeはこれを呼び出さなかったため、測定された診断は差分、メトリクス、ログ、トレースに基づいています。urllib3のリファレンスは独立に、allowed_methods=Noneがあらゆる動詞をリトライし、backoff_factor=0が待ち時間をなくすことを確認しますが、そのページ自体は測定証拠には含まれません。
反事実リプレイは、疑わしい原因を1つ取り除いてインシデントのトラフィックを再実行し、失敗が消えるかを確認します。「これらの系列が同時に上がっている」をテストに変える手段です。
リプレイは同じトラフィックパターンを再利用します。以下の比較では、各シナリオが1つの条件のみを変更し、どの変更が許容されるかはアプリケーションが制御します。
サマリーは、ゲートウェイの503とプールのタイムアウト、チェックアウトの503とカート・注文の読み取り失敗を分けて集計します。この分離こそが、モデルにトリガーと増幅要因を見分けさせます。
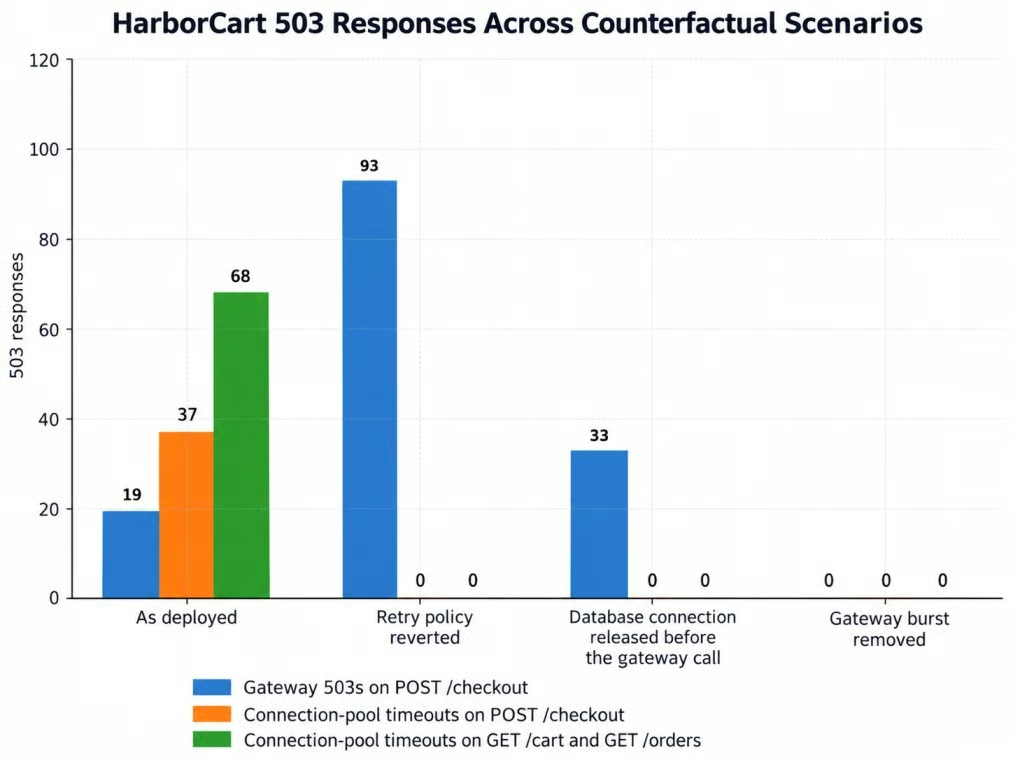
各リプレイは1つだけ変更。画像:筆者作成。
ベースラインのリプレイでは503が124件:プールのタイムアウト105件(うち読み取りエンドポイントの失敗68件)、ゲートウェイエラー19件。リトライポリシーを戻すと、プールのタイムアウトと読み取り失敗はすべて消える一方、チェックアウトのゲートウェイ503が93件に顕在化。ゲートウェイ呼び出し前に接続を解放してもプールの失敗は消え、ゲートウェイ503は33件残存。ゲートウェイのバースト自体を除去するとエラーは発生しませんでした。
このリプレイはトレードオフを示します。ロールバックは共有プールを守る代わりに、チェックアウトの失敗をより多く通してしまいます。つなぎとしては有効です。その後、同一課金の二重請求を防ぐためにべき等性キーを追加し、ゲートウェイ呼び出し中の接続保持をやめましょう。
システムプロンプトはリプレイを要求しますが、プロンプトは強制力ではありません。ループはリプレイ証拠の有無を確認し、未検証の診断を却下します。
このチェックはPython側に保持してください。鋭いプロンプトで遵守は改善しても、保証はできません。
Effortはステップごとの思考量を設定し、タスク予算はループ全体の作業量を設定します。当社のClaude Opus 5 APIチュートリアルで5段階のeffortを比較しています。ここでは、mediumとhighが同じプレリプレイ証拠を受け取ります。
本番はmediumを維持します。リプレイ前に、アプリケーションは同じ証拠から因果テスト設計をmediumとhighに求めます。実行するのはmediumの推奨のみで、highの応答は比較にのみ使います。
highのリクエストは、mid-conversation-output-config-2026-07-01の裏でメッセージ単位のoutput_config.effort変更を使用します。highはmediumの解答を見ません。
両effortレベルは同じ仮説と3つの中核リプレイシナリオを選びました。平均出力トークンはhighが2,631、mediumが2,307で、因果テストを変えずにコストは約11%高くなりました。
当てずっぽうではなく観測に基づいて予算を選びます。HarborCartで最大の無制限調査は、モデル出力とClaudeが見たツール結果テキストを含め13,322カウントトークンを消費しました。25%のマージンを加えると16,653で、Anthropicの最小20,000トークンを下回るため、構成は20,000にします。
ターン数と経過時間はアプリケーション制限として維持します。実験ランナーは、記録された支出が$2.50に達した時点で新規作業の開始を止めました。これはハードキャップではなく、進行中のリクエストはその上で完了する可能性があります。
最終回答には構造化出力を使います。フラットなスキーマで、評決、原因、棄却した仮説、証拠、対策をカバーします。コストとレイテンシはアプリケーションが測定するため除外します。
ウェブ検索の出典とoutput_config.formatは同一リクエストに共存できません。出典にはコンテンツブロックの挿入が必要で、スキーマはJSONを要求するからです。HarborCartはそのため、出力スキーマなしで調査します。所見をその出典とリプレイ結果に紐づけて保存し、検証済みの証拠のみを、ツールやウェブ検索なしの2本目のリクエストへ送ります。
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
2本目のリクエストには検証済みの証拠だけが必要なので、完全な調査キャッシュの保存は不要です。
verdictフィールドでは"inconclusive"を許容します。リプレイが説明に反するとき、検証済み診断に無理やり当てはめるべきではありません。
スキーマはレポートの形を検証し、診断はリプレイで検証します。拒否もHTTP 200(stop_reason: "refusal")で返り、スキーマに一致しない可能性があるため、パース前に停止理由を確認してください。
最終レポート3本はいずれも中核の因果メカニズムを見つけ、3つの代替説明を退けました。うち2本は8つのチェックをすべて満たし、3本目はPOSTリトライの明示的な設定変更を記し忘れ、デプロイ差分を引用しなかったため6/8でした。これが、スキーマ検証と別にオフライン採点を行う理由です。正しいJSONと正しい診断でも、レポートが不完全であり得ます。
レポートは第二のリスクも特定しています:課金のリトライで顧客に二重請求が発生し得ること。RFC 9110はPOSTを本質的にべき等とは定義しておらず、クライアントが繰り返し可能な安全な操作と分かっていない限り自動リトライを推奨していません。決済プロバイダーがサポートするべき等性キーは、これらのリトライを安全にする一般的手段です。
当社のStreamlitチュートリアルはUIのセットアップを扱います。HarborCartのインターフェースは調査イベント、mediumとhighのリプレイ計画、リプレイ結果、最終レポート、コストを表示します。ツール呼び出しの間のステータスには、Claude Opus 5.5のプロンプトガイドdisplay: "updates"が記載されています。アプリも、アップデートブロックが空のときはツールイベントを描画します。
DataCampで学ぶ
Courses
Courses
Courses