
Kurs
Claude 101
2 Std.
21.4K
In diesem Tutorial teste ich ein Szenario: Wenige Minuten nach einem Software-Update verzeichnet HarborCart — ein fiktiver Shop für dieses Beispiel — Checkout-Fehler. Manche Kundinnen und Kunden warten über 30 Sekunden; andere sehen einen Serverfehler und können nicht bezahlen. Der Zahlungsanbieter hat ebenfalls eine kurze Störung, was wie die naheliegende Ursache wirkt.
Die Störung beim Anbieter erklärt jedoch nicht, warum auch Warenkorb- und Bestellseiten ausfallen. Um die fehlende Verbindung zu finden, braucht es Anwendungslogs, Diagramme, Request-Records und den jüngsten Code-Change. Dieses Tutorial prüft, ob Claude Opus 5.5 diesen Spuren folgen, seine Erklärung unter kontrollierten Bedingungen testen und nur das berichten kann, was die Belege stützen.
Zum Hintergrund: Claude Opus 5.5 erschien früher in derselben Woche, kurz bevor ich dieses Projekt startete. Unsere Übersicht zu Claude Opus 5.5 deckt Launch und Benchmarks ab, daher konzentriert sich dieses Tutorial auf die API und baut einen Investigation-Agenten vom ersten Request bis zum verifizierten Report.
Wir behandeln:
HarborCarts Investigator hat den Burst beim Payment-Gateway vom Retry-Policy-Effekt getrennt, der ihn verstärkte, die Erklärung getestet und erst dann berichtet.
Du greifst auf Claude Opus 5.5 über Anthropics Messages API mit der Modell-ID claude-opus-5-5 zu. Laut Modellübersicht akzeptiert es Text und Bilder, mit einem Kontextfenster von 1 Mio. Tokens und 128K Max-Output. Adaptives Denken ist immer aktiv, der Standard-Effort ist medium.
Das Standardpreis beträgt $4 pro Million Input-Tokens und $20 pro Million Output-Tokens. Fünf-Minuten-Cache-Writes kosten $5 pro Million, Cache-Reads $0,20. Sobald Prompt Caching aktiv ist, werden passende Präfixe zum günstigeren Cache-Read-Tarif abgerechnet.
Vier Punkte aus dem Migrationsleitfaden finden sich direkt in diesem Projekt wieder.
Erzwungenes tool_choice mit any oder einem benannten Tool liefert einen 400-Fehler.
Der Standard-Effort fiel von high bei Claude Opus 5 auf medium.
Thinking lässt sich nicht ausschalten, und thinking-Blöcke müssen innerhalb einer Tool-Schleife unverändert zurückgegeben werden.
Notizen, die das Modell zwischen Tool-Calls schreibt, erscheinen in thinking-Blöcken, die standardmäßig leer sind.
Der Agent ermittelt nur. Er erhält schreibgeschützte Evidenz-Tools und keine Produktions-Credentials. Nach dem Sammeln der Belege schlagen separate Planungs-Requests kontrafaktische Tests vor, und Python validiert und führt den Medium-Effort-Plan aus.
Der komplette Code, inklusive Evidence-Generator und Web-App, liegt in diesem GitHub-Repository.
HarborCart ist ein fiktiver Shop. Seine checkout-api bedient Warenkorbseiten, Bestellstatus und POST /checkout, das ein externes Payment-Gateway belastet. Alle diese Endpunkte teilen sich einen PostgreSQL-Pool mit 15 Verbindungen pro Instanz.
Ein Deploy geht live, und fünf Minuten später liefert das Gateway für etwa 90 Sekunden 503 zurück. Die Checkout-Latenz steigt über 30 Sekunden, während der Pool bei 15 von 15 steht. Den Zahlungsanbieter zu beschuldigen ist naheliegend, und das Gateway ist tatsächlich ausgefallen.
Die verborgene Ursache liegt eine Ebene tiefer. Das Deploy erlaubte fehlgeschlagenen POST-Charges bis zu dreimal zu wiederholen, also vier Versuche insgesamt, ohne Pause, während der Handler seine Datenbankverbindung weiter hält. Langsam scheiternde Charges blockieren nun Verbindungen für 30 Sekunden oder mehr, bis der Pool erschöpft ist und auch Warenkorbseiten, die das Gateway nie aufrufen, ausfallen.
Ab hier nutze ich drei Begriffe konsistent. Der Auslöser ist die temporäre Gateway-Störung. Das Wiederholen von Checkout-POSTs während knappe Datenbankverbindungen gehalten werden, ist der Verstärkungsmechanismus; die Erschöpfung des gemeinsamen Connection-Pools ist der Systemfehler.
Der Agent startet mit dem Alert, einem Monitoring-Screenshot und einem Architekturdiagramm. Alles Weitere kommt über Tools: Logs, Traces, fünf Metriken, Deployment-Metadaten, der Git-Diff und ein Runbook. Drei konkurrierende Erklärungen sind im Belegsatz angelegt: eine Inventurwarnung, eine Frontend-Warnung und mögliche CPU-Sättigung.
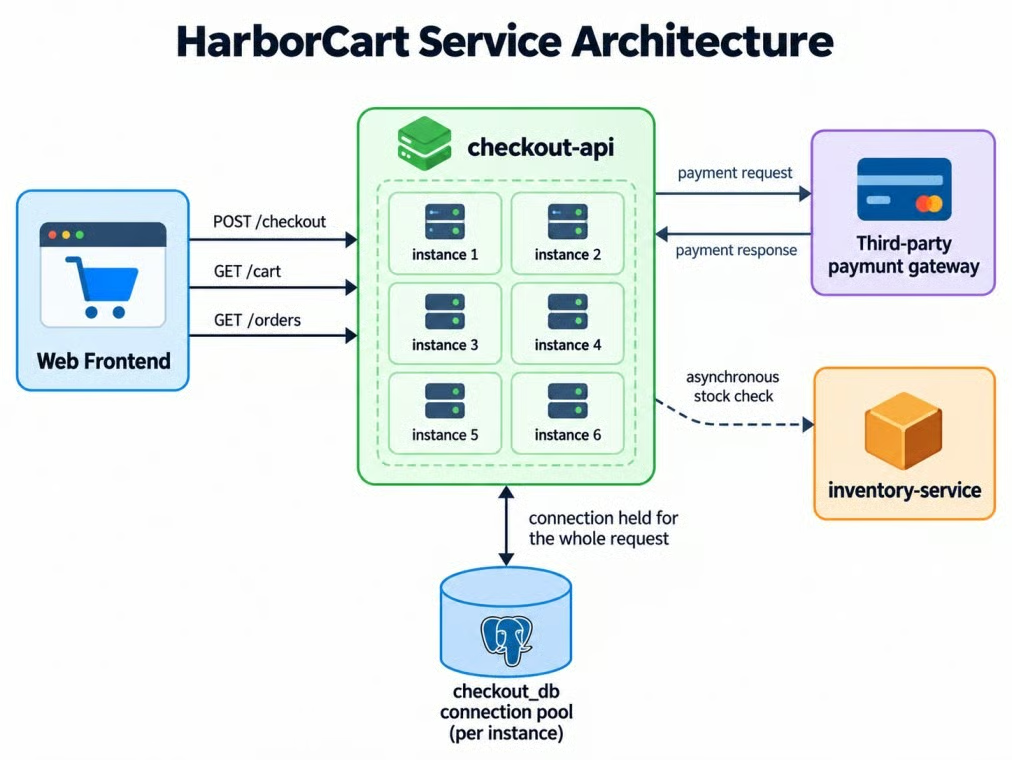
HarborCart-Checkout-Pfad und Shared Pool. Bild: Autor.
Das Diagramm sagt, dass die Verbindung über den gesamten Request gehalten wird. Es sagt nicht, dass das ein Problem ist; die Untersuchung muss das herleiten.
Definiere Erfolg, bevor du den Agenten baust. Ein korrekter Report muss:
POST-Retries ermöglichteDu brauchst Python 3.10 oder neuer und einen Anthropic API Key mit Zugriff auf claude-opus-5-5. Diese PowerShell-Befehle klonen das Projekt und installieren die gepinnten Abhängigkeiten, inklusive anthropic 1.8.0. Wenn du Amazon Bedrock nutzt, lies zuerst die FAQs, da mehrere Features nicht portierbar sind.
git clone https://github.com/KhalidAbdelaty/opus-5-5-api-tutorial.git
cd opus-5-5-api-tutorial
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
Unter macOS oder Linux aktivierst du mit source .venv/bin/activate und kopierst mit cp .env.example .env. Füge deinen Key zu .env hinzu, python-dotenv lädt ihn für das SDK; unsere Anleitung zu Umgebungsvariablen erklärt das Muster. Wenn du Claude bereits aus Python aufgerufen hast, kannst du den nächsten Abschnitt überspringen — er bestätigt nur das Setup.
Die kleinste sinnvolle Anfrage bestätigt den Key und zeigt, was zurückkommt.
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "A checkout API returns HTTP 503 right after a deploy. Name the first two things to check."}],
)
print([block.type for block in response.content])
text = "".join(block.text for block in response.content if block.type == "text")
In dieser Anfrage enthält die Antwort thinking- und text-Blöcke. Wähle Blöcke nach Typ aus, statt response.content[0] zu lesen.
Tool-Calling-Agenten kombinieren die Messages API von Claude mit Python-Funktionen, die den Datenzugriff steuern. Die Anwendung folgt einer Regel: Claude entscheidet, welche Belege es braucht, und Python entscheidet, worauf es zugreifen darf.
Unser Leitfaden zur Agent-Harness-Engineering behandelt breitere Tool-Grenzen und -Schleifen; HarborCart hält seine Tools schreibgeschützt und auf diesen Incident begrenzt.
Jedes Tool liest einen festen Belegsatz und liefert ein begrenztes JSON-Resultat. Log- und Trace-Queries geben maximal 200 Zeilen plus Zählung zurück, Metrik-Queries maximal 60 Punkte.
Programmgesteuertes Tool-Calling unterstützt kein strict: true, daher teilst du die Tools in zwei Gruppen. Behalte Evidence-Kontrollen und das Untersuchungs-Stopp-Tool strikt und nur direkt aufrufbar. Logs, Traces und Metriken laufen rein über Codeausführung, was Claude einen klaren Pfad für große Evidence-Queries gibt.
{"name": "finish_investigation", "strict": True,
 "allowed_callers": ["direct"],
 "input_schema": {"type": "object",
                  "properties": {"summary": {"type": "string"}},
                  "required": ["summary"],
                  "additionalProperties": False}},
{"name": "query_traces",
 "allowed_callers": ["code_execution_20260120"],
 "input_schema": {...}},
allowed_callers leitet das Modell, ist aber keine Sicherheitsgrenze. Python prüft den Caller vor jedem Tool-Run und weist direkte Query-Calls ab. Programmgesteuerte Calls umgehen auch strikte Validierung, daher müssen Query-Funktionen ihre Argumente weiterhin selbst prüfen.
Die Anwendung taggt jedes akzeptierte Tool-Resultat, verwirft Findings, die fehlende Belege zitieren, und akzeptiert Doku-URLs nur, wenn die Websuche sie geliefert hat. Python, nicht das Modell, zeichnet Replay-Outputs auf.
Wie im Migrationsabschnitt erwähnt, belasse tool_choice auf auto. Erkläre im Prompt, wann ein Tool gilt, und nutze strikte Schemas, wo Argumente exakt sein müssen.
Die Schleife sendet die Konversation, führt ggf. tool_use-Blöcke aus, hängt die Ergebnisse an und wiederholt. Hänge die Assistant-Blöcke unverändert an, inklusive Thinking, und solange Program-Code pausiert, übergib die container-ID nur mit tool_result-Blöcken.
Die Investigations-Anfrage enthält Vision, Tools, Websuche, Effort und das Task-Budget, aber kein Output-Schema. So bleiben zitationsfähige Suchergebnisse von strukturiertem JSON-Output getrennt, während das stabile Request-Präfix das Prompt Caching aktiv hält:
request = dict(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=[{"type": "text", "text": SYSTEM_PROMPT, "cache_control": {"type": "ephemeral"}}],
    tools=investigation_tools,
    cache_control={"type": "ephemeral"},
    thinking={"type": "adaptive", "display": "updates"},
    output_config={
        "effort": "medium",
        "task_budget": {"type": "tokens", "total": 20_000},
    },
    betas=["task-budgets-2026-03-13", "thinking-display-updates-2026-08-18"],
)Hänge Dashboard und Architekturdiagramm als Base64-PNGs an die erste User-Message. Weise Claude an, alles aus einem Bild Gelesene als Hypothese zu behandeln und mit query_metrics zu bestätigen.
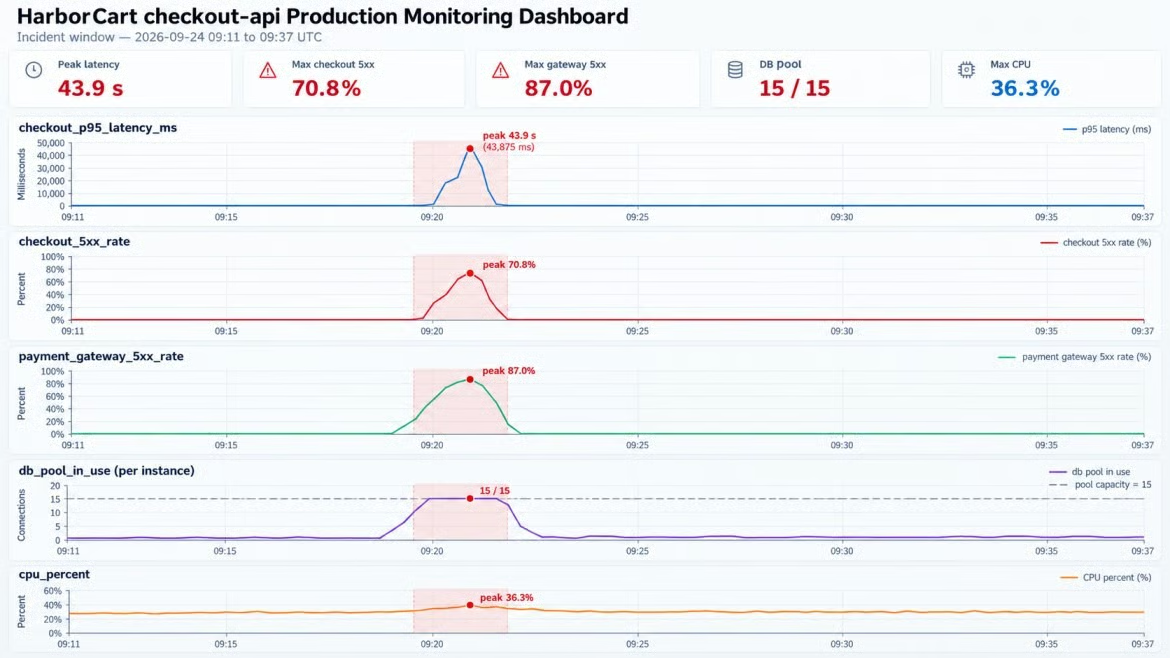
Dashboard zeigt Pool-Sättigung, konstante CPU. Bild: Autor.
Dashboard und Metrik-Queries nutzen dieselben Datenquellen. Die CPU bleibt nahe 30%, während der Pool voll ist — das spricht gegen "Host überlastet", noch bevor eine Query läuft.
Der Screenshot zeigt nur, wo man suchen sollte; die Zahlenreihe entscheidet, ob die Beobachtung hält. Vision erzeugt eine Hypothese, Metriken testen sie.
Für image-first Workflows siehe unser Agentic-Vision-Tutorial. HarborCart nutzt Vision nur zur Wahl der nächsten Metrik.
Programmgesteuertes Tool-Calling lässt Claude Python-Code in einem Code-Execution-Container ausführen und deine Tools als Funktionen aufrufen. Rohdaten bleiben in der Sandbox, und nur die ausgegebenen Prints des Codes erreichen das Modell.
Der Agent schreibt kurze Skripte, die fehlschlagende Traces ziehen und nur die Zählungen pro Endpunkt ausgeben. In einer kompletten Untersuchung reduzierte programmgesteuertes Tool-Calling die serialisierten Belege zum Modell um 98,8%. Die Tool-Ergebnisse waren 42,9 KB, die Zusammenfassungen 0,5 KB — ein Byte-Maß statt abgerechneter Input-Tokens.
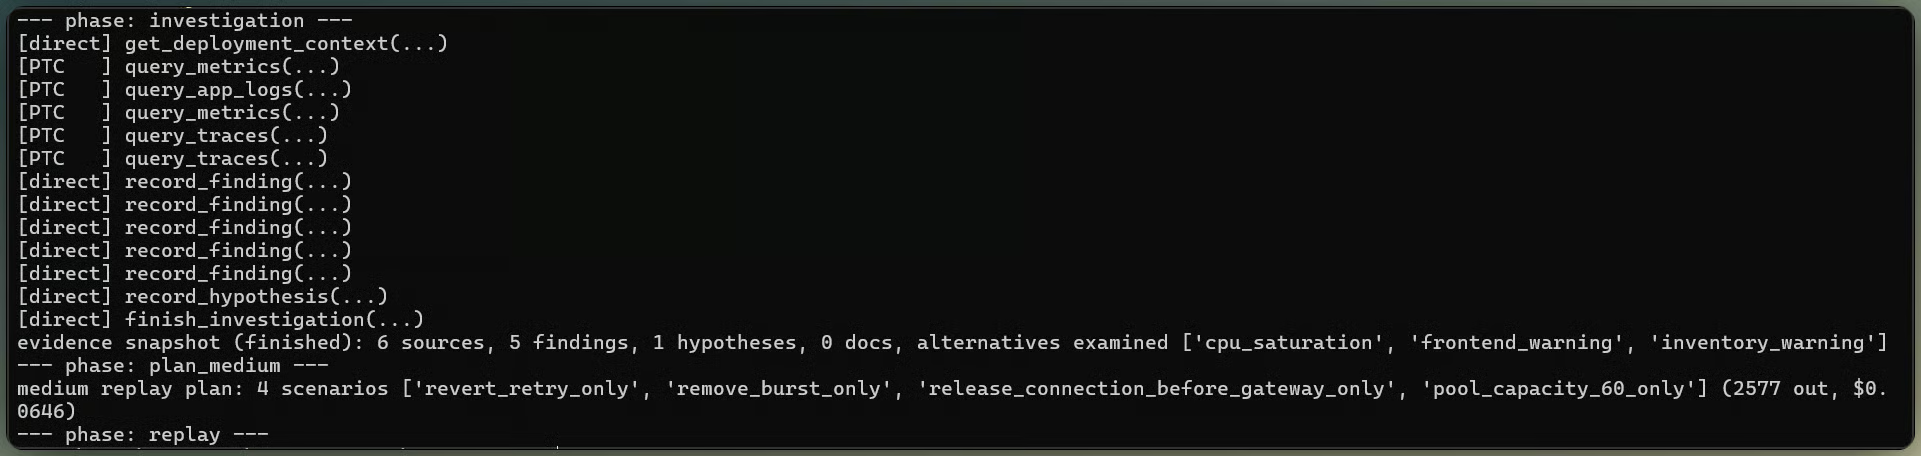
Tool-Calls verdichten die Incident-Belege. Bild: Autor.
Die Anwendung stellt eine eingeschränkte Websuche für Retry-Bibliothekssemantik bereit. Claude rief sie in der Endbewertung nicht auf, daher stützt sich die gemessene Diagnose auf Diff, Metriken, Logs und Traces. Die urllib3-Referenz bestätigt unabhängig, dass allowed_methods=None jeden Verb wiederholt und backoff_factor=0 die Wartezeit entfernt, aber diese Seite ist kein Teil der gemessenen Belege.
Ein kontrafaktisches Replay spielt den Incident-Traffic erneut ab, entfernt eine vermutete Ursache und prüft, ob der Fehler verschwindet. Es macht aus "Diese Linien steigen gemeinsam" einen Test.
Das Replay nutzt dasselbe Traffic-Muster. In der Vergleichsansicht unten ändert jedes Szenario genau eine Bedingung, und die Anwendung kontrolliert, welche Änderungen erlaubt sind.
Die Zusammenfassung trennt Gateway-503s von Pool-Timeouts sowie Checkout-503s von Lese-Endpunkten für Warenkorb und Bestellung. Diese Aufteilung ermöglicht es dem Modell, Auslöser und Verstärker zu unterscheiden.
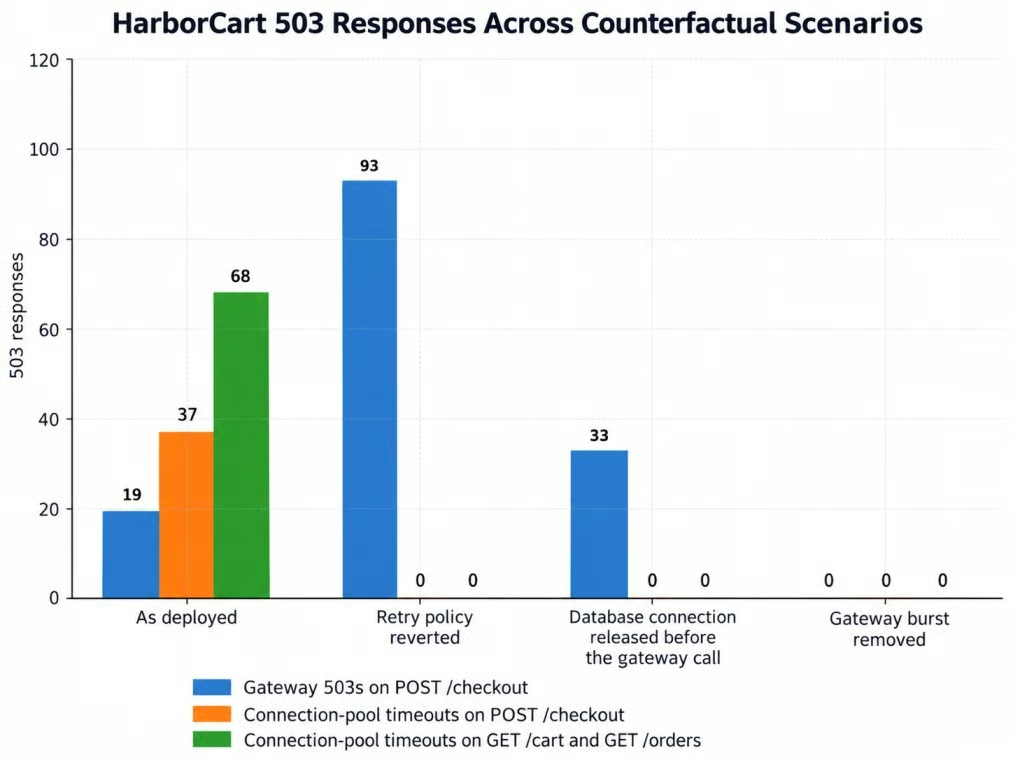
Jedes Replay ändert genau eine Sache. Bild: Autor.
Das Baseline-Replay erzeugte 124 mal 503: 105 Pool-Timeouts, darunter 68 Ausfälle auf Lese-Endpunkten, und 19 Gateway-Fehler. Das Zurücksetzen der Retry-Policy entfernte alle Pool-Timeouts und Lese-Fehler, brachte aber 93 Gateway-503s beim Checkout zum Vorschein. Das Freigeben der Verbindung vor dem Gateway-Call entfernte ebenfalls Pool-Fehler und ließ 33 Gateway-503s zurück, und das Entfernen des Gateway-Bursts ergab keine Fehler.
Das Replay zeigt den Trade-off: Ein Rollback schützt den Shared Pool, lässt aber mehr Checkout-Fehler durch. Nutze es als Übergangslösung. Füge dann einen Idempotency Key hinzu, damit eine wiederholte Abbuchung nicht doppelt belastet, und halte die Verbindung nicht während des Gateway-Calls.
Der Systemprompt fordert ein Replay an, aber ein Prompt erzwingt nichts. Die Schleife prüft, ob Replay-Belege vorliegen, und weist eine ungetestete Diagnose zurück.
Behalte diese Prüfung in Python. Ein schärferer Prompt kann die Compliance verbessern, garantiert sie aber nicht.
Effort steuert, wie viel Claude pro Schritt nachdenkt, und ein Task-Budget legt fest, wie viel Arbeit die gesamte Schleife kosten darf. Unser Claude Opus 5 API-Tutorial vergleicht alle fünf Effort-Level; hier bekommen Medium und High dieselben Vor-Replay-Belege.
In der Produktion bleibt es bei medium. Vor dem Replay bittet die Anwendung Medium und High, aus denselben Belegen einen Kausaltest zu entwerfen. Ausgeführt wird nur die Medium-Empfehlung; die High-Antwort dient nur dem Vergleich.
Die High-Anfrage nutzt eine per-Message-Änderung an output_config.effort hinter mid-conversation-output-config-2026-07-01. Sie sieht die Medium-Antwort nicht.
Beide Effort-Level wählten dieselbe Hypothese und dieselben drei Kern-Replay-Szenarien. High nutzte im Schnitt 2.631 Output-Tokens gegenüber 2.307 bei Medium und kostete rund 11% mehr, ohne den Kausaltest zu ändern.
Wähle ein Task-Budget auf Basis beobachteter Nutzung statt zu raten. HarborCarts größte ungebremste Untersuchung verbrauchte 13.322 gezählte Tokens, inklusive Modell-Output und Tool-Result-Texte, die Claude sah. Mit 25% Puffer ergibt das 16.653, unter Anthropics Minimum von 20.000 Tokens, daher ist das konfigurierte Budget 20.000.
Halte Turns und verstrichene Zeit als Anwendungslimits fest. Der Experiment-Runner startete keine neue Arbeit mehr, nachdem die aufgezeichneten Kosten $2,50 erreicht hatten. Das ist keine harte Obergrenze, weil ein bereits laufender Request darüber enden kann.
Die finale Antwort nutzt strukturierte Outputs. Ihr flaches Schema deckt Urteil, Ursache, verworfene Hypothesen, Belege und Fix ab. Kosten und Latenz bleiben außen vor, weil die Anwendung sie misst.
Websuche-Zitationen und output_config.format können nicht in einem Request kombiniert werden: Zitationen brauchen ineinander verschachtelte Content-Blocks, während das Schema JSON verlangt. HarborCart untersucht daher ohne Output-Schema. Es speichert Findings mit Quellenbindung und Replay-Ergebnissen und sendet nur diese verifizierten Belege an einen zweiten Request ohne Tools oder Websuche.
import json

report_response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16_000,
    system=report_instructions,
    messages=[{"role": "user", "content": json.dumps(verified_evidence)}],
    output_config={
        "effort": "medium",
        "format": {"type": "json_schema", "schema": report_schema},
    },
)
Die zweite Anfrage braucht nur verifizierte Belege, daher ist es nicht notwendig, den kompletten Investigation-Cache zu bewahren.
Erlaube "inconclusive" im Feld verdict. Ein Report darf nicht zu einer verifizierten Diagnose gezwungen werden, wenn das Replay die Erklärung widerlegt.
Das Schema validiert die Form des Reports, während das Replay die Diagnose validiert. Eine Verweigerung kommt ebenfalls mit HTTP 200 und stop_reason: "refusal" und kann nicht zu deinem Schema passen, also prüfe die Stop-Reason vor dem Parsen.
Alle drei finalen Reports fanden den kausalen Kernmechanismus und schlossen die drei Alternativerklärungen aus. Zwei erfüllten alle acht Checks; der dritte erzielte 6/8, weil er die explizite POST-Retry-Konfigurationsänderung ausließ und den Deployment-Diff nicht zitierte. Darum bleibt das Offline-Scoring getrennt von der Schema-Validierung: Valides JSON und die richtige Diagnose können trotzdem einen unvollständigen Report ergeben.
Die Reports identifizieren auch ein zweites Risiko: Das Wiederholen einer Abbuchung kann Kundinnen und Kunden doppelt belasten. RFC 9110 definiert POST nicht als inhärent idempotent und rät von automatischen Retries ab, sofern der Client nicht weiß, dass die Operation gefahrlos wiederholbar ist. Ein vom Zahlungsanbieter unterstützter Idempotency Key ist ein gängiger Weg, diese Retries sicherer zu machen.
Unser Streamlit-Tutorial deckt das Interface-Setup ab. HarborCarts Interface zeigt Investigationsereignisse, die Medium- und High-Replay-Pläne, Replay-Ergebnisse, den finalen Report und die Kosten. Für Status zwischen Tool-Calls beschreibt der Claude Opus 5.5 Prompting-Guide display: "updates"; die App rendert zudem Tool-Events, wenn ein Update-Block leer ist.
Lerne mit DataCamp
Kurs
Kurs
Kurs