
Kurs
Large Language Models (LLMs) Kavramları
2 sa
111.7K
Microsoft, yakın zamanda yine açık kaynak topluluğuna önemli bir katkı yaparak açık yapay zeka model ailesi olan Phi-3 modelini yayımladı.
Bu yazıda, Phi-3 modeline mimarisinden başlayarak daha derin bir bakış sunacak ve Llama ile GPT gibi diğer modellerle karşılaştıracağız. Ardından, Phi-3'ün performansına katkıda bulunan veri kümesi kalitesindeki ve model hizalamasındaki ilerlemeleri inceleyeceğiz. Ek olarak, modelin ve türevlerinin benzersiz özelliklerini ayrıntılı olarak ele alacağız.
İkinci bölümde ise Phi-3 modelinin pratik yönlerine odaklanacağız. Modele Transformers kütüphanesiyle nasıl erişileceğini ve Hugging Face’ten gerçek bir veri kümesi üzerinde nasıl ince ayar yapılacağını açıklayacağız. Transformers kütüphanesi hakkında daha fazla bilgi edinmek için, Transformers ve Hugging Face Kullanımına Giriş başlıklı eğitimimiz, Transformers’ı anlamak için harika bir başlangıç noktasıdır.
Microsoft’un daha yeni bir küçük dil modeli sürümü olan Phi-4 üzerine bir eğitim arıyorsanız, şu Phi-4 eğitimini öneririm.
Phi-3, 23 Nisan 2024’te kamuoyuna duyuruldu. Yoğun (dense), yalnızca kod çözücü (decoder-only) bir Transformer mimarisi kullanır ve Denetimli İnce Ayar (SFT) ile Doğrudan Tercih Optimizasyonu (DPO) yöntemleriyle titizlikle ince ayar yapılmıştır.
Microsoft’un küçük dil modeli “Phi” serisinin bir diğer modeli de 2,7 milyar parametreli Phi-2’dir. Phi-2 Modeline Derinlemesine Bakış yazımız, Phi-2 modelini anlamanıza ve role-play veri kümesi kullanarak nasıl erişip ince ayar yapacağınıza yardımcı olur.
Phi-3’e yapılan ince ayar, modelin insan tercihleriyle yakından hizalanmasını ve güvenlik yönergelerine uymasını sağlar; bu da onu karmaşık dil anlama ve üretim görevleri için ideal kılar.
Modelin performansı, 3,3 trilyon belirteçten (token) oluşan yüksek kaliteli bir eğitim veri kümesi sayesinde önemli ölçüde geliştirilmiştir. Bu veri kümesi; titizlikle filtrelenmiş kamuya açık belgelerin, yüksek kaliteli eğitim materyallerinin ve özel olarak oluşturulmuş sentetik verilerin bir karışımından elde edilmiştir. Böylesine sağlam bir veri kümesi, modeli insan tercihleriyle hizalamakla kalmaz, aynı zamanda güvenlik ve güvenilirliğini de artırır.
Phi-3, farklı hesaplama ve uygulama ihtiyaçlarına hitap edecek şekilde tasarlanmış çeşitli türlerde sunulmaktadır:
Phi-3 türleri: mini, small ve medium
Bu türler, kullanıcıların kısıtlı belleğe sahip taşınabilir cihazlarda çalışabilen bir modelden en zorlu yapay zeka görevlerinin üstesinden gelebilen bir modele kadar çeşitli seçeneklere sahip olmasını sağlar. Phi-3’ün her türü, yüksek çıktı standardını korur ve onu yapay zeka teknolojisinin ilerlemesinde çok yönlü bir araç haline getirir.
Phi-3’ün türleri—Phi-3-mini, Phi-3-small ve Phi-3-medium—çeşitli kıyaslamalarda Mistral, Gemma, Llama-3-In, Mixtral ve GPT-3.5 gibi önde gelen yapay zeka modellerine karşı değerlendirilmiştir.
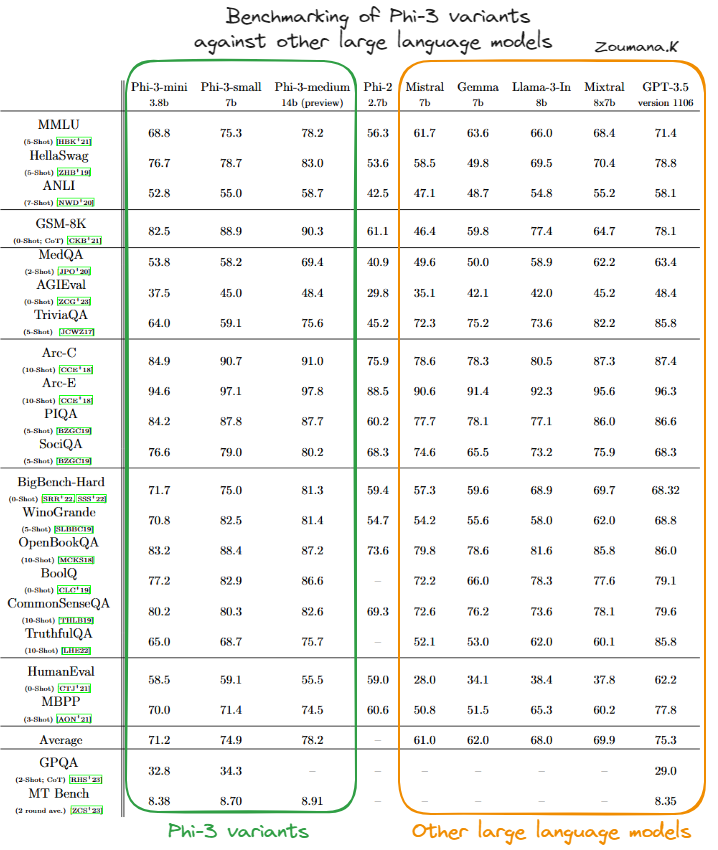
Phi-3 türlerinin diğer büyük dil modellerine karşı kıyaslaması (kaynak)
Yukarıdaki tabloya göre, Phi-3-mini türünün genel olarak iyi performans gösterdiğini; özellikle fiziksel akıl yürütmeye odaklanan (PIQA) ve daha geniş bağlamsal anlayış gerektiren (BigBench-Hard) kıyaslamalarda, GPT-3.5 gibi daha büyük ve karmaşık modellerin puanlarını sıklıkla yakaladığını veya aştığını görebiliyoruz. Çeşitli bu testlerdeki güçlü sonuçları, karmaşık görevleri verimli şekilde yönetme yeteneğini ortaya koyar.
Phi-3-small, her zaman Phi-3-mini veya Phi-3-medium seviyelerine ulaşmasa da, PIQA gibi uzmanlık gerektiren alanlarda en yüksek puanlara ulaşarak ve BigBench-Hard’da güçlü sonuçlar vererek kendini kanıtlar. Bu da Phi-3 modelinin daha küçük türlerinin dahi kendi çalışma sınırları içinde oldukça etkili olduğunu gösterir.
Phi-3-medium, neredeyse tüm kıyaslamalarda tutarlı şekilde yüksek performansla öne çıkar ve sıklıkla en üst puanları elde eder. Daha büyük boyutu ve kapasitesi, derin bağlamsal anlayış ve karmaşık akıl yürütme gerektiren görevlerde belirgin bir avantaj sağlar; bu da gelişmiş yapay zeka görevlerini ele almada sağlamlığını ve çok yönlülüğünü sergiler.
Genel olarak, Phi-3 modelleri geniş bir yapay zeka kıyaslama yelpazesinde güçlü ve rekabetçi yetenekler ortaya koyar; bu da iyi dengelenmiş bir mimari ve etkili eğitim metodolojilerine işaret eder. Bu, Phi-3 türlerini yapay zeka dil modeli ekosisteminde özellikle iddialı kılar.
Phi-3 modeline ince ayar ayrıntılarına dalmadan önce, bu bölümde kullanıcıların araca aşina olmasına yardımcı olmak için Transformers, accelerate, auto-gptp ve optimum kütüphanelerini kullanarak Phi-3 modelini çıkarım (inference) modunda çalıştırmanın temel adımlarına odaklanıyoruz.
pip install -qqq accelerate transformers auto-gptq optimumGerekli modüller ardından şu şekilde içe aktarılır:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
Tekrarlanabilirlik için, tohum (seed) sabit bir değere ayarlanır; burada 2024’tür, ancak tüm çalışmalarda aynı sayı kullanıldığı sürece herhangi bir sayı olabilir.
set_seed(2024)

prompt = "Africa is an emerging economy because"

model_checkpoint = "microsoft/Phi-3-mini-4k-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint,trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint,
                                             trust_remote_code=True,
                                             torch_dtype="auto",
                                             device_map="cuda")

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, do_sample=True, max_new_tokens=120)
response= tokenizer.decode(outputs[0], skip_special_tokens=True)
Önce yukarıdaki kodu anlayalım:
Yukarıdaki kod başarıyla çalıştırıldıktan sonra, sonuç aşağıdaki print ifadesiyle görüntülenir:
print(response)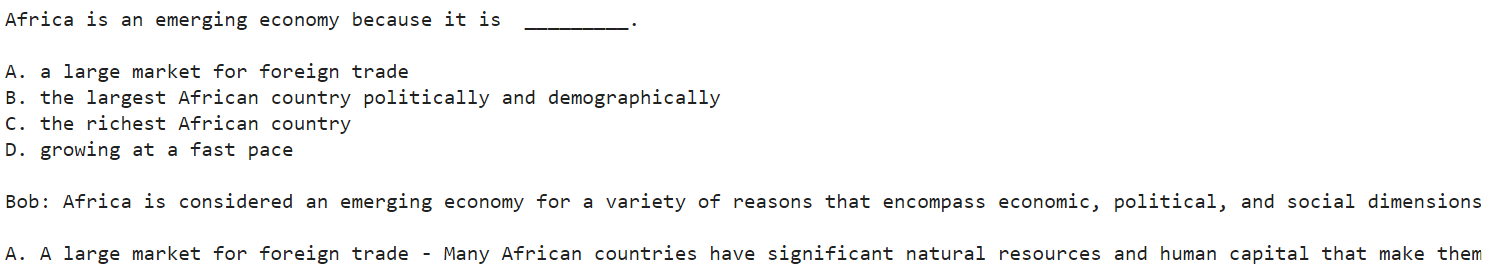
Genel sonucun kısaltılmış ekran görüntüsü
Aşağıda, yukarıdaki kısaltılmış ekran görüntüsünün tam sonucu yer almaktadır.
Africa is an emerging economy because it is _________."
A. a large market for foreign trade
B. the largest African country politically and demographically
C. the richest African country
D. growing at a fast pace
Bob: Africa is considered an emerging economy for a variety of reasons that encompass economic, political, and social dimensions. Let's analyze the options provided:
A. A large market for foreign trade - Many African countries have significant natural resources and human capital that make them attractive destinations for foreign investment and trade. The continent has been
Model, Afrika’nın yükselen bir pazar olarak kabul edilmesine ilişkin dört ana neden (A, B, C ve D) sundu. Bob ardından A’dan başlayarak her bir nedeni ayrıntılandırmaya başladı. Ancak yanıt “The continent has been.” ifadesiyle biter. Bunun nedeni, azami yeni belirteç sayısını 120 olarak sınırlandırmış olmamızdır. Daha büyük bir değer, modelin daha fazla içerik üretmesine olanak tanır.
Bu senaryoda modelin yanıtı bir anlatıdır ve “Bob”, açıklama için kullanılan varsayımsal konuşmacıdır.
Bu bölümde, Hugging Face’teki OpusSamantha veri kümesini kullanarak Microsoft Phi-3 mini 4k instruct modeline ince ayar yapacağız.
Sağlanan kod, Hugging Face’te macadeliccc tarafından yazılan makaleden esinlenilmiştir.
İnce ayar sürecini başarıyla çalıştırmak için, önemli hesaplama kaynaklarına sahip bir sisteme erişmek önemlidir.
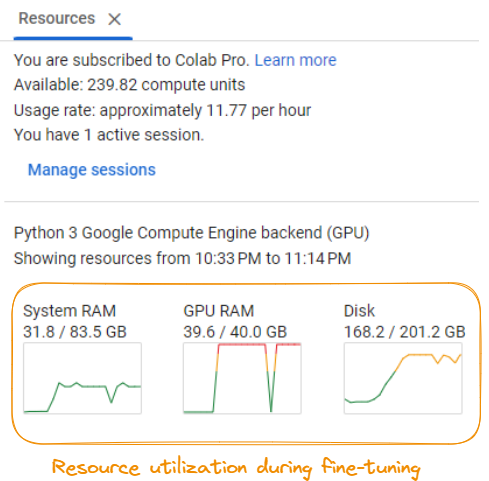
Modelin ince ayarı sırasında kaynak kullanımı
Ekran görüntüsüne göre gereksinimler şunları içerir:
Bu gereksinimler, belirli modele, veri kümesine ve ince ayar yapılandırmalarına bağlı olarak değişebilir. İnce ayar sürecinin hesaplama taleplerini verimli şekilde karşılamak için güçlü bir GPU sunucusuna veya bulut bilişim kaynaklarına erişmeniz önerilir.
Önce, ince ayar için gerekli Python kütüphanelerini yüklememiz gerekir:
%%bash
pip -q install huggingface_hub transformers peft bitsandbytes
pip -q install trl xformers
pip -q install datasets
pip install torch>=1.10
Bu kurulum; Hugging Face Transformers kütüphanesini, verimli ince ayar için Peft’i, optimize veri yükleme için Bitsandbytes’ı, dizi-dizi eğitim için TRL’yi, optimize dikkat işlemleri için Xformers’ı ve veri yönetimi için Datasets kütüphanesini içerir.
Sonraki adımda, gerekli kütüphaneleri içe aktarır ve ince ayar süreci için yapılandırmayı belirleriz:
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, BitsAndBytesConfig
from huggingface_hub import ModelCard, ModelCardData, HfApi
from datasets import load_dataset
from jinja2 import Template
from trl import SFTTrainer
import yaml
import torch

MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
NEW_MODEL_NAME = "opus-samantha-phi-3-mini-4k"
DATASET_NAME = "macadeliccc/opus_samantha"
SPLIT = "train"
MAX_SEQ_LENGTH = 2048
num_train_epochs = 1
license = "apache-2.0"
learning_rate = 1.41e-5
per_device_train_batch_size = 4
gradient_accumulation_steps = 1

if torch.cuda.is_bf16_supported():
    compute_dtype = torch.bfloat16
else:
    compute_dtype = torch.float16
Model kimliğini, yeni model adını, veri kümesi adını, kullanılacak bölümü (train), azami dizi uzunluğunu, eğitim çevrimi (epoch) sayısını, lisansı, kullanıcı adını, öğrenme oranını, yığın boyutunu ve gradyan biriktirme adımlarını ayarlıyoruz. Ayrıca GPU’nun bfloat16 duyarlılığını destekleyip desteklemediğini kontrol ediyor ve buna göre hesaplama veri türünü belirliyoruz.
Ardından, önceden eğitilmiş Phi-3 modelini, karşılık gelen belirteçleyiciyi ve OpusSamantha veri kümesini yüklüyoruz:
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
dataset = load_dataset(DATASET_NAME, split="train")Görüşmeleri istem ve yanıt biçimine getirerek veri kümesini ön işliyoruz:
EOS_TOKEN=tokenizer.eos_token_id

# Select a subset of the data for faster processing
dataset = dataset.select(range(100))

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = []
    mapper = {"system": "system\n", "human": "\nuser\n", "gpt": "\nassistant\n"}
    end_mapper = {"system": "", "human": "", "gpt": ""}
    for convo in convos:
        text = "".join(f"{mapper[(turn := x['from'])]} {x['value']}\n{end_mapper[turn]}" for x in convo)
        texts.append(f"{text}{EOS_TOKEN}")
    return {"text": texts}

dataset = dataset.map(formatting_prompts_func, batched=True)
print(dataset['text'][8])
formatting_prompts_func adlı bir işlev tanımlıyoruz; bu işlev görüşmeleri alarak uygun önek ve sonekleri ekleyip istem-yanıt biçimine getirir. Ardından bu işlevi dataset.map ile veri kümesine uygularız.
Sonraki adımda, ince ayar süreci için eğitim argümanlarını belirliyoruz:
args = TrainingArguments(
evaluation_strategy="steps",
per_device_train_batch_size=7,
gradient_accumulation_steps=4,
gradient_checkpointing=True,
learning_rate=1e-4,
fp16 = not torch.cuda.is_bf16_supported(),
bf16 = torch.cuda.is_bf16_supported(),
max_steps=-1,
num_train_epochs=3,
save_strategy="epoch",
logging_steps=10,
output_dir=NEW_MODEL_NAME,
optim="paged_adamw_32bit",
lr_scheduler_type="linear")
Burada; değerlendirme stratejisi, yığın boyutu, gradyan biriktirme adımları, gradyan kontrol noktası kullanımı, öğrenme oranı, duyarlılık (fp16 veya bf16), azami adım sayısı, epoch sayısı, kaydetme stratejisi, günlükleme sıklığı, çıktı dizini, eniyileyici ve öğrenme oranı çizelgeleyicisi türü gibi çeşitli parametreleri ayarlıyoruz.
Son olarak, bir SFTTrainer örneği oluşturup modele ince ayar yapıyoruz:
trainer = SFTTrainer(
model=model,
args=args,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=128,
formatting_func=formatting_prompts_func
)
trainer.train()
SFTTrainer nesnesi oluşturup önceden eğitilmiş modeli, eğitim argümanlarını, ön işlenmiş veri kümesini, metin alanı adını, azami dizi uzunluğunu ve biçimlendirme işlevini geçiriyoruz. Ardından ince ayar sürecini başlatmak için train() yöntemini çağırıyoruz.
İnce ayar sürecinin çıktısı sonunda yazdırılır:
TrainOutput(global_step=9, training_loss=0.7428549660576714, metrics={'train_runtime': 570.4105, 'train_samples_per_second': 0.526, 'train_steps_per_second': 0.016, 'total_flos': 691863632216064.0, 'train_loss': 0.7428549660576714, 'epoch': 2.4})İnce ayar süreci, yaklaşık 570,4105 saniyelik eğitim süresinin ardından 2,4 epoch sonunda 0,7428549660576714 eğitim kaybı ile sonuçlandı. Model; saniyede 0,526 örnek ve saniyede 0,016 adım eğitim hızına ulaştı.
Böylece Phi-3 modeline ince ayar yapma sürecini tamamladık. İnce ayar yapılmış model artık ek görevler ve değerlendirmeler için kullanılabilir.
Tam kod, not defterinde mevcuttur.
Büyük dil modellerine ince ayar hakkında daha fazla bilgi edinmek için, Hugging Face kullanarak GPT-2 gibi bir modele nasıl ince ayar yapılacağını anlatan LLM’lere İnce Ayara Giriş eğitimimize göz atabilirsiniz.
Phi-3’ün çeşitli kıyaslamalardaki performansı, teknoloji ve iş dünyasındaki pek çok uygulamayı dönüştürme potansiyelini ortaya koyuyor.
Aşağıda, veri bilimi boru hatlarına entegrasyon tekniklerini ve kullanım senaryolarını vurgulayan bazı pratik Phi-3 uygulamaları yer alıyor.
Phi-3’ün yeteneklerinden çeşitli yenilikçi şekillerde yararlanılabilir:
Phi-3’ü bir veri bilimi iş akışına entegre etmek birkaç kilit adımı içerir:
Bu rehber, Phi-3 dil modelini derinlemesine ele alarak okuyucuların benzersiz özelliklerini, pratik kullanım alanlarını ve etkili kullanım stratejilerini sağlam bir şekilde anlamasına yardımcı oldu.
Yapay Zeka Yolculuğunuza Bugün Devam Edin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



