
Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.7K
Kürzlich hat Microsoft der Open-Source-Community erneut einen wichtigen Beitrag geliefert und sein Phi-3-Modell veröffentlicht, eine Familie offener KI-Modelle.
In diesem Artikel erhältst du tiefere Einblicke in das Phi-3-Modell: Wir starten mit der Architektur und vergleichen es mit Modellen wie Llama und GPT. Anschließend schauen wir uns die Fortschritte bei Datenqualität und Modellausrichtung an, die zur Leistung von Phi-3 beitragen. Außerdem gehen wir auf die besonderen Merkmale des Modells und seiner Varianten im Detail ein.
Im zweiten Teil wird es praktisch. Wir zeigen, wie du über die Transformers-Bibliothek auf das Modell zugreifst und es mit einem realen Datensatz von Hugging Face feinabstimmst. Wenn du mehr über die Transformers-Bibliothek erfahren möchtest, ist unser Tutorial An Introduction to Using Transformers and Hugging Face ein guter Einstieg.
Wenn du ein Tutorial zu Phi-4 suchst, der neueren Version von Microsofts Small Language Model, empfehle ich dieses Tutorial zu Phi-4.
Phi-3 wurde am 23. April 2024 der Öffentlichkeit vorgestellt. Es nutzt eine dichte, rein dekoderbasierte Transformer-Architektur und wurde sorgfältig per Supervised Fine-Tuning (SFT) und Direct Preference Optimization (DPO) abgestimmt.
Ein weiteres Modell aus Microsofts „Phi“-Reihe kleiner Sprachmodelle ist Phi-2 mit 2,7 Milliarden Parametern. Unser Tutorial A Deep Dive into the Phi-2 Model erklärt Phi-2 und zeigt, wie du es mit dem Role-Play-Datensatz nutzen und feinabstimmen kannst.
Das Feintuning von Phi-3 sorgt dafür, dass es eng an menschlichen Präferenzen ausgerichtet ist und Sicherheitsrichtlinien einhält – ideal für komplexes Sprachverständnis und Textgenerierung.
Die Leistung des Modells profitiert stark von einem hochwertigen Trainingsdatensatz mit 3,3 Billionen Tokens. Dieser stammt aus einer Mischung streng gefilterter öffentlicher Dokumente, hochwertiger Lernmaterialien und speziell erzeugter synthetischer Daten. Ein derart robuster Datensatz stärkt nicht nur die Ausrichtung an menschlichen Präferenzen, sondern erhöht auch Sicherheit und Zuverlässigkeit.
Phi-3 ist in mehreren Varianten erhältlich, zugeschnitten auf unterschiedliche Rechen- und Anwendungsszenarien:
Phi-3-Varianten: mini, small und medium
Damit hast du die Wahl: vom Modell für portable Geräte mit wenig Speicher bis hin zur Variante für besonders fordernde KI-Aufgaben. Alle Phi-3-Versionen liefern konsistent hochwertige Ergebnisse und sind vielseitige Werkzeuge für den Fortschritt der KI.
Die Leistung der Phi-3-Varianten – Phi-3-mini, Phi-3-small und Phi-3-medium – wurde in verschiedenen Benchmarks gegen prominente KI-Modelle wie Mistral, Gemma, Llama-3-In, Mixtral und GPT-3.5 bewertet.
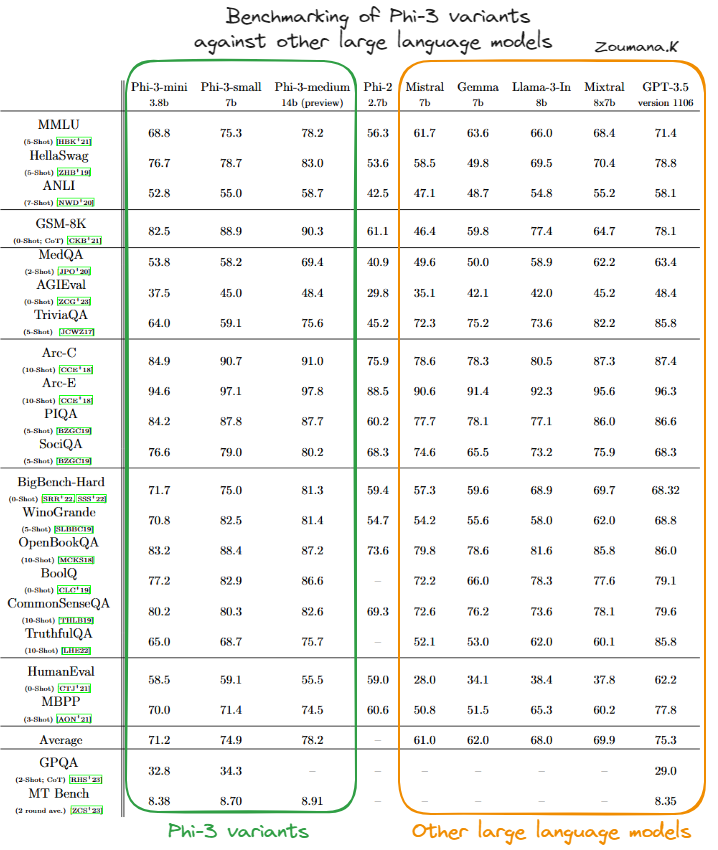
Benchmarking der Phi-3-Varianten gegenüber anderen großen Sprachmodellen (Quelle)
Wie die Tabelle zeigt, schneidet die Variante Phi-3-mini insgesamt sehr gut ab und erreicht oft die Werte größerer, komplexerer Modelle wie GPT-3.5 – besonders in Benchmarks zu physikalischem Schließen (PIQA) und breiterem Kontextverständnis (BigBench-Hard). Die starke Leistung über verschiedene Tests hinweg zeigt, dass sie komplexe Aufgaben effizient bewältigen kann.
Phi-3-small erreicht zwar nicht in allen Fällen das Niveau von Phi-3-mini oder Phi-3-medium, behauptet sich aber in spezialisierten Bereichen wie PIQA – hier erzielt es die höchsten Werte seiner Peergroup – und BigBench-Hard. Das legt nahe, dass auch die kleineren Phi-3-Varianten innerhalb ihrer Einsatzgrenzen sehr effektiv sind.
Phi-3-medium überzeugt mit konstant hoher Performance in fast allen Benchmarks und liegt häufig an der Spitze. Die größere Größe und Kapazität bringen klare Vorteile bei Aufgaben mit tiefem Kontextverständnis und komplexem Reasoning – ein Beleg für Robustheit und Vielseitigkeit bei anspruchsvollen KI-Aufgaben.
In Summe zeigen die Phi-3-Modelle starke, wettbewerbsfähige Fähigkeiten über ein breites Spektrum an Benchmarks – ein Hinweis auf eine ausgewogene Architektur und wirksame Trainingsmethoden. Damit zählen die Phi-3-Varianten zu den besonders leistungsfähigen Sprachmodellen.
Bevor wir ins Feintuning von Phi-3 einsteigen, konzentriert sich dieser Abschnitt auf die wichtigsten Schritte, um Phi-3 im Inferenzmodus mit den Bibliotheken Transformers, accelerate, auto-gptq und optimum auszuführen – ideal, um dich mit dem Tool vertraut zu machen.
pip install -qqq accelerate transformers auto-gptq optimumAnschließend importieren wir die benötigten Module wie folgt:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
Zur Reproduzierbarkeit setzen wir den Seed auf einen festen Wert – hier 2024. Grundsätzlich ist jede Zahl möglich, solange sie in allen Läufen gleich bleibt.
set_seed(2024)

prompt = "Africa is an emerging economy because"

model_checkpoint = "microsoft/Phi-3-mini-4k-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint,trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint,
                                             trust_remote_code=True,
                                             torch_dtype="auto",
                                             device_map="cuda")

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, do_sample=True, max_new_tokens=120)
response= tokenizer.decode(outputs[0], skip_special_tokens=True)
Was macht der obige Code?
Nach erfolgreicher Ausführung wird das Ergebnis mit dem folgenden Print-Statement ausgegeben:
print(response)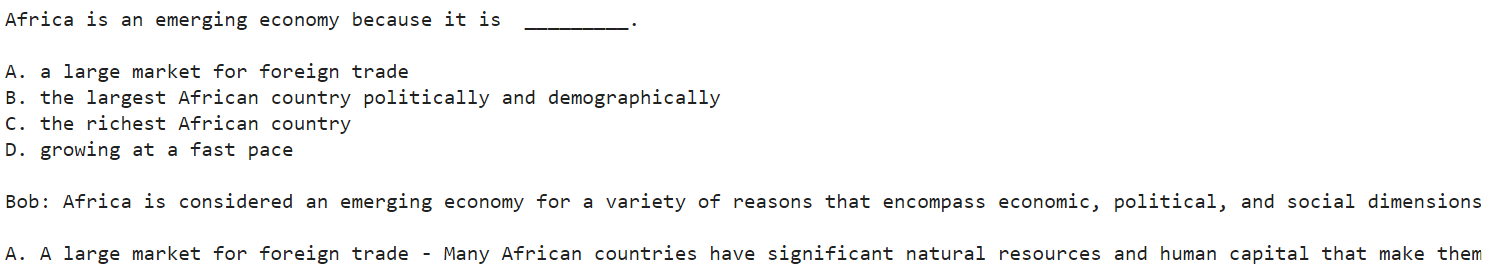
Gekürzter Screenshot des Gesamtergebnisses
Unten findest du das vollständige Ergebnis des oben gekürzten Screenshots.
Africa is an emerging economy because it is _________.
A. a large market for foreign trade
B. the largest African country politically and demographically
C. the richest African country
D. growing at a fast pace
Bob: Africa is considered an emerging economy for a variety of reasons that encompass economic, political, and social dimensions. Let's analyze the options provided:
A. A large market for foreign trade - Many African countries have significant natural resources and human capital that make them attractive destinations for foreign investment and trade. The continent has been
Das Modell liefert vier Hauptgründe (A, B, C und D), warum Afrika als Emerging Market gilt. „Bob“ beginnt anschließend mit der Erläuterung, ausgehend von A. Die Antwort endet jedoch mit „The continent has been.“ – weil wir die maximale Anzahl neuer Tokens auf 120 begrenzt haben. Ein größerer Wert gibt dem Modell mehr Spielraum für umfangreichere Ausgaben.
Die Antwort des Modells ist hier eine Erzählung, und „Bob“ ist der hypothetische Sprecher für die Erklärung.
In diesem Abschnitt feinabstimmen wir das Microsoft Phi-3 mini 4k instruct-Modell mit dem OpusSamantha-Datensatz von Hugging Face.
Der bereitgestellte Code ist inspiriert vom Hugging-Face-Artikel von macadeliccc.
Für ein erfolgreiches Feintuning brauchst du ein System mit viel Rechenleistung.
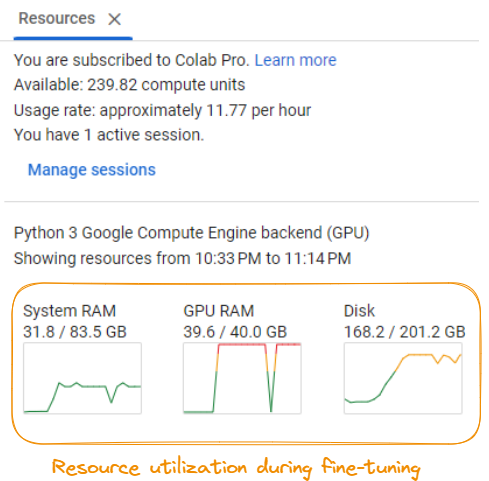
Ressourcennutzung während des Feintunings
Laut Screenshot gelten folgende Anforderungen:
Diese Anforderungen können je nach Modell, Datensatz und Feintuning-Konfiguration variieren. Empfehlenswert ist ein leistungsstarker GPU-Server oder Cloud-Ressourcen, um den Prozess effizient zu bewältigen.
Zuerst installieren wir die benötigten Python-Bibliotheken fürs Feintuning:
%%bash
pip -q install huggingface_hub transformers peft bitsandbytes
pip -q install trl xformers
pip -q install datasets
pip install torch>=1.10
Damit installierst du die Transformers-Bibliothek von Hugging Face, Peft für effizientes Feintuning, Bitsandbytes für optimierte Datenverarbeitung, TRL für Sequence-to-Sequence-Training, Xformers für optimierte Attention-Operationen und Datasets für die Datenhandhabung.
Als Nächstes importieren wir die benötigten Bibliotheken und legen die Konfiguration fürs Feintuning fest:
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, BitsAndBytesConfig
from huggingface_hub import ModelCard, ModelCardData, HfApi
from datasets import load_dataset
from jinja2 import Template
from trl import SFTTrainer
import yaml
import torch

MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
NEW_MODEL_NAME = "opus-samantha-phi-3-mini-4k"
DATASET_NAME = "macadeliccc/opus_samantha"
SPLIT = "train"
MAX_SEQ_LENGTH = 2048
num_train_epochs = 1
license = "apache-2.0"
learning_rate = 1.41e-5
per_device_train_batch_size = 4
gradient_accumulation_steps = 1

if torch.cuda.is_bf16_supported():
    compute_dtype = torch.bfloat16
else:
    compute_dtype = torch.float16
Wir setzen Model-ID, neuen Modellnamen, Datensatz, Split (train), maximale Sequenzlänge, Anzahl Epochen, Lizenz, Lernrate, Batch-Größe und die Anzahl der Gradient Accumulation Steps. Zudem prüfen wir, ob die GPU bfloat16 unterstützt, und setzen den Berechnungstyp entsprechend.
Nun laden wir das vortrainierte Phi-3-Modell, den zugehörigen Tokenizer und den OpusSamantha-Datensatz:
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
dataset = load_dataset(DATASET_NAME, split="train")Wir formatieren die Dialoge des Datensatzes in Prompts und Antworten:
EOS_TOKEN=tokenizer.eos_token_id

# Select a subset of the data for faster processing
dataset = dataset.select(range(100))

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = []
    mapper = {"system": "system\n", "human": "\nuser\n", "gpt": "\nassistant\n"}
    end_mapper = {"system": "", "human": "", "gpt": ""}
    for convo in convos:
        text = "".join(f"{mapper[(turn := x['from'])]} {x['value']}\n{end_mapper[turn]}" for x in convo)
        texts.append(f"{text}{EOS_TOKEN}")
    return {"text": texts}

dataset = dataset.map(formatting_prompts_func, batched=True)
print(dataset['text'][8])
Wir definieren formatting_prompts_func, das die Konversationen in ein Prompt-Response-Format bringt und passende Präfixe/Suffixe ergänzt. Danach wenden wir die Funktion mit dataset.map auf den Datensatz an.
Jetzt legen wir die Trainingsparameter für das Feintuning fest:
args = TrainingArguments(
evaluation_strategy="steps",
per_device_train_batch_size=7,
gradient_accumulation_steps=4,
gradient_checkpointing=True,
learning_rate=1e-4,
fp16 = not torch.cuda.is_bf16_supported(),
bf16 = torch.cuda.is_bf16_supported(),
max_steps=-1,
num_train_epochs=3,
save_strategy="epoch",
logging_steps=10,
output_dir=NEW_MODEL_NAME,
optim="paged_adamw_32bit",
lr_scheduler_type="linear")
Hier definieren wir unter anderem Evaluationsstrategie, Batch-Größe, Gradient Accumulation, Gradient Checkpointing, Lernrate, Präzision (fp16 oder bf16), maximale Schritte, Epochenzahl, Speicherrhythmus, Logging-Frequenz, Ausgabeverzeichnis, Optimizer und den Typ des Lernratenplans.
Zum Schluss erstellen wir eine Instanz des SFTTrainer und starten das Training:
trainer = SFTTrainer(
model=model,
args=args,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=128,
formatting_func=formatting_prompts_func
)
trainer.train()
Wir erzeugen ein SFTTrainer-Objekt, übergeben das vortrainierte Modell, die Trainingsargumente, den vorverarbeiteten Datensatz, das Textfeld, die maximale Sequenzlänge und die Formatierungsfunktion. Danach startet train() das Feintuning.
Am Ende wird die Ausgabe des Feintunings ausgegeben:
TrainOutput(global_step=9, training_loss=0.7428549660576714, metrics={'train_runtime': 570.4105, 'train_samples_per_second': 0.526, 'train_steps_per_second': 0.016, 'total_flos': 691863632216064.0, 'train_loss': 0.7428549660576714, 'epoch': 2.4})Nach 2,4 Epochen ergab sich ein Training Loss von 0,7428549660576714 bei einer Laufzeit von rund 570,4105 Sekunden. Die Trainingsgeschwindigkeit lag bei 0,526 Samples pro Sekunde und 0,016 Schritten pro Sekunde.
Damit ist das Feintuning von Phi-3 abgeschlossen. Das feinabgestimmte Modell kann nun für weitere Aufgaben und Evaluierungen genutzt werden.
Der vollständige Code steht im Notebook bereit.
Wenn du mehr über das Feintuning großer Sprachmodelle lernen willst, führt dich unser Tutorial An Introductory Guide to Fine-Tuning LLMs Schritt für Schritt durch das Feintuning eines Modells wie GPT-2 mit Hugging Face.
Die starke Performance von Phi-3 in unterschiedlichen Benchmarks zeigt das Potenzial, vielfältige Technologie- und Business-Anwendungen voranzutreiben.
Hier sind einige praktische Einsatzfelder von Phi-3 – inklusive Use-Case-Szenarien und Integrationsansätzen in Data-Science-Pipelines.
Die Fähigkeiten von Phi-3 lassen sich auf mehrere innovative Arten nutzen:
Für die Integration von Phi-3 in Data-Science-Workflows sind mehrere Schritte wichtig:
Dieser Leitfaden bietet einen umfassenden Blick auf das Sprachmodell Phi-3 – von seinen Besonderheiten über praxisnahe Anwendungen bis zu Strategien für den effektiven Einsatz. So hast du eine solide Grundlage, um Phi-3 gezielt in deinen Projekten zu nutzen.
Setze deine KI-Reise heute fort!
Kurs
Kurs
Kurs