
कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
112.1K
हाल ही में, Microsoft ने अपने Phi-3 मॉडल—ओपन AI मॉडलों के एक परिवार—को जारी करके एक बार फिर ओपन-सोर्स समुदाय में महत्वपूर्ण योगदान दिया है।
इस लेख में, हम Phi-3 मॉडल की गहराई से पड़ताल करेंगे—इसकी आर्किटेक्चर से शुरुआत करते हुए और इसे Llama व GPT जैसे अन्य मॉडलों से तुलना करेंगे। इसके बाद, हम डेटा सेट की गुणवत्ता और मॉडल एलाइनमेंट में हुए उन सुधारों पर चर्चा करेंगे जो Phi-3 के प्रदर्शन में योगदान करते हैं। साथ ही, हम मॉडल और इसके वेरिएंट्स की विशिष्ट विशेषताओं पर विस्तार से बात करेंगे।
दूसरे भाग में, हम Phi-3 मॉडल के व्यावहारिक पहलुओं में उतरेंगे। हम बताएंगे कि Transformers लाइब्रेरी का उपयोग करके मॉडल तक कैसे पहुँचा जाए और Hugging Face के वास्तविक-जीवन डेटा सेट पर इसे फाइन-ट्यून कैसे किया जाए। Transformers लाइब्रेरी के बारे में अधिक जानने के लिए, हमारा ट्यूटोरियल An Introduction to Using Transformers and Hugging Face Transformers को समझने के लिए एक अच्छा शुरुआती बिंदु है।
यदि आप Phi-4 पर ट्यूटोरियल ढूँढ रहे हैं, जो Microsoft के छोटे भाषा मॉडल का एक अधिक हालिया संस्करण है, तो मैं यह Phi-4 पर ट्यूटोरियल सुझाता हूँ।
Phi-3 को 23 अप्रैल, 2024 को सार्वजनिक रूप से प्रस्तुत किया गया था। यह डेंस, डिकोडर-ओनली Transformer आर्किटेक्चर का उपयोग करता है और इसे Supervised Fine-Tuning (SFT) और Direct Preference Optimization (DPO) के ज़रिये सावधानीपूर्वक फाइन-ट्यून किया गया है।
Microsoft के “Phi” छोटे भाषा मॉडलों की श्रृंखला का एक और मॉडल Phi-2 है, जो 2.7 बिलियन पैरामीटर का मॉडल है। हमारा A Deep Dive into the Phi-2 Model Phi-2 मॉडल की समझ प्रदान करता है और यह बताता है कि रोल-प्ले डेटा सेट का उपयोग करके इसे कैसे एक्सेस और फाइन-ट्यून किया जाए।
Phi-3 का फाइन-ट्यूनिंग सुनिश्चित करता है कि यह मानव वरीयताओं के साथ क़रीबी रूप से संरेखित हो और सुरक्षा दिशानिर्देशों का पालन करे, जिससे यह जटिल भाषा समझ और जनरेशन कार्यों के लिए उपयुक्त बनता है।
उच्च-गुणवत्ता वाले प्रशिक्षण डेटा सेट—3.3 ट्रिलियन टोकन—से मॉडल के प्रदर्शन में उल्लेखनीय सुधार होता है। यह डेटा सेट सख्ती से फ़िल्टर किए गए सार्वजनिक दस्तावेज़ों, उच्च-गुणवत्ता वाली शैक्षिक सामग्री, और विशेष रूप से निर्मित सिंथेटिक डेटा के मिश्रण से तैयार किया गया है। इतना सक्षम डेटा सेट न केवल मॉडल को मानव वरीयताओं के अनुरूप लाता है, बल्कि इसकी सुरक्षा और विश्वसनीयता भी बढ़ाता है।
Phi-3 कई वेरिएंट्स में उपलब्ध है, जिनमें से प्रत्येक अलग-अलग गणनात्मक और अनुप्रयोग आवश्यकताओं को पूरा करने के लिए बनाया गया है:
Phi-3 वेरिएंट्स: mini, small और medium
ये वेरिएंट्स सुनिश्चित करते हैं कि उपयोगकर्ताओं के पास विकल्पों की एक श्रृंखला हो—चाहे उन्हें सीमित मेमोरी वाले पोर्टेबल डिवाइस पर चलने में सक्षम मॉडल चाहिए या सबसे चुनौतीपूर्ण AI कार्यों को संभालने में सक्षम मॉडल। Phi-3 का प्रत्येक वेरिएंट उच्च-गुणवत्ता का आउटपुट बनाए रखता है, जिससे यह AI तकनीक की प्रगति में एक बहुमुखी उपकरण बनता है।
Phi-3 मॉडल वेरिएंट्स—Phi-3-mini, Phi-3-small, और Phi-3-medium—का प्रदर्शन विभिन्न बेंचमार्क्स पर Mistral, Gemma, Llama-3-In, Mixtral, और GPT-3.5 जैसे कई प्रमुख AI मॉडलों के विरुद्ध आंका गया है।
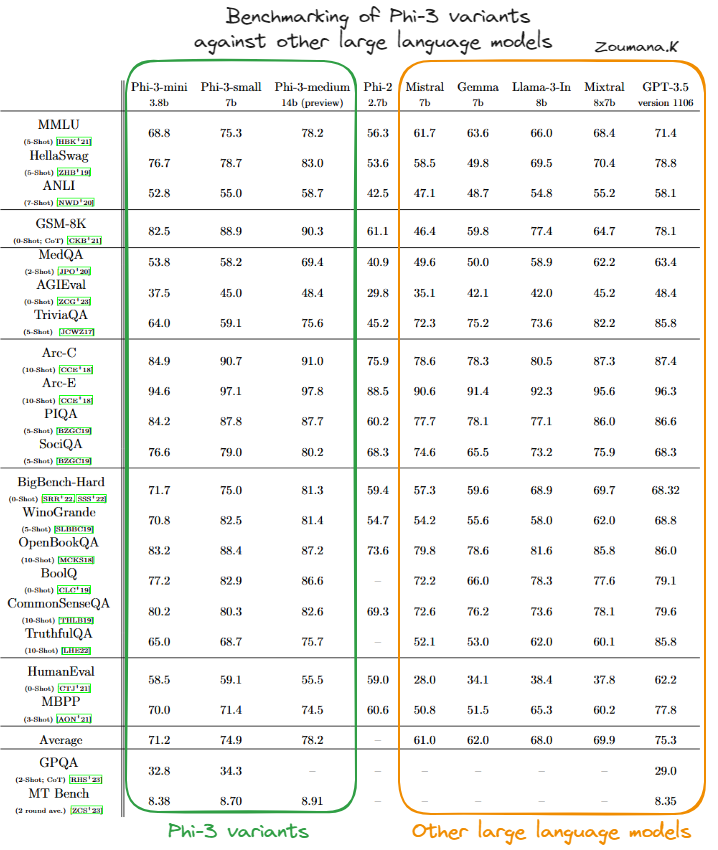
अन्य बड़े भाषा मॉडलों के विरुद्ध Phi-3 वेरिएंट्स का बेंचमार्किंग (स्रोत)
ऊपर दी गई तालिका के आधार पर, हम देख सकते हैं कि Phi-3-mini वेरिएंट सामान्यतः अच्छा प्रदर्शन करता है, और अक्सर GPT-3.5 जैसे बड़े और अधिक जटिल मॉडलों के स्कोर की बराबरी करता है या उन्हें पार कर जाता है—विशेषकर फिज़िकल रीजनिंग (PIQA) और व्यापक प्रसंगीय समझ (BigBench-Hard) पर केंद्रित बेंचमार्क्स में। जटिल कार्यों को कुशलता से संभालने की इसकी क्षमता इन विविध परीक्षणों में इसके मज़बूत प्रदर्शन से स्पष्ट है।
हालाँकि Phi-3-small हमेशा Phi-3-mini या Phi-3-medium के स्तर तक नहीं पहुँचता, फिर भी यह PIQA जैसे विशेष क्षेत्रों में, जहाँ यह अपने समकक्षों में सर्वोच्च स्कोर प्राप्त करता है, और BigBench-Hard में अपना दमखम दिखाता है। यह संकेत देता है कि Phi-3 के छोटे वेरिएंट भी अपने परिचालन दायरे में अत्यंत प्रभावी हैं।
Phi-3-medium लगभग सभी बेंचमार्क्स में लगातार उच्च प्रदर्शन के साथ अलग दिखाई देता है और अक्सर शीर्ष स्कोर प्राप्त करता है। इसका बड़ा आकार और क्षमता उन कार्यों में महत्वपूर्ण बढ़त प्रदान करती है जिन्हें गहरी प्रसंगीय समझ और जटिल तर्क की आवश्यकता होती है, जिससे उन्नत AI कार्यों को संभालने में इसकी मजबूती और बहुमुखी प्रतिभा झलकती है।
कुल मिलाकर, Phi-3 मॉडल व्यापक AI बेंचमार्क्स में मज़बूत और प्रतिस्पर्धी क्षमता दिखाते हैं, जो संतुलित आर्किटेक्चर और प्रभावी प्रशिक्षण पद्धतियों का संकेत है। इससे Phi-3 वेरिएंट्स AI भाषा मॉडलों के परिदृश्य में विशेष रूप से प्रभावशाली बनते हैं।
Phi-3 मॉडल के फाइन-ट्यूनिंग में उतरने से पहले, यह अनुभाग Transformers, accelerate, auto-gptp, और optimum लाइब्रेरियों का उपयोग करके Phi-3 मॉडल को इन्फ़रेंस मोड में चलाने के मुख्य चरणों पर केंद्रित है, जो उपयोगकर्ताओं को इस टूल से परिचित होने में मदद कर सकता है।
pip install -qqq accelerate transformers auto-gptq optimumआवश्यक मॉड्यूल्स इस प्रकार इम्पोर्ट किए जाते हैं:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
पुनरुत्पादनशीलता के लिए, seed को एक स्थिर मान पर सेट किया जाता है—हमारे मामले में 2024—लेकिन यह कोई भी संख्या हो सकती है, बशर्ते सभी रन में वही संख्या उपयोग की जाए।
set_seed(2024)

prompt = "Africa is an emerging economy because"

model_checkpoint = "microsoft/Phi-3-mini-4k-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint,trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint,
                                             trust_remote_code=True,
                                             torch_dtype="auto",
                                             device_map="cuda")

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, do_sample=True, max_new_tokens=120)
response= tokenizer.decode(outputs[0], skip_special_tokens=True)
आइए पहले ऊपर दिए गए कोड को समझें:
ऊपर का कोड सफलतापूर्वक चलने के बाद, परिणाम निम्नलिखित प्रिंट स्टेटमेंट से दिखाया जाता है:
print(response)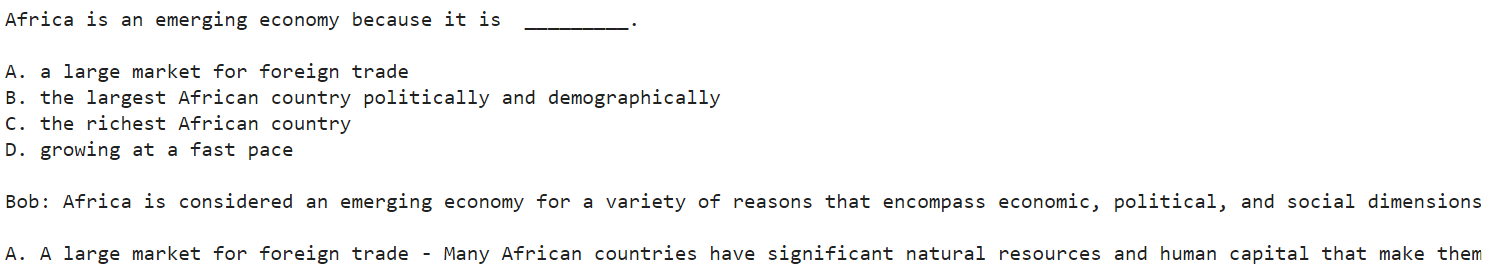
कुल परिणाम का ट्रंकेटेड स्क्रीनशॉट
नीचे ऊपर दिए गए ट्रंकेटेड स्क्रीनशॉट का पूरा परिणाम है।
Africa is an emerging economy because it is _________.
A. a large market for foreign trade
B. the largest African country politically and demographically
C. the richest African country
D. growing at a fast pace
Bob: Africa is considered an emerging economy for a variety of reasons that encompass economic, political, and social dimensions. Let's analyze the options provided:
A. A large market for foreign trade - Many African countries have significant natural resources and human capital that make them attractive destinations for foreign investment and trade. The continent has been
मॉडल ने अफ्रीका को उभरते हुए बाज़ार के रूप में माने जाने के चार मुख्य कारण (A, B, C, और D) दिए हैं। इसके बाद “Bob” ने प्रत्येक कारण पर A से शुरू करते हुए विस्तार करना शुरू किया। हालाँकि, प्रतिक्रिया “The continent has been.” पर समाप्त हो जाती है। इसका कारण यह है कि हमने अधिकतम टोकनों की सीमा 120 रखी है। एक बड़ा मान मॉडल को अधिक सामग्री जनरेट करने की स्वतंत्रता देता है।
इस परिदृश्य में मॉडल की प्रतिक्रिया एक व्याख्या है, और “Bob” स्पष्टीकरण के लिए प्रयुक्त काल्पनिक वक्ता है।
इस अनुभाग में, हम Hugging Face के OpusSamantha डेटा सेट का उपयोग करके Microsoft Phi-3 mini 4k instruct मॉडल को फाइन-ट्यून करेंगे।
दिया गया कोड Hugging Face पर macadeliccc के लेख से प्रेरित है।
फाइन-ट्यूनिंग प्रक्रिया को सफलतापूर्वक चलाने के लिए, पर्याप्त गणनात्मक संसाधनों वाली प्रणाली तक पहुँचना महत्वपूर्ण है।
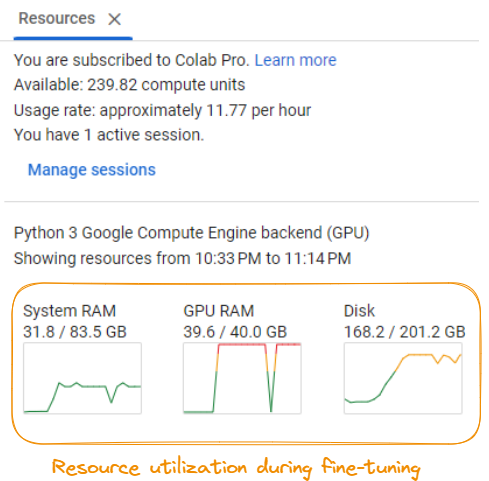
मॉडल की फाइन-ट्यूनिंग के दौरान संसाधन उपयोग
स्क्रीनशॉट के अनुसार, आवश्यकताएँ शामिल हैं:
ये आवश्यकताएँ विशिष्ट मॉडल, डेटा सेट और फाइन-ट्यूनिंग कॉन्फ़िगरेशन पर निर्भर करके बदल सकती हैं। फाइन-ट्यूनिंग प्रक्रिया की गणनात्मक माँगों को कुशलतापूर्वक संभालने के लिए किसी शक्तिशाली GPU सर्वर या क्लाउड कम्प्यूटिंग संसाधनों तक पहुँच रखने की सिफारिश की जाती है।
सबसे पहले, हमें फाइन-ट्यूनिंग के लिए आवश्यक Python लाइब्रेरियाँ इंस्टॉल करनी होंगी:
%%bash
pip -q install huggingface_hub transformers peft bitsandbytes
pip -q install trl xformers
pip -q install datasets
pip install torch>=1.10
यह Hugging Face Transformers लाइब्रेरी, कुशल फाइन-ट्यूनिंग के लिए Peft लाइब्रेरी, अनुकूलित डेटा लोडिंग के लिए Bitsandbytes लाइब्रेरी, सीक्वेंस-टू-सीक्वेंस ट्रेनिंग के लिए TRL लाइब्रेरी, अनुकूलित अटेंशन ऑपरेशंस के लिए Xformers लाइब्रेरी, और डेटा हैंडलिंग के लिए Datasets लाइब्रेरी इंस्टॉल करता है।
इसके बाद, हम आवश्यक लाइब्रेरियाँ इम्पोर्ट करते हैं और फाइन-ट्यूनिंग प्रक्रिया के लिए कॉन्फ़िगरेशन सेट करते हैं:
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, BitsAndBytesConfig
from huggingface_hub import ModelCard, ModelCardData, HfApi
from datasets import load_dataset
from jinja2 import Template
from trl import SFTTrainer
import yaml
import torch

MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
NEW_MODEL_NAME = "opus-samantha-phi-3-mini-4k"
DATASET_NAME = "macadeliccc/opus_samantha"
SPLIT = "train"
MAX_SEQ_LENGTH = 2048
num_train_epochs = 1
license = "apache-2.0"
learning_rate = 1.41e-5
per_device_train_batch_size = 4
gradient_accumulation_steps = 1

if torch.cuda.is_bf16_supported():
    compute_dtype = torch.bfloat16
else:
    compute_dtype = torch.float16
हम मॉडल ID, नए मॉडल का नाम, डेटा सेट का नाम, उपयोग करने वाला स्प्लिट (train), अधिकतम सीक्वेंस लंबाई, प्रशिक्षण epochs की संख्या, लाइसेंस, यूज़रनेम, लर्निंग रेट, बैच साइज़ और ग्रेडिएंट एक्यूमुलेशन स्टेप्स सेट करते हैं। हम यह भी जाँचते हैं कि क्या GPU bfloat16 प्रिसीजन को सपोर्ट करता है और तदनुसार compute dtype सेट करते हैं।
इसके बाद, हम प्री-ट्रेंड Phi-3 मॉडल, संबद्ध टोकनाइज़र और OpusSamantha डेटा सेट लोड करते हैं:
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
dataset = load_dataset(DATASET_NAME, split="train")हम बातचीतों को प्रॉम्प्ट और रिस्पॉन्स में फ़ॉर्मैट करके डेटा सेट का प्रीप्रोसेसिंग करते हैं:
EOS_TOKEN=tokenizer.eos_token_id

# Select a subset of the data for faster processing
dataset = dataset.select(range(100))

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = []
    mapper = {"system": "system\n", "human": "\nuser\n", "gpt": "\nassistant\n"}
    end_mapper = {"system": "", "human": "", "gpt": ""}
    for convo in convos:
        text = "".join(f"{mapper[(turn := x['from'])]} {x['value']}\n{end_mapper[turn]}" for x in convo)
        texts.append(f"{text}{EOS_TOKEN}")
    return {"text": texts}

dataset = dataset.map(formatting_prompts_func, batched=True)
print(dataset['text'][8])
हम एक formatting_prompts_func परिभाषित करते हैं जो बातचीतों को लेता है और उन्हें प्रॉम्प्ट-रिस्पॉन्स फ़ॉर्मैट में बदलता है, उपयुक्त प्रीफ़िक्स और सफ़िक्स जोड़ते हुए। फिर हम इस फ़ंक्शन को dataset.map का उपयोग करके डेटा सेट पर लागू करते हैं।
अगला, हम फाइन-ट्यूनिंग प्रक्रिया के लिए प्रशिक्षण आर्ग्युमेंट्स सेट करते हैं:
args = TrainingArguments(
evaluation_strategy="steps",
per_device_train_batch_size=7,
gradient_accumulation_steps=4,
gradient_checkpointing=True,
learning_rate=1e-4,
fp16 = not torch.cuda.is_bf16_supported(),
bf16 = torch.cuda.is_bf16_supported(),
max_steps=-1,
num_train_epochs=3,
save_strategy="epoch",
logging_steps=10,
output_dir=NEW_MODEL_NAME,
optim="paged_adamw_32bit",
lr_scheduler_type="linear")
यहाँ हम विभिन्न पैरामीटर्स सेट करते हैं, जैसे इवैल्यूएशन स्ट्रैटेजी, बैच साइज़, ग्रेडिएंट एक्यूमुलेशन स्टेप्स, ग्रेडिएंट चेकपॉइंटिंग, लर्निंग रेट, प्रिसीजन (fp16 या bf16), अधिकतम स्टेप्स, epochs की संख्या, सेविंग स्ट्रैटेजी, लॉगिंग फ़्रीक्वेंसी, आउटपुट डायरेक्टरी, ऑप्टिमाइज़र, और लर्निंग रेट शेड्यूलर प्रकार।
अंत में, हम SFTTrainer का एक इंस्टेंस बनाते हैं और मॉडल को फाइन-ट्यून करते हैं:
trainer = SFTTrainer(
model=model,
args=args,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=128,
formatting_func=formatting_prompts_func
)
trainer.train()
हम SFTTrainer ऑब्जेक्ट बनाते हैं, जिसमें प्री-ट्रेंड मॉडल, प्रशिक्षण आर्ग्युमेंट्स, प्रीप्रोसेस्ड डेटा सेट, टेक्स्ट फ़ील्ड का नाम, अधिकतम सीक्वेंस लंबाई और फ़ॉर्मैटिंग फ़ंक्शन पास करते हैं। फिर, फाइन-ट्यूनिंग प्रक्रिया शुरू करने के लिए train() मेथड कॉल करते हैं।
फाइन-ट्यूनिंग प्रक्रिया का आउटपुट अंत में प्रिंट होता है:
TrainOutput(global_step=9, training_loss=0.7428549660576714, metrics={'train_runtime': 570.4105, 'train_samples_per_second': 0.526, 'train_steps_per_second': 0.016, 'total_flos': 691863632216064.0, 'train_loss': 0.7428549660576714, 'epoch': 2.4})फाइन-ट्यूनिंग प्रक्रिया 2.4 epochs के बाद 0.7428549660576714 के प्रशिक्षण लॉस पर पहुँची, और प्रशिक्षण रनटाइम लगभग 570.4105 सेकंड रहा। मॉडल ने 0.526 सैम्पल्स प्रति सेकंड और 0.016 स्टेप्स प्रति सेकंड की प्रशिक्षण गति हासिल की।
यही Phi-3 मॉडल की फाइन-ट्यूनिंग प्रक्रिया का समापन है। फाइन-ट्यून किया गया मॉडल अब आगे के कार्यों और मूल्यांकन के लिए उपयोग किया जा सकता है।
पूरा कोड नोटबुक पेज पर उपलब्ध है।
बड़े भाषा मॉडलों को फाइन-ट्यून करने के बारे में अधिक जानने के लिए, हमारा ट्यूटोरियल An Introductory Guide to Fine-Tuning LLMs Hugging Face का उपयोग करके GPT-2 जैसे मॉडल को फाइन-ट्यून करने की प्रक्रिया से आपको गुज़ारता है।
विविध बेंचमार्क्स में Phi-3 का प्रदर्शन तकनीक और व्यवसाय के विभिन्न अनुप्रयोगों में क्रांति लाने की इसकी क्षमता को रेखांकित करता है।
नीचे Phi-3 के कुछ व्यावहारिक अनुप्रयोग दिए गए हैं, जो उपयोग मामलों और डेटा साइंस पाइपलाइनों में इंटीग्रेशन तकनीकों को उजागर करते हैं।
Phi-3 की क्षमताओं का कई नवीन तरीकों से उपयोग किया जा सकता है:
डेटा साइंस वर्कफ़्लो में Phi-3 का इंटीग्रेशन कई प्रमुख चरणों में होता है:
इस गाइड ने Phi-3 भाषा मॉडल की गहन पड़ताल प्रस्तुत की है, जिससे पाठकों को इसकी विशिष्ट विशेषताओं, व्यावहारिक अनुप्रयोगों और प्रभावी उपयोग रणनीतियों की ठोस समझ मिलती है।
आज ही अपनी AI यात्रा आगे बढ़ाएँ!
कोर्स
कोर्स
कोर्स