
{count, plural, one {Corso} other {Corsi}}
Concetti sui Large Language Models (LLM)
{hours} ore
112.3K
Di recente, Microsoft ha dato nuovamente un contributo significativo alla comunità open-source rilasciando il modello Phi-3, una famiglia di modelli di IA aperti.
In questo articolo approfondiremo il modello Phi-3, partendo dalla sua architettura e confrontandolo con altri modelli come Llama e GPT. Esploreremo poi i progressi nella qualità dei dataset e nell'allineamento del modello che contribuiscono alle prestazioni di Phi-3. Inoltre, parleremo in dettaglio delle caratteristiche uniche del modello e delle sue varianti.
Nella seconda parte entreremo negli aspetti pratici di Phi-3. Spiegheremo come accedere al modello usando la libreria Transformers e come eseguire il fine-tuning su un dataset reale di Hugging Face. Per saperne di più sulla libreria Transformers, il nostro tutorial Introduzione all'uso di Transformers e Hugging Face è un ottimo punto di partenza per capire Transformers.
Se cerchi un tutorial su Phi-4, una versione più recente del piccolo modello linguistico di Microsoft, ti consiglio questo tutorial su Phi-4.
Phi-3 è stato presentato al pubblico il 23 aprile 2024. Adotta un'architettura Transformer densa, solo decoder, ed è stato meticolosamente perfezionato usando Supervised Fine-Tuning (SFT) e Direct Preference Optimization (DPO).
Un altro modello della serie di piccoli modelli linguistici “Phi” di Microsoft è Phi-2, con 2,7 miliardi di parametri. Il nostro Approfondimento sul modello Phi-2 aiuta a comprendere Phi-2 e a imparare come accedervi ed eseguirne il fine-tuning usando il dataset di role-play.
Il fine-tuning di Phi-3 garantisce un elevato allineamento con le preferenze umane e il rispetto delle linee guida di sicurezza, rendendolo ideale per compiti complessi di comprensione e generazione del linguaggio.
Le prestazioni del modello sono notevolmente migliorate da un dataset di addestramento di alta qualità, composto da 3,3 trilioni di token. Questo dataset deriva da un mix di documenti pubblici rigorosamente filtrati, materiali didattici di qualità e dati sintetici creati ad hoc. Un dataset così solido non solo allinea il modello alle preferenze umane, ma ne aumenta anche sicurezza e affidabilità.
Phi-3 è disponibile in diverse varianti, ciascuna pensata per soddisfare esigenze computazionali e applicative differenti:
Varianti di Phi-3: mini, small e medium
Queste varianti garantiscono agli utenti un ventaglio di opzioni, sia che serva un modello in grado di funzionare su dispositivi portatili con memoria limitata, sia che occorra affrontare i compiti di IA più esigenti. Ogni variante di Phi-3 mantiene un alto standard di output, rendendolo uno strumento versatile per l'avanzamento della tecnologia IA.
Le prestazioni delle varianti del modello Phi-3—Phi-3-mini, Phi-3-small e Phi-3-medium—sono state valutate rispetto a diversi modelli di IA di spicco come Mistral, Gemma, Llama-3-In, Mixtral e GPT-3.5 su una varietà di benchmark.
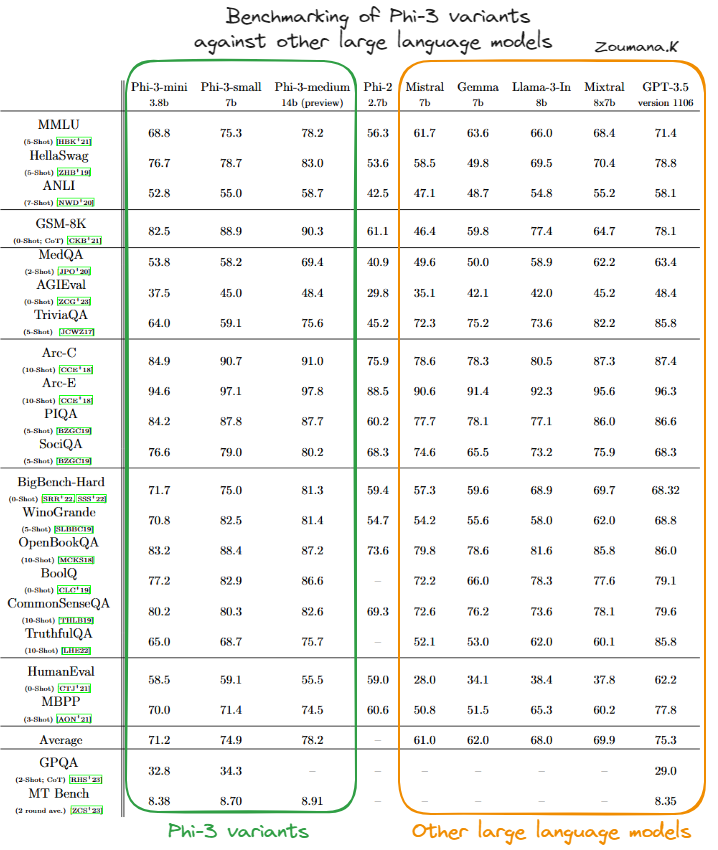
Benchmark delle varianti di Phi-3 rispetto ad altri grandi modelli linguistici (fonte)
In base alla tabella sopra, si vede che la variante Phi-3-mini in genere si comporta bene, spesso eguagliando o superando i punteggi di modelli più grandi e complessi come GPT-3.5, soprattutto nei benchmark focalizzati sul ragionamento fisico (PIQA) e sulla comprensione contestuale più ampia (BigBench-Hard). La sua capacità di gestire compiti complessi in modo efficiente è evidenziata dagli ottimi risultati in questi test eterogenei.
Phi-3-small, pur non raggiungendo sempre i livelli di Phi-3-mini o Phi-3-medium, si difende bene in aree specialistiche come PIQA, dove ottiene i punteggi più alti tra i pari, e BigBench-Hard. Ciò suggerisce che anche le varianti più piccole di Phi-3 sono molto efficaci entro i loro parametri operativi.
Phi-3-medium spicca per prestazioni costantemente elevate in quasi tutti i benchmark, spesso raggiungendo i punteggi migliori. Le sue dimensioni e capacità maggiori sembrano fornire un vantaggio significativo nei compiti che richiedono profonda comprensione contestuale e ragionamento complesso, mostrando robustezza e versatilità nella gestione di attività di IA avanzate.
Nel complesso, i modelli Phi-3 mostrano capacità solide e competitive in un'ampia gamma di benchmark di IA, a indicare un'architettura equilibrata e metodologie di addestramento efficaci. Questo rende le varianti Phi-3 particolarmente rilevanti nel panorama dei modelli linguistici di IA.
Prima di entrare nel fine-tuning del modello Phi-3, questa sezione si concentra sui passaggi principali per eseguire il modello in modalità inferenza usando le librerie Transformers, accelerate, auto-gptp e optimum, così da aiutarti a prendere confidenza con lo strumento.
pip install -qqq accelerate transformers auto-gptq optimumSi importano quindi i moduli necessari come segue:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
Per la riproducibilità, il seed è impostato a un valore costante, che nel nostro caso corrisponde a 2024, ma potrebbe essere qualsiasi numero, purché lo stesso venga usato in tutte le diverse esecuzioni.
set_seed(2024)

prompt = "Africa is an emerging economy because"

model_checkpoint = "microsoft/Phi-3-mini-4k-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint,trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint,
                                             trust_remote_code=True,
                                             torch_dtype="auto",
                                             device_map="cuda")

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, do_sample=True, max_new_tokens=120)
response= tokenizer.decode(outputs[0], skip_special_tokens=True)
Cerchiamo prima di capire il codice qui sopra:
Dopo aver eseguito correttamente il codice sopra, il risultato viene mostrato con la seguente istruzione di stampa:
print(response)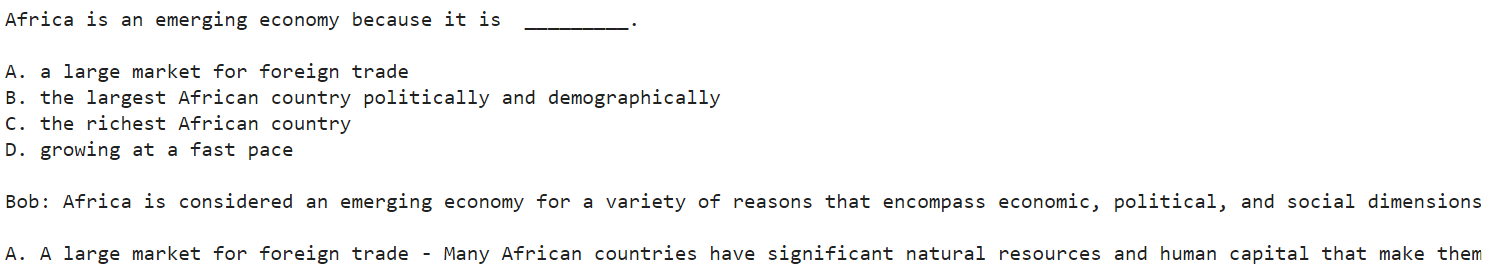
Screenshot troncato del risultato complessivo
Di seguito il risultato completo del precedente screenshot troncato.
Africa is an emerging economy because it is _________.
A. a large market for foreign trade
B. the largest African country politically and demographically
C. the richest African country
D. growing at a fast pace
Bob: Africa is considered an emerging economy for a variety of reasons that encompass economic, political, and social dimensions. Let's analyze the options provided:
A. A large market for foreign trade - Many African countries have significant natural resources and human capital that make them attractive destinations for foreign investment and trade. The continent has been
Il modello ha fornito quattro motivi principali (A, B, C e D) per cui l'Africa è considerata un mercato emergente. Bob ha poi iniziato a elaborare ciascun motivo, partendo da A. Tuttavia, la risposta termina con “The continent has been.” Questo perché abbiamo impostato un limite di 120 come numero massimo di token. Un valore più alto dà al modello maggiore libertà di generare più contenuto.
La risposta del modello in questo scenario è una narrazione e “Bob” è l'oratore ipotetico usato per l'esposizione.
In questa sezione eseguiremo il fine-tuning del modello Microsoft Phi-3 mini 4k instruct utilizzando il dataset OpusSamantha di Hugging Face.
Il codice fornito è ispirato all'articolo su Hugging Face di macadeliccc.
Per eseguire con successo il processo di fine-tuning, è importante disporre di un sistema con risorse computazionali significative.
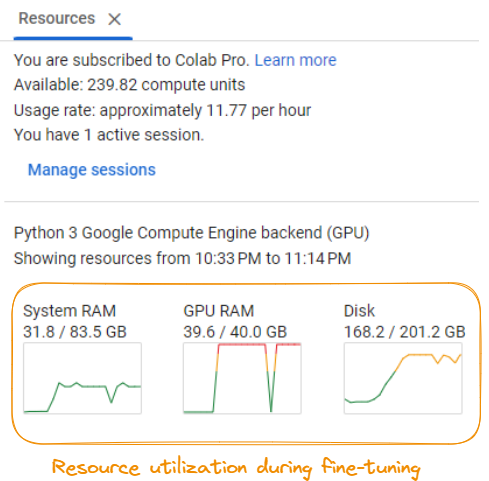
Utilizzo delle risorse durante il fine-tuning del modello
Come da screenshot, i requisiti includono:
Questi requisiti possono variare in base allo specifico modello, al dataset e alle configurazioni di fine-tuning. Si consiglia di avere accesso a un server GPU potente o a risorse di cloud computing per gestire in modo efficiente le esigenze computazionali del processo.
Per prima cosa, dobbiamo installare le librerie Python necessarie per il fine-tuning:
%%bash
pip -q install huggingface_hub transformers peft bitsandbytes
pip -q install trl xformers
pip -q install datasets
pip install torch>=1.10
Questo installa la libreria Transformers di Hugging Face, la libreria Peft per il fine-tuning efficiente, la libreria Bitsandbytes per il caricamento dati ottimizzato, la libreria TRL per il training sequence-to-sequence, la libreria Xformers per operazioni di attenzione ottimizzate e la libreria Datasets per la gestione dei dati.
Successivamente, importiamo le librerie necessarie e impostiamo la configurazione per il processo di fine-tuning:
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, BitsAndBytesConfig
from huggingface_hub import ModelCard, ModelCardData, HfApi
from datasets import load_dataset
from jinja2 import Template
from trl import SFTTrainer
import yaml
import torch

MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
NEW_MODEL_NAME = "opus-samantha-phi-3-mini-4k"
DATASET_NAME = "macadeliccc/opus_samantha"
SPLIT = "train"
MAX_SEQ_LENGTH = 2048
num_train_epochs = 1
license = "apache-2.0"
learning_rate = 1.41e-5
per_device_train_batch_size = 4
gradient_accumulation_steps = 1

if torch.cuda.is_bf16_supported():
    compute_dtype = torch.bfloat16
else:
    compute_dtype = torch.float16
Impostiamo l'ID del modello, il nuovo nome del modello, il nome del dataset, lo split da usare (train), la lunghezza massima della sequenza, il numero di epoche di training, la licenza, il nome utente, il learning rate, la dimensione del batch e gli step di accumulo del gradiente. Verifichiamo anche se la GPU supporta la precisione bfloat16 e impostiamo di conseguenza il tipo di calcolo.
Quindi carichiamo il modello Phi-3 pre-addestrato, il relativo tokenizer e il dataset OpusSamantha:
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
dataset = load_dataset(DATASET_NAME, split="train")Preprocessiamo il dataset formattando le conversazioni in prompt e risposte:
EOS_TOKEN=tokenizer.eos_token_id

# Select a subset of the data for faster processing
dataset = dataset.select(range(100))

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = []
    mapper = {"system": "system\n", "human": "\nuser\n", "gpt": "\nassistant\n"}
    end_mapper = {"system": "", "human": "", "gpt": ""}
    for convo in convos:
        text = "".join(f"{mapper[(turn := x['from'])]} {x['value']}\n{end_mapper[turn]}" for x in convo)
        texts.append(f"{text}{EOS_TOKEN}")
    return {"text": texts}

dataset = dataset.map(formatting_prompts_func, batched=True)
print(dataset['text'][8])
Definiamo una formatting_prompts_func che prende le conversazioni e le formatta in un formato prompt-risposta, aggiungendo i prefissi e i suffissi appropriati. Applichiamo poi questa funzione al dataset usando dataset.map.
Successivamente, impostiamo gli argomenti di training per il processo di fine-tuning:
args = TrainingArguments(
evaluation_strategy="steps",
per_device_train_batch_size=7,
gradient_accumulation_steps=4,
gradient_checkpointing=True,
learning_rate=1e-4,
fp16 = not torch.cuda.is_bf16_supported(),
bf16 = torch.cuda.is_bf16_supported(),
max_steps=-1,
num_train_epochs=3,
save_strategy="epoch",
logging_steps=10,
output_dir=NEW_MODEL_NAME,
optim="paged_adamw_32bit",
lr_scheduler_type="linear")
Qui impostiamo vari parametri come la strategia di valutazione, la dimensione del batch, gli step di accumulo del gradiente, il gradient checkpointing, il learning rate, la precisione (fp16 o bf16), il numero massimo di step, il numero di epoche, la strategia di salvataggio, la frequenza di logging, la directory di output, l'ottimizzatore e il tipo di scheduler del learning rate.
Infine, creiamo un'istanza di SFTTrainer ed eseguiamo il fine-tuning del modello:
trainer = SFTTrainer(
model=model,
args=args,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=128,
formatting_func=formatting_prompts_func
)
trainer.train()
Creiamo un oggetto SFTTrainer, passando il modello pre-addestrato, gli argomenti di training, il dataset pre-processato, il nome del campo testuale, la lunghezza massima della sequenza e la funzione di formattazione. Quindi chiamiamo il metodo train() per avviare il processo di fine-tuning.
L'output del processo di fine-tuning viene stampato alla fine:
TrainOutput(global_step=9, training_loss=0.7428549660576714, metrics={'train_runtime': 570.4105, 'train_samples_per_second': 0.526, 'train_steps_per_second': 0.016, 'total_flos': 691863632216064.0, 'train_loss': 0.7428549660576714, 'epoch': 2.4})Il fine-tuning ha portato a una training loss di 0.7428549660576714 dopo 2,4 epoche, con un tempo di esecuzione di circa 570,4105 secondi. Il modello ha raggiunto una velocità di training di 0,526 campioni al secondo e 0,016 step al secondo.
Con questo si conclude il processo di fine-tuning del modello Phi-3. Il modello perfezionato può ora essere utilizzato per ulteriori compiti e valutazioni.
Il codice completo è disponibile sulla pagina del notebook.
Per approfondire il fine-tuning dei large language model, il nostro tutorial Guida introduttiva al fine-tuning degli LLM ti accompagna nel processo di fine-tuning di un modello come GPT-2 usando Hugging Face.
Le prestazioni di Phi-3 su benchmark eterogenei sottolineano il suo potenziale di rivoluzionare diverse applicazioni in ambito tecnologico e business.
Di seguito alcune applicazioni pratiche di Phi-3, con esempi d'uso e tecniche di integrazione nelle pipeline di data science.
Le capacità di Phi-3 possono essere sfruttate in vari modi innovativi:
Integrare Phi-3 in un flusso di lavoro di data science comporta diversi passaggi chiave:
Questa guida ha offerto un'esplorazione approfondita del modello linguistico Phi-3, aiutandoti a costruire una solida comprensione delle sue caratteristiche uniche, delle applicazioni pratiche e delle strategie di utilizzo efficaci.
Continua oggi il tuo percorso nell'IA!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



