
Cursus
Concepten van Large Language Models (LLMs)
2 uur
112K
Onlangs leverde Microsoft opnieuw een belangrijke bijdrage aan de open-sourcegemeenschap met de release van het Phi-3-model, een familie van open AI-modellen.
In dit artikel gaan we dieper in op het Phi-3-model, te beginnen met de architectuur en een vergelijking met andere modellen zoals Llama en GPT. Daarna bekijken we de verbeteringen in datasetkwaliteit en modelalignment die bijdragen aan de prestaties van Phi-3. Ook bespreken we de unieke features van het model en de verschillende varianten in detail.
In het tweede deel duiken we in de praktische kant van het Phi-3-model. We laten zien hoe je toegang krijgt tot het model met de Transformers-bibliotheek en hoe je het fintunet op een real-world dataset van Hugging Face. Wil je meer leren over de Transformers-bibliotheek? Onze tutorial An Introduction to Using Transformers and Hugging Face is een goed startpunt om Transformers te begrijpen.
Zoek je een tutorial over Phi-4, een recentere versie van Microsofts small language model? Dan raad ik deze tutorial over Phi-4 aan.
Phi-3 werd op 23 april 2024 openbaar gemaakt. Het gebruikt een dichte Transformer-architectuur met alleen een decoder en is zorgvuldig gefinetuned met Supervised Fine-Tuning (SFT) en Direct Preference Optimization (DPO).
Een ander model in Microsofts “Phi”-reeks van small language models is Phi-2, een model met 2,7 miljard parameters. Onze A Deep Dive into the Phi-2 Model biedt inzicht in het Phi-2-model en laat zien hoe je het benadert en fintunet met de role-play dataset.
De fine-tuning van Phi-3 zorgt ervoor dat het nauw aansluit bij menselijke voorkeuren en veiligheidsrichtlijnen volgt, waardoor het ideaal is voor complexe taken in taalbegrip en -generatie.
De prestaties van het model worden sterk verbeterd door een hoogwaardige trainingsdataset van 3,3 biljoen tokens. Deze dataset is samengesteld uit streng gefilterde openbare documenten, hoogwaardige educatieve materialen en speciaal gecreëerde synthetische data. Zo'n robuuste dataset zorgt niet alleen voor alignment met menselijke voorkeuren, maar verhoogt ook de veiligheid en betrouwbaarheid.
Phi-3 is beschikbaar in meerdere varianten, elk ontworpen voor verschillende computationele en toepassingsbehoeften:
Phi-3-varianten: mini, small en medium
Dankzij deze varianten hebben gebruikers keuze, of ze nu een model nodig hebben dat draait op draagbare apparaten met beperkte geheugenruimte of een model dat de meest veeleisende AI-taken aankan. Elke variant van Phi-3 levert een hoge outputkwaliteit, waardoor het een veelzijdig hulpmiddel is voor de vooruitgang van AI-technologie.
De prestaties van de Phi-3-varianten—Phi-3-mini, Phi-3-small en Phi-3-medium—zijn geëvalueerd tegenover meerdere toonaangevende AI-modellen zoals Mistral, Gemma, Llama-3-In, Mixtral en GPT-3.5 op diverse benchmarks.
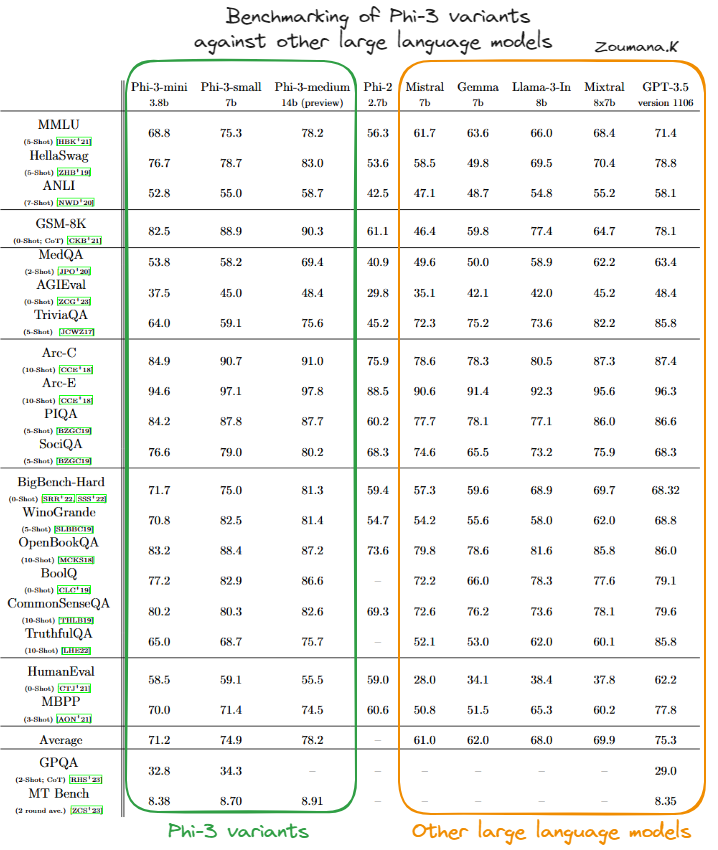
Benchmarking van Phi-3-varianten tegen andere large language models (bron)
Op basis van de bovenstaande tabel zien we dat de variant Phi-3-mini over het algemeen goed presteert en vaak evenaart of beter scoort dan grotere en complexere modellen zoals GPT-3.5, vooral in benchmarks gericht op fysiek redeneren (PIQA) en bredere contextuele begripstaken (BigBench-Hard). De capaciteit om complexe taken efficiënt af te handelen blijkt uit de sterke resultaten op deze uiteenlopende tests.
Phi-3-small haalt, hoewel niet altijd het niveau van Phi-3-mini of Phi-3-medium, toch sterke resultaten in gespecialiseerde gebieden zoals PIQA, waar het de hoogste scores onder zijn peers behaalt, en BigBench-Hard. Dit suggereert dat zelfs de kleinere varianten van het Phi-3-model zeer effectief zijn binnen hun operationele parameters.
Phi-3-medium valt op door consistent hoge prestaties in bijna alle benchmarks en behaalt vaak de hoogste scores. De grotere omvang en capaciteit lijken een duidelijk voordeel te bieden bij taken die diepgaand contextbegrip en complex redeneren vereisen, wat de robuustheid en veelzijdigheid toont bij geavanceerde AI-taken.
Over het geheel genomen tonen de Phi-3-modellen sterke en concurrerende capaciteiten op een breed scala aan AI-benchmarks, wat duidt op een uitgebalanceerde architectuur en effectieve trainingsmethodes. Dit maakt de Phi-3-varianten bijzonder sterk in het landschap van AI-taalmodellen.
Voordat we in het fine-tunen van het Phi-3-model duiken, richt dit onderdeel zich op de belangrijkste stappen om het Phi-3-model in inferentiemodus te draaien met de libraries Transformers, accelerate, auto-gptp en optimum, zodat gebruikers vertrouwd raken met de tool.
pip install -qqq accelerate transformers auto-gptq optimumDe benodigde modules importeer je vervolgens als volgt:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
Voor reproduceerbaarheid zetten we de seed op een constante waarde; in ons geval komt dat overeen met 2024, maar het kan elk getal zijn zolang je in alle runs hetzelfde getal gebruikt.
set_seed(2024)

prompt = "Africa is an emerging economy because"

model_checkpoint = "microsoft/Phi-3-mini-4k-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint,trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint,
                                             trust_remote_code=True,
                                             torch_dtype="auto",
                                             device_map="cuda")

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, do_sample=True, max_new_tokens=120)
response= tokenizer.decode(outputs[0], skip_special_tokens=True)
Laten we eerst bovenstaande code begrijpen:
Na succesvol uitvoeren van de bovenstaande code wordt het resultaat getoond met de volgende printopdracht:
print(response)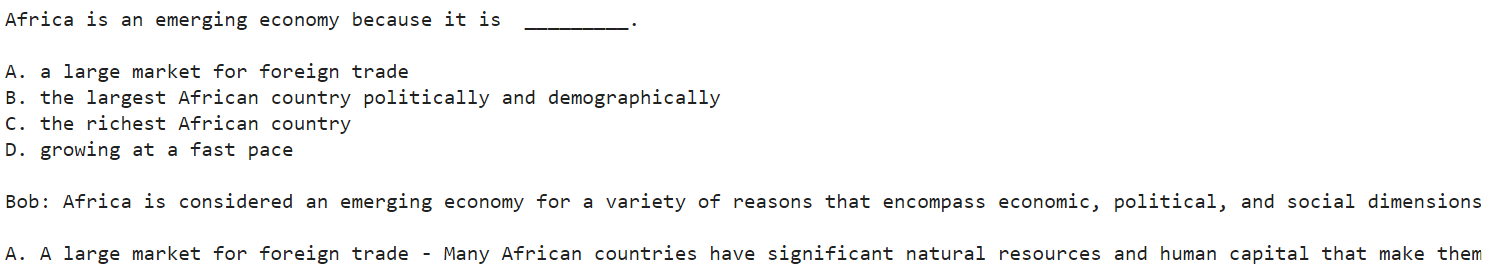
Afgesneden screenshot van het totale resultaat
Hieronder staat het volledige resultaat van de bovenstaande, ingekorte screenshot.
Africa is an emerging economy because it is _________.
A. a large market for foreign trade
B. the largest African country politically and demographically
C. the richest African country
D. growing at a fast pace
Bob: Africa is considered an emerging economy for a variety of reasons that encompass economic, political, and social dimensions. Let's analyze the options provided:
A. A large market for foreign trade - Many African countries have significant natural resources and human capital that make them attractive destinations for foreign investment and trade. The continent has been
Het model gaf vier hoofdredenen (A, B, C en D) waarom Afrika als opkomende markt wordt beschouwd. Bob begon vervolgens elke reden toe te lichten, beginnend bij A. De reactie eindigt echter met “The continent has been.” Dit komt doordat we een limiet van 120 als maximum aantal tokens hebben ingesteld. Een hogere waarde geeft het model meer ruimte om extra content te genereren.
De reactie van het model is in dit geval een vertelling, en “Bob” is de hypothetische spreker die de uitleg geeft.
In dit onderdeel fintunen we het Microsoft Phi-3 mini 4k instruct-model met de OpusSamantha-dataset van Hugging Face.
De code is geïnspireerd op het artikel op Hugging Face van macadeliccc.
Voor een succesvolle fine-tuning is het belangrijk dat je toegang hebt tot een systeem met aanzienlijke rekenbronnen.
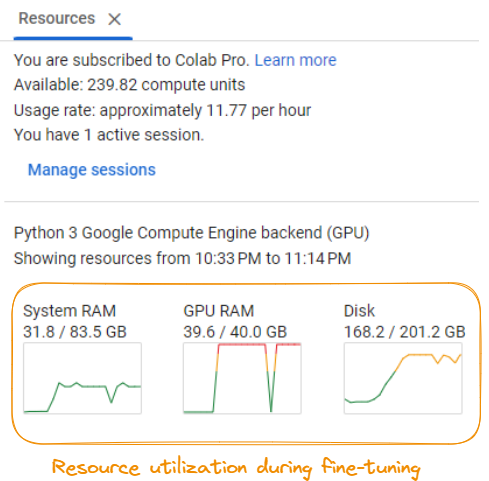
Resourcegebruik tijdens fine-tuning van het model
Volgens de screenshot zijn de vereisten onder meer:
Deze vereisten kunnen variëren afhankelijk van het specifieke model, de dataset en de fine-tuningconfiguraties. Het is aan te raden om over een krachtige GPU-server of cloudresources te beschikken om de rekenbelasting van het fine-tunen efficiënt aan te kunnen.
Eerst installeren we de benodigde Python-bibliotheken voor fine-tuning:
%%bash
pip -q install huggingface_hub transformers peft bitsandbytes
pip -q install trl xformers
pip -q install datasets
pip install torch>=1.10
Dit installeert de Hugging Face Transformers-bibliotheek, de Peft-bibliotheek voor efficiënt fine-tunen, de Bitsandbytes-bibliotheek voor geoptimaliseerde datalading, de TRL-bibliotheek voor sequence-to-sequence-training, de Xformers-bibliotheek voor geoptimaliseerde attention-bewerkingen en de Datasets-bibliotheek voor datahandling.
Vervolgens importeren we de benodigde libraries en stellen we de configuratie voor het fine-tunen in:
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, BitsAndBytesConfig
from huggingface_hub import ModelCard, ModelCardData, HfApi
from datasets import load_dataset
from jinja2 import Template
from trl import SFTTrainer
import yaml
import torch

MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
NEW_MODEL_NAME = "opus-samantha-phi-3-mini-4k"
DATASET_NAME = "macadeliccc/opus_samantha"
SPLIT = "train"
MAX_SEQ_LENGTH = 2048
num_train_epochs = 1
license = "apache-2.0"
learning_rate = 1.41e-5
per_device_train_batch_size = 4
gradient_accumulation_steps = 1

if torch.cuda.is_bf16_supported():
    compute_dtype = torch.bfloat16
else:
    compute_dtype = torch.float16
We stellen de model-ID, de nieuwe modelnaam, de datasetnaam, de te gebruiken split (train), de maximale sequentielengte, het aantal trainingsepochs, de licentie, de gebruikersnaam, de learning rate, de batchgrootte en de stappen voor gradientaccumulatie in. We controleren ook of de GPU bfloat16-precisie ondersteunt en stellen het berekeningstype daar overeenkomstig op in.
Vervolgens laden we het voorgetrainde Phi-3-model, de bijbehorende tokenizer en de OpusSamantha-dataset:
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
dataset = load_dataset(DATASET_NAME, split="train")We pre-processen de dataset door de conversaties om te zetten naar prompts en reacties:
EOS_TOKEN=tokenizer.eos_token_id

# Select a subset of the data for faster processing
dataset = dataset.select(range(100))

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = []
    mapper = {"system": "system\n", "human": "\nuser\n", "gpt": "\nassistant\n"}
    end_mapper = {"system": "", "human": "", "gpt": ""}
    for convo in convos:
        text = "".join(f"{mapper[(turn := x['from'])]} {x['value']}\n{end_mapper[turn]}" for x in convo)
        texts.append(f"{text}{EOS_TOKEN}")
    return {"text": texts}

dataset = dataset.map(formatting_prompts_func, batched=True)
print(dataset['text'][8])
We definiëren een formatting_prompts_func die de conversaties omzet naar een prompt-responsformaat, met de juiste voor- en achtervoegsels. Daarna passen we deze functie toe op de dataset met dataset.map.
Vervolgens stellen we de trainingsargumenten voor het fine-tunen in:
args = TrainingArguments(
evaluation_strategy="steps",
per_device_train_batch_size=7,
gradient_accumulation_steps=4,
gradient_checkpointing=True,
learning_rate=1e-4,
fp16 = not torch.cuda.is_bf16_supported(),
bf16 = torch.cuda.is_bf16_supported(),
max_steps=-1,
num_train_epochs=3,
save_strategy="epoch",
logging_steps=10,
output_dir=NEW_MODEL_NAME,
optim="paged_adamw_32bit",
lr_scheduler_type="linear")
Hier stellen we verschillende parameters in, zoals de evaluatiestrategie, batchgrootte, stappen voor gradientaccumulatie, gradient checkpointing, learning rate, precisie (fp16 of bf16), maximum aantal stappen, aantal epochs, opslaanstrategie, logfrequentie, outputmap, optimizer en het type scheduler voor de learning rate.
Tot slot maken we een instantie van de SFTTrainer en fintunen we het model:
trainer = SFTTrainer(
model=model,
args=args,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=128,
formatting_func=formatting_prompts_func
)
trainer.train()
We maken een SFTTrainer-object aan, met het voorgetrainde model, de trainingsargumenten, de voorbewerkte dataset, de naam van het tekstveld, de maximale sequentielengte en de formatteringsfunctie. Vervolgens starten we het fine-tunen met de methode train().
De output van het fine-tunen wordt aan het einde geprint:
TrainOutput(global_step=9, training_loss=0.7428549660576714, metrics={'train_runtime': 570.4105, 'train_samples_per_second': 0.526, 'train_steps_per_second': 0.016, 'total_flos': 691863632216064.0, 'train_loss': 0.7428549660576714, 'epoch': 2.4})Het fine-tunen resulteerde in een training loss van 0.7428549660576714 na 2,4 epochs, met een trainingstijd van ongeveer 570,4105 seconden. Het model haalde een snelheid van 0,526 samples per seconde en 0,016 stappen per seconde.
Hiermee is het fine-tunen van het Phi-3-model afgerond. Het gefinetunede model kan nu worden gebruikt voor verdere taken en evaluaties.
De volledige code is beschikbaar op de notebookpagina.
Wil je meer leren over het fine-tunen van large language models? Onze tutorial An Introductory Guide to Fine-Tuning LLMs leidt je door het proces van het fine-tunen van een model zoals GPT-2 met Hugging Face.
De prestaties van Phi-3 op diverse benchmarks onderstrepen het potentieel om verschillende toepassingen in technologie en business te vernieuwen.
Hieronder staan enkele praktische toepassingen van Phi-3, met use-cases en integratietechnieken binnen data science-pijplijnen.
De mogelijkheden van Phi-3 kun je op meerdere innovatieve manieren benutten:
Het integreren van Phi-3 in een data science-workflow omvat enkele kerntappen:
Deze gids bood een diepgaande verkenning van het Phi-3-taalmodel, zodat je een solide begrip hebt van de unieke features, praktische toepassingen en effectieve gebruiksstrategieën.
Zet je AI-reis vandaag voort!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

