Curso
Machine Learning com caret em R
4 h
60.8K
Se você precisa de uma introdução a machine learning, faça o curso Introduction to Machine Learning da DataCamp e confira o tutorial Introduction to Machine Learning in Python.
Use uma variedade de algoritmos de classificação de machine learning (ML) para construir, passo a passo, modelos que preveem o gênero de uma música e se ela terá sucesso nas paradas da Billboard — tudo isso só com base nas letras!
Este é o Parte Três de uma série de três tutoriais em que você continuará usando R para executar várias tarefas analíticas em um estudo de caso com letras do lendário artista Prince, além de outros artistas e autores. Os três tutoriais abordam:
Como cientista de dados, você precisa entender aprendizado supervisionado e não supervisionado. Este tutorial explica e traz um caso de uso musical para uma forma de aprendizado supervisionado — especificamente classificação — baseada nas letras de diversos artistas (e alguns autores de livros). Você vai aprender a construir modelos para classificar músicas no gênero associado e investigar a possibilidade de usar letras para prever sucesso comercial.
Você já usou um serviço de streaming e recomendação automática, como Pandora, iHeart Radio, Spotify etc.? Se você criou uma estação de hard rock, provavelmente não espera ouvir um country sobre botas de cowboy e cidades pequenas. Sistemas de recomendação de música costumam focar em qualidades sonoras, enquanto a análise das letras vem ganhando espaço em pesquisas mais recentes. Com as técnicas deste tutorial, você pode usar métodos de ponta pesquisados hoje por cientistas para gerar ideias e avançar nesse campo em crescimento.
Este tutorial parte do entendimento básico de mineração de texto com tidytext. É uma introdução intermediária a técnicas de machine learning usando vários algoritmos populares de classificação. Recomenda-se que você tenha experiência sólida com programação em R, de preferência com algum conhecimento de machine learning, e queira aprender mais sobre aplicação e implementação por meio de casos práticos. Cada algoritmo é explicado brevemente, mas há links para leituras mais aprofundadas.
Ao longo do artigo, você vai usar um framework para experimentos de machine learning em R chamado mlr. Embora este tutorial não seja sobre o mlr, você vai utilizá-lo extensivamente como uma interface para o processo de ML. A ideia é simplificar a explicação das etapas para construir um modelo com diferentes algoritmos. Recomendo muito este tutorial abrangente sobre o pacote.
Há muitos componentes em ML e aqui vamos apenas arranhar a superfície. Diferente das Partes Um e Dois da série, a narrativa pode deixar mais perguntas do que respostas. Você vai aproveitar mais se acompanhar com seus próprios dados e código e pesquisar os algoritmos no seu ritmo.
Veja um panorama das etapas para construir seus modelos:
Seção um: aprenda a prever o gênero com base em atributos das letras.
Seção dois: use as letras do icônico Prince para criar modelos que preveem o sucesso de uma música.
Vale a pena conferir os tutoriais anteriores para entender bem os dados e suas nuances. Lembre-se: mineração e análise preditiva de letras é bem mais complexa do que em textos não ficcionais, pois contexto, significado e mensagens sutis costumam ficar escondidos nas nuances criativas do compositor. Assim como na Parte Dois-B sobre modelagem de tópicos, você continuará trabalhando com artistas de gêneros distintos e com o conteúdo de dois livros sobre machine learning (com o gênero data science — para introduzir outra forma de texto).
Comece carregando as bibliotecas e depois dê uma olhada na estrutura geral dos dados.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Assim como nos tutoriais anteriores, o código para o gráfico em círculo abaixo pode parecer complicado, mas é difícil resistir a um visual bacana. Ele mostra a capa de um álbum/livro para cada artista/autor nos seus dados — cobrindo os conjuntos de treino e teste. Para mais detalhes sobre o pacote circlize, confira este livro do Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)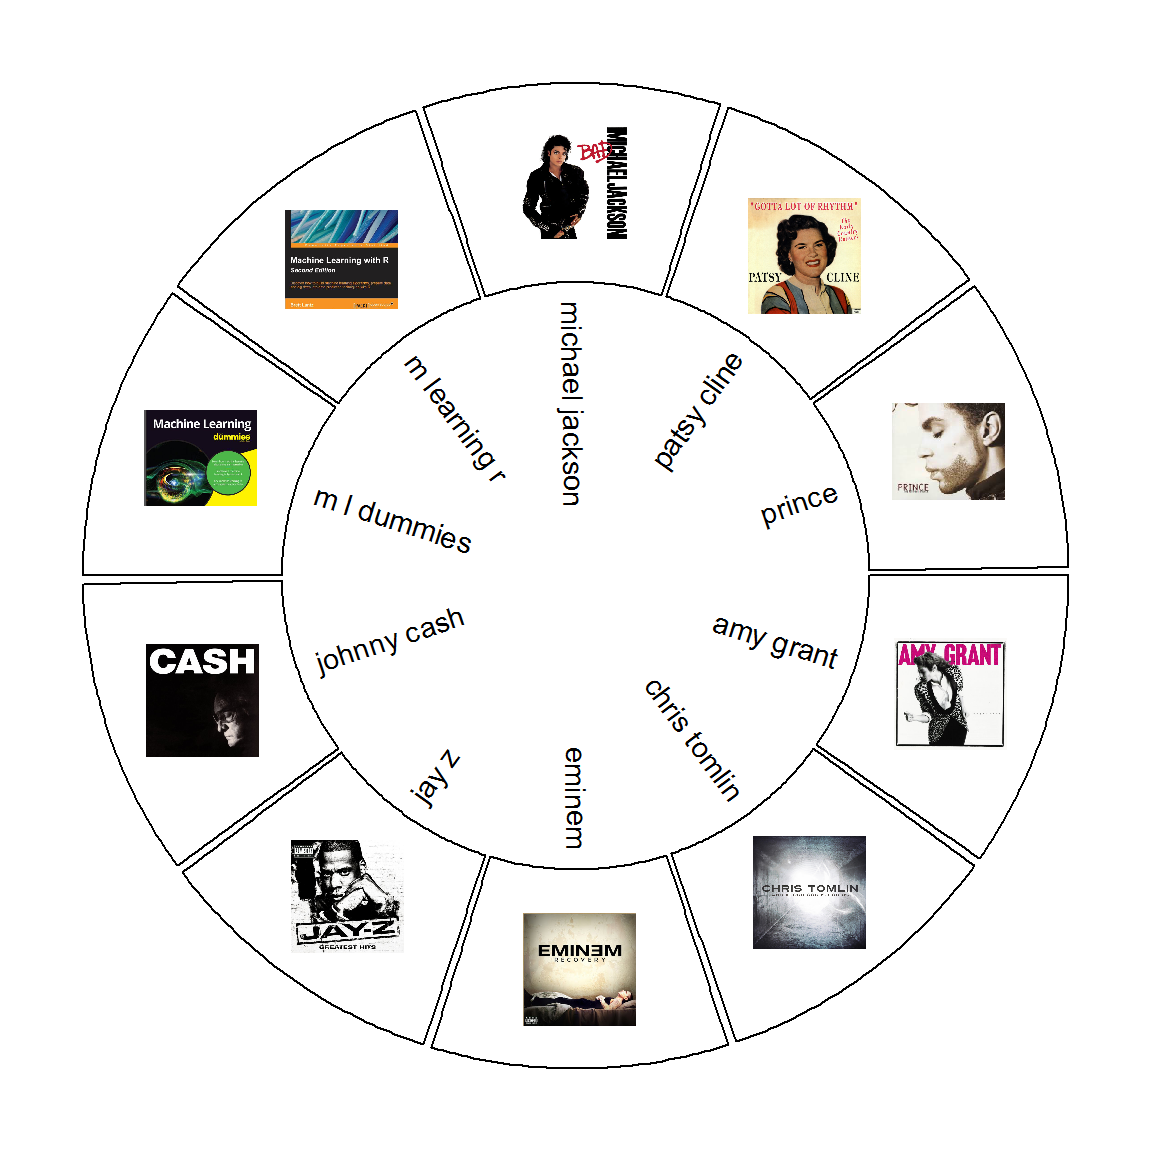
Para focar no modelagem, fiz o tratamento dos dados fora deste tutorial e disponibilizei tudo o que você precisa para a análise. Resumo do pré-processamento:
pdf_text() do pacote pdftools para coletar o conteúdo de dois livros (cada página representa um documento distinto)A seguir, você vai carregar os dados de treino e teste, que já estão divididos para serem carregados separadamente. Depois, use unnest() do tidytext para criar a versão tidy com uma palavra por registro.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Com os dados de treino e teste carregados e organizados, veja quantas músicas existem por artista/autor. Como o conjunto tem músicas e páginas de livros, vou chamar cada um de documento. Os atributos que você vai criar são baseados em documentos e seus metadados associados, então é importante entender esse conceito. Além disso, como há artistas e autores, vou chamá-los de source de cada documento.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")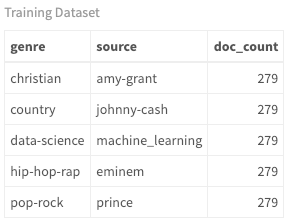
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")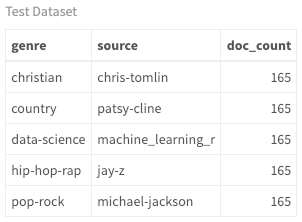
Apesar de ser possível ver gênero, source e número de documentos, o diagrama de acordes a seguir é uma forma melhor de visualizar esses relacionamentos. Ao longo do tutorial, você verá como essas relações evoluem com os novos modelos. Neste momento há uma relação um-para-um entre source e gênero porque os artistas são classificados assim; porém, artistas crossover são muito comuns — e isso vai aparecer nas versões seguintes do diagrama.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")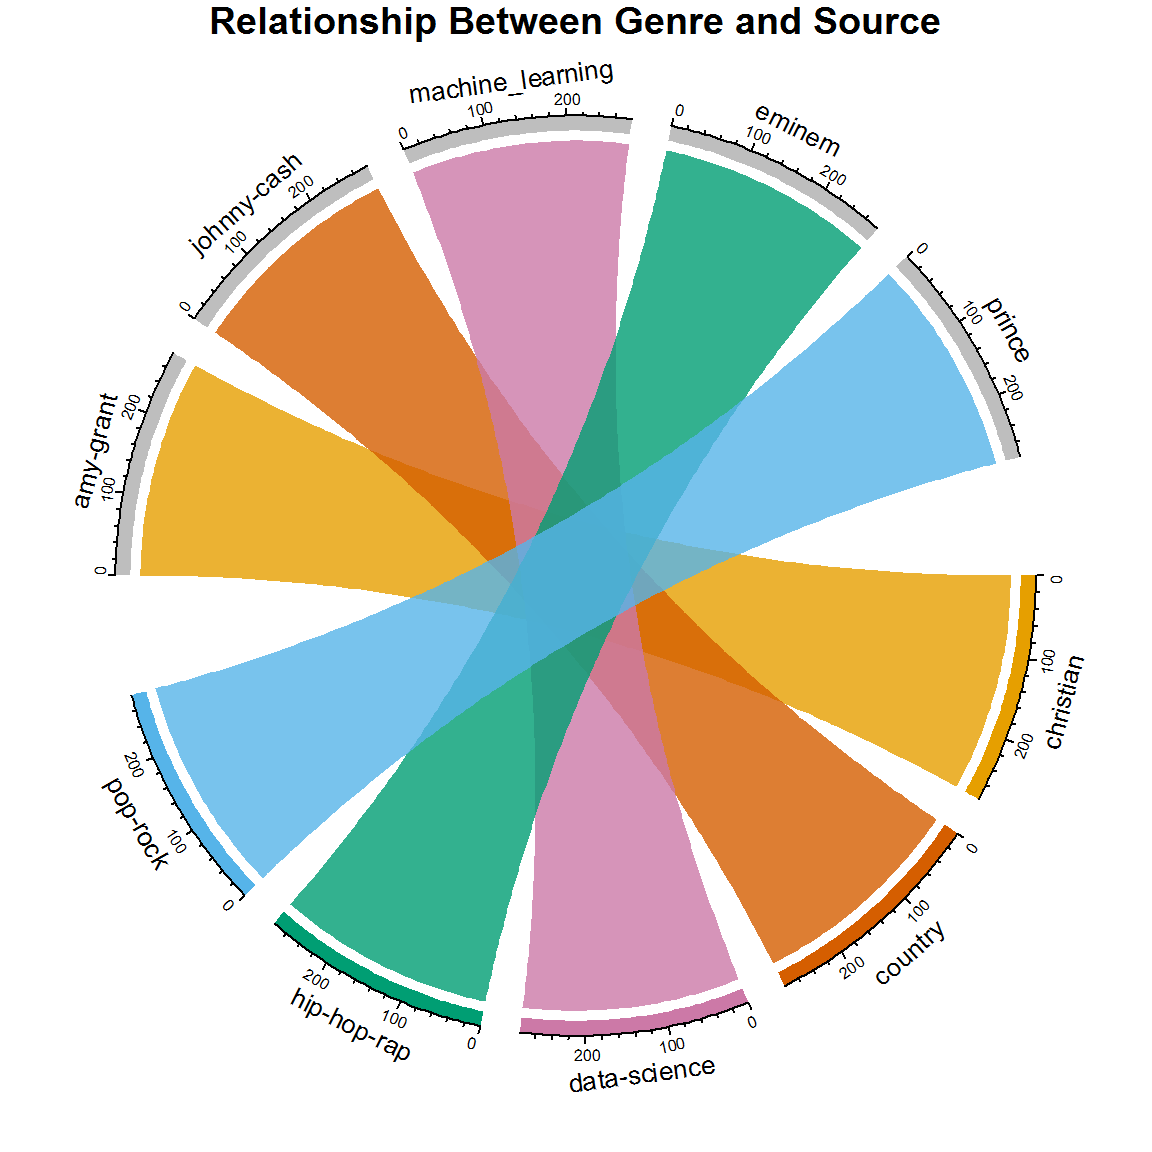
Pense em como esse diagrama ficaria sem a relação um-para-um. Se você fosse prever o gênero apenas com base nas letras, o que acha que aconteceria?
Se tudo o que você tivesse para classificar uma música fossem as letras, como criaria variáveis preditoras? Primeiro, pense na música e no que diferencia uma letra da outra. Um tema comum em toda música é repetição. Alguns gêneros usam mais repetição do que outros? E o tamanho das palavras? Existem gêneros que usam palavras maiores ou menores com maior frequência? Que outros fatores descrevem letras? Se você obtiver essas contagens por música, terá seu primeiro conjunto de preditores!
Note que todas as variáveis acima são atributos quantitativos (contagens, comprimentos etc.) baseados em palavras por música. Mas e palavras individuais específicas de gêneros? Nos tutoriais anteriores, você trabalhou com análise de sentimentos e modelagem de tópicos. Essas atividades focaram em palavras específicas de certos artistas ou gêneros. Dando um passo além, você pode criar componentes preditivos importantes baseados em conteúdo (ou contexto). Essa é a etapa criativa específica da análise de texto e que gera preditores críticos para seus modelos.
Primeiro, você quer obter as palavras mais comuns (frequentes) por gênero. Isso foi feito na Parte Um. Comece obtendo o total de palavras por gênero. Em seguida, agrupe por palavras e conte a frequência de cada uma. Agora selecione as n palavras mais frequentes definidas pela variável number_of_words. Eis a parte difícil: quantas palavras escolher? Se escolher poucas, não otimiza o modelo; se escolher demais, você superajusta e distorce o resultado. É complexo de descrever, mas na prática é tentativa e erro. Cheguei a um total de 5.500 como número mais adequado de palavras. Brinque com esse valor e veja o impacto no resultado. Você pode conseguir algo melhor! Se este passo ainda não está claro, continue comigo que vai fazer mais sentido.
Muitas palavras são comuns a mais de um gênero (como time, life etc.), e eu removi essas palavras com a variável multi_genre abaixo. Assim a lista fica mais limpa, com palavras distintas que separam melhor as fontes.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Agora use as palavras específicas de gênero como atributos no seu dataset. Como você criará atributos para múltiplos conjuntos, crie uma função para escrever isso uma vez só. Nessa função, há referências a diversidade e densidade lexical. Veja a explicação desses conceitos na Parte Um.
Pense em cada atributo abaixo e como ele pode variar conforme o gênero. Em vez de explicar um a um, vou focar nas etapas de ML a seguir. E não esqueça os preditores específicos de gênero. Por exemplo, country_word_count é só a contagem das principais palavras de country que aparecem em cada música. Repare que dei mais peso a palavras explícitas e de livros (veja os 10 e 20 no sum()). Fiz isso porque são muito distintas e ajudam na classificação dos documentos. De novo: foi tentativa e erro!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Agora chame sua função features() para os datasets de treino e teste.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Se você nunca usou o pacote mlr, tudo bem. Vamos passo a passo e você verá que o processo é direto. De novo, recomendo fortemente revisar este tutorial, que é a documentação mais completa do pacote. Você também pode visitar mlr.org.
mlr (Machine Learning for R) é um framework que inclui os algoritmos de ML mais usados. Em vez de explicar a teoria por trás de cada um, vou focar na implementação. Ao final, você terá usado várias ferramentas de classificação — e vai aproveitar mais se praticar acompanhando o código.
Depois de fazer a engenharia de atributos, o processo de ML é simples: criar uma tarefa, definir um learner, treinar, testar. As etapas são:
Uma tarefa é apenas o conjunto de dados no qual um learner aprende. Como é um problema de classificação, você vai criar uma tarefa de classificação com makeClassifTask(). É preciso especificar a variável de saída, genre, passando como argumento target.
Criei três tarefas abaixo, cada uma com um propósito. Treino e teste são óbvios, mas há também um dataset que usa apenas os atributos quantitativos básicos, com resumos e contagens do documento. Essa tarefa, task_train_subset, é criada sem os contadores de palavras por gênero (isto é, country_word_count, pop_rock_word_count etc.) para ilustrar a importância desses preditores contextuais no modelo final. Usar train[3:13] remove essas variáveis. Além disso, você sempre deve remover colunas de texto ao criar a tarefa. Aqui, estão nas posições um e dois do dataframe.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
data = test[-c(1:2)], target = "genre")Normalização é um tópico que exige investigação, nem sempre é necessária e depende do dataset; neste caso, é benéfica. É basicamente escalar seus dados para que os valores fiquem entre zero e um (ou outro intervalo). Se algumas variáveis têm magnitude muito maior e estão em escalas diferentes, podem enviesar o modelo dando mais peso a elas. Normalizar resolve isso. Este tópico vale a leitura. No mlr há a função normalizeFeatures() para esta etapa.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Um learner no mlr é gerado com makeLearner(). No construtor, você especifica qual método de aprendizado quer usar. Dá para obter uma lista de algoritmos de classificação com listLearners("classif")[c("class","package")], que mostra as opções e os pacotes dependentes (que podem precisar de instalação).
Para este exercício, escolhi uma lista que lida com mais de duas classes e oferece variedade de técnicas: árvores de decisão, random forests, SVM, gradient boosting e redes neurais. Existem muitos learners para escolher (atualmente são mais de 80 classificadores no mlr). Experimente!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)
Reamostragem é essencial em ML e renderia um tutorial à parte. Em resumo, envolve extrair amostras repetidas do conjunto de treino e ajustar o modelo em cada amostra. Isso permite obter informações que você não teria ajustando o modelo apenas uma vez no treino original.
Há vários métodos, mas aqui usaremos a validação cruzada k-fold, indicada por "CV" na chamada a makeResampleDesc(), que retorna um objeto de descrição de reamostragem (rdesc). Essa abordagem divide o dataset em k grupos (folds) de mesmo tamanho. O primeiro fold vira validação e os demais, treino. Isso se repete k vezes, alternando os folds. A taxa de erro é capturada a cada iteração e depois média.
Pode parecer complicado se é seu primeiro contato com reamostragem, mas é um passo essencial. Usaremos validação cruzada com 10 folds. "Para classificação, é desejável ter a mesma proporção de classes em cada fold." (Fonte) Use stratify = TRUE para garantir isso.
Para saber mais sobre reamostragem no mlr, veja este artigo.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)O objetivo típico da classificação é obter alta acurácia e minimizar erros. Nesse sentido, todos os tipos de erro de classificação são considerados com o mesmo peso. Porém, em muitas aplicações, diferentes erros têm impactos distintos. Por exemplo, ao classificar se um paciente tem uma doença, errar e não identificar a doença pode ser crítico. Existem métricas específicas para esses nuances. Para análise de letras, vamos focar em acurácia e erro. Só lembre: acurácia e taxa de erro nem sempre são as melhores escolhas para avaliar a robustez de um modelo. É um tema importante que merece discussão à parte.
Acurácia é o número de previsões corretas sobre o total de previsões. Para examinar os erros do modelo, também veremos a matriz de confusão (previsto vs. real). Por ora, defina uma lista de métricas de interesse. Adicionei três aqui, mas vamos olhar apenas acc. Este link traz mais informações sobre métricas.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)No mlr, você pode conduzir um experimento de benchmark em que diferentes algoritmos (métodos de aprendizado) são aplicados ao seu conjunto de dados. Isso permite comparar algoritmos pelas métricas de interesse (por exemplo, acurácia). Vamos rodar benchmark() para treinar e gerar um objeto BenchmarkResult, do qual você acessa modelos e resultados.
Hora de construir um modelo. Comece com a tarefa sem os contadores de palavras por gênero. Passe ao benchmark sua lista de learners, a tarefa de subset, a estratégia de reamostragem (rdesc) e a lista de métricas.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252Observando o objeto BenchmarkResult, você vê o acc.test.mean para cada algoritmo. Note que isso se refere à validação (folds) na cross-validation durante o treino. Não é o mesmo conjunto de teste que usaremos depois. De novo: há uma série de datasets de validação retidos na cross-validation e um dataset de teste que você usa após decidir o algoritmo e ajustar o modelo.
Neste benchmark, Random Forest teve o melhor desempenho com r rf_perf por cento (e foi o que mais demorou para treinar). Com esse valor em mente, rode o experimento no conjunto completo de atributos.
Desta vez, passe a tarefa que inclui o contador de palavras por gênero por documento. Isso adiciona atributos que indicam se uma música tem mais palavras de country, de pop-rock etc. Lembre que, usando o dataset rotulado, você selecionou as palavras mais comuns de hip-hop e as colocou na lista hip_hop_words — com termos como thug, crib, drug. A lista de country tem termos como lonesome, coal, drunken, cattle. Deu para entender.
O mlr oferece diversos métodos para acessar os resultados do benchmark. Vou usar alguns, mas para se familiarizar com o objeto, recomendo as funções getter getBMR*. Se você chamar str() no objeto, vai esperar um bom tempo!
Antes de detalhar o conjunto completo, compare múltiplas tarefas e veja o full vs. subset com plotBMRSummary(). Crie uma lista de tarefas e passe para benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)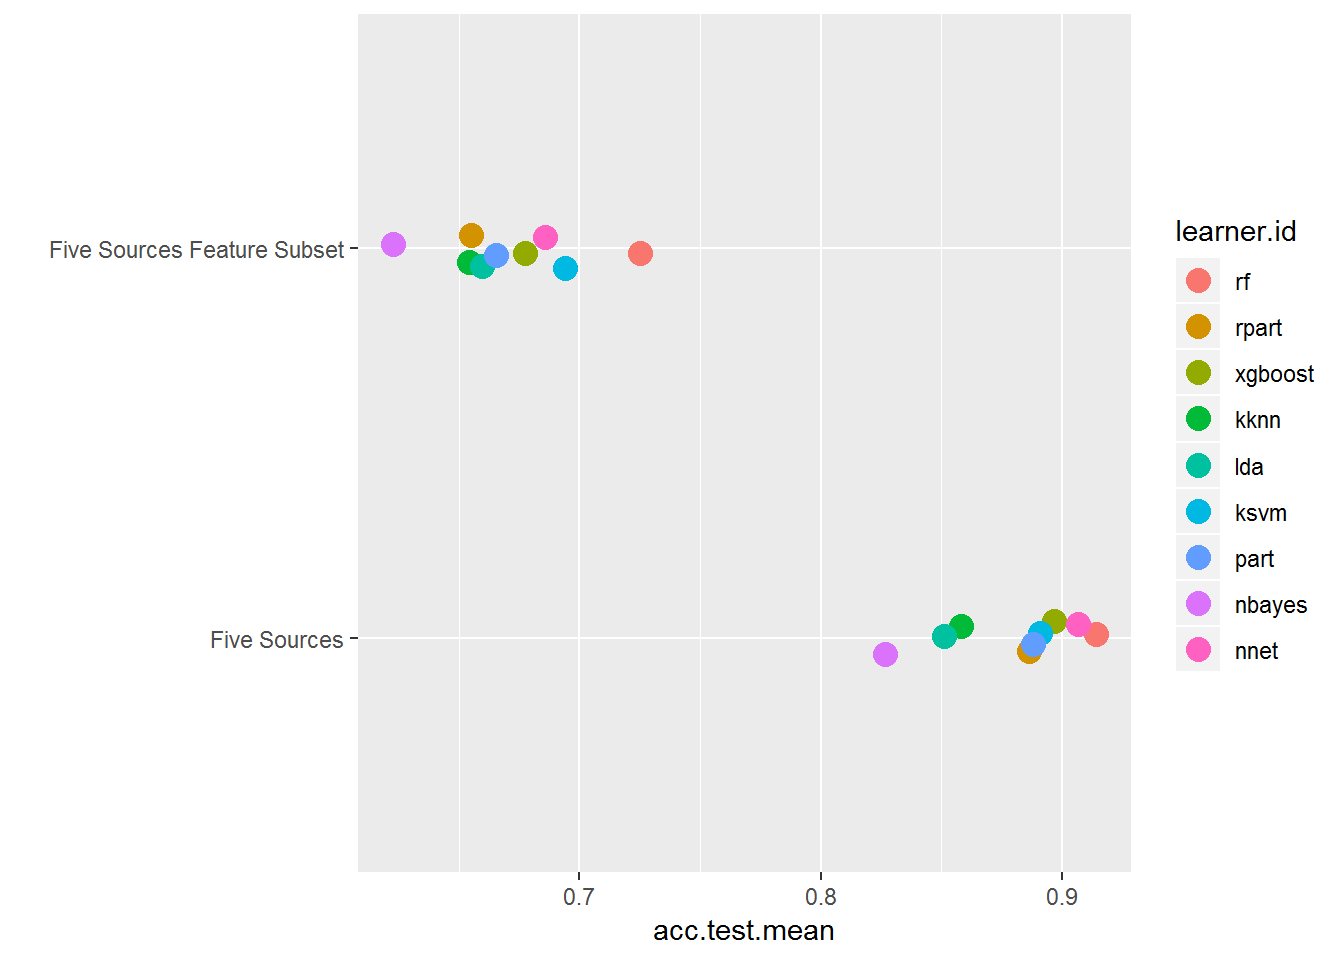
Aqui dá para ver que o acc.test.mean do subset sem os contadores por gênero é menor do que no conjunto completo. Isso indica que esses atributos fazem muita diferença! Esse passo criativo é algo típico de ML com texto. Guarde para os seus projetos.
Embora você pudesse acessar só os resultados de treino do bmr_multi_task, rode o benchmark novamente só com a tarefa de treino e veja os resultados com getBMRAggrPerformances() e plotBMRBoxplots().
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)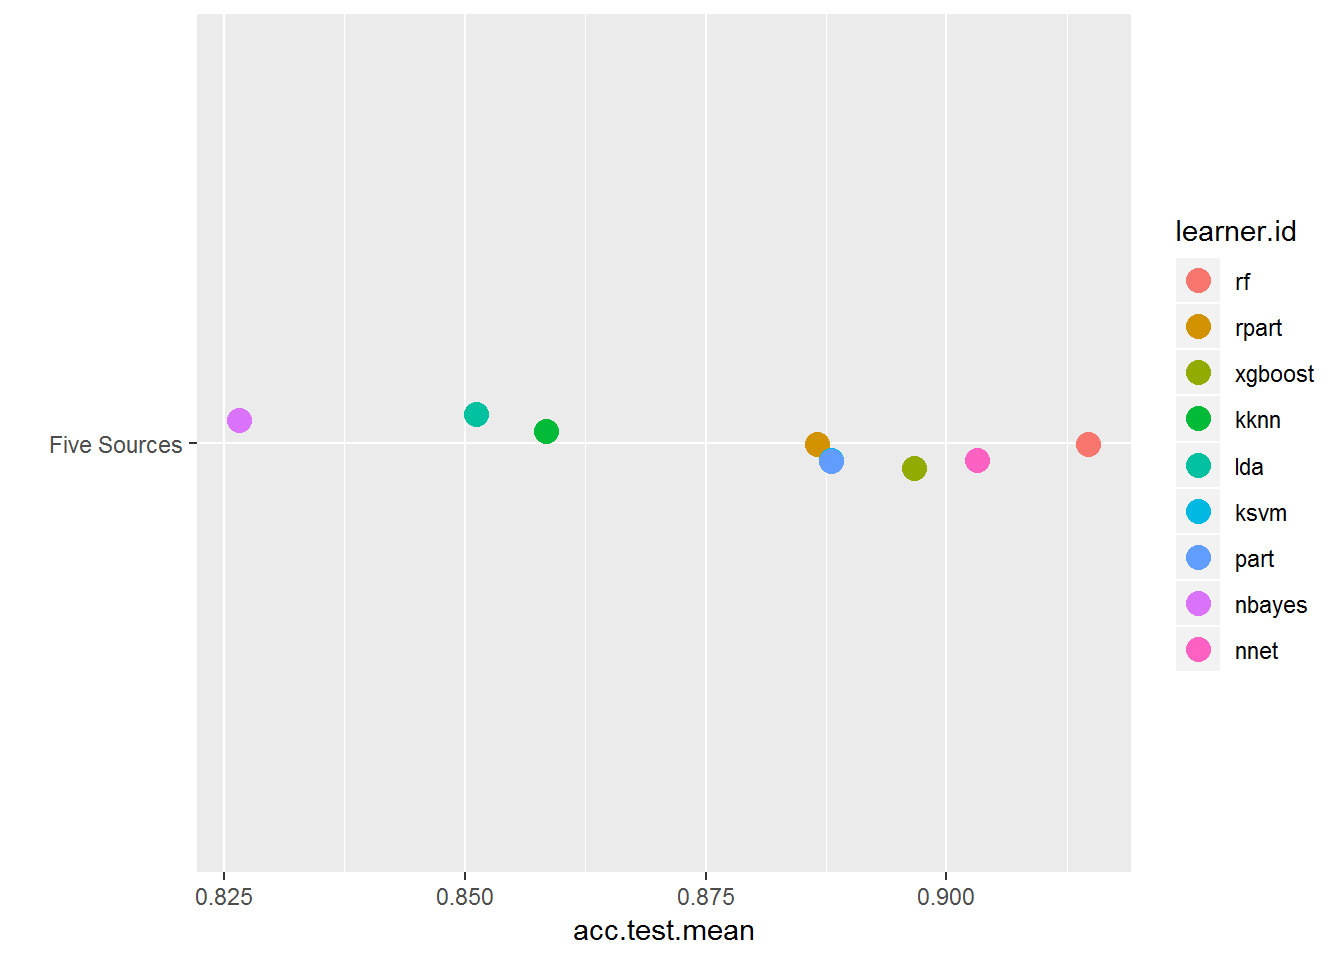
Assim você foca nos resultados do conjunto completo. Agora fica mais claro o descolamento entre algoritmos e como random forest supera os demais.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))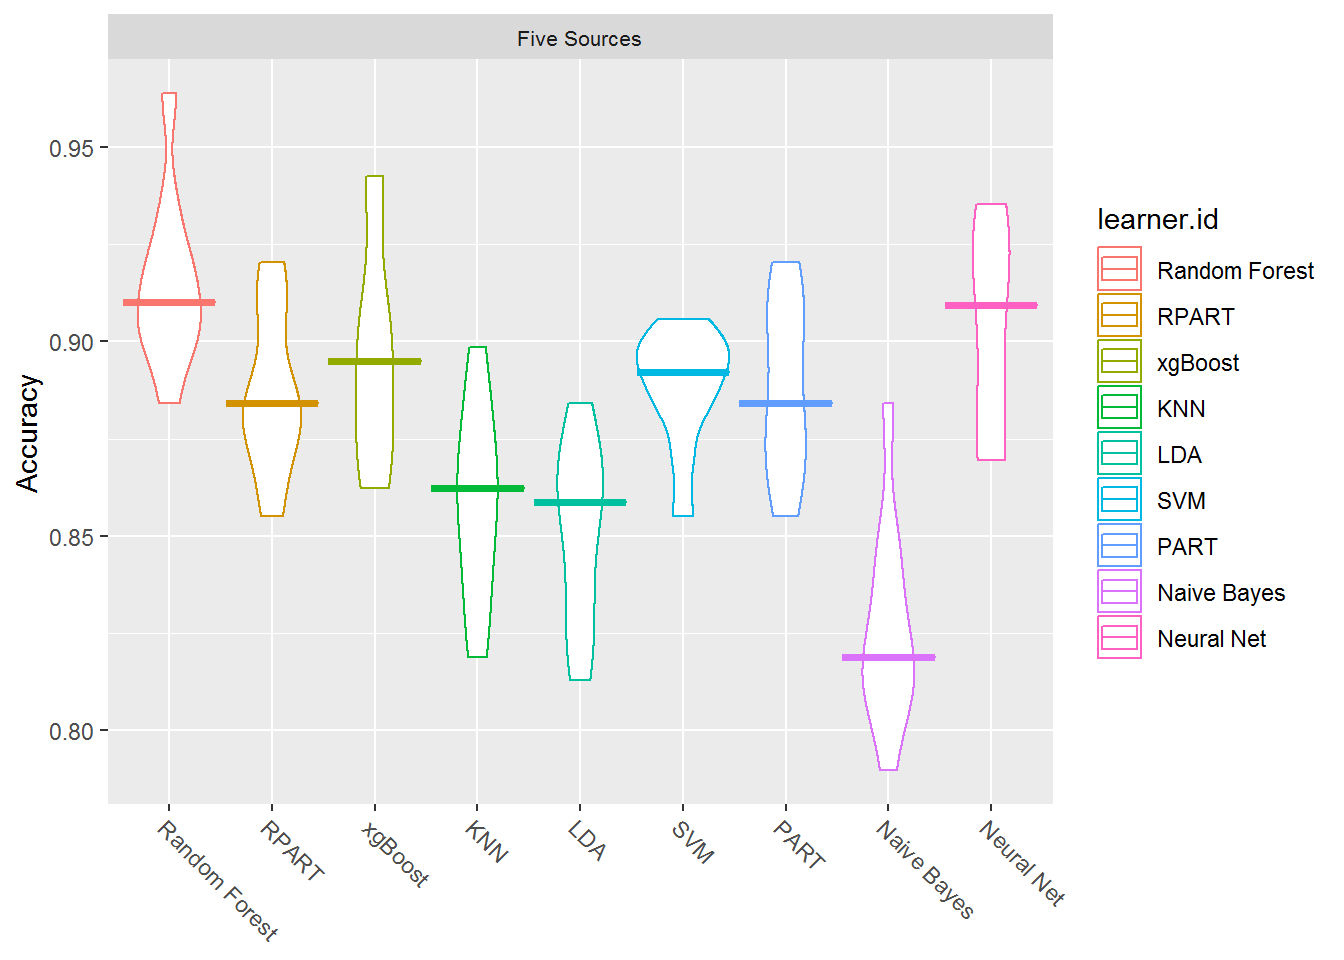
Esses boxplots mostram os resultados por método ao longo das iterações do benchmark.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")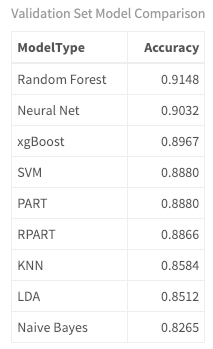
Aqui vemos que a acurácia é mais alta para Random Forest, Neural Net e xgBoost, com acurácias de r first_three, respectivamente. E o que aconteceu no modelo? Como os documentos/músicas foram classificados? Quais gêneros foram mais difíceis de classificar só pelas letras? Para mais insight, veja a matriz de confusão das previsões. Na diagonal estão os acertos; fora dela, os erros. As colunas são os valores previstos e as linhas, os reais. Use getBMRPredictions() para acessar as previsões do treino/validação. Depois veja o result da matriz de confusão do Random Forest, acessando pelo id Five Sources que você definiu para a tarefa de treino. (Daria para fazer isso com qualquer modelo do benchmark.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")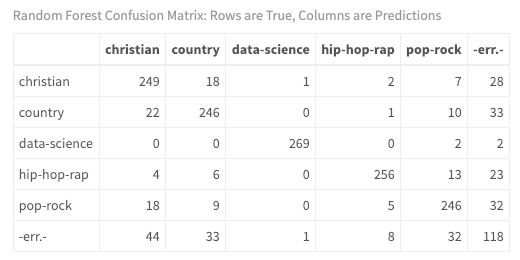
Agora temos mais clareza sobre o modelo! Como esperado, com apenas uma classificação errada, é relativamente fácil distinguir documentos de data science de letras de músicas usando os metadados textuais que você criou. Além disso, hip-hop-rap é bem distinto dos outros gêneros musicais, com apenas oito erros. Porém, apesar do bom desempenho, há menos distinção entre letras de country, cristã e pop-rock.
O objetivo não é só expor técnicas preditivas, mas também fazer análise de letras como continuação dos tutoriais anteriores. Pense no que esses resultados significam. Se você estivesse desenvolvendo um sistema de recomendação complementado por insights das letras, que cuidados deveria tomar? Há chance de o sistema recomendar um artista de hip hop com letras explícitas para quem ouve música cristã ou country?
Lembra do diagrama de acordes no começo? Veja-o de novo, agora com previsões em vez de rótulos reais.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")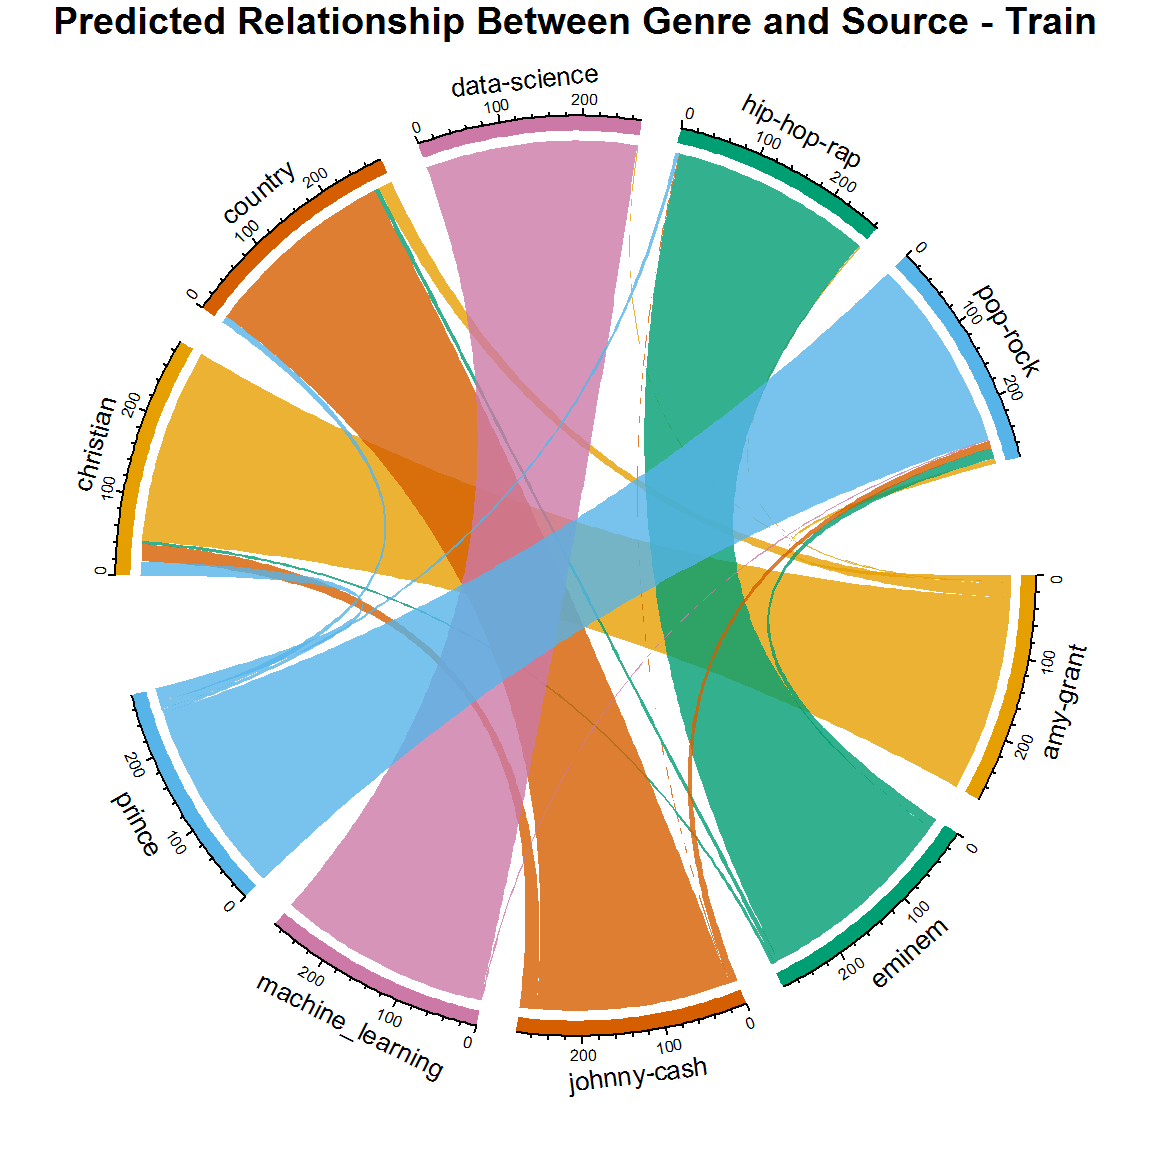
Bem legal. Agora dá para ver o desempenho nos dados de treino. De novo, os resultados impressionam. As linhas menores representam as classificações erradas. Mas aqui está talvez o conceito mais importante: mesmo sendo a acurácia da validação, ainda é baseada em dados rotulados de treino! Se não tiver cuidado, você pode superajustar o modelo e introduzir alta variância — seu algoritmo varia muito dependendo dos dados e pode não ser robusto a ruído em dados novos. Vamos fazer um teste real já já, alimentando dados inéditos.
Antes de testar novos dados, escolha um modelo e faça tuning — ajustando os hiperparâmetros. Se você acompanha o Kaggle, já viu o extreme gradient boosting dominar competições. Mesmo não tendo sido o melhor no benchmark, vou escolhê-lo para ajustar e rodar no conjunto de teste. Se você é novo nesse tipo de algoritmo, tuning pode ser a parte mais difícil. Pelo escopo do tutorial, não vou detalhar conceitos de gradient boosting nem seus hiperparâmetros, mas o código abaixo é um ponto de partida. Recomendo revisar gradient boosting antes de mergulhar no tuning. Este artigo, do Prince Grover, é ótimo para começar. Em resumo:
Primeiro modele com modelos simples e analise os erros. Esses erros indicam pontos difíceis de ajustar com um modelo simples. Depois, nos modelos seguintes, foque nesses pontos difíceis para acertá-los. No fim, combine os preditores ponderando cada um.
(Observação: o maxit de 150 em makeTuneControlRandom() abaixo leva um bom tempo. Comece menor para testar.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Você pode examinar os parâmetros otimizados olhando a saída do tuneParams(). Agora crie um novo modelo com os hiperparâmetros ajustados e re-treine no conjunto de treino.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))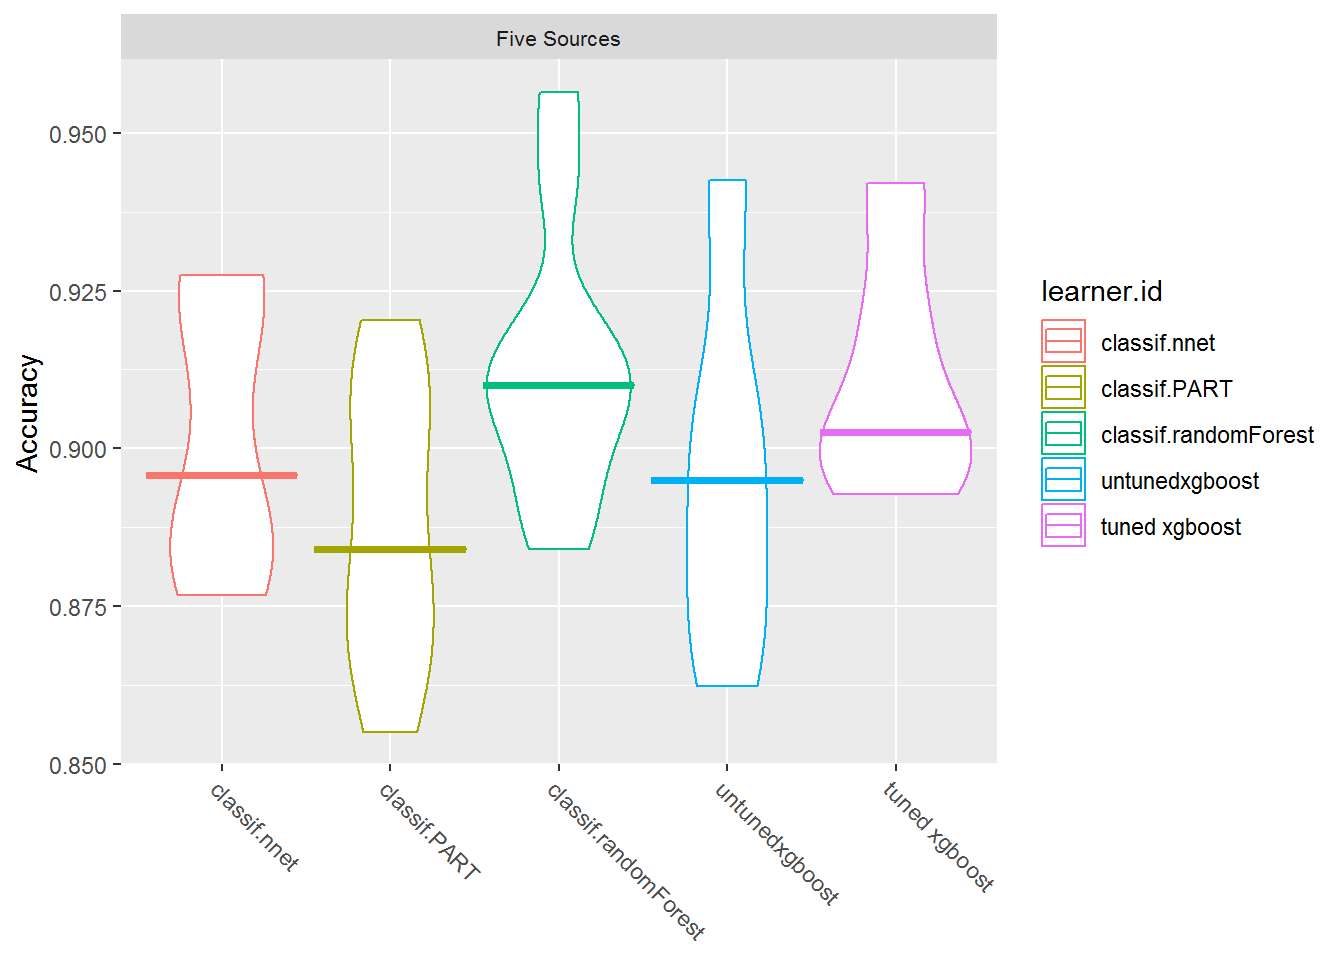
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")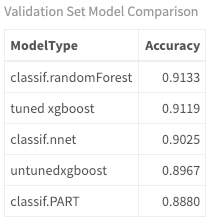
O xgBoost ajustado ficou só um pouco acima do sem tuning e ainda abaixo do random forest. Mas como eles se saem no conjunto de teste?
Com o modelo ajustado e os benchmarks, chame predict() para os seus três melhores modelos no conjunto de teste — nunca visto antes. Ele inclui cinco fontes completamente diferentes, como mostrado antes. Veja o desempenho e as classificações.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Resultados interessantes. Embora o random forest tenha tido acurácia maior no treino do que o xgBoost ajustado, ele foi ligeiramente menos preciso no teste. A acurácia da rede neural caiu bem mais do que no treino — redes neurais podem ser muito flexíveis e, por isso, superajustar.
Com acurácia de r round(test_perf,2)*100% para o xgBoost ajustado, ainda houve queda expressiva no teste em relação ao treino — e o tuning trouxe melhora modesta (com esta configuração mínima!). Essa queda entre treino e teste é comum e é exatamente por isso que você deve testar o modelo em dados novos.
Agora, veja as classificações de fato.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")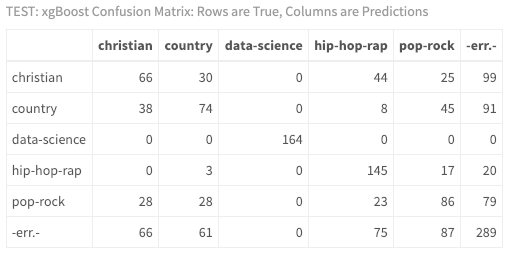
Pela matriz, ficou bem mais difícil classificar este artista de hip hop, Jay-Z. Mesmo que você não conheça a música, os resultados indicam possível discrepância entre o artista usado no treino, Eminem, e Jay-Z no teste. O ideal seria ter mais dados, mais artistas, mais tuning e rodar o modelo várias vezes!
Mas pense no que isso pode estar mostrando. Olhe o diagrama de acordes mais uma vez:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")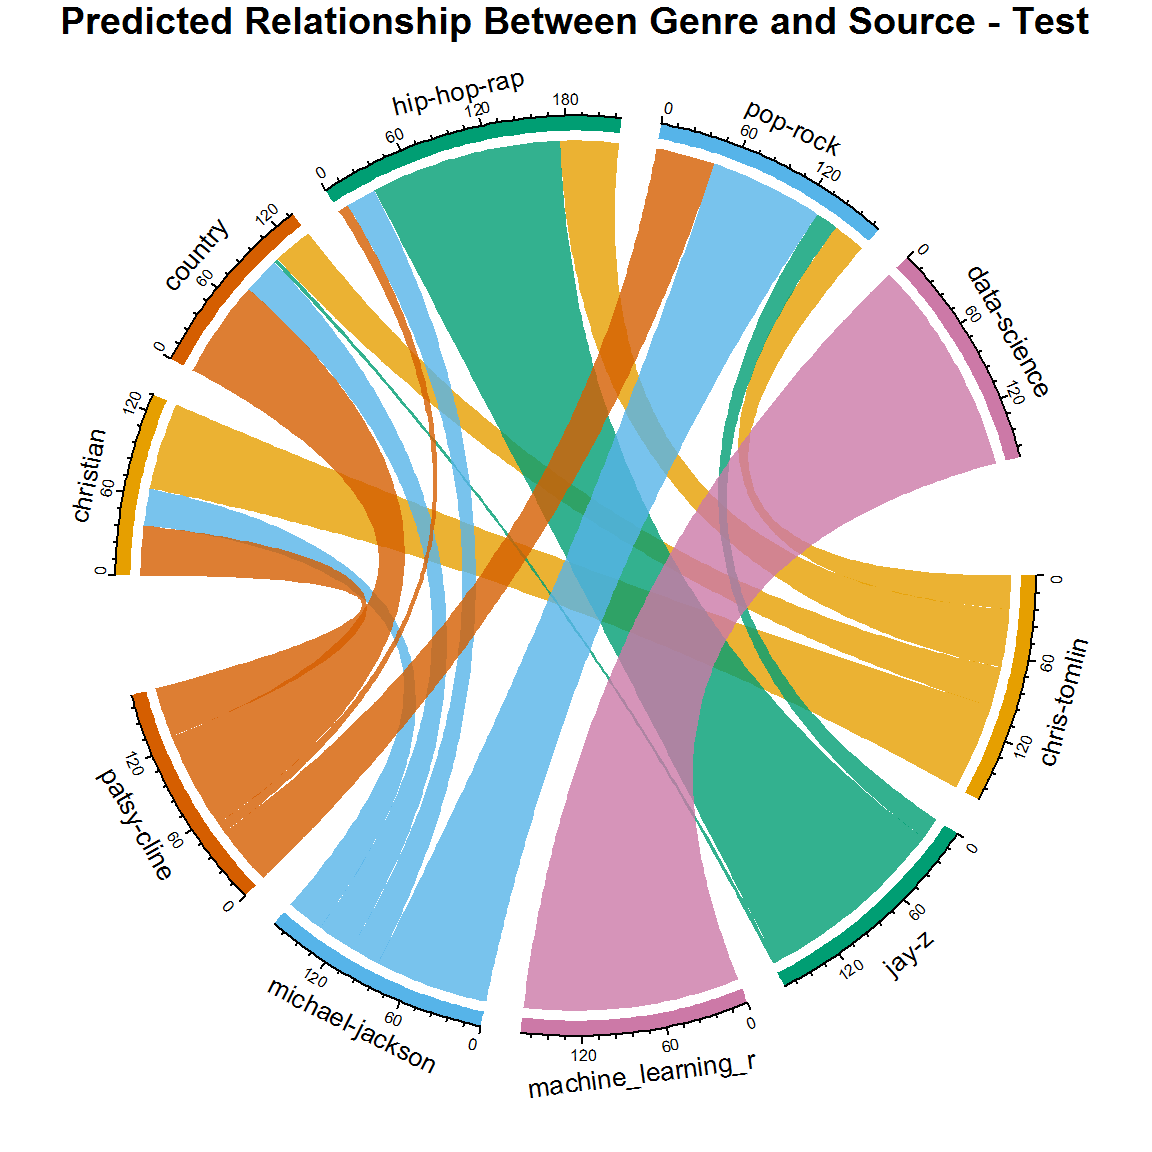
Está errado? Inexato? Ou revelador? Parece que você está tendo um vislumbre real do mundo da música. Pense: Michael Jackson já colaborou com artistas de rap? Já cantou sobre temas religiosos? Artistas country já migraram para o pop-rock? Seu novo diagrama de acordes mostra uma versão mais realista da classificação pelas letras do que o dataset original! No mundo real, raramente há relação um-para-um entre artista e gênero — e essa flexibilidade está capturada no seu modelo.
Na próxima parte, vamos explorar uma ideia aplicável em marketing, vendas, ciência, economia etc., mas aqui aplicada à música. O sucesso de uma canção é subjetivo. Já sucesso comercial pode ser definido por padrões da indústria. As paradas da Billboard (entre outras) são exemplos de medidas desse sucesso. Se você trabalhasse em uma gravadora decidindo quais artistas contratar — ou promover —, não seria interessante prever se eles entrarão nas paradas com base nas letras, usando métodos científicos? Você precisaria de muitos dados atuais e metadados detalhando cada música. Como nossos recursos aqui são limitados, vamos usar o que temos e testar a ideia nas letras do Prince, com dados rotulados de chart.
Nos tutoriais anteriores, você criou um dataset de músicas do Prince em que a maioria não entrou nas paradas. Aqui, usaremos um conjunto balanceado com o mesmo número de músicas que entraram vs. não entraram. Veja os números:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")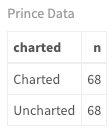
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Usando o mesmo processo, crie atributos em duas etapas. Agora, em vez de contar palavras por gênero, conte por nível de chart. Ou seja, pegue as palavras mais frequentes das músicas que entraram e das que não entraram e guarde em listas. Usei 1.000 palavras e tive melhor resposta com esse número. Teste outros valores. Ao criar os atributos por música, adicione dois campos que contam quantas palavras de cada lista aparecem (mesmo processo usado para gênero).
Note novamente que removi todas as palavras que aparecem tanto nas top de charted quanto uncharted. Também adicionei alguns atributos polinomiais, elevando entradas ao quadrado. Essa ideia de melhorar o modelo não ajustando o algoritmo, mas transformando as entradas, é fundamental em ML.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Repita as etapas: crie uma tarefa de classificação para o dataset do Prince com alvo em charted. Normalize, configure cross-validation e crie a lista de learners. Adicionei alguns algoritmos diferentes aqui porque agora é classificação binária, não multiclasse.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
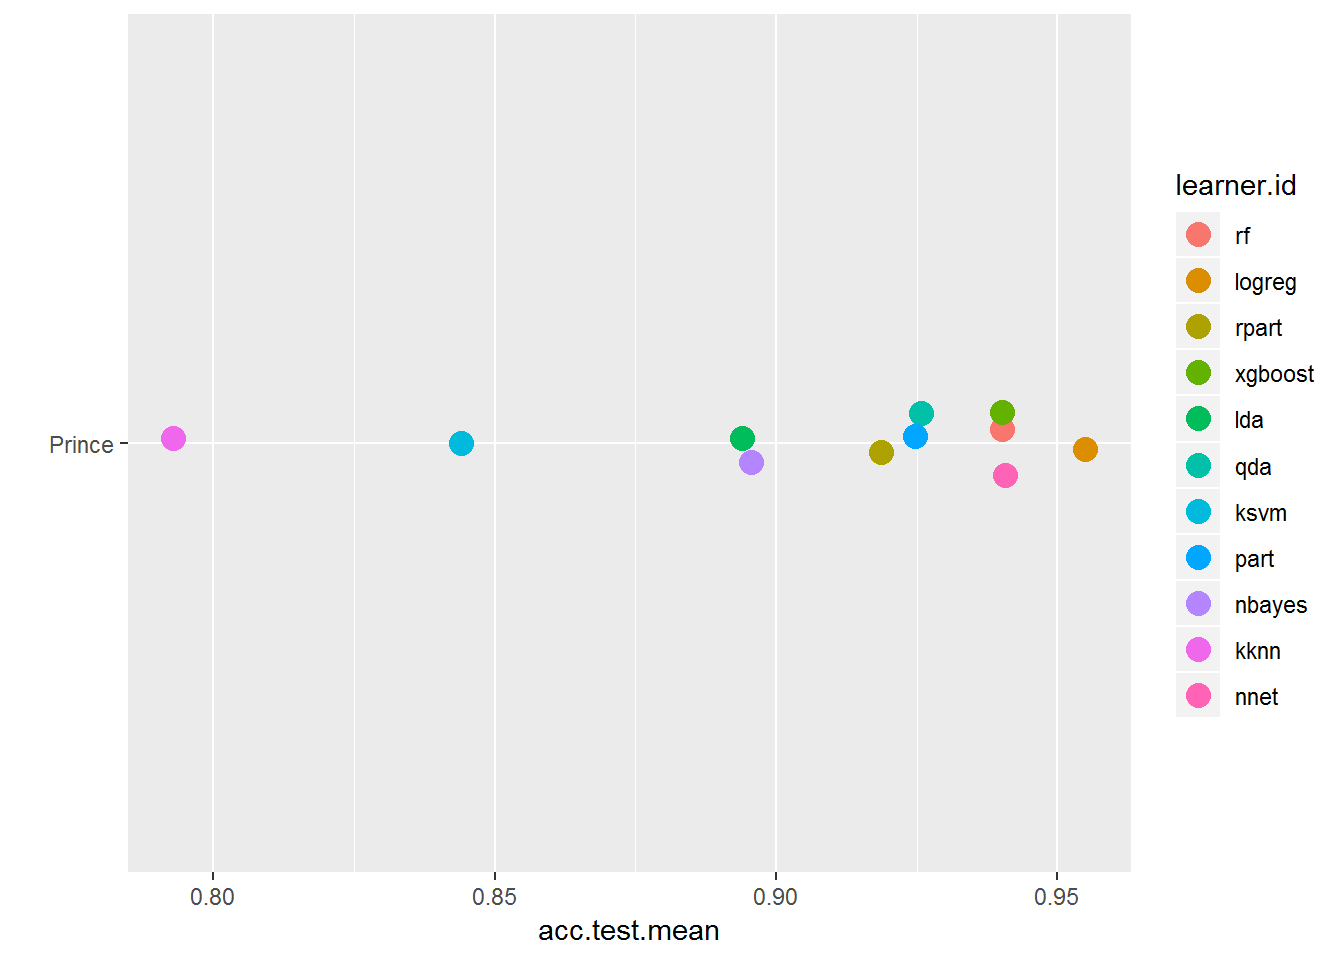
Com os benchmarks criados, examine os resultados em diferentes formatos. Note as diferenças de performance dos learners em relação ao caso anterior.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))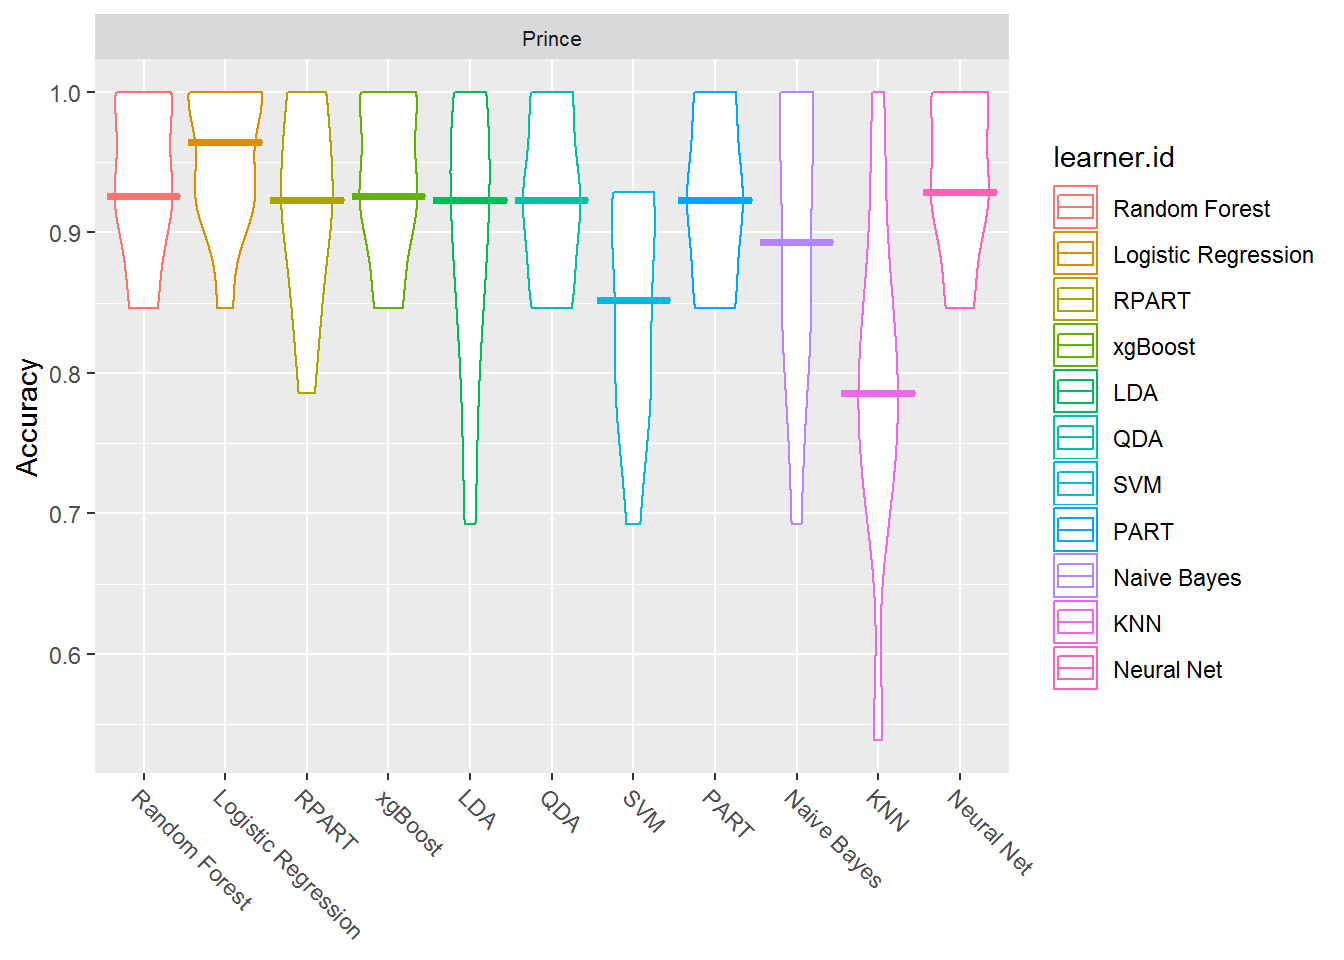
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")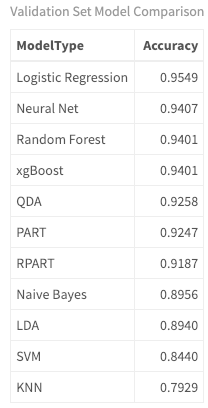
Ao prever o nível nas paradas, agora é um problema de duas classes: charted ou uncharted. Antes, em gênero, era multiclasse (mais de duas classes). (Diferente de um problema multirrótulo, no qual uma observação pode ter mais de um rótulo — tema para explorar!). Por ser binário, adicionei QDA e Regressão Logística, que se adaptam bem a duas classes.
Regressão Logística é projetada para resultados binários e modela a probabilidade de uma observação (música) pertencer a uma categoria. Baseia-se em um limiar padrão de .5. Por exemplo, probabilidades acima de .5 pertencem à classe alvo e abaixo, à outra. Esse limiar é ajustável. QDA (análise discriminante quadrática) é mais flexível para limites de decisão quadráticos em vez de lineares. Não é justo jogar termos técnicos sem contexto — então, olhe seus dados, os algoritmos que performam bem e investigue cada um. A ideia é despertar sua curiosidade para ir a fundo!
O próximo passo é rodar as previsões e olhar as classificações.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")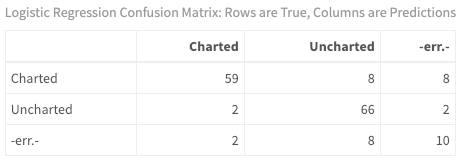
É fácil ver como o modelo classifica cada música individualmente. Em classificação binária, há várias métricas para analisar. Por agora, veja os falsos positivos — isto é, músicas previstas como charted quando, na verdade, não entraram no Top 100.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")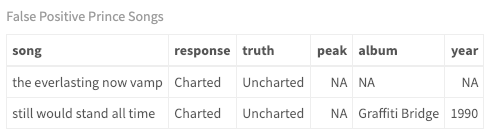
Mesmo usando cross-validation no treino, você deve sempre rodar o modelo em um conjunto separado (como fizemos com gênero). Deixo isso como exercício e adoraria ver seu feedback com os resultados. Para ser um teste real do poder preditivo na análise de letras, os resultados mais realistas viriam de um artista separado também de pop-rock como o Prince. Outro fator é o período: as músicas aqui são majoritariamente dos anos 70, 80 e 90, então um artista do mesmo período é crucial. Ou escolha seus próprios artistas para treino e teste e veja o que acontece!
Neste tutorial, você construiu um modelo para prever o gênero de uma música apenas pelas letras. Usou algoritmos supervisionados de classificação e treinou modelos com cinco artistas e cinco gêneros. Com o framework mlr, você criou tarefas, learners e estratégias de reamostragem para treinar e depois ajustar modelo(s). Em seguida, rodou seu modelo em um conjunto de teste inédito com artistas diferentes. Deu para identificar quais algoritmos funcionam melhor com configurações padrão e, por fim, prever o gênero de músicas que seu modelo nunca viu.
Quanto à análise de letras, deve ter ficado claro que, embora a indústria (e a Billboard) definam gêneros por artista, sua análise sugere que, de acordo com as letras, as músicas atravessam gêneros e raramente há relação um-para-um. (Sendo compositora, meu slogan de gênero é "funkified, acoustic, rockin' soul!"). Você também aplicou as mesmas técnicas para modelar se uma música entra nas paradas apenas pelas letras, com boa acurácia no treino. Sua missão agora é aplicar esse conhecimento aos seus próprios datasets!
Adorei trabalhar com você nesta série de três partes (quatro tutoriais) sobre análise de letras. Espero que você tenha percebido a complexidade desse tipo de texto e as sutilezas das letras em comparação com outros formatos (como não ficção). Tomara que você tenha aprendido novas habilidades e se sinta inspirado a usar seus próprios dados para gerar insights em temas do seu interesse. Machine learning é uma área empolgante — e, como cientista de dados iniciante ou experiente, criatividade, inspiração e persistência vão te destacar. Então, pense fora do paralelogramo quadrilateral e aproveite a jornada!
"Coloquei o pé na linha de partida e parti para um novo dia. Soprei um beijo ao vento, fechei os olhos e chutei o medo para longe." — Debbie Liske, New Day
(Aliás, já escrevi mais de 100 músicas minhas e rodei aquele último modelo no meu repertório. Ele previu que 35 delas deveriam ter entrado nas paradas! Se eu soubesse dessa técnica antes!! Talvez meu próximo artigo seja sobre como usar análise de letras para escrever um hit com base nos artistas da atualidade...)
Mencionei rapidamente os tópicos abaixo e incentivo você a se aprofundar em cada um.
Deixe suas dúvidas nos comentários!
Aqui estão os links dos datasets:
Aprenda mais sobre R e machine learning
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
Moez Ali
14 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Moez Ali
13 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Zoumana Keita
15 min


