Cours
Machine Learning avec caret en R
4 h
60.8K
Si vous avez besoin d'une introduction à l'apprentissage automatique, suivez le cours Introduction to Machine Learning de DataCamp et consultez le tutoriel Introduction to Machine Learning in Python.
Utilisez différents algorithmes de classification en apprentissage automatique (ML) pour construire pas à pas des modèles qui prédisent le genre d'une chanson et sa probabilité de succès dans les classements Billboard — uniquement à partir des paroles !
Voici la troisième partie d’une série de trois tutoriels dans laquelle vous continuez d’utiliser R pour réaliser diverses analyses sur une étude de cas portant sur les paroles du légendaire Prince, ainsi que d’autres artistes et auteurs. Les trois tutoriels couvrent :
En tant que data scientist, vous devez comprendre l’apprentissage supervisé et non supervisé. Ce tutoriel explique — et illustre sur un cas d’usage musical — une forme d’apprentissage supervisé, la classification, basée sur les paroles d’artistes variés (et de quelques auteurs de livres). Vous apprendrez à construire des modèles pour classer des chansons dans leur genre associé et à explorer la possibilité d’utiliser les paroles pour anticiper le succès commercial.
Avez-vous déjà utilisé un service de streaming et de recommandation musicale comme Pandora, iHeart Radio, Spotify, etc. ? Si vous avez créé une station « hard rock », vous ne vous attendez probablement pas à entendre une chanson country sur les bottes de cow-boy et les petites villes. Les systèmes de recommandation musicale se concentrent généralement sur les caractéristiques sonores, et l’analyse des paroles n’apparaît que récemment dans la recherche. Avec les techniques de ce tutoriel, vous pouvez mobiliser des méthodes de pointe étudiées aujourd’hui par les scientifiques pour imaginer des pistes et faire avancer ce domaine en plein essor.
Ce tutoriel suppose une compréhension de base du text mining avec tidytext. C’est une introduction intermédiaire aux techniques de machine learning à l’aide de plusieurs algorithmes de classification populaires. Il est recommandé d’avoir une solide expérience en R, idéalement avec quelques notions de machine learning, et l’envie d’en apprendre davantage sur l’application et l’implémentation via des cas pratiques. Chaque algorithme n’est expliqué que brièvement, mais des liens sont fournis pour approfondir.
Tout au long de l’article, vous utiliserez un framework d’expérimentation en apprentissage automatique pour R appelé mlr. Bien que ce tutoriel ne porte pas sur mlr, vous l’utiliserez largement comme interface avec le processus de machine learning. L’objectif est de simplifier l’explication des étapes de construction d’un modèle avec différents algorithmes. Je recommande vivement ce tutoriel complet sur le package.
Le ML comporte de très nombreux éléments, et vous n’en effleurerez que la surface ici. Contrairement aux parties 1 et 2 de cette série, la narration pourra vous laisser avec plus de questions que de réponses. Vous en tirerez un maximum si vous suivez avec vos propres données et votre code, et recherchez les différents algorithmes à votre rythme.
Voici le déroulé, à haut niveau, de la construction des modèles :
Section 1 : apprendre à prédire le genre à partir de caractéristiques textuelles des paroles.
Pour bien comprendre les données et leurs subtilités, consultez les tutoriels précédents. Gardez à l’esprit que le text mining et l’analytique prédictive sur des paroles sont bien plus complexes que sur des textes non fictionnels : le contexte, le sens et les messages implicites sont souvent masqués par les nuances créatives voulues par l’auteur-compositeur. Comme dans la partie 2-B sur la modélisation de sujets, vous travaillerez avec des artistes de genres différents et le contenu de deux livres sur le machine learning (genre data science, pour introduire une autre forme de texte).
Commencez par charger les bibliothèques puis examinez la structure générale des données.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Comme dans les tutoriels précédents, le code du graphique circulaire ci-dessous peut paraître chargé, mais je ne résiste pas à une belle visualisation. Il affiche une pochette d’album/livre pour chacun des artistes/auteurs de vos données (ensembles d’entraînement et de test). Pour plus de détails sur le package circlize, consultez cet ouvrage de Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)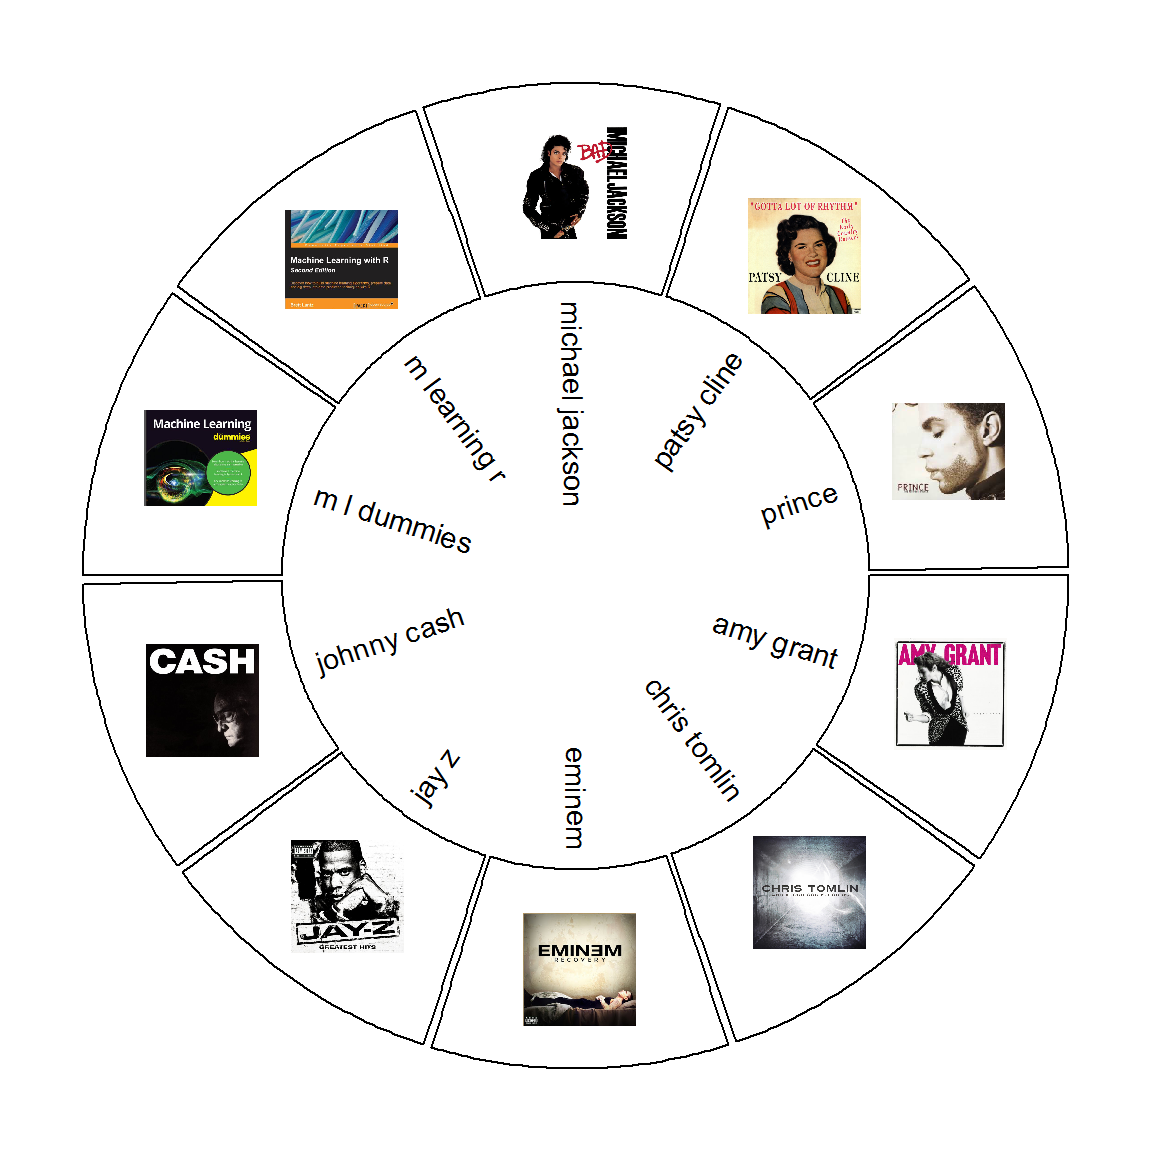
Pour se concentrer sur le modélisage, j’ai préparé les données en amont et vous fournis tout le nécessaire pour l’analyse. Résumé du prétraitement :
pdf_text() du package pdftools pour collecter le contenu de deux livres (chaque page constitue un document distinct) ;Ci-dessous, vous allez lire les données d’entraînement et de test (déjà séparées). Puis utilisez unnest() de tidytext pour créer la version « tidy », une ligne par mot.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)À présent que les données d’entraînement et de test sont chargées et « tidy », regardez combien de chansons existent par artiste/auteur. Comme l’ensemble contient des chansons et des pages de livres, nous parlerons de documents. Les variables que vous allez créer sont basées sur les documents et leurs métadonnées : il est important de garder cela en tête. Et comme il y a des artistes et des auteurs, nous parlerons de la source de chaque document.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")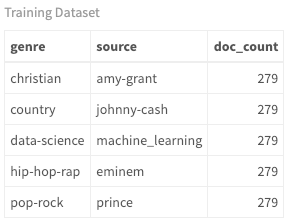
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")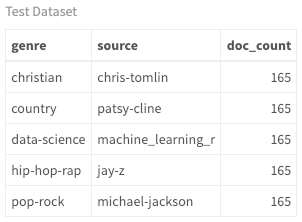
Bien que vous puissiez voir le genre, la source et le nombre de documents, le diagramme chord suivant est un meilleur moyen de visualiser ces relations. Tout au long du tutoriel, vous observerez leur évolution avec vos nouveaux modèles. Actuellement, la relation source-genre est un à un parce que les artistes sont classés ainsi ; toutefois, les artistes « cross-over » sont fréquents, et vous en verrez des indices dans les versions ultérieures de ce diagramme.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")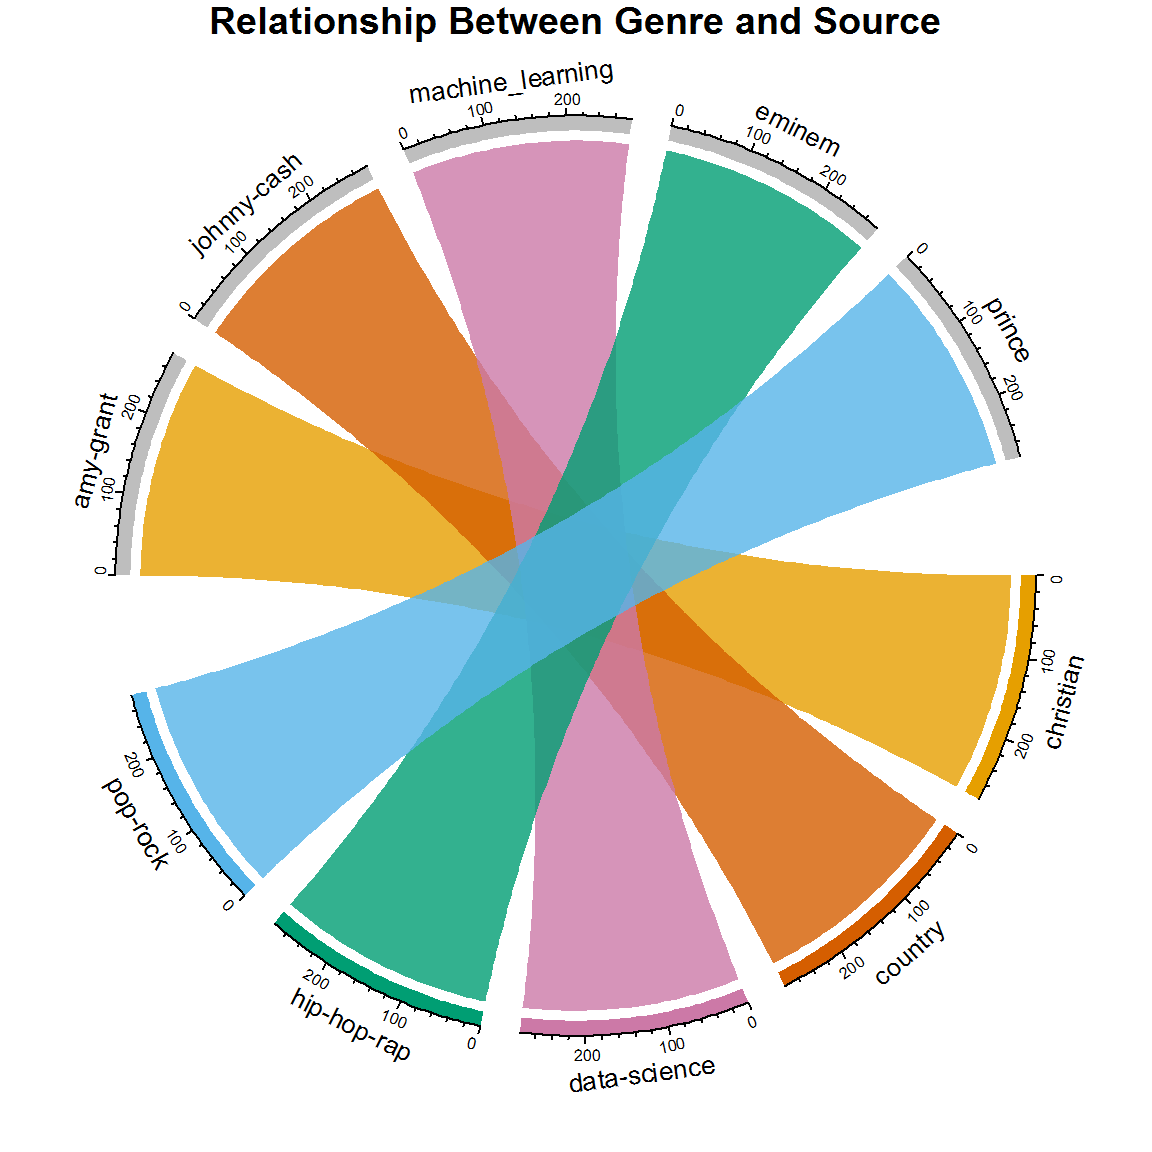
Imaginez à quoi ressemblerait ce diagramme s’il n’y avait pas de relation un à un. Si vous deviez prédire le genre uniquement à partir des paroles, que pensez-vous qu’il se passerait ?
Si vous ne disposiez que des paroles pour classer une chanson, comment créeriez-vous des variables prédictives ? Réfléchissez à ce qui différencie les chansons sur le plan lyrique. Un thème commun est la répétition. Certains genres l’utilisent-ils davantage ? Qu’en est-il de la longueur des mots ? D’autres facteurs pour décrire les paroles ? En calculant ces occurrences par chanson, vous obtenez un premier jeu de prédicteurs.
Notez que toutes les variables ci-dessus sont des caractéristiques quantitatives (comptages, longueurs, etc.) basées sur les mots par chanson. Mais qu’en est-il de mots individuels spécifiques à des genres ? Dans les tutoriels précédents, vous avez travaillé sur l’analyse de sentiments et la modélisation de sujets, centrées sur des mots propres à certains artistes ou genres. En allant plus loin, vous pouvez créer des composantes prédictives majeures basées sur le contenu (ou le contexte). C’est l’étape créative propre à l’analyse de texte qui produit des prédicteurs essentiels.
Commencez par extraire les mots les plus courants par genre. C’était réalisé dans la partie 1. D’abord, calculez le nombre total de mots par genre. Puis regroupez par mots et obtenez leur fréquence. Ensuite, sélectionnez les n mots les plus fréquents définis par la variable number_of_words. Combien de mots choisir ? Trop peu : le modèle ne sera pas optimal. Trop : vous surajustez et brouillez les résultats. En pratique, c’est une affaire d’itérations. J’ai trouvé qu’un total de 5 500 mots donnait un optimum. Testez d’autres valeurs et observez l’impact.
Beaucoup de mots sont communs à plusieurs genres (time, life, etc.). Je les ai retirés avec la variable multi_genre ci-dessous pour obtenir une liste plus propre de mots distinctifs améliorant la séparation entre sources.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Utilisez maintenant ces listes de mots spécifiques aux genres comme variables de votre jeu de données. Comme vous allez créer des features pour plusieurs jeux, créez une fonction pour ne pas vous répéter. Dans cette fonction, vous verrez des références à la diversité et à la densité lexicales. Reportez-vous à la partie 1 pour ces notions.
Réfléchissez à chaque variable ci-dessous et à sa variation potentielle selon le genre. Plutôt que de détailler chaque feature, je me concentre sur les étapes ML qui suivent : prenez un moment pour parcourir le code. Et n’oubliez pas les prédicteurs spécifiques aux genres. Par exemple, country_word_count compte simplement le nombre de mots « country » de tête présents dans chaque chanson. Notez la pondération plus forte accordée aux mots explicites et de livres (10 et 20 dans sum()) car ils sont très distinctifs. Là encore, c’est issu d’itérations.
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Appelez maintenant votre fonction features() pour les jeux d’entraînement et de test.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Si vous n’avez jamais utilisé le package mlr, pas d’inquiétude. Procédez étape par étape : le processus est en réalité simple. Encore une fois, je vous recommande vivement ce tutoriel, la documentation la plus complète sur le sujet, ainsi que mlr.org.
mlr (Machine Learning for R) est un framework qui rassemble la plupart des algorithmes de ML courants. Plutôt que d’expliquer la théorie derrière chacun, nous nous concentrerons sur leur mise en œuvre. À la fin, vous aurez utilisé de nombreux outils de classification — et c’est en pratiquant avec le code que vous en tirerez le plus.
Une fois le feature engineering effectué, le processus ML est direct : créer une tâche, définir un learner, l’entraîner, tester. Étapes :
Une tâche n’est autre que le jeu de données sur lequel un learner apprend. Comme il s’agit d’une classification, créez une tâche avec makeClassifTask(). Indiquez la variable cible, genre, via l’argument target.
J’ai créé trois tâches ci-dessous, chacune avec un objectif différent. Entraînement et test sont évidents, mais il y a aussi un ensemble ne contenant que des features quantitatives « de base » (résumés et comptes). Cette tâche, task_train_subset, est créée sans les variables de décompte de mots par genre (p. ex. country_word_count, pop_rock_word_count, etc.) pour illustrer l’importance de ces prédicteurs contextuels dans le modèle final. Avec le dataset train[3:13], on retire ces variables. Par ailleurs, retirez toujours les colonnes textuelles dans la tâche de classification : ici, ce sont les deux premières colonnes.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
data = test[-c(1:2)], target = "genre")La normalisation mérite qu’on s’y attarde : elle n’est pas toujours nécessaire et dépend du dataset. Ici, elle est bénéfique. Il s’agit de mettre les variables sur une échelle comparable (par exemple entre 0 et 1). Si certaines variables ont des valeurs bien plus grandes, elles peuvent dominer le modèle. La normalisation corrige cela. Ce fil est une bonne entrée en matière. mlr fournit normalizeFeatures() pour cette étape.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Un learner dans mlr se crée avec makeLearner(). Dans le constructeur, vous indiquez la méthode d’apprentissage souhaitée. Obtenez la liste des algorithmes de classification via listLearners("classif")[c("class","package")] pour voir les options et packages dépendants (à installer si besoin).
Pour l’exercice, j’ai choisi une liste gérant plus de deux classes et couvrant un large spectre : arbres de décision, forêts aléatoires, SVM, gradient boosting, réseaux de neurones, etc. Il existe de nombreux learners (plus de 80 actuellement), n’hésitez pas à expérimenter.
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)Le rééchantillonnage est essentiel en ML et mériterait un tutoriel dédié. Il consiste à tirer de façon répétée des échantillons du set d’entraînement et à réajuster le modèle sur chaque échantillon afin d’obtenir des informations indisponibles sur un seul ajustement.
Vous utiliserez ici la validation croisée en k-folds, indiquée par « CV » dans makeResampleDesc() qui renvoie un objet resample description (rdesc). L’approche divise aléatoirement le dataset en k groupes de taille égale : un fold sert de validation, les autres à l’entraînement. On répète l’opération k fois. Le taux d’erreur est capturé à chaque itération et moyenné.
Si c’est votre première exposition au rééchantillonnage, cela peut sembler abstrait, mais c’est un passage obligé. Vous utiliserez une validation croisée en 10 folds. « Pour la classification, il est généralement souhaitable d’avoir la même proportion de classes dans chaque fold. » (Source) Utilisez stratify = TRUE pour l’assurer.
Pour en savoir plus sur le rééchantillonnage dans mlr, consultez cet article.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)L’objectif typique en classification est une forte précision de prédiction et un minimum d’erreurs, en considérant les types d’erreurs de la même manière. Toutefois, selon les contextes, certaines erreurs coûtent plus cher que d’autres (p. ex. en santé). Différentes métriques existent pour adresser ces nuances. Pour l’analyse des paroles, nous regarderons surtout l’accuracy et l’erreur — en gardant à l’esprit que ces métriques ne sont pas toujours les plus pertinentes.
L’accuracy est le nombre de prédictions correctes sur l’ensemble des prédictions. Pour examiner les erreurs de classification, on utilise aussi une matrice de confusion (prédit vs réel). Pour l’instant, définissez une liste de mesures d’intérêt. J’en ajoute trois ici, mais nous observerons acc. Ce lien détaille les mesures disponibles.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)Dans mlr, vous pouvez conduire une expérience de benchmark où différents algorithmes sont appliqués à votre dataset. Cela permet de comparer selon les mesures d’intérêt (p. ex. l’accuracy). Vous exécuterez benchmark() pour entraîner vos modèles et générer un objet BenchmarkResult contenant modèles et résultats.
Passons à la construction du premier modèle. Commencez avec la tâche sans les décomptes de mots spécifiques aux genres. Passez à benchmark votre liste de learners, la tâche « subset », la stratégie de rééchantillonnage (rdesc) et la liste des mesures souhaitées.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252En regardant l’objet BenchmarkResult, vous voyez le acc.test.mean pour chaque algorithme. Il s’agit de la précision moyenne sur les jeux de validation de la validation croisée pendant l’entraînement — à ne pas confondre avec le jeu de test externe que vous utiliserez plus loin.
Ici, Random Forest est en tête avec r rf_perf % (et le temps d’entraînement le plus long). En gardant ce repère, relancez l’expérience sur l’ensemble complet de features.
Cette fois, utilisez la tâche incluant le décompte de mots spécifiques au genre par document. Cela ajoute des indicateurs tels que la présence plus marquée de mots « country », « pop-rock », etc. À partir de votre dataset labellisé, vous avez extrait les mots hip-hop les plus fréquents dans hip_hop_words (par ex. thug, crib, drug). La liste country contient lonesome, coal, drunken, cattle, etc.
mlr propose plusieurs méthodes pour accéder aux résultats de benchmark. J’en utiliserai quelques-unes, mais pour vous familiariser avec l’objet, je vous conseille les fonctions getBMR*. Un str() sur l’objet risquerait d’être très long.
Avant le détail de l’ensemble complet, benchmarkez plusieurs tâches et comparez l’ensemble complet au sous-ensemble précédent via plotBMRSummary(). Pour cela, créez une liste de tâches à passer à benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)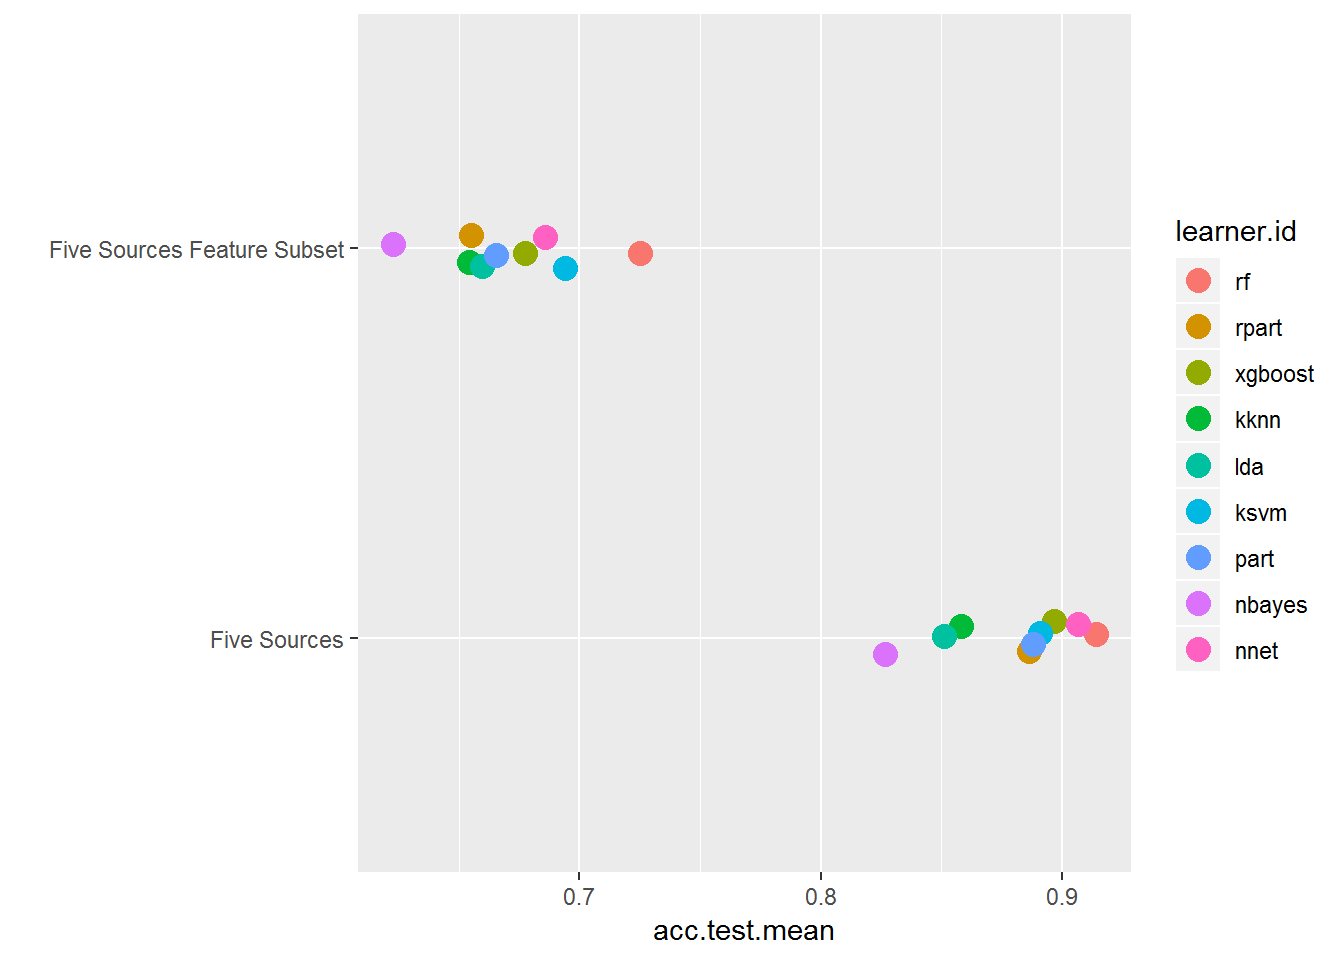
On voit ici que le acc.test.mean du sous-ensemble sans les décomptes par genre est inférieur à celui de l’ensemble complet. Ces features font donc une vraie différence ! Cette étape créative est propre au machine learning sur texte : à garder en tête pour vos projets.
Bien que vous puissiez extraire uniquement les résultats d’entraînement de bmr_multi_task, relancez un benchmark sur la seule tâche d’entraînement et regardez de plus près via getBMRAggrPerformances() et plotBMRBoxplots().
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)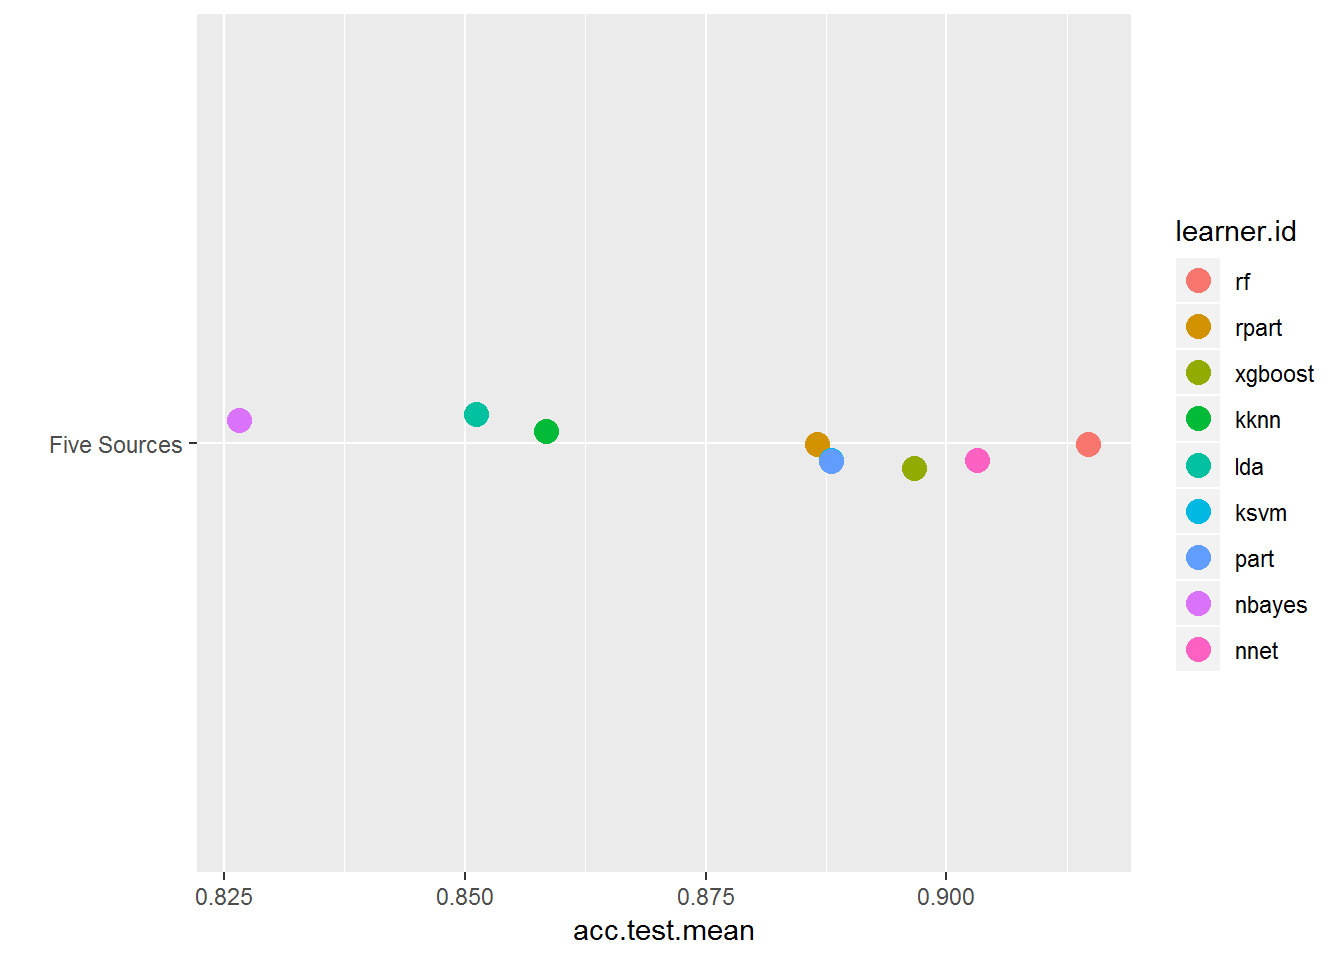
Cela permet de zoomer sur les résultats avec toutes les features. La supériorité de random forest apparaît clairement.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))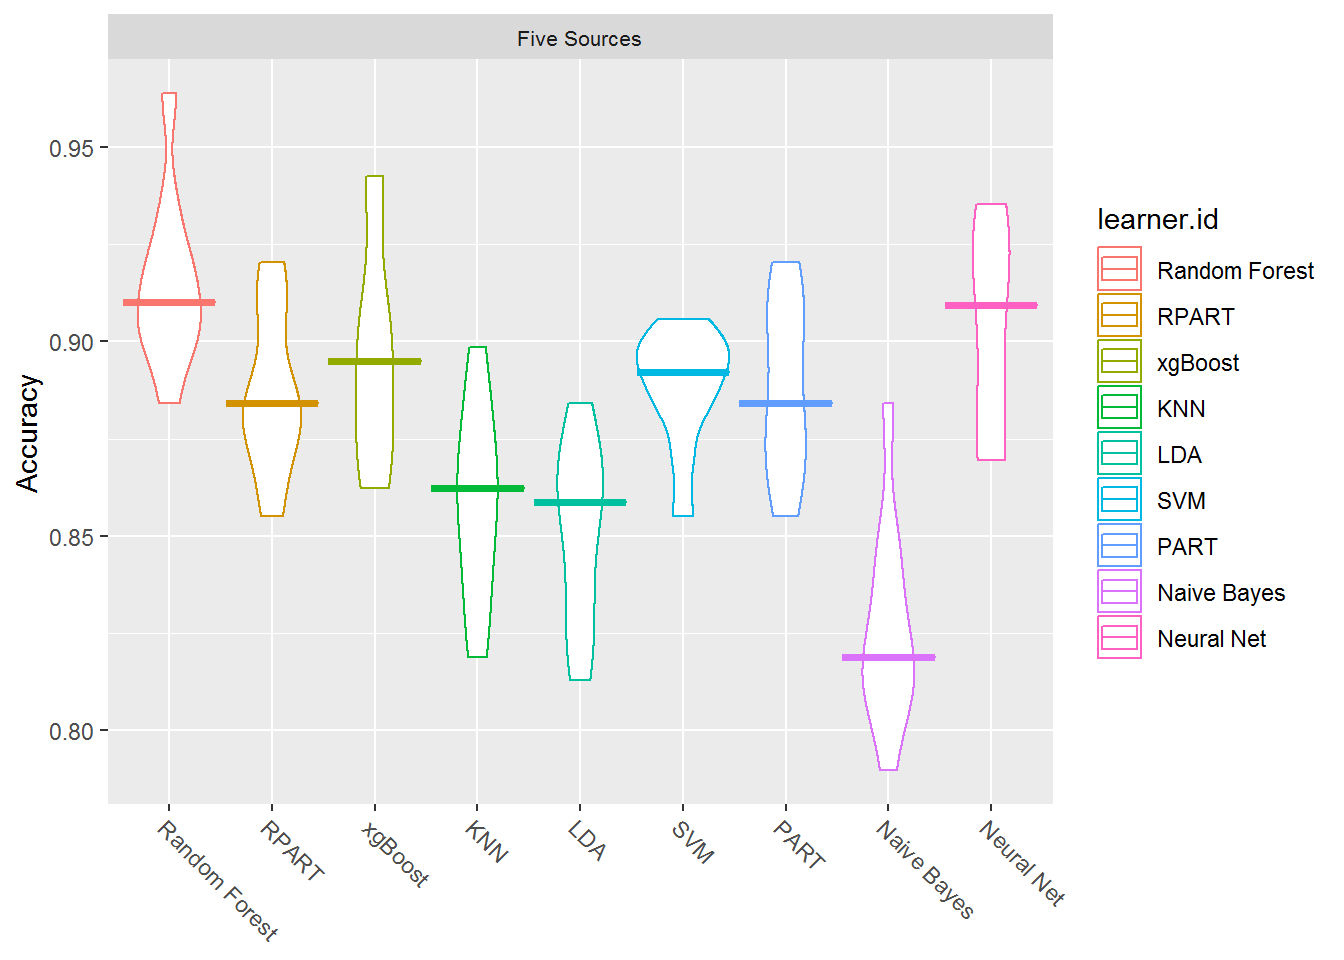
Ces boîtes à moustaches (violons) montrent les résultats pour chaque méthode à travers les itérations de benchmark.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")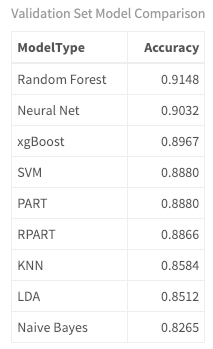
Ici, l’accuracy est la plus élevée pour Random Forest, Neural Net et xgBoost avec des précisions de r first_three %, respectivement. Mais concrètement, comment les documents/chansons ont-ils été classés ? Quels genres posent le plus de difficultés ? Pour approfondir, observez la matrice de confusion des prédictions. Les bonnes classifications sont sur la diagonale, les erreurs hors diagonale. Les colonnes sont les valeurs prédites, les lignes les valeurs réelles. Utilisez getBMRPredictions() pour accéder aux prédictions apprentissage/validation. Puis regardez le result de la matrice de confusion du modèle Random Forest (id Five Sources défini plus haut). (Vous pourriez le faire pour tout modèle des résultats.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")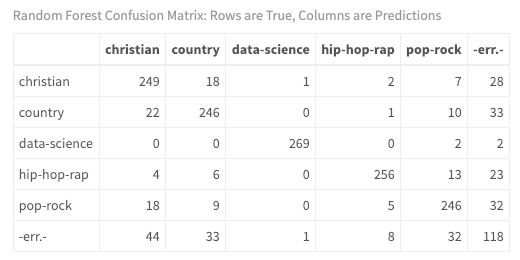
Vous obtenez enfin de l’insight ! Sans surprise, avec une seule erreur, il est relativement facile de distinguer des documents de data science de paroles de chansons avec les features textuelles que vous avez conçues. De plus, le hip-hop-rap se distingue fortement des autres genres avec seulement huit erreurs. En revanche, malgré une performance solide, la séparation est moindre entre country, christian et pop-rock.
Le but du tutoriel est autant d’exposer des techniques prédictives que de poursuivre l’analyse de paroles. Réfléchissez à ce que ces résultats impliquent. Si vous développiez un système de recommandation enrichi par les paroles, quelles précautions prendriez-vous ? Votre système risquerait-il de recommander un artiste hip-hop aux paroles explicites à un auditeur de musique chrétienne ou de country ?
Souvenez-vous du diagramme chord au début. Regardez-le de nouveau, cette fois avec les prédictions plutôt que les labels réels.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")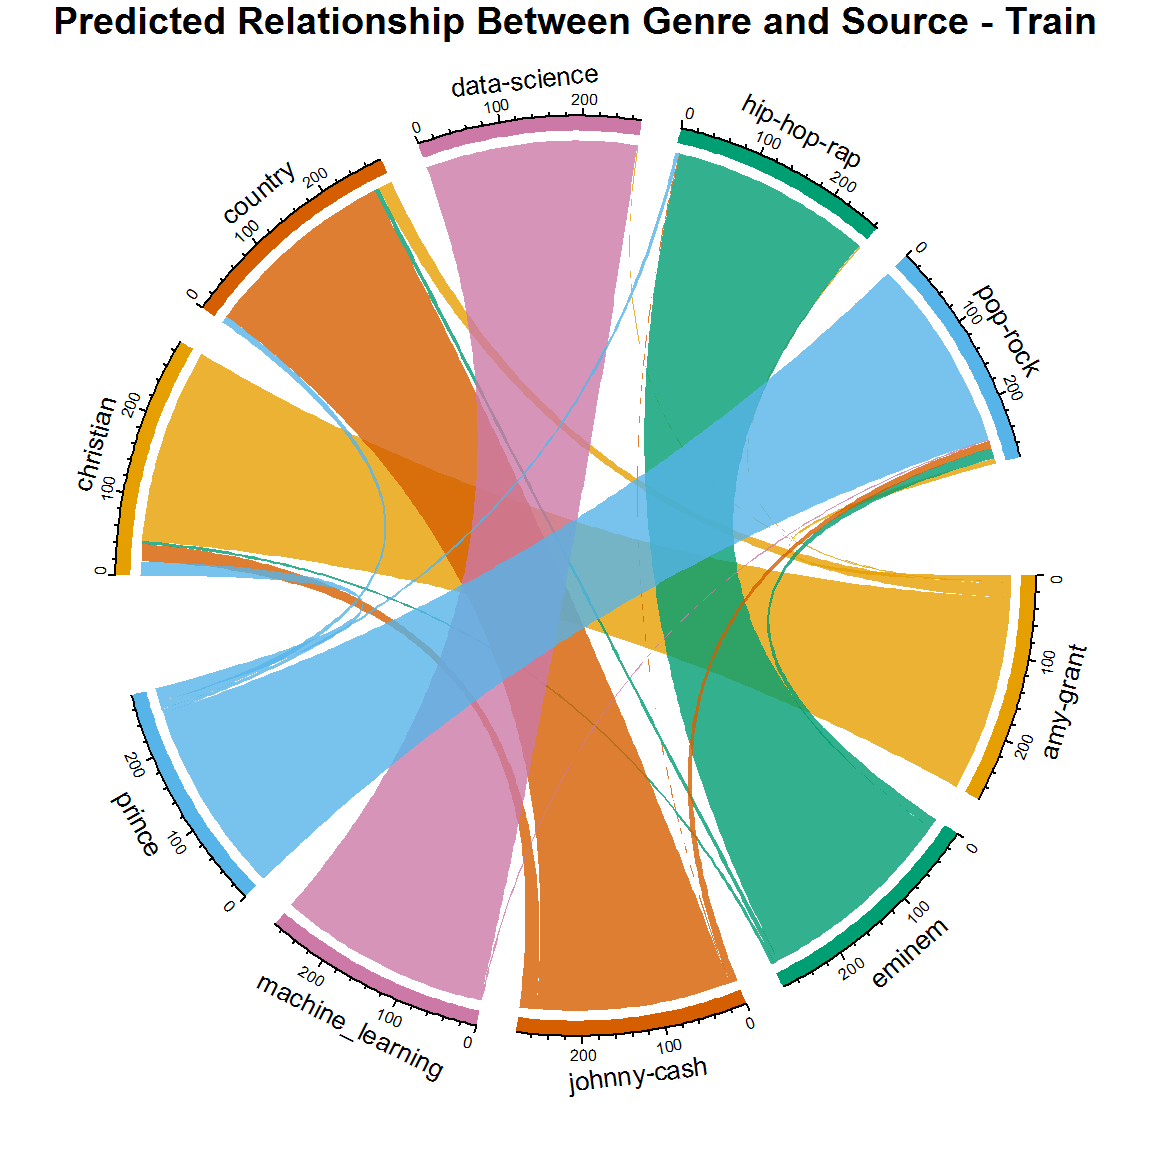
Plutôt convaincant. Vous voyez la performance sur les données d’entraînement. Les petits liens représentent les erreurs. Mais voici un concept clé : même s’il s’agit de précision sur jeux de validation, cela reste basé sur des données d’entraînement labellisées. Gare au surapprentissage (variance élevée) — votre algorithme peut être sensible au bruit des nouvelles données. Vous allez exécuter un vrai test avec des données inédites.
Avant de tester, choisissez un modèle et affinez-le en ajustant ses hyperparamètres. Sur Kaggle, un algorithme tendance domine les compétitions : le gradient boosting extrême. Même s’il n’a pas été le meilleur ici, je le choisis pour l’affiner et l’exécuter sur le jeu de test. Si vous découvrez cet algorithme, le tuning sera probablement la partie la plus ardue. Compte tenu de la portée de ce tutoriel, je ne détaille ni le gradient boosting ni les hyperparamètres, mais le code ci-dessous vous mettra sur les rails. Je recommande cet article de Prince Grover pour démarrer : Gradient boosting from scratch.
Modéliser d’abord avec des modèles simples, analyser les erreurs (points difficiles à ajuster), puis concentrer les modèles suivants sur ces points. Enfin, combiner tous les prédicteurs en leur attribuant des poids.
(Note : la valeur maxit de 150 dans makeTuneControlRandom() est longue à exécuter. Commencez plus bas pour tester.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Examinez les paramètres optimisés dans la sortie de tuneParams(). Créez ensuite un nouveau modèle avec ces hyperparamètres puis réentraînez-le sur le jeu d’entraînement.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))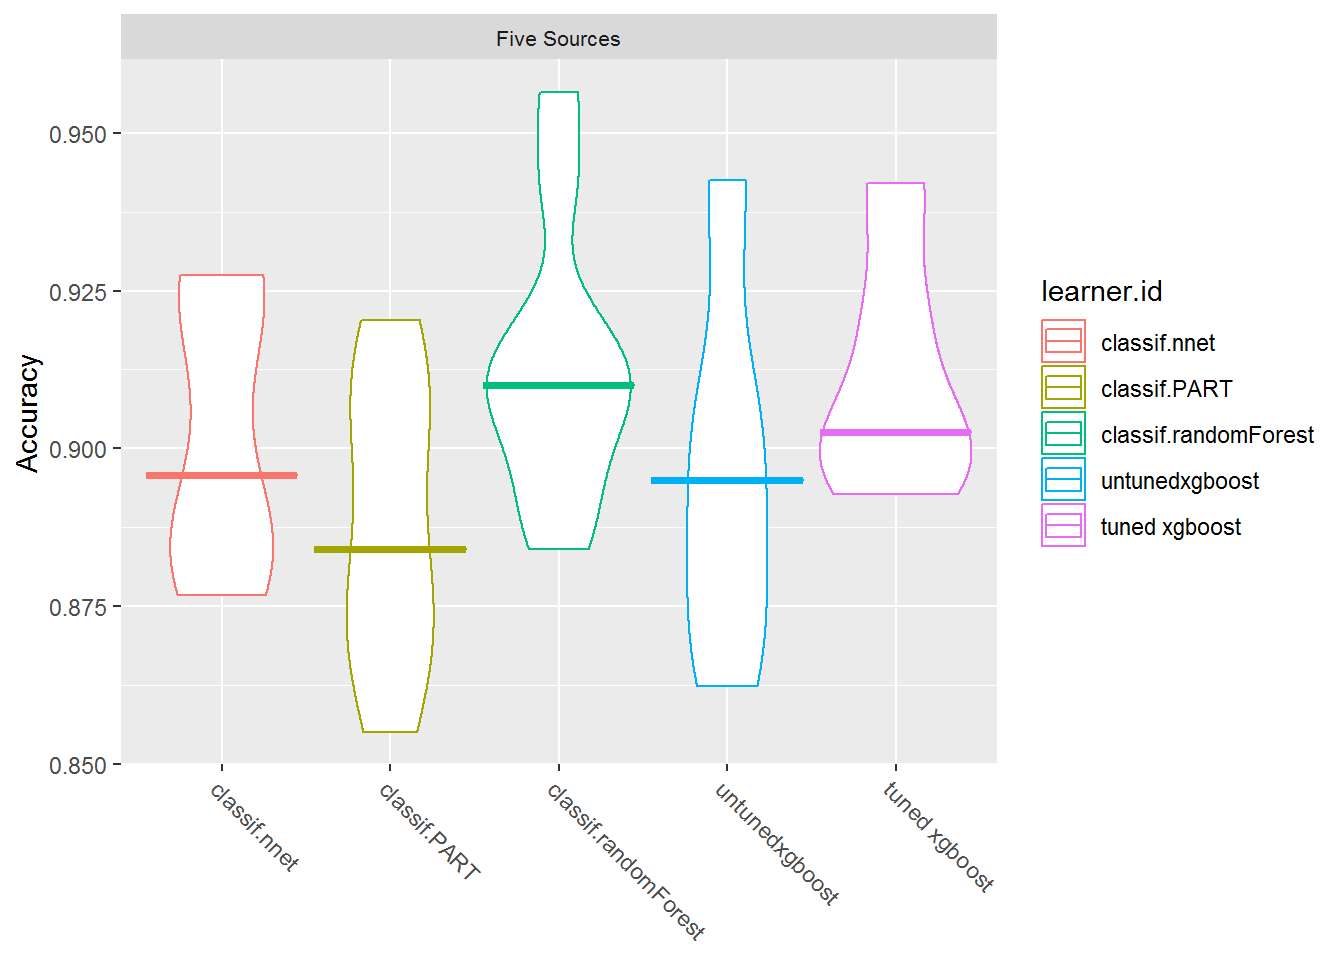
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")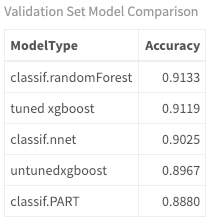
Le xgBoost ajusté est seulement légèrement supérieur à la version non tunée et reste moins précis que Random Forest. Mais qu’en est-il sur le jeu de test ?
Maintenant que vous avez votre modèle ajusté et les benchmarks, utilisez predict() pour vos trois meilleurs modèles sur le jeu de test — jamais vu auparavant. Il comprend cinq sources entièrement différentes comme montré plus tôt. Observez la performance et les classifications réelles.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Résultats intéressants : même si Random Forest avait une meilleure précision sur l’entraînement que le xgBoost ajusté, il est légèrement moins précis sur le test. L’accuracy du réseau de neurones baisse aussi fortement. Les réseaux de neurones étant très flexibles, ils peuvent surajuster l’entraînement.
Avec une précision de r round(test_perf,2)*100 % pour le xgBoost ajusté, la baisse de performance sur le test par rapport à l’entraînement est marquée — et le tuning n’apporte qu’un léger gain (avec cette configuration minimale). Cette chute entre train et test est courante et illustre pourquoi il faut toujours tester sur des données nouvelles.
Regardons maintenant les classifications réelles.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")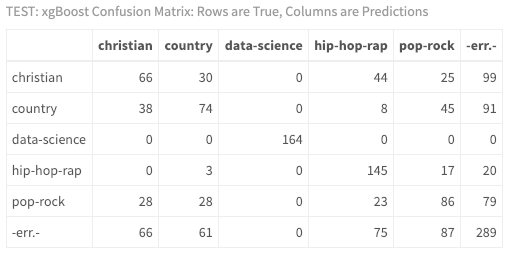
À la lecture de la matrice de confusion, on voit qu’il a été bien plus difficile de classer cet artiste hip-hop, Jay-Z. Même sans connaître la musique, vos résultats suggèrent un écart entre l’artiste d’entraînement Eminem et Jay-Z en test. Idéalement, vous auriez plus de données, plus d’artistes, davantage d’ajustements — et feriez tourner votre modèle plusieurs fois !
Mais réfléchissez à ce que cela révèle. Regardez encore le diagramme chord :
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")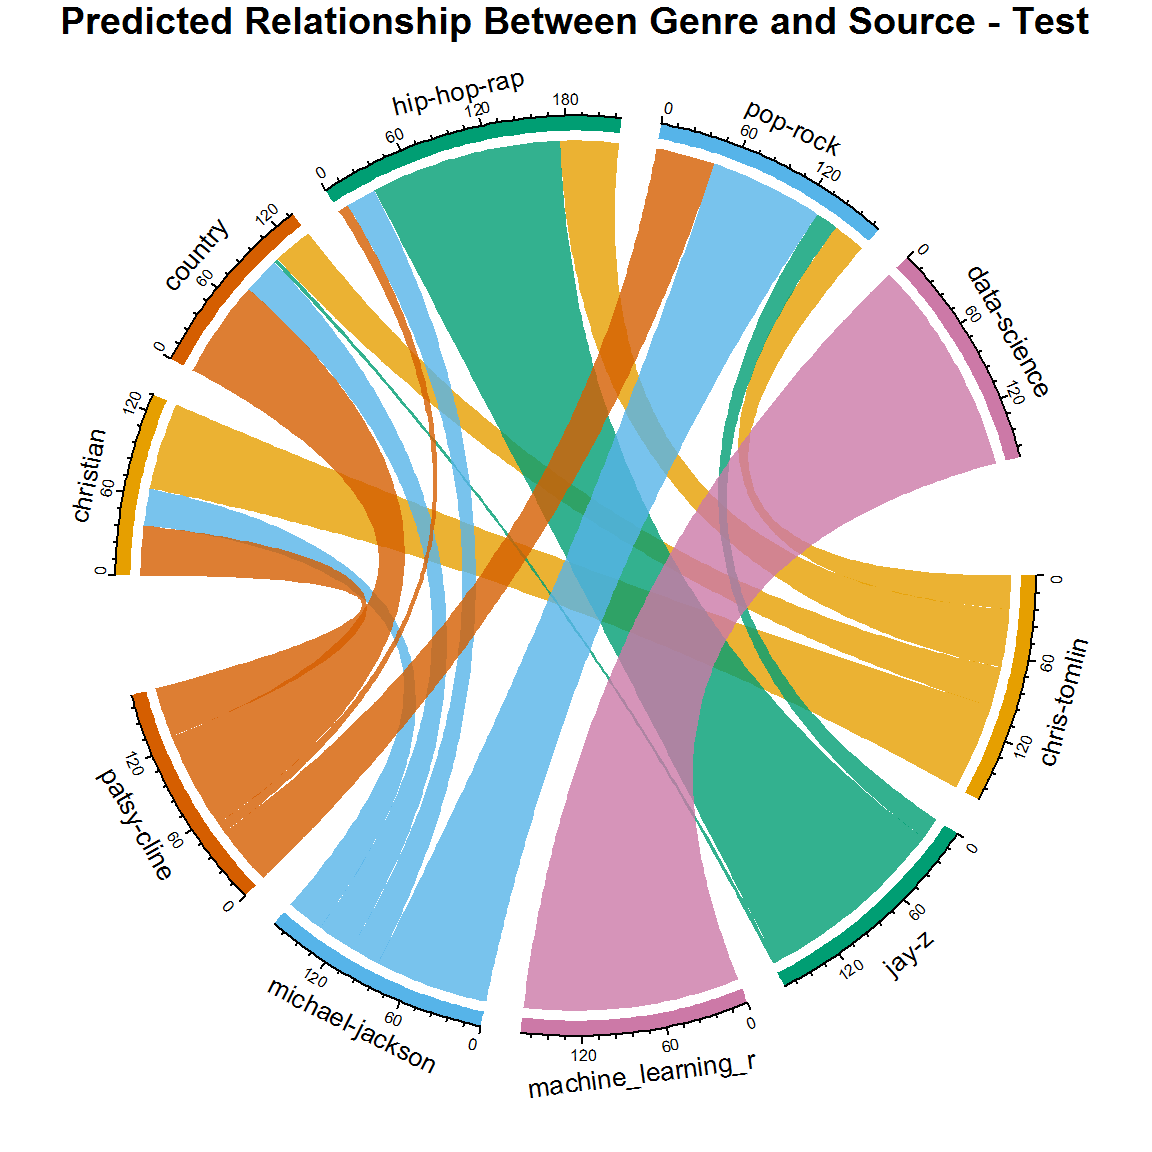
Est-ce faux ? Inexact ? Ou instructif ? Vous entrevez le monde de la musique : Michael Jackson a-t-il collaboré avec des rappeurs ? A-t-il chanté des thèmes religieux ? Des artistes country ont-ils déjà traversé vers le pop-rock ? Votre nouveau diagramme donne en fait une vision plus réaliste de la classification par paroles que l’ensemble d’origine. Dans la vraie vie, il n’y a pas toujours de relation un à un entre artiste et genre — et cette souplesse est reflétée par votre modèle.
Pour la suite, explorons une idée transposable au marketing, aux ventes, aux sciences, à l’économie, etc., mais appliquée ici à la musique. Le succès d’une chanson est subjectif. Le succès commercial est plus clair, car défini par des standards du secteur. Les classements Billboard (entre autres) en sont une mesure. Si vous travailliez pour un label et deviez décider quels artistes signer — ou promouvoir — ne serait-il pas intéressant de prédire, à partir des paroles, s’ils se classeront dans les charts ? Il faudrait beaucoup de données récentes et de métadonnées. Avec des ressources limitées ici, testons l’idée sur les paroles de Prince avec des labels de classement.
Dans les tutoriels précédents, vous avez créé un dataset des chansons de Prince où la majorité n’étaient pas classées. Nous utiliserons un ensemble équilibré avec autant de morceaux classés que non classés. Voici les chiffres :
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")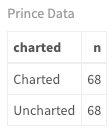
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)En reprenant le même procédé, créez les features en deux étapes. Cette fois, au lieu de compter les mots par genre, comptez par niveau de classement. En d’autres termes, extrayez les mots les plus fréquents des chansons « classées » et « non classées », et stockez-les dans des listes. J’ai retenu 1 000 mots, qui a donné de bons résultats dans mon cas. Testez vos propres valeurs. Puis, lors de la création des features par chanson, ajoutez deux variables qui comptent le nombre de mots présents dans chacune des listes (même logique que pour les genres).
Notez que j’ai retiré tous les mots apparaissant à la fois dans les tops « classés » et « non classés ». J’ai aussi ajouté quelques features polynomiales en élevant au carré certaines entrées. Améliorer un modèle en transformant les entrées — plutôt qu’en changeant l’algorithme — est une idée clé en ML.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Répétez les mêmes étapes : créez une tâche de classification pour le dataset de Prince avec charted comme cible. Normalisez, paramétrez la validation croisée et créez une liste de learners. J’ai ajouté quelques algorithmes supplémentaires, car il s’agit ici d’une classification binaire, et non plus multi-classes.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
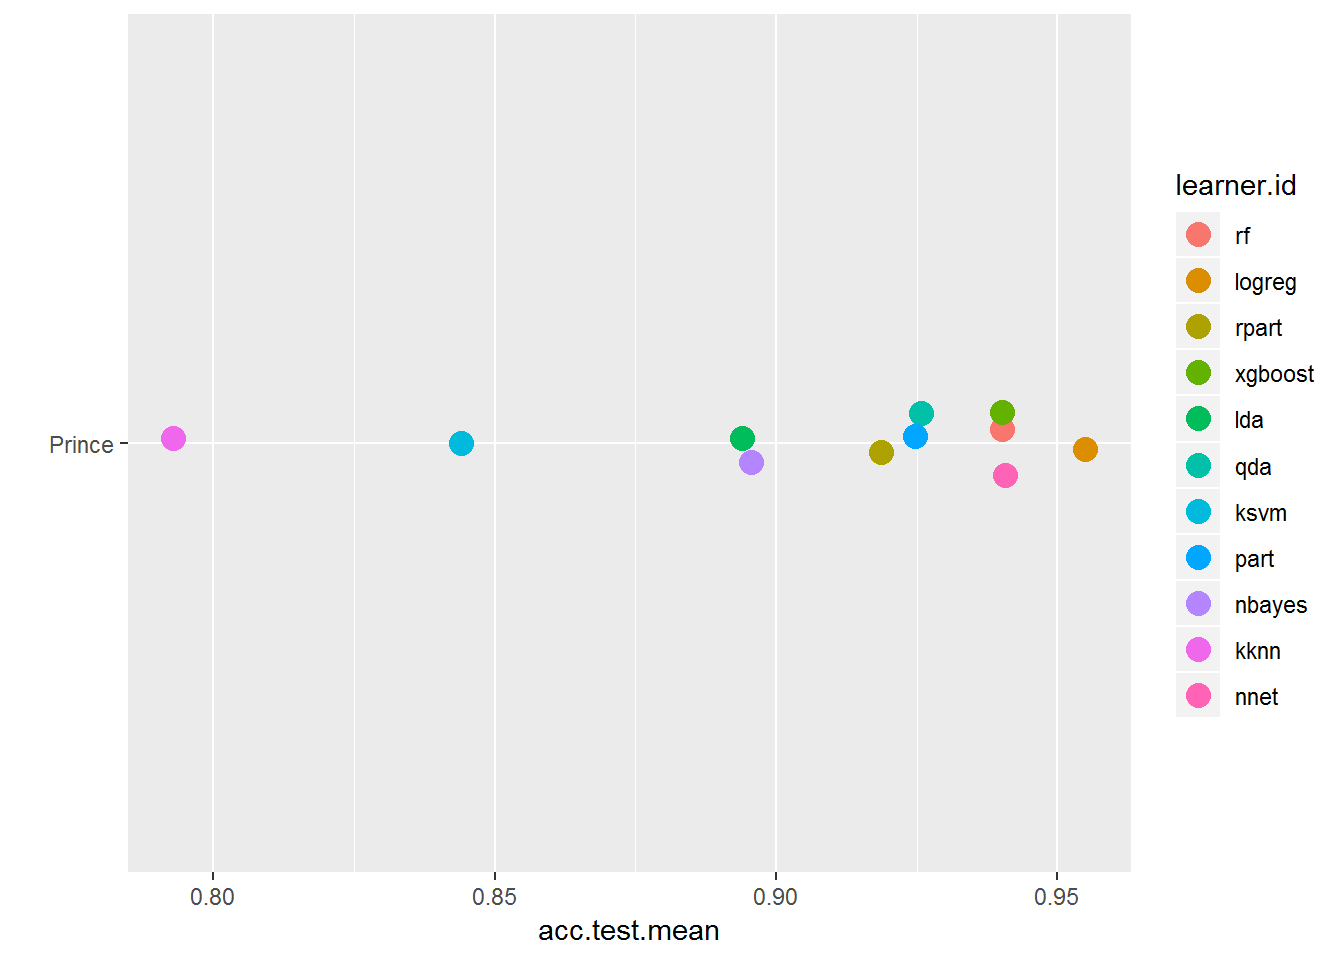
Maintenant que les benchmarks sont créés, examinez les résultats sous plusieurs formats. Remarquez les différences de performance par learner par rapport à la section précédente.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))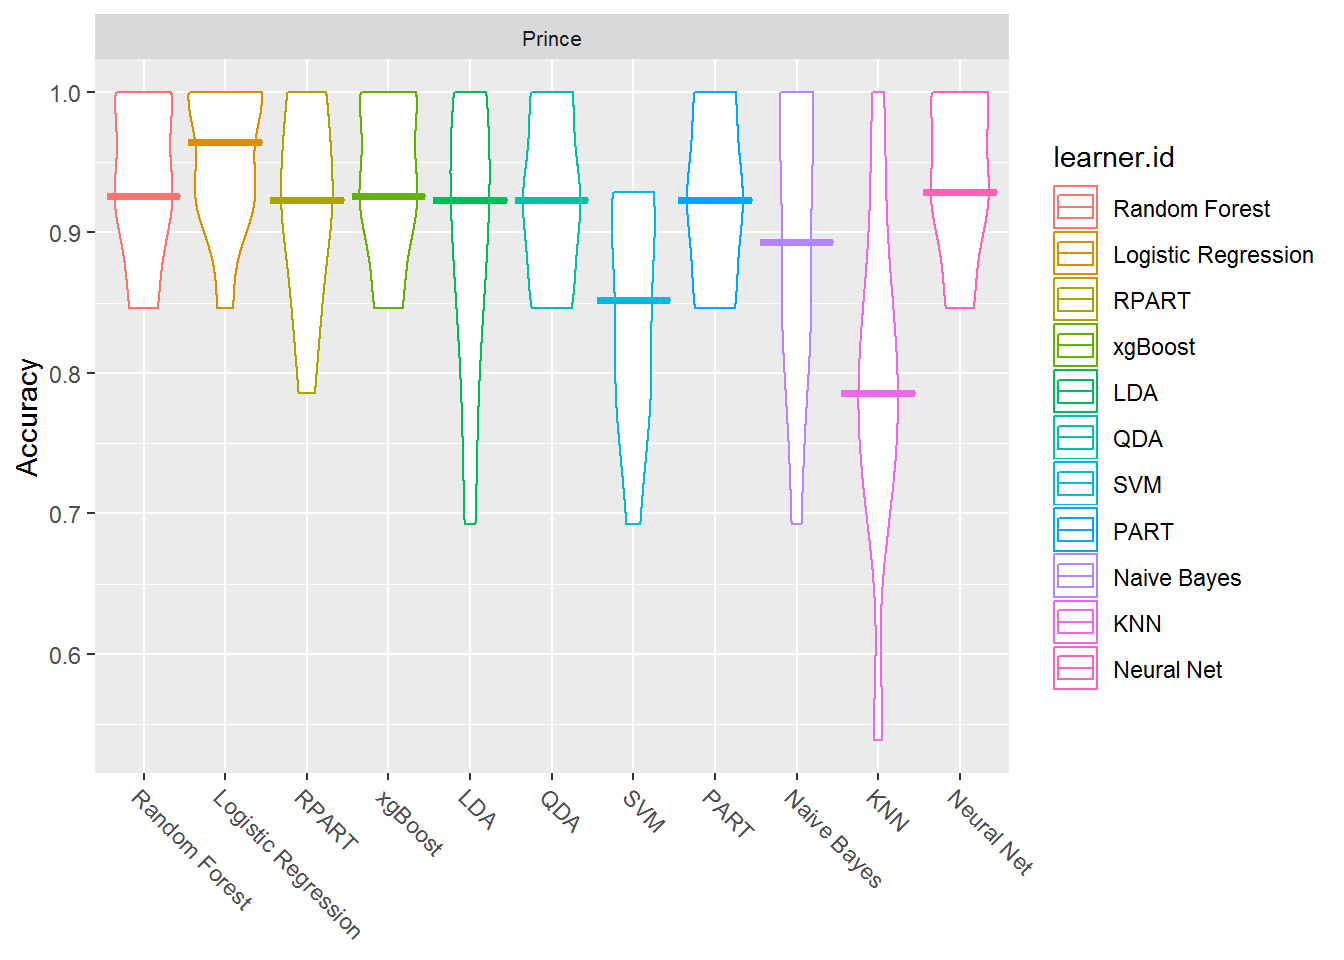
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")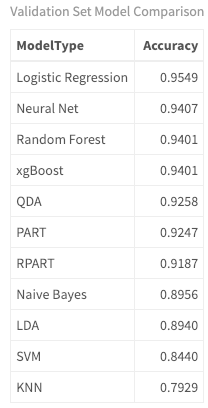
Pour prédire le niveau de classement, vous traitez un problème à deux classes : classé ou non classé. Pour le genre, c’était un problème multiclasses (plus de deux classes). (À ne pas confondre avec le multi-label, où une observation peut avoir plusieurs classes.) Étant une classification binaire, j’ai ajouté QDA et régression logistique, mieux adaptés à ce cas.
La régression logistique est conçue pour un résultat binaire et modélise la probabilité qu’une observation (chanson) appartienne à une catégorie, avec un seuil par défaut à .5 (ajustable). QDA (quadratic discriminant analysis) est plus flexible pour des frontières de décision quadratiques plutôt que linéaires. Je vous encourage à étudier les données, les algorithmes performants et à approfondir chaque méthode.
Étape suivante : exécuter les prédictions et examiner les classifications.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")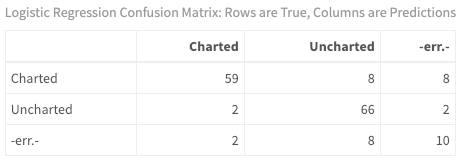
Il est très simple d’examiner comment le modèle classe chaque chanson individuellement. En binaire, il existe de nombreuses mesures. Pour l’instant, regardons les faux positifs : les chansons prédites « classées » alors qu’elles n’ont pas atteint le Top 100.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")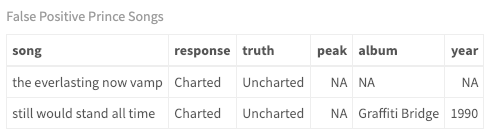
Même si vous avez utilisé la validation croisée à l’entraînement, exécutez toujours le modèle sur un dataset séparé (comme pour le genre). Je vous laisse l’exercice et espère vos retours. Pour un test réaliste de la puissance prédictive de l’analyse de paroles, le mieux serait un artiste distinct mais du même genre (pop-rock) que Prince, et de la même époque (années 70–90). Ou bien choisissez vos propres artistes pour l’entraînement et le test, et voyez ce que vous obtenez.
Dans ce tutoriel, vous avez construit un modèle pour prédire le genre d’une chanson à partir de ses seules paroles. Vous avez utilisé des algorithmes de classification supervisée et entraîné des modèles sur un ensemble de cinq artistes et cinq genres. Avec le framework mlr, vous avez créé des tâches, des learners et des stratégies de rééchantillonnage pour entraîner puis ajuster des modèles. Enfin, vous avez testé sur un dataset inédit d’artistes différents. Vous avez identifié les algorithmes les plus performants avec les réglages par défaut et, in fine, prédit le genre de nouvelles chansons jamais vues.
Concernant l’analyse de paroles, il apparaît clairement que, même si l’industrie musicale (et les classements Billboard) pré-définissent des genres par artiste, votre analyse montre qu’au regard des paroles, les chansons franchissent les genres et qu’il n’y a pas toujours de relation un à un. (Étant songwriter moi-même, ma signature de genre est « funkified, acoustic, rockin' soul! »). Vous avez également utilisé les mêmes techniques pour modéliser la probabilité qu’une chanson entre dans les charts à partir de ses paroles, avec une précision correcte à l’entraînement. À vous d’appliquer ce savoir à vos jeux de données.
J’ai pris plaisir à travailler avec vous tout au long de cette série en trois parties (quatre tutoriels) sur l’analyse de paroles. J’espère que vous mesurez la complexité de ce type de texte et les subtilités des paroles face à d’autres formes (non fiction). J’espère aussi que vous avez acquis de nouvelles compétences et que vous êtes inspiré·e pour explorer vos propres données. Le machine learning est un domaine passionnant : en tant que data scientist débutant·e ou confirmé·e, créativité, inspiration et persévérance feront la différence. Alors, pensez en dehors du parallélogramme quadrilatéral et bonne exploration !
« I put my foot on the starting line, and took off into a brand new day. I blew a kiss into the wind, closed my eyes and kicked the fear away. - Debbie Liske, New Day »
(Au fait, j’ai écrit plus de 100 chansons et j’ai fait tourner le dernier modèle sur ma musique. Il a prédit que 35 de mes titres auraient dû entrer dans les charts ! Si seulement j’avais connu cette technique plus tôt !! Mon prochain article devrait peut-être porter sur l’usage de l’analyse de paroles pour écrire un hit à partir des artistes actuels…)
J’ai effleuré les thèmes ci-dessous : je vous encourage à approfondir chacun.
N’hésitez pas à poser vos questions dans les commentaires !
Voici les liens vers les jeux de données :
Approfondissez R et le machine learning
Cours
Cours
Cours