Kurs
R ile caret kullanarak Machine Learning
4 sa
60.9K
Makine öğrenimine girişe ihtiyacınız varsa, DataCamp'in Introduction to Machine Learning kursunu alın ve Introduction to Machine Learning in Python eğitimine göz atın.
Bir şarkının türünü ve Billboard listelerinde başarılı olup olmayacağını—tamamen şarkı sözlerine dayanarak—adım adım tahmin eden modeller oluşturmak için çeşitli makine öğrenimi (ML) sınıflandırma algoritmalarını kullanın!
Bu, efsanevi sanatçı Prince'in yanı sıra diğer sanatçılar ve yazarların şarkı sözleri üzerine vaka çalışmasında R kullanarak çeşitli analitik görevleri gerçekleştirmeye devam edeceğiniz üç bölümlük eğitim serisinin Üçüncü Bölümü'dür. Üç eğitim şu konuları kapsar:
Bir Veri Bilimci olarak, hem gözetimli hem de gözetimsiz öğrenmeyi anlamanız gerekir. Bu eğitim, çeşitli sanatçıların (ve birkaç kitap yazarının) şarkı sözlerine dayanan, özellikle sınıflandırma biçimindeki bir gözetimli öğrenme türünü açıklar ve bir müzikal kullanım örneği sunar. Şarkıları ait oldukları türe göre sınıflandıracak modellerin nasıl oluşturulacağını ve ticari başarıyı belirlemek için şarkı sözlerinin kullanılmasının olasılığını nasıl araştıracağınızı öğreneceksiniz.
Pandora, iHeart Radio, Spotify vb. gibi bir müzik akışı ve otomatik öneri internet radyo hizmeti kullandınız mı? Sert rock istasyonu kurduysanız, muhtemelen kovboy çizmeleri ve küçük kasabalar hakkında bir country şarkısı duymayı beklemezsiniz. Tipik müzik öneri sistemleri ses niteliklerine odaklanırken, söz analizi ancak şimdi araştırma makalelerinde yer almaya başlıyor. Bu eğitimdeki tekniklerle, bilim insanlarının bugün araştırdığı en güncel yöntemlerden yararlanarak bu gelişmekte olan alanı ilerletmeye yönelik fikirler geliştirebilirsiniz.
Bu eğitim, tidytext kullanarak metin madenciliğine ilişkin temel bir anlayış varsayar. Birkaç popüler sınıflandırma algoritmasını kullanan makine öğrenimi tekniklerine yönelik orta seviye bir giriş niteliğindedir. R programlama konusunda kayda değer deneyime sahip olmanız, tercihen makine öğrenimi hakkında bir miktar bilgi sahibi olmanız ve uygulamalı kullanım örnekleri aracılığıyla uygulamasını ve uygulamasını daha fazla öğrenmek istemeniz önerilir. Her algoritma yalnızca kısaca açıklanmıştır, ancak daha derinlemesine inceleme için her zaman bağlantılar sağlanmıştır.
Bu makale boyunca R'de makine öğrenimi deneyleri için mlr adlı bir çerçeve kullanacaksınız. Bu eğitim mlr hakkında olmasa da, makine öğrenimi sürecine bir tür arayüz olarak kapsamlı biçimde kullanacaksınız. Amaç, farklı algoritmalarla model oluşturmanın çeşitli adımlarının açıklamasını basitleştirmek için bundan yararlanmaktır. Paketle ilgili bu kapsamlı eğitimi şiddetle tavsiye ederim.
ML'in çok sayıda bileşeni vardır ve bu eğitimde yalnızca yüzeyine dokunacaksınız. Bu serinin Bir ve İki numaralı bölümlerinden farklı olarak, anlatım size cevaplardan çok soru bırakabilir. Kendi verileriniz ve kodunuzla birlikte ilerler ve farklı algoritmaları kendi hızınızda araştırırsanız deneyimden en iyi şekilde yararlanırsınız.
Modellerinizi oluşturmanın adımlarına ilişkin yüksek seviyeli bir taslak:
Bölüm Bir: Sözsel özelliklere göre türün nasıl tahmin edileceğini öğrenin.
Veriyi ve nüanslarını gerçekten anlamak için önceki eğitimlere göz atmak isteyeceksiniz. Unutmayın, şarkı sözleri üzerinde madencilik ve öngörücü analitik yapmak, bağlam, anlam ve ince mesajların sıklıkla söz yazarının yaratıcı nüanslarının altında gizli olması nedeniyle kurgu dışına kıyasla oldukça karmaşıktır. Bölüm İki-B'deki konu modellemesinde olduğu gibi, farklı türlerden sanatçılarla ve makine öğrenimi üzerine iki kitabın içeriğiyle (başka bir metin türünü tanıtmak amacıyla veri bilimi türü) çalışmaya devam edeceksiniz.
Kütüphaneleri yükleyerek başlayın ve sonra verinin genel yapısına göz atın.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Önceki eğitimlerde olduğu gibi, aşağıdaki çember grafik için olan kod karmaşık görünebilir, ancak havalı bir görsele asla karşı koyamıyorum. Bu, verinizdeki her sanatçı/yazar için bir albüm/kitap kapağını gösterir. Bu, test ve eğitim veri kümelerini kapsar. circlize paketi hakkında daha fazla ayrıntı için Zuguang Gu'nun bu kitabına bakın.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)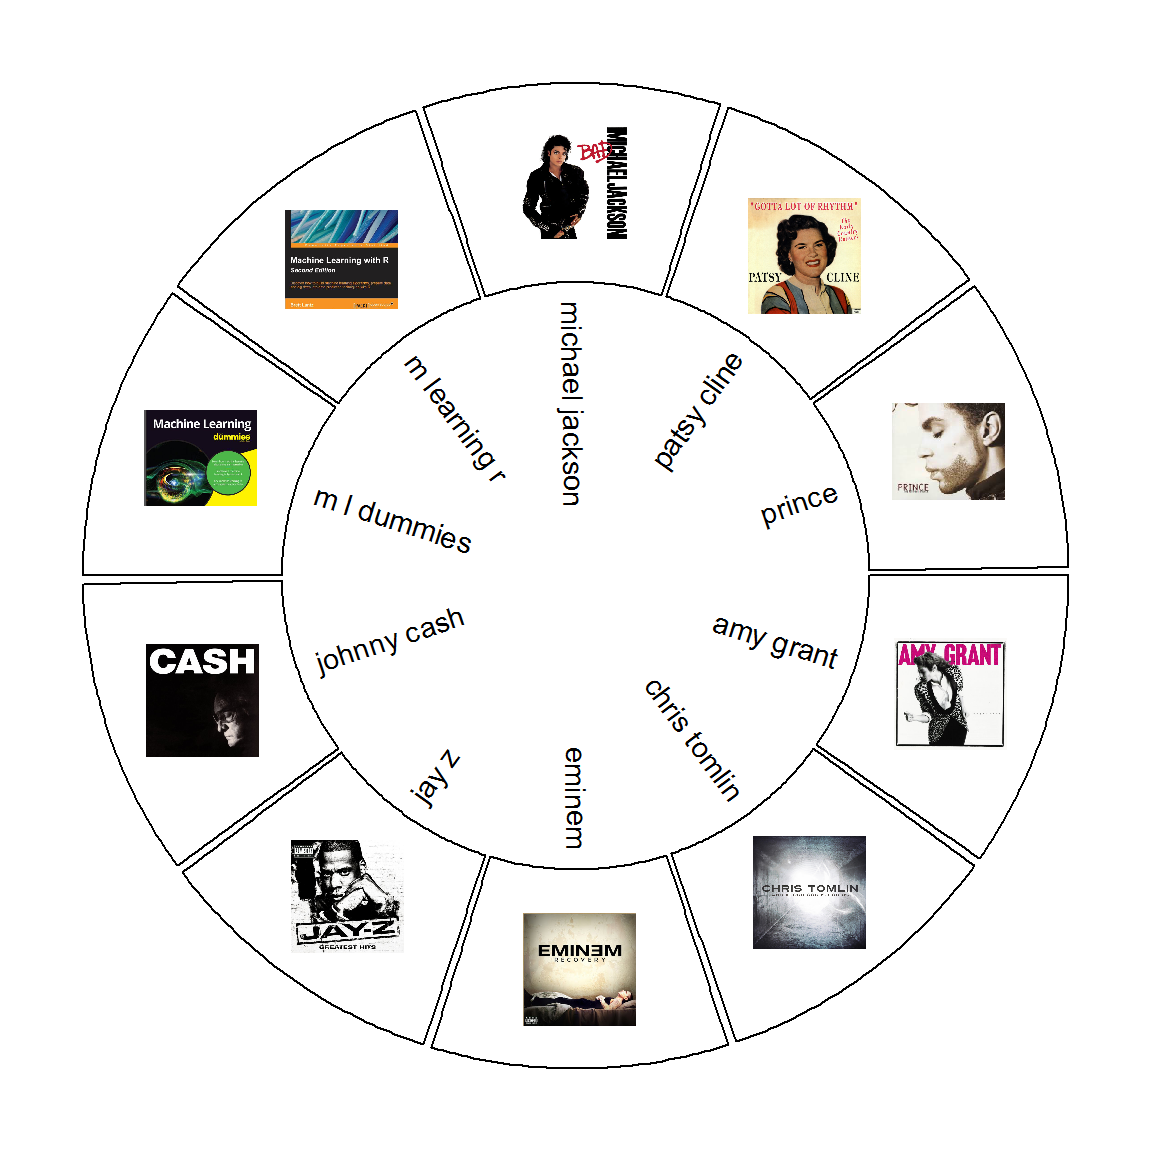
Modellemeye odaklanabilmek için bu eğitimin dışında veri koşullandırma yaptım ve analiz için ihtiyacınız olan tüm verileri sağladım. Ön işleme özetleri şunlardır:
pdftools paketindeki pdf_text() fonksiyonu, iki kitabın içeriğini toplamak için kullanıldı (her sayfa ayrı bir belgeyi temsil eder)Aşağıda ayrı yüklenmek üzere zaten bölünmüş olan eğitim ve test verilerini içe alacaksınız. Ardından, her kayıtta bir kelime olacak şekilde tertipli sürümü oluşturmak için tidytext içindeki unnest() fonksiyonunu kullanın.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Artık eğitim ve test verilerini yükleyip tertiplediğinize göre, sanatçı/yazar başına kaç şarkı olduğunu görebilirsiniz. Veri kümesi şarkılar ve kitap sayfaları içerdiğinden, her birine bir belge olarak atıfta bulunacağım. Oluşturacağınız özellikler belgeler ve ilişkili meta verilerine dayanır, bu nedenle bu kavramı anlamak önemlidir. Ayrıca, sanatçılar ve yazarlar olduğundan, her belgenin kaynağı olarak adlandıracağım.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Eğitim Veri Kümesi")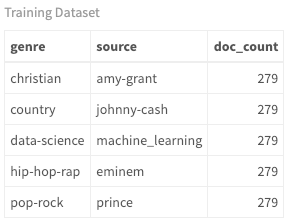
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Veri Kümesi")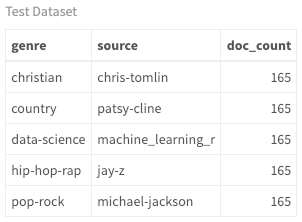
Tür, kaynak ve belge sayısını görebilmenize rağmen, aşağıdaki akor diyagramı bu ilişkileri görüntülemenin daha iyi bir yoludur. Eğitim boyunca, yeni modellerinizle bu ilişkilerin nasıl değiştiğini görebilirsiniz. Şu anda kaynak ile tür arasında bire bir ilişki vardır çünkü sanatçılar bu şekilde sınıflandırılmıştır; ancak geçiş yapan sanatçılar oldukça yaygındır ve bu diyagramın daha sonraki sürümlerine baktığınızda bunun kanıtını göreceksiniz.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Tür ve Kaynak Arasındaki İlişki")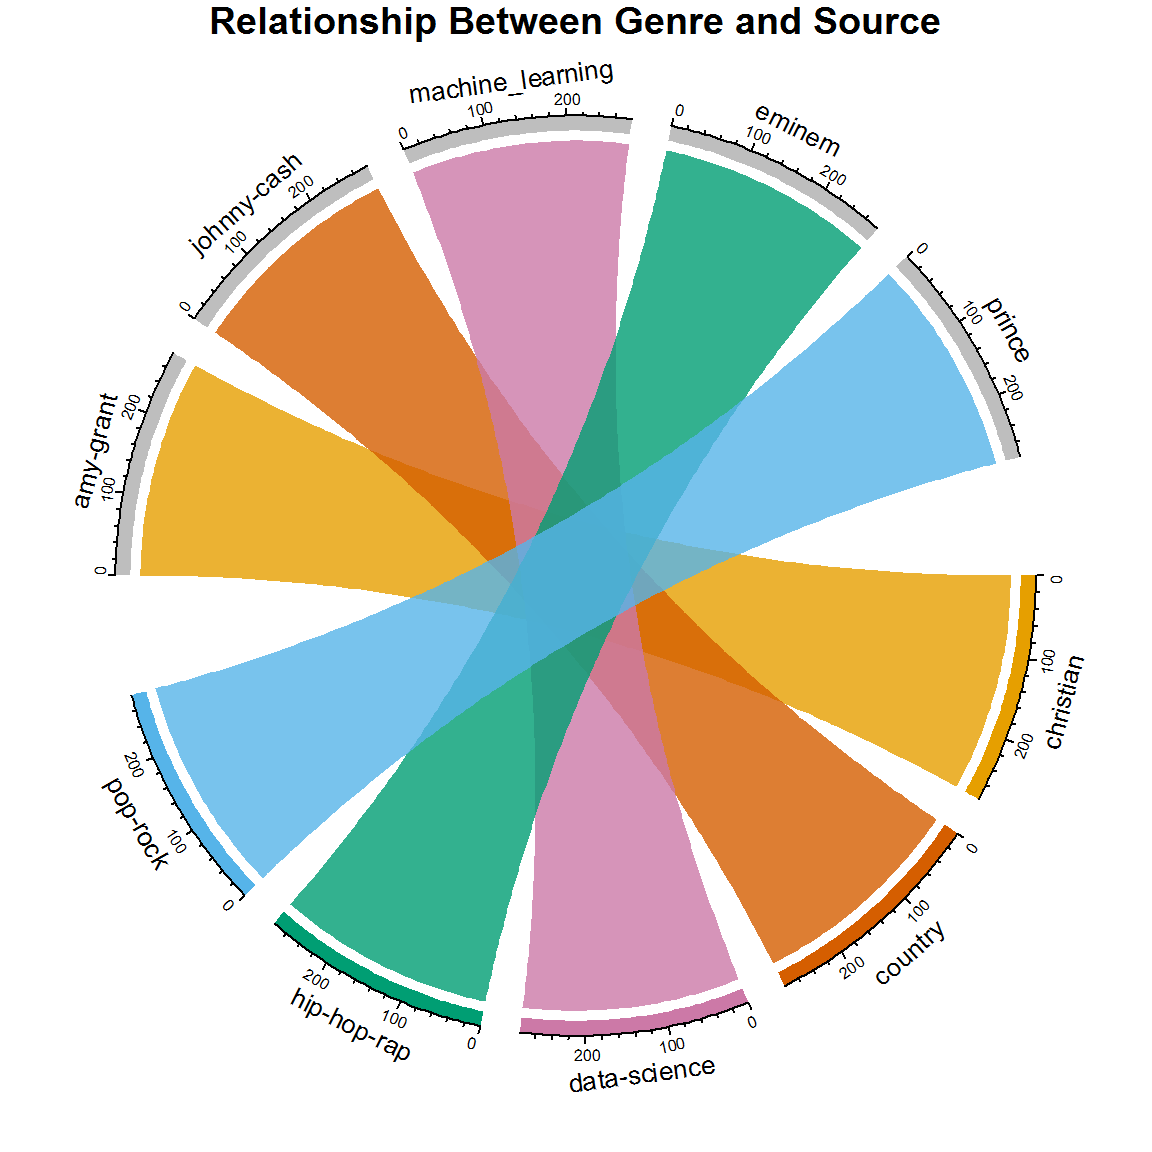
Eğer bire bir ilişki olmasaydı bu diyagramın nasıl görüneceğini düşünün. Türü yalnızca şarkı sözlerine göre tahmin etseydiniz, sizce ne olurdu?
Bir şarkıyı sınıflandırmak için elinizde yalnızca şarkı sözleri olsaydı, yordayıcı değişkenleri nasıl üretirdiniz? Önce şarkıyı ve birini diğerinden sözsel olarak farklı kılan şeyleri düşünün. Tüm müzikte ortak bir tema tekrarlar. Bazı türler diğerlerinden daha fazla tekrar kullanır mı? Peki ya kelime uzunluğu? Bazıları daha büyük veya daha küçük kelimeleri daha sık mı kullanır? Şarkı sözlerini tanımlamak için aklınıza başka hangi faktörler geliyor? Bu sayımları şarkı başına alırsanız, ilk yordayıcı kümenizi elde etmiş olursunuz!
Yukarıda listelenen değişkenlerin tümünün, şarkı başına kelimelere dayalı nicel özellikler (sayımlar, uzunluklar vb.) olduğuna dikkat edin. Peki, türlere özgü bireysel kelimeler ne olacak? Önceki eğitimlerde duygu analizi ve konu modellemesi üzerine çalıştınız. Bu faaliyetler belirli sanatçılara veya türlere özgü kelimelere odaklanmıştı. Bunu bir adım daha ileri götürürseniz, içeriğe (veya bağlama) dayanan en önemli öngörücü bileşenlerden bazılarını oluşturabilirsiniz. Bu, metin analitiğine özgü yaratıcı bir adımdır ve modelleriniz için kritik yordayıcılar ile sonuçlanır.
Önce, tür başına en yaygın (sık kullanılan) kelimeleri almak isteyeceksiniz. Bu, Bölüm Bir eğitiminde yapılmıştı. Tür başına toplam kelime sayısını alarak başlayın. Ardından, tür başına kelimelere göre gruplayın ve her kelimenin ne sıklıkta kullanıldığının sayımını alın. Şimdi, number_of_words değişkeniyle tanımlanan en sık kullanılan n kelimeyi seçin. Zor kısım şu: Kaç kelime seçmelisiniz? Yeterince seçmezseniz modeli optimize edemezsiniz; çok fazla seçerseniz aşırı uyum sağlar ve sonuçları çarpıtırsınız. Bunu açıklamak nispeten karmaşıktır, ancak gerçek çözüm deneme yanılmadır. En uygun kelime sayısı olarak toplam 5500'e ulaştım. Bu değeri kurcalayın ve çıktınızı nasıl etkilediğini görün. Daha iyi bir sonuç bulabilirsiniz! Bu adım henüz tamamen net değilse, benimle kalın; daha anlamlı hale gelmeye başlayacak.
Birçok kelime birden fazla türe oldukça yaygındır (ör. time, life vb.) ve aşağıdaki multi_genre değişkeniyle bu kelimeleri kaldırdım. Bu, kaynaklar arasında daha iyi ayrım yaratan, ayırt edici kelimelerden oluşan daha temiz bir liste sağlar.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Şimdi türe özgü kelimeleri veri kümenizde özellik olarak kullanın. Birden fazla veri kümesi için özellikler oluşturacağınızdan, bunu yalnızca bir kez yazmanız için bir fonksiyon oluşturun. Bu fonksiyonda, sözcüksel çeşitlilik ve yoğunluğa atıflar göreceksiniz. Bu kavramların açıklaması için Bölüm Bir'e göz atın.
Aşağıdaki her bir özelliği ve türe göre nasıl değişebileceğini düşünün. Her özelliği açıklamak yerine, takip eden makine öğrenimi adımlarına odaklanacağım; bu yüzden kodu gözden geçirmek ve ne yaptığını anlamak için bir dakikanızı ayırın. Ve kritik, türe özgü yordayıcıları unutmayın. Örneğin, country_word_count her şarkıda görülen en üst country kelimelerinin basit bir sayımıdır. Açık ve kitap kelimelerine daha fazla ağırlık verdiğime dikkat edin (sum() fonksiyonunda kullanılan 10 ve 20'ye bakın). Bunu, çok ayırt edici oldukları ve belgeleri sınıflandırmaya yardımcı oldukları için yaptım. Yine, bu bir deneme yanılma süreciydi!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Şimdi features() fonksiyonunuzu eğitim ve test veri kümeleriniz için çağırın.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Daha önce mlr paketini kullanmadıysanız sorun değil. Adım adım ilerleyecek ve aslında oldukça basit bir süreç olduğunu göreceksiniz. Yine, bu paket hakkında bulabileceğiniz en kapsamlı dokümantasyon olan bu eğitimi gözden geçirmenizi şiddetle öneririm. Ayrıca mlr.org'u da ziyaret edebilirsiniz.
mlr (R için Makine Öğrenimi), sık kullanılan tüm makine öğrenimi algoritmalarını içeren bir çerçevedir. Her bir algoritmanın teorisini açıklamak yerine, uygulamalarına odaklanacağım. Bu eğitimin sonunda birçok sınıflandırma aracını kullanmış olacaksınız ve burada sunulan kodla birlikte pratik yaparsanız en çok faydayı sağlayacaksınız.
Özellik mühendisliğini tamamladıktan sonra ML süreci basittir: bir görev oluşturun, bir öğrenici tanımlayın, eğitin, test edin. Atacağınız adımlar şunlardır:
Bir görev, bir öğrenicinin öğrendiği veri kümesidir. Bu bir sınıflandırma problemi olduğundan, makeClassifTask() kullanarak bir sınıflandırma görevi oluşturacaksınız. genre olan sınıflandırma sonuç değişkeninizi target bağımsız değişkeni olarak geçirerek belirtmeniz gerekir.
Aşağıda, her biri farklı amaca sahip üç görev oluşturdum. Test ve eğitim açık, ancak yalnızca belge özetleri ve sayımlardan oluşan temel nicel özellikleri kullanan bir veri kümesi de var. Bu görev, task_train_subset, nihai modelde bu bağlamsal yordayıcıların önemini göstermek için tür kelime sayımı özellikleri (ör. country_word_count, pop_rock_word_count vb.) olmadan oluşturulmuştur. Dolayısıyla, train[3:13] veri kümesini kullanmak bu değişkenleri kaldırır. Ayrıca, sınıflandırıcı görevi oluştururken her zaman metin sütunlarını kaldırmak istersiniz. Bu durumda, veri çerçevesinde birinci ve ikinci pozisyonlardadırlar.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
data = test[-c(1:2)], target = "genre")Veri normalleştirme biraz araştırma gerektiren, her zaman gerekli olmayan ve veri kümesine bağlı bir konudur; ancak bu durumda faydalıdır. Basitçe, tüm değerlerin sıfır ile bir (veya verdiğiniz değerlere) arasında ölçeklendiği bir yöntemdir. Bazı değişkenlerin değerleri çok daha büyükse ve diğerlerinden farklı bir ölçekteyse, bu değişkenlere daha fazla ağırlık vererek modelinizi yanıltırlar. Normalleştirme bu sorunu çözer. Konuyla ilgili iyi bir başlık burada. Ön işleme adımında önemli olduğundan, kesinlikle daha fazla araştırmaya değerdir. mlr bu adım için normalizeFeatures() adlı basit bir fonksiyon sağlar.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")mlr içinde bir öğrenici makeLearner() çağrılarak oluşturulur. Kurucu içinde, hangi öğrenme yöntemini kullanmak istediğinizi belirtmeniz gerekir. Olası sınıflandırma algoritmalarının bir listesini listLearners("classif")[c("class","package")] çağırarak elde edebilirsiniz. Bu, seçebileceğiniz algoritmaları ve onların bağımlı paketlerini (ayrıca ayrı kurmanız gerekebilir) gösterir.
Bu alıştırma için, iki sınıftan fazlasını işleyebilen ve karar ağaçlarından rastgele ormanlara, destek vektör makinelerine, gradyan artırmaya ve sinir ağlarına kadar geniş bir teknik yelpazesi sunan bir liste seçtim. Seçilebilecek çok sayıda öğrenici vardır (halen mlr içinde 80'in üzerinde sınıflandırma öğrenicisi bulunmaktadır) ve onlarla oynamanızı teşvik ederim!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)
Yeniden örnekleme, makine öğreniminde vazgeçilmez bir araçtır ve başlı başına ayrı bir eğitim gerektirir. Şimdilik, temel bir anlayış bu adımda size yardımcı olabilir. Eğitim kümesinden örnekler tekrar tekrar çekmeyi ve her örnek üzerinde modeli yeniden kurmayı içerir. Bu, modeli yalnızca bir kez orijinal eğitim verisiyle kurmaktan elde edilemeyen bilgiler edinmenizi sağlayabilir.
Birçok yeniden örnekleme yöntemi vardır, ancak burada makeResampleDesc() çağrısındaki "CV" ile belirtilen ve bir yeniden örnekleme açıklaması nesnesi (rdesc) döndüren k-katlı çapraz doğrulamayı kullanacaksınız. Bu yaklaşım, veri kümesini rastgele eşit boyutlu k gruba (kat) böler. İlk kat doğrulama seti olarak, kalan katlar eğitim için kullanılır. Bu işlem her kat üzerinde k kez tekrarlanır. Her yineleme için hata oranı yakalanır ve sonunda ortalaması alınır.
Eğer yeniden örnekleme ile ilk kez karşılaşıyorsanız bu Yunan alfabesi gibi gelebilir, ancak kavramla tanışmak için zorunlu bir ilk adımdır! Aşağıdaki örneğinizde 10 katlı çapraz doğrulama kullanacaksınız. "Sınıflandırma için, her katta sınıfların aynı oranda olması genellikle arzu edilir." (Kaynak) Bunun olmasını sağlamak için stratify = TRUE kullanın.
mlr içindeki yeniden örnekleme hakkında daha fazla bilgi için bu makaleye göz atın.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)Sınıflandırmanın tipik amacı yüksek tahmin doğruluğu elde etmek ve hata sayısını en aza indirmektir. Bu anlamda, her türlü yanlış sınıflandırma hatası eşit ağırlıkla değerlendirilir. Ancak birçok uygulamada, farklı hata türlerinin etkisi diğerlerinden daha fazladır. Örneğin, bir hastanın hastalığı olup olmadığını sınıflandırıyorsanız, gerçekte hastalık varken bunu belirleyemeyen bir yanlış sınıflandırma hayatı tehdit edebilir. Farklı performans ölçütleri bu nüansları ele alır. Şarkı sözü analizi için ise çoğunlukla temel doğruluk ve hata ölçütlerine bakacaksınız. Yine de doğruluk ve hata oranının her zaman bir modelin sağlamlığını değerlendirmek için en iyi seçenekler olmadığını unutmayın. Bu da bu eğitimin dışında daha fazla tartışmayı hak eden önemli bir konudur.
Doğruluk, yapılan tüm tahminlerden doğru olanların sayısıdır. Modelinizin yanlış sınıflandırmalarını incelemek için, karışıklık matrisine de bakacaksınız; nasıl sınıflandırıldığını (tahmin vs. gerçek) göreceksiniz. Bir dakikaya kadar daha fazlası. Şimdilik ilgilendiğiniz ölçütlerin bir listesini ayarlayın. Burada üç ölçüt ekledim, ancak siz sadece acc'e bakacaksınız. Performans ölçütleri hakkında daha fazla bilgi ve açıklama için bu bağlantı size yardımcı olacaktır.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)mlr içinde, farklı algoritmaların (öğrenme yöntemlerinin) veri kümenize uygulandığı bir kıyas deneyi yapabilirsiniz. Bu, belirli ilgi ölçütlerine (ör. doğruluk) göre algoritmaları karşılaştırmanıza olanak tanır. Modelinizi eğitmek ve BenchmarkResult nesnesi üreterek modeller ve sonuçlara erişmenizi sağlayacak benchmark() çalıştıracaksınız.
Sonunda model kurma zamanı. Türlere özgü kelime sayımlarını içermeyen oluşturduğunuz görevle başlayın. benchmark'a öğrenici listenizi, alt küme görevini, yeniden örnekleme stratejisini (rdesc) ve görmek istediğiniz ölçütlerin listesini geçirin.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252BenchmarkResult nesnesine bakarsanız, ilettiğiniz her algoritma için acc.test.mean'i görebilirsiniz. Bunun özellikle test'e atıf yaptığını unutmayın. Bu, modeli eğitirken çapraz doğrulamada kullanılan doğrulama veri kümeleri için tüm örnekler üzerinden ortalama doğruluktur. Bu, daha sonra kullanacağınız test veri kümesi ile aynı değildir. Bu da açıklamayı hak eden konulardan biridir, ancak aklınızda tutmanız gereken, çapraz doğrulama sırasında ayrılan bir dizi doğrulama veri kümesi ve bir algoritmaya karar verdikten ve modeli ayarladıktan sonra kullanacağınız bir test veri kümesi olduğudur.
Bu kıyas deneyinde, Random Forest'ın r rf_perf yüzde ile en iyi performansı gösterdiğini görebilirsiniz (ve eğitmesi en uzun süren de odur). Bu değeri akılda tutarak, deneyi tam özellik kümesi üzerinde yeniden çalıştırın.
Bu kez belge başına türe özgü kelime sayımını içeren görevi geçin. Bu, bir şarkının daha fazla country kelimesi mi yoksa pop-rock kelimesi mi içerdiğini belirten özellikler ekler. Unutmayın, etiketli veri kümenizi kullanarak en yaygın hip-hop kelimelerini seçtiniz ve hip_hop_words adlı bir listeye koydunuz. Bu listede thug, crib ve drug gibi kelimeler var. Country kelime listesinde ise lonesome, coal, drunken ve cattle gibi şeyler var. Fikir anlaşıldı.
mlr kıyas sonuçlarına erişmek için çeşitli yöntemler sağlar. Birkaçını kullanacağım, ancak kıyas nesnesiyle rahat etmek için getBMR* erişimci fonksiyonlarını kullanmanızı öneririm. BenchMark nesnenizde str() çağırırsanız, ayrıntıların döndürülmesi için bir süre bekleyeceksiniz!
Tam özellik kümesini ayrıntılı incelemeden önce, birden fazla görevi kıyaslamak ve plotBMRSummary() erişimci fonksiyonunu kullanarak tam özellik kümesini yukarıdaki özellik alt kümesiyle karşılaştırmak için bir dakikanızı ayırın. Bunu, benchmark()'a ileteceğiniz bir görev listesi oluşturarak yapın.
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)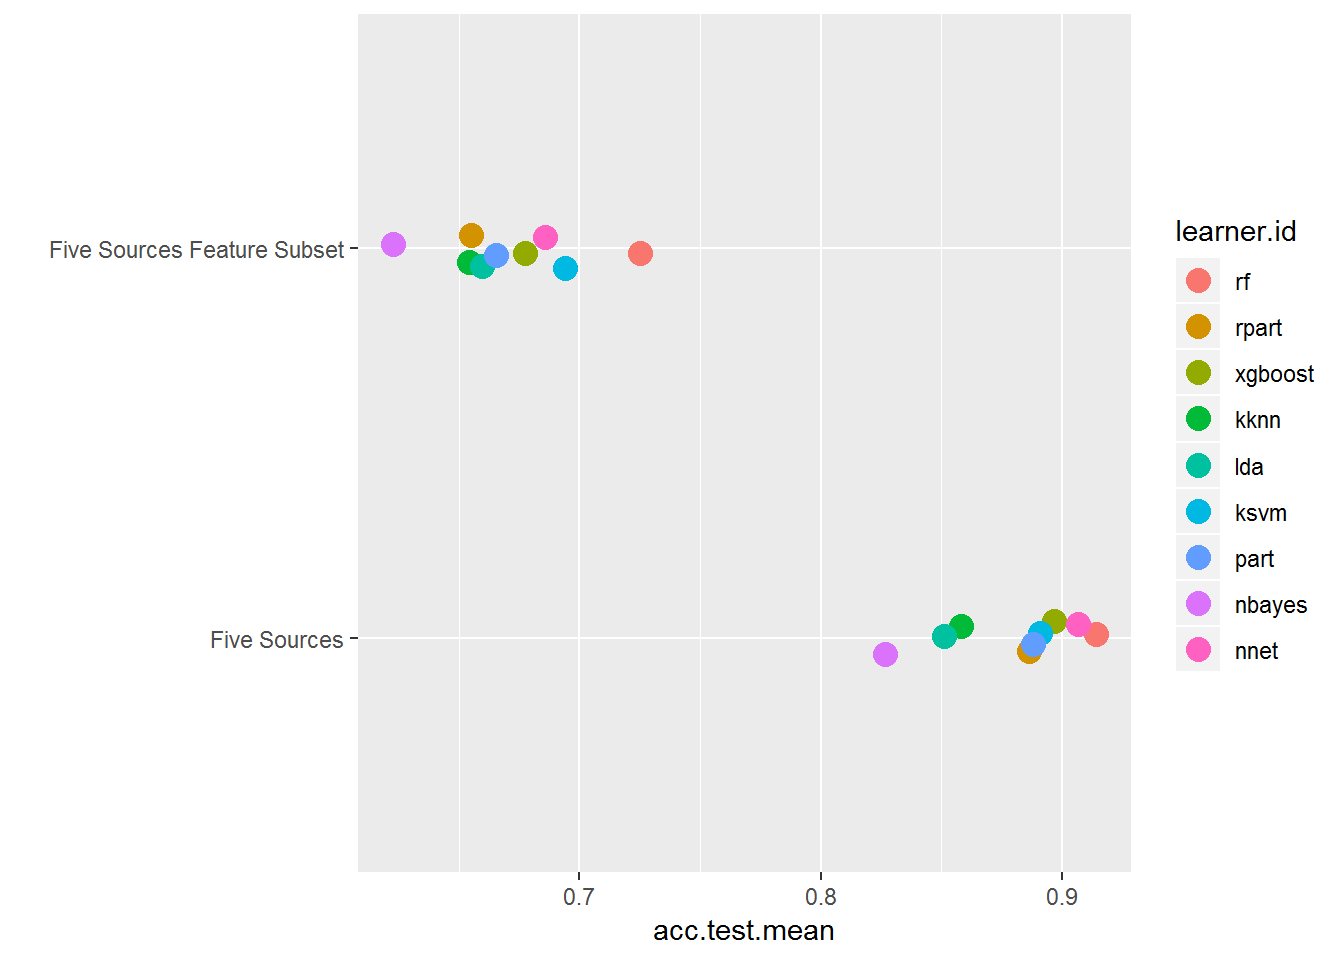
Burada, belge başına türe özgü kelime sayımları olmadan eğitim alt kümesinin acc.test.mean değerinin tam özellik veri kümesinden daha düşük olduğunu görebilirsiniz. Bu, bu özelliklerin çok büyük fark yarattığını gösterir! Bu küçük yaratıcı adımı gerçekleştirmek, yalnızca metin kullanan makine öğreniminde göreceğiniz bir şeydir. Kendi projeleriniz için de elinizin altında bulundurun.
bmr_multi_task içinden yalnızca eğitim sonuçlarına erişebilmenize rağmen, yalnızca eğitim göreviyle yeniden kıyaslayın ve ardından getBMRAggrPerformances() ve plotBMRBoxplots() kullanarak sonuçlara daha yakından bakın.
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)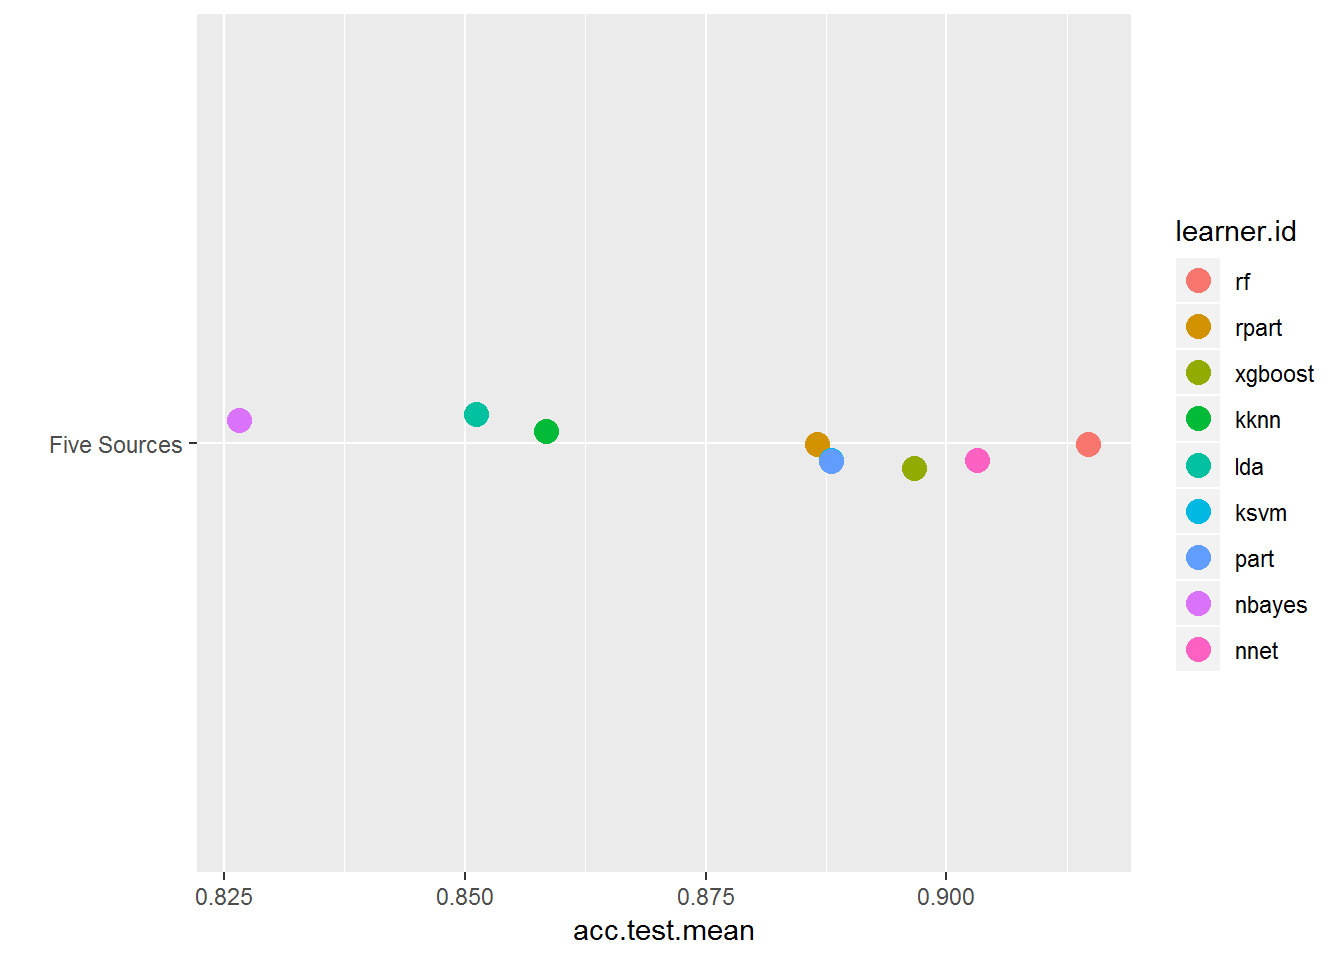
Bu, tam özellikli veri kümesi sonuçlarına yakınlaştırma yapmanızı sağlar. Artık algoritmalar arasındaki farkı ve random forest'ın diğerlerinden daha iyi performans gösterdiğini daha net görebilirsiniz.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Doğruluk") +
  theme(strip.text.x = element_text(size = 8))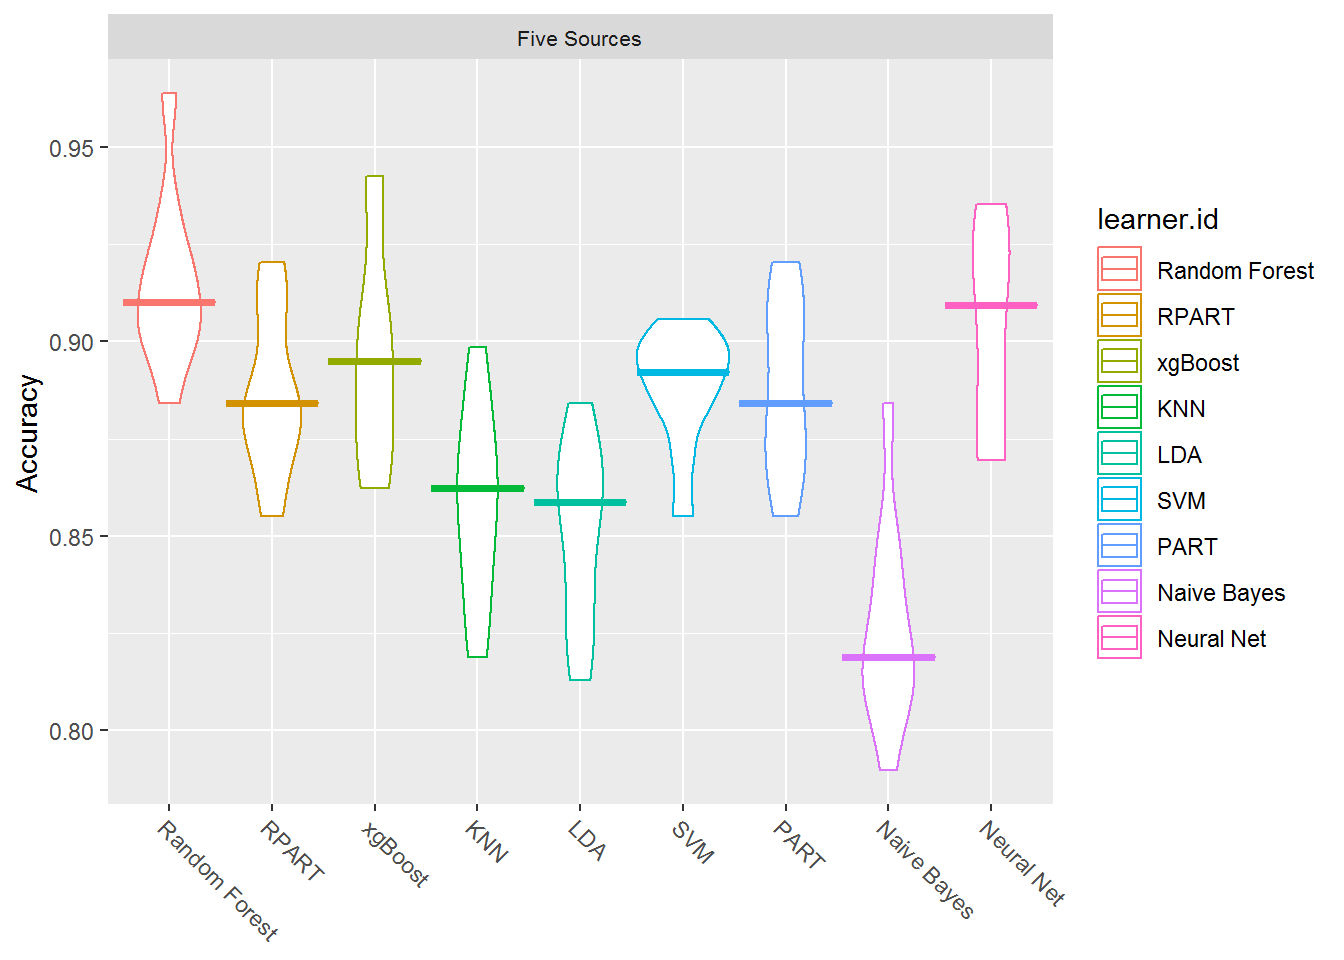
Bu kutu grafikleri, kıyaslama tarafından gerçekleştirilen birkaç yineleme boyunca her yöntem için sonuçları gösterir.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Doğrulama Seti Model Karşılaştırması")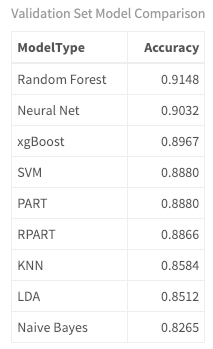
Burada, Random Forest, Neural Net ve xgBoost'un doğruluklarının sırasıyla r first_three yüzdeleri ile en yüksek olduğunu görebilirsiniz. Peki modelde gerçekte neler oldu? Bu belgeler/şarkılar gerçekte nasıl sınıflandırıldı? Şarkı sözlerine dayalı olarak sınıflandırması en zor türler hangileriydi? Daha fazla içgörü elde etmek için tahminlerin karışıklık matrisine bakın. Bu matriste, doğru sınıflandırılmış belge sayıları köşegende yer alır. Yanlış sınıflandırılmış belgeler köşegen dışındadır. Hata gözlem sayıları kenar boşluklarındadır. Sütunlar tahmin edilen değerleri, satırlar gerçek değerleri temsil eder. Eğitim/doğrulama seti tahminlerine erişmek için getBMRPredictions() kullanın. Ardından, daha önce eğitim göreviniz olarak etiketlediğiniz Five Sources kimliğini kullanarak erişebileceğiniz Random Forest modelinin karışıklık matrisinin result'ına bakın. (Bunu kıyas sonuçlarındaki herhangi bir model için yapabileceğinizi unutmayın.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Karışıklık Matrisi: Satırlar Gerçek, Sütunlar Tahmin")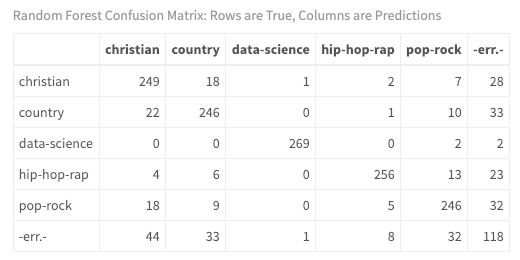
Sonunda modeliniz hakkında bazı içgörülere sahipsiniz! Beklenebileceği gibi, yalnızca bir yanlış sınıflandırma ile, mühendisliğini yaptığınız metinsel meta veri özelliklerini kullanarak veri bilimi belgelerini şarkı sözlerinden ayırt etmek nispeten kolaydır. Ayrıca hip-hop-rap, yalnızca sekiz yanlış sınıflandırma ile diğer müzik türlerinden oldukça ayırt edicidir. Ancak performans oldukça etkileyici olmasına rağmen, country, Hristiyan ve pop-rock müzik sözleri arasında daha az ayrım vardır.
Bu eğitimin amacı yalnızca öngörücü makine öğrenimi tekniklerine maruz kalmak değil, aynı zamanda bu serinin önceki eğitimlerinin devamı olarak şarkı sözü analizi yapmaktır. Dolayısıyla bu sonuçların ne anlama geldiğini düşünün. Sözsel içgörülerle desteklenen bir öneri sistemi geliştiriyor olsaydınız, hangi hususları göz önünde bulundurmanız gerekirdi? Sisteminizin, Hristiyan müziği dinleyicisi veya bir country müzik hayranı için açık sözlü şarkı sözlerine sahip bir hip hop sanatçısını önermesi olası mı?
Eğitimin başındaki akor diyagramını hatırlıyor musunuz? Bu kez gerçek etiketler yerine tahminlerle tekrar bakın.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Tür ve Kaynak Arasındaki Tahmini İlişki - Eğitim")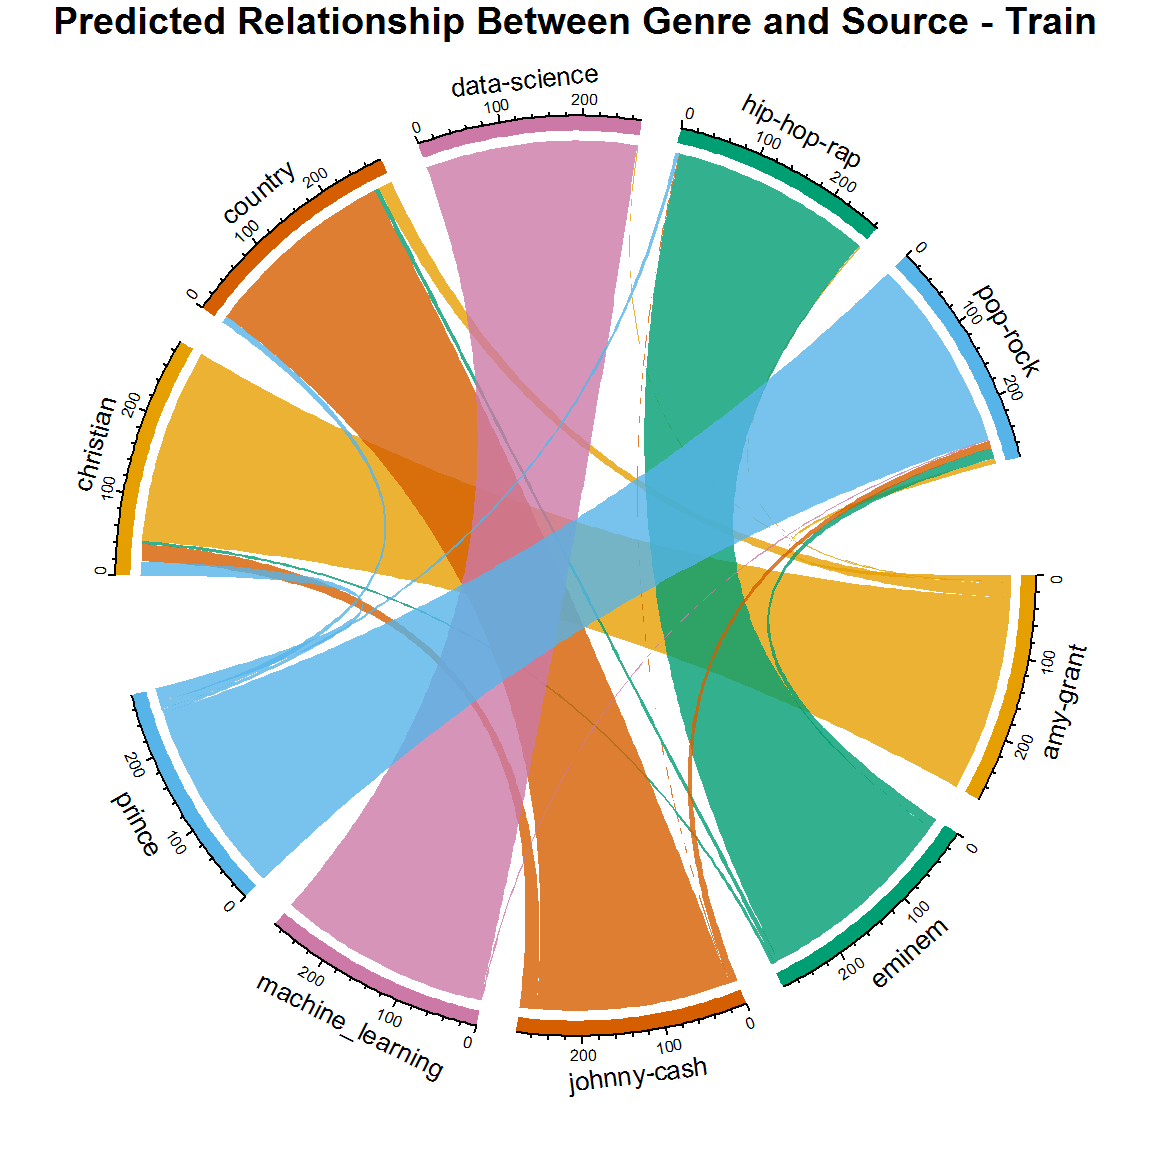
Oldukça hoş. Artık eğitim verilerinde ne kadar iyi sonuç aldığınızı görebilirsiniz. Sonuçlar bir kez daha etkileyici. Küçük çizgiler yanlış sınıflandırmaları temsil eder. Ancak muhtemelen bu eğitimden alabileceğiniz en önemli kavram şu: Bu, doğrulama seti doğruluk sonuçları olsa bile, hâlâ etiketli bir eğitim veri setine dayanmaktadır! Dikkatli olmazsanız, modelinizi aşırı uyumlandırabilir ve yüksek varyans oluşturabilirsiniz. Yüksek varyans, öğrenme algoritmanızın kendisine verdiğiniz veriye bağlı olarak çok değiştiği anlamına gelir. Bu, algoritmanızın daha önce görmediği yeni verilerle gelebilecek gürültüye karşı dayanıklı olmayabileceği anlamına gelebilir. Birazdan modele tamamen yeni veri vererek gerçek bir test yapacaksınız.
Yeni verileri test etmeden önce, modellerden birini seçip ayarlamak isteyeceksiniz. Bunu, hiperparametrelerini ayarlayarak yapacaksınız. Bu, modelinizin performansını iyileştirmek için parametrelerini yapılandırmak anlamına gelen süslü bir kelimedir. Son zamanlarda Kaggle'a uğradıysanız, yarışmalara damga vuran aşırı gradyan artırma adlı modaya uygun bir algoritma fark etmişsinizdir. Kıyaslamada en üstte yer almamasına rağmen, yine de test veri kümesinde ayarlayıp çalıştırmak için bunu seçeceğim. Bu türdeki bir algoritmaya yeniyseniz, ayarlama muhtemelen zor kısım olacaktır. Bu eğitimin kapsamı gereği, aşırı gradyan artırmanın kavramlarına veya hatta hiperparametrelerine giremiyorum, ancak aşağıdaki kod size bir başlangıç noktası sağlayacaktır. Parametreleri ayarlamaya dalmadan önce gradyan artırma kavramını gözden geçirmenizi şiddetle tavsiye ederim. Bu bağlantı, Prince Grover'ın başlamanız için harika bir makalesini sunar. Onun anlattığı gibi, klasik gradyan artırmanın genel özeti şöyledir:
Önce veriyi basit modellerle modelleyin ve hatalar için veriyi analiz edin. Bu hatalar, basit bir model tarafından uydurulması zor veri noktalarını gösterir. Sonraki modellerde özellikle bu zor uydurulan verilere odaklanarak onları doğru elde edin. Sonunda, tüm yordayıcıları her birine bazı ağırlıklar vererek birleştirin.
(Küçük bir not: Aşağıda makeTuneControlRandom() içindeki 150'lik maxit değeri çalışması epey zaman alır. Başlamak için çok daha küçük bir şeyle başlamak isteyebilirsiniz.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
tuneParams() çıktısına bakarak optimize edilmiş parametreleri inceleyebilirsiniz. Şimdi ayarlanmış hiperparametreleri kullanarak yeni bir model oluşturmak ve ardından eğitim veri kümesinde yeniden eğitmek istiyorsunuz.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Doğruluk") +
  theme(strip.text.x = element_text(size = 8))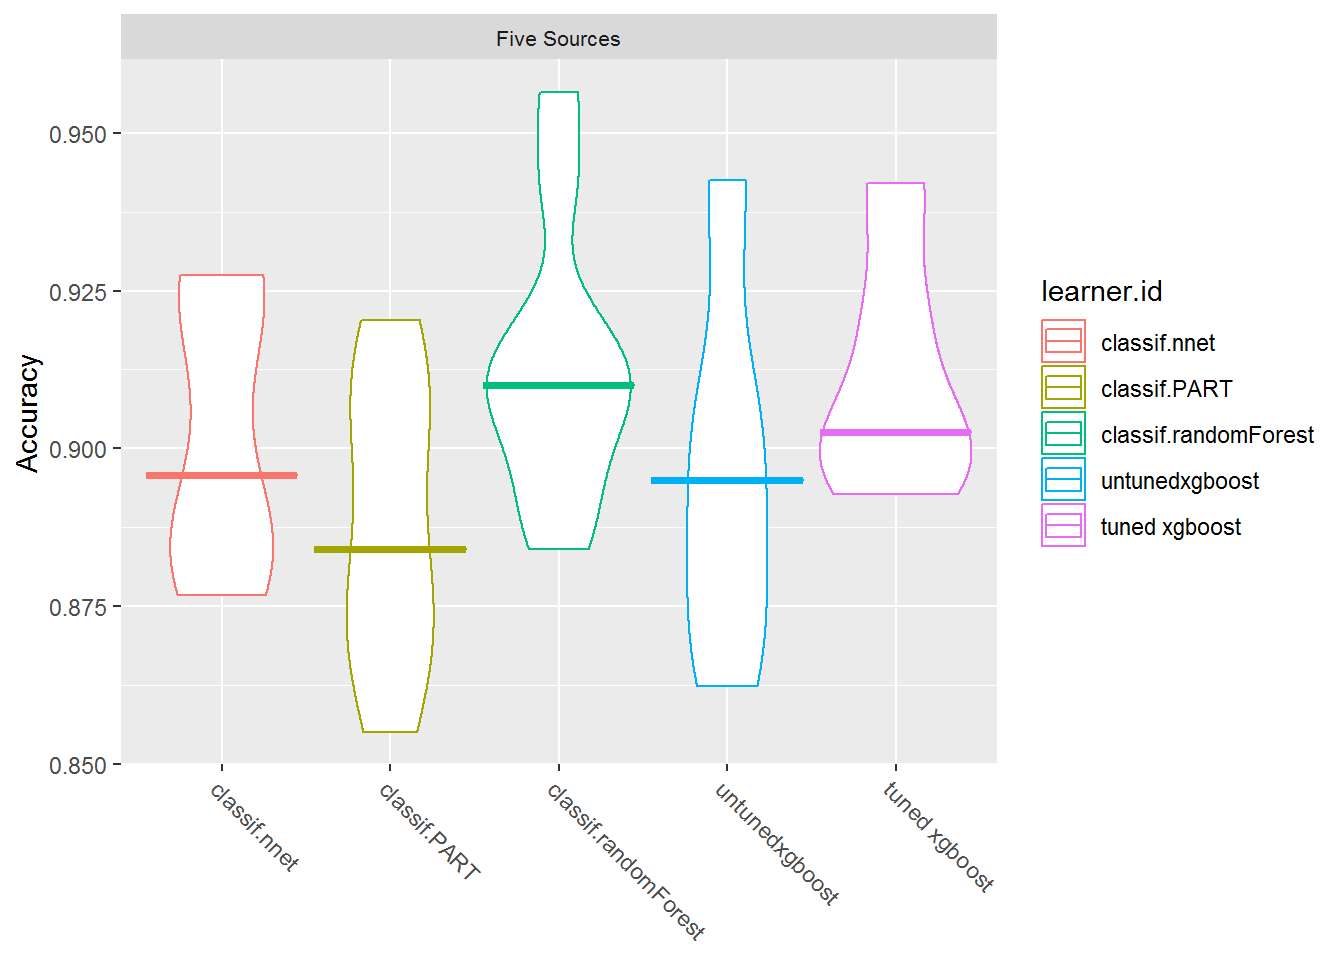
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Doğrulama Seti Model Karşılaştırması")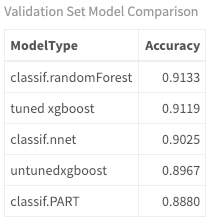
Ayarlanmış xgBoost modeli, ayarlanmamış olandan yalnızca biraz daha yüksek ve yine de random forest kadar doğru değil. Peki test verilerinde nasıl performans gösteriyorlar?
Artık ayarlanmış modeliniz ve kıyaslarınız olduğuna göre, daha önce hiç görülmemiş test veri kümesi üzerinde en iyi üç modeliniz için predict() çağırabilirsiniz. Bu, daha önce gösterildiği gibi tamamen farklı beş kaynağı içerir. Performansına ve gerçek sınıflandırmalara bakın.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Bunlar oldukça ilginç sonuçlar. Random forest, eğitim verisinde ayarlanmış xgBoost'tan daha yüksek doğruluğa sahip olsa da, test veri kümesinde biraz daha az doğruydu. Neural net için test doğruluğu da eğitime kıyasla oldukça düşüktür. Sinir ağları çok esnek modeller olabilir ve bunun sonucu olarak eğitim setine aşırı uyum sağlayabilirler.
r round(test_perf,2)*100% doğruluk oranıyla (ayarlanmış xgBoost için), eğitime kıyasla test verilerinde performansta yine de dramatik bir düşüş yaşandı ve ayarlama yalnızca hafif bir iyileşme sağladı (bu minimal yapılandırma kullanılarak!). Eğitim ve test arasındaki bu doğruluk düşüşü yaygındır ve modeli yeni veriler üzerinde test etmeniz gerektiğinin tam nedenidir.
Şimdi gerçek sınıflandırmalara bakın.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Karışıklık Matrisi: Satırlar Gerçek, Sütunlar Tahmin")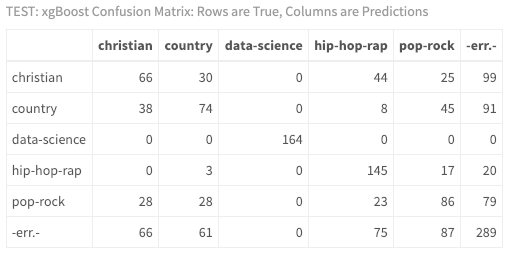
Karışıklık matrisine baktığınızda, bu hip hop sanatçısının, Jay-Z'nin sınıflandırılmasının çok daha zor olduğunu şimdi görebilirsiniz. Müziği bilmiyor olsanız bile, sonuçlarınız modelinizi eğitmek için kullanılan sanatçı Eminem ile test verisinde kullanılan Jay-Z arasında bir tutarsızlık olabileceğini gösteriyor. İdeal olarak, daha fazla veriye, daha fazla sanatçıya, daha fazla ayarlamaya ihtiyacınız olurdu ve modelinizi birden çok kez çalıştırırdınız!!
Yine de, bunun size ne söylüyor olabileceğini düşünün. Akor diyagramına bir kez daha bakın:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Tür ve Kaynak Arasındaki Tahmini İlişki - Test")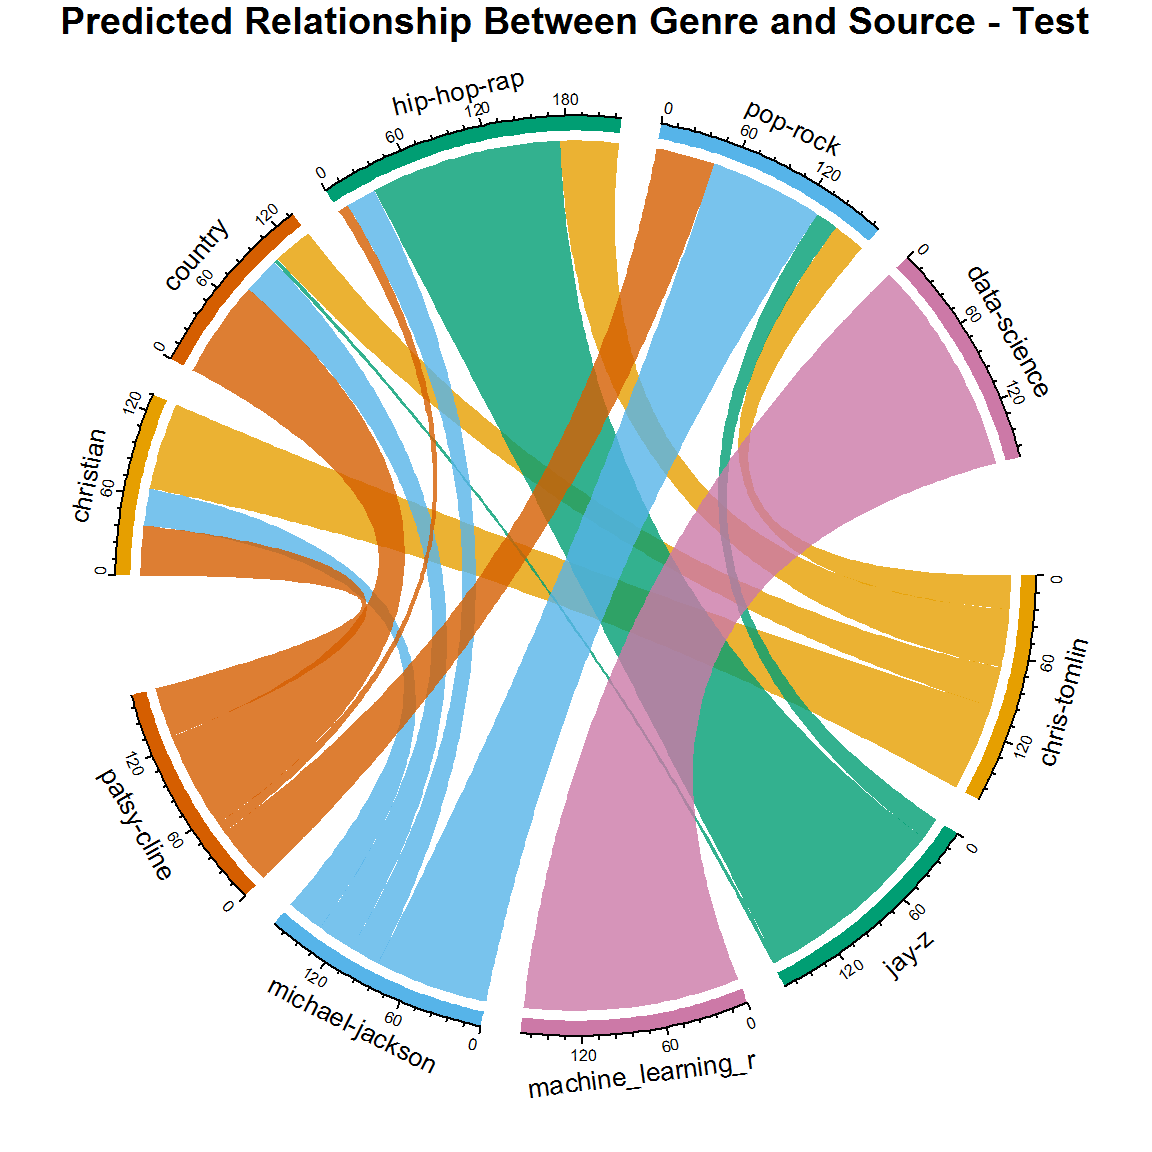
Yanlış mı? Hatalı mı? İçgörü verici mi? Bence müzik dünyasına gerçek bir bakış atıyorsunuz. Düşünün: Michael Jackson hiç rap sanatçılarıyla iş birliği yaptı mı? Hiç dini konular hakkında şarkı söyledi mi? Country sanatçıları hiç pop-rock'a geçti mi? Yeni akor diyagramınız aslında orijinal veri setinde gösterilenden daha gerçekçi bir sözsel sınıflandırma sunuyor! Gerçek hayatta sanatçı ile tür arasında genellikle bire bir ilişki yoktur ve bu esneklik modelinize yerleşiktir.
Eğitimin bir sonraki bölümünde, pazarlama, satış, bilim, ekonomi vb. alanlara uygulanabilecek bir fikre bakacaksınız; ancak burada bunu müziğe uygulayacaksınız. Bir şarkının başarısı oldukça öznel bir kavramdır. Ticari başarı kavramı ise sektör standartlarıyla tanımlanabildiği için biraz daha nettir. Billboard Listeleri (ve diğerleri) böyle bir başarının örnek ölçüleridir. Bir plak şirketinde çalışıyor olsanız ve hangi sanatçıları imzalayacağınıza—veya imzalı sanatçılardan hangilerini tanıtacağınıza—karar vermeye çalışıyor olsanız, bilimsel yöntemlerle şarkı sözlerine dayanarak listeye girip girmeyeceklerini tahmin edebilmek ilginç olmaz mıydı? Çok sayıda güncel veriye ve her şarkıyı tanımlayan tonlarca meta veriye ihtiyacınız olurdu. Kaynaklarınız burada sınırlı olduğundan, elinizdekini alıp etiketli liste verileriyle Prince'in şarkı sözleri üzerinde fikri test edin.
Önceki eğitimlerde, şarkılarının çoğunluğu listeye girmemiş olan Prince'in şarkılarından bir veri kümesi oluşturmuştunuz. Listeye giren ve girmeyen şarkı sayısının aynı olduğu dengeli bir şarkı sözü seti kullanacaksınız. Sayılar şöyle:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Verisi")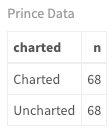
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Yukarıdakiyle aynı süreci kullanarak iki aşamalı bir süreçle özellikleri oluşturun. Bu kez bir şarkıda tür başına kelime saymak yerine, liste düzeyi başına kelime sayacaksınız. Başka bir deyişle, listeye giren şarkılar için en sık kullanılan kelimeleri ve listeye girmeyen şarkılar için en sık kullanılan kelimeleri alın ve listelerde saklayın. 1000 kelime kullanmayı seçtim ve bu sayıyla en iyi yanıtı aldım. Kendi değerlerinizle oynayın. Ardından şarkı özelliklerini oluştururken, her şarkı için her listedeki kelime sayısını sayan bu iki özelliği eklediğinizden emin olun (yukarıda tür ile yaptığınızla aynı süreç).
Yine, hem en çok listeye giren hem de girmeyen şarkılarda görünen tüm kelimeleri kaldırdığıma dikkat edin. Ayrıca, orijinal girdileri kareye aldığım birkaç ek polinom özellik ekledim. Bir modeli algoritmayı ayarlayarak değil, girdileri dönüştürerek iyileştirme fikri, makine öğrenimi yöntemlerinin temelidir.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Prince veri kümesi için hedefi charted alanı olacak şekilde bir sınıflandırıcı görevi oluşturarak yukarıdaki adımların aynısını gerçekleştirin. Veriyi normalleştirin, çapraz doğrulamayı ayarlayın ve bir öğrenici listesi oluşturun. Burada, öncekinden farklı olarak ikili sınıflandırma yapacağınız için birkaç farklı algoritma ekledim.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
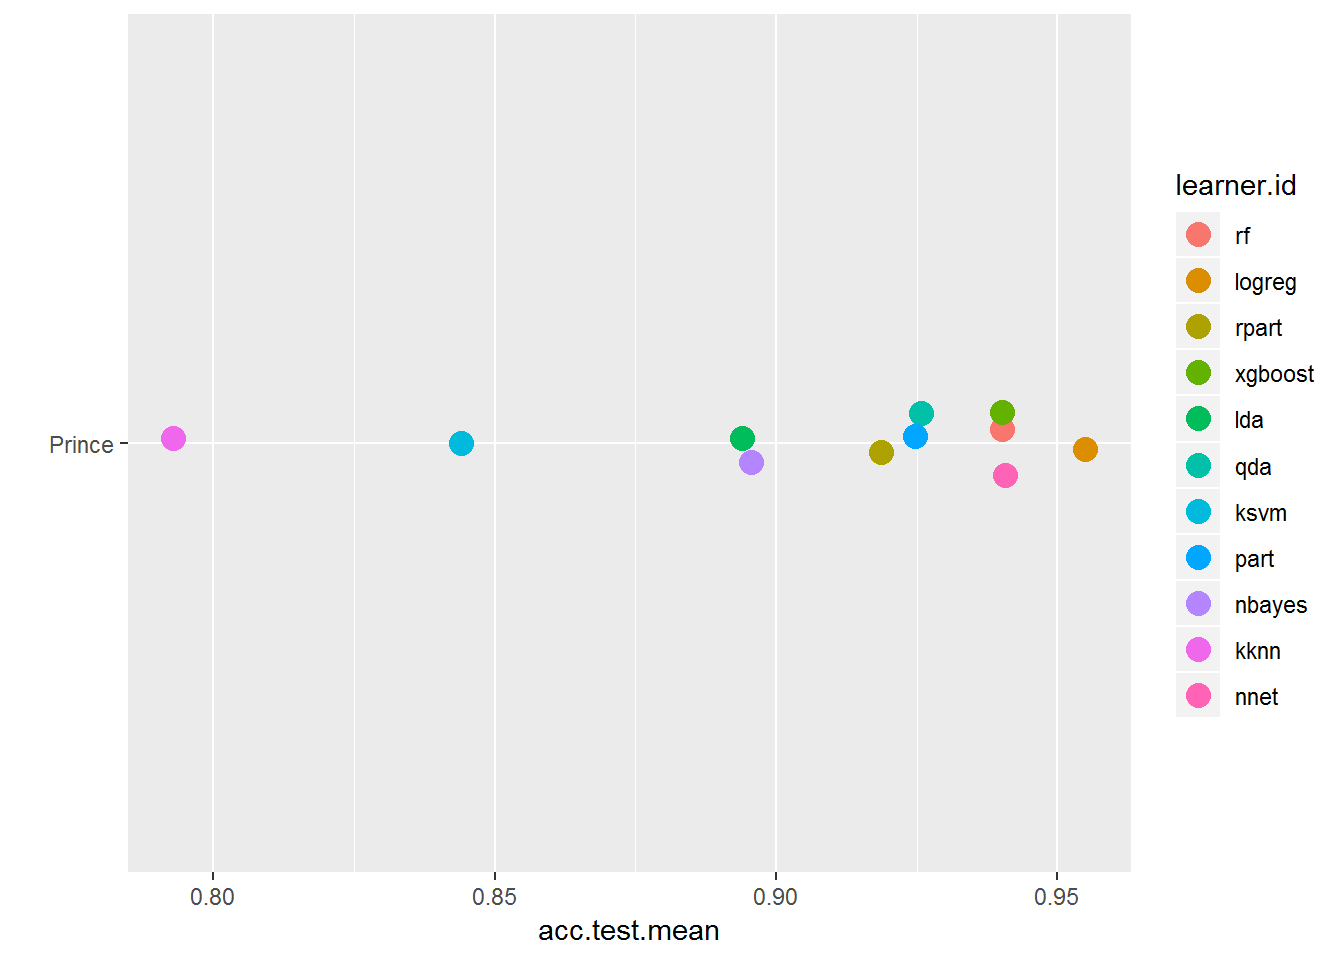
Artık kıyaslarınızı oluşturduğunuza göre, sonuçları birkaç formatta inceleyin. Öğrenici performansındaki farklılıklara dikkat edin.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Doğruluk") +
  theme(strip.text.x = element_text(size = 8))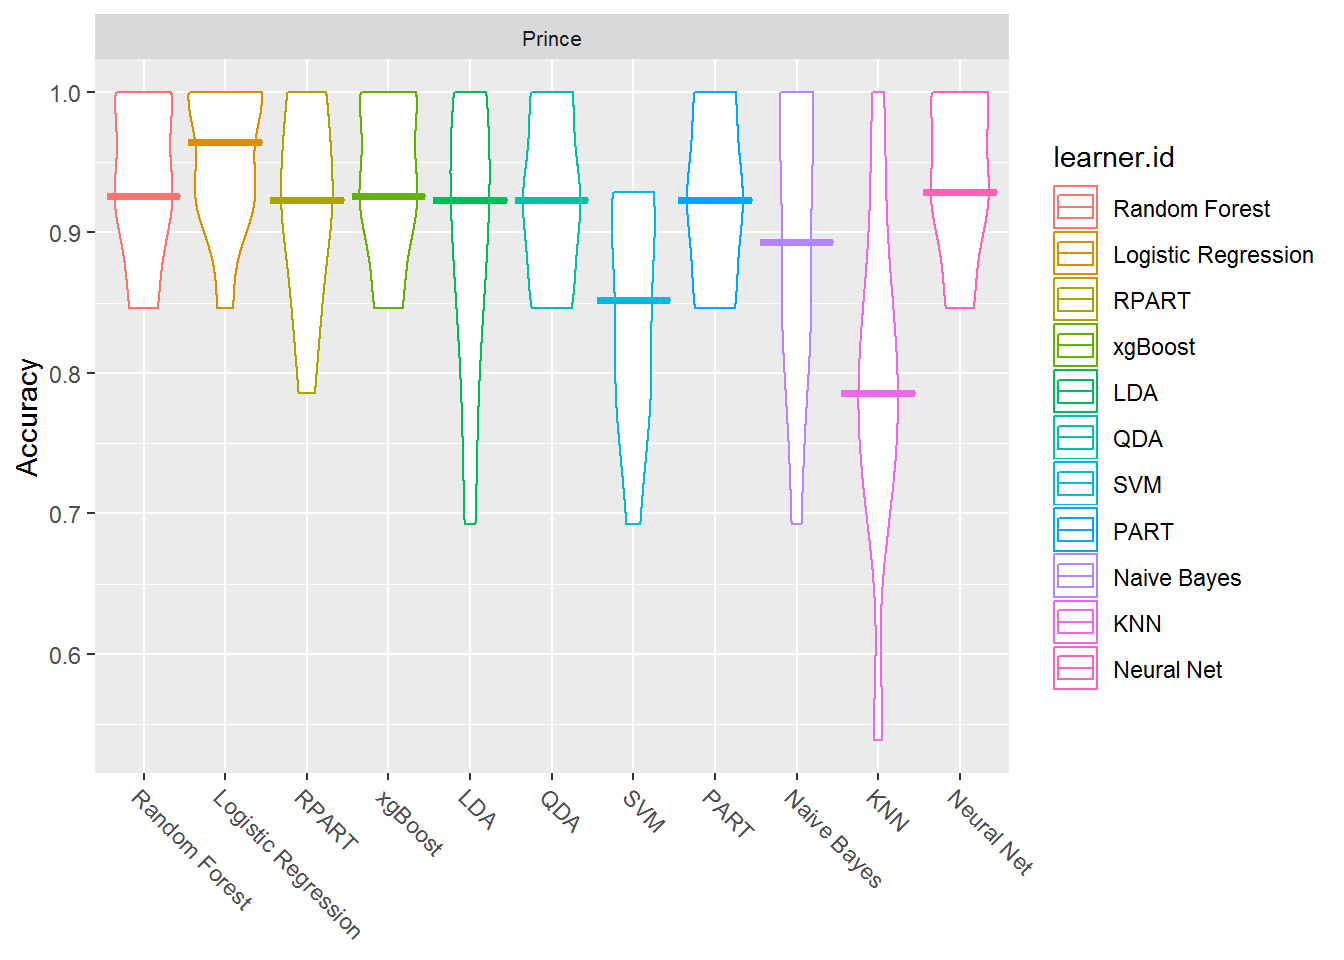
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Doğrulama Seti Model Karşılaştırması")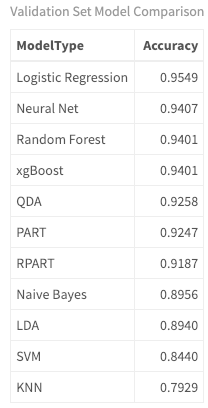
Liste düzeyini tahmin ederken artık iki sınıflı bir problem üzerinde çalışıyorsunuz. Sadece iki seçenek var: listeye girdi veya girmedi. Türü sınıflandırırken, ikiden fazla olası sınıfın bulunduğu çok sınıflı bir probleminiz vardı. (Bunun, bir gözlemin birden fazla sınıfa sahip olabildiği çok etiketli bir problemden farklı olduğuna dikkat edin. Bu da araştırılabilir!). Bu bir binom sınıflandırma problemi olduğundan, birkaç farklı algoritma ekledim: QDA ve Lojistik Regresyon. Bu ikisi iki sınıflı sorunlara daha uygundur.
Lojistik Regresyon, ikili sonuçlar için tasarlanmıştır ve bir gözlemin (şarkının) belirli bir kategoriye ait olma olasılığını modeller. Varsayılanı .5 olan bir eşik değerine dayanır. Örneğin, .5'ten büyük olasılığa sahip olanlar hedef sınıfa, bu eşikten düşük olanlar diğer sınıfa aittir. Bu eşik ayarlanabilir. QDA, ikinci dereceden ayrımcı analiz anlamına gelir ve kuadratik karar sınırlarını doğrusala kıyasla ele almakta daha esnektir. Tamam, size daha fazla bilgi vermeden teknik terimler atmak adil değil, bu yüzden elinizdeki veriye, iyi performans gösteren algoritmalara bakmak ve her birini ayrı ayrı incelemek için zaman ayırın. Umarım bu analiz sizi ayrıntıları araştırmaya teşvik ediyordur!
Bir sonraki adım, tahminlerinizi çalıştırmak ve sınıflandırmalara bakmaktır.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Lojistik Regresyon Karışıklık Matrisi: Satırlar Gerçek, Sütunlar Tahmin")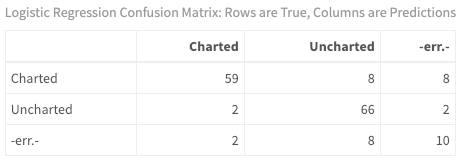
Modelin her bir şarkıyı nasıl sınıflandırdığını görmek çok kolaydır. İkili sınıflandırmada inceleyecek epey ölçüt vardır. Şimdilik sadece yanlış pozitiflere bakın—yani, aslında İlk 100'e girmemişken listeye girecek şekilde tahmin edilen şarkılar hangileri?
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("Yanlış Pozitif Prince Şarkıları")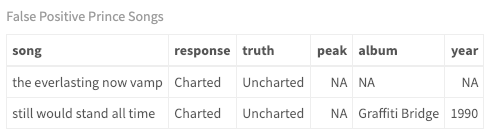
Modelinizi eğitirken çapraz doğrulama kullansanız da, modelinizi her zaman ayrı bir veri kümesine karşı çalıştırmalısınız (yukarıda tür ile yaptığınız gibi). Bunu size bir alıştırma olarak bıraktım ve sonuçlarınıza ilişkin geri bildirim bırakmanızı umuyorum. Şarkı sözü analizinin ardındaki öngörü gücünün gerçek bir testi olması için, en gerçekçi sonuçlar, Prince gibi pop-rock türünde ayrı bir sanatçıdan gelir. Bir diğer faktör zaman dilimidir. Bu şarkılar çoğunlukla 70'lerde, 80'lerde ve 90'larda listeye girdi, dolayısıyla aynı dönemden bir sanatçı kritik önemdedir. Ya da eğitim ve test verileri için kendi sanatçılarını seçin ve neler elde ettiğinizi görün!
Bu eğitimde, tamamen şarkı sözlerine dayanarak bir şarkının türünü tahmin eden bir model oluşturdunuz. Gözetimli makine öğrenimi sınıflandırma algoritmalarını kullandınız ve beş farklı sanatçı ve beş farklı türden oluşan bir kümede modelleri eğittiniz. mlr çerçevesini kullanarak görevler, öğreniciler ve yeniden örnekleme stratejileri oluşturdunuz; ardından model(ler)i ayarladınız. Daha sonra modelinizi farklı sanatçılardan oluşan görülmemiş bir test veri kümesine karşı çalıştırdınız. Varsayılan ayarlarla hangi algoritmaların daha iyi çalıştığını belirleyebildiniz ve nihayetinde modelinizin daha önce hiç görmediği yeni şarkıların türünü tahmin ettiniz.
Şarkı sözü analizine ilişkin olarak, müzik endüstrisinin (ve Billboard Listelerinin) her sanatçı için önceden tanımlanmış türleri olmasına rağmen, analizinizin şarkı sözlerine göre şarkıların türleri aştığını ve genellikle bire bir ilişki olmadığını ima ettiği açık olmalıdır. ( Ben de bir söz yazarıyım, tür sloganım "funksiyonel, akustik, rock'n soul!"). Aynı teknikleri kullanarak bir şarkının tamamen şarkı sözlerine dayanarak listeye girip girmeyeceğini modelleyebildiniz ve eğitim verilerinde makul doğruluk elde ettiniz. Göreviniz şimdi bu bilgiyi kendi veri kümelerinize uygulamak!
Şarkı sözü analizi üzerine bu üç bölümlük (dört eğitim) dizi boyunca sizinle çalışmaktan keyif aldım. Umarım bu tür bir metinle çalışmanın karmaşıklığını ve şarkı sözlerinin diğer metin türlerine (ör. kurgu dışı) kıyasla içerdiği incelikleri takdir etmişsinizdir. Yeni beceriler öğrendiğinizi ve ilgi duyduğunuz yeni konular için içgörü yakalamak üzere kendi verilerinizi kullanma konusunda ilham aldığınızı umuyorum. Makine öğrenimi heyecan verici bir alandır ve yeni ya da deneyimli bir veri bilimci olarak yaratıcılık, ilham ve azim sizi alışılmışın dışına taşıyacaktır. Bu yüzden, dörtgen paralelkenarın dışını düşünmeyi unutmayın ve öğrenme maceranızın tadını çıkarın!
"Ayağımı çıkış çizgisine koydum ve yepyeni bir güne doğru fırladım. Rüzgâra bir öpücük gönderdim, gözlerimi kapattım ve korkuyu tekmeleyip uzaklaştırdım. - Debbie Liske, New Day"
(Bu arada, 100'den fazla kendi şarkımı yazdım ve son modeli müziğim üzerinde çalıştırdım. 35 şarkımın listeye girmesi gerektiğini tahmin etti! Keşke bu tekniği daha önce bilseydim!! Belki bir sonraki makalem, günümüz sanatçılarına dayanarak hit bir şarkı yazmak için şarkı sözü analizinin nasıl kullanılacağı üzerine olmalı...)
Aşağıdaki konulara kısaca değindim ve her birinde daha derin bir anlayış kazanmak için zaman harcamanızı teşvik ediyorum.
Lütfen sorularınızı yorum bölümünde sorun!
Veri kümelerine bağlantılar burada:
R ve Makine Öğrenimi hakkında daha fazla bilgi edinin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




