
Last chance! 50% off DataCamp Premium
Sale ends in
Se ti serve un’introduzione al machine learning, segui il corso Introduction to Machine Learning di DataCamp e dai un’occhiata al tutorial Introduction to Machine Learning in Python.
Usa una varietà di algoritmi di classificazione di machine learning (ML) per costruire, passo dopo passo, modelli che predicono il genere di una canzone e se avrà successo nelle classifiche Billboard — basandoti esclusivamente sui testi!
Questa è la Parte Tre di una serie di tre tutorial in cui continuerai a usare R per svolgere diverse attività analitiche su un caso di studio dei testi musicali dell’iconico artista Prince, oltre che di altri artisti e autori. I tre tutorial coprono:
Come data scientist, ti servirà comprendere sia l’apprendimento supervisionato che quello non supervisionato. Questo tutorial spiega e propone un caso d’uso musicale per una forma di apprendimento supervisionato, in particolare la classificazione, basata sui testi di diversi artisti (e un paio di autori di libri). Imparerai a costruire modelli per classificare le canzoni nel loro genere associato e a valutare la possibilità di usare i testi per prevedere il successo commerciale.
Hai mai usato un servizio di streaming musicale e raccomandazione automatica come Pandora, iHeart Radio, Spotify, ecc.? Se hai impostato una stazione hard rock, probabilmente non ti aspetti di sentire un brano country su stivali da cowboy e piccole città. I sistemi di raccomandazione musicali tipicamente si concentrano sulle qualità del suono, mentre l’analisi dei testi sta iniziando solo ora ad apparire negli articoli di ricerca. Con le tecniche di questo tutorial, puoi sfruttare metodi all’avanguardia studiati dagli scienziati per trovare idee con cui far progredire questo campo in crescita.
Questo tutorial presuppone una comprensione di base del text mining con tidytext. È un’introduzione di livello intermedio alle tecniche di machine learning usando diversi algoritmi di classificazione popolari. Si raccomanda una solida esperienza in programmazione R, preferibilmente con qualche conoscenza di machine learning, e il desiderio di approfondirne applicazione e implementazione tramite i casi d’uso pratici. Ogni algoritmo è spiegato brevemente, ma sono sempre forniti link per analisi più approfondite.
Per tutto l’articolo userai un framework per esperimenti di machine learning in R chiamato mlr. Anche se questo tutorial non è su mlr, lo utilizzerai ampiamente come interfaccia al processo di machine learning. L’obiettivo è usarlo per semplificare la spiegazione dei vari passaggi per costruire un modello con diversi algoritmi. Consiglio vivamente questo tutorial completo sul pacchetto.
Le componenti del ML sono moltissime e in questo tutorial ne sfiorerai appena la superficie. A differenza delle Parti Uno e Due della serie, la narrazione potrebbe lasciarti con più domande che risposte. Otterrai il massimo se lavorerai in parallelo con i tuoi dati e il tuo codice, approfondendo i diversi algoritmi con i tuoi tempi.
Ecco una panoramica ad alto livello dei passaggi per costruire i tuoi modelli:
Sezione Uno: impara a prevedere il genere in base alle caratteristiche dei testi.
Ti conviene consultare i tutorial precedenti per comprendere davvero i dati e le loro sfumature. Tieni a mente che il mining e l’analisi predittiva sui testi delle canzoni sono molto più complicati rispetto alla saggistica, perché contesto, significato e messaggi sottili sono spesso nascosti nelle raffinatezze creative implicite del cantautore. Come in Parte Due-B sul topic modeling, continuerai a lavorare con artisti di diversi generi e con i contenuti di due libri sul machine learning (con un genere data science — per introdurre un’altra forma di testo).
Inizia caricando le librerie e poi dai un’occhiata alla struttura generale dei dati.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Come nei tutorial precedenti, il codice per il circle plot qui sotto può sembrare complicato, ma non resisto mai a una grafica d’effetto. Mostra una copertina di album/libro per ciascuno degli artisti/autori nei tuoi dati. Copre i dataset di test e training. Per maggiori dettagli sul pacchetto circlize, consulta questo libro di Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)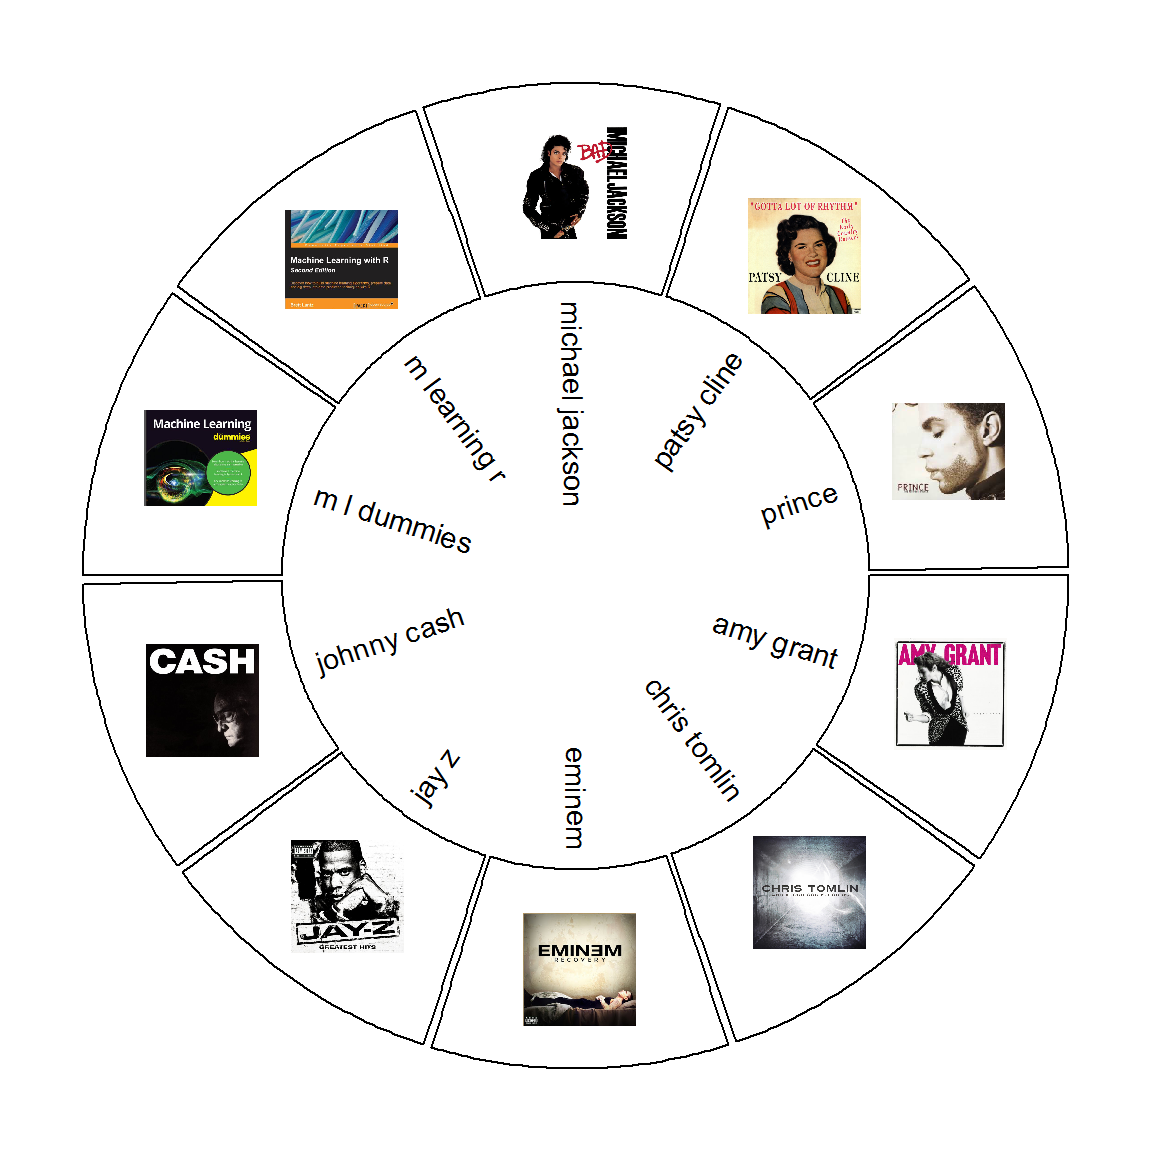
Per concentrarmi sul modeling, ho effettuato il conditioning dei dati al di fuori di questo tutorial e ti ho fornito tutto ciò che ti serve per l’analisi. Ecco un riepilogo del pre-processing:
pdf_text() del pacchetto pdftools per raccogliere il contenuto di due libri (ogni pagina rappresenta un documento distinto)Qui sotto leggerai i dati di training e di test, già suddivisi per il caricamento separato. Poi usa unnest() di tidytext per creare la versione tidy con una parola per record.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Ora che hai caricato e messo in forma tidy i dati di train e test, puoi vedere quante canzoni esistono per artista/autore. Poiché il dataset contiene canzoni e pagine di libro, mi riferirò a entrambe come documenti. Le feature che creerai sono basate sui documenti e sui rispettivi metadati, quindi è importante comprendere questo concetto. Inoltre, dato che ci sono artisti e autori, li chiamerò la source di ciascun documento.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")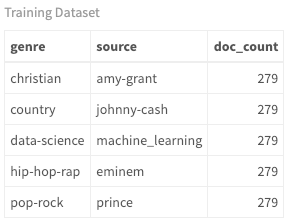
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")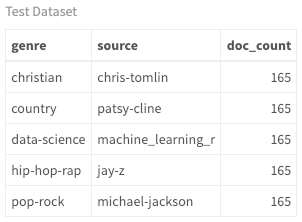
Benché tu possa vedere genere, source e numero di documenti, il seguente diagramma a corde è un modo migliore per visualizzare queste relazioni. Nel corso del tutorial vedrai come evolvono con i nuovi modelli. Al momento c’è una relazione uno-a-uno tra source e genere perché gli artisti sono classificati così; tuttavia, gli artisti crossover sono molto comuni, e lo vedrai nelle versioni successive di questo diagramma.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")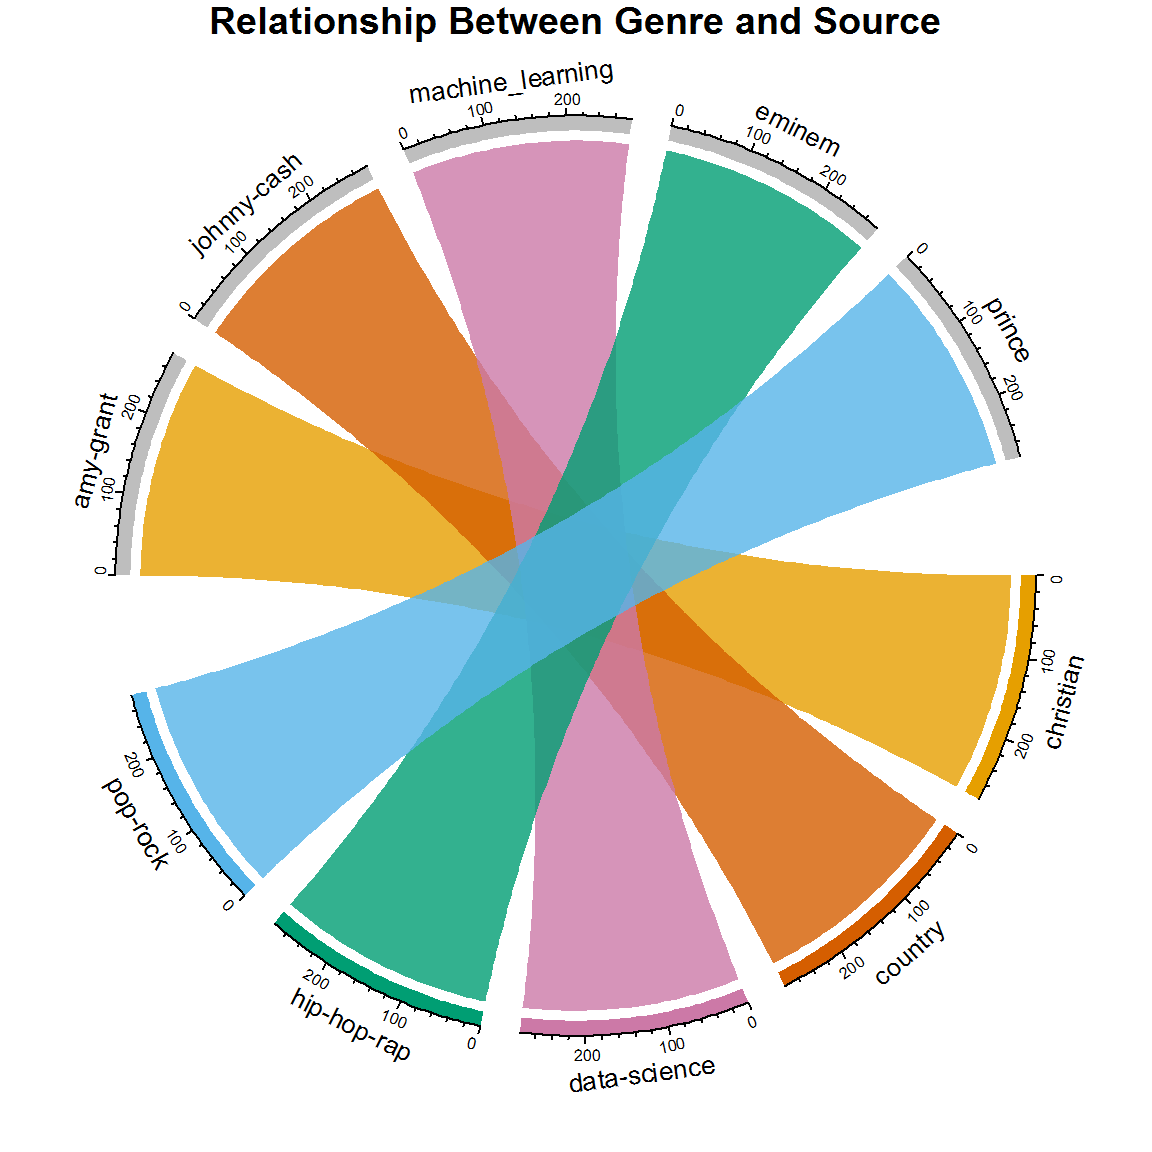
Pensa a come apparirebbe questo diagramma se non ci fosse una relazione uno-a-uno. Se dovessi prevedere il genere basandoti solo sui testi, cosa pensi accadrebbe?
Se per classificare una canzone avessi a disposizione solo i testi, come genereresti le variabili predittive? Pensa prima alla canzone e a cosa la rende diversa da un’altra, dal punto di vista testuale. Un tema comune in tutta la musica è la ripetizione. Alcuni generi usano la ripetizione più di altri? E la lunghezza delle parole? Alcuni usano più spesso parole più lunghe o più corte? Quali altri fattori ti vengono in mente per descrivere i testi? Se ottieni questi conteggi per canzone, hai il tuo primo set di predittori!
Nota che tutte le variabili elencate sopra sono feature quantitative (conteggi, lunghezze, ecc.) basate sulle parole per canzone. Ma che dire delle singole parole specifiche dei generi? Nei tutorial precedenti ti sei occupato di analisi del sentiment e topic modeling. Queste attività erano focalizzate su parole specifiche di certi artisti o generi. Facendo un passo oltre, puoi creare alcuni dei componenti predittivi più importanti basati sul contenuto (o contesto). È il passaggio creativo specifico dell’analisi testuale e produce predittori cruciali per i tuoi modelli.
Per prima cosa, vuoi ottenere le parole più comuni (più frequentemente usate) per genere. Questo è stato fatto nel tutorial Parte Uno. Inizia ottenendo il numero totale di parole per genere. Poi raggruppa per parole per genere e conta quante volte ciascuna parola è usata. Ora seleziona le n parole più frequenti definite dalla variabile number_of_words. Qui sta l’inghippo: quante parole scegliere? Se non ne selezioni abbastanza, non ottimizzerai il modello, ma se ne selezioni troppe, farai overfitting e distorcerai i risultati. È abbastanza complicato da spiegare, ma la soluzione reale è la sperimentazione. Io ho trovato 5500 come numero più ottimale. Prova a variare questo valore e osserva come impatta l’esito. Potresti trovare un risultato migliore! Se questo passaggio non è ancora chiarissimo, continua a seguirmi e tutto prenderà più senso.
Molte parole sono molto comuni a più di un genere (come time, life, ecc.) e le ho rimosse con la variabile multi_genre qui sotto. Questo produce un elenco più pulito di parole distinte che separano meglio le source.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Ora usa le parole specifiche di genere come feature nel tuo dataset. Dato che creerai feature per più dataset, crea una funzione così la scrivi una volta sola. In questa funzione trovi riferimenti a diversità e densità lessicale. Consulta Parte Uno per la spiegazione di questi concetti.
Pensa a ciascuna feature qui sotto e a come potrebbe variare in base al genere. Piuttosto che spiegare ogni feature, mi concentrerò sui passaggi di machine learning successivi, quindi prenditi un momento per rivedere il codice e capire cosa fa. E non dimenticare i predittori specifici di genere, fondamentali. Per esempio, country_word_count è semplicemente il conteggio delle parole country top che compaiono in ogni canzone. Nota che ho assegnato più peso alle parole esplicite e dei libri (vedi 10 e 20 nella funzione sum()). L’ho fatto perché sono molto distintive e aiutano a classificare i documenti. Anche questo è stato un processo di tentativi ed errori!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Ora richiama la tua funzione features() per i dataset di training e test.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Se non hai mai usato il pacchetto mlr, nessun problema. Andrai per gradi e vedrai che è un processo lineare. Di nuovo, raccomando di rivedere questo tutorial, la documentazione più completa sul pacchetto. Puoi visitare anche mlr.org.
mlr (Machine Learning for R) è un framework che include tutti i principali algoritmi di machine learning. Invece di spiegare la teoria dietro ciascun algoritmo, mi concentrerò sulla loro implementazione. Alla fine di questo tutorial avrai utilizzato molti strumenti di classificazione e otterrai il massimo se praticherai seguendo il codice qui presentato.
Una volta eseguito il feature engineering, il processo ML è semplice: crea un task, crea un learner, addestralo, testalo. Ecco i passaggi che seguirai:
Un task è semplicemente il dataset su cui un learner impara. Poiché questo è un problema di classificazione, creerai un task di classificazione con makeClassifTask(). Devi specificare la variabile di outcome, genre, passandola come argomento target.
Ho creato tre task qui sotto, ciascuno con uno scopo diverso. Test e train sono ovvi, ma c’è anche un dataset che usa solo le feature quantitative di base costituite da riepiloghi e conteggi del documento. Questo task, task_train_subset, viene creato senza le feature del conteggio parole per genere (ovvero country_word_count, pop_rock_word_count, ecc.) per illustrare l’importanza di questi predittori contestuali nel modello finale. Usare il dataset train[3:13] rimuove queste variabili. Inoltre, quando crei il task di classificazione, rimuovi sempre le colonne testuali. In questo caso, sono nelle posizioni uno e due del dataframe.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
data = test[-c(1:2)], target = "genre")La normalizzazione dei dati è un tema che richiede qualche approfondimento, non è sempre necessaria e dipende dal dataset; tuttavia, in questo caso è utile. È semplicemente un metodo per scalare i dati in modo che tutti i valori siano normalizzati tra zero e uno (o i valori che imposti). Se alcune variabili hanno valori molto più grandi e sono su scale diverse, falsano il modello attribuendo più peso a quelle variabili. La normalizzazione risolve il problema. Ecco un buon thread sull’argomento. Vale la pena approfondire perché è un passaggio importante nel pre-processing. mlr fornisce una funzione semplice chiamata normalizeFeatures() per questo step.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Un learner in mlr si genera chiamando makeLearner(). Nel costruttore devi specificare quale metodo di apprendimento vuoi usare. Puoi ottenere l’elenco degli algoritmi di classificazione disponibili chiamando listLearners("classif")[c("class","package")]. Mostra gli algoritmi tra cui scegliere e i pacchetti da cui dipendono (che potresti dover installare a parte).
Per questo esercizio ho scelto un elenco che gestisce più di due classi e ti offre un’ampia gamma di tecniche, dagli alberi di decisione alle random forest, SVM, gradient boosting e reti neurali. Ci sono molti learner tra cui scegliere (attualmente ci sono oltre 80 learner di classificazione in mlr) e ti incoraggio a sperimentarli!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)Il resampling è uno strumento essenziale nel machine learning e meriterebbe un tutorial a parte. Per ora, una comprensione di base ti aiuterà a superare questo passaggio. Consiste nell’estrarre ripetutamente campioni da un set di training e rifit di un modello su ciascun campione. Questo può permettere di ottenere informazioni non disponibili addestrando il modello una volta sola sul training originale.
Esistono vari metodi di resampling, ma qui userai la k-fold cross validation, indicata da "CV" nella chiamata a makeResampleDesc() che restituisce un oggetto di descrizione del resample (rdesc). Questo approccio divide casualmente il dataset in k gruppi (fold) di dimensione uguale. Il primo fold è usato come set di validazione, e i fold rimanenti per il training. Questo si ripete k volte su ciascun fold. Il tasso di errore viene registrato a ogni iterazione e mediato alla fine.
Se è la prima volta che affronti il resampling, tutto questo può sembrare arabo, ma è un primo passo essenziale per familiarizzare col concetto! Nell’esempio qui sotto userai una cross-validazione a 10 fold. "Per la classificazione, di solito è preferibile avere la stessa proporzione di classi in ciascun fold." (Fonte) Usa stratify = TRUE per assicurarlo.
Per maggiori informazioni sul resampling in mlr, vedi questo articolo.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)L’obiettivo tipico della classificazione è ottenere un’alta accuratezza predittiva e minimizzare il numero di errori. In questo senso, tutti i tipi di errori di classificazione sono considerati con peso uguale. Tuttavia, in molte applicazioni certi errori hanno più impatto di altri. Per esempio, se classificassi la presenza di una malattia, un errore che non la identifica quando in realtà c’è potrebbe essere pericoloso per la vita. Diverse metriche affrontano queste sfumature. Per l’analisi dei testi musicali, però, guarderai soprattutto alle misure base di accuratezza ed errore. Ricorda solo che accuratezza e tasso d’errore non sono sempre le scelte migliori per valutare la robustezza di un modello. È un tema importante che merita ulteriore discussione al di fuori di questo tutorial.
L’accuratezza è il numero di predizioni corrette sul totale delle predizioni. Per esaminare le misclassificazioni del tuo modello, guarderai anche una confusion matrix per vedere come sono state classificate le osservazioni (predetto vs. reale). Tra poco ne parleremo. Per ora, imposta un elenco di metriche di interesse. Qui ne ho aggiunte tre, ma guarderai solo acc. Questo link offre maggiori informazioni e spiegazioni sulle metriche.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)In mlr puoi condurre un esperimento di benchmark in cui diversi algoritmi (metodi di apprendimento) sono applicati al tuo dataset. Questo ti permette di confrontare gli algoritmi in base alle specifiche metriche di interesse (es., accuratezza). Eseguirai benchmark() per addestrare il modello e generare un oggetto BenchmarkResult dal quale accedere a modelli e risultati.
Finalmente è il momento di costruire un modello. Parti dal task creato senza i conteggi di parole specifici di genere. Passa a benchmark la tua lista di learner, il task con il sottoinsieme, la strategia di resampling (rdesc) e l’elenco delle metriche che vuoi ottenere.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252Osservando l’oggetto BenchmarkResult, puoi vedere acc.test.mean per ciascun algoritmo passato. Nota che si riferisce specificamente al test. È l’accuratezza media su tutti i campioni per i dataset di validazione usati in cross-validazione mentre addestravi il modello. Non è lo stesso del dataset di test che userai più avanti. È un altro tema che merita parecchia spiegazione, ma tieni a mente che c’è una serie di dataset di validazione tenuti da parte durante la cross-validazione, e un dataset di test che userai dopo aver scelto un algoritmo e aver tunato il modello.
In questo benchmark, vedi che Random Forest performa meglio con il r rf_perf per cento (e ha impiegato più tempo ad allenarsi). Tenendo presente quel valore, riesegui l’esperimento sull’insieme completo di feature.
Questa volta passa il task che include il conteggio di parole specifiche di genere per documento. Aggiunge feature che indicano se una canzone ha più parole country, pop-rock, ecc. Ricorda, usando il dataset etichettato, hai selezionato le parole hip-hop più comuni e le hai inserite in una lista chiamata hip_hop_words. Contiene parole come thug, crib, drug. La lista per il country contiene parole come lonesome, coal, drunken, cattle. L’idea è chiara.
mlr fornisce diversi metodi per accedere ai risultati di benchmark. Ne userò solo alcuni, ma per familiarizzare con l’oggetto benchmark, ti consiglio le funzioni getter getBMR*. Se chiami str() sul tuo oggetto benchMark, aspetterai a lungo per i dettagli!
Prima di guardare nel dettaglio il set completo di feature, prenditi un secondo per fare il benchmark di più task e confrontare set completo e sottoinsieme usando la funzione getter plotBMRSummary(). Fallo creando una lista di task da passare a benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)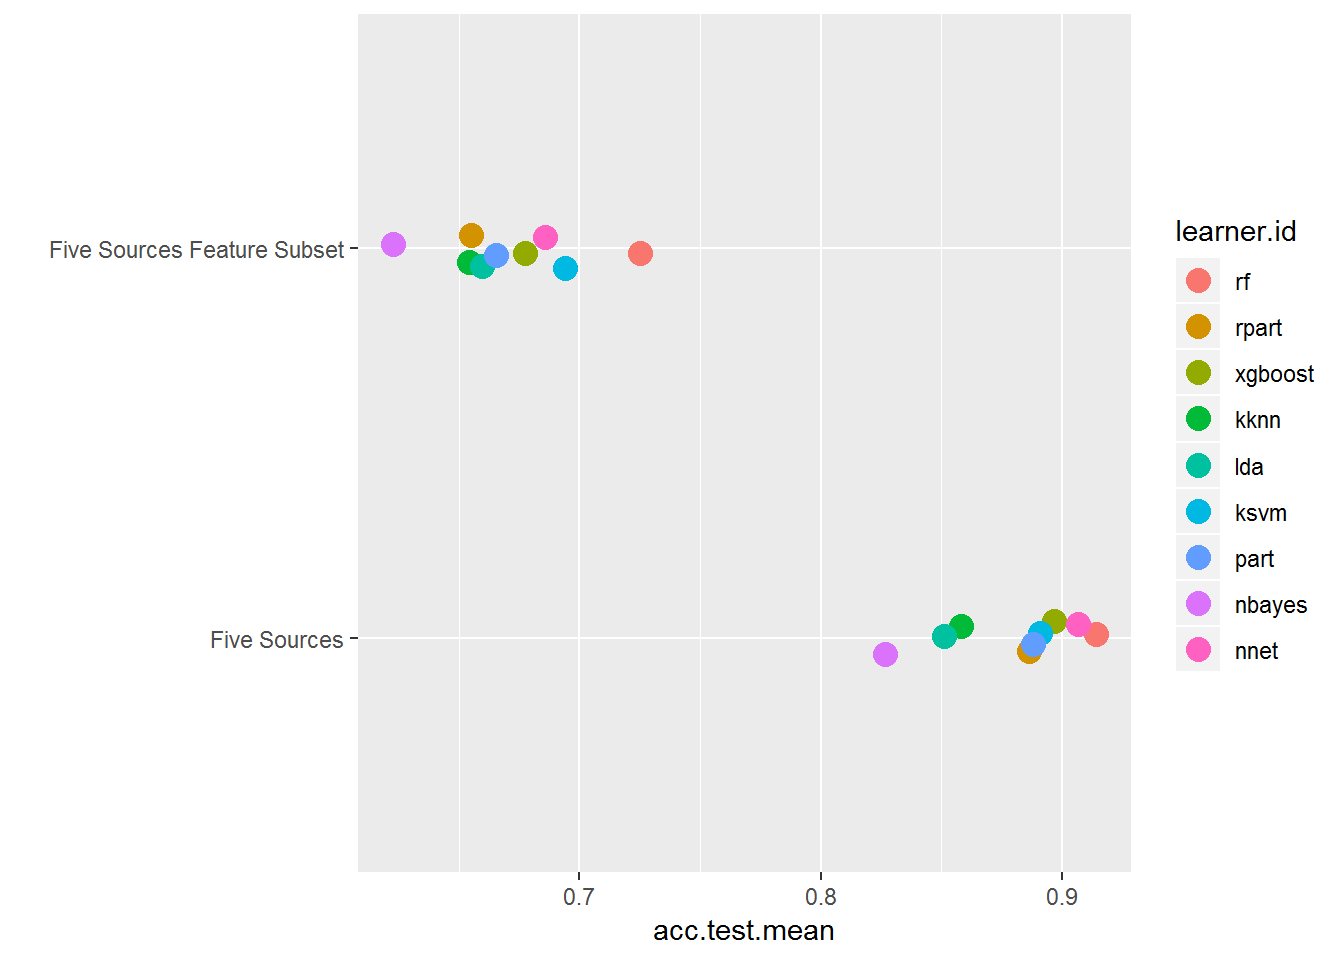
Qui puoi vedere che acc.test.mean del sottoinsieme di training senza i conteggi di parole specifici di genere per documento è inferiore rispetto al dataset con feature complete. Ciò indica che queste feature fanno un’enorme differenza! Questo piccolo passaggio creativo è qualcosa che vedrai solo nel machine learning su testo. Tienilo tra i tuoi assi nella manica per i tuoi progetti.
Benché potresti accedere ai risultati di training da bmr_multi_task, rifai il benchmark solo con il task di training e poi guarda più da vicino i risultati usando getBMRAggrPerformances() e plotBMRBoxplots().
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)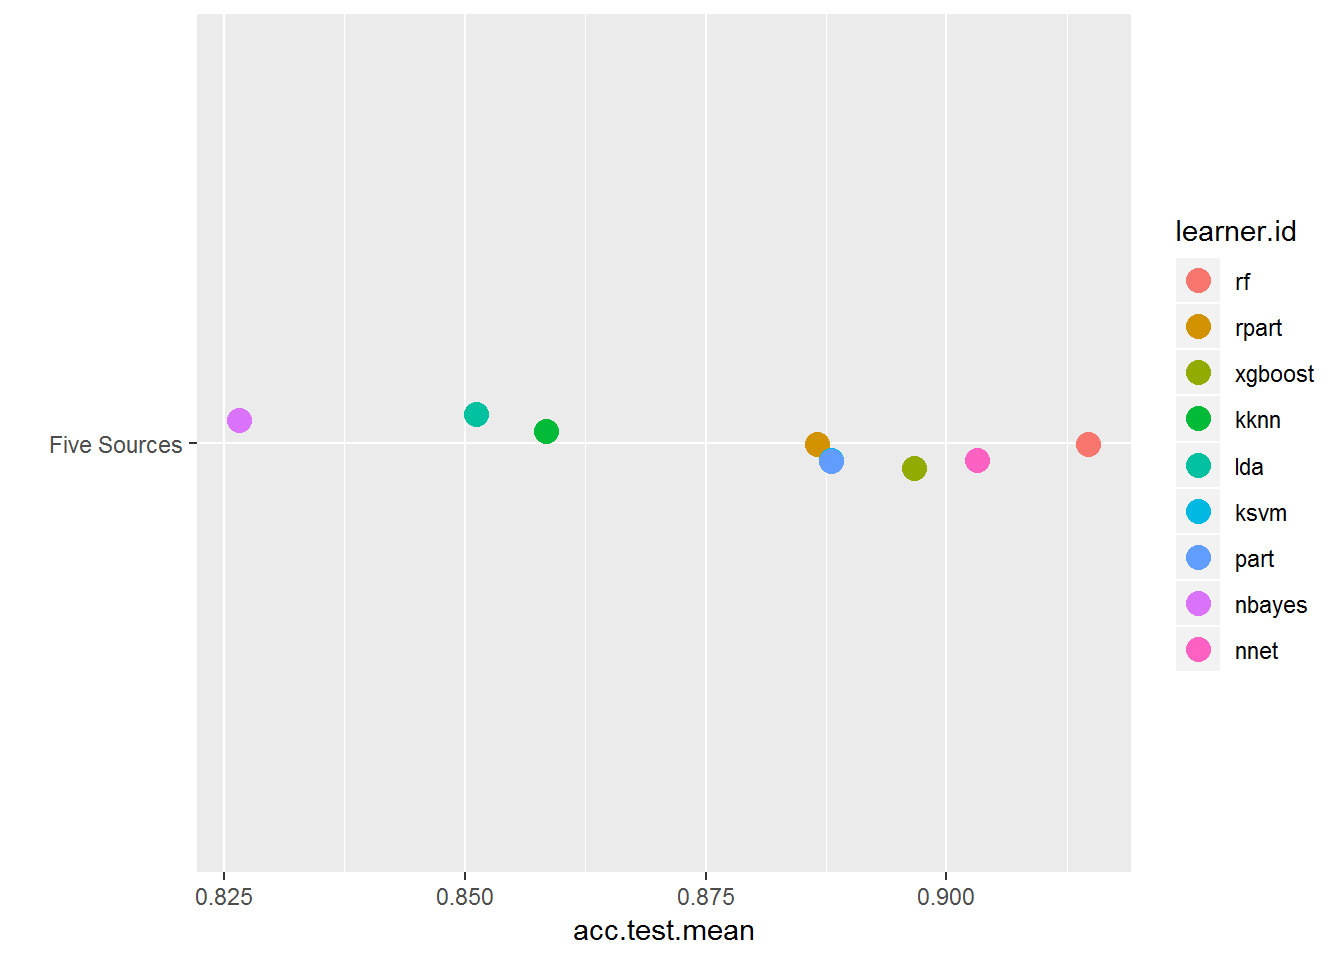
Questo ti permette di mettere a fuoco i risultati del dataset con feature complete. Ora vedi più chiaramente la discrepanza tra algoritmi e come random forest superi gli altri.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))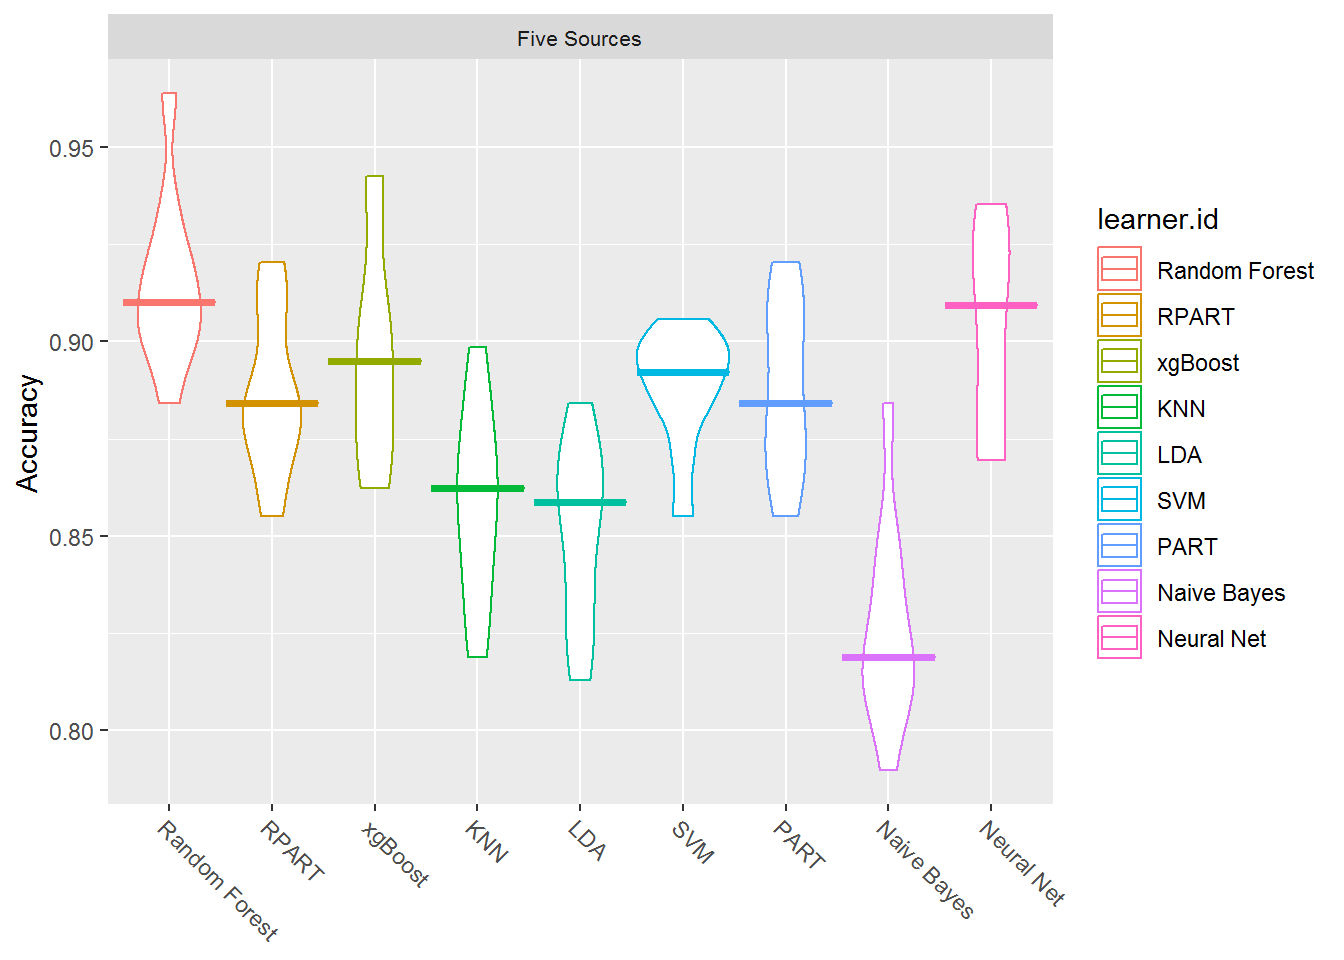
Questi boxplot mostrano i risultati per ciascun metodo attraverso le varie iterazioni del benchmarking.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")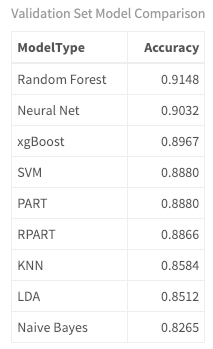
Qui puoi vedere che l’accuratezza è più alta per Random Forest, Neural Net e xgBoost, con accuratezze rispettive di r first_three percentuali. Ma cosa è davvero successo nel modello? Come sono stati effettivamente classificati questi documenti/canzoni? Quali sono i generi più difficili da classificare in base ai testi? Per capirlo meglio, guarda la confusion matrix delle predizioni. Nella matrice, i documenti classificati correttamente compaiono sulla diagonale. I documenti misclassificati sono fuori diagonale. I conteggi degli errori sono nei margini. Le colonne rappresentano i valori predetti, le righe quelli reali. Usa getBMRPredictions() per accedere alle predizioni training/validazione. Poi osserva il result della confusion matrix del modello Random Forest, a cui puoi accedere tramite l’id Five Sources assegnato prima al tuo task di training. (Potresti farlo per qualsiasi modello nei risultati del benchmark.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")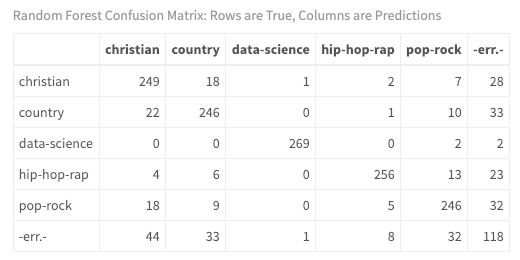
Finalmente hai qualche insight sul tuo modello! Come potevi aspettarti, con una sola misclassificazione è relativamente facile distinguere i documenti di data science dai testi di canzoni usando le feature testuali che hai ingegnerizzato. Inoltre, hip-hop-rap è molto distinto dagli altri generi musicali con solo otto misclassificazioni. Tuttavia, benché la performance sia piuttosto buona, c’è meno distinzione tra i testi country, Christian e pop-rock.
Lo scopo di questo tutorial non è solo farti conoscere tecniche predittive di machine learning, ma anche proseguire l’analisi dei testi come continuazione dei tutorial precedenti. Quindi pensa a cosa significano questi risultati. Se stessi sviluppando un sistema di raccomandazione integrato con insight testuali, quali considerazioni dovresti fare? C’è la possibilità che il tuo sistema raccomandi un artista hip hop con testi espliciti a un ascoltatore di musica Christian o a un fan del country?
Ricordi il diagramma a corde all’inizio del tutorial? Riguardalo, questa volta con le predizioni invece delle etichette reali.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")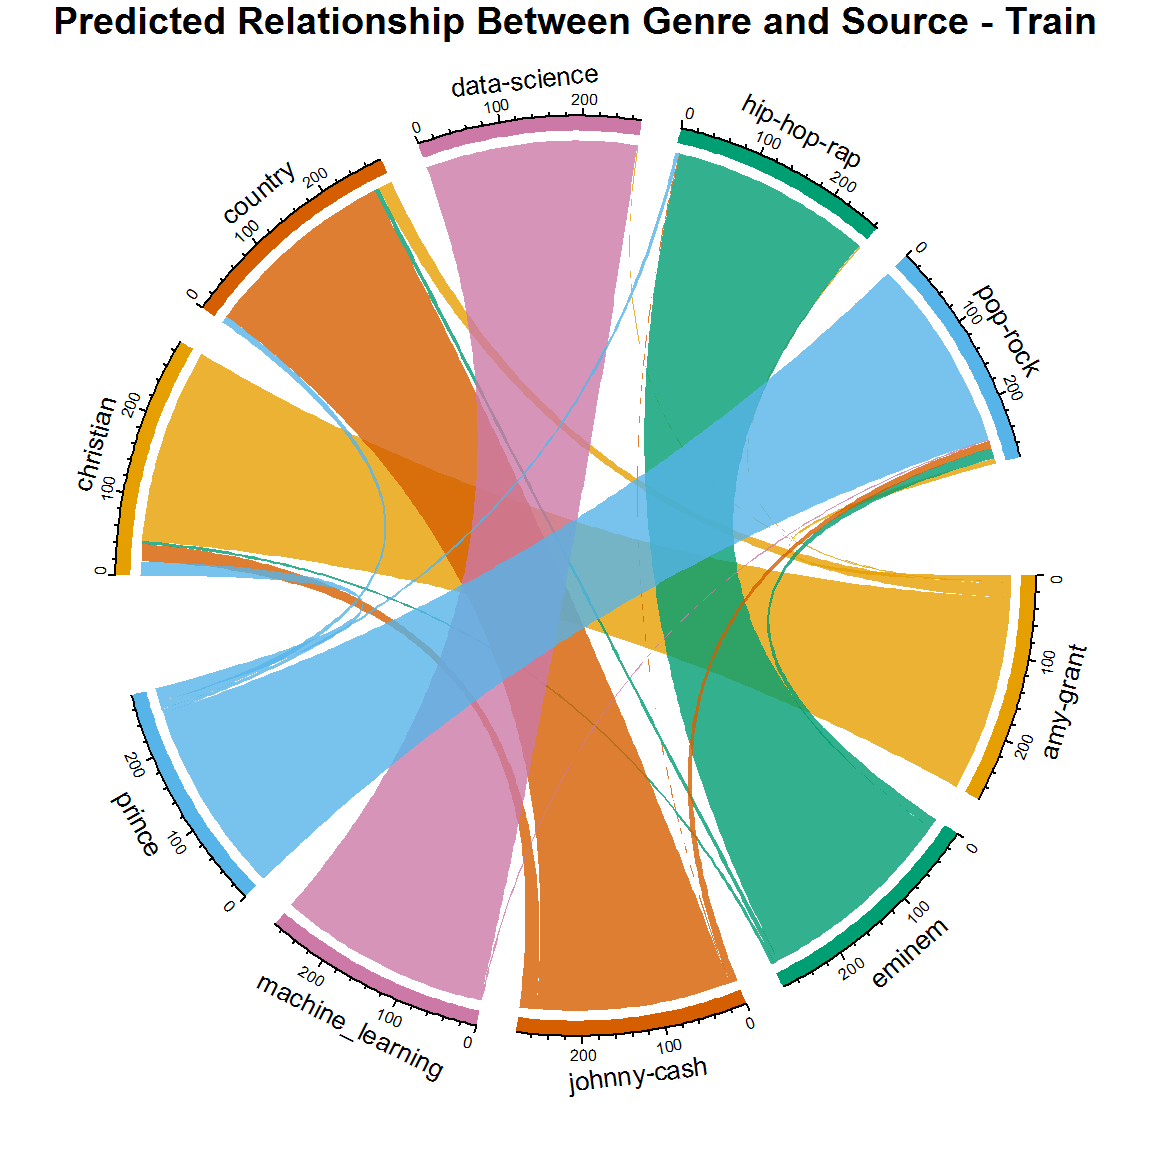
Niente male. Ora puoi vedere quanto bene hai fatto sui dati di training. Di nuovo, i risultati sono notevoli. Le linee più sottili rappresentano le misclassificazioni. Ma qui c’è probabilmente il concetto più importante del tutorial: anche se questa è l’accuratezza del set di validazione, è comunque basata su un dataset di training etichettato! Se non stai attento, potresti fare overfitting e introdurre alta varianza. Alta varianza significa che l’algoritmo di apprendimento varia molto a seconda dei dati forniti. Questo potrebbe implicare che l’algoritmo non sia robusto al rumore introdotto da nuovi dati mai visti. Farai un vero test del modello tra poco, quando gli darai in pasto dati nuovi.
Prima di testare nuovi dati, vorrai scegliere uno dei modelli e sintonizzarlo. Lo farai regolando i suoi iperparametri. È solo un modo elegante per dire che configurerai i parametri del modello per migliorarne le prestazioni. Se hai visitato Kaggle di recente, avrai notato un algoritmo di tendenza chiamato extreme gradient boosting che domina le competizioni. Anche se non è stato il modello con prestazioni migliori nel nostro benchmark, sceglierò comunque di tunarlo e lanciarlo sul dataset di test. Se sei nuovo a questo tipo di algoritmo, la parte difficile sarà il tuning. Dato l’ambito del tutorial, non posso entrare nelle basi del gradient boosting né negli iperparametri, ma il codice qui sotto ti darà un punto di partenza. Raccomando vivamente di rivedere il concetto di gradient boosting prima di addentrarti troppo nel tuning. Questo link offre un ottimo articolo di Prince Grover per iniziare. Come lo descrive, ecco un riassunto del gradient boosting classico:
Prima modella i dati con modelli semplici e analizza gli errori. Questi errori indicano i punti difficili da adattare con un modello semplice. Poi, per i modelli successivi, concentrati in particolare su quei dati difficili per sistemarli. Alla fine, combina tutti i predittori assegnando dei pesi a ciascuno.
(Nota a margine: il valore maxit di 150 in makeTuneControlRandom() qui sotto richiede parecchio tempo per l’esecuzione. Potresti voler iniziare con qualcosa di molto più piccolo.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Puoi esaminare gli iperparametri ottimizzati guardando l’output di tuneParams(). Ora vuoi creare un nuovo modello usando gli iperparametri tunati e poi ri-addestrarlo sul dataset di training.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))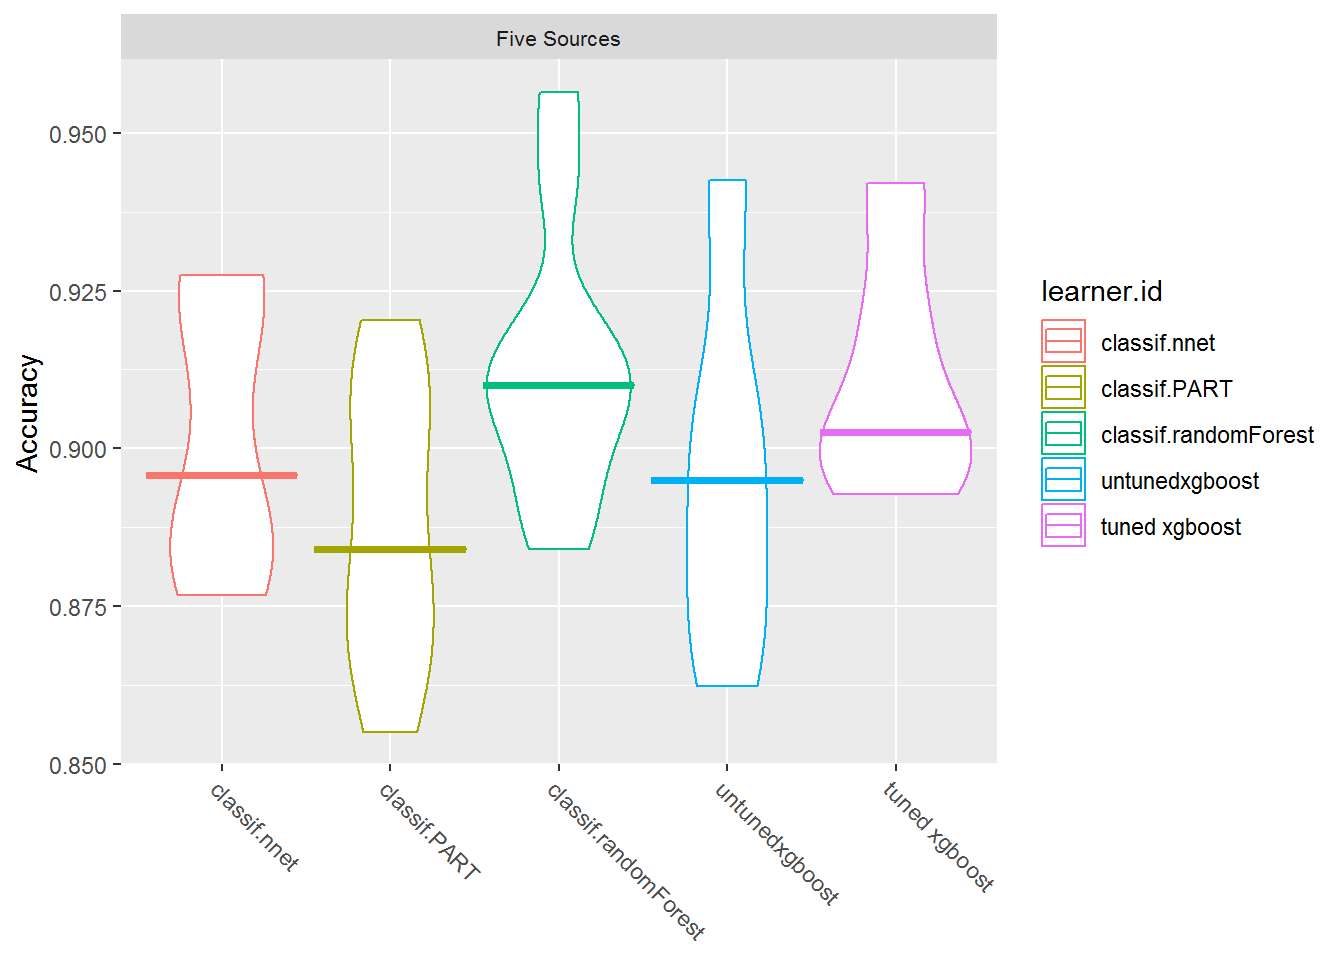
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")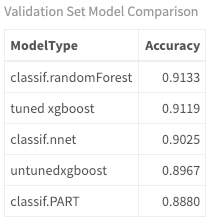
Il modello xgBoost tunato è solo leggermente migliore di quello non tunato e resta meno accurato della random forest. Ma come si comportano sui dati di test?
Ora che hai il modello tunato e i benchmark, puoi chiamare predict() per i tuoi tre modelli migliori sul dataset di test che non è mai stato visto prima. Include cinque source completamente diverse, come mostrato in precedenza. Guarda le prestazioni e le classificazioni effettive.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Risultati piuttosto interessanti. Anche se la random forest aveva un’accuratezza maggiore sui dati di training rispetto a xgBoost tunato, è stata leggermente meno accurata sul dataset di test. L’accuratezza di neural net sul test è anche molto più bassa rispetto al training. Le reti neurali possono essere modelli molto flessibili e, di conseguenza, possono fare overfitting sul training set.
Con un tasso di accuratezza del r round(test_perf,2)*100% per xgBoost tunato, c’è stata comunque una diminuzione netta della performance sul test rispetto al training e il tuning ha portato solo un lieve miglioramento (con questa configurazione minima!). Questo calo di accuratezza tra train e test è comune ed è esattamente il motivo per cui dovresti testare il modello su dati nuovi.
Ora guarda le classificazioni effettive.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")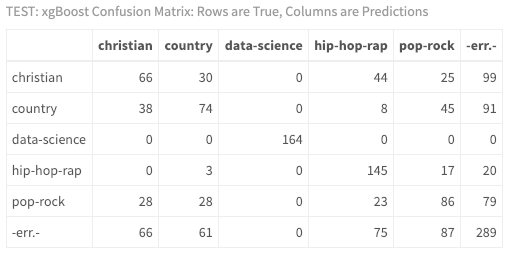
Osservando la confusion matrix, puoi vedere che è stato molto più difficile classificare questo artista hip hop, Jay-Z. Va bene se non conosci la musica: i risultati indicano che potrebbe esserci una discrepanza tra l’artista usato per addestrare il modello, Eminem, e Jay-Z usato nei dati di test. Idealmente, avresti più dati, più artisti, più tuning e lanceresti il modello più volte!!
Tuttavia, pensa a cosa potrebbe dirti questo. Guarda di nuovo il diagramma a corde:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")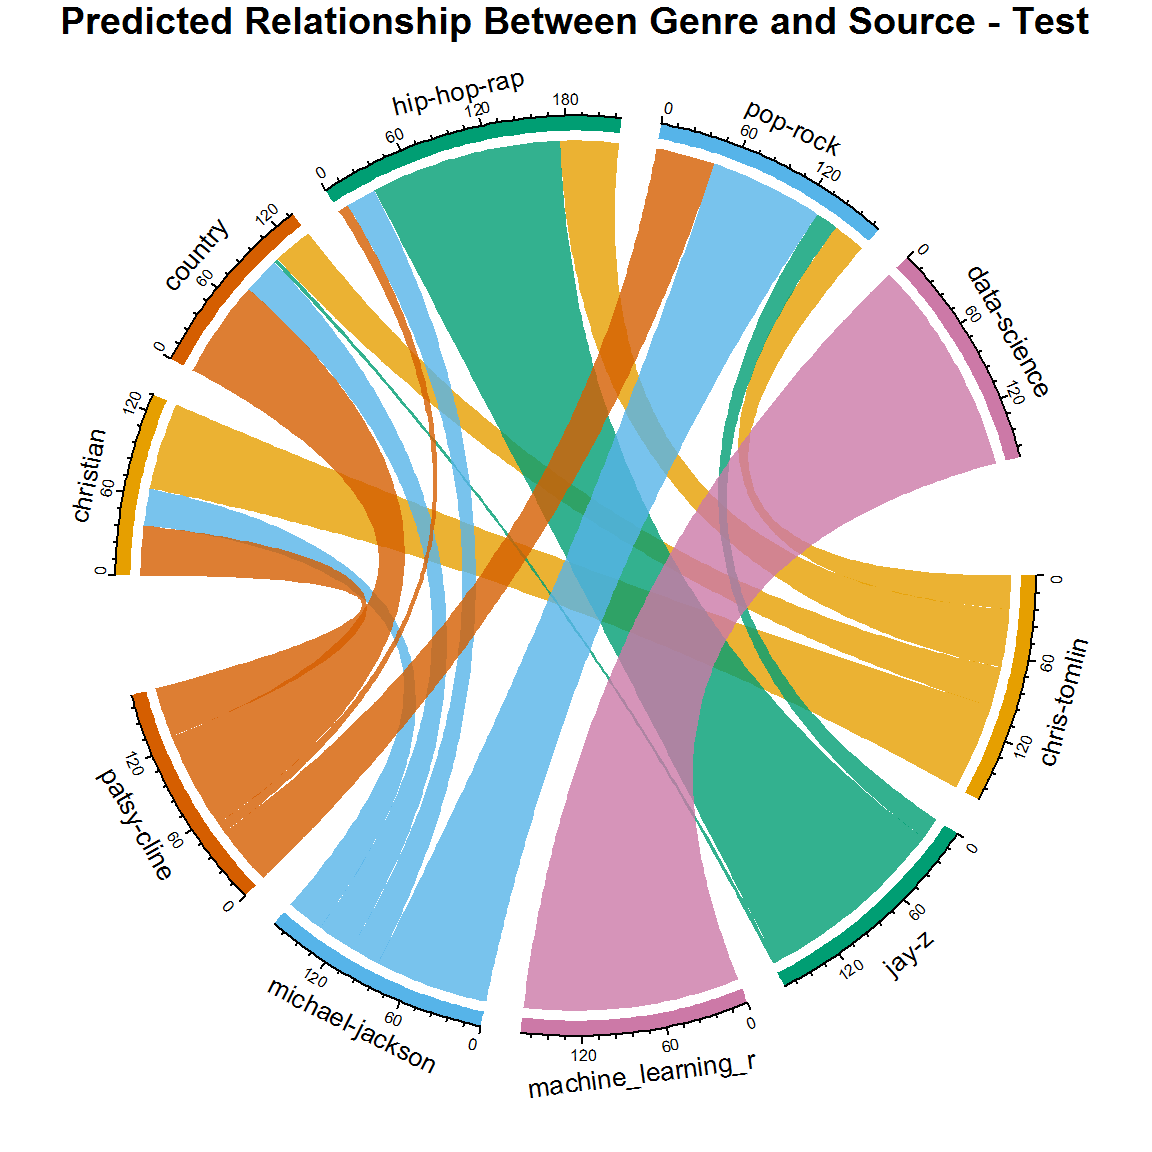
È sbagliato? È impreciso? È illuminante? Credo tu stia intravedendo il mondo reale della musica. Pensa: Michael Jackson ha mai collaborato con artisti rap? Ha mai cantato temi religiosi? Gli artisti country sono mai passati al pop-rock? Il nuovo diagramma a corde fornisce una versione più realistica della classificazione testuale rispetto al dataset originale! Nella realtà non c’è quasi mai una relazione uno-a-uno tra artista e genere, e questa flessibilità è incorporata nel tuo modello.
Nella parte successiva del tutorial, guarderai a un’idea applicabile in marketing, vendite, scienze, economia, ecc., ma qui la applicherai alla musica. Il successo di una canzone è molto soggettivo. Il concetto di successo commerciale è più chiaro perché può essere definito da standard di settore. Le Billboard Charts (e molte altre) sono esempi di tali misure. Se lavorassi per un’etichetta discografica e stessi decidendo quali artisti ingaggiare — o quali promuovere tra quelli già ingaggiati — non sarebbe interessante prevedere se entreranno in classifica in base ai loro testi con metodi scientifici? Ti servirebbero molti dati aggiornati e tonnellate di metadati per ogni canzone. Dato che qui le risorse sono limitate, prendi ciò che hai e metti alla prova l’idea sui testi di Prince con dati etichettati di classifica.
Nei tutorial precedenti hai creato un dataset di canzoni di Prince in cui la maggior parte non è entrata in classifica. Userai un set bilanciato di testi con lo stesso numero di canzoni in classifica e fuori classifica. Ecco i numeri:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")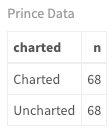
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Usando lo stesso processo di sopra, crea le feature in due passaggi. Questa volta, invece di contare le parole per genere in una canzone, conterai le parole per livello di classifica. In altre parole, ottieni le parole più usate per le canzoni entrate in classifica e quelle più usate per le canzoni non entrate, e salvale in liste. Ho scelto 1000 parole e con quel numero ho ottenuto la resa migliore. Sperimenta con i tuoi valori. Poi, quando crei le feature della canzone, assicurati di aggiungere queste due feature che contano il numero di parole di ciascuna lista per canzone (stesso procedimento usato per il genere sopra).
Nota di nuovo che ho rimosso tutte le parole che compaiono sia tra le top delle canzoni in classifica che fuori classifica. Ho anche aggiunto alcune feature polinomiali elevando al quadrato alcuni input originali. Questa idea di migliorare un modello non tanto tunando l’algoritmo, quanto trasformando gli input, è fondamentale nei metodi di machine learning.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Ripeti gli stessi passaggi di prima creando un task di classificazione per il dataset di Prince con target il campo charted. Normalizza i dati, imposta la cross-validazione e crea una lista di learner. Qui ho aggiunto alcuni algoritmi diversi perché farai classificazione binaria invece che multiclasse come prima.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
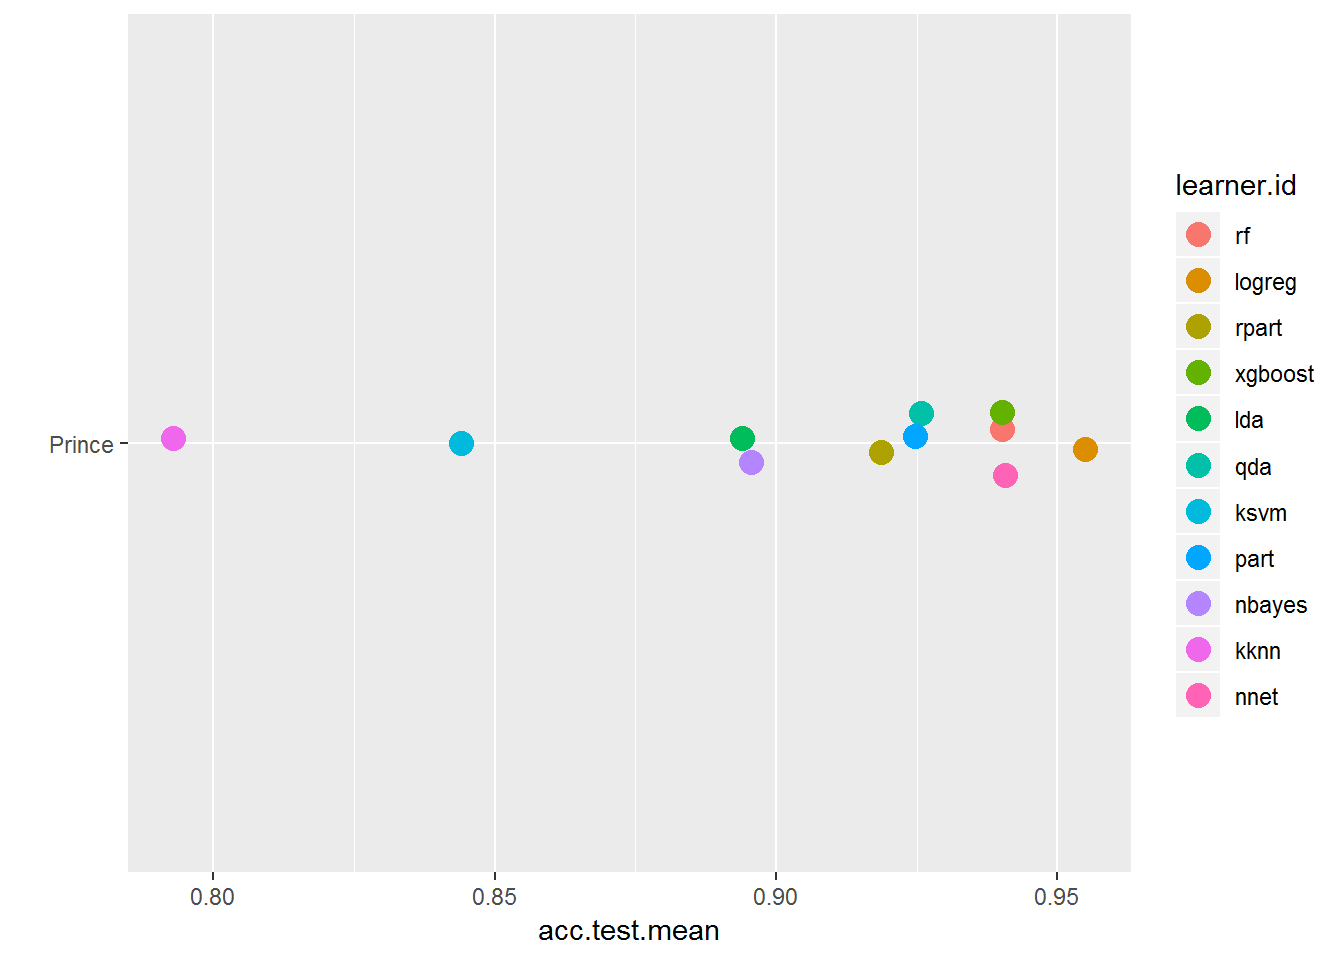
Ora che hai creato i benchmark, esamina i risultati in diversi formati. Nota le differenze di performance dei learner rispetto a quelle viste sopra.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))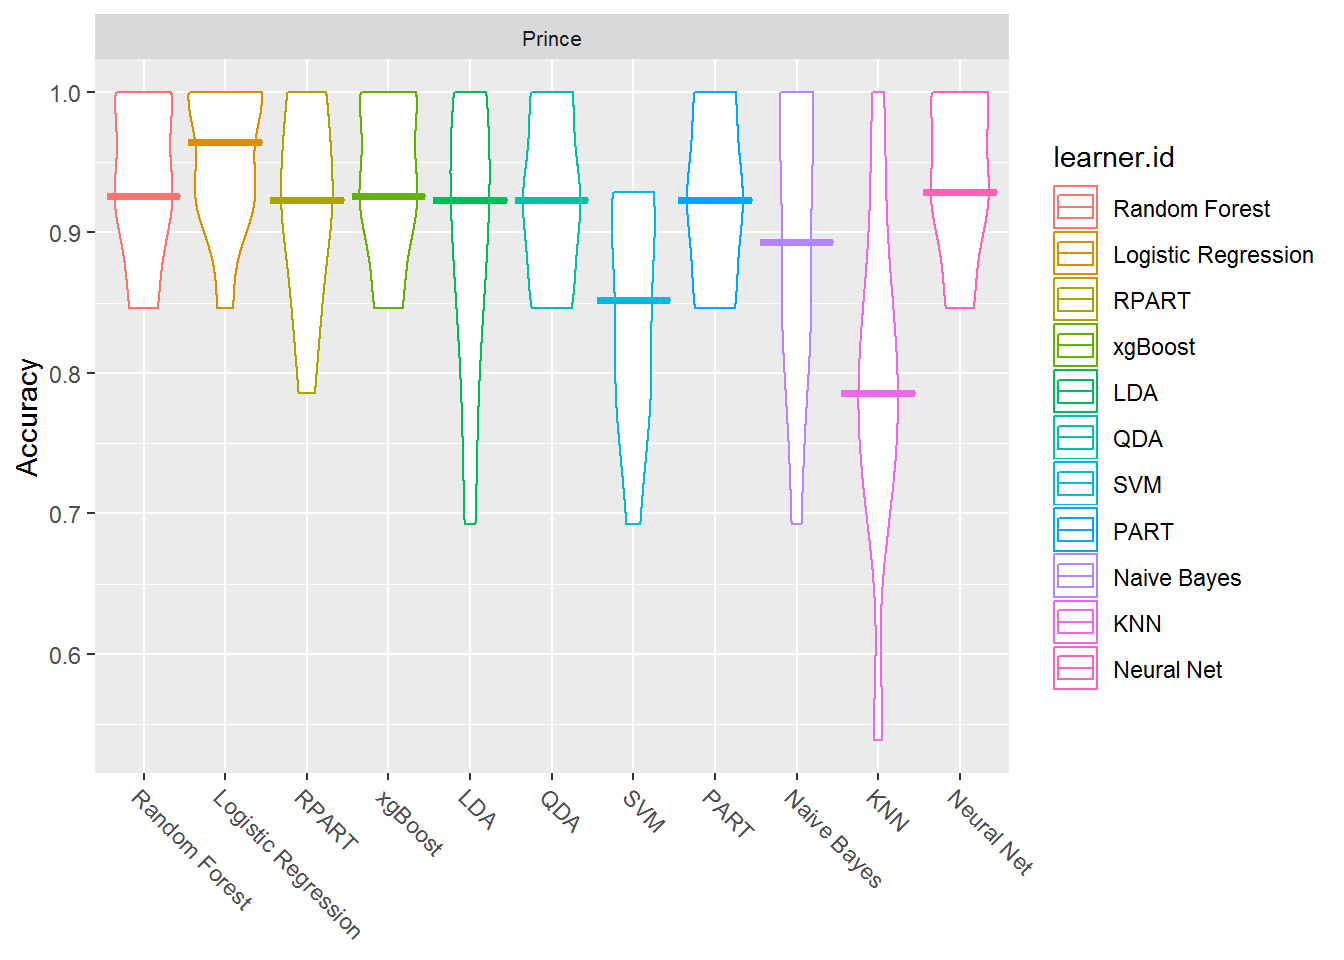
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")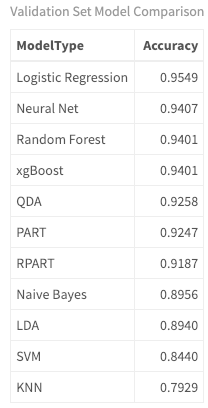
Nella previsione del livello in classifica stai lavorando con un problema a due classi. Ci sono solo due opzioni: in classifica o fuori classifica. Quando classificavi il genere, avevi un problema multiclasse, con più di due possibili classi. (Nota che questo è diverso da un problema multi-label in cui un’osservazione può avere più di una classe. Potrebbe valere la pena esplorarlo!). Poiché questa è classificazione binaria, ho aggiunto un paio di algoritmi: QDA e regressione logistica. Questi due sono più adatti ai problemi a due classi.
La regressione logistica è progettata per risultati binari e modella la probabilità che un’osservazione (canzone) appartenga a una determinata categoria. Si basa su una soglia che di default è .5. Per esempio, tutto ciò che ha probabilità maggiore di .5 appartiene alla classe target, e tutto ciò che è sotto la soglia appartiene all’altra classe. Questa soglia è regolabile. QDA sta per quadratic discriminant analysis ed è più flessibile nel gestire confini di decisione quadratici anziché lineari. Ok, non è giusto lanciare termini tecnici senza ulteriori informazioni, quindi prenditi il tempo per guardare i dati a disposizione, gli algoritmi che performano bene e approfondirli uno per uno. Spero che questa analisi ti invogli a studiare i dettagli!
Il passo successivo è eseguire le predizioni e guardare le classificazioni.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")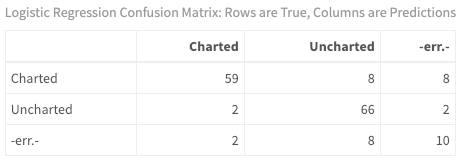
È molto semplice vedere come il modello classifica ciascuna canzone. Con la classificazione binaria, ci sono parecchie metriche da esaminare. Per ora, guarda solo i falsi positivi — cioè, quali canzoni sono state previste come in classifica quando, in realtà, non sono entrate nella Top 100.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")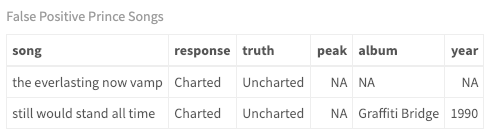
Benché tu abbia usato la cross-validazione durante l’addestramento del modello, dovresti sempre eseguirlo contro un dataset separato (come hai fatto col genere sopra). Lascio questo esercizio a te e spero che lascerai un feedback sui tuoi risultati. Perché questo sia un vero test del potere predittivo dell’analisi dei testi, i risultati più realistici arriverebbero da un artista separato ma sempre nel genere pop-rock come Prince. Un altro fattore è il periodo storico. Queste canzoni sono entrate in classifica per lo più negli anni ’70, ’80 e ’90, quindi un artista dello stesso periodo è fondamentale. Oppure scegli i tuoi artisti per training e test e vedi cosa ottieni!
In questo tutorial hai costruito un modello per prevedere il genere di una canzone basandoti interamente sui testi. Hai usato algoritmi di classificazione supervisionata e addestrato modelli su un set di cinque artisti e cinque generi. Con il framework mlr hai creato task, learner e strategie di resampling per addestrare e poi tunare uno o più modelli. Poi hai eseguito il modello su un dataset di test non visto con artisti diversi. Sei stato in grado di identificare quali algoritmi funzionano meglio con le impostazioni predefinite e, infine, di prevedere il genere di nuove canzoni mai viste dal modello.
Per quanto riguarda l’analisi dei testi, dovrebbe essere chiaro che, anche se l’industria musicale (e le Billboard Charts) hanno generi predefiniti per ogni artista, la tua analisi suggerisce che, in base ai testi, le canzoni attraversano i generi e di solito non esiste una relazione uno-a-uno. (Essendo io stessa cantautrice, il mio slogan di genere è "funkified, acoustic, rockin' soul!"). Hai anche potuto usare le stesse tecniche per modellare se una canzone entrerà in classifica basandoti interamente sui testi, con un’accuratezza discreta sui dati di training. La tua missione ora è applicare questa conoscenza ai tuoi dataset!
È stato un piacere lavorare con te in questa intera serie di tre parti (quattro tutorial) sull’analisi dei testi. Spero che tu abbia apprezzato la complessità del lavoro con questo tipo di testo e le sottigliezze dei testi musicali rispetto ad altre forme (cioè la saggistica). Spero che tu abbia imparato nuove competenze e sia ispirato a usare i tuoi dati per ottenere insight su nuovi argomenti di tuo interesse. Il machine learning è un campo entusiasmante e, come data scientist alle prime armi o esperto, creatività, ispirazione e perseveranza ti distingueranno dalla massa. Quindi ricorda di pensare fuori dal parallelogramma quadrilatero e goditi la tua avventura di apprendimento!
"Ho messo il piede sulla linea di partenza e sono partita verso un giorno tutto nuovo. Ho soffiato un bacio nel vento, chiuso gli occhi e scacciato la paura. - Debbie Liske, New Day"
(A proposito, ho scritto oltre 100 canzoni mie e ho eseguito l’ultimo modello sulla mia musica. Ha previsto che 35 delle mie canzoni sarebbero dovute entrare in classifica! Se solo avessi conosciuto prima questa tecnica!! Forse il mio prossimo articolo dovrebbe essere su come usare l’analisi dei testi per scrivere una hit basata sugli artisti di oggi...)
Ho toccato brevemente i temi qui sotto e ti incoraggio a dedicare tempo a comprenderli a fondo.
Fai pure domande nella sezione commenti!
Ecco i link ai dataset:
Approfondisci R e il Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



