Curso
Machine Learning con caret en R
4 h
60.9K
Si necesitas una introducción al aprendizaje automático, haz el curso de DataCamp Introduction to Machine Learning y revisa el tutorial Introduction to Machine Learning in Python.
Utiliza distintos algoritmos de clasificación de aprendizaje automático (ML) para crear, paso a paso, modelos que predigan el género de una canción y si tendrá éxito en las listas de Billboard, ¡basándote únicamente en sus letras!
Este es el tercer y último artículo de una serie de tres tutoriales en los que seguirás usando R para realizar varias tareas analíticas con un caso práctico de letras musicales del legendario Prince, además de otros artistas y autores. Los tres tutoriales cubren lo siguiente:
Como científico de datos, necesitas entender el aprendizaje supervisado y no supervisado. Este tutorial explica y aporta un caso de uso musical de una forma de aprendizaje supervisado —concretamente, la clasificación— basada en las letras de varios artistas (y un par de autores de libros). Aprenderás a crear modelos para clasificar canciones según su género y a investigar si es posible usar las letras para anticipar el éxito comercial.
¿Has usado alguna vez un servicio de streaming con radio de recomendaciones automáticas como Pandora, iHeart Radio, Spotify, etc.? Si creas una emisora de hard rock, seguramente no esperas escuchar una canción country sobre botas vaqueras y pueblos pequeños. Los sistemas de recomendación musical suelen centrarse en cualidades del sonido, mientras que el análisis de letras empieza ahora a aparecer en artículos científicos. Con las técnicas de este tutorial, podrás aplicar métodos punteros que hoy investigan los científicos para aportar ideas que impulsen este campo emergente.
Este tutorial asume conocimientos básicos de minería de texto con tidytext. Es una introducción intermedia a técnicas de aprendizaje automático con varios algoritmos populares de clasificación. Se recomienda tener experiencia sólida programando en R, a ser posible con algo de bagaje en aprendizaje automático y ganas de profundizar en su aplicación e implementación a través de casos prácticos. Cada algoritmo se explica brevemente, pero siempre se incluyen enlaces para ampliar.
A lo largo del artículo usarás un framework para experimentos de aprendizaje automático en R llamado mlr. Aunque el tutorial no trata sobre mlr, lo utilizarás ampliamente como una especie de interfaz del proceso de ML. El objetivo es simplificar la explicación de los pasos para crear un modelo con distintos algoritmos. Te recomiendo encarecidamente este tutorial completo del paquete.
ML tiene muchísimos componentes y aquí solo arañarás la superficie. A diferencia de las partes uno y dos, puede que esta narración te deje con más preguntas que respuestas. Sacarás el máximo provecho si avanzas con tus propios datos y código, y si investigas los diferentes algoritmos a tu ritmo.
Este es el esquema general para construir tus modelos:
Sección uno: aprende a predecir el género a partir de rasgos de las letras.
Conviene que revises los tutoriales anteriores para comprender bien los datos y sus matices. Ten en cuenta que la minería y el análisis predictivo de letras es mucho más complejo que en textos no literarios, porque el contexto, el significado y los mensajes sutiles suelen quedar ocultos bajo los matices creativos que sugiere quien compone. Igual que en la parte dos-B sobre modelado de temas, seguirás trabajando con artistas de distintos géneros y con el contenido de dos libros sobre aprendizaje automático (con género data science, para introducir otra forma de texto).
Empieza cargando las librerías y echa un vistazo a la estructura general de los datos.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Como en los tutoriales anteriores, el código del siguiente gráfico circular puede parecer enrevesado, pero no me resisto a una visual chula. Muestra la portada de un álbum/libro para cada artista/autor de tus datos. Incluye los conjuntos de entrenamiento y prueba. Para más detalles sobre el paquete circlize, consulta este libro de Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)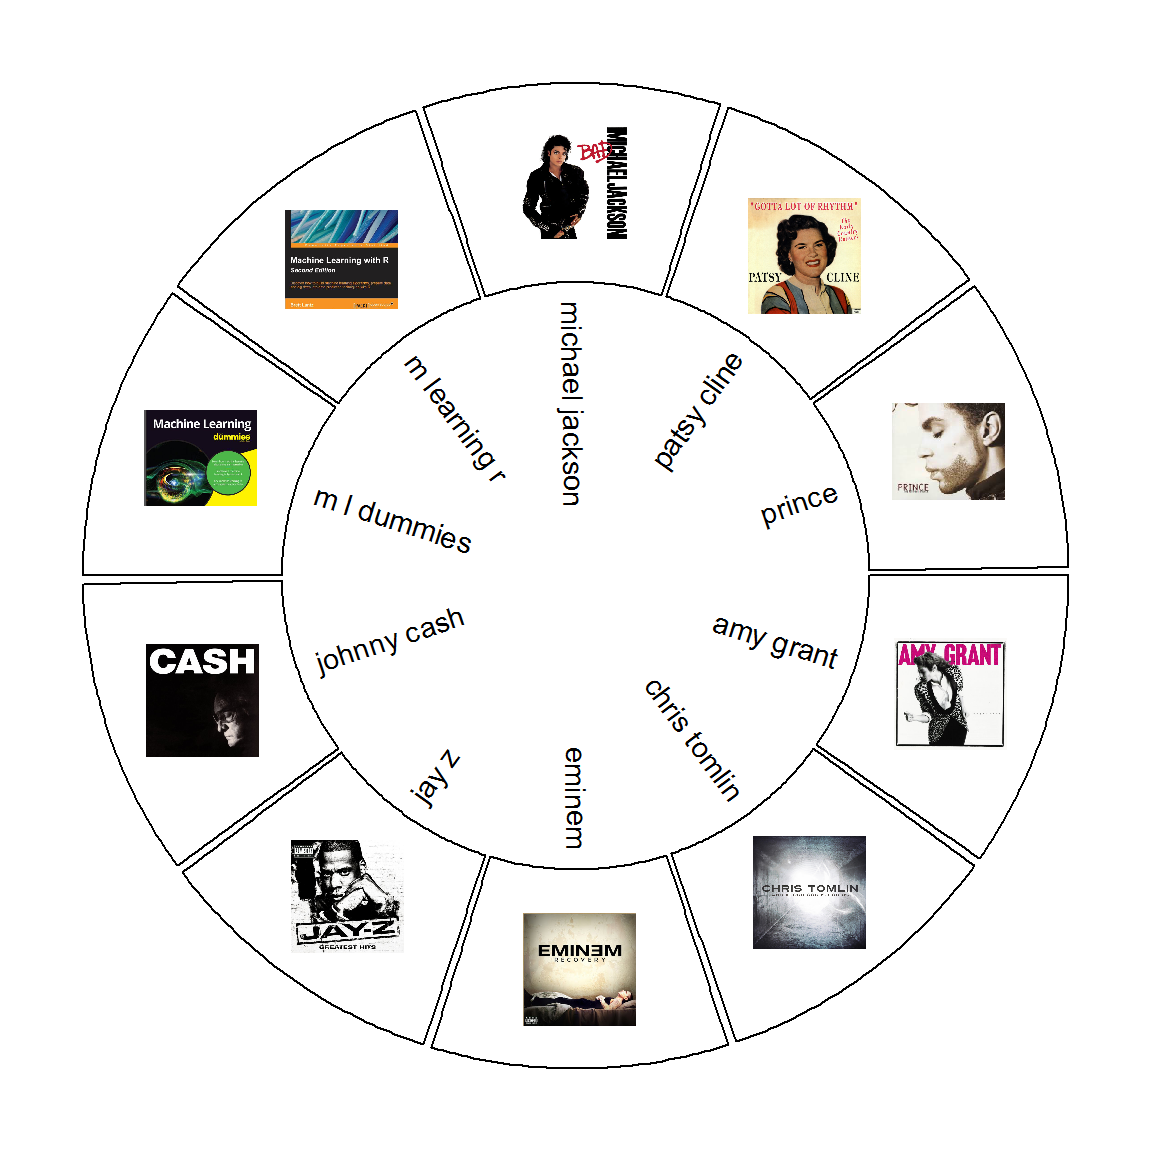
Para centrarnos en el modelado, hice el acondicionamiento de datos fuera de este tutorial y te proporciono todo lo necesario para el análisis. Resumen del preprocesado:
pdf_text() del paquete pdftools para recopilar el contenido de dos libros (cada página representa un documento distinto)A continuación, lee los datos de entrenamiento y prueba —ya vienen separados—. Después usa unnest() de tidytext para crear la versión tidy con una palabra por registro.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Ahora que ya tienes los datos de entrenamiento y prueba cargados y ordenados, puedes ver cuántos documentos hay por artista/autor. Como el conjunto contiene canciones y páginas de libros, nos referiremos a ambos como documentos. Las características que crearás se basan en documentos y su metadatos asociados, así que este concepto es importante. Además, como hay artistas y autores, los llamaremos la fuente de cada documento.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")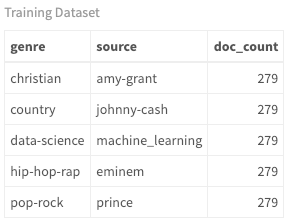
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")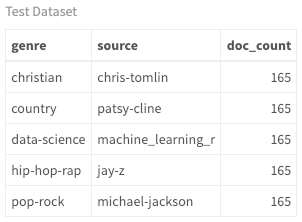
Aunque puedes ver el género, la fuente y el número de documentos, el siguiente diagrama de acordes es una forma mejor de visualizar estas relaciones. A lo largo del tutorial verás cómo evolucionan con tus nuevos modelos. Actualmente hay una relación uno a uno entre fuente y género porque los artistas están clasificados así; sin embargo, los artistas crossover son muy habituales y verás indicios de ello en versiones posteriores de este diagrama.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")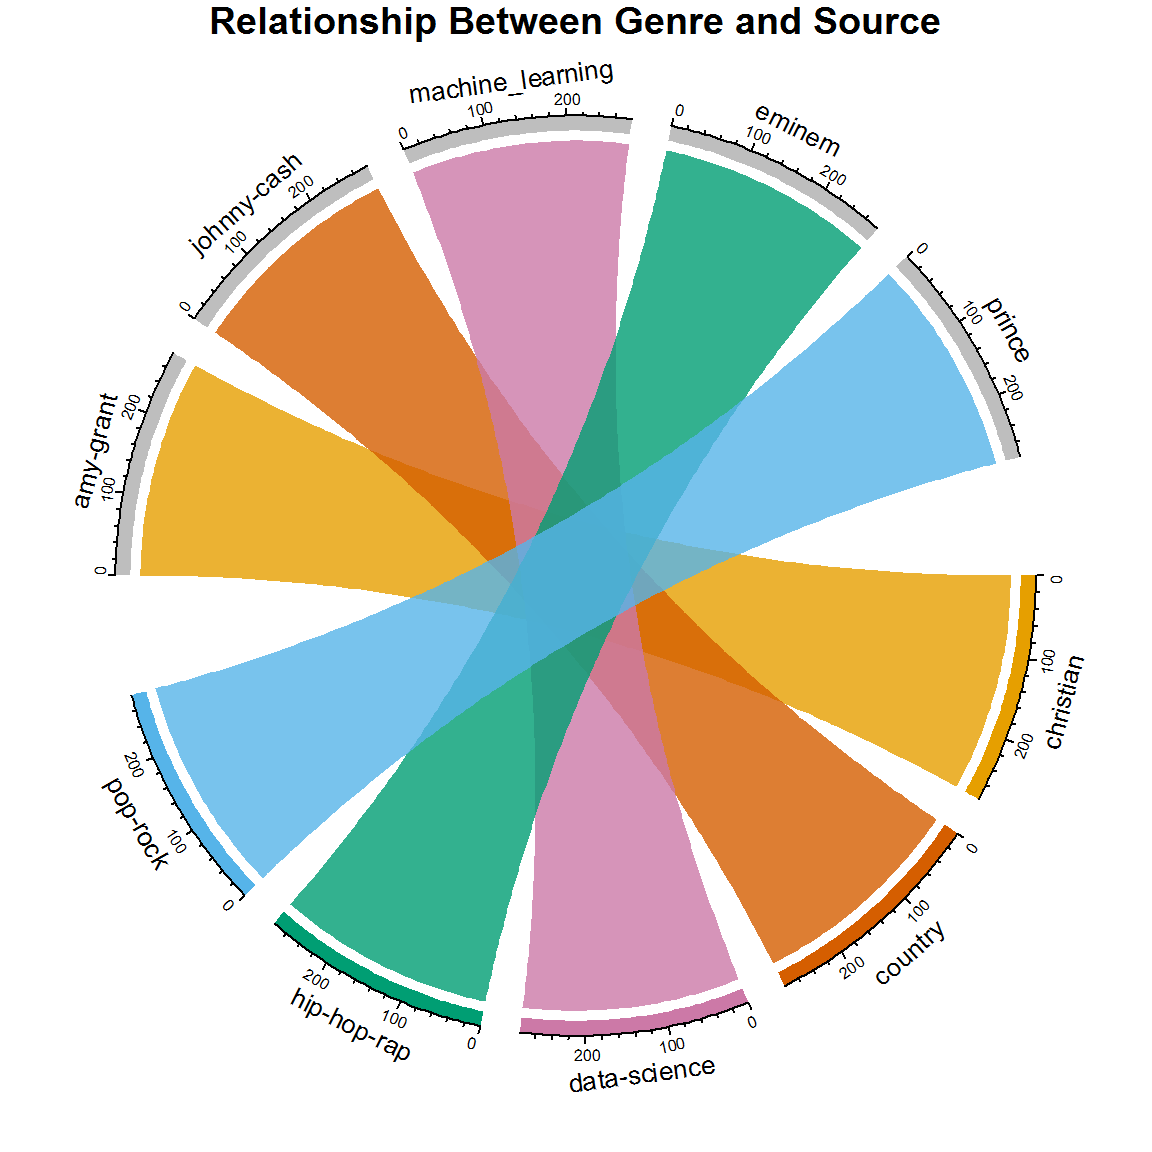
Piensa cómo sería este diagrama si no hubiera relación uno a uno. Si predijeras el género solo a partir de las letras, ¿qué crees que pasaría?
Si lo único que tienes para clasificar una canción son las letras, ¿cómo generarías variables predictoras? Primero piensa en la canción y en lo que la diferencia, a nivel de letra. Un tema común en toda la música es la repetición. ¿Algunos géneros la usan más que otros? ¿Y la longitud de las palabras? ¿Hay géneros con palabras más largas o más cortas con mayor frecuencia? ¿Qué otros factores se te ocurren para describir unas letras? Si obtienes estos recuentos por canción, ¡ya tienes tu primer conjunto de predictores!
Fíjate en que todas las variables anteriores son rasgos cuantitativos (recuentos, longitudes, etc.) basados en palabras por canción. ¿Y qué hay de palabras individuales específicas de géneros? En tutoriales anteriores trabajaste con análisis de sentimiento y modelado de temas. Estas actividades se centraban en palabras específicas de ciertos artistas o géneros. Si vas un paso más allá, puedes crear componentes predictivos muy importantes basados en el contenido (o contexto). Este paso creativo es propio del análisis de texto y genera predictores críticos para tus modelos.
Primero, quieres obtener las palabras más comunes (más usadas) por género. Esto ya se hizo en la parte uno. Empieza por contar el total de palabras por género. Luego agrupa por palabras dentro de cada género y cuenta cuántas veces se usa cada una. Ahora selecciona las n palabras más frecuentes definidas por la variable number_of_words. Aquí está la trampa: ¿cuántas eliges? Si escoges pocas, no optimizarás el modelo; si eliges demasiadas, sobreajustarás y sesgarás los resultados. Describirlo es complejo, pero la solución real es probar y errar. Yo llegué a 5500 como número óptimo. Juega con ese valor y observa su impacto: ¡puede que mejores el resultado! Si este paso aún no te queda claro, sigue leyendo: irá encajando.
Muchas palabras son muy comunes en más de un género (por ejemplo, time, life, etc.) y las he eliminado con la variable multi_genre de abajo. Así queda una lista más limpia de palabras distintas que marcan mejor la diferencia entre fuentes.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Ahora usa las palabras específicas de género como rasgos en tu dataset. Como crearás características para varios conjuntos, define una función para no repetir código. En esta función verás referencias a diversidad y densidad léxicas. Revisa la parte uno para una explicación.
Piensa en cada rasgo de abajo y cómo podría variar según el género. En vez de explicar cada uno, me centraré en los pasos de ML que vienen después; tómate un minuto para revisar el código y entender qué hace. Y no olvides los predictores específicos de género. Por ejemplo, country_word_count es simplemente el recuento de palabras top de country que aparecen en cada canción. Observa que he asignado más peso a las palabras explícitas y de libros (los valores 10 y 20 en sum()). Lo hice porque son muy distintivas y ayudan a clasificar documentos. De nuevo, ¡por prueba y error!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Ahora llama a tu función features() para los conjuntos de entrenamiento y prueba.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Si nunca has usado el paquete mlr, no pasa nada. Iremos paso a paso y verás que es bastante directo. De nuevo, te recomiendo revisar este tutorial, la documentación más completa del paquete. También puedes visitar mlr.org.
mlr (Machine Learning for R) es un framework que integra los algoritmos de ML más utilizados. En lugar de explicar la teoría de cada algoritmo, me centraré en su implementación. Al terminar, habrás usado muchas herramientas de clasificación y sacarás más provecho si practicas con el código que verás aquí.
Una vez realizada la ingeniería de características, el proceso de ML es simple: crea una tarea, define un aprendiz, entrena, prueba. Estos son los pasos:
Una tarea es simplemente el conjunto de datos sobre el que un aprendiz aprende. Como es un problema de clasificación, crearás una tarea de clasificación con makeClassifTask(). Debes indicar tu variable objetivo, genre, pasándola en el argumento target.
He creado tres tareas con objetivos distintos. Train y test son evidentes, pero además hay un dataset que usa solo rasgos cuantitativos básicos (resúmenes y recuentos por documento). Esta tarea, task_train_subset, se crea sin las variables de conteo de palabras por género (p. ej., country_word_count, pop_rock_word_count, etc.) para ilustrar la importancia de estos predictores contextuales en el modelo final. Usar train[3:13] elimina estas variables. Además, siempre debes quitar las columnas de texto al crear la tarea; en este caso están en las posiciones uno y dos del dataframe.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
data = test[-c(1:2)], target = "genre")La normalización requiere algo de investigación, no siempre es necesaria y depende del dataset; en este caso, es beneficiosa. Escala tus datos para que todos los valores queden en rangos comparables (p. ej., entre 0 y 1). Si algunas variables tienen valores mucho mayores y en otra escala, sesgarán el modelo dando más peso a esas variables. La normalización corrige esto. Este hilo es una buena introducción. mlr ofrece la función normalizeFeatures() para este paso.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Un aprendiz en mlr se genera con makeLearner(). En el constructor debes indicar el método de aprendizaje. Puedes obtener la lista de posibles algoritmos de clasificación con listLearners("classif")[c("class","package")]. Te muestra los algoritmos disponibles y sus paquetes dependientes (que quizá debas instalar aparte).
Para este ejercicio, he elegido una lista que admite más de dos clases y te da un abanico de técnicas, desde árboles de decisión hasta random forests, SVM, gradient boosting y redes neuronales. Hay muchos learners entre los que elegir (actualmente hay más de 80 de clasificación en mlr). ¡Te animo a probar!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)El remuestreo es esencial en ML y merecería un tutorial aparte. De momento, una noción básica te ayudará. Consiste en extraer repetidamente muestras del conjunto de entrenamiento y reentrenar un modelo en cada muestra. Así puedes obtener información que no tendrías ajustando el modelo una sola vez sobre el conjunto original.
Hay varios métodos, pero aquí usarás validación cruzada k-fold (indicado por "CV" en makeResampleDesc()), que devuelve un objeto de descripción de remuestreo (rdesc). Este enfoque divide aleatoriamente el dataset en k grupos (folds) del mismo tamaño. El primer fold se usa como validación y el resto para entrenar. Se repite k veces, una por fold. Se captura la tasa de error y se promedia al final.
Si es tu primera vez con remuestreo, puede sonarte a chino, pero es clave familiarizarse con el concepto. Usarás validación cruzada de 10 folds. «En clasificación, suele ser deseable mantener la misma proporción de clases en cada fold.» (Fuente) Usa stratify = TRUE para garantizarlo.
Más información sobre remuestreo en mlr en este artículo.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)El objetivo típico en clasificación es lograr alta precisión de predicción y minimizar errores. En este sentido, se consideran todos los tipos de error con el mismo peso. Sin embargo, en muchas aplicaciones ciertos errores importan más que otros. Por ejemplo, al clasificar una enfermedad, no detectarla cuando existe puede ser crítico. Existen diferentes métricas para estos matices. Para el análisis de letras, nos centraremos sobre todo en medidas básicas de accuracy y error. Recuerda que la accuracy y la tasa de error no siempre son la mejor opción para evaluar la robustez de un modelo. Es un tema importante que también merece más discusión fuera de este tutorial.
La accuracy es el número de predicciones correctas sobre el total. Para examinar las malas clasificaciones del modelo, también verás una matriz de confusión con las clasificaciones (predicho vs. real). Enseguida volveremos a ello. Por ahora, configura la lista de métricas de interés. Aquí añado tres, pero miraremos acc. Este enlace ofrece más información.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)En mlr puedes ejecutar un experimento de benchmark en el que aplicas distintos algoritmos a tu dataset. Así comparas algoritmos según las métricas (por ejemplo, accuracy). Ejecutarás benchmark() para entrenar tu modelo y generar un objeto BenchmarkResult desde el que acceder a modelos y resultados.
Por fin, toca construir un modelo. Empieza con la tarea que creaste sin los conteos de palabras por género. Pasa a benchmark tu lista de aprendices, la tarea de subconjunto, la estrategia de remuestreo (rdesc) y las métricas que quieras ver.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252Si miras el objeto BenchmarkResult, verás el acc.test.mean de cada algoritmo. Ojo: se refiere a test dentro de la validación cruzada, es decir, la media de accuracy sobre los conjuntos de validación retenidos durante el entrenamiento. No es el mismo conjunto de prueba que usarás después. De nuevo, tema para profundizar; quédate con que hay una serie de conjuntos de validación retenidos en la CV y, aparte, un conjunto de prueba para usar tras elegir y ajustar el algoritmo.
En este benchmark, Random Forest rinde mejor con un r rf_perf por ciento (y tardó más en entrenar). Con ese valor en mente, repite el experimento con el conjunto completo de características.
Ahora pasa la tarea que incluye el conteo de palabras por género y documento. Esto añade rasgos que indican si una canción tiene más palabras de country, de pop-rock, etc. Recuerda: con tu dataset etiquetado seleccionaste las palabras hip-hop más comunes y las guardaste en hip_hop_words (como thug, crib, drug). La lista de country incluye lonesome, coal, drunken, cattle. Ya te haces una idea.
mlr ofrece varios métodos para acceder a resultados de benchmark. Usaré unos pocos, pero para familiarizarte con el objeto, te recomiendo las funciones getBMR*. Si llamas a str() sobre el objeto, tardará un buen rato en devolverte el detalle.
Antes de entrar en detalle, haz benchmark de múltiples tareas y compara el conjunto completo frente al subconjunto con plotBMRSummary(). Crea una lista de tareas y pásala a benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)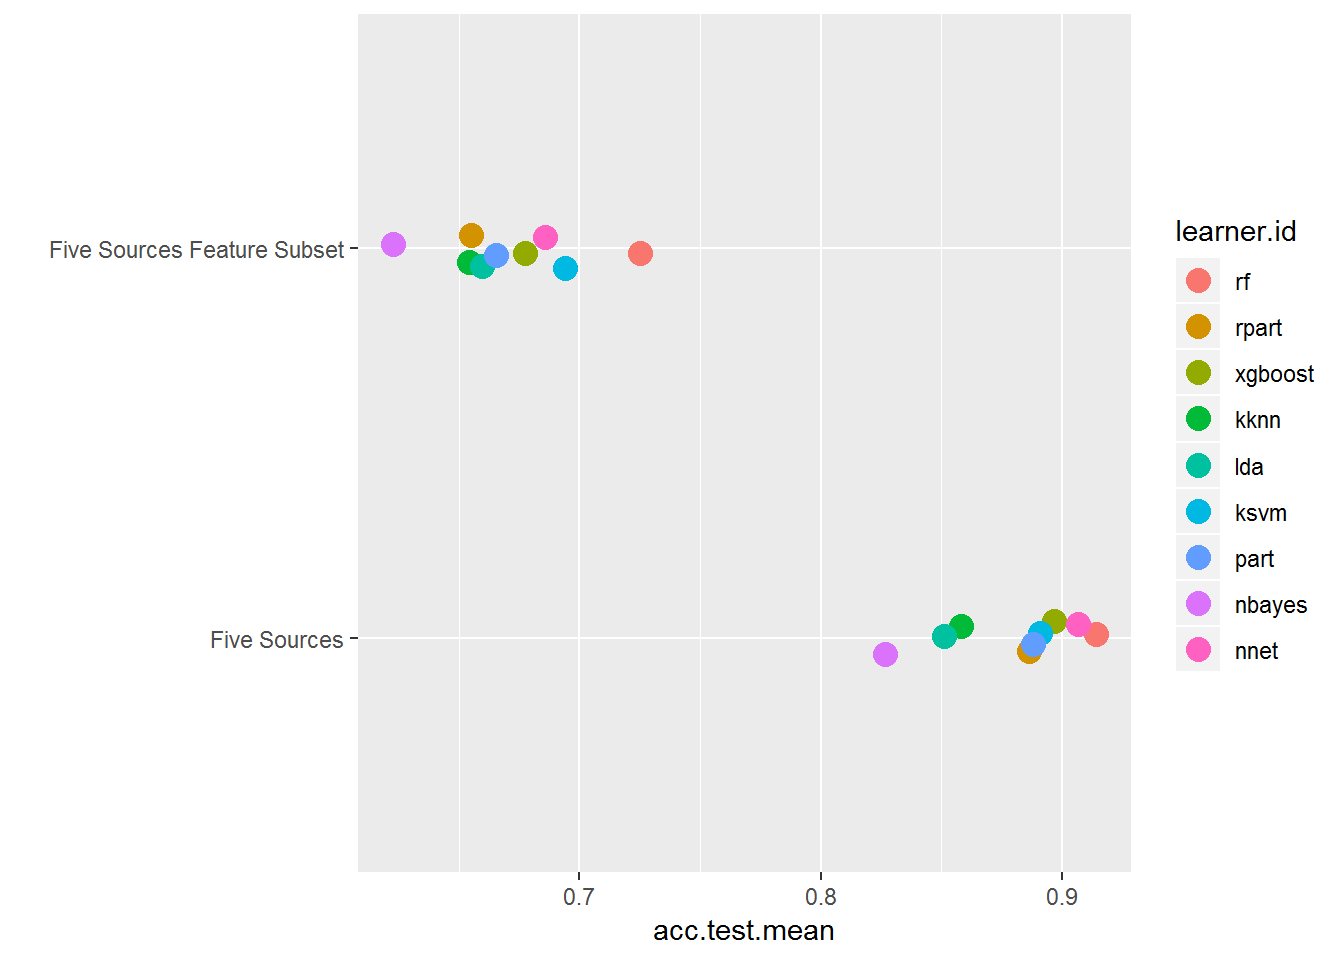
Aquí puedes ver que el acc.test.mean del subconjunto sin conteos de palabras por género es inferior al del conjunto completo. ¡Estas características marcan una gran diferencia! Este paso creativo es muy propio del ML con texto. Guárdalo como recurso para tus proyectos.
Aunque podrías acceder solo a los resultados de bmr_multi_task, haz de nuevo el benchmark con la tarea de entrenamiento y analiza los resultados con getBMRAggrPerformances() y plotBMRBoxplots().
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)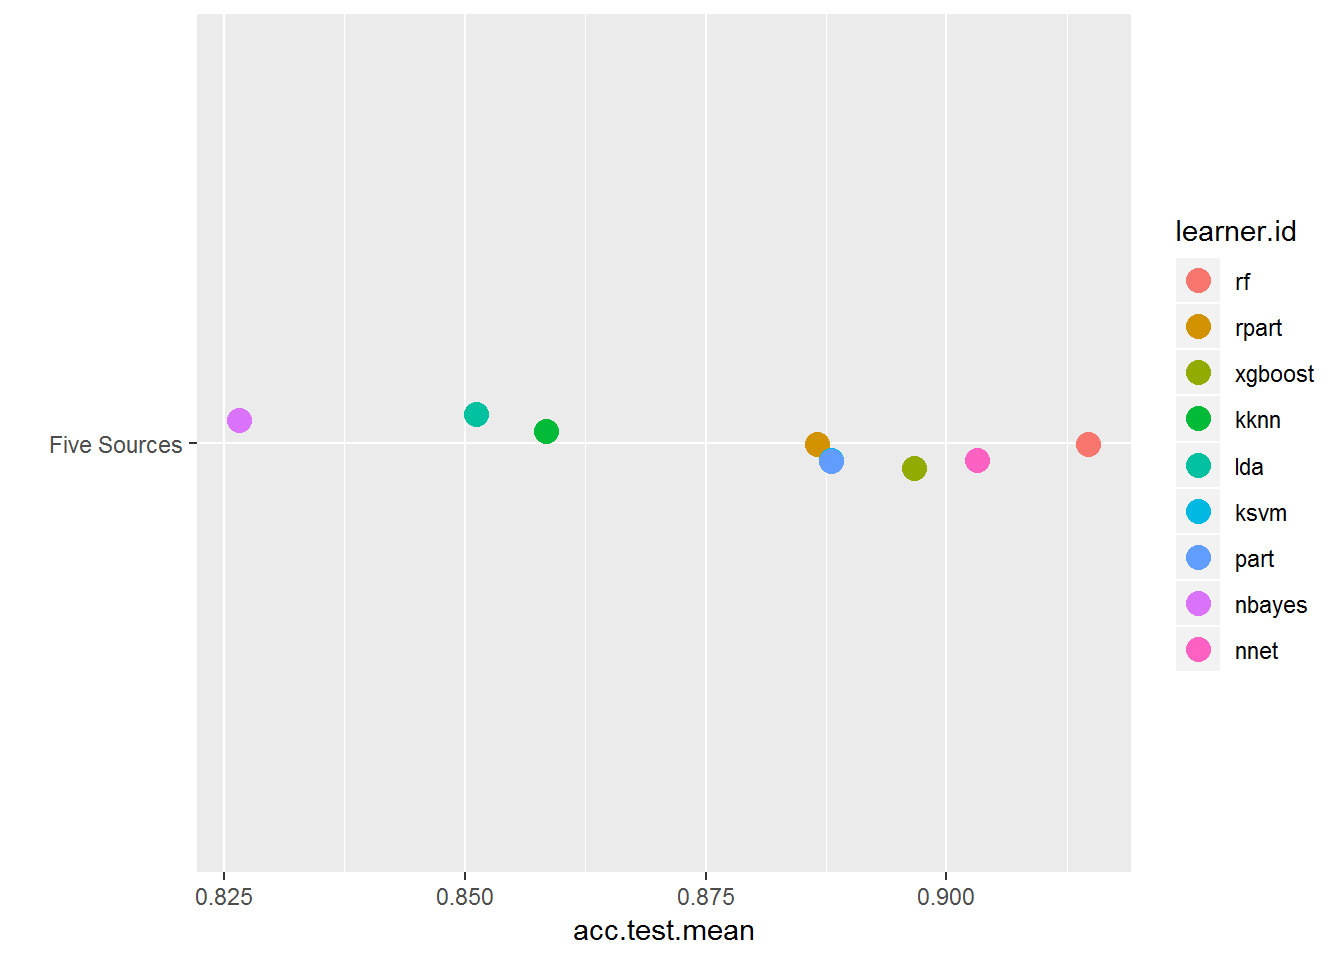
Esto te permite acercarte a los resultados del conjunto completo. Ahora se aprecia mejor la diferencia entre algoritmos y cómo random forest supera a los demás.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))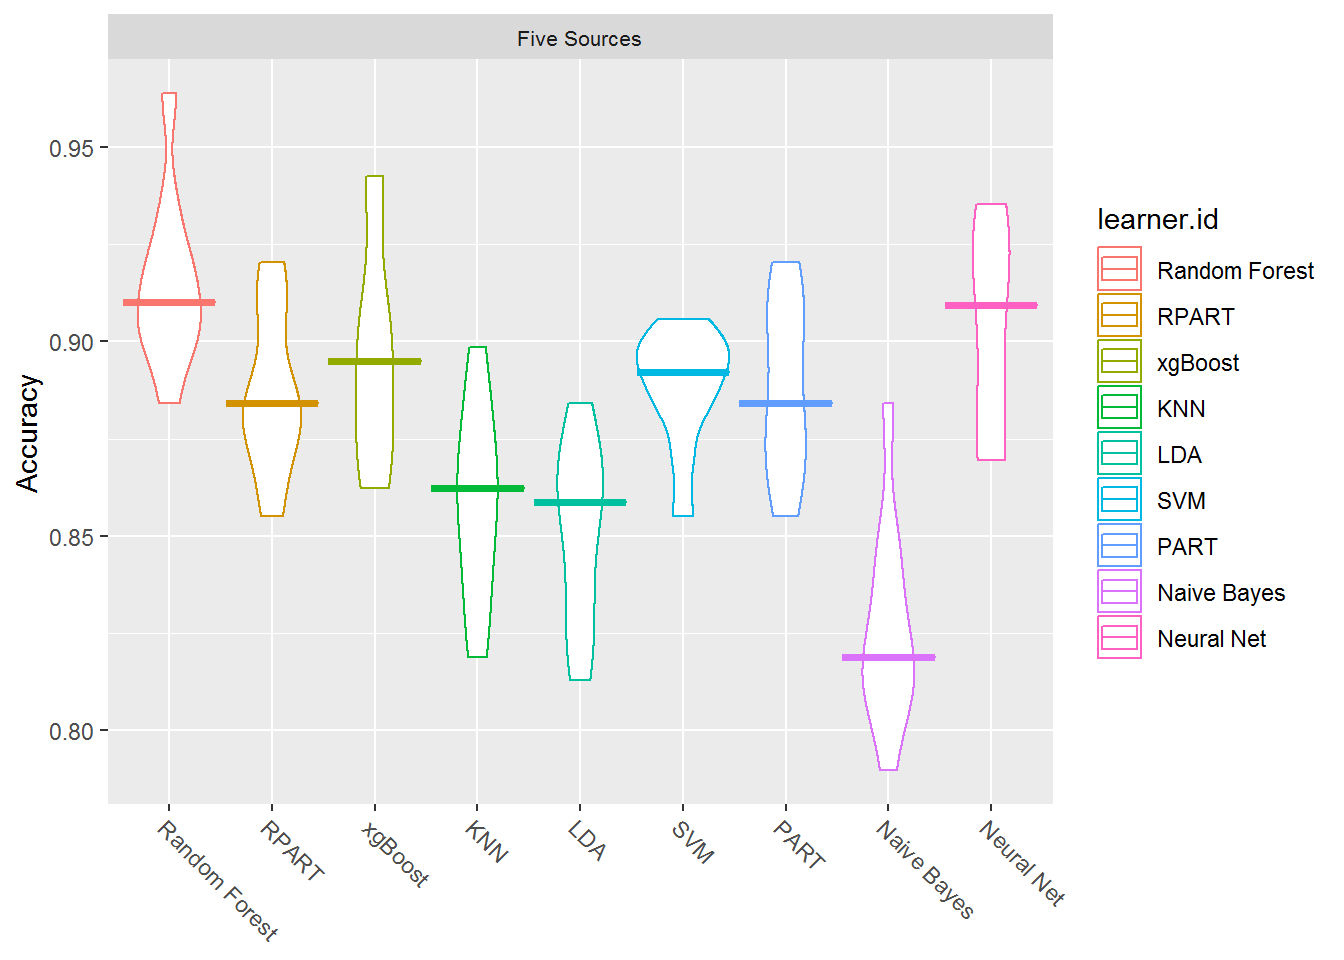
Estos boxplots muestran los resultados de cada método a lo largo de las iteraciones del benchmark.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")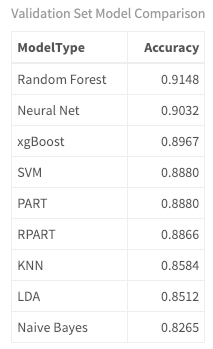
Aquí ves que la accuracy más alta es para Random Forest, Neural Net y xgBoost, con r first_three por ciento, respectivamente. ¿Qué ha pasado realmente en el modelo? ¿Cómo se clasificaron los documentos/canciones? ¿Qué géneros fueron más difíciles de clasificar por letras? Para profundizar, mira la matriz de confusión de las predicciones. En la diagonal aparecen los documentos correctamente clasificados. Las malas clasificaciones están fuera de la diagonal. Los conteos de error están en los márgenes. Las columnas son las predicciones; las filas, los valores reales. Usa getBMRPredictions() para acceder a las predicciones de entrenamiento/validación. Luego consulta el result de la matriz de confusión del modelo Random Forest, accesible con el id Five Sources que diste antes a tu tarea de entrenamiento. (Podrías hacerlo con cualquier modelo del benchmark.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")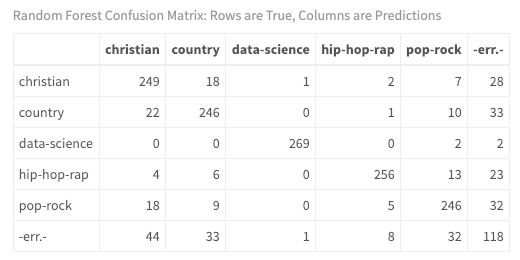
¡Por fin tienes visibilidad de tu modelo! Como era de esperar, con una sola mala clasificación, es relativamente fácil distinguir documentos de data science de letras de canciones usando las características textuales que creaste. Además, hip-hop-rap es muy distintivo respecto a otros géneros musicales con solo ocho malas clasificaciones. Aun así, aunque el rendimiento es notable, hay menos distinción entre country, christian y pop-rock.
El objetivo del tutorial no es solo exponer técnicas de ML predictivo, sino también analizar letras como continuación de los anteriores. Piensa qué significan estos resultados. Si desarrollaras un sistema de recomendación complementado con información de letras, ¿qué tendrías en cuenta? ¿Cabe la posibilidad de recomendar un artista de hip hop con letras explícitas a quien escucha música cristiana o country?
¿Recuerdas el diagrama de acordes del principio? Vuelve a mirarlo, ahora con predicciones en lugar de etiquetas reales.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")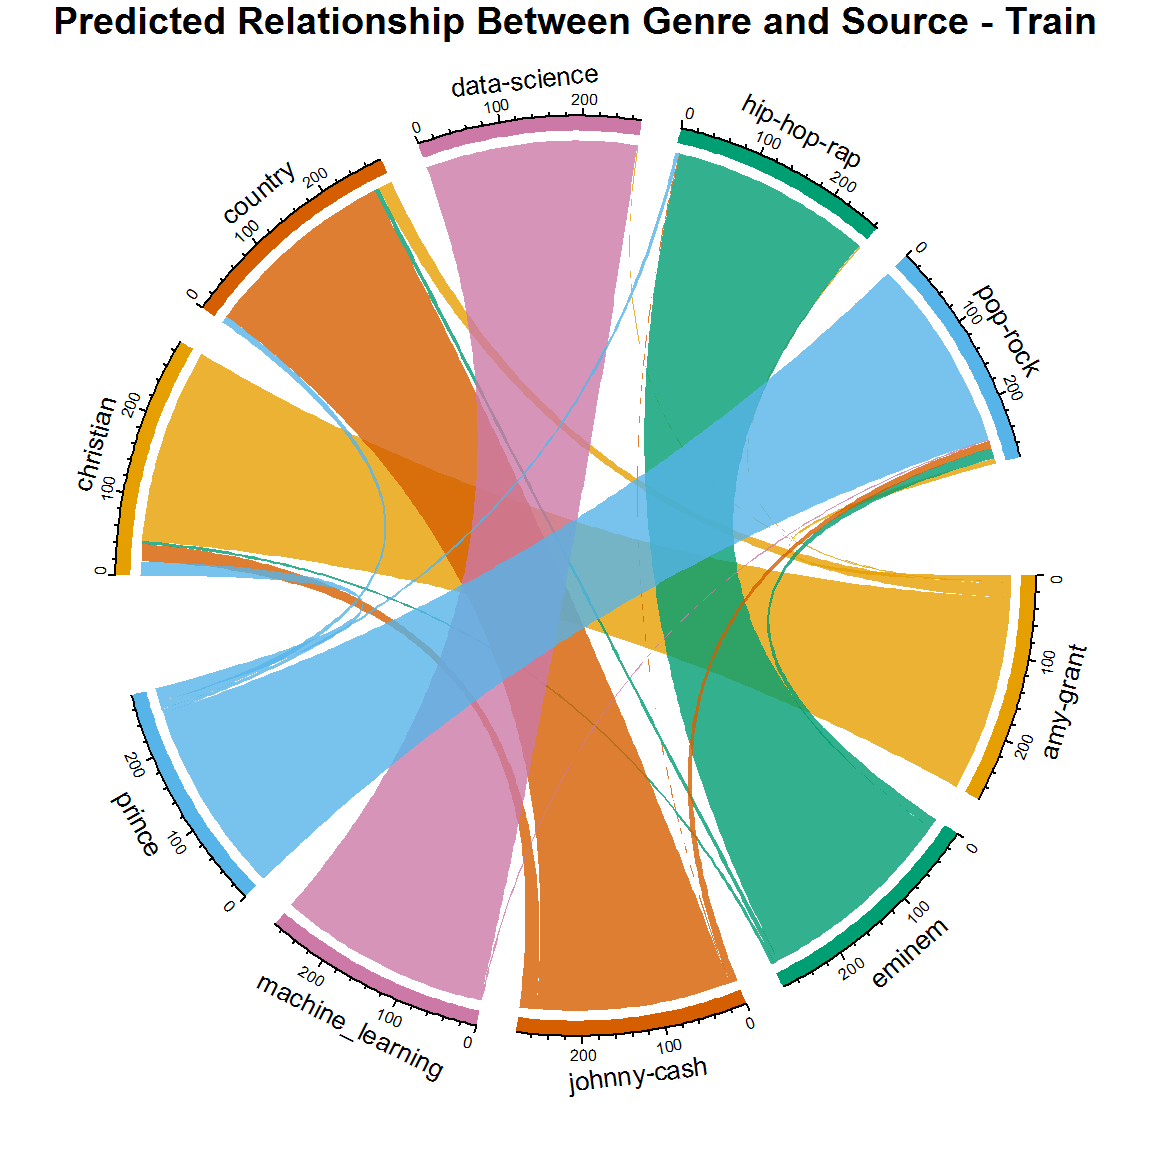
Muy bien. Ya puedes ver cómo lo hiciste en los datos de entrenamiento. De nuevo, los resultados son sólidos. Las líneas más finas representan malas clasificaciones. Pero aquí llega probablemente el concepto más importante del tutorial: aunque esta accuracy sea de validación, ¡sigue basada en un dataset etiquetado de entrenamiento! Si no tienes cuidado, puedes sobreajustar el modelo e introducir alta varianza. La alta varianza implica que tu algoritmo de aprendizaje varía mucho según los datos que reciba, y podría no ser robusto al ruido de datos nuevos no vistos. Harás una prueba real en un momento, cuando lo alimentes con datos totalmente nuevos.
Antes de probar datos nuevos, vas a escoger un modelo y ajustarlo —mediante sus hiperparámetros. Es decir, configurar los parámetros del modelo para mejorar su rendimiento. Si has pasado por Kaggle últimamente, habrás visto que un algoritmo de moda llamado extreme gradient boosting domina muchas competiciones. Aunque no fuera el mejor en nuestro benchmark, voy a elegirlo para ajustar y ejecutarlo en el conjunto de prueba. Si eres nuevo en este tipo de algoritmos, el ajuste quizá sea la parte más dura. Por alcance, no entraré en los conceptos de gradient boosting ni en sus hiperparámetros, pero el código de abajo te servirá de base. Te recomiendo encarecidamente revisar el concepto de gradient boosting antes de afinar. Este artículo de Prince Grover es un gran punto de partida. Según lo describe, resumen del boosting clásico:
Primero modela los datos con modelos simples y analiza los errores. Esos errores señalan puntos difíciles de ajustar por un modelo simple. Después, en modelos posteriores, céntrate especialmente en esos puntos difíciles. Al final, combina todos los predictores ponderándolos.
(Nota: el valor maxit de 150 en makeTuneControlRandom() tarda bastante. Quizá quieras empezar con algo mucho menor).
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Puedes revisar los hiperparámetros optimizados en la salida de tuneParams(). Ahora crea un nuevo modelo con esos hiperparámetros ajustados y vuelve a entrenarlo sobre el conjunto de entrenamiento.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))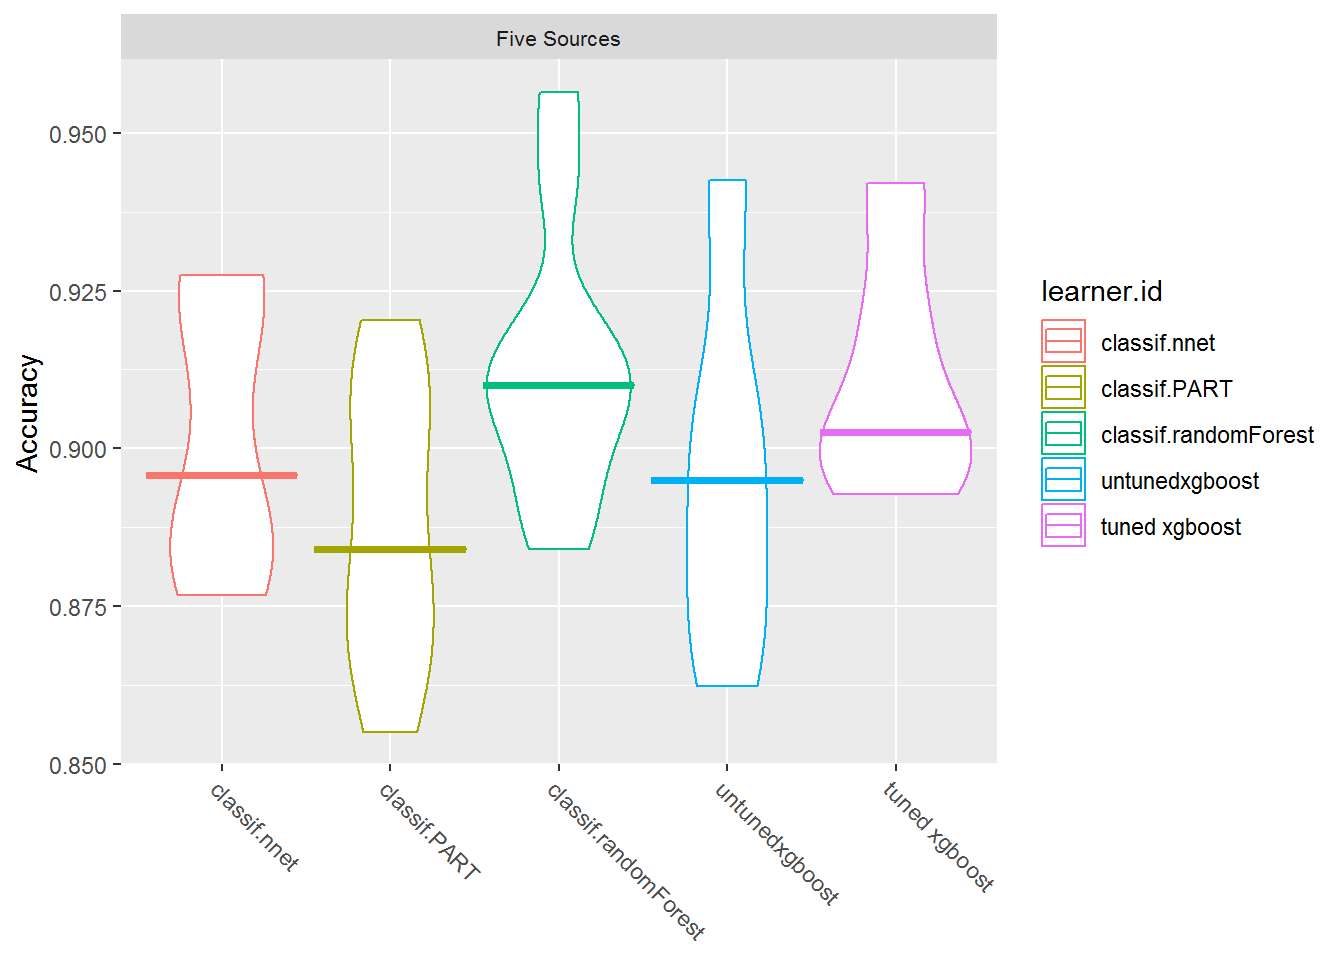
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")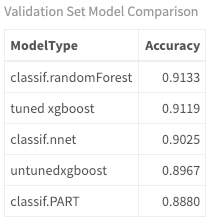
El xgBoost ajustado mejora ligeramente al no ajustado, pero sigue sin alcanzar a random forest. ¿Y qué pasa en el test?
Con el modelo ajustado y los benchmarks listos, llama a predict() para tus tres mejores modelos sobre el conjunto de prueba que el modelo nunca ha visto. Incluye cinco fuentes completamente distintas, como viste antes. Observa su rendimiento y las clasificaciones reales.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Resultados interesantes. Aun cuando random forest tuvo mayor accuracy en entrenamiento que el xgBoost ajustado, fue ligeramente menos preciso en el conjunto de prueba. La accuracy de la red neuronal también cae bastante respecto a entrenamiento. Las redes pueden ser muy flexibles y, como consecuencia, sobreajustar el set de entrenamiento.
Con una accuracy de r round(test_perf,2)*100% para el xgBoost ajustado, igualmente hay una caída notable de rendimiento en test respecto a training, y el ajuste solo mejoró ligeramente (con esta configuración mínima). Esta bajada entre train y test es muy común y es precisamente la razón por la que debes probar con datos nuevos.
Ahora, mira las clasificaciones reales.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")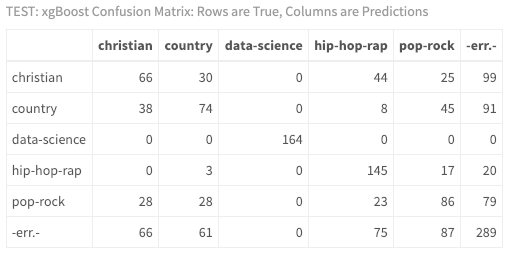
Al mirar la matriz de confusión, ves que fue mucho más difícil clasificar a este artista de hip hop, Jay-Z. No pasa nada si no conoces su música: tus resultados indican que puede haber discrepancias entre el artista usado para entrenar, Eminem, y Jay-Z en los datos de prueba. Lo ideal sería disponer de más datos, más artistas, más afinado y ejecutar el modelo múltiples veces.
Pero piensa qué te puede estar diciendo esto. Vuelve a mirar el diagrama de acordes:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")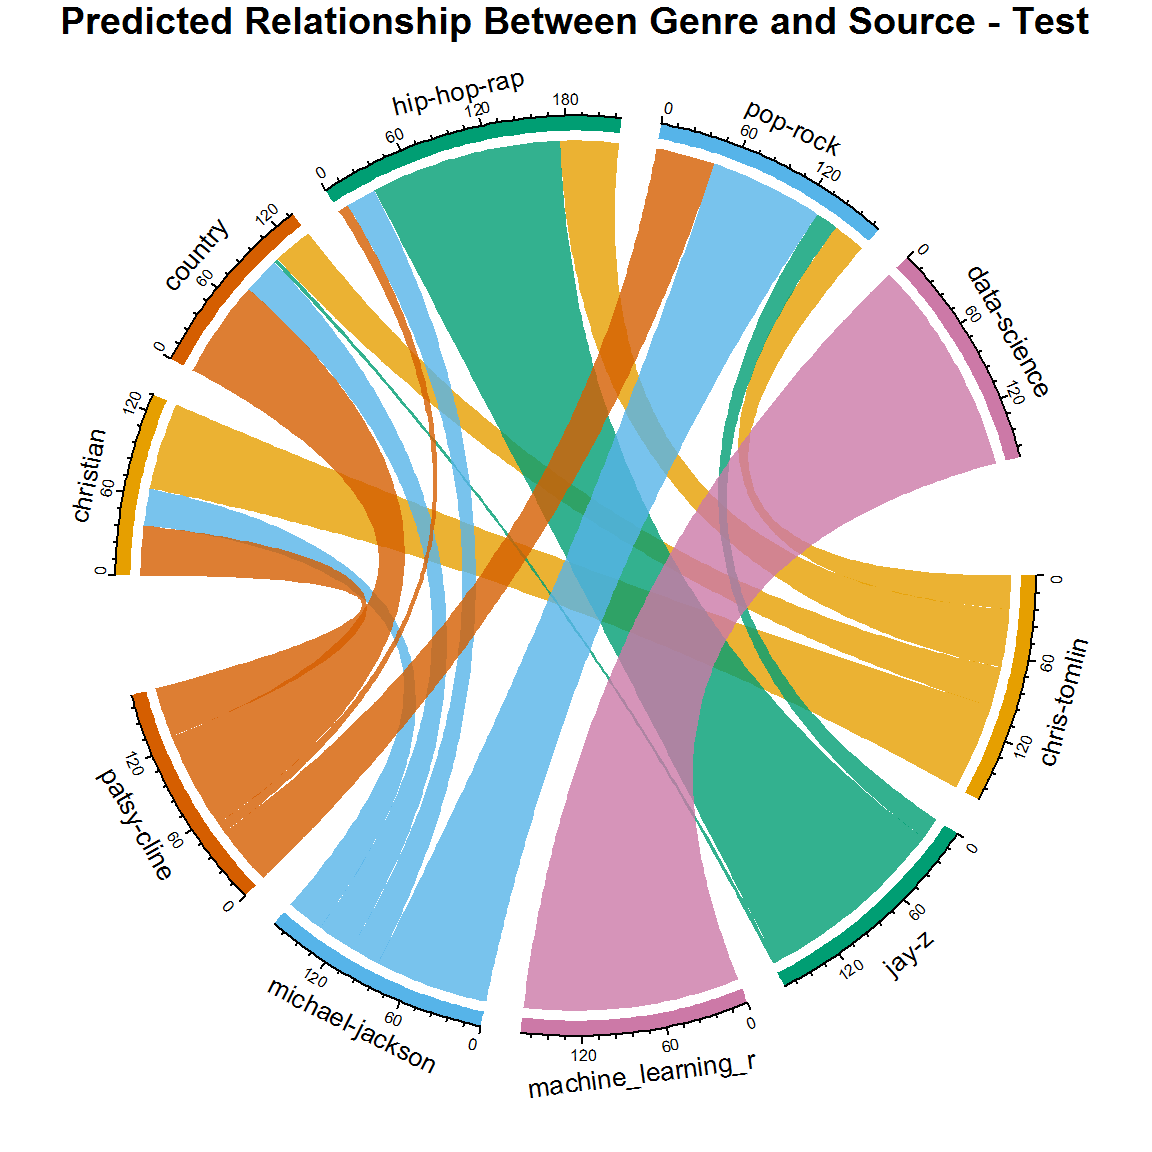
¿Está mal? ¿Es inexacto? ¿O es revelador? Creo que estás teniendo una visión realista del mundo de la música. Piénsalo: ¿Michael Jackson colaboró con artistas de rap? ¿Cantó sobre temas religiosos? ¿Artistas country han cruzado al pop-rock? ¡Tu nuevo diagrama ofrece una versión más realista de la clasificación lírica que el dataset original! En la vida real casi nunca hay relación uno a uno entre artista y género, y esa flexibilidad también aparece en tu modelo.
En la siguiente parte explorarás una idea aplicable al marketing, ventas, ciencia, economía, etc., pero aquí la aplicarás a la música. El éxito de una canción es subjetivo. El éxito comercial es más concreto y puede definirse con estándares del sector. Las listas de Billboard (y otras) son ejemplos de esa medida. Si trabajases en un sello y tuvieras que decidir qué artistas fichar o a quién impulsar, ¿no sería interesante poder predecir si entrarán en listas a partir de sus letras con métodos científicos? Necesitarías muchos datos actuales y metadatos de cada canción. Como aquí los recursos son limitados, toma lo que tenemos y prueba la idea con letras de Prince y datos etiquetados sobre si entraron en listas.
En tutoriales anteriores creaste un conjunto de canciones de Prince donde la mayoría no entraron en listas. Aquí usarás un conjunto equilibrado con el mismo número de canciones que sí y que no entraron. Estos son los números:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")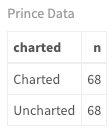
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Usando el mismo proceso, crea las características en dos pasos. Esta vez, en lugar de contar palabras por género en una canción, contarás palabras por nivel de éxito en listas. Es decir, obtén las palabras más frecuentes en canciones que entraron y en las que no entraron, y guárdalas en listas. Yo utilicé 1000 palabras y con ese número obtuve la mejor respuesta. Prueba tus propios valores. Al crear las características por canción, añade estos dos rasgos que cuentan las palabras de cada lista por canción (como hiciste con género).
De nuevo, eliminé todas las palabras que aparecen tanto en el top de charted como de uncharted. También añadí algunas características polinómicas elevando al cuadrado entradas originales. Mejorar un modelo no solo va de afinar el algoritmo, sino de transformar las entradas: es una idea fundamental en ML.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Repite los mismos pasos: crea una tarea de clasificación para el dataset de Prince con charted como target. Normaliza los datos, configura la validación cruzada y crea una lista de aprendices. Aquí añado algunos algoritmos distintos porque ahora harás clasificación binaria, no multiclase.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
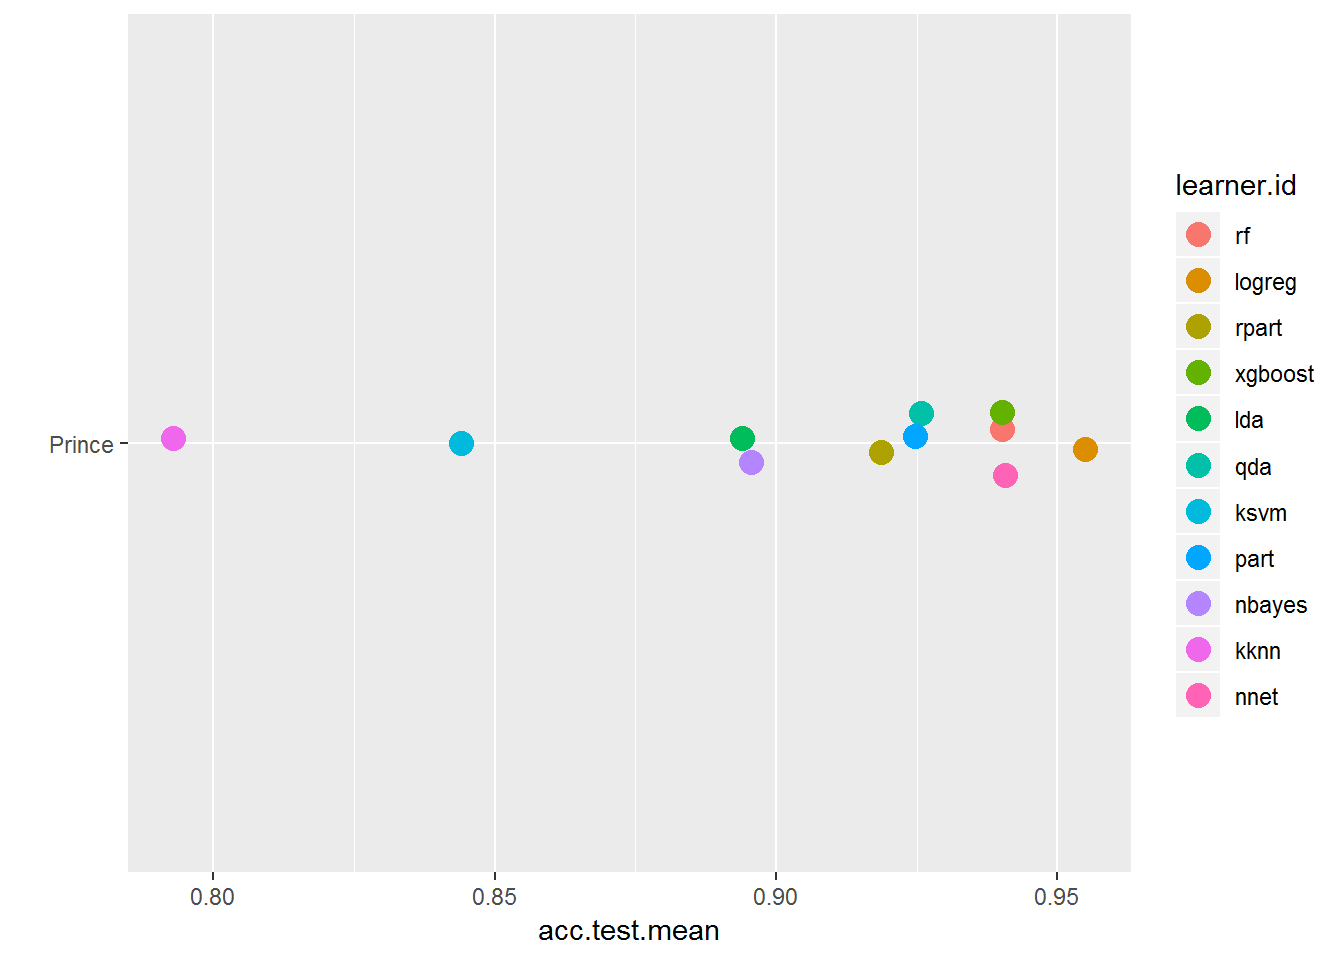
Con los benchmarks creados, explora los resultados en varios formatos. Observa las diferencias de rendimiento respecto a los anteriores.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))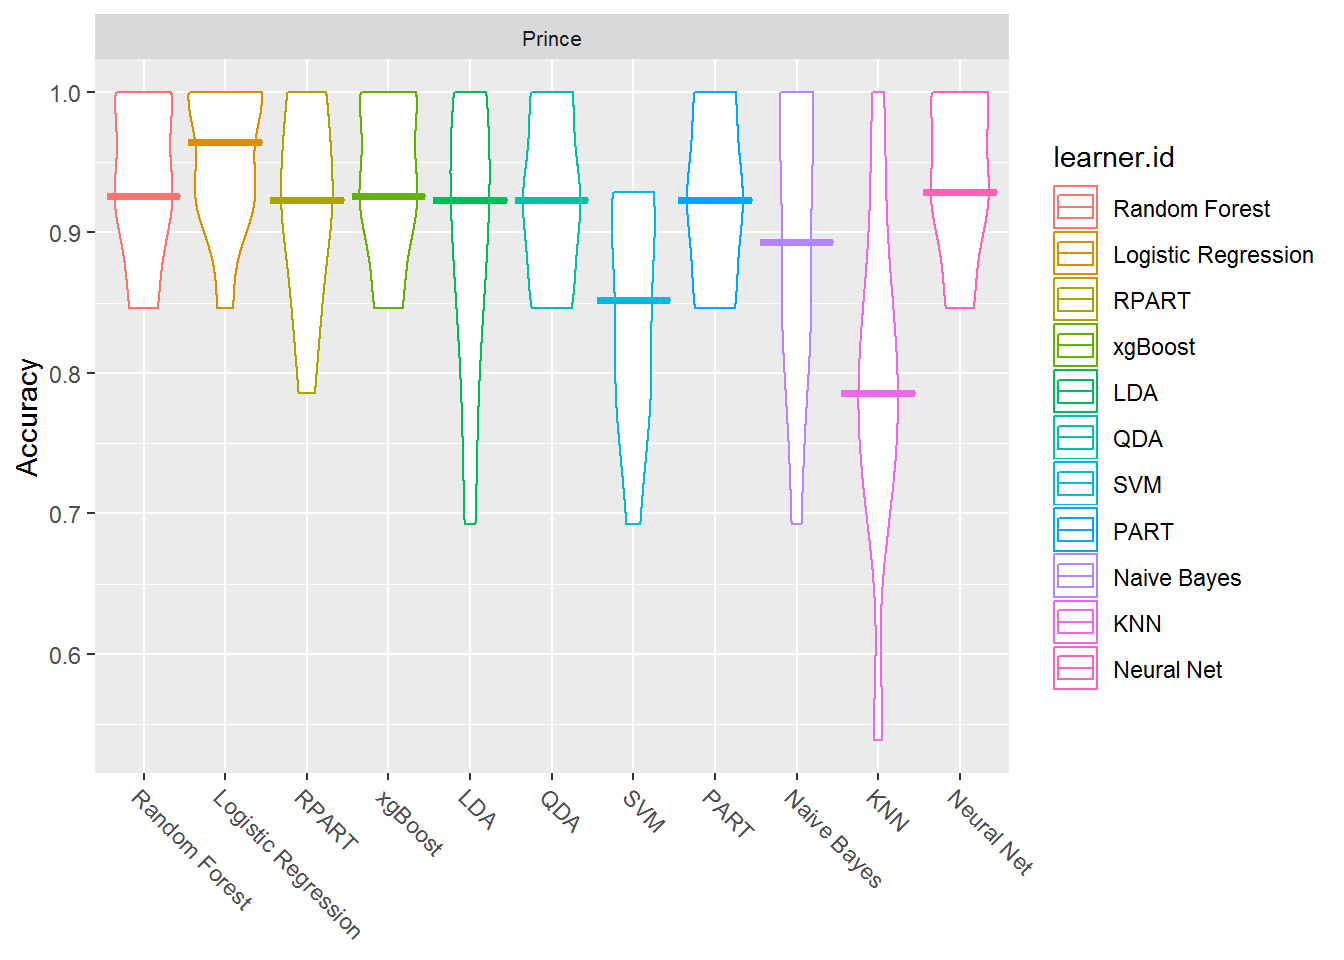
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")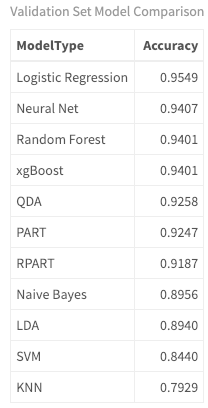
Al predecir éxito en listas, ahora trabajas con dos clases: charted o uncharted. Al clasificar género tenías un problema multiclase (más de dos clases posibles). (Ojo, distinto de un problema multi-label, donde una observación puede tener más de una clase). Como es un problema binario, he añadido un par de algoritmos: QDA y regresión logística, más adecuados para dos clases.
La regresión logística está pensada para resultados binarios y modela la probabilidad de que una observación (canción) pertenezca a una categoría. Usa un umbral que por defecto es .5. Por ejemplo, cualquier probabilidad mayor que .5 se asigna a la clase objetivo; por debajo, a la otra. Este umbral es ajustable. QDA (quadratic discriminant analysis) es más flexible para manejar fronteras de decisión cuadráticas frente a lineales. No es justo soltar términos técnicos sin más, así que te animo a mirar los datos, ver qué algoritmos rinden bien e investigar cada uno por separado. Espero que este análisis te anime a profundizar.
El siguiente paso es ejecutar predicciones y ver las clasificaciones.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")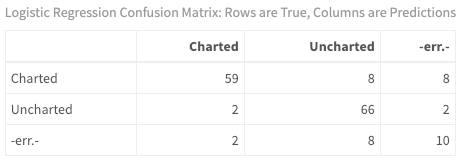
Es muy fácil ver cómo clasifica el modelo cada canción individual. En clasificación binaria hay muchas métricas. Por ahora, mira los falsos positivos, es decir, qué canciones se predijeron como que entrarían en listas cuando en realidad no alcanzaron el Top 100.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")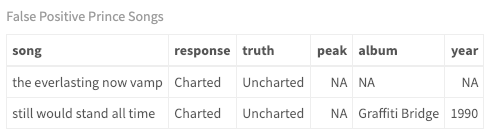
Aunque usaste validación cruzada al entrenar tu modelo, siempre deberías ejecutarlo contra un conjunto de datos aparte (como hiciste con género). Te lo dejo como ejercicio y me encantaría que compartieras tus resultados. Para que sea una prueba realista del poder predictivo del análisis de letras, lo ideal sería usar un artista distinto también de pop-rock como Prince. Otro factor es el periodo: estas canciones entraron mayormente en los 70, 80 y 90, así que un artista de la misma época es clave. O elige tus propios artistas para entrenamiento y prueba y mira qué obtienes.
En este tutorial has creado un modelo para predecir el género de una canción basándote únicamente en sus letras. Has usado algoritmos de clasificación supervisada y entrenado modelos con cinco artistas y cinco géneros. Con el framework mlr creaste tareas, aprendices y estrategias de remuestreo para entrenar y ajustar modelos. Después ejecutaste tu modelo sobre un conjunto de prueba con artistas diferentes. Identificaste qué algoritmos funcionan mejor con parámetros por defecto y, finalmente, predeciste el género de canciones que tu modelo no había visto.
En cuanto al análisis de letras, debería quedar claro que, aunque la industria (y Billboard) definan géneros para cada artista, tu análisis sugiere que, según las letras, las canciones abarcan géneros y rara vez hay relación uno a uno. (Siendo compositora, mi etiqueta de género es «funky, acústico, rockin' soul»). También pudiste usar las mismas técnicas para modelar si una canción entrará en listas a partir de las letras con una accuracy decente en entrenamiento. Tu misión ahora es aplicar lo aprendido a tus propios datasets.
Ha sido un placer acompañarte durante esta serie de tres partes (cuatro tutoriales) sobre análisis de letras. Ojalá ahora aprecies la complejidad de trabajar con este tipo de texto y las sutilezas de las letras frente a otros formatos (p. ej., no ficción). Espero que hayas aprendido nuevas habilidades y que te sientas inspirado para usar tus propios datos y descubrir insights en temas que te interesen. El aprendizaje automático es un campo apasionante y, como científico de datos —novato o con experiencia—, la creatividad, la inspiración y la constancia te harán destacar. Así que recuerda pensar fuera del paralelogramo cuadrilateral y disfruta del aprendizaje.
"I put my foot on the starting line, and took off into a brand new day. I blew a kiss into the wind, closed my eyes and kicked the fear away. - Debbie Liske, New Day"
(Por cierto, he escrito más de 100 canciones propias y ejecuté ese último modelo sobre mi música. ¡Predijo que 35 de mis canciones deberían haber entrado en listas! ¡Ojalá hubiera conocido esta técnica antes! Quizá mi próximo artículo sea sobre cómo usar el análisis de letras para escribir un hit basándome en artistas actuales...)
He mencionado brevemente los temas de abajo y te animo a profundizar en cada uno.
¡Deja tus preguntas en los comentarios!
Aquí tienes los enlaces a los datasets:
Aprende más sobre R y aprendizaje automático
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
Moez Ali
14 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Eugenia Anello
8 min
Tutorial
Zoumana Keita
15 min
Tutorial
Duong Vu
11 min


