Khóa học
Machine Learning với caret trong R
4 giờ
61K
Nếu bạn cần phần giới thiệu về machine learning, hãy học khóa Introduction to Machine Learning của DataCamp và xem hướng dẫn Introduction to Machine Learning in Python.
Sử dụng nhiều thuật toán phân loại machine learning (ML) để xây dựng mô hình theo từng bước nhằm dự đoán thể loại của một bài hát và liệu bài hát đó có thành công trên bảng xếp hạng Billboard hay không — chỉ dựa trên lời bài hát!
Đây là Phần Ba của chuỗi hướng dẫn gồm ba phần, trong đó bạn sẽ tiếp tục sử dụng R để thực hiện nhiều tác vụ phân tích trên nghiên cứu tình huống về lời bài hát của nghệ sĩ huyền thoại Prince, cũng như các nghệ sĩ và tác giả khác. Ba hướng dẫn bao gồm:
Với vai trò Nhà khoa học dữ liệu, bạn cần hiểu cả học có giám sát và không giám sát. Hướng dẫn này giải thích và đưa ra một tình huống sử dụng âm nhạc cho một dạng học có giám sát, cụ thể là phân loại, dựa trên lời bài hát của nhiều nghệ sĩ (và một vài tác giả sách). Bạn sẽ học cách xây dựng mô hình để phân loại bài hát vào thể loại tương ứng và khảo sát khả năng dùng lời bài hát để xác định mức độ thành công thương mại.
Bạn đã từng dùng dịch vụ phát nhạc và gợi ý tự động như Pandora, iHeart Radio, Spotify,… chưa? Nếu bạn tạo một kênh hard rock, có lẽ bạn không mong nghe một bài đồng quê về đôi bốt cao bồi và thị trấn nhỏ. Các hệ thống gợi ý nhạc điển hình tập trung vào đặc tính âm thanh, trong khi phân tích ca từ chỉ mới xuất hiện trong các bài báo nghiên cứu. Với các kỹ thuật trong hướng dẫn này, bạn có thể tận dụng những phương pháp tiên tiến đang được nghiên cứu để nảy ra ý tưởng thúc đẩy lĩnh vực đang nở rộ này.
Hướng dẫn này giả định bạn hiểu cơ bản về khai phá văn bản bằng tidytext. Đây là phần giới thiệu ở mức trung cấp về các kỹ thuật machine learning sử dụng một số thuật toán phân loại phổ biến. Khuyến nghị bạn có kinh nghiệm đáng kể với lập trình R, tốt nhất là có một chút kiến thức về machine learning và muốn học thêm về cách ứng dụng và triển khai qua các tình huống thực hành. Mỗi thuật toán chỉ được giải thích ngắn gọn, nhưng luôn có liên kết để bạn phân tích sâu hơn.
Xuyên suốt bài viết, bạn sẽ dùng một framework cho các thí nghiệm machine learning trong R tên là mlr. Dù hướng dẫn này không tập trung vào mlr, bạn sẽ dùng nó nhiều như một giao diện cho quy trình machine learning. Mục tiêu là dùng nó để đơn giản hóa việc giải thích các bước xây dựng mô hình bằng những thuật toán khác nhau. Tôi rất khuyến khích bài hướng dẫn toàn diện này về gói.
Có rất nhiều thành phần trong ML và bạn chỉ chạm đến bề nổi trong hướng dẫn này. Không giống Phần Một và Hai của loạt bài, phần thuyết minh có thể khiến bạn có nhiều câu hỏi hơn câu trả lời. Bạn sẽ thu được nhiều nhất nếu tự chạy cùng với dữ liệu và mã của mình, và tự nghiên cứu các thuật toán theo tốc độ của bạn.
Dưới đây là phác thảo ở mức cao các bước để xây dựng mô hình:
Phần Một: Học cách dự đoán thể loại dựa trên đặc trưng ca từ.
Bạn nên xem các hướng dẫn trước để thực sự hiểu dữ liệu và các sắc thái của nó. Hãy nhớ rằng khai phá và phân tích dự đoán trên lời bài hát phức tạp hơn nhiều so với phi hư cấu bởi ngữ cảnh, ý nghĩa và thông điệp tinh tế thường ẩn dưới những sắc thái sáng tạo mà nhạc sĩ gợi ý. Tương tự Phần Hai-B về mô hình chủ đề, bạn sẽ tiếp tục làm việc với các nghệ sĩ thuộc những thể loại khác nhau và với nội dung của hai cuốn sách về machine learning (với thể loại khoa học dữ liệu — nhằm giới thiệu một dạng văn bản khác).
Bắt đầu bằng cách nạp các thư viện rồi xem qua cấu trúc tổng thể của dữ liệu.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Giống như các hướng dẫn trước, mã cho biểu đồ vòng tròn dưới đây có thể trông phức tạp, nhưng tôi khó mà cưỡng lại một đồ họa đẹp mắt. Biểu đồ này hiển thị ảnh bìa album/sách cho mỗi nghệ sĩ/tác giả trong dữ liệu. Bao gồm cả tập kiểm tra và huấn luyện. Để biết thêm chi tiết về gói circlize, hãy xem cuốn sách này của Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)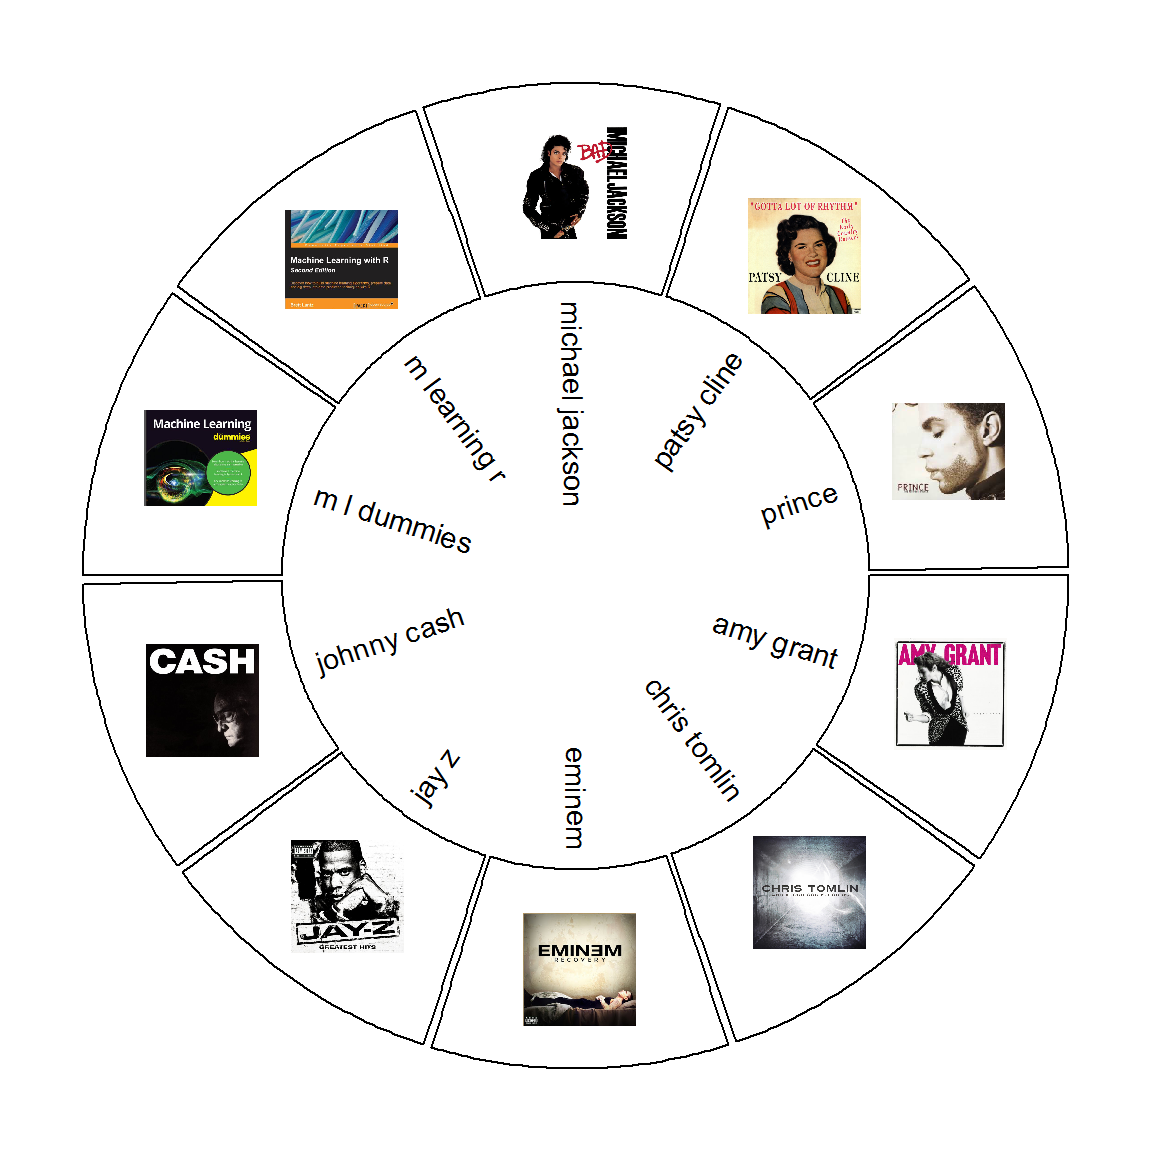
Để tập trung vào mô hình, tôi đã xử lý điều kiện dữ liệu bên ngoài hướng dẫn này và cung cấp cho bạn tất cả dữ liệu cần cho phân tích. Tóm tắt tiền xử lý như sau:
pdf_text() từ gói pdftools để thu thập nội dung của hai cuốn sách (mỗi trang là một tài liệu riêng biệt)Bên dưới bạn sẽ đọc vào dữ liệu huấn luyện và kiểm tra vốn đã được tách sẵn để tải riêng. Sau đó dùng unnest() từ tidytext để tạo phiên bản tidy với mỗi bản ghi là một từ.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Bây giờ bạn đã tải và làm sạch dữ liệu train và test, bạn có thể xem có bao nhiêu bài hát cho mỗi nghệ sĩ/tác giả. Vì tập dữ liệu có cả bài hát và trang sách, tôi sẽ gọi chung chúng là một tài liệu. Các đặc trưng bạn sẽ tạo dựa trên tài liệu và siêu dữ liệu liên quan, nên việc hiểu khái niệm này là quan trọng. Ngoài ra, vì có cả nghệ sĩ và tác giả, tôi sẽ gọi họ là nguồn của mỗi tài liệu.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")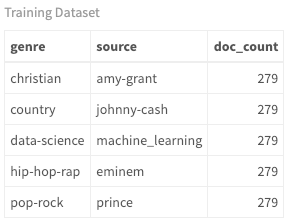
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")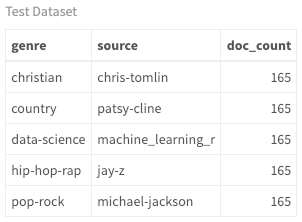
Mặc dù bạn có thể thấy thể loại, nguồn và số lượng tài liệu, sơ đồ chord dưới đây là cách tốt hơn để quan sát các mối quan hệ này. Xuyên suốt hướng dẫn, bạn có thể thấy quá trình các mối quan hệ thay đổi với các mô hình mới. Hiện tại có quan hệ một-một giữa nguồn và thể loại vì các nghệ sĩ được phân loại như vậy; tuy nhiên, nghệ sĩ giao thoa giữa các thể loại rất phổ biến, và bạn sẽ thấy bằng chứng khi xem các phiên bản sau của sơ đồ này.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")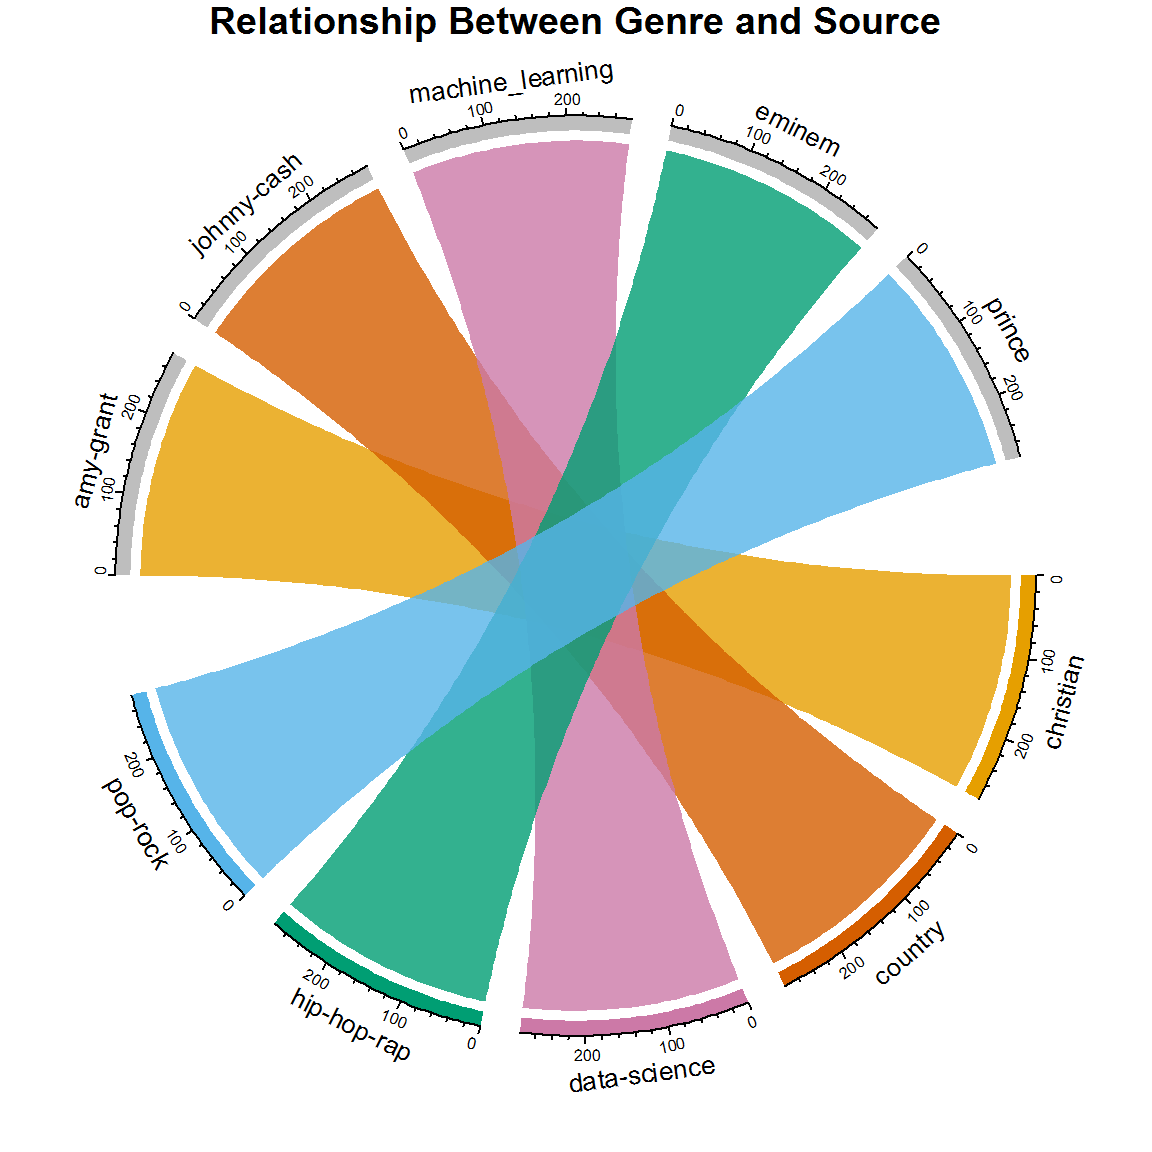
Hãy nghĩ xem sơ đồ này sẽ trông thế nào nếu không có quan hệ một-một. Nếu bạn dự đoán thể loại chỉ dựa trên lời bài hát, bạn nghĩ điều gì sẽ xảy ra?
Nếu tất cả những gì bạn có để phân loại một bài hát là lời bài hát, bạn sẽ tạo biến dự báo thế nào? Trước hết hãy nghĩ về bài hát và điều gì khiến ca từ của bài này khác bài khác. Một chủ đề chung trong âm nhạc là lặp lại. Một số thể loại có dùng lặp lại nhiều hơn không? Còn độ dài từ? Có thể loại dùng từ dài hoặc ngắn thường xuyên hơn không? Bạn nghĩ thêm yếu tố nào để mô tả lời bài hát? Nếu bạn có các số đếm này theo bài, đó chính là bộ biến dự báo đầu tiên!
Lưu ý rằng tất cả biến liệt kê trên là đặc trưng định lượng (số đếm, độ dài, v.v.) dựa trên từ trong mỗi bài. Nhưng còn các từ riêng của từng thể loại thì sao? Ở các hướng dẫn trước, bạn đã làm phân tích cảm xúc và mô hình chủ đề. Những hoạt động này tập trung vào các từ đặc thù cho nghệ sĩ hay thể loại nhất định. Đi xa hơn một bước, bạn có thể tạo ra những thành phần dự đoán quan trọng nhất dựa trên nội dung (hoặc ngữ cảnh). Đây là bước sáng tạo đặc thù của phân tích văn bản và tạo ra các biến dự báo then chốt cho mô hình.
Trước tiên, bạn muốn lấy các từ phổ biến (dùng thường xuyên) nhất theo thể loại. Việc này đã được thực hiện trong hướng dẫn Phần Một. Bắt đầu bằng cách lấy tổng số từ theo thể loại. Sau đó nhóm theo từ trong mỗi thể loại và đếm tần suất. Bây giờ chọn n từ xuất hiện nhiều nhất do biến number_of_words xác định. Đây là phần khó: bạn nên chọn bao nhiêu từ? Nếu chọn không đủ, bạn sẽ không tối ưu mô hình, nhưng nếu chọn quá nhiều, bạn sẽ overfit và làm sai lệch kết quả. Khá phức tạp để mô tả, nhưng giải pháp thực tế là thử và sai. Tôi chọn tổng cộng 5500 là số lượng tối ưu. Hãy thử thay đổi và xem tác động. Bạn có thể tìm ra kết quả tốt hơn! Nếu bước này chưa rõ, cứ tiếp tục, rồi bạn sẽ hiểu hơn.
Nhiều từ rất phổ biến ở hơn một thể loại (như time, life, v.v.) và tôi đã loại những từ này bằng biến multi_genre bên dưới. Điều này giúp danh sách sạch hơn với các từ phân biệt tốt hơn giữa các nguồn.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Bây giờ dùng các từ đặc thù theo thể loại làm đặc trưng trong tập dữ liệu. Vì bạn sẽ tạo đặc trưng cho nhiều tập dữ liệu, hãy tạo một hàm để chỉ viết một lần. Trong hàm này, bạn sẽ thấy tham chiếu đến đa dạng và mật độ từ vựng. Xem Phần Một để giải thích các khái niệm này.
Hãy nghĩ về từng đặc trưng dưới đây và cách nó có thể khác nhau theo thể loại. Thay vì giải thích từng đặc trưng, tôi sẽ tập trung vào các bước machine learning tiếp theo, vậy nên hãy dành chút thời gian xem mã và hiểu chức năng của nó. Và đừng quên những biến dự báo đặc thù theo thể loại quan trọng. Ví dụ, country_word_count đơn thuần là số đếm các từ đồng quê hàng đầu xuất hiện trong mỗi bài. Lưu ý tôi đã gán trọng số lớn hơn cho từ explicit và từ book (xem 10 và 20 trong hàm sum()). Tôi làm vậy vì chúng rất đặc trưng và giúp phân loại tài liệu. Một lần nữa, đây là quá trình thử và sai!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Bây giờ gọi hàm features() cho tập huấn luyện và kiểm tra.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Nếu bạn chưa dùng gói mlr trước đây cũng không sao. Bạn sẽ đi từng bước và thấy quy trình thực ra khá thẳng thắn. Một lần nữa, tôi khuyến khích xem hướng dẫn này vì đây là tài liệu toàn diện nhất về gói. Bạn cũng có thể ghé mlr.org.
mlr (Machine Learning cho R) là một framework bao gồm tất cả các thuật toán machine learning được dùng thường xuyên. Thay vì giải thích lý thuyết phía sau từng thuật toán, tôi sẽ tập trung vào triển khai. Kết thúc hướng dẫn, bạn sẽ sử dụng nhiều công cụ phân loại, và bạn sẽ học tốt nhất nếu thực hành cùng với mã trình bày ở đây.
Sau khi hoàn tất kỹ thuật đặc trưng, quy trình ML đơn giản: tạo task, tạo learner, huấn luyện, kiểm tra. Các bước bạn sẽ thực hiện:
Một task đơn giản là tập dữ liệu mà một learner học. Vì đây là bài toán phân loại, bạn sẽ tạo task phân loại bằng makeClassifTask(). Bạn cần chỉ định biến đầu ra phân loại, genre, bằng cách truyền nó vào tham số target.
Tôi tạo ba task bên dưới, mỗi task có mục đích khác nhau. Test và train thì rõ ràng, còn có một tập chỉ dùng các đặc trưng định lượng cơ bản gồm tóm tắt tài liệu và số đếm. Task này, task_train_subset, được tạo không có các biến đếm từ theo thể loại (tức country_word_count, pop_rock_word_count, v.v.) để minh họa tầm quan trọng của các biến dự báo theo ngữ cảnh này trong mô hình cuối. Vậy dùng tập train[3:13] sẽ loại các biến đó. Ngoài ra, bạn luôn cần loại các cột văn bản khi tạo task phân loại. Ở đây, chúng ở vị trí một và hai trong dataframe.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
                             data = test[-c(1:2)], target = "genre")
Chuẩn hóa dữ liệu là chủ đề cần tìm hiểu thêm, không phải lúc nào cũng cần và phụ thuộc vào tập dữ liệu; tuy nhiên, trong trường hợp này, nó có lợi. Đây đơn giản là phương pháp scale dữ liệu sao cho các giá trị được chuẩn hóa giữa 0 và 1 (hoặc khoảng bạn chỉ định). Nếu một số biến có giá trị lớn hơn nhiều và trên thang đo khác, chúng sẽ làm lệch mô hình bằng cách khiến các biến đó được trọng số cao hơn. Chuẩn hóa giải quyết vấn đề này. Đây là một chuỗi thảo luận hay về chủ đề. Rất đáng tìm hiểu sâu vì đây là bước tiền xử lý quan trọng. mlr cung cấp hàm normalizeFeatures() đơn giản cho bước này.
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Một learner trong mlr được tạo bằng cách gọi makeLearner(). Trong hàm khởi tạo, bạn cần chỉ định phương pháp học muốn dùng. Bạn có thể lấy danh sách các thuật toán phân loại khả dụng bằng cách gọi listLearners("classif")[c("class","package")]. Lệnh này cho thấy các thuật toán có thể chọn và các gói phụ thuộc (bạn có thể cần cài riêng).
Trong bài tập này, tôi chọn danh sách có thể xử lý nhiều hơn hai lớp và mang đến nhiều kỹ thuật, từ cây quyết định đến rừng ngẫu nhiên, SVM, gradient boosting và mạng nơ-ron. Có rất nhiều learners để chọn ( hiện tại có hơn 80 learner phân loại trong mlr), và tôi khuyến khích bạn thử nghiệm!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)
Lấy mẫu lại là công cụ thiết yếu trong machine learning và xứng đáng có riêng một hướng dẫn. Tạm thời, hiểu cơ bản có thể giúp bạn qua bước này. Nó bao gồm việc lặp lại rút mẫu từ tập huấn luyện và fit lại mô hình trên mỗi mẫu. Điều này có thể giúp bạn thu được thông tin không có nếu chỉ fit mô hình một lần với dữ liệu huấn luyện gốc.
Có vài phương pháp lấy mẫu lại, nhưng ở đây bạn sẽ dùng k-fold cross validation, thể hiện bởi "CV" trong lời gọi makeResampleDesc() trả về đối tượng mô tả lấy mẫu lại (rdesc). Cách tiếp cận này chia ngẫu nhiên tập dữ liệu thành k nhóm (fold) có kích thước bằng nhau. Fold đầu tiên dùng làm tập validation, các fold còn lại dùng để huấn luyện. Quá trình lặp k lần cho mỗi fold. Tỷ lệ lỗi được ghi lại cho mỗi lần và lấy trung bình cuối cùng.
Nếu đây là lần đầu bạn gặp lấy mẫu lại, nghe có thể khó hiểu, nhưng đây là bước đầu tiên thiết yếu để làm quen! Bạn sẽ dùng cross-validation 10-fold trong ví dụ dưới đây. "Đối với phân loại, thường mong muốn có cùng tỷ lệ các lớp trong mỗi fold." (Nguồn) Dùng stratify = TRUE để đảm bảo điều này.
Để biết thêm về lấy mẫu lại trong mlr, xem bài viết này.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)Mục tiêu điển hình của phân loại là đạt độ chính xác dự đoán cao và giảm thiểu số lỗi. Theo nghĩa này, mọi loại lỗi phân loại sai được xem là có trọng số như nhau. Tuy nhiên, trong nhiều ứng dụng, các loại lỗi khác nhau có mức độ ảnh hưởng khác nhau. Ví dụ, nếu phân loại bệnh nhân có bệnh hay không, việc phân loại sai không phát hiện bệnh khi thực sự có thể đe dọa tính mạng. Các thước đo hiệu năng khác nhau giải quyết những sắc thái này. Tuy nhiên, với phân tích ca từ, bạn chủ yếu xem các thước đo cơ bản về độ chính xác và lỗi. Hãy nhớ rằng độ chính xác và tỷ lệ lỗi không phải lúc nào cũng là lựa chọn tốt nhất để đánh giá độ vững của mô hình. Đây là chủ đề quan trọng cũng cần bàn thêm ngoài hướng dẫn này.
Độ chính xác là số dự đoán đúng trên tổng số dự đoán. Để xem các phân loại sai của mô hình, bạn cũng sẽ xem ma trận nhầm lẫn để thấy cách các mục được phân loại (dự đoán vs. thực tế). Chút nữa sẽ nói tiếp. Hiện tại, chỉ cần thiết lập danh sách thước đo quan tâm. Tôi thêm ba thước đo ở đây, nhưng bạn sẽ chỉ xem acc. Liên kết này cung cấp thêm thông tin và giải thích về thước đo hiệu năng.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)Trong mlr, bạn có thể thực hiện thí nghiệm benchmark trong đó các thuật toán khác nhau (phương pháp học) được áp dụng cho tập dữ liệu của bạn. Điều này cho phép so sánh thuật toán theo các thước đo cụ thể (ví dụ: độ chính xác). Bạn sẽ chạy benchmark() để huấn luyện mô hình và tạo đối tượng BenchmarkResult từ đó có thể truy cập mô hình và kết quả.
Cuối cùng cũng đến lúc xây dựng mô hình. Bắt đầu với task bạn tạo mà không bao gồm số đếm từ đặc thù theo thể loại. Truyền vào benchmark danh sách learners, task subset, chiến lược lấy mẫu lại (rdesc) và danh sách thước đo muốn xem.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252Nếu bạn xem đối tượng BenchmarkResult, bạn có thể thấy acc.test.mean cho từng thuật toán đã truyền vào. Lưu ý điều này đề cập cụ thể đến test. Đây là độ chính xác trung bình trên tất cả các mẫu cho tập validation dùng trong cross-validation khi bạn huấn luyện mô hình. Điều này không giống tập dữ liệu kiểm tra mà bạn sẽ dùng sau. Đây lại là một chủ đề cần nhiều giải thích, nhưng hãy nhớ có một loạt tập validation được giữ lại trong cross-validation, và một tập test bạn sẽ dùng sau khi quyết định thuật toán và tinh chỉnh mô hình.
Trong thí nghiệm benchmark này, bạn có thể thấy Random Forest hoạt động tốt nhất ở mức r rf_perf phần trăm (và mất lâu nhất để huấn luyện). Ghi nhớ giá trị đó, chạy lại thí nghiệm trên bộ đặc trưng đầy đủ.
Lần này truyền task bao gồm số đếm từ theo thể loại cho mỗi tài liệu. Điều này thêm các đặc trưng cho biết một bài hát có nhiều từ đồng quê, hay pop-rock, v.v. Hãy nhớ, dùng tập dữ liệu đã gắn nhãn, bạn chọn các từ hip-hop phổ biến nhất và đưa vào danh sách hip_hop_words. Danh sách này có các từ như thug, crib, và drug. Danh sách từ đồng quê có những từ như lonesome, coal, drunken, và cattle. Bạn hiểu ý rồi đấy.
mlr cung cấp vài phương pháp truy cập kết quả benchmark. Tôi chỉ dùng một vài cách, nhưng để quen với đối tượng benchmark, tôi khuyến nghị dùng các hàm getBMR*. Nếu bạn gọi str() trên đối tượng benchMark, bạn sẽ phải đợi khá lâu để có chi tiết!
Trước khi xem chi tiết bộ đặc trưng đầy đủ, hãy benchmark nhiều task và so sánh bộ đặc trưng đầy đủ với tập con ở trên bằng hàm plotBMRSummary(). Làm điều này bằng cách tạo danh sách các task để truyền vào benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)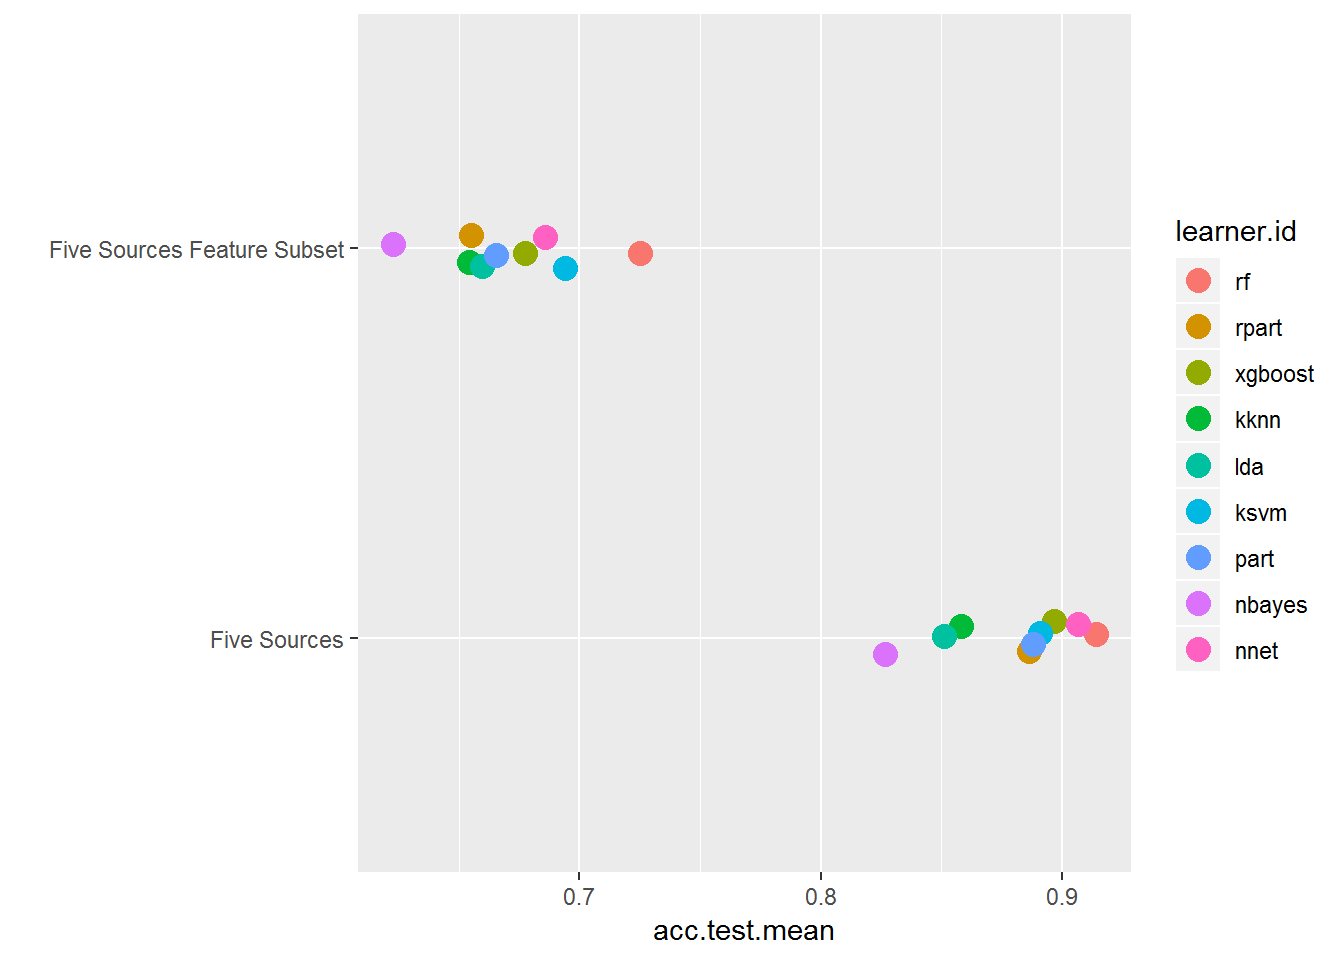
Ở đây bạn có thể thấy acc.test.mean của tập con huấn luyện không có số đếm từ theo thể loại trên mỗi tài liệu thấp hơn bộ đặc trưng đầy đủ. Điều này cho thấy các đặc trưng này tạo khác biệt lớn! Thực hiện bước sáng tạo nhỏ này là điều bạn chỉ thấy trong machine learning dùng văn bản. Hãy ghi nhớ nó cho các dự án của riêng bạn.
Mặc dù bạn có thể chỉ truy cập kết quả huấn luyện từ bmr_multi_task, hãy benchmark lại chỉ với task huấn luyện và sau đó xem kỹ kết quả bằng getBMRAggrPerformances() và plotBMRBoxplots().
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)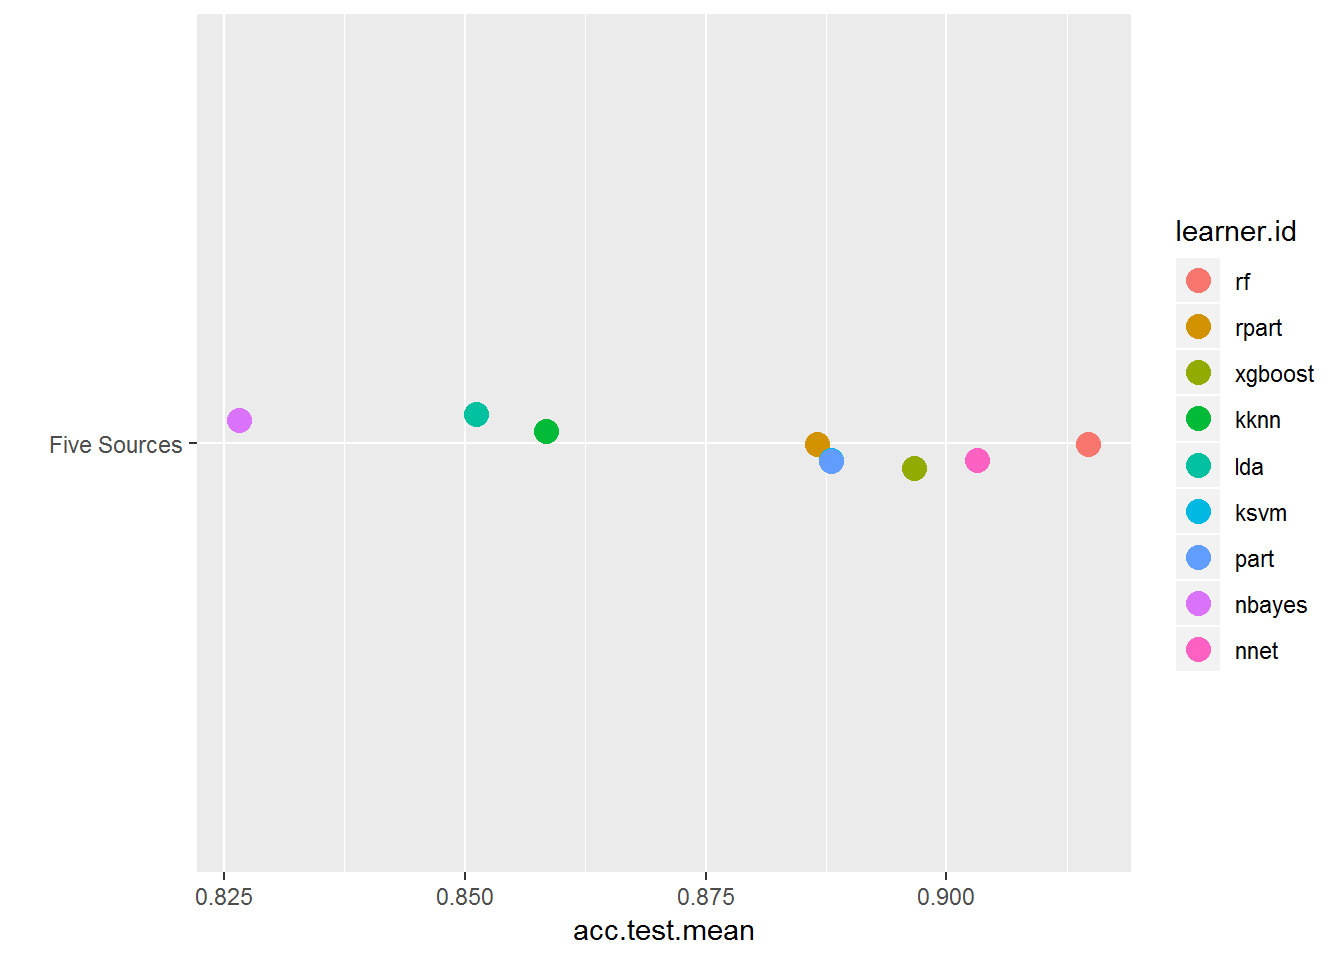
Điều này cho phép bạn phóng to vào kết quả của bộ dữ liệu đầy đủ đặc trưng. Bây giờ bạn thấy rõ hơn sự chênh lệch giữa các thuật toán và cách random forest vượt trội hơn.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))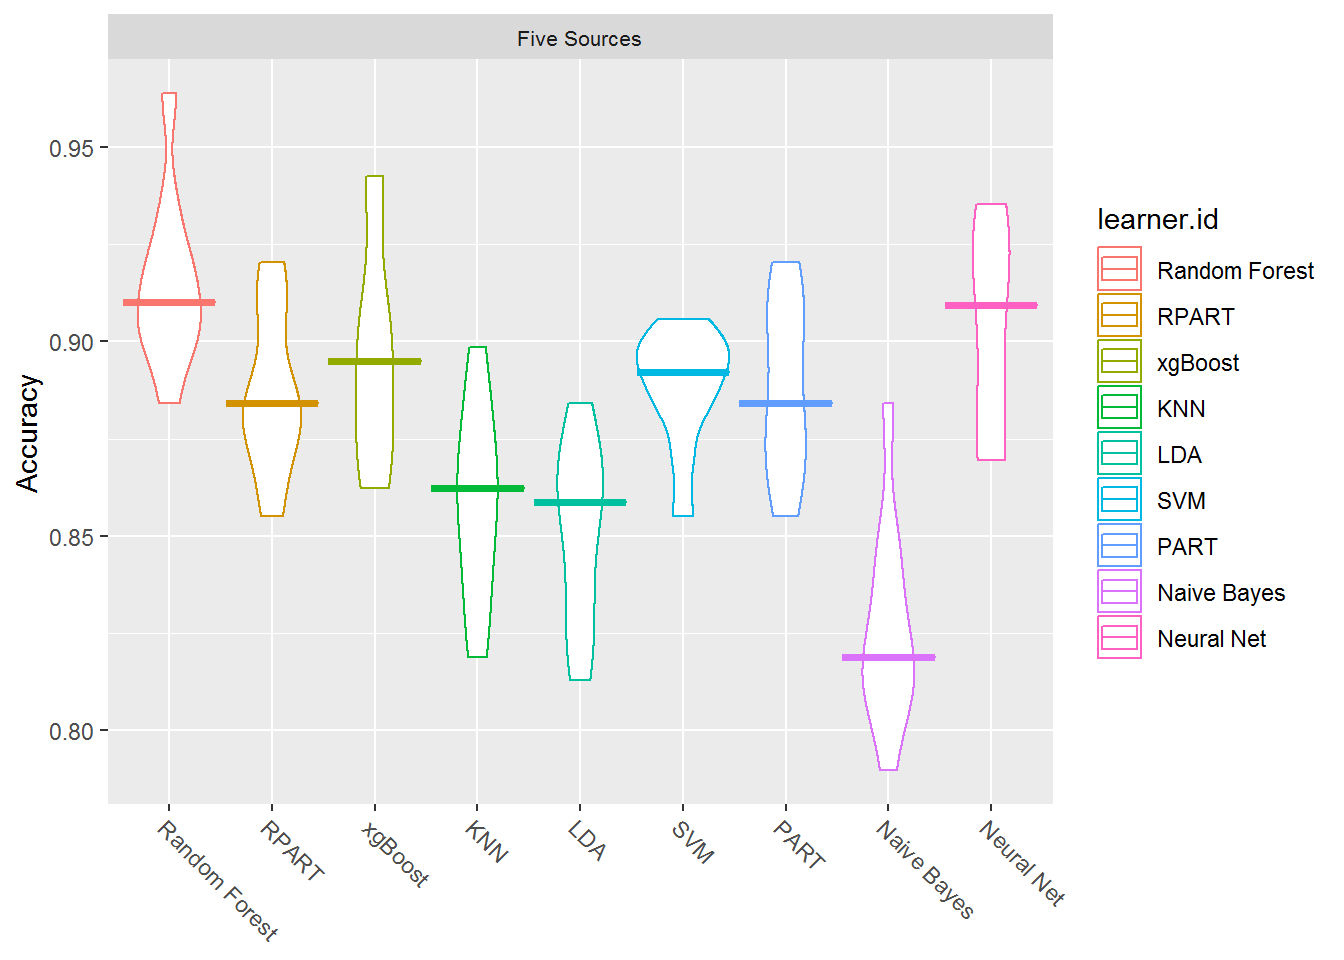
Các biểu đồ hộp này cho bạn kết quả cho mỗi phương pháp qua nhiều lần lặp thực hiện bởi benchmark.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")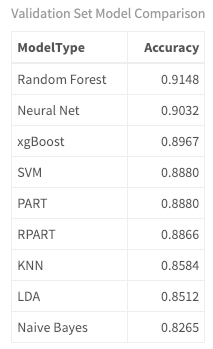
Ở đây bạn có thể thấy độ chính xác cao nhất thuộc về Random Forest, Neural Net và xgBoost với độ chính xác lần lượt là r first_three phần trăm. Vậy thực sự đã xảy ra điều gì với mô hình? Các tài liệu/bài hát được phân loại thế nào? Những thể loại nào khó phân loại dựa trên ca từ? Để hiểu rõ hơn, hãy xem ma trận nhầm lẫn của các dự đoán. Trong ma trận này, số tài liệu được phân loại đúng nằm trên đường chéo. Tài liệu phân loại sai nằm ngoài đường chéo. Số quan sát lỗi ở biên. Cột là giá trị dự đoán, hàng là giá trị thực. Dùng getBMRPredictions() để truy cập dự đoán trên tập huấn luyện/validation. Sau đó xem result của ma trận nhầm lẫn của mô hình Random Forest mà bạn có thể truy cập bằng id Five Sources bạn đặt trước đó cho task huấn luyện. (Lưu ý bạn có thể làm điều này với bất kỳ mô hình nào trong kết quả benchmark.)
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")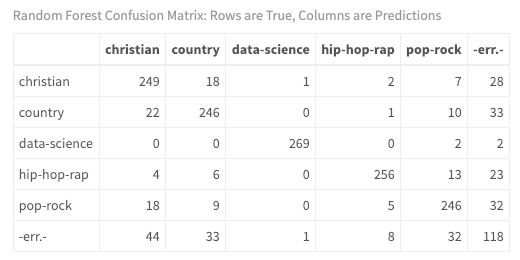
Cuối cùng bạn có một số hiểu biết về mô hình! Như bạn có thể mong đợi, với chỉ một phân loại sai, khá dễ để phân biệt tài liệu khoa học dữ liệu với lời bài hát dùng các đặc trưng siêu dữ liệu văn bản mà bạn đã kỹ thuật hóa. Ngoài ra, hip-hop-rap rất khác biệt với các thể loại âm nhạc khác với chỉ tám phân loại sai. Tuy nhiên, dù hiệu năng khá ấn tượng, ít có sự khác biệt rõ ràng giữa lời bài hát đồng quê, Thiên Chúa giáo và pop-rock.
Mục đích của hướng dẫn này không chỉ là tiếp cận các kỹ thuật machine learning dự đoán mà còn thực hiện phân tích ca từ tiếp nối các hướng dẫn trước trong loạt bài. Vậy hãy nghĩ xem các kết quả này có ý nghĩa gì. Nếu bạn phát triển một hệ thống gợi ý được bổ trợ bằng phân tích ca từ, bạn cần cân nhắc gì? Có khả năng hệ thống của bạn gợi ý một nghệ sĩ hip hop có ca từ nhạy cảm cho người nghe nhạc Thiên Chúa giáo hay fan nhạc đồng quê không?
Nhớ sơ đồ chord ở đầu hướng dẫn chứ? Xem lại nó, lần này với dự đoán thay vì nhãn thực.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")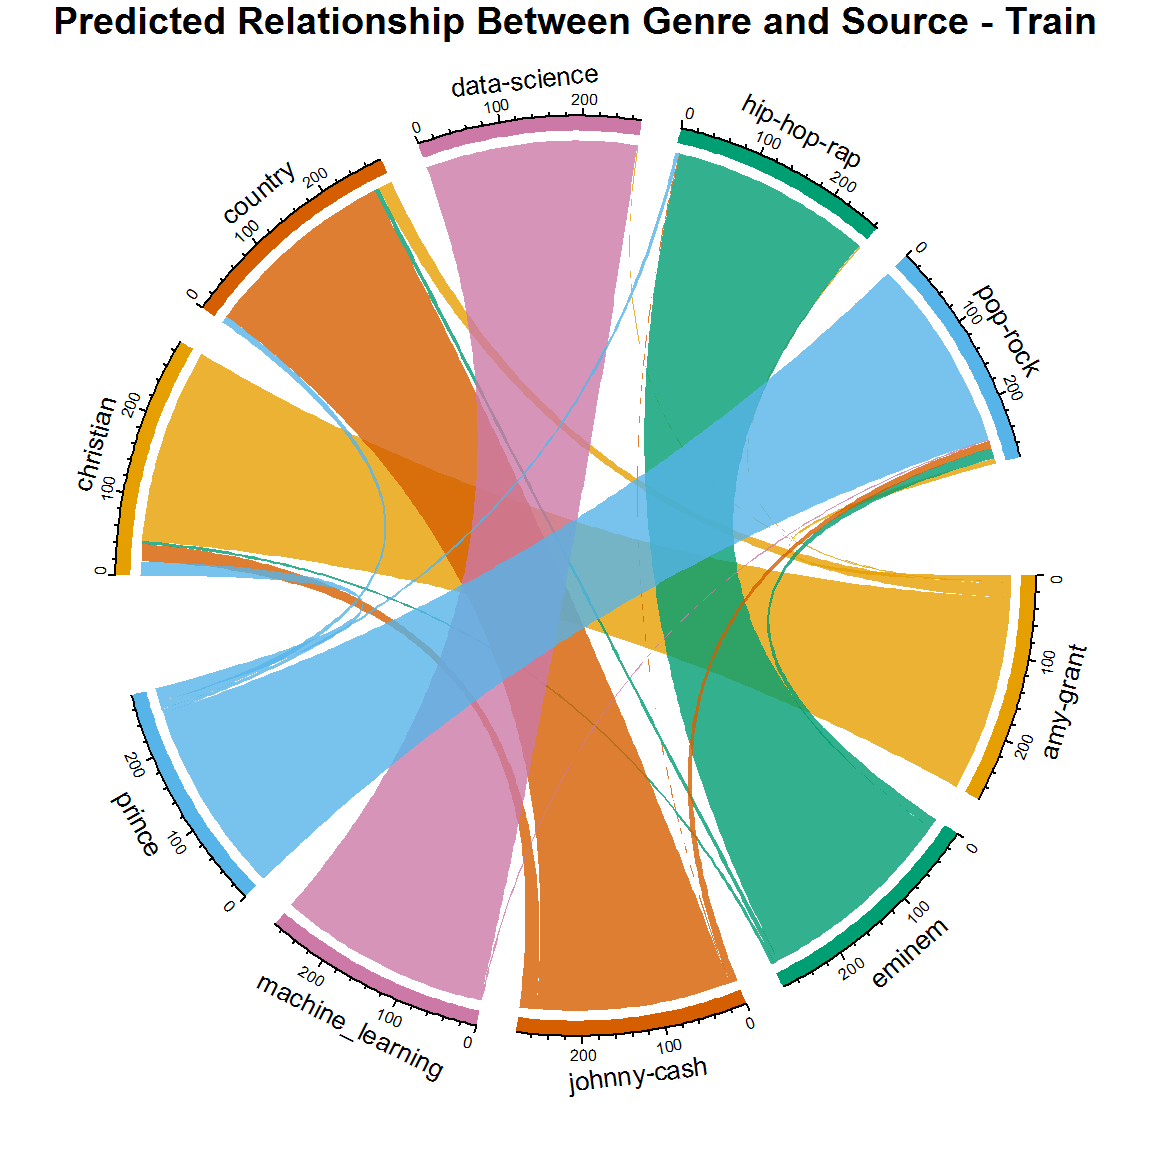
Khá thú vị. Bây giờ bạn có thể thấy mức độ hiệu quả trên dữ liệu huấn luyện. Một lần nữa kết quả rất ấn tượng. Các đường nhỏ hơn thể hiện phân loại sai. Nhưng đây có lẽ là khái niệm quan trọng nhất bạn rút ra: dù đây là kết quả độ chính xác của tập validation, nó vẫn dựa trên tập dữ liệu huấn luyện đã gắn nhãn! Nếu không cẩn thận, bạn có thể overfit mô hình và tạo ra phương sai cao. Phương sai cao nghĩa là thuật toán học thay đổi nhiều tùy dữ liệu đưa vào. Điều này có thể khiến thuật toán không vững trước nhiễu được đưa vào với dữ liệu mới mà nó chưa từng thấy. Bạn sẽ chạy một bài kiểm tra thực sự trong chốc lát khi nạp dữ liệu hoàn toàn mới.
Trước khi kiểm tra dữ liệu mới, bạn sẽ muốn chọn một trong các mô hình và tinh chỉnh nó. Bạn sẽ làm điều này bằng cách điều chỉnh siêu tham số. Đây chỉ là cách nói hoa mỹ để chỉ cấu hình các tham số của mô hình nhằm cải thiện hiệu năng. Nếu bạn ghé Kaggle gần đây, bạn sẽ thấy một thuật toán thời thượng gọi là extreme gradient boosting đang thống trị các cuộc thi. Dù nó không phải mô hình đứng đầu trong benchmark của chúng ta, tôi vẫn chọn nó để tinh chỉnh và chạy trên tập test. Nếu bạn mới với kiểu thuật toán này, việc tinh chỉnh có lẽ là phần khó. Trong phạm vi hướng dẫn này, tôi không thể đi sâu vào khái niệm về gradient boosting hay thậm chí siêu tham số, nhưng đoạn mã dưới đây sẽ cho bạn điểm khởi đầu. Tôi rất khuyến khích xem lại khái niệm gradient boosting trước khi đi quá sâu vào tinh chỉnh. Liên kết này là bài viết tuyệt vời của Prince Grover để bắt đầu. Như anh mô tả, tóm tắt chung của gradient boosting cổ điển là:
Đầu tiên mô hình hóa dữ liệu bằng các mô hình đơn giản và phân tích các lỗi. Những lỗi này biểu thị các điểm dữ liệu khó fit bằng mô hình đơn giản. Sau đó với các mô hình về sau, đặc biệt tập trung vào các điểm khó đó để dự đoán đúng. Cuối cùng, kết hợp tất cả bộ dự báo bằng cách gán trọng số cho từng bộ dự báo.
(Lưu ý: giá trị maxit là 150 trong makeTuneControlRandom() bên dưới mất khá nhiều thời gian để chạy. Bạn có thể bắt đầu với giá trị nhỏ hơn nhiều.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Bạn có thể xem các tham số tối ưu bằng cách xem đầu ra của tuneParams(). Giờ bạn muốn tạo mô hình mới dùng các siêu tham số đã tinh chỉnh rồi huấn luyện lại trên tập huấn luyện.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))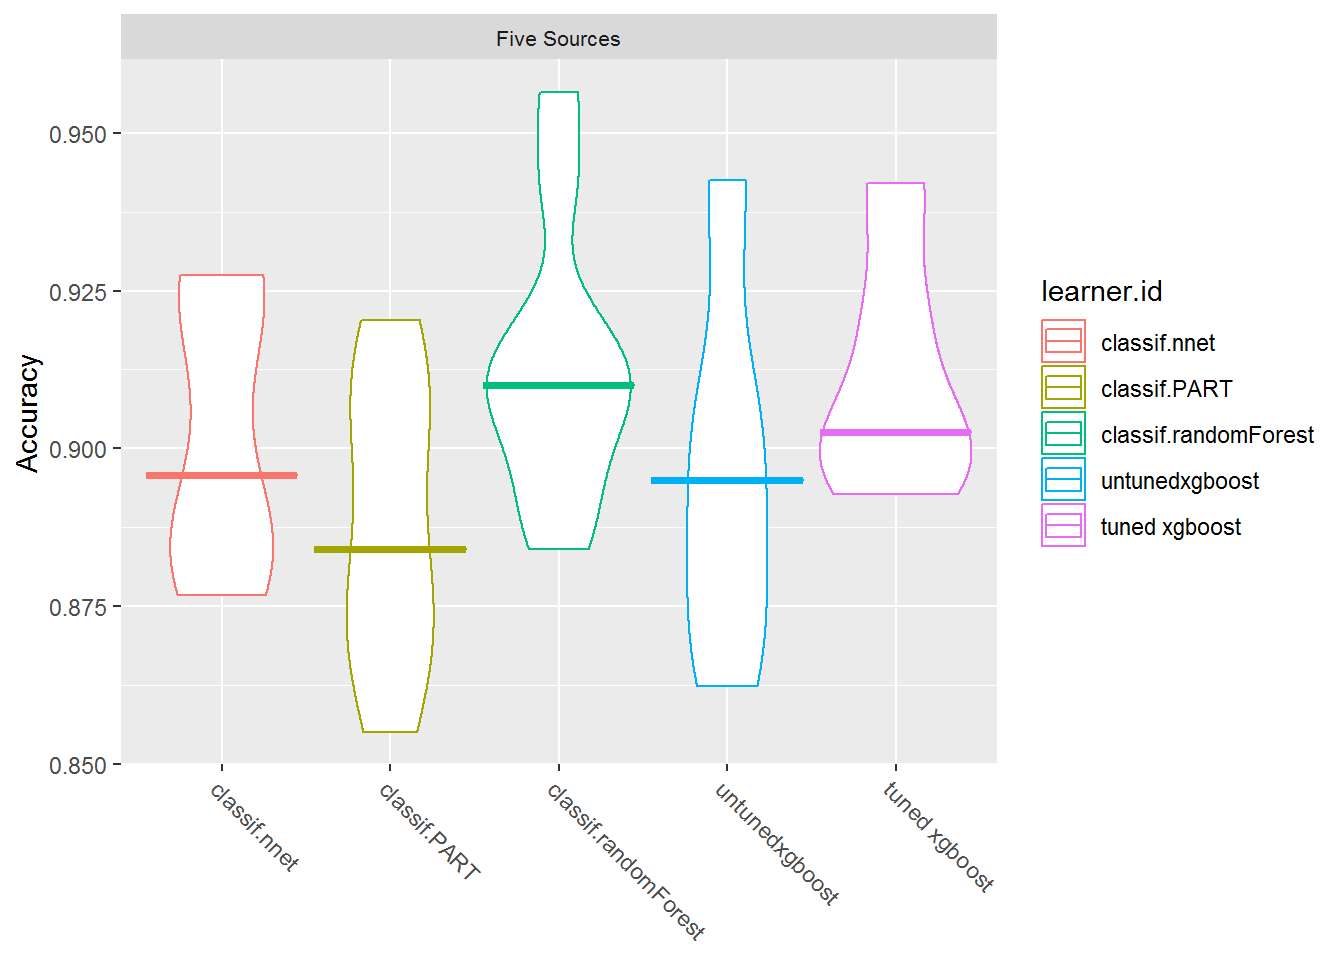
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")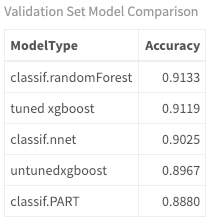
Mô hình xgBoost đã tinh chỉnh chỉ nhỉnh hơn chút so với bản chưa tinh chỉnh và vẫn chưa chính xác bằng random forest. Nhưng chúng thể hiện thế nào trên dữ liệu test?
Bây giờ khi đã có mô hình tinh chỉnh và benchmark, bạn có thể gọi predict() cho ba mô hình hàng đầu trên tập test chưa từng thấy trước đây. Tập này bao gồm năm nguồn hoàn toàn khác như đã hiển thị trước đó. Hãy xem hiệu năng và phân loại thực tế.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Đây là các kết quả khá thú vị. Dù random forest có độ chính xác cao hơn trên dữ liệu huấn luyện so với xgBoost đã tinh chỉnh, nó lại hơi kém chính xác hơn trên tập test. Độ chính xác test của neural net cũng thấp hơn nhiều so với huấn luyện. Neural net có thể là mô hình rất linh hoạt và do đó có thể overfit tập huấn luyện.
Với độ chính xác r round(test_perf,2)*100% cho xgBoost đã tinh chỉnh, hiệu năng trên dữ liệu test vẫn giảm đáng kể so với huấn luyện và tinh chỉnh chỉ mang lại cải thiện nhẹ (với cấu hình tối thiểu này!). Sự sụt giảm độ chính xác giữa train và test là điều phổ biến và chính là lý do bạn nên kiểm tra mô hình trên dữ liệu mới.
Bây giờ, xem các phân loại thực tế.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")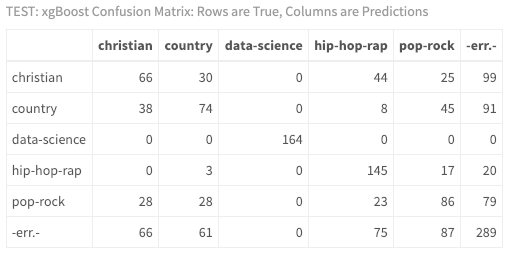
Khi xem ma trận nhầm lẫn, bạn có thể thấy rất khó để phân loại nghệ sĩ hip hop này, Jay-Z. Không sao nếu bạn không rành nhạc, kết quả cho thấy có thể có sự khác biệt giữa nghệ sĩ dùng để huấn luyện mô hình Eminem và Jay-Z dùng trong dữ liệu test. Lý tưởng là bạn có nhiều dữ liệu hơn, nhiều nghệ sĩ hơn, nhiều tinh chỉnh hơn, và bạn sẽ chạy mô hình nhiều lần!!
Tuy nhiên, hãy nghĩ xem điều này nói gì. Xem lại sơ đồ chord một lần nữa:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")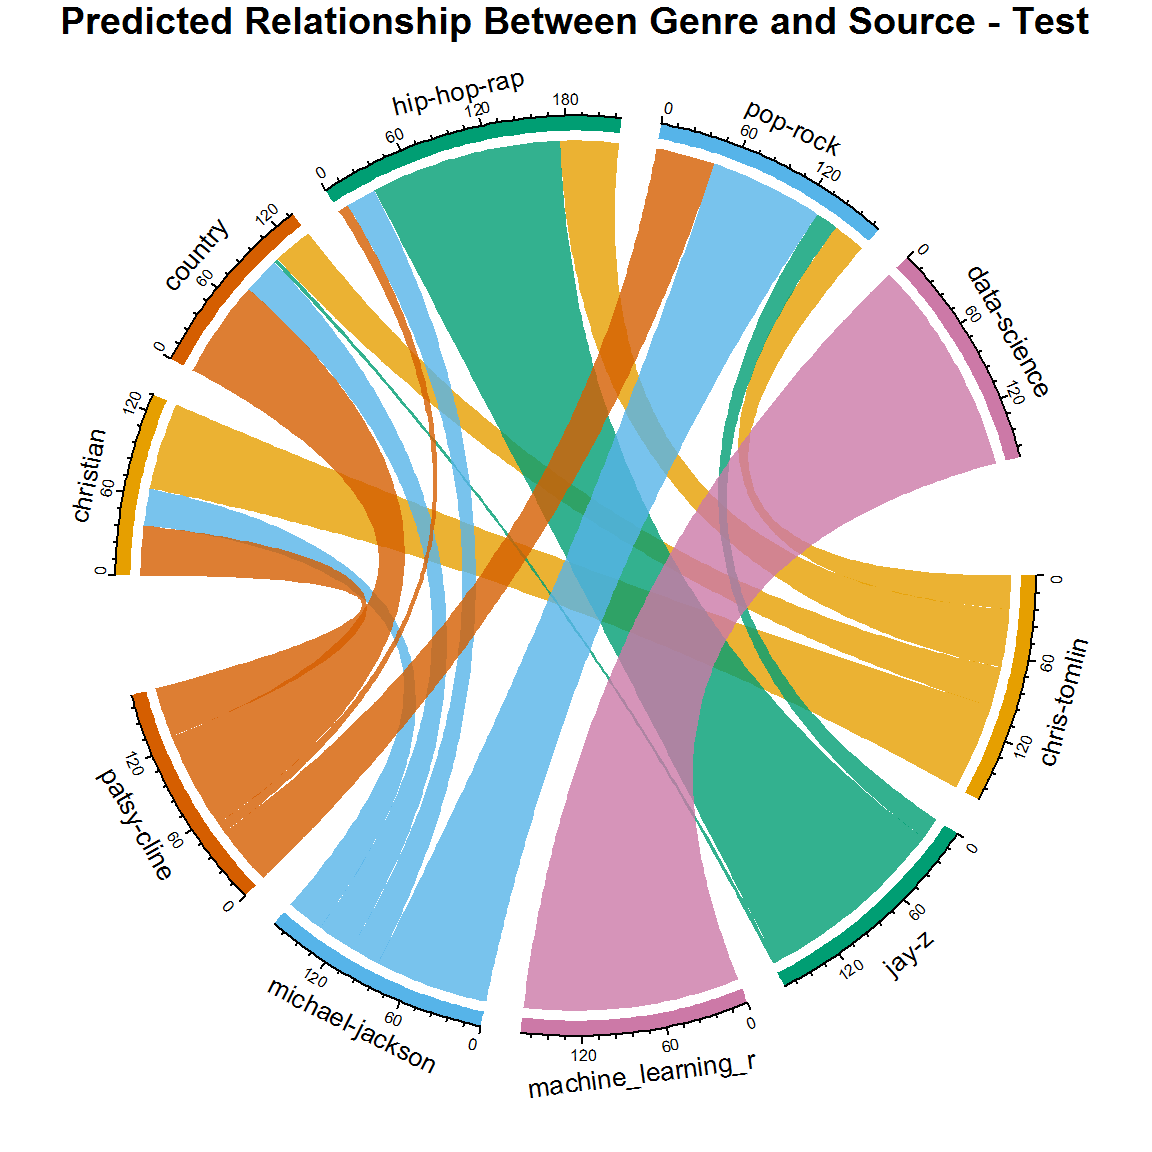
Nó có sai không? Nó không chính xác? Hay nó đem lại hiểu biết? Tôi nghĩ bạn đang có một cái nhìn thực tế về thế giới âm nhạc. Nghĩ mà xem: Michael Jackson từng hợp tác với nghệ sĩ rap chưa? Anh ấy từng hát về chủ đề tôn giáo không? Các nghệ sĩ đồng quê đã từng chuyển sang pop-rock chưa? Sơ đồ chord mới của bạn thực sự đưa ra phiên bản thực tế hơn của phân loại theo ca từ so với tập dữ liệu gốc! Trên thực tế, không có quan hệ một-một giữa nghệ sĩ và thể loại trong đời sống, và sự linh hoạt đó đã được tích hợp vào mô hình của bạn.
Ở phần tiếp theo, bạn sẽ xem một ý tưởng có thể áp dụng trong marketing, bán hàng, khoa học, kinh tế, v.v., nhưng ở đây bạn sẽ áp dụng cho âm nhạc. Thành công của một bài hát rất chủ quan. Khái niệm thành công thương mại rõ ràng hơn vì có thể được định nghĩa bởi các tiêu chuẩn ngành. Billboard Charts (và nhiều bảng khác) là ví dụ về thước đo thành công. Nếu bạn làm cho một hãng thu âm và đang cố quyết định nên ký hợp đồng với nghệ sĩ nào — hoặc quảng bá nghệ sĩ nào đã ký, chẳng phải sẽ thú vị nếu bạn có thể dự đoán liệu họ sẽ vào bảng xếp hạng chỉ dựa trên ca từ bằng các phương pháp khoa học? Bạn sẽ cần rất nhiều dữ liệu hiện hành và nhiều siêu dữ liệu mô tả mỗi bài. Vì nguồn lực ở đây hạn chế, hãy dùng những gì bạn có và thử ý tưởng này trên lời bài hát của Prince với dữ liệu chart đã gắn nhãn.
Ở các hướng dẫn trước, bạn đã tạo tập dữ liệu các bài hát của Prince trong đó phần lớn không vào bảng xếp hạng. Bạn sẽ dùng một tập lời bài hát cân bằng với số lượng bài vào bảng và không vào bảng bằng nhau. Dưới đây là các con số:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")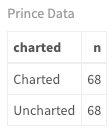
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Dùng cùng quy trình như trên, tạo đặc trưng bằng hai bước. Lần này thay vì đếm từ theo thể loại trong một bài, bạn sẽ đếm từ theo mức xếp hạng. Nói cách khác, lấy các từ xuất hiện thường xuyên nhất cho các bài vào bảng và các từ xuất hiện thường xuyên nhất cho các bài không vào bảng và lưu vào danh sách. Tôi chọn 1000 từ và có vẻ cho phản hồi tốt nhất với con số đó. Hãy thử các giá trị của riêng bạn. Sau đó khi tạo đặc trưng bài hát, hãy thêm hai đặc trưng đếm số từ trong mỗi danh sách theo bài (cùng quy trình như với thể loại ở trên).
Lưu ý một lần nữa tôi đã loại tất cả các từ xuất hiện ở cả hai nhóm bài vào và không vào bảng. Tôi cũng thêm một vài đặc trưng đa thức khi bình phương các đầu vào gốc. Ý tưởng cải thiện mô hình không phải bằng cách tinh chỉnh thuật toán, mà bằng cách biến đổi đầu vào, là nguyên lý cơ bản trong các phương pháp machine learning.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Thực hiện các bước tương tự như trên bằng cách tạo task phân loại cho tập dữ liệu của Prince với mục tiêu là trường charted. Chuẩn hóa dữ liệu, thiết lập cross-validation và tạo danh sách learners. Tôi đã thêm vài thuật toán khác ở đây vì bạn sẽ làm phân loại nhị phân thay vì đa lớp như trước.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
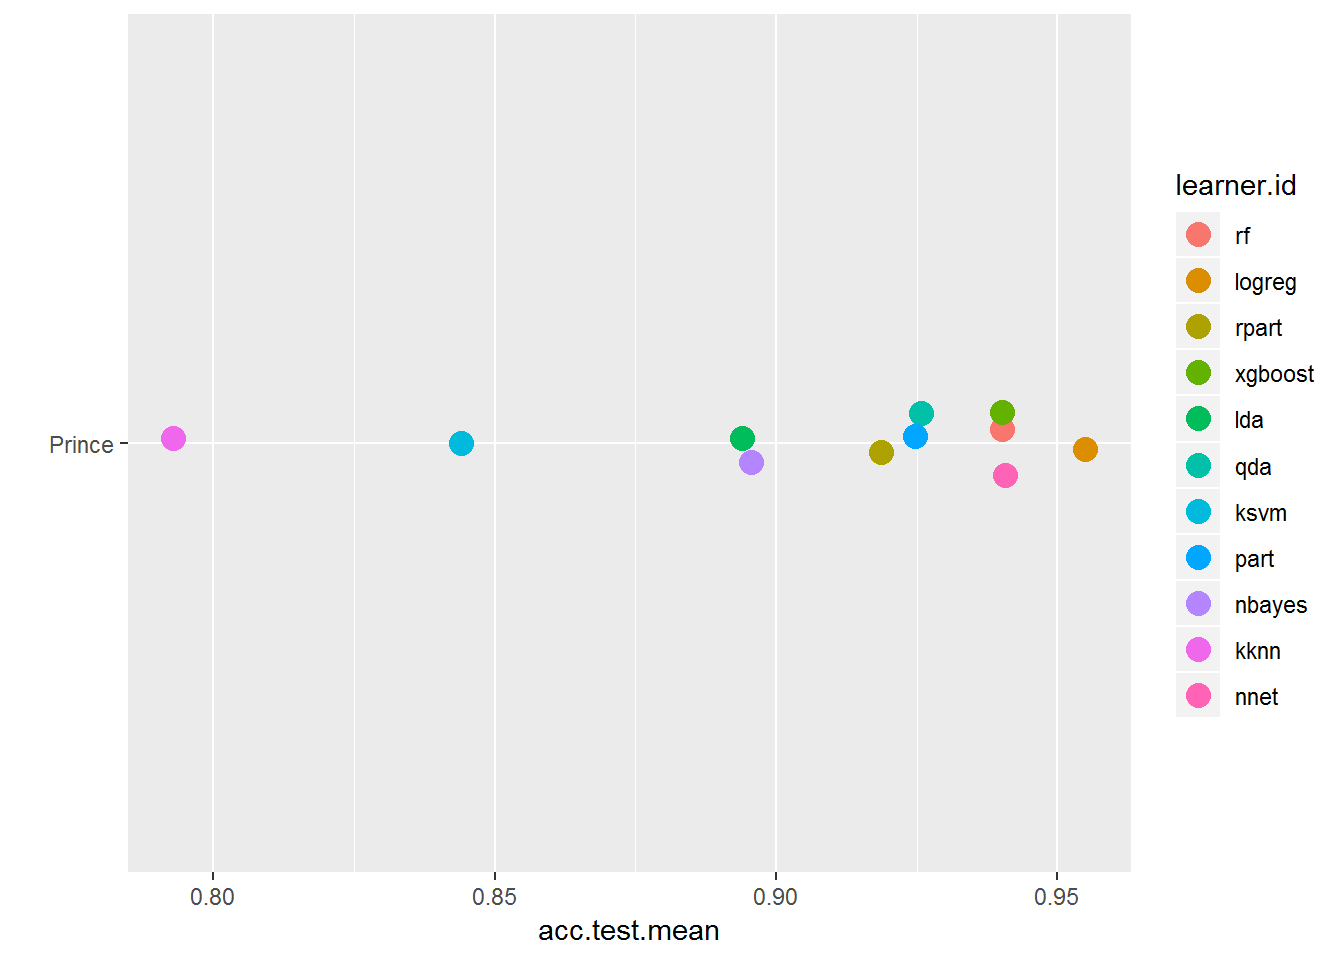
Sau khi tạo benchmark, hãy xem kết quả ở nhiều dạng. Lưu ý sự khác biệt về hiệu năng của các learners so với phía trên.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))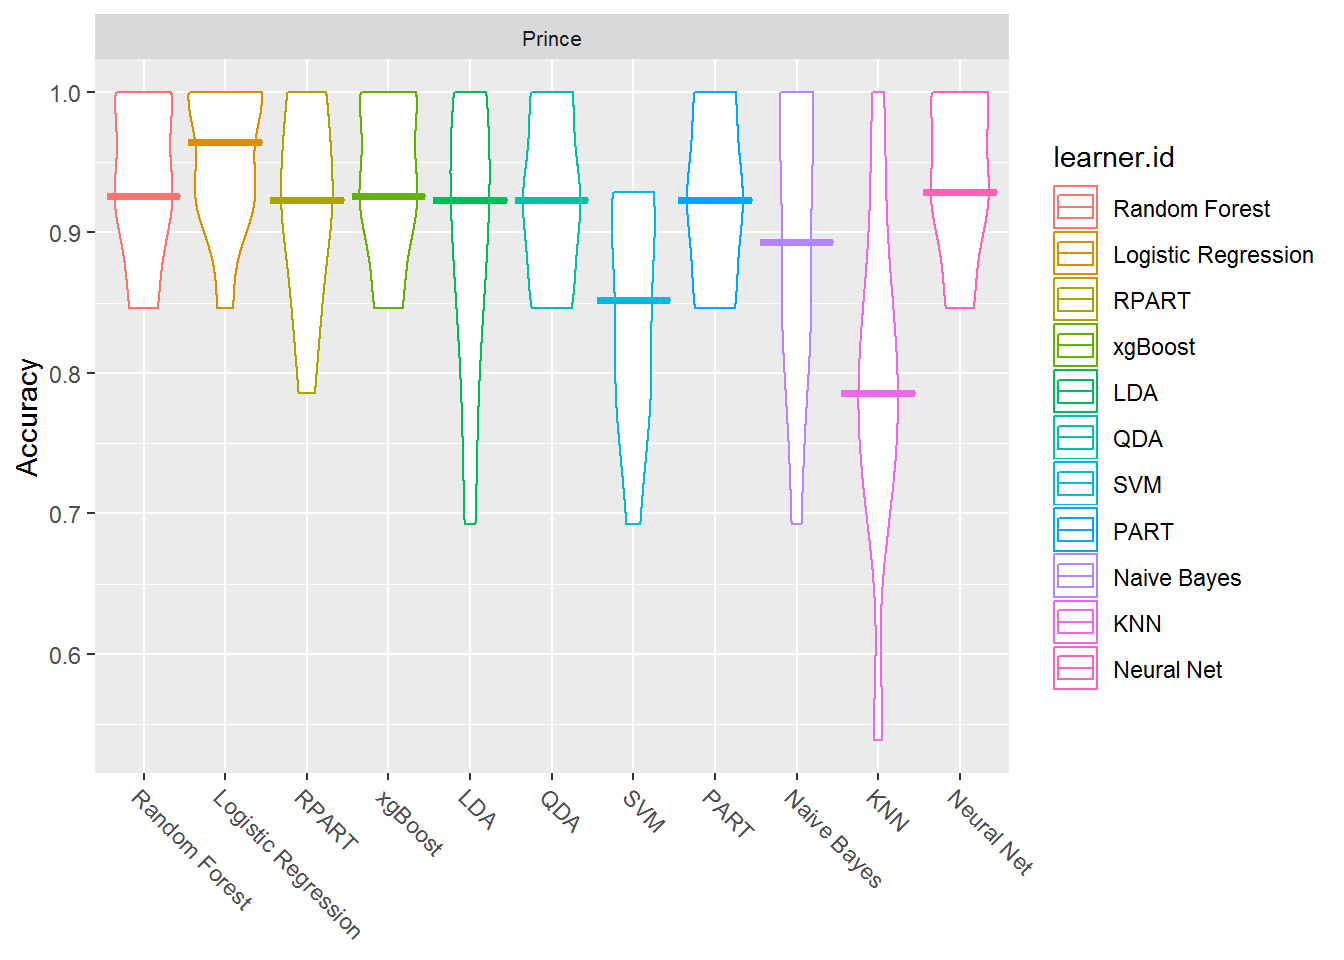
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")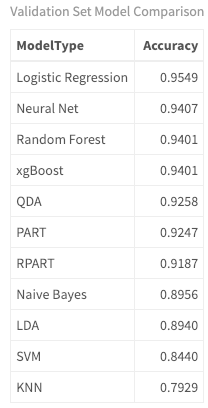
Khi dự đoán mức xếp hạng, bạn đang làm việc với bài toán hai lớp. Chỉ có hai lựa chọn: vào bảng hoặc không vào bảng. Khi phân loại thể loại, bạn có bài toán đa lớp với hơn hai lớp có thể. (Lưu ý điều này khác với bài toán đa nhãn nơi một quan sát có thể thuộc nhiều lớp. Có thể là điều đáng tìm hiểu!). Vì đây là bài toán phân loại nhị phân, tôi đã thêm hai thuật toán: QDA và Logistic Regression. Hai thuật toán này phù hợp hơn cho bài toán hai lớp.
Logistic Regression được thiết kế cho kết quả nhị phân và mô hình hóa xác suất một quan sát (bài hát) thuộc một nhóm cụ thể. Nó dựa trên một ngưỡng mặc định .5. Ví dụ, bất kỳ cái gì có xác suất lớn hơn .5 thuộc lớp mục tiêu, và thấp hơn ngưỡng thuộc lớp còn lại. Ngưỡng này có thể điều chỉnh. QDA là viết tắt của quadratic discriminant analysis và linh hoạt hơn cho việc xử lý biên quyết định phi tuyến bậc hai so với tuyến tính. Tôi biết không công bằng khi nêu thuật ngữ kỹ thuật mà không có thêm thông tin, nên hãy dành thời gian xem dữ liệu bạn có, các thuật toán hoạt động tốt, và nghiên cứu từng cái riêng. Hy vọng phân tích này gợi cảm hứng để bạn tìm hiểu chi tiết!
Bước tiếp theo là chạy dự đoán và xem phân loại.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")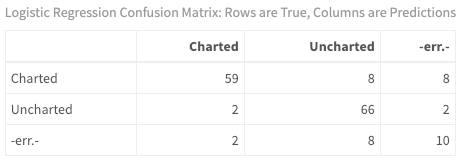
Rất dễ để xem mô hình phân loại từng bài hát như thế nào. Với phân loại nhị phân, có khá nhiều thước đo để xem. Tạm thời, hãy xem dương tính giả — tức các bài được dự đoán vào bảng trong khi thực tế không vào Top 100.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")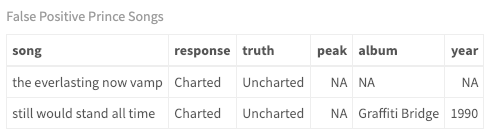
Dù bạn đã dùng cross-validation khi huấn luyện mô hình, bạn luôn nên chạy mô hình đó trên một tập dữ liệu riêng (như bạn đã làm với thể loại ở trên). Tôi để lại việc này như một bài tập cho bạn và hy vọng bạn sẽ để lại phản hồi về kết quả. Để đây là một bài kiểm tra thực sự về sức mạnh dự đoán phía sau phân tích ca từ, kết quả thực tế nhất sẽ đến từ một nghệ sĩ khác cũng thuộc thể loại pop-rock như Prince. Một yếu tố khác là thời kỳ. Những bài này vào bảng chủ yếu ở thập niên 70, 80 và 90, nên nghệ sĩ cùng thời kỳ là rất quan trọng. Hoặc, chọn nghệ sĩ của riêng bạn cho dữ liệu huấn luyện và kiểm tra và xem bạn thu được gì!
Trong hướng dẫn này, bạn đã xây dựng một mô hình để dự đoán thể loại của bài hát chỉ dựa trên ca từ. Bạn đã dùng các thuật toán phân loại học có giám sát và huấn luyện mô hình trên tập gồm năm nghệ sĩ và năm thể loại khác nhau. Bằng framework mlr, bạn đã tạo tasks, learners và chiến lược lấy mẫu lại để huấn luyện rồi tinh chỉnh mô hình. Sau đó bạn chạy mô hình trên tập dữ liệu test chưa từng thấy của các nghệ sĩ khác. Bạn đã có thể xác định thuật toán nào hoạt động tốt hơn với thiết lập mặc định, và cuối cùng, dự đoán thể loại của các bài hát mới mà mô hình chưa từng thấy.
Liên quan đến phân tích ca từ, có thể thấy rằng dù ngành công nghiệp âm nhạc (và Billboard Charts) có định nghĩa thể loại sẵn cho mỗi nghệ sĩ, phân tích của bạn gợi ý rằng theo ca từ, bài hát băng qua các thể loại và thường không có quan hệ một-một. (Là một nhạc sĩ sáng tác, slogan thể loại của tôi là "funkified, acoustic, rockin' soul!"). Bạn cũng có thể dùng cùng kỹ thuật để mô hình hóa việc một bài hát sẽ vào bảng xếp hạng chỉ dựa trên lời bài hát với độ chính xác khá trên dữ liệu huấn luyện. Nhiệm vụ của bạn bây giờ là áp dụng kiến thức đó cho các tập dữ liệu của riêng bạn!
Tôi đã rất vui khi đồng hành cùng bạn trong suốt chuỗi bài ba phần (bốn hướng dẫn) về phân tích ca từ. Hy vọng bạn đã đánh giá cao độ phức tạp khi làm việc với dạng văn bản này và những tinh tế liên quan đến lời bài hát so với các dạng văn bản khác (ví dụ, phi hư cấu). Tôi hy vọng bạn đã học được kỹ năng mới và được truyền cảm hứng để dùng dữ liệu của chính mình nhằm khám phá những chủ đề mới bạn quan tâm. Machine learning là một lĩnh vực thú vị, và với tư cách là nhà khoa học dữ liệu mới vào nghề hay dạn dày, sự sáng tạo, cảm hứng và kiên trì sẽ giúp bạn khác biệt. Hãy nhớ nghĩ ngoài chiếc hình bình hành tứ giác và tận hưởng hành trình học tập!
"Tôi đặt chân lên vạch xuất phát, và lao vào một ngày mới. Tôi gửi một nụ hôn vào gió, nhắm mắt lại và đá bay nỗi sợ. - Debbie Liske, New Day"
(Nhân tiện, tôi đã viết hơn 100 bài hát của riêng mình và chạy mô hình cuối cùng đó trên âm nhạc của tôi. Mô hình dự đoán 35 bài của tôi đáng ra đã vào bảng xếp hạng! Giá mà tôi biết kỹ thuật này sớm hơn!! Có lẽ bài viết tiếp theo của tôi sẽ là cách dùng phân tích ca từ để viết một bản hit dựa trên nghệ sĩ đương đại…)
Tôi chỉ điểm qua nhanh các chủ đề dưới đây và khuyến khích bạn dành thời gian để hiểu sâu từng cái.
Vui lòng đặt câu hỏi trong phần bình luận!
Đây là các liên kết đến tập dữ liệu:
Tìm hiểu thêm về R và Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
