DataCamp Premium à -50 %.Plus de 700 cours, à moitié prix. Commencez à apprendre dès aujourd’hui.
Embarquez pour un voyage sentimental à travers la vie et l’époque de Prince, The Artist, dans la partie Deux-A d’une série de trois tutoriels, en utilisant l’analyse de sentiment avec R pour éclairer la carrière de l’Artiste et son influence sociétale. Les trois tutoriels couvrent :
Pour aller plus loin sur l’analyse de sentiment, consultez notre cours Sentiment Analysis in R : The Tidy Way.
Saviez-vous que Prince a « prédit » le 11 septembre sur scène, trois ans avant ? Il aurait aussi prédit sa propre mort. Possible ? Ne serait-il pas intéressant d’examiner ses paroles et de vous forger votre propre opinion étayée ? Le 21 avril 1985, il enregistre "Sometimes It Snows In April". Il meurt exactement 31 ans plus tard, le 21 avril 2016. Observez le choix des mots dans l’analyse de sentiment de ce titre :
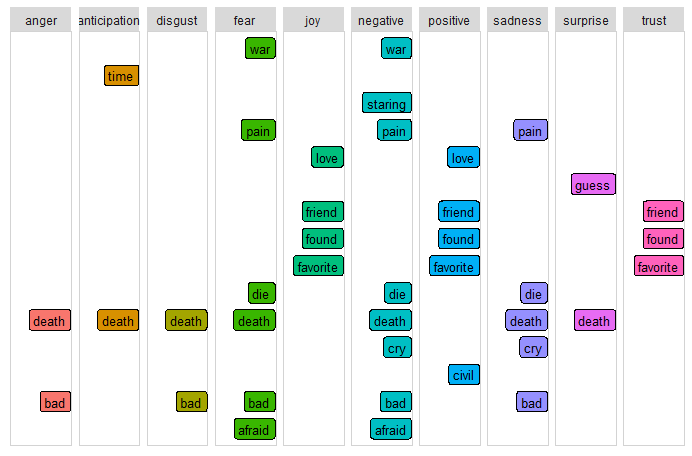
Voilà qui donne un nouveau sens à l’analytique prédictive !
Chaque bloc de code est suivi d’un commentaire d’interprétation, souvent subjectif. N’hésitez pas à passer d’une section à l’autre et à formuler vos propres hypothèses si vous préférez. Je vous recommande de lire l’introduction ci-dessous, mais si vous souhaitez plonger directement dans le code, cliquez ici. Si vous maîtrisez déjà la notion de lexiques, vous pouvez aller à l’essentiel en rejoignant directement la section d’analyse détaillée.
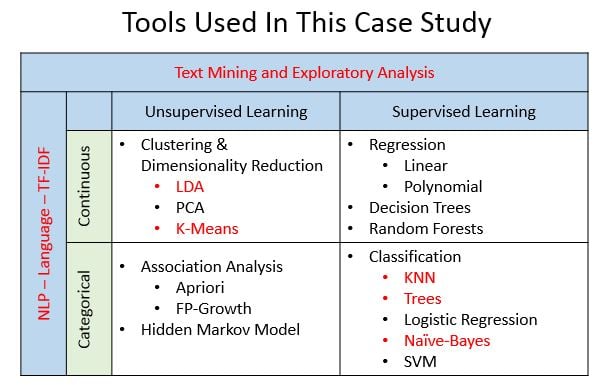
Je viens de recueillir deux chatons et un chiot, alors je pense par trois désormais. Et puis, la règle de trois en écriture veut que les éléments présentés par trois soient plus percutants, mémorables ou efficaces que les autres – d’où ce découpage en trois volets. Dans la Partie un, vous avez découvert la fouille de texte et l’analyse exploratoire à partir d’un jeu de données contenant des centaines de paroles de chansons du légendaire Prince. Dans la Partie deux, vous vous concentrez sur l’analyse de sentiment (Deux-A) et la modélisation de sujets (Deux-B) en NLP. La Partie trois conclura avec des tâches d’analytique prédictive via des techniques de machine learning pour répondre à des questions comme : peut-on déterminer la décennie de sortie d’une chanson ? Peut-on, plus intéressant encore, prédire qu’un titre entrera au Billboard à partir de ses paroles ? Tout au long de ces tutoriels, vous utiliserez différents algorithmes de machine learning – chacun étant mis en évidence en rouge dans le graphique ci-dessous.
Oui, j’avais promis trois parties, mais j’ai décidé de scinder la Partie deux en Deux-A (analyse de sentiment) et Deux-B (modélisation de sujets – à venir), ce qui donne quatre tutoriels distincts. Il existe de nombreux excellents articles et cours sur la démarche d’analyse de sentiment ; l’objectif de la Partie Deux-A est donc d’extraire des enseignements de l’analyse – pas seulement d’écrire du code. Nous utiliserons les paroles de Prince comme exemple, mais vous pourrez appliquer ces étapes à votre artiste préféré. J’espère que ce parcours complet attisera votre curiosité sur les possibilités de l’analyse de paroles tout en vous initiant au traitement automatique du langage (NLP) et aux techniques de machine learning.
La Partie Deux-A suppose une compréhension de base des données « tidy » – en particulier des packages comme dplyr pour la transformation des données, ggplot2 pour les visualisations, et l’opérateur pipe %>% (issu initialement de magrittr). Vous verrez que plusieurs étapes sont enchaînées avec %>% pour garder un code compact et réutilisable.
Comme ce tutoriel est aussi une étude de cas, il regorge de visualisations au-delà des graphiques habituels. Autre prérequis : savoir installer de nouveaux packages dans votre environnement. Pour vous laisser vous concentrer sur les insights, j’ai inclus du code conçu pour être réutilisé sur vos propres données, mais une explication exhaustive demandera des recherches complémentaires de votre part. Des liens utiles sont fournis pour chaque package, afin de vous exposer à de nouveaux outils tout en privilégiant leur mise en pratique.
Conseil : lisez d’abord la Partie un pour poser les bases de la série et découvrir le vocabulaire denses et varié des paroles de Prince.
Méthodes : l’analyse de sentiment est une forme de fouille de texte visant à déterminer l’opinion et la subjectivité d’un contenu. Appliquée aux paroles, elle peut refléter non seulement l’attitude de l’artiste, mais aussi révéler des influences culturelles plus larges. Plusieurs approches existent : apprentissage supervisé sur un jeu de données annoté, création de vos propres classifieurs par règles, ou utilisation de dictionnaires lexicaux prédéfinis (lexiques). Dans ce tutoriel, vous utiliserez une approche fondée sur les lexiques ; je vous encourage toutefois à explorer les autres méthodes et leurs compromis.
Niveaux : comme pour les méthodes, il existe différents niveaux d’analyse selon le texte : document, phrase et mot. Pour des paroles, le « document » peut correspondre au sentiment par décennie, par année, par niveau de classement, ou par chanson. Le niveau phrase est rarement pertinent, la ponctuation pouvant nuire aux rimes et aux schémas. L’analyse au niveau mot révèle des détails utiles et sert de base à des techniques plus avancées en modélisation de sujets.
Tout projet data doit commencer par des questions à explorer. Gardez celles-ci à l’esprit au fil du tutoriel : peut-on écrire un programme pour déterminer l’humeur exprimée dans des paroles ? Les lexiques prédéfinis suffisent-ils ? Quel niveau de préparation des données est nécessaire ? Pouvez-vous relier vos résultats à des événements réels ? Le sentiment évolue-t-il dans le temps ? Les hits sont-ils plus positifs ou plus négatifs que les morceaux non classés ? Quels mots ressortent l’année où l’on dit que Prince a prédit le 11 septembre ? A-t-il prédit sa propre mort ?
Conseil : l’analyse de paroles est très différente, et souvent plus complexe, que celle de discours ou de livres ; il est difficile d’en extraire des insights fiables, alors soyez prudents avec vos hypothèses. Je poserai plus de questions que je n’apporterai de réponses ; préparez-vous à sortir du cadre classique !
Pour commencer l’analyse des paroles de Prince, chargez les bibliothèques ci-dessous. La liste peut paraître impressionnante, mais la plupart servent aux graphiques. Vu la fréquence des visuels, mieux vaut définir un nuancier standard pour garantir la cohérence. J’ai créé une liste avec des codes couleur ANSI. La fonction theme() de ggplot2 permet de personnaliser chaque graphique ; vous allez donc créer votre propre fonction, theme_lyrics(), pour ajuster les paramètres par défaut. Le package knitr est un moteur de génération de rapports dynamiques avec R. Utilisez-le avec kableExtra et formattable pour produire de belles tables colorées. Créez aussi votre fonction my_kable_styling() afin d’uniformiser le rendu de ces bibliothèques. Les autres packages seront mentionnés au fil de leur utilisation.
library(dplyr) #Data manipulation (also included in the tidyverse package)
library(tidytext) #Text mining
library(tidyr) #Spread, separate, unite, text mining (also included in the tidyverse package)
library(widyr) #Use for pairwise correlation

#Visualizations!
library(ggplot2) #Visualizations (also included in the tidyverse package)
library(ggrepel) #`geom_label_repel`
library(gridExtra) #`grid.arrange()` for multi-graphs
library(knitr) #Create nicely formatted output tables
library(kableExtra) #Create nicely formatted output tables
library(formattable) #For the color_tile function
library(circlize) #Visualizations - chord diagram
library(memery) #Memes - images with plots
library(magick) #Memes - images with plots (image_read)
library(yarrr)  #Pirate plot
library(radarchart) #Visualizations
library(igraph) #ngram network diagrams
library(ggraph) #ngram network diagrams

#Define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#Customize ggplot2's default theme settings
#This tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #Center the title
        axis.ticks = aticks, #Set axis ticks to on or off
        panel.grid.minor = pgminor, #Turn the minor grid lines on or off
        legend.title = lt, #Turn the legend title on or off
        legend.position = lp) #Turn the legend on or off
}

#Customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}
Comme toujours, commencez par lire les données brutes dans un data frame. Dans la Partie un, vous avez conditionné le jeu de données d’origine : expansion des contractions, suppression des séquences d’échappement, passage en minuscules. Vous avez sauvegardé ce jeu nettoyé en CSV pour ce tutoriel. Utilisez read.csv() pour créer prince_data ; gardez à l’esprit que vous voulez des chaînes de caractères pour les paroles : définissez stringsAsFactors = FALSE. Comme vous n’avez pas besoin d’index de ligne, mettez row.names = 1.
Remarque : vous pourriez éviter ces paramètres en lisant un data frame moderne appelé tibble via read_csv(), mais pour rester cohérent avec la Partie un, nous utilisons read.csv().
prince_data <- read.csv('prince_new.csv', stringsAsFactors = FALSE, row.names = 1)
Jetez un coup d’œil rapide aux données :
glimpse(prince_data) #Transposed version of `print()`## Observations: 824
## Variables: 10
## $ lyrics <chr> "all 7 and we will watch them fall they stand in t...
## $ song <chr> "7", "319", "1999", "2020", "3121", "7779311", "u"...
## $ year <int> 1992, NA, 1982, NA, 2006, NA, NA, NA, NA, NA, NA, ...
## $ album <chr> "Symbol", NA, "1999", "Other Songs", "3121", NA, N...
## $ peak <int> 3, NA, 2, NA, 1, NA, NA, NA, NA, NA, NA, NA, NA, N...
## $ us_pop <chr> "7", NA, "12", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ us_rnb <chr> "61", NA, "4", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ decade <chr> "1990s", NA, "1980s", NA, "2000s", NA, NA, NA, NA,...
## $ chart_level <chr> "Top 10", "Uncharted", "Top 10", "Uncharted", "Top...
## $ charted <chr> "Charted", "Uncharted", "Charted", "Uncharted", "C...Vous voyez que prince_data contient 824 chansons et 10 colonnes. Autrement dit, un enregistrement est une chanson, littéralement.
prince_tidyVoici quelques dernières étapes de préparation des données :
Pour passer à un format tidy, utilisez unnest_tokens() de tidytext pour créer prince_tidy, qui éclate les paroles en mots avec un mot par ligne. Vous pourrez ensuite employer anti_join() et filter() de dplyr pour finaliser le nettoyage. (Voir la Partie un pour l’explication détaillée.)
#Created in the first tutorial
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats", "la", "da", "uh", "ah")

#Create tidy text format: Unnested, Unsummarized, -Undesirables, Stop and Short words
prince_tidy <- prince_data %>%
  unnest_tokens(word, lyrics) %>% #Break the lyrics into individual words
  filter(!word %in% undesirable_words) %>% #Remove undesirables
  filter(!nchar(word) < 3) %>% #Words like "ah" or "oo" used in music
  anti_join(stop_words) #Data provided by the tidytext package
glimpse(prince_tidy) #From `dplyr`, better than `str()`.
 ## Observations: 76,116
## Variables: 10
## $ song        <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ year        <int> 1992, 1992, 1992, 1992, 1992, 1992, 1992, 1992, 19...
## $ album       <chr> "Symbol", "Symbol", "Symbol", "Symbol", "Symbol", ...
## $ peak        <int> 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3,...
## $ us_pop      <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ us_rnb      <chr> "61", "61", "61", "61", "61", "61", "61", "61", "6...
## $ decade      <chr> "1990s", "1990s", "1990s", "1990s", "1990s", "1990...
## $ chart_level <chr> "Top 10", "Top 10", "Top 10", "Top 10", "Top 10", ...
## $ charted     <chr> "Charted", "Charted", "Charted", "Charted", "Chart...
## $ word        <chr> "watch", "fall", "stand", "love", "smoke", "intell...
Votre nouveau jeu prince_tidy est désormais tokenisé : un mot par ligne, avec la chanson d’origine associée. Vous avez un data frame de 76 116 mots et 10 colonnes.
Si vous n’avez pas lu la Partie un, prenez un instant pour parcourir quelques graphiques de synthèse sur l’ensemble du jeu. Nous utiliserons des visuels originaux via ggplot2, circlize et yarrr.
Un pirate dirait shipshape quand tout est en ordre, propre et net. Voici donc une vue intéressante des données « tidy » montrant la diversité lexicale, autrement dit le vocabulaire, au fil du temps. Un pirate plot est une méthode avancée pour représenter une variable dépendante continue (p. ex. le nombre de mots) en fonction d’une variable catégorielle (p. ex. la décennie). Il combine données brutes, statistiques descriptives et inférentielles en un seul graphique efficace. Consultez cet excellent billet sur pirateplot() du package yarrr.
Créez le data frame word_summary qui calcule le nombre de mots distincts par chanson. Plus les paroles sont variées, plus le vocabulaire est riche. Penser les données ainsi vous prépare à l’analyse au niveau mot. Remplacez la décennie par "NONE" pour les titres sans date de sortie et renommez quelques champs via select().
word_summary <- prince_tidy %>%
  mutate(decade = ifelse(is.na(decade),"NONE", decade)) %>%
  group_by(decade, song) %>%
  mutate(word_count = n_distinct(word)) %>%
  select(song, Released = decade, Charted = charted, word_count) %>%
  distinct() %>% #To obtain one record per song
  ungroup()

pirateplot(formula =  word_count ~ Released + Charted, #Formula
   data = word_summary, #Data frame
   xlab = NULL, ylab = "Song Distinct Word Count", #Axis labels
   main = "Lexical Diversity Per Decade", #Plot title
   pal = "google", #Color scheme
   point.o = .2, #Points
   avg.line.o = 1, #Turn on the Average/Mean line
   theme = 0, #Theme
   point.pch = 16, #Point `pch` type
   point.cex = 1.5, #Point size
   jitter.val = .1, #Turn on jitter to see the songs better
   cex.lab = .9, cex.names = .7) #Axis label size
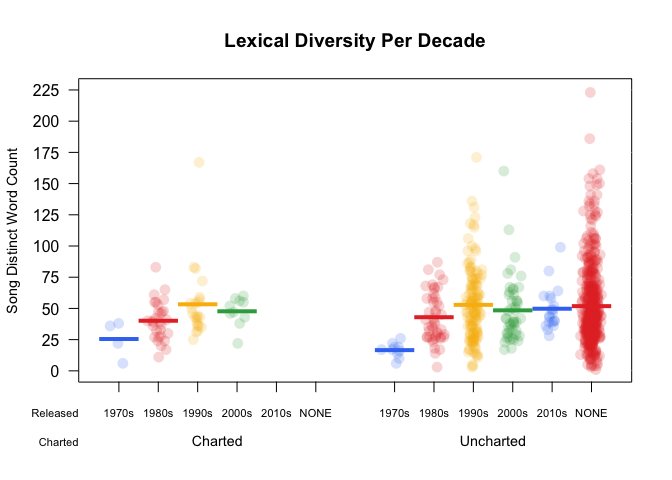
Chaque disque coloré de ce pirate plot représente une chanson. La zone rouge dense avec la valeur "NONE" montre qu’un grand nombre de morceaux du jeu n’ont pas de date de sortie. On observe une légère hausse du nombre de mots uniques par chanson dans les premières décennies : la ligne horizontale solide indique la moyenne de la décennie. C’est important quand vous commencerez à analyser l’évolution du sentiment dans le temps. Le vocabulaire devient plus révélateur au fil de la carrière de Prince.
Je vous encourage à creuser les pirate plots : nous n’avons fait qu’effleurer le sujet.
Les graphes circulaires offrent une manière originale de visualiser des relations complexes (ou simples) entre catégories. (Et les disques étaient ronds !) Le graphique ci-dessous est un simple histogramme circulaire avec coord_polar() de ggplot2, montrant le nombre relatif de chansons par année. Beaucoup de code pour un graph simple, mais ça vaut le coup. Un exemple détaillé est disponible dans la R Graph Gallery ici. Comme pour les pirate plots, ce n’est qu’une introduction à ce que vous pouvez faire avec les graphiques circulaires.
songs_year <- prince_data %>%
  select(song, year) %>%
  group_by(year) %>%
  summarise(song_count = n())

id <- seq_len(nrow(songs_year))
songs_year <- cbind(songs_year, id)
label_data = songs_year
number_of_bar = nrow(label_data) #Calculate the ANGLE of the labels
angle = 90 - 360 * (label_data$id - 0.5) / number_of_bar #Center things
label_data$hjust <- ifelse(angle < -90, 1, 0) #Align label
label_data$angle <- ifelse(angle < -90, angle + 180, angle) #Flip angle
ggplot(songs_year, aes(x = as.factor(id), y = song_count)) +
  geom_bar(stat = "identity", fill = alpha("purple", 0.7)) +
  geom_text(data = label_data, aes(x = id, y = song_count + 10, label = year, hjust = hjust), color = "black", alpha = 0.6, size = 3, angle =  label_data$angle, inherit.aes = FALSE ) +
  coord_polar(start = 0) +
  ylim(-20, 150) + #Size of the circle
  theme_minimal() +
  theme(axis.text = element_blank(),
        axis.title = element_blank(),
        panel.grid = element_blank(),
        plot.margin = unit(rep(-4,4), "in"),
        plot.title = element_text(margin = margin(t = 10, b = -10)))
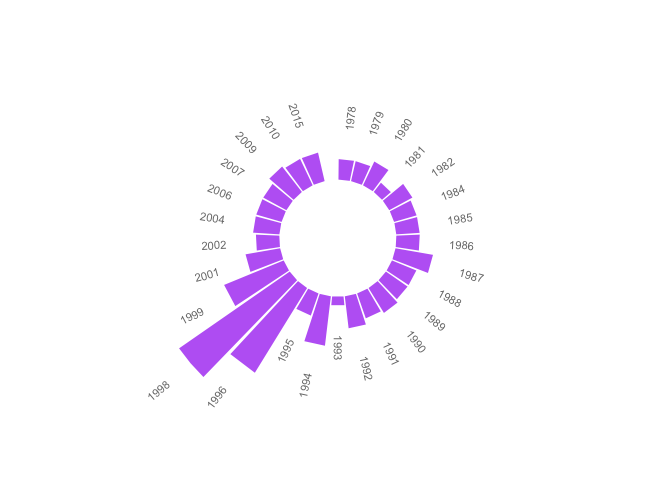
Voyez l’espace vide tout en haut ? C’est le signe des centaines de chansons sans dates de sortie repérées avec le pirate plot. Avec un tel volume de titres non datés, le graphique perdrait en lisibilité s’ils étaient inclus. Les années manquantes indiquent celles sans sortie. Les années les plus prolifiques : 1996 et 1998.
Envie de savoir pourquoi ? Lisez la suite !
Le graphique suivant montre la relation entre la décennie de sortie et la présence ou non au Billboard. Utiliser un chordDiagram() pour une analyse musicale était tentant ! Cet outil graphique provient du très beau package circlize de Zuguang Gu. Le graphe est séparé en deux catégories : classement (haut) et décennie (bas). Les deux catégories sont séparées par de larges espaces, avec de plus petits espaces entre les valeurs. Les commentaires de haut niveau dans le code ci-dessous peuvent être complétés par davantage de détails ici.
decade_chart <-  prince_data %>%
  filter(decade != "NA") %>% #Remove songs without release dates
  count(decade, charted)  #Get SONG count per chart level per decade. Order determines top or bottom.

circos.clear() #Very important - Reset the circular layout parameters!
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "Charted" = "grey", "Uncharted" = "grey") #assign chord colors
# Set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_chart[[1]])) - 1), 15,
                         rep(5, length(unique(decade_chart[[2]])) - 1), 15))

chordDiagram(decade_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Chart and Decade")
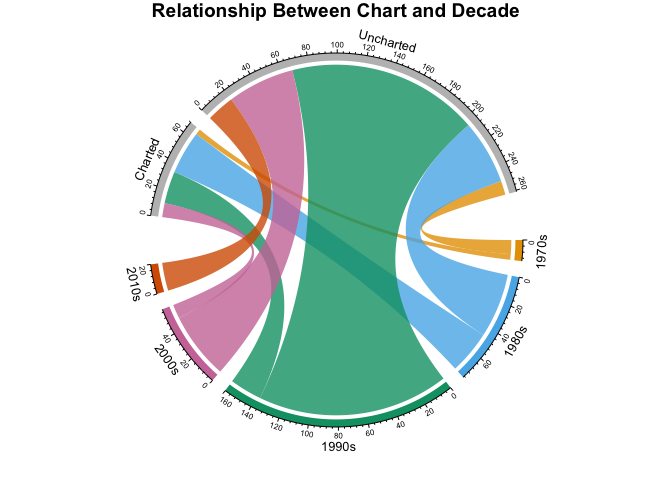
Ce diagramme circulaire peut sembler complexe au premier regard, mais il illustre clairement le nombre de chansons par décennie et par statut de classement. On voit que Prince commence sa carrière dans les années 1970 avec peu de sorties, dont certaines classées. En comparant les années 1980 aux années 1990, on constate davantage de sorties dans les années 1990, mais plus de titres classés dans les années 1980. Dans les années 2000, peu de succès commerciaux ; dans les années 2010, aucun hit.
Dans cette section, vous allez :
Le package tidytext inclut un jeu sentiments qui regroupe plusieurs lexiques. Ces lexiques sont des dictionnaires associant des mots à une catégorie ou une valeur de sentiment. tidytext propose trois lexiques généralistes :
Pour examiner les lexiques, créez un data frame new_sentiments. Excluez un lexique financier, créez un champ de sentiment binaire (dit polar) pour AFINN en convertissant le score numérique en positive ou negative, et ajoutez un champ contenant le nombre de mots distincts par lexique.
new_sentiments comporte une colonne avec les différentes catégories ; pour mieux visualiser les volumes par lexique et par catégorie, utilisez spread() de tidyr pour pivoter ces catégories en colonnes. Profitez de knitr et kableExtra via la fonction my_kable_styling() créée plus tôt. Ajoutez de la couleur avec color_tile() et color_bar() de formattable pour obtenir une table joliment formatée. Imprimez-la et comparez les différences entre lexiques.
new_sentiments <- sentiments %>% #From the tidytext package
  filter(lexicon != "loughran") %>% #Remove the finance lexicon
  mutate( sentiment = ifelse(lexicon == "AFINN" & score >= 0, "positive",
                              ifelse(lexicon == "AFINN" & score < 0,
                                     "negative", sentiment))) %>%
  group_by(lexicon) %>%
  mutate(words_in_lexicon = n_distinct(word)) %>%
  ungroup()

new_sentiments %>%
  group_by(lexicon, sentiment, words_in_lexicon) %>%
  summarise(distinct_words = n_distinct(word)) %>%
  ungroup() %>%
  spread(sentiment, distinct_words) %>%
  mutate(lexicon = color_tile("lightblue", "lightblue")(lexicon),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon)) %>%
  my_kable_styling(caption = "Word Counts Per Lexicon")
| lexicon | words_in_lexicon | anger | anticipation | disgust | fear | joy | negative | positive | sadness | surprise | trust |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AFINN | 2476 | NA | NA | NA | NA | NA | 1597 | 879 | NA | NA | NA |
| bing | 6785 | NA | NA | NA | NA | NA | 4782 | 2006 | NA | NA | NA |
| nrc | 6468 | 1247 | 839 | 1058 | 1476 | 689 | 3324 | 2312 | 1191 | 534 | 1231 |
Le tableau ci-dessus vous donne une idée de la taille et de la structure de chaque lexique.
Pour savoir quel lexique convient le mieux aux paroles, étudiez le ratio de correspondance des mots présents à la fois dans le lexique et dans les paroles. Rappel : prince_tidy contient 76 116 mots au total et 7851 mots distincts.
Combien de ces mots figurent effectivement dans les lexiques ?
Faites un inner_join() entre prince_tidy et new_sentiments, puis regroupez par lexique. Le lexique NRC comprend 10 catégories, et un mot peut appartenir à plusieurs catégories : par exemple, un mot peut être négatif et triste. Utilisez donc n_distinct() dans summarise() pour obtenir le nombre de mots distincts par lexique.
prince_tidy %>%
  mutate(words_in_lyrics = n_distinct(word)) %>%
  inner_join(new_sentiments) %>%
  group_by(lexicon, words_in_lyrics, words_in_lexicon) %>%
  summarise(lex_match_words = n_distinct(word)) %>%
  ungroup() %>%
  mutate(total_match_words = sum(lex_match_words), #Not used but good to have
         match_ratio = lex_match_words / words_in_lyrics) %>%
  select(lexicon, lex_match_words,  words_in_lyrics, match_ratio) %>%
  mutate(lex_match_words = color_bar("lightpink")(lex_match_words),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Lyrics Found In Lexicons")
| lexicon | lex_match_words | words_in_lyrics | match_ratio |
|---|---|---|---|
| AFINN | 770 | 7851 | 0.0980767 |
| bing | 1185 | 7851 | 0.1509362 |
| nrc | 1678 | 7851 | 0.2137307 |
Le lexique NRC comporte davantage de mots distincts des paroles que AFINN ou Bing. Notez que la somme des ratios de correspondance est faible. Aucun lexique ne peut (ni ne doit) contenir tous les mots. Beaucoup sont neutres et n’ont pas de sentiment associé. Par exemple, 2000 est en général neutre, donc absent des lexiques. Pourtant, souvenez-vous des peurs liées à l’an 2000 : avions supposés tomber du ciel, ordinateurs censés s’arrêter... Une crainte associée existe bien dans la chanson, mais n’est pas capturée par une analyse fondée sur des lexiques.
Quelques raisons pour lesquelles un mot n’apparaît pas dans un lexique :
Examinez quelques mots précis des chansons de Prince qui semblent influencer le sentiment. Sont-ils dans tous les lexiques ?
new_sentiments %>%
  filter(word %in% c("dark", "controversy", "gangster",
                     "discouraged", "race")) %>%
  arrange(word) %>% #sort
  select(-score) %>% #remove this field
  mutate(word = color_tile("lightblue", "lightblue")(word),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Specific Words")
| word | sentiment | lexicon | words_in_lexicon |
|---|---|---|---|
| controversy | negative | nrc | 6468 |
| controversy | negative | bing | 6785 |
| dark | sadness | nrc | 6468 |
| dark | negative | bing | 6785 |
| discouraged | negative | AFINN | 2476 |
| gangster | negative | bing | 6785 |
Controversy et dark apparaissent chez NRC et Bing, mais gangster seulement chez Bing. Race n’apparaît pas alors qu’il s’agit d’un thème central chez Prince. Est-il pour autant facile à associer à un sentiment ? Notez aussi qu’AFINN, beaucoup plus réduit, ne contient qu’un seul de ces mots.
Voyons un exemple plus complexe. La sexualité est un thème récurrent chez Prince. Comment une analyse basée sur des lexiques prédéfinis gère-t-elle les différentes formes d’un mot ? Voici toutes les occurrences liées à la racine sex dans les paroles. Comparez avec Bing et NRC pour voir où il y a correspondance.
my_word_list <- prince_data %>%
  unnest_tokens(word, lyrics) %>%
  filter(grepl("sex", word)) %>% #Use `grepl()` to find the substring `"sex"`
  count(word) %>%
  select(myword = word, n) %>% #Rename word
  arrange(desc(n))

new_sentiments %>%
  #Right join gets all words in `my_word_list` to show nulls
  right_join(my_word_list, by = c("word" = "myword")) %>%
  filter(word %in% my_word_list$myword) %>%
  mutate(word = color_tile("lightblue", "lightblue")(word),
          instances = color_tile("lightpink", "lightpink")(n),
          lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  select(-score, -n) %>% #Remove these fields
  my_kable_styling(caption = "Dependency on Word Form")
| word | sentiment | lexicon | words_in_lexicon | instances |
|---|---|---|---|---|
| sexy | positive | bing | 6785 | 220 |
| sexy | positive | AFINN | 2476 | 220 |
| sex | anticipation | nrc | 6468 | 185 |
| sex | joy | nrc | 6468 | 185 |
| sex | positive | nrc | 6468 | 185 |
| sex | trust | nrc | 6468 | 185 |
| superfunkycalifragisexy | NA | NA | NA | 19 |
| lovesexy | NA | NA | NA | 16 |
| sexual | NA | NA | NA | 11 |
| sexuality | NA | NA | NA | 11 |
| sexiness | NA | NA | NA | 2 |
| sexually | NA | NA | NA | 2 |
| sexe | NA | NA | NA | 1 |
| sexed | NA | NA | NA | 1 |
| sexier | NA | NA | NA | 1 |
| superfunkycalifraagisexy | NA | NA | NA | 1 |
| superfunkycalifragisexi | NA | NA | NA | 1 |
Remarquez que Prince utilise souvent sexy, mais ce mot n’existe pas sous cette forme dans NRC. Le mot sex existe dans NRC mais pas dans Bing. Que se passerait-il si vous regardiez les stems ou racines ? Votre texte peut contenir un passé, un pluriel, un adverbe d’un mot racine, mais la forme n’existe dans aucun lexique. Comment gérer cela ?
Il se peut que vous ayez besoin de quelques étapes supplémentaires. Trois techniques à envisager avant une analyse de sentiment :
Un concept avancé consiste à remplacer par des synonymes (pairs sémantiquement proches) ou hyperonymes (parents communs) plus fréquents. Ces termes apparaissent dans le lexique et augmentent le taux de correspondance. Nous n’avons pas la place pour couvrir ces traitements, mais c’est à considérer.
Défi : renseignez-vous sur la création des lexiques. En existe-t-il déjà un mieux adapté aux paroles ? Si le sujet vous passionne, que faudrait-il pour construire votre propre lexique ? Quelle différence entre une approche par classifieur et une approche par lexique ?
Maintenant que vous avez compris le jeu de données et les lexiques, vous pouvez les joindre pour analyser. Étapes générales :
Commencez par créer des jeux de sentiment spécifiques à chaque lexique via un inner_join() sur la fonction get_sentiments(). Passez le nom du lexique à chaque appel. Pour cet exercice, utilisez Bing pour le binaire et NRC pour le catégoriel. Comme un mot peut apparaître dans plusieurs catégories NRC (négatif/peur, positif/joie), créez aussi un sous-ensemble sans les catégories positive et negative pour plus tard.
prince_bing <- prince_tidy %>%
  inner_join(get_sentiments("bing"))
prince_nrc <- prince_tidy %>%
  inner_join(get_sentiments("nrc"))
prince_nrc_sub <- prince_tidy %>%
  inner_join(get_sentiments("nrc")) %>%
  filter(!sentiment %in% c("positive", "negative"))
Dans l’analyse détaillée, vous étudierez différents niveaux : toutes chansons, niveau classement, décennie, mot. Commencez par tracer l’analyse NRC sur l’ensemble du jeu.
(Pour le fun, j’ai utilisé les packages memery et magick pour ajouter des images (memes) aux graphiques.)
nrc_plot <- prince_nrc %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  #Use `fill = -word_count` to make the larger bars darker
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) + #Turn off the legend
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 15000)) + #Hard code the axis limit
  ggtitle("Prince NRC Sentiment") +
  coord_flip()

img <- "prince_background2.jpg" #Load the background image
lab <- ""  #Turn off the label
#Overlay the plot on the image and create the meme file
meme(img, lab, "meme_nrc.jpg", inset = nrc_plot)
#Read the file back in and display it!
nrc_meme <- image_read("meme_nrc.jpg")
plot(nrc_meme)
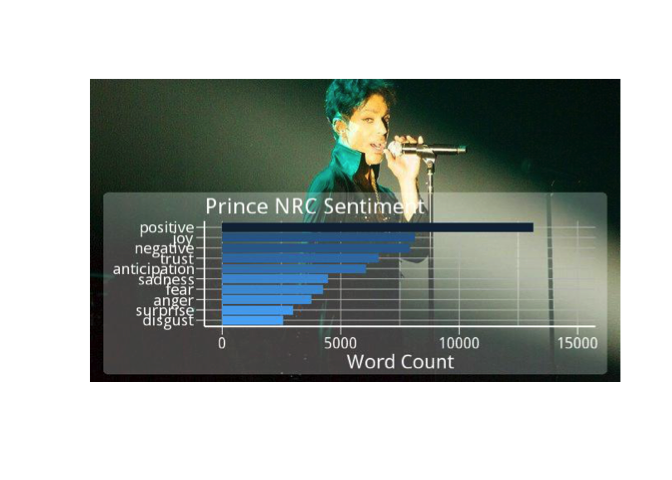
Pour les paroles de Prince, NRC penche fortement vers le positif. Mais les mots associés à disgust ou anger figurent-ils aussi dans la catégorie negative ? Cela mérite vérification.
Regardons maintenant le sentiment global selon Bing. Parmi les 1185 mots distincts des paroles de Prince présents dans Bing, combien sont positifs et combien négatifs ?
bing_plot <- prince_bing %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = sentiment)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 8000)) +
  ggtitle("Prince Bing Sentiment") +
  coord_flip()

img1 <- "prince_background1.jpg"
lab1 <- ""
meme(img1, lab1, "meme_bing.jpg", inset = bing_plot)
x <- image_read("meme_bing.jpg")
plot(x)
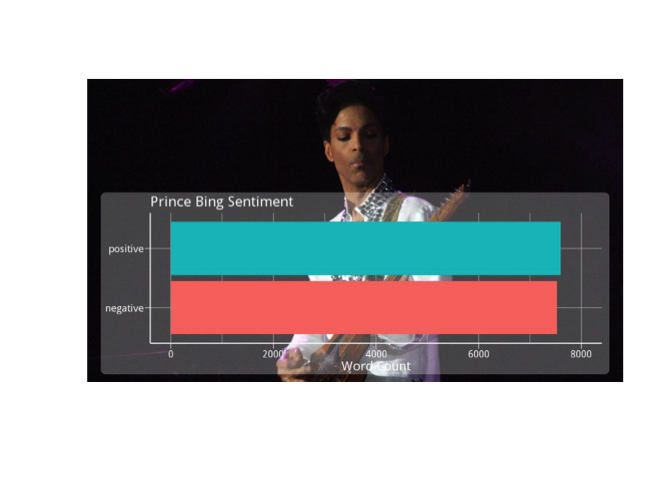
Se pourrait-il qu’avec Bing, le positif et le négatif s’équilibrent dans l’ensemble des chansons ? Le sentiment se neutralise-t-il à l’échelle d’un corpus trop vaste ? Difficile à dire ; découpez en « tranches » et observez.
En acoustique, on parle d’annulation de phase lorsque deux signaux de même fréquence sont en opposition de phase et s’annulent, par exemple lors de l’enregistrement d’une batterie avec deux micros. Résultat : un silence total à cette fréquence. Comment cela pourrait-il s’appliquer à une analyse de sentiment sur de grands jeux ? À méditer.
Professeur de linguistique : « En anglais, une double négation devient une affirmation. En russe, une double négation reste une négation. Mais il n’existe aucune langue où deux affirmations produisent une négation. » Un étudiant réplique : « Ouais, bien sûr. »
Affinez l’analyse au niveau du classement avec le lexique Bing. Créez un graphique du sentiment polar par niveau de classement. Utilisez spread() pour séparer les sentiments en colonnes et mutate() pour créer un champ polarity (positive − negative) et un percent_positive (positive / total des sentiments × 100). Pour le graphe de polarité, ajoutez une yintercept avec geom_hline(). Affichez les deux graphes côte à côte avec grid.arrange().
prince_polarity_chart <- prince_bing %>%
  count(sentiment, chart_level) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

#Polarity by chart
plot1 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, polarity, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = my_colors[3:5]) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity By Chart Level")

#Percent positive by chart
plot2 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, percent_positive, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = c(my_colors[3:5])) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive By Chart Level")

grid.arrange(plot1, plot2, ncol = 2)
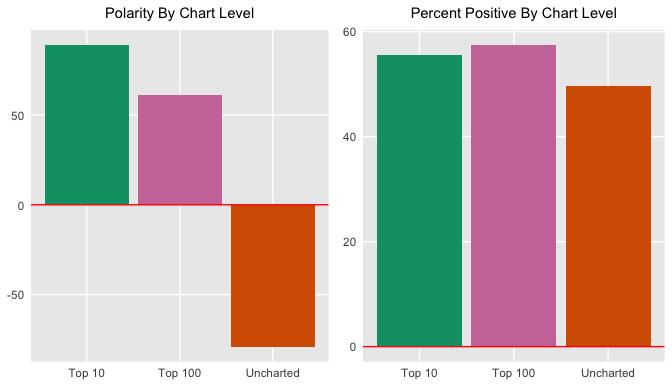
Ces résultats suggèrent-ils que les titres classés sont en général plus positifs que négatifs ? Qu’est-ce que cela dit de ce que le public souhaite entendre ? Peut-on l’affirmer ? En regardant le positif relatif au total, les titres classés semblent légèrement plus positifs. Intéressant sachant que Bing contient lui-même plus de mots négatifs que positifs.
Puisque vous examinez le sentiment sous un angle polar, vérifiez s’il évolue (humour de data geek). Utilisez geom_smooth() avec la méthode loess pour une courbe lissée, et un autre geom_smooth() avec lm pour une tendance linéaire.
prince_polarity_year <- prince_bing %>%
  count(sentiment, year) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, polarity, color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity Over Time")

relative_polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, percent_positive , color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive Over Time")

grid.arrange(polarity_over_time, relative_polarity_over_time, ncol = 2)
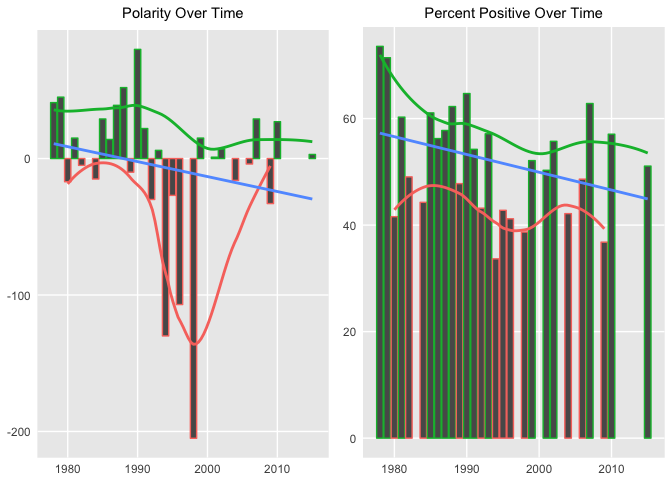
Quelques extrêmes ont été ajustés sur le second graphe, mais la tendance de fond de la polarité dans le temps est négative dans les deux cas.
Exploitez à nouveau la puissance de chordDiagram() pour étudier les relations entre les sentiments NRC et les décennies. Les catégories de sentiment apparaissent en haut de l’anneau, les décennies en bas.
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "anger" = "grey", "anticipation" = "grey", "disgust" = "grey", "fear" = "grey", "joy" = "grey", "sadness" = "grey", "surprise" = "grey", "trust" = "grey")

decade_mood <-  prince_nrc %>%
  filter(decade != "NA" & !sentiment %in% c("positive", "negative")) %>%
  count(sentiment, decade) %>%
  group_by(decade, sentiment) %>%
  summarise(sentiment_sum = sum(n)) %>%
  ungroup()

circos.clear()
#Set the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_mood[[1]])) - 1), 15,
                         rep(5, length(unique(decade_mood[[2]])) - 1), 15))
chordDiagram(decade_mood, grid.col = grid.col, transparency = .2)
title("Relationship Between Mood and Decade")
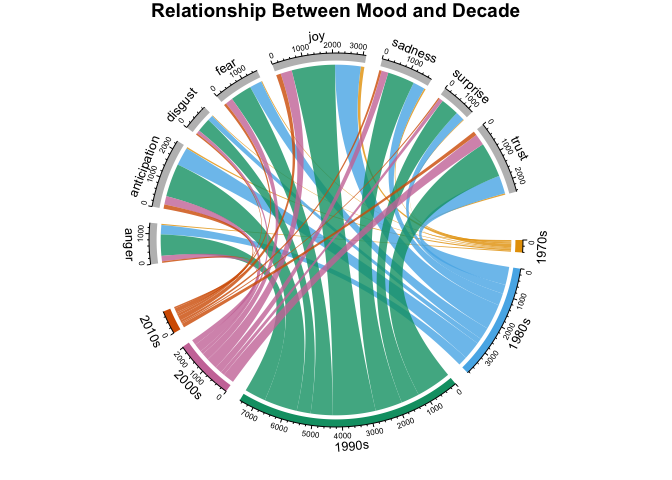
On visualise ici le nombre de mots par catégorie NRC et par décennie. Beaucoup d’informations pour un petit graphique, mais il révèle énormément de relations entre catégories et temporalité. Ces diagrammes sont extrêmement personnalisables.
Après toutes les excellentes formations suivies sur DataCamp, vous avez sans doute envie d’appliquer ces compétences au réel. Cartographiez maintenant votre analyse des paroles de Prince à des éléments concrets sur une période. Restez néanmoins prudent : le sujet est complexe et notre analyse simplifiée.
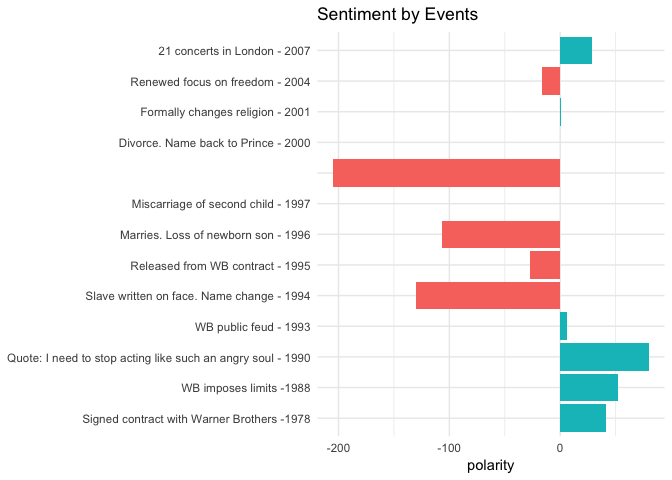
J’ai constitué une liste d’événements de la vie de Prince, à partir de sources populaires comme Rolling Stone, Biography.com, etc. J’ai sélectionné des années marquantes qui correspondent à des chansons datées dans notre jeu. Lisez ces événements depuis princeEvents.csv. Puis, à partir de prince_bing et de spread(), calculez un score de polarité par année. Rejoignez le data frame events et créez un champ de sentiment pour colorer vos barres. Comme toujours, utilisez coord_flip() avec de longues étiquettes.
events <- read.csv('princeEvents.csv', stringsAsFactors = FALSE)

year_polarity_bing <- prince_bing %>%
  group_by(year, sentiment) %>%
  count(year, sentiment) %>%
  spread(sentiment, n) %>%
  mutate(polarity = positive - negative,
         ratio = polarity / (positive + negative)) #use polarity ratio in next graph

 events %>%
   #Left join gets event years with no releases
   left_join(year_polarity_bing) %>%
   filter(event != " ") %>% #Account for bad data
   mutate(event = reorder(event, year), #Sort chart by desc year
           sentiment = ifelse(positive > negative,
                              "positive", "negative")) %>%
   ggplot(aes(event, polarity, fill = sentiment)) +
   geom_bar(stat = "identity") +
   theme_minimal() + theme(legend.position = "none") +
   xlab(NULL) +
   ggtitle("Sentiment by Events") +
   coord_flip()
Conseil : vous trouverez princeEvents.csv ici.
Comparer les événements au sentiment est fascinant. Bien que subjectifs, je les ai trouvés très corrélés. D’accord, j’ai créé ce jeu d’événements ; j’aurais pu le biaiser. Mais j’ai croisé plusieurs sources par année pour retenir les faits les plus rapportés. Ces résultats devraient vous motiver à pousser l’analyse au niveau mot pour comprendre de quoi Prince chantait.
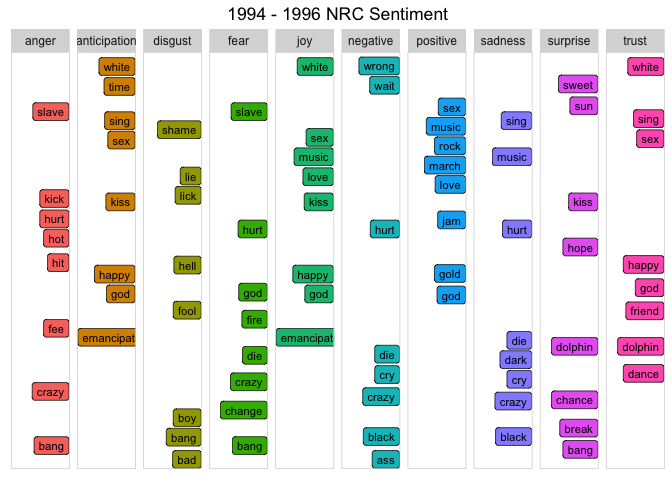
En 1994, Prince sort The Black Album pour reconquérir son public afro-américain. Étant donné que 1994 et les deux années suivantes ressortent de l’analyse, regardez les mots les plus fréquents correspondant au lexique NRC sur cette période, avec geom_label_repel() du package ggrepel et geom_point(). Le graphique est un peu délicat ; testez différents réglages du code ci-dessous.
plot_words_94_96 <- prince_nrc %>%
  filter(year %in% c("1994", "1995", "1996")) %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(8)) %>% #consider top_n() from dplyr also
  ungroup()

plot_words_94_96 %>%
  #Set `y = 1` to just plot one variable and use word as the label
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  #You want the words, not the points
  geom_point(color = "transparent") +
  #Make sure the labels don't overlap
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.04,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1994 - 1996 NRC Sentiment") +
  coord_flip()
En 1994, Prince déclare à Rolling Stone :
« Quand vous empêchez un homme de rêver, il devient esclave. C’est là que j’en étais. »
Il apparaît alors en public avec le mot « slave » écrit en gros sur le visage, affichant son rejet de sa maison de disques. Il change aussi son nom pour un symbole. Dans le graphe, observez-vous les mots "slave", "emancipation", "black" et "change" ?
(Rappel : il ne s’agit pas que de Prince. Appliquez cette méthode à tout texte ! Par exemple, quels étaient les mots les plus associés à la confiance dans les discours du président Trump durant sa première année ?)
Le graphique Sentiment par événements indiquait qu’entre 1996 et 1998, Prince s’est marié, a perdu deux enfants, et aurait prédit le 11 septembre sur scène. (Cherchez son concert de 1998 aux Pays-Bas sur YouTube pour juger par vous-même.) Reprenez la même démarche que précédemment pour extraire les 10 mots principaux de chaque catégorie NRC en 1998.
plot_words_1998 <- prince_nrc %>%
  filter(year == "1998") %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(10)) %>%
  ungroup()

#Same comments as previous graph
plot_words_1998 %>%
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  geom_point(color = "transparent") +
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.05,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1998 NRC Sentiment") +
  coord_flip()
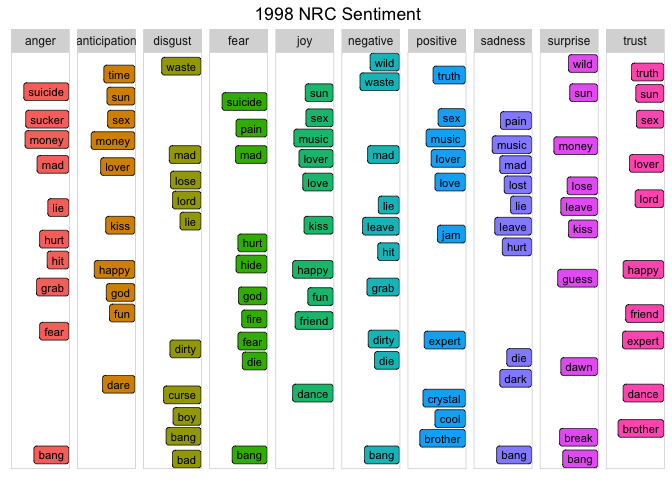
Vu les drames personnels et la menace terroriste, des mots comme "suicide", "waste", "mad", "hurt", et bien d’autres non affichés ici reflètent fidèlement les événements. Ces mots sont puissants et éclairent réellement l’humeur de l’époque.
Un autre bon moyen de comparer les sentiments par catégories est le graphique radar (ou « toile d’araignée »), via le package radarchart. Utile pour repérer les variables aux valeurs proches ou des valeurs atypiques.
Nous déclinons l’analyse à trois niveaux : année, classement, décennie. (Pour gagner de la place, je ne montre ici que le code pour les années.)
prince_nrc_sub sans les sentiments positive et negative afin de rendre les autres plus lisibles. Calculez d’abord le nombre total de mots par sentiment et par année, ainsi que le total annuel, puis obtenez un pourcentage (mots d’un sentiment / total annuel × 100).select().spread() l’année et la valeur de pourcentage en plusieurs colonnes afin d’avoir une ligne par sentiment et une colonne par année. Utilisez ensuite chartJSRadar() pour générer un widget HTML interactif. Vous pouvez afficher les libellés au survol.#Get the count of words per sentiment per year
year_sentiment_nrc <- prince_nrc_sub %>%
group_by(year, sentiment) %>%
count(year, sentiment) %>%
select(year, sentiment, sentiment_year_count = n)
#Get the total count of sentiment words per year (not distinct)
total_sentiment_year <- prince_nrc_sub %>%
count(year) %>%
select(year, year_total = n)
#Join the two and create a percent field
year_radar_chart <- year_sentiment_nrc %>%
inner_join(total_sentiment_year, by = "year") %>%
mutate(percent = sentiment_year_count / year_total * 100 ) %>%
filter(year %in% c("1978","1994","1995")) %>%
select(-sentiment_year_count, -year_total) %>%
spread(year, percent) %>%
chartJSRadar(showToolTipLabel = TRUE,
main = "NRC Years Radar")
Faites défiler pour comparer les graphes, je les ai laissés en pleine taille. Intéressant : sur un sous-ensemble plus petit comme year, on distingue mieux la variance de chaque sentiment. Vous noterez aussi que, en pourcentage, « joy » domine sur tous les graphiques (notamment au début de la carrière de Prince en 1978).
Spotify utilise le machine learning pour recommander des titres à ses 140 millions d’utilisateurs actifs. Il n’utilise pas encore les paroles. Imaginez s’il le faisait… Approfondissons maintenant l’humeur de chansons précises.
En 1987, Prince écrit "Sign O' the Times". Un article de Billboard signé Kenneth Partridge dit :
« En abordant le SIDA, les gangs, la drogue, les catastrophes naturelles, et même Challenger, Prince reste calme et détaché. 'Sign O' the Times' est un état des lieux, pas un appel à l’action. Sa solution, ce n’est pas de battre le pavé ni d’appeler votre député. »
Comment une machine interpréterait-elle l’humeur de ce morceau ? Fortement émotionnelle ou plutôt factuelle ? Représente-t-elle Prince en tant que personne ou la société en général ? Tracez les catégories NRC avec ggplot2.
prince_nrc %>%
  filter(song %in% "sign o the times") %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_minimal() + theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  ggtitle("Sign O' The Times NRC Sentiment") +
  coord_flip()
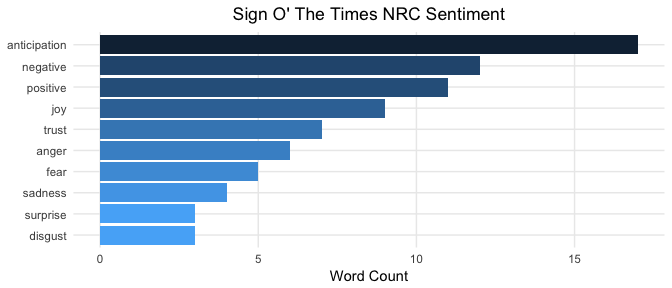
Toujours subjectif, mais vos résultats semblent confirmer que Prince « reste calme et détaché », comme l’écrit Partridge. On peut l’interpréter au vu de la prédominance des mots d’anticipation par rapport aux catégories davantage émotionnelles comme sadness, fear et anger. Cet article précise que ces trois catégories sont des émotions tandis que l’anticipation est un sentiment. L’auteur de Billboard qualifie la chanson « d’état des lieux, presque dénué d’émotion ». La machine semble d’accord. Et vous ? Même si c’est un tutoriel R, l’analyse de sentiment n’est pas que technique : on dit qu’elle est à la croisée de l’IA et de la psychologie.
Avec ggplot2, créez un graphique légèrement différent pour visualiser les mots par catégorie.
prince_tidy %>%
  filter(song %in% 'sign o the times') %>%
  distinct(word) %>%
  inner_join(get_sentiments("nrc")) %>%
  ggplot(aes(x = word, fill = sentiment)) +
  facet_grid(~sentiment) +
  geom_bar() + #Create a bar for each word per sentiment
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) + #Place the words on the y-axis
  xlab(NULL) + ylab(NULL) +
  ggtitle("Sign O' The Times Sentiment Words") +
  coord_flip()
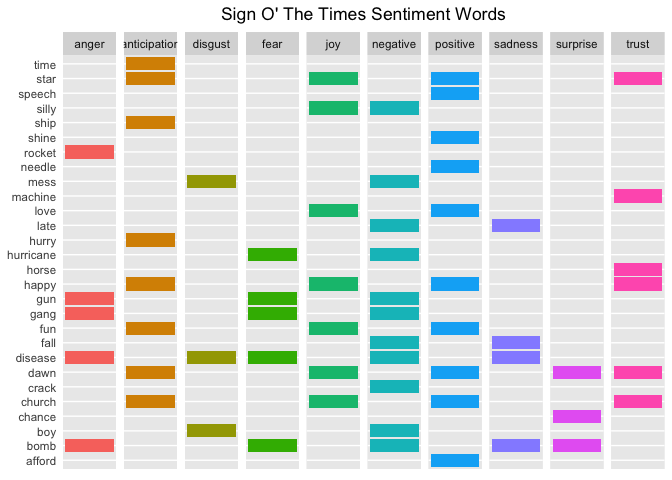
Associez-vous ces mots aux thèmes cités par Billboard ? Lien direct : catastrophe de Challenger → "rocket", SIDA → "disease", drogues → "crack", catastrophes naturelles → "hurricane", gangs → "gang", etc.
On dirait presque que Partridge a écrit un peu de code R et produit ce graphique avant d’écrire son article.
Regardez les catégories de sentiment pour quelques autres titres aux noms évocateurs et voyez si la corrélation est au rendez-vous.
prince_nrc_sub %>%
  filter(song %in% c("so blue", "controversy", "raspberry beret",
                     "when doves cry", "the future", "1999")) %>%
  count(song, sentiment, year) %>%
  mutate(sentiment = reorder(sentiment, n), song = reorder(song, n)) %>%
  ggplot(aes(sentiment, n, fill = sentiment)) +
  geom_col() +
  facet_wrap(year ~ song, scales = "free_x", labeller = label_both) +
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) +
  labs(x = NULL, y = NULL) +
  ggtitle("NRC Sentiment Song Analysis") +
  coord_flip()
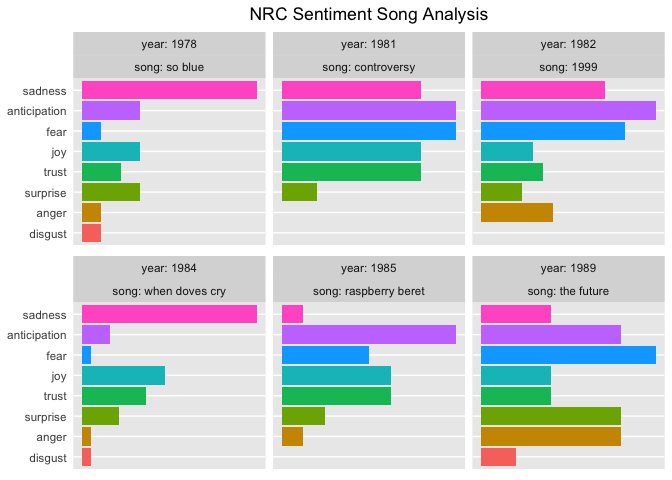
Les sentiments NRC montrent une forte anticipation et fear pour une chanson sur the future, ainsi que ces deux catégories plus une forte trust pour un titre sur la controversy. Les morceaux dominés par la tristesse collent aussi à leur titre.
Jusqu’ici, nous avons analysé des unigrams (mots seuls). Mais si "love" est fréquent, que le précède-t-il ? Et que le suit ? Regarder des mots isolés peut être trompeur. Passons donc aux bigrammes (paires de mots).
Pratique : tidytext permet aussi de tokeniser en paires. Utilisez unnest_tokens() avec l’argument token ngrams et n = 2 pour ne garder que les bigrammes. Stockez le résultat dans prince_bigrams.
Le package tidyr peut séparer les bigrammes en mots individuels via separate(). Pour supprimer stop words et indésirables, séparez d’abord, filtrez ce que vous ne voulez pas, puis unite() pour reconstituer les paires. Ainsi, vous visualiserez facilement les bigrammes les plus fréquents par décennie. (Voir la Partie un pour slice() et row_number().)
prince_bigrams <- prince_data %>%
  unnest_tokens(bigram, lyrics, token = "ngrams", n = 2)

bigrams_separated <- prince_bigrams %>%
  separate(bigram, c("word1", "word2"), sep = " ")

bigrams_filtered <- bigrams_separated %>%
  filter(!word1 %in% stop_words$word) %>%
  filter(!word2 %in% stop_words$word) %>%
  filter(!word1 %in% undesirable_words) %>%
  filter(!word2 %in% undesirable_words)

#Because there is so much repetition in music, also filter out the cases where the two words are the same
bigram_decade <- bigrams_filtered %>%
  filter(word1 != word2) %>%
  filter(decade != "NA") %>%
  unite(bigram, word1, word2, sep = " ") %>%
  inner_join(prince_data) %>%
  count(bigram, decade, sort = TRUE) %>%
  group_by(decade) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  arrange(decade, n) %>%
  mutate(row = row_number())
## Joining, by = c("song", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level", "charted")bigram_decade %>%
ggplot(aes(row, n, fill = decade)) +
geom_col(show.legend = FALSE) +
facet_wrap(~decade, scales = "free_y") +
xlab(NULL) + ylab(NULL) +
scale_x_continuous( # This handles replacement of row
breaks = bigram_decade$row, # Notice need to reuse data frame
labels = bigram_decade$bigram) +
theme_lyrics() +
theme(panel.grid.major.x = element_blank()) +
ggtitle("Bigrams Per Decade") +
coord_flip()
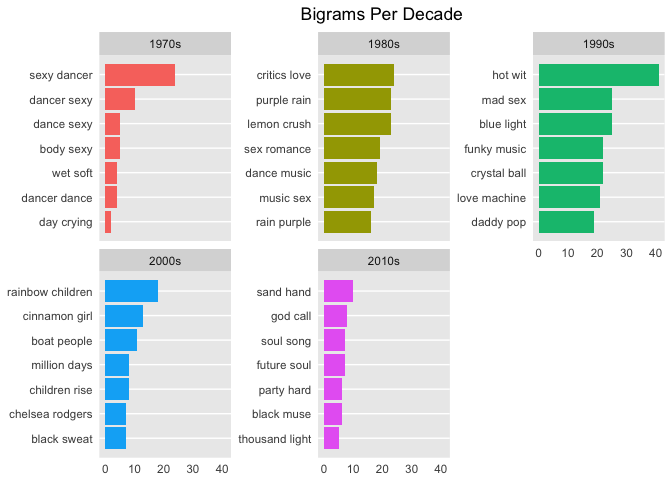
Avec les bigrammes, on devine presque l’évolution des thèmes : du sexe, de la danse et de la romance vers la religion et les (rainbow) children. Pour info, un « rainbow baby » désigne parfois un enfant conçu après la perte d’un bébé. Fait intéressant : je n’ai pas trouvé de critique de l’album Rainbow Children de Prince qui mentionne cela.
Comment les bigrammes influencent-ils le sentiment ? Utilisons cette fois le lexique AFINN pour analyser les paires de mots, en observant la fréquence des mots à sentiment précédés de "not" ou d’autres négations.
AFINN <- get_sentiments("afinn")

not_words <- bigrams_separated %>%
  filter(word1 == "not") %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word2, score, sort = TRUE) %>%
  ungroup()

not_words %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  head(20) %>%
  mutate(word2 = reorder(word2, contribution)) %>%
  ggplot(aes(word2, n * score, fill = n * score > 0)) +
  geom_col(show.legend = FALSE) +
  theme_lyrics() +
  xlab("Words preceded by \"not\"") +
  ylab("Sentiment score * Number of Occurrences") +
  ggtitle("Polar Sentiment of Words Preceded by Not") +
  coord_flip()
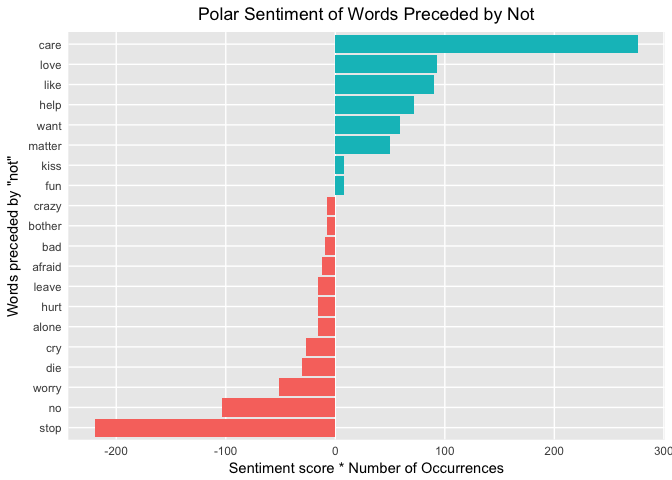
Sur la première ligne, care obtient un faux positif car le "not" est ignoré par l’analyse à mot unique. Les bigrammes faux positifs compensent-ils les faux négatifs ?
Encore une question ouverte, mais un excellent sujet d’exploration. Conseil : vous pouvez aussi passer « trigrams » et n = 3 à unnest_tokens() pour analyser trois mots consécutifs.
Il existe d’autres mots de négation à considérer. Créons un graphe de réseau avec ggraph et igraph. Disposez les mots en nœuds reliés, avec les négations au centre. Créez l’objet à partir du jeu « tidy » avec graph_from_data_frame(), puis tracez via ggraph(). Mettez en valeur les nœuds principaux avec geom_edge_density(). Pour un exemple proche, voyez le livre de Julia Silge et David Robinson sur la fouille de texte « tidy ».
negation_words <- c("not", "no", "never", "without")

negation_bigrams <- bigrams_separated %>%
  filter(word1 %in% negation_words) %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word1, word2, score, sort = TRUE) %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  group_by(word1) %>%
  slice(seq_len(20)) %>%
  arrange(word1,desc(contribution)) %>%
  ungroup()

bigram_graph <- negation_bigrams %>%
  graph_from_data_frame() #From `igraph`

set.seed(123)

a <- grid::arrow(type = "closed", length = unit(.15, "inches"))

ggraph(bigram_graph, layout = "fr") +
  geom_edge_link(alpha = .25) +
  geom_edge_density(aes(fill = score)) +
  geom_node_point(color = "purple1", size = 1) + #Purple for Prince!
  geom_node_text(aes(label = name),  repel = TRUE) +
  theme_void() + theme(legend.position = "none",
                       plot.title = element_text(hjust = 0.5)) +
  ggtitle("Negation Bigram Network")
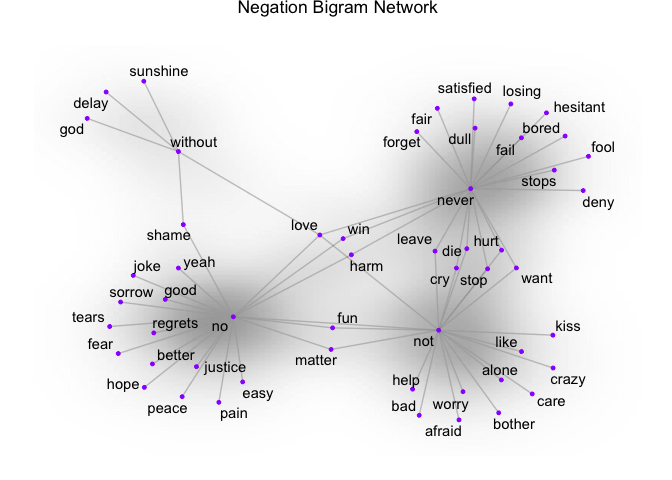
Vous voyez ici les paires associées aux négations. Si votre analyse repose sur les unigrams et que "alone" ressort négatif, le bigramme "not alone" aura l’effet inverse. Certains mots se connectent à plusieurs nœuds, visible sur ce type de visuel : par exemple, "never hurt" et "not hurt".
Puisque vous avez étudié les n-grammes, regardez la corrélation entre mots. Quels mots sont le plus corrélés ? Utilisez pairwise_count() du package widyr pour repérer les cooccurrences : le nombre de fois où chaque paire apparaît ensemble dans une chanson. widyr prend un jeu « tidy », le met temporairement en large, puis le remet en « tidy » pour la visualisation et l’analyse.
Pour rester simple, j’ai retenu quatre mots intéressants chez Prince.
pwc <- prince_tidy %>%
  filter(n() >= 20) %>%  #High counts
  pairwise_count(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  mutate(row = -row_number()) #Descending order

pwc %>%
  ggplot(aes(row, n, fill = item1)) +
  geom_bar(stat = "identity", show.legend = FALSE) +
  facet_wrap(~item1, scales = "free") +
  scale_x_continuous(  #This handles replacement of row
      breaks = pwc$row, #Notice need to reuse data frame
      labels = pwc$item2) +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Counts") +
  coord_flip()
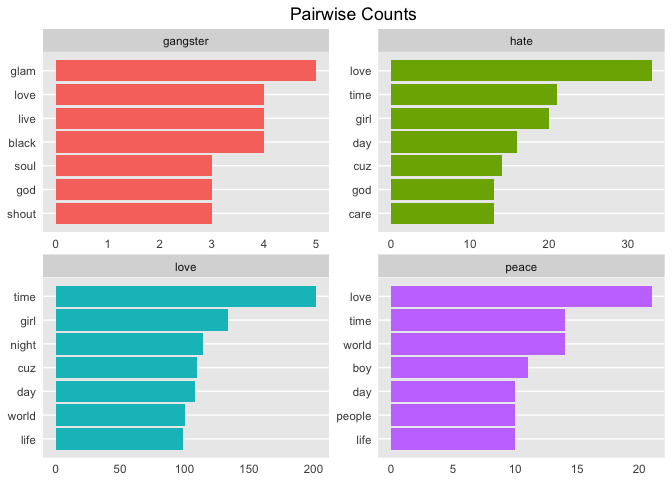
Comparez avec la corrélation par paires : fréquence d’apparition conjointe rapportée à la fréquence d’apparition séparée. Utilisez pairwise_cor() pour la corrélation entre mots selon leurs cooccurrences dans la même chanson.
prince_tidy %>%
  group_by(word) %>%
  filter(n() >= 20) %>%
  pairwise_cor(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  top_n(7) %>%
  ungroup() %>%
  mutate(item2 = reorder(item2, correlation)) %>%
  ggplot(aes(item2, correlation, fill = item1)) +
  geom_bar(stat = 'identity', show.legend = FALSE) +
  facet_wrap(~item1, scales = 'free') +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Correlation") +
  coord_flip()
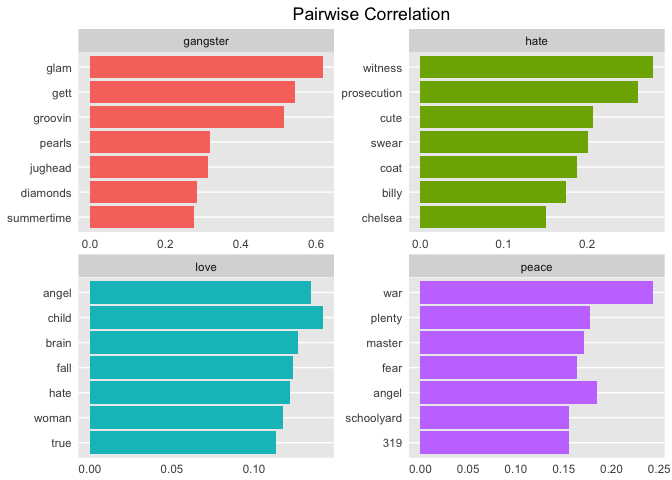
Ces aperçus sont passionnants, rien qu’avec ces quatre mots ! En observant ces résultats, on commence à voir émerger des thématiques. Une parfaite transition vers le prochain tutoriel sur la modélisation de sujets.
Dans ce tutoriel, vous avez créé un jeu « tidy », analysé des informations de base comme la diversité lexicale et le nombre de chansons par année, puis examiné la relation entre décennie de sortie et présence au classement. Vous avez ensuite exploré des lexiques de sentiment et leur adéquation avec les paroles. Vous avez analysé le sentiment sur l’ensemble des morceaux, dans le temps, au niveau des chansons, ainsi que l’impact des bigrammes. Tout cela à l’aide d’une grande variété de graphiques, chacun apportant un angle différent.
Peut-on écrire un programme pour détecter l’humeur des paroles ? Oui. La fiabilité dépend-elle de nombreux facteurs ? Absolument : niveau de préparation des données, choix du lexique, méthode d’analyse, qualité des sources, etc. Mettre en regard les événements réels, personnels et sociétaux, éclaire l’humeur d’un texte. Chez Prince, la polarité semble décliner légèrement au fil du temps, mais dans l’ensemble, la joie ressort. Les titres classés paraissent plus positifs que les non classés. Les « prédictions » du 11 septembre et de sa propre mort semblent étrangement résonner avec ses mots.
Mais les paroles sont complexes, et trop d’hypothèses peuvent induire en erreur. En emportant ces enseignements vers la Partie Deux-B, consacrée à la modélisation de sujets, vous serez bien armé pour dégager thèmes et motifs. Jusqu’où peut-on faire du NLP sur des paroles sans ponctuation ni structure de phrase ? De quoi Prince parlait-il vraiment ? Maintenant que vous percevez l’humeur, vous êtes mieux préparé pour explorer les thématiques. Enfin, peut-on appliquer le machine learning pour prédire la décennie ou le niveau de classement d’un titre ? Retrouvez-moi dans les prochains tutoriels pour le découvrir !
J’espère que le voyage vous a plu jusqu’ici. En Partie Deux-B, on va faire la fête comme en 1999 !
En savoir plus sur R
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {blog} other {blogs}}
Kurtis Pykes
15 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Josef Waples
8 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Aditya Sharma
5 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Laiba Siddiqui
14 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Samuel Shaibu
9 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Sejal Jaiswal
24 min