Khóa học
Phân tích cảm xúc trong R
4 giờ
14.2K
Hãy cùng thực hiện một Hành Trình Cảm Xúc xuyên suốt cuộc đời và thời đại của Prince, The Artist, trong Phần Hai-A của chuỗi hướng dẫn gồm ba phần, sử dụng phân tích cảm xúc với R để soi rọi sự nghiệp và tầm ảnh hưởng xã hội của The Artist. Ba bài hướng dẫn bao gồm:
Nếu bạn muốn tìm hiểu thêm về phân tích cảm xúc, đừng quên xem khóa học Sentiment Analysis in R: The Tidy Way của chúng tôi.
Bạn có biết Prince đã “dự đoán” sự kiện 11/9 trên sân khấu ba năm trước khi nó xảy ra? Anh ấy thậm chí có thể đã dự báo về cái chết của chính mình. Điều này có thể đúng không? Sẽ thật thú vị nếu xem xét ca từ của anh ấy và tự đưa ra nhận định có cơ sở, phải không? Ngày 21 tháng 4 năm 1985, anh thu âm "Sometimes It Snows In April". Chính xác 31 năm sau, vào ngày 21 tháng 4 năm 2016, anh qua đời. Hãy xem lựa chọn ngôn từ của anh ấy trong phân tích cảm xúc của bài hát này:
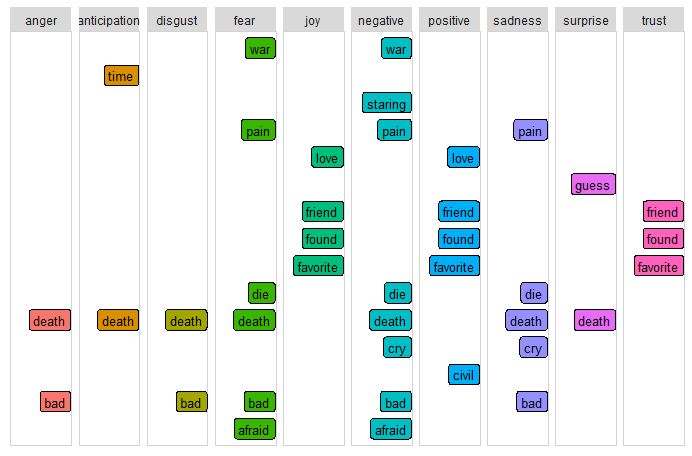
Điều này mang lại một ý nghĩa mới cho phân tích Dự đoán!
Mỗi đoạn mã đều được theo sau bởi một nhận định, thường mang tính chủ quan. Bạn cứ thoải mái di chuyển giữa các phần và tự đưa ra giả định của riêng mình nếu muốn! Tôi khuyến nghị đọc phần giới thiệu sau đây, nhưng nếu bạn muốn vào thẳng phần mã, nhấp vào đây. Nếu bạn đã hiểu khái niệm đằng sau các bộ từ vựng (lexicon), bạn có thể đi đường tắt bằng cách chuyển thẳng đến phần phân tích chi tiết.
Tôi vừa cứu hai chú mèo con và một chú cún, nên giờ tôi hay nghĩ theo “bộ ba”. Hơn nữa, quy tắc số ba là một nguyên tắc viết cho rằng những thứ xuất hiện theo bộ ba thường hài hước hơn, thỏa mãn hơn, hoặc hiệu quả hơn so với các con số hay nhóm khác - đó là lý do tôi chia nội dung thành ba phần... Vậy nên, trong Phần Một, bạn đã được giới thiệu khai phá văn bản và phân tích khám phá với một tập dữ liệu gồm hàng trăm ca từ của nghệ sĩ huyền thoại Prince. Ở Phần Hai, bạn sẽ tập trung vào phân tích cảm xúc (Hai-A) và mô hình chủ đề (Hai-B) với NLP. Phần Ba sẽ kết lại với các tác vụ phân tích dự đoán bổ sung bằng kỹ thuật học máy, giải đáp các câu hỏi như liệu có thể xác định thập niên phát hành của một bài hát, hoặc thú vị hơn, dự đoán liệu một bài hát có lọt vào bảng xếp hạng Billboard dựa trên ca từ của nó hay không. Xuyên suốt loạt bài, bạn sẽ sử dụng nhiều thuật toán học máy khác nhau - mỗi thuật toán được tô đỏ trong hình dưới đây.
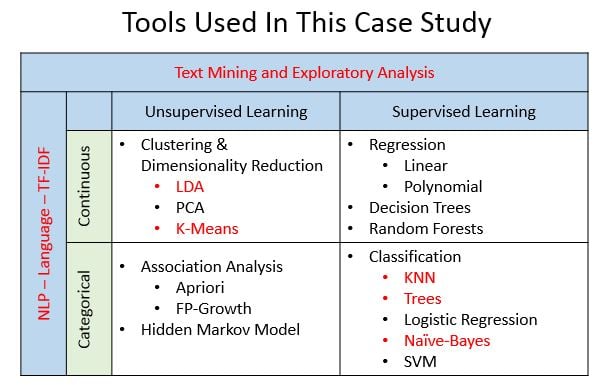
Đúng là tôi đã “chốt” chỉ ba phần, nhưng tôi quyết định chia nhỏ Phần Hai thành Hai-A (Phân tích cảm xúc) và Hai-B (Mô hình chủ đề - sắp ra mắt), thành bốn bài hướng dẫn riêng biệt. Có rất nhiều bài viết và khóa học tuyệt vời về quy trình phân tích cảm xúc, nên mục tiêu của Phần Hai-A là tập trung vào việc rút ra insight từ phân tích - không chỉ là viết mã. Bạn sẽ dùng ca từ của Prince làm ví dụ, nhưng có thể áp dụng các bước này cho nghệ sĩ yêu thích của riêng bạn. Hy vọng hành trình qua trọn bộ hướng dẫn sẽ khơi gợi sự tò mò về cơ hội mà phân tích ca từ mang lại, đồng thời giới thiệu đến bạn các kỹ thuật Xử lý ngôn ngữ tự nhiên (NLP) và học máy.
Phần Hai-A của chuỗi hướng dẫn này yêu cầu hiểu biết cơ bản về dữ liệu tidy - cụ thể là các gói như dplyr để biến đổi dữ liệu, ggplot2 để trực quan hóa, và toán tử %>% pipe (ban đầu từ gói magrittr). Bạn sẽ thấy nhiều bước thường được kết hợp bằng toán tử %>% để giữ cho mã gọn gàng và có thể tái sử dụng.
Vì đây cũng là một nghiên cứu tình huống, bài có rất nhiều hình trực quan vượt ra ngoài các biểu đồ thường gặp. Do đó, một yêu cầu khác là bạn có thể cài đặt gói mới trong môi trường của mình. Để tập trung vào việc khai thác insight, tôi đã đưa vào những đoạn mã có thể tái sử dụng với bộ dữ liệu của bạn, nhưng giải thích chi tiết sẽ đòi hỏi bạn tự tìm hiểu thêm. Liên kết hỗ trợ sẽ được cung cấp cho từng gói. Cách tiếp cận này sẽ giúp bạn làm quen với công cụ mới đồng thời tập trung vào ứng dụng của chúng.
Mẹo: hãy đọc Phần Một trước để có nền tảng cho chuỗi hướng dẫn và hiểu về vốn từ dày đặc và đa dạng trong ca từ của Prince.
Phương pháp: Phân tích cảm xúc là một dạng khai phá văn bản nhằm xác định quan điểm và tính chủ quan trong nội dung. Khi áp dụng cho ca từ, kết quả không chỉ phản ánh thái độ của nghệ sĩ mà còn có thể hé lộ những ảnh hưởng văn hóa rộng khắp. Có nhiều phương pháp dùng cho phân tích cảm xúc, bao gồm huấn luyện trên một tập dữ liệu đã biết, tự xây bộ phân loại bằng luật, và dùng các từ điển từ vựng định sẵn (lexicon). Trong hướng dẫn này, bạn sẽ dùng phương pháp dựa trên lexicon, nhưng tôi khuyến khích bạn tìm hiểu thêm các phương pháp khác cũng như các đánh đổi đi kèm.
Cấp độ: Cũng như có nhiều phương pháp, phân tích cảm xúc còn có các cấp độ khác nhau dựa trên văn bản. Các cấp độ thường được xác định là tài liệu, câu và từ. Với ca từ, tài liệu có thể được định nghĩa là cảm xúc theo thập niên, năm, cấp độ bảng xếp hạng, hoặc theo bài hát. Cấp độ câu thường không phù hợp vì dấu câu có thể làm giảm vần điệu và nhịp điệu. Phân tích ở cấp từ cho thấy thông tin chi tiết và có thể làm nền tảng cho các thực hành nâng cao hơn trong mô hình chủ đề.
Mọi dự án khoa học dữ liệu đều cần một tập câu hỏi để khám phá. Dưới đây là vài câu để bạn ghi nhớ khi làm theo hướng dẫn này: liệu có thể viết một chương trình xác định tâm trạng thể hiện trong ca từ? Các lexicon định sẵn có đủ dùng không? Cần chuẩn bị dữ liệu đến mức nào? Bạn có thể liên hệ kết quả với các sự kiện đời thực không? Cảm xúc có thay đổi theo thời gian không? Những bài hit tích cực hay tiêu cực hơn so với bài không vào bảng xếp hạng? Những từ nào nổi bật trong ca từ ở năm được cho là Prince dự đoán sự kiện 11/9? Anh ấy có dự đoán cái chết của chính mình không?
Mẹo: phân tích ca từ rất khác và thường phức tạp hơn diễn văn hay sách vở, khiến việc rút ra insight trở nên khó khăn, nên hãy thận trọng với mọi giả định! Trong bài này, tôi sẽ đưa ra nhiều câu hỏi hơn câu trả lời, nên hãy sẵn sàng “nghĩ ngoài hình bình hành tứ giác” nhé!
Để bắt đầu phân tích ca từ của Prince, hãy nạp các thư viện dưới đây. Ban đầu có vẻ nhiều, nhưng phần lớn chỉ để vẽ biểu đồ. Do thường xuyên dùng hình ảnh, nên tốt hơn là định nghĩa một bảng màu chuẩn để đảm bảo nhất quán. Tôi đã tạo một danh sách dùng mã màu ANSI cụ thể. Hàm theme() từ ggplot2 cho phép tùy biến từng biểu đồ, vì vậy bạn cũng sẽ tạo hàm riêng, theme_lyrics(), để điều chỉnh các thiết lập mặc định. Gói knitr là động cơ tạo báo cáo động với R. Hãy dùng cùng với kableExtra và formattable để tạo bảng văn bản bắt mắt có màu sắc. Một lần nữa, hãy tạo hàm riêng my_kable_styling() để tiêu chuẩn hóa đầu ra của các thư viện này. Tôi sẽ đề cập đến các gói khác khi sử dụng.
library(dplyr) #Data manipulation (also included in the tidyverse package)
library(tidytext) #Text mining
library(tidyr) #Spread, separate, unite, text mining (also included in the tidyverse package)
library(widyr) #Use for pairwise correlation

#Visualizations!
library(ggplot2) #Visualizations (also included in the tidyverse package)
library(ggrepel) #`geom_label_repel`
library(gridExtra) #`grid.arrange()` for multi-graphs
library(knitr) #Create nicely formatted output tables
library(kableExtra) #Create nicely formatted output tables
library(formattable) #For the color_tile function
library(circlize) #Visualizations - chord diagram
library(memery) #Memes - images with plots
library(magick) #Memes - images with plots (image_read)
library(yarrr)  #Pirate plot
library(radarchart) #Visualizations
library(igraph) #ngram network diagrams
library(ggraph) #ngram network diagrams

#Define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#Customize ggplot2's default theme settings
#This tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #Center the title
        axis.ticks = aticks, #Set axis ticks to on or off
        panel.grid.minor = pgminor, #Turn the minor grid lines on or off
        legend.title = lt, #Turn the legend title on or off
        legend.position = lp) #Turn the legend on or off
}

#Customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}
Như thường lệ, bạn sẽ bắt đầu bằng cách đọc dữ liệu thô vào một data frame. Ở Phần Một, bạn đã xử lý sơ bộ bộ dữ liệu gốc, như mở rộng dạng rút gọn, loại chuỗi escape, và chuyển văn bản về chữ thường. Bạn đã lưu bộ dữ liệu sạch đó vào tệp CSV để dùng cho bài này. Dùng read.csv() để tạo prince_data và lưu ý rằng bạn muốn ca từ ở dạng chuỗi ký tự, nên hãy đặt stringsAsFactors = FALSE. Vì không cần đánh số dòng, đặt row.names = 1.
Lưu ý bạn có thể tránh dùng các tham số này bằng cách đọc vào một data frame hiện đại gọi là tibble, dùng read_csv(), nhưng để nhất quán với Phần Một, ta dùng read.csv().
prince_data <- read.csv('prince_new.csv', stringsAsFactors = FALSE, row.names = 1)
Xem nhanh dữ liệu:
glimpse(prince_data) #Transposed version of `print()`## Observations: 824
## Variables: 10
## $ lyrics <chr> "all 7 and we will watch them fall they stand in t...
## $ song <chr> "7", "319", "1999", "2020", "3121", "7779311", "u"...
## $ year <int> 1992, NA, 1982, NA, 2006, NA, NA, NA, NA, NA, NA, ...
## $ album <chr> "Symbol", NA, "1999", "Other Songs", "3121", NA, N...
## $ peak <int> 3, NA, 2, NA, 1, NA, NA, NA, NA, NA, NA, NA, NA, N...
## $ us_pop <chr> "7", NA, "12", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ us_rnb <chr> "61", NA, "4", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ decade <chr> "1990s", NA, "1980s", NA, "2000s", NA, NA, NA, NA,...
## $ chart_level <chr> "Top 10", "Uncharted", "Top 10", "Uncharted", "Top...
## $ charted <chr> "Charted", "Uncharted", "Charted", "Uncharted", "C...Bạn có thể thấy prince_data là một data frame gồm 824 bài hát và 10 cột. Điều này có nghĩa là mỗi bản ghi chính là một bài hát, theo đúng nghĩa đen!
prince_tidyVài bước xử lý dữ liệu còn lại:
Để biến dữ liệu thô thành định dạng tidy, dùng unnest_tokens() từ tidytext để tạo prince_tidy, tách ca từ thành từng từ với mỗi hàng là một từ. Sau đó, bạn có thể dùng anti_join() và filter() từ dplyr cho các bước làm sạch còn lại. (Xem Phần Một để biết giải thích chi tiết.)
#Created in the first tutorial
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats", "la", "da", "uh", "ah")

#Create tidy text format: Unnested, Unsummarized, -Undesirables, Stop and Short words
prince_tidy <- prince_data %>%
  unnest_tokens(word, lyrics) %>% #Break the lyrics into individual words
  filter(!word %in% undesirable_words) %>% #Remove undesirables
  filter(!nchar(word) < 3) %>% #Words like "ah" or "oo" used in music
  anti_join(stop_words) #Data provided by the tidytext package
glimpse(prince_tidy) #From `dplyr`, better than `str()`.
 ## Observations: 76,116
## Variables: 10
## $ song        <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ year        <int> 1992, 1992, 1992, 1992, 1992, 1992, 1992, 1992, 19...
## $ album       <chr> "Symbol", "Symbol", "Symbol", "Symbol", "Symbol", ...
## $ peak        <int> 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3,...
## $ us_pop      <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ us_rnb      <chr> "61", "61", "61", "61", "61", "61", "61", "61", "6...
## $ decade      <chr> "1990s", "1990s", "1990s", "1990s", "1990s", "1990...
## $ chart_level <chr> "Top 10", "Top 10", "Top 10", "Top 10", "Top 10", ...
## $ charted     <chr> "Charted", "Charted", "Charted", "Charted", "Chart...
## $ word        <chr> "watch", "fall", "stand", "love", "smoke", "intell...
Bộ dữ liệu mới của bạn, prince_tidy, giờ đã ở dạng đã token hóa với mỗi hàng là một từ kèm bài hát chứa từ đó. Bạn hiện có một data frame gồm 76.116 từ và 10 cột.
Nếu bạn chưa đọc Phần Một, bạn có thể cần xem qua vài biểu đồ tóm tắt của toàn bộ dữ liệu. Bạn sẽ làm điều này bằng các biểu đồ sáng tạo từ các gói ggplot2, circlize và yarrr.
Một tên cướp biển sẽ nói shipshape khi mọi thứ gọn gàng, sạch sẽ, đâu vào đấy. Dưới đây là một góc nhìn thú vị về dữ liệu sạch và tidy thể hiện sự đa dạng từ vựng, hay nói cách khác là vốn từ, của ca từ theo thời gian. Biểu đồ cướp biển là một phương pháp nâng cao để vẽ một biến phụ thuộc liên tục, như số lượng từ, theo một biến độc lập phân loại, như thập niên. Cách này kết hợp điểm dữ liệu gốc, thống kê mô tả và suy luận vào một biểu đồ hiệu quả duy nhất. Xem bài blog hay này để biết thêm chi tiết về pirateplot() từ gói yarrr.
Tạo data frame word_summary để tính số từ phân biệt theo từng bài. Ca từ càng đa dạng, vốn từ càng lớn. Suy nghĩ dữ liệu theo cách này giúp bạn sẵn sàng cho phân tích ở cấp từ. Đặt lại trường thập niên về giá trị "NONE" cho những bài chưa có ngày phát hành và đổi nhãn những trường đó cho gọn bằng select().
word_summary <- prince_tidy %>%
  mutate(decade = ifelse(is.na(decade),"NONE", decade)) %>%
  group_by(decade, song) %>%
  mutate(word_count = n_distinct(word)) %>%
  select(song, Released = decade, Charted = charted, word_count) %>%
  distinct() %>% #To obtain one record per song
  ungroup()

pirateplot(formula =  word_count ~ Released + Charted, #Formula
   data = word_summary, #Data frame
   xlab = NULL, ylab = "Song Distinct Word Count", #Axis labels
   main = "Lexical Diversity Per Decade", #Plot title
   pal = "google", #Color scheme
   point.o = .2, #Points
   avg.line.o = 1, #Turn on the Average/Mean line
   theme = 0, #Theme
   point.pch = 16, #Point `pch` type
   point.cex = 1.5, #Point size
   jitter.val = .1, #Turn on jitter to see the songs better
   cex.lab = .9, cex.names = .7) #Axis label size
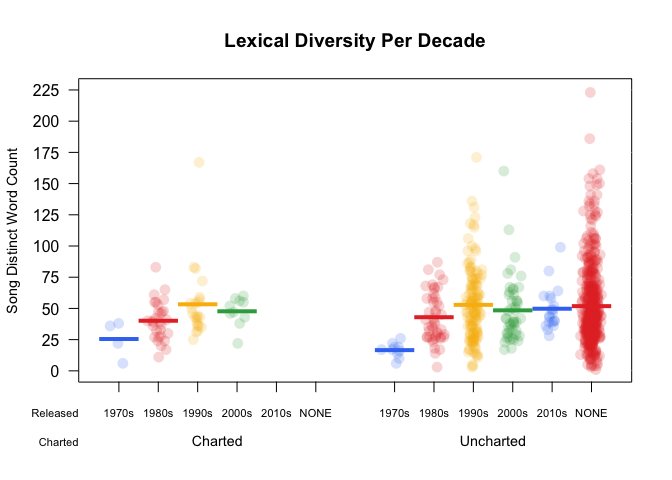
Mỗi vòng tròn có màu trong biểu đồ cướp biển này đại diện cho một bài hát. Vùng đỏ đậm với giá trị "NONE" cho thấy có rất nhiều bài trong dữ liệu chưa có ngày phát hành. Có một xu hướng tăng nhẹ về số từ phân biệt theo bài trong các thập niên đầu: đường ngang liền thể hiện số từ trung bình cho thập niên đó. Điều này quan trọng khi bạn bắt đầu phân tích cảm xúc theo thời gian. Từ ngữ trở nên “khai sáng” hơn xuyên suốt sự nghiệp của Prince.
Tôi thách thức bạn tìm hiểu sâu hơn về biểu đồ cướp biển, vì ở đây mới chỉ là bề nổi!
Biểu đồ tròn là một cách độc đáo để trực quan hóa các mối quan hệ phức tạp (hoặc đơn giản!) giữa nhiều hạng mục. (Vả lại, đĩa nhạc ngày xưa cũng hình tròn!). Biểu đồ dưới đây là biểu đồ cột tròn sử dụng coord_polar() từ ggplot2 để hiển thị số bài hát tương đối theo năm. Phải viết khá nhiều mã cho một biểu đồ đơn giản như vậy, nhưng hoàn toàn xứng đáng. Một ví dụ tương tự có thể xem chi tiết hơn trong R Graph Gallery tại đây. Cũng như với biểu đồ cướp biển, đây chỉ là phần mở đầu cho những gì bạn có thể làm với biểu đồ tròn.
songs_year <- prince_data %>%
  select(song, year) %>%
  group_by(year) %>%
  summarise(song_count = n())

id <- seq_len(nrow(songs_year))
songs_year <- cbind(songs_year, id)
label_data = songs_year
number_of_bar = nrow(label_data) #Calculate the ANGLE of the labels
angle = 90 - 360 * (label_data$id - 0.5) / number_of_bar #Center things
label_data$hjust <- ifelse(angle < -90, 1, 0) #Align label
label_data$angle <- ifelse(angle < -90, angle + 180, angle) #Flip angle
ggplot(songs_year, aes(x = as.factor(id), y = song_count)) +
  geom_bar(stat = "identity", fill = alpha("purple", 0.7)) +
  geom_text(data = label_data, aes(x = id, y = song_count + 10, label = year, hjust = hjust), color = "black", alpha = 0.6, size = 3, angle =  label_data$angle, inherit.aes = FALSE ) +
  coord_polar(start = 0) +
  ylim(-20, 150) + #Size of the circle
  theme_minimal() +
  theme(axis.text = element_blank(),
        axis.title = element_blank(),
        panel.grid = element_blank(),
        plot.margin = unit(rep(-4,4), "in"),
        plot.title = element_text(margin = margin(t = 10, b = -10)))
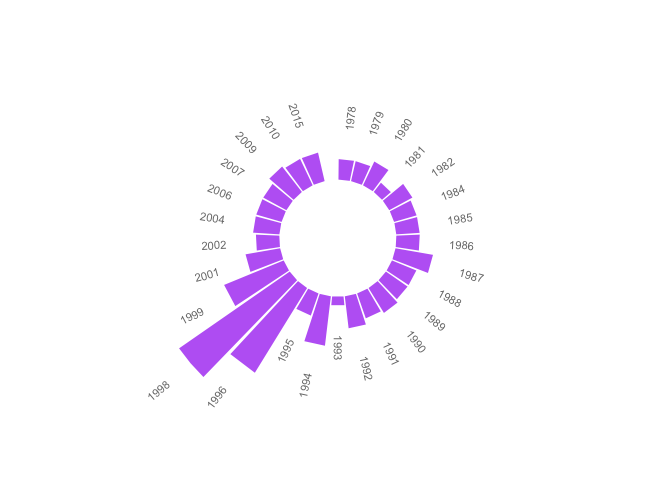
Thấy khoảng trống ở trên cùng chứ? Đây là dấu hiệu cho hàng trăm bài hát không có ngày phát hành mà bạn đã nhận diện ở biểu đồ cướp biển. Với số lượng bài chưa phát hành lớn như vậy, biểu đồ sẽ không hữu ích nếu đưa chúng vào. Những năm bị thiếu thể hiện thời điểm không có bài hát nào được phát hành. Hai năm sung mãn nhất là 1996 và 1998.
Muốn biết tại sao không? Đọc tiếp nhé!
Biểu đồ sau cho thấy mối quan hệ giữa thập niên phát hành và việc bài hát có lọt bảng Billboard hay không. Dùng chordDiagram() cho phân tích âm nhạc nghe chừng rất hợp lý! Công cụ đồ họa này đến từ gói circlize tuyệt đẹp của Zuguang Gu. Biểu đồ được chia thành hai nhóm: lọt bảng (trên) và thập niên (dưới). Hai nhóm được tách bằng khoảng cách rộng, với khoảng cách nhỏ hơn giữa các giá trị. Phần chú thích cấp cao trong đoạn mã dưới có thể được bổ sung chi tiết tại đây.
decade_chart <-  prince_data %>%
  filter(decade != "NA") %>% #Remove songs without release dates
  count(decade, charted)  #Get SONG count per chart level per decade. Order determines top or bottom.

circos.clear() #Very important - Reset the circular layout parameters!
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "Charted" = "grey", "Uncharted" = "grey") #assign chord colors
# Set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_chart[[1]])) - 1), 15,
                         rep(5, length(unique(decade_chart[[2]])) - 1), 15))

chordDiagram(decade_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Chart and Decade")
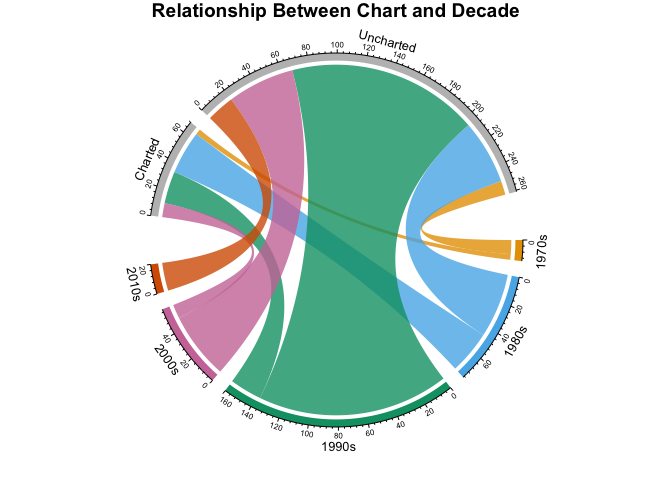
Biểu đồ tròn trên có vẻ phức tạp lúc đầu, nhưng nó minh họa đẹp số lượng bài theo thập niên và theo cấp độ bảng xếp hạng. Bạn có thể thấy Prince bắt đầu sự nghiệp vào thập niên 1970 với chỉ vài bản phát hành, một số trong đó có lọt bảng. Nếu so sánh thập niên 1980 với 1990, bạn sẽ thấy có nhiều bài được phát hành hơn trong thập niên 1990, nhưng nhiều bài lọt bảng hơn ở thập niên 1980. Chỉ có vài bài thành công về mặt thương mại trong thập niên 2000 và không có bài hit nào trong thập niên 2010.
Trong phần này bạn sẽ:
Gói tidytext bao gồm một tập dữ liệu tên là sentiments cung cấp một số lexicon khác nhau. Các lexicon này là từ điển những từ được gán hạng mục hoặc giá trị cảm xúc. tidytext cung cấp ba lexicon mục đích chung:
Để xem xét các lexicon, hãy tạo một data frame tên new_sentiments. Lọc bỏ lexicon tài chính, tạo một trường cảm xúc nhị phân (còn gọi là polar) cho lexicon AFINN bằng cách chuyển điểm số thành tích cực hoặc tiêu cực, và thêm một trường chứa số lượng từ phân biệt cho mỗi lexicon.
new_sentiments có một cột với các hạng mục cảm xúc khác nhau, vì vậy để nhìn rõ hơn số lượng từ theo lexicon, theo hạng mục, hãy dùng spread() từ tidyr để xoay các hạng mục thành các trường riêng. Tận dụng các gói knitr và kableExtra trong hàm my_kable_styling() bạn đã tạo trước đó. Thêm màu cho biểu đồ bằng color_tile() và color_bar() từ formattable để tạo một bảng được định dạng đẹp mắt. In bảng ra và xem khác biệt giữa các lexicon.
new_sentiments <- sentiments %>% #From the tidytext package
  filter(lexicon != "loughran") %>% #Remove the finance lexicon
  mutate( sentiment = ifelse(lexicon == "AFINN" & score >= 0, "positive",
                              ifelse(lexicon == "AFINN" & score < 0,
                                     "negative", sentiment))) %>%
  group_by(lexicon) %>%
  mutate(words_in_lexicon = n_distinct(word)) %>%
  ungroup()

new_sentiments %>%
  group_by(lexicon, sentiment, words_in_lexicon) %>%
  summarise(distinct_words = n_distinct(word)) %>%
  ungroup() %>%
  spread(sentiment, distinct_words) %>%
  mutate(lexicon = color_tile("lightblue", "lightblue")(lexicon),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon)) %>%
  my_kable_styling(caption = "Word Counts Per Lexicon")
| lexicon | words_in_lexicon | anger | anticipation | disgust | fear | joy | negative | positive | sadness | surprise | trust |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AFINN | 2476 | NA | NA | NA | NA | NA | 1597 | 879 | NA | NA | NA |
| bing | 6785 | NA | NA | NA | NA | NA | 4782 | 2006 | NA | NA | NA |
| nrc | 6468 | 1247 | 839 | 1058 | 1476 | 689 | 3324 | 2312 | 1191 | 534 | 1231 |
Bảng trên giúp bạn hình dung kích thước và cấu trúc của từng lexicon.
Để xác định lexicon nào phù hợp hơn với ca từ, bạn sẽ muốn xem tỷ lệ khớp giữa các từ xuất hiện đồng thời trong lexicon và ca từ. Nhắc lại, có 76.116 từ tổng cộng và 7.851 từ phân biệt trong prince_tidy.
Vậy có bao nhiêu từ trong số đó thực sự nằm trong các lexicon?
Dùng inner_join() giữa prince_tidy và new_sentiments rồi nhóm theo lexicon. Lexicon NRC có 10 hạng mục khác nhau và một từ có thể xuất hiện ở nhiều hạng mục: ví dụ, một từ có thể vừa tiêu cực vừa buồn. Điều đó có nghĩa bạn nên dùng n_distinct() trong summarise() để lấy số lượng từ phân biệt theo lexicon.
prince_tidy %>%
  mutate(words_in_lyrics = n_distinct(word)) %>%
  inner_join(new_sentiments) %>%
  group_by(lexicon, words_in_lyrics, words_in_lexicon) %>%
  summarise(lex_match_words = n_distinct(word)) %>%
  ungroup() %>%
  mutate(total_match_words = sum(lex_match_words), #Not used but good to have
         match_ratio = lex_match_words / words_in_lyrics) %>%
  select(lexicon, lex_match_words,  words_in_lyrics, match_ratio) %>%
  mutate(lex_match_words = color_bar("lightpink")(lex_match_words),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Lyrics Found In Lexicons")
| lexicon | lex_match_words | words_in_lyrics | match_ratio |
|---|---|---|---|
| AFINN | 770 | 7851 | 0.0980767 |
| bing | 1185 | 7851 | 0.1509362 |
| nrc | 1678 | 7851 | 0.2137307 |
Lexicon NRC bao phủ nhiều từ phân biệt trong ca từ hơn AFINN hoặc Bing. Lưu ý tổng các tỷ lệ khớp khá thấp. Không một lexicon nào có thể chứa mọi từ, và cũng không nên. Nhiều từ được xem là trung tính và sẽ không có cảm xúc đi kèm. Ví dụ, 2000 thường là một từ trung tính, nên không xuất hiện trong các lexicon. Tuy nhiên, nếu bạn còn nhớ, người ta từng dự đoán máy bay sẽ rơi và máy tính sẽ ngừng hoạt động trong năm đó. Vì thế có một nỗi sợ gắn liền trong bài hát nhưng không được nắm bắt bởi phân tích cảm xúc dùng lexicon điển hình.
Dưới đây là vài lý do một từ có thể không xuất hiện trong lexicon:
Hãy xem một số từ cụ thể trong ca từ của Prince có vẻ như sẽ tác động đến cảm xúc. Chúng có xuất hiện trong tất cả lexicon không?
new_sentiments %>%
  filter(word %in% c("dark", "controversy", "gangster",
                     "discouraged", "race")) %>%
  arrange(word) %>% #sort
  select(-score) %>% #remove this field
  mutate(word = color_tile("lightblue", "lightblue")(word),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Specific Words")
| word | sentiment | lexicon | words_in_lexicon |
|---|---|---|---|
| controversy | negative | nrc | 6468 |
| controversy | negative | bing | 6785 |
| dark | sadness | nrc | 6468 |
| dark | negative | bing | 6785 |
| discouraged | negative | AFINN | 2476 |
| gangster | negative | bing | 6785 |
Controversy và dark xuất hiện trong NRC và Bing, nhưng gangster chỉ xuất hiện trong Bing. Race không xuất hiện và là một chủ đề then chốt trong ca từ của Prince. Nhưng liệu có dễ dàng gán cảm xúc cho từ này không? Lưu ý AFINN nhỏ hơn nhiều và chỉ có một trong các từ trên.
Giờ hãy xem một ví dụ phức tạp hơn. Tính dục là một chủ đề phổ biến trong âm nhạc của Prince. Phân tích cảm xúc dựa trên các lexicon định sẵn sẽ bị ảnh hưởng thế nào bởi các dạng khác nhau của một từ? Ví dụ, dưới đây là tất cả tham chiếu đến từ gốc sex trong ca từ. So sánh chúng với Bing và NRC và xem những chỗ nào khớp.
my_word_list <- prince_data %>%
  unnest_tokens(word, lyrics) %>%
  filter(grepl("sex", word)) %>% #Use `grepl()` to find the substring `"sex"`
  count(word) %>%
  select(myword = word, n) %>% #Rename word
  arrange(desc(n))

new_sentiments %>%
  #Right join gets all words in `my_word_list` to show nulls
  right_join(my_word_list, by = c("word" = "myword")) %>%
  filter(word %in% my_word_list$myword) %>%
  mutate(word = color_tile("lightblue", "lightblue")(word),
          instances = color_tile("lightpink", "lightpink")(n),
          lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  select(-score, -n) %>% #Remove these fields
  my_kable_styling(caption = "Dependency on Word Form")
| word | sentiment | lexicon | words_in_lexicon | instances |
|---|---|---|---|---|
| sexy | positive | bing | 6785 | 220 |
| sexy | positive | AFINN | 2476 | 220 |
| sex | anticipation | nrc | 6468 | 185 |
| sex | joy | nrc | 6468 | 185 |
| sex | positive | nrc | 6468 | 185 |
| sex | trust | nrc | 6468 | 185 |
| superfunkycalifragisexy | NA | NA | NA | 19 |
| lovesexy | NA | NA | NA | 16 |
| sexual | NA | NA | NA | 11 |
| sexuality | NA | NA | NA | 11 |
| sexiness | NA | NA | NA | 2 |
| sexually | NA | NA | NA | 2 |
| sexe | NA | NA | NA | 1 |
| sexed | NA | NA | NA | 1 |
| sexier | NA | NA | NA | 1 |
| superfunkycalifraagisexy | NA | NA | NA | 1 |
| superfunkycalifragisexi | NA | NA | NA | 1 |
Lưu ý Prince dùng sexy rất thường xuyên, nhưng dạng này không tồn tại trong NRC. Từ sex lại có trong NRC nhưng không có trong Bing. Nếu bạn xét đến gốc hoặc thân của từ, liệu có giúp gì không? Một “bài toán khó”! Văn bản của bạn có thể chứa thì quá khứ, số nhiều, hoặc trạng từ của một từ gốc, nhưng lại không xuất hiện trong bất kỳ lexicon nào. Xử lý thế nào đây?
Có thể bạn cần vài bước chuẩn bị dữ liệu nữa. Dưới đây là ba kỹ thuật để cân nhắc trước khi phân tích cảm xúc:
Một khái niệm nâng cao trong phân tích cảm xúc là thay thế đồng nghĩa (tương đồng ngữ nghĩa) và siêu nghĩa (từ cha chung). Đây là những từ được dùng thường xuyên hơn so với từ liên quan trong ca từ, và thực sự có xuất hiện trong một lexicon, từ đó tăng tỷ lệ khớp. Bài này không đủ chỗ để bàn về chuẩn bị dữ liệu bổ sung, nhưng đây chắc chắn là điều bạn nên cân nhắc!
Thử thách: nghiên cứu một chút về lexicon và cách chúng được tạo. Liệu đã có một lexicon phù hợp hơn với ca từ âm nhạc không? Nếu bạn thực sự hứng thú, hãy cân nhắc việc xây dựng lexicon của riêng mình cần những gì. Khác biệt giữa phân tích cảm xúc dựa trên bộ phân loại và dựa trên lexicon là gì?
Giờ bạn đã có nền tảng về bộ dữ liệu và các lexicon, hãy áp dụng bằng cách kết hợp chúng để phân tích. Dưới đây là các bước cấp cao bạn sẽ thực hiện:
Bắt đầu bằng cách tạo các bộ dữ liệu cảm xúc của Prince cho từng lexicon bằng cách inner_join() với hàm get_sentiments(). Truyền tên lexicon cho mỗi lần gọi. Trong bài này, dùng Bing cho cảm xúc nhị phân và NRC cho cảm xúc phân loại. Vì từ có thể xuất hiện ở nhiều hạng mục trong NRC, như Negative/Fear hoặc Positive/Joy, bạn cũng sẽ tạo một tập con không gồm hạng mục positive và negative để dùng sau.
prince_bing <- prince_tidy %>%
  inner_join(get_sentiments("bing"))
prince_nrc <- prince_tidy %>%
  inner_join(get_sentiments("nrc"))
prince_nrc_sub <- prince_tidy %>%
  inner_join(get_sentiments("nrc")) %>%
  filter(!sentiment %in% c("positive", "negative"))
Trong phân tích chi tiết ca từ, bạn sẽ muốn xem xét các cấp văn bản khác nhau, như toàn bộ bài hát, cấp độ bảng xếp hạng, cấp độ thập niên và cấp từ. Bắt đầu bằng việc vẽ đồ thị phân tích cảm xúc theo NRC cho toàn bộ tập dữ liệu.
(Cho vui, tôi đã dùng các gói memery và magick để thêm hình ảnh (meme) vào các biểu đồ.)
nrc_plot <- prince_nrc %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  #Use `fill = -word_count` to make the larger bars darker
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) + #Turn off the legend
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 15000)) + #Hard code the axis limit
  ggtitle("Prince NRC Sentiment") +
  coord_flip()

img <- "prince_background2.jpg" #Load the background image
lab <- ""  #Turn off the label
#Overlay the plot on the image and create the meme file
meme(img, lab, "meme_nrc.jpg", inset = nrc_plot)
#Read the file back in and display it!
nrc_meme <- image_read("meme_nrc.jpg")
plot(nrc_meme)
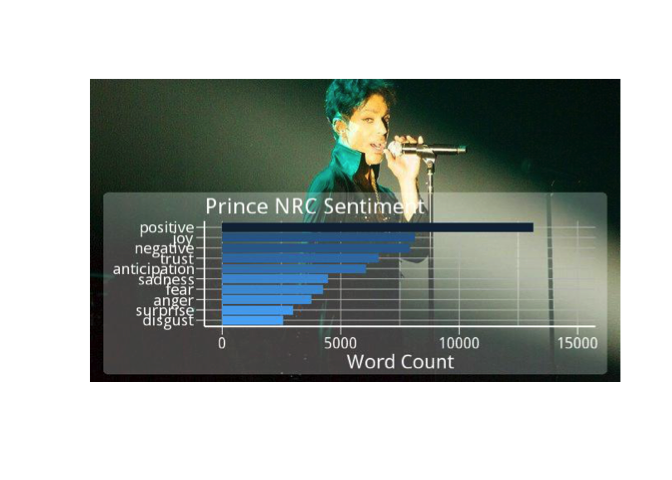
Có vẻ như với ca từ của Prince, NRC nghiêng mạnh về tích cực. Nhưng liệu tất cả các từ mang sắc thái ghê tởm hoặc giận dữ cũng đều thuộc nhóm tiêu cực? Có lẽ đáng để kiểm tra.
Bây giờ hãy xem cảm xúc tổng thể theo Bing. Trong số 1185 từ khác nhau từ ca từ của Prince xuất hiện trong từ điển Bing, có bao nhiêu là tích cực và bao nhiêu là tiêu cực?
bing_plot <- prince_bing %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = sentiment)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 8000)) +
  ggtitle("Prince Bing Sentiment") +
  coord_flip()

img1 <- "prince_background1.jpg"
lab1 <- ""
meme(img1, lab1, "meme_bing.jpg", inset = bing_plot)
x <- image_read("meme_bing.jpg")
plot(x)
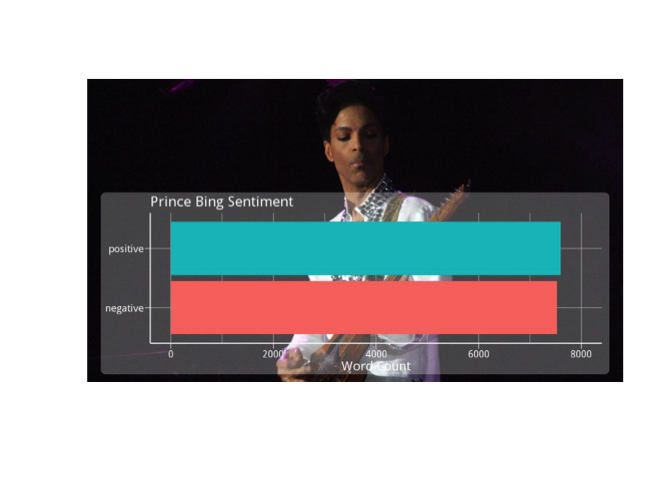
Có thể với Bing, dường như có lượng cảm xúc tích cực và tiêu cực ngang nhau trong âm nhạc của Prince? Liệu cảm xúc tổng thể có tự triệt tiêu khi xem một tập dữ liệu quá lớn? Khó mà biết chắc, nhưng hãy thử xem theo từng phần và quan sát điều gì xảy ra.
Trong âm học, có khái niệm triệt tiêu pha khi tần số của hai tín hiệu cùng dạng sóng lệch pha đúng bằng nhau và triệt tiêu lẫn nhau, ví dụ khi bạn thu tiếng trống bằng hai micro và âm thanh mất nhiều thời gian hơn để đến một micro so với micro kia. Kết quả là im lặng hoàn toàn tại tần số đó! Điều này có thể áp dụng thế nào cho phân tích cảm xúc với tập dữ liệu lớn? Hãy suy ngẫm thêm.
Giáo sư ngôn ngữ học: "Trong tiếng Anh, hai phủ định tạo thành khẳng định. Trong tiếng Nga, hai phủ định vẫn là phủ định. Tuy nhiên, không có ngôn ngữ nào mà hai khẳng định có thể tạo thành phủ định." Sinh viên phản bác: "Ừ, đúng rồi."
Tăng âm lượng cho phân tích của bạn bằng cách tách xuống cấp độ bảng xếp hạng với từ điển Bing. Tạo biểu đồ cảm xúc cực theo cấp độ bảng xếp hạng. Dùng spread() để tách các cảm xúc thành cột và mutate() để tạo trường polarity (tích cực - tiêu cực) và trường percent_positive ($positive / total sentiment * 100$), để có một góc nhìn khác. Với biểu đồ polarity, thêm một yintercept bằng geom_hline(). Vẽ hai biểu đồ cạnh nhau bằng grid.arrange().
prince_polarity_chart <- prince_bing %>%
  count(sentiment, chart_level) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

#Polarity by chart
plot1 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, polarity, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = my_colors[3:5]) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity By Chart Level")

#Percent positive by chart
plot2 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, percent_positive, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = c(my_colors[3:5])) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive By Chart Level")

grid.arrange(plot1, plot2, ncol = 2)
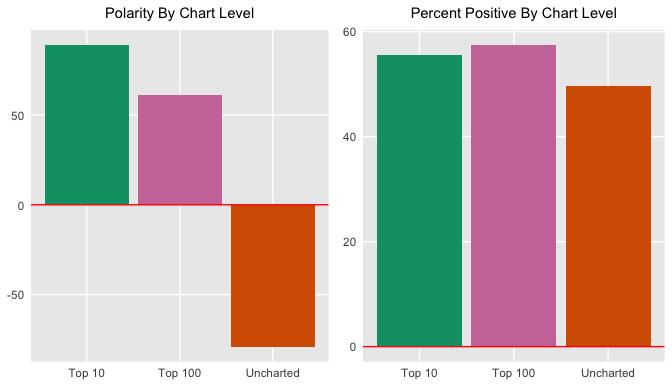
Điều này có nói rằng các ca khúc vào bảng xếp hạng thường tích cực hơn tiêu cực? Nếu vậy, điều đó cho bạn biết gì về những gì xã hội muốn nghe? Bạn có thể đưa ra các giả định này không? Nhìn vào cảm xúc tích cực so với tổng thể, có vẻ các bài vào bảng chỉ hơi tích cực hơn tiêu cực một chút. Điều này thú vị vì bản thân từ điển Bing có nhiều từ tiêu cực hơn từ tích cực.
Vì bạn đang nhìn cảm xúc theo góc độ cực, bạn có thể muốn xem nó có thay đổi theo thời tiết hay không (đùa geek). Lần này dùng geom_smooth() với phương pháp loess để có đường cong mượt hơn và một geom_smooth() khác với method = lm cho đường mượt tuyến tính.
prince_polarity_year <- prince_bing %>%
  count(sentiment, year) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, polarity, color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity Over Time")

relative_polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, percent_positive , color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive Over Time")

grid.arrange(polarity_over_time, relative_polarity_over_time, ncol = 2)
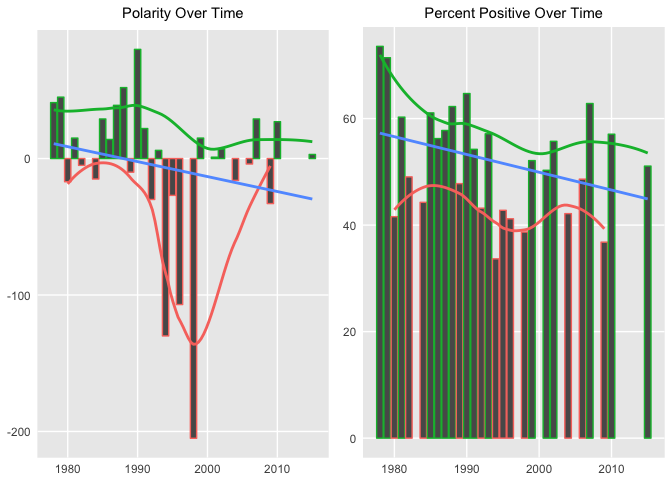
Một vài giá trị cực đoan đã được điều chỉnh trong biểu đồ thứ hai phía trên, nhưng xu hướng polarity tổng thể theo thời gian lại là tiêu cực ở cả hai trường hợp.
Bạn sẽ tiếp tục dùng sức mạnh của chordDiagram() để khảo sát mối quan hệ giữa các cảm xúc theo NRC và các thập niên. Lưu ý các hạng mục cảm xúc xuất hiện ở nửa trên vòng tròn và các thập niên ở nửa dưới.
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "anger" = "grey", "anticipation" = "grey", "disgust" = "grey", "fear" = "grey", "joy" = "grey", "sadness" = "grey", "surprise" = "grey", "trust" = "grey")

decade_mood <-  prince_nrc %>%
  filter(decade != "NA" & !sentiment %in% c("positive", "negative")) %>%
  count(sentiment, decade) %>%
  group_by(decade, sentiment) %>%
  summarise(sentiment_sum = sum(n)) %>%
  ungroup()

circos.clear()
#Set the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_mood[[1]])) - 1), 15,
                         rep(5, length(unique(decade_mood[[2]])) - 1), 15))
chordDiagram(decade_mood, grid.col = grid.col, transparency = .2)
title("Relationship Between Mood and Decade")
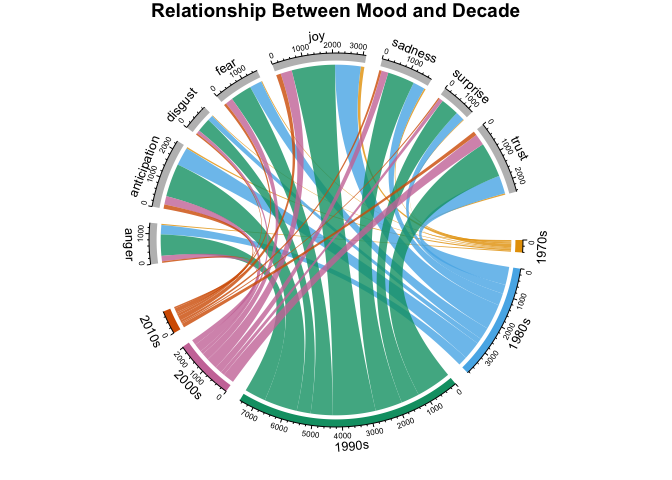
Biểu đồ này cho thấy số lượng từ theo từng hạng mục NRC cho mỗi thập niên. Khá nhiều thông tin trong một biểu đồ nhỏ, nhưng nó cung cấp rất nhiều dữ liệu về mối quan hệ giữa các hạng mục và thời gian. Những sơ đồ này có khả năng tùy biến cực cao và có thể đơn giản hay chi tiết tùy ý.
Với tất cả các khóa học tuyệt vời bạn đã học trên DataCamp, hẳn bạn đang nóng lòng áp dụng kỹ năng vào tình huống đời thực. Hãy làm điều đó ngay bây giờ bằng cách ánh xạ phân tích ca từ của Prince sang một thứ gì đó thực theo thời gian. Tuy nhiên, hãy hoài nghi và thận trọng khi thực hiện phân tích đơn giản hóa trên một chủ đề phức tạp như vậy.
Tôi đã tạo danh sách các sự kiện trong đời của Prince, thu thập từ những nguồn phổ biến như tạp chí Rolling Stone, Biography.com, v.v. Tôi chọn những năm được công chúng biết đến rộng rãi, trùng với các bài hát có ngày phát hành trong tập dữ liệu của chúng ta. Hãy đọc các sự kiện đó từ princeEvents.csv ngay bây giờ. Sau đó dùng prince_bing và spread() để tạo điểm polarity theo năm. Kết hợp với khung dữ liệu events và tạo một trường sentiment để bạn có thể tô màu trên biểu đồ cột. Như thường lệ, dùng coord_flip() khi bạn hiển thị nhãn chữ lớn.
events <- read.csv('princeEvents.csv', stringsAsFactors = FALSE)

year_polarity_bing <- prince_bing %>%
  group_by(year, sentiment) %>%
  count(year, sentiment) %>%
  spread(sentiment, n) %>%
  mutate(polarity = positive - negative,
         ratio = polarity / (positive + negative)) #use polarity ratio in next graph

 events %>%
   #Left join gets event years with no releases
   left_join(year_polarity_bing) %>%
   filter(event != " ") %>% #Account for bad data
   mutate(event = reorder(event, year), #Sort chart by desc year
           sentiment = ifelse(positive > negative,
                              "positive", "negative")) %>%
   ggplot(aes(event, polarity, fill = sentiment)) +
   geom_bar(stat = "identity") +
   theme_minimal() + theme(legend.position = "none") +
   xlab(NULL) +
   ggtitle("Sentiment by Events") +
   coord_flip()
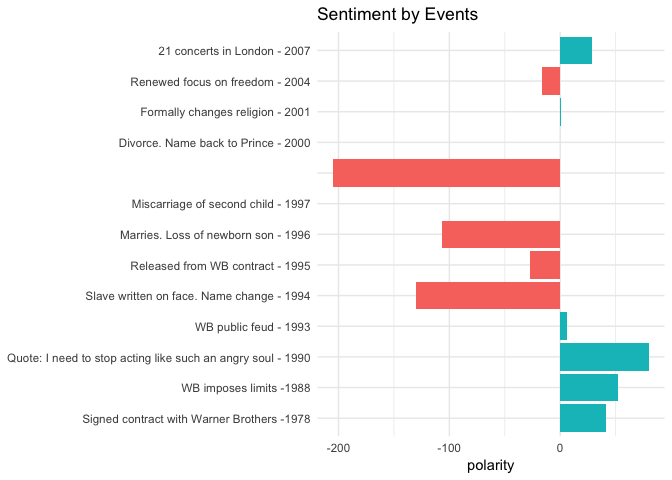
Mẹo: bạn có thể tìm princeEvents.csv tại đây.
Tôi thấy việc so sánh các sự kiện với cảm xúc thật hấp dẫn. Dù mang tính chủ quan, tôi thấy chúng tương quan rất mạnh. Tất nhiên, tôi tự tạo tập sự kiện. Tôi hoàn toàn có thể thiên lệch nó để khớp với ca từ. Tuy vậy, tôi đã dùng nhiều nguồn cho mỗi năm để xác định dữ kiện được tường thuật phổ biến nhất. Những kết quả này nên thúc đẩy bạn đào sâu hơn vào phân tích ở mức từ để xem Prince hát về điều gì.
Năm 1994, Prince phát hành The Black Album như một nỗ lực giành lại khán giả người Mỹ gốc Phi. Xét việc 1994 và hai năm sau đó nổi bật trong phân tích, bạn có thể xem các từ hàng đầu khớp với từ điển NRC trong giai đoạn này bằng geom_label_repel() từ gói ggrepel cùng với geom_point(). Đây là một biểu đồ khó, nên tôi gợi ý bạn thử nghiệm điều chỉnh cấu hình đoạn mã dưới đây.
plot_words_94_96 <- prince_nrc %>%
  filter(year %in% c("1994", "1995", "1996")) %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(8)) %>% #consider top_n() from dplyr also
  ungroup()

plot_words_94_96 %>%
  #Set `y = 1` to just plot one variable and use word as the label
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  #You want the words, not the points
  geom_point(color = "transparent") +
  #Make sure the labels don't overlap
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.04,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1994 - 1996 NRC Sentiment") +
  coord_flip()
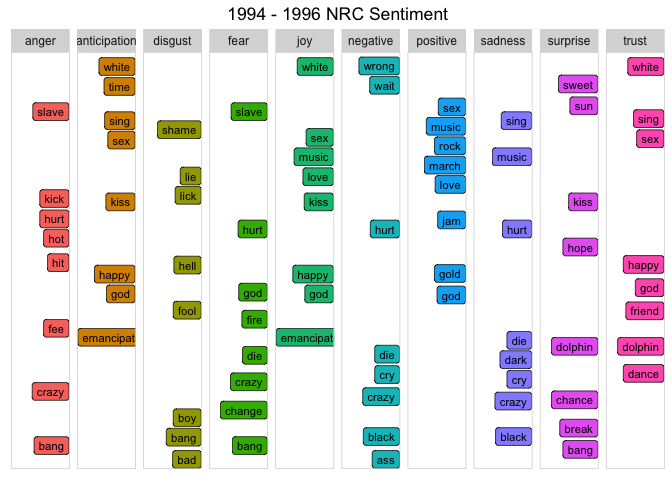
Năm 1994, Prince nói với tạp chí Rolling Stone,
"Khi bạn ngăn một người đàn ông mơ ước, anh ta sẽ trở thành nô lệ. Đó là nơi tôi ở."
Vì vậy anh xuất hiện trước công chúng với chữ "slave" (nô lệ) được viết nổi bật trên mặt, công khai tuyên bố thái độ chống doanh nghiệp đối với hãng đĩa lúc bấy giờ. Anh cũng đổi tên thành một ký hiệu. Những từ ở trên khớp với các sự kiện này đến mức nào? Bạn có để ý các từ "slave", "emancipation" (giải phóng), "black" và "change" trong biểu đồ không?
(Hãy nhớ, đây không chỉ về Prince. Bạn có thể áp dụng cho bất kỳ văn bản nào! Ví dụ, những từ mang cảm xúc trust được Tổng thống Trump nói nhiều nhất trong năm đầu tại vị là gì?)
Biểu đồ Sentiment By Events ở trên cho thấy giữa 1996 và 1998, Prince kết hôn, mất hai người con, và được cho là đã dự đoán 11/9 trên sân khấu. (Hãy tìm trên YouTube buổi hòa nhạc năm 1998 của anh ở Hà Lan để tự nghe!) Dùng các bước tương tự như biểu đồ trước, xem 10 từ đứng đầu trong mỗi hạng mục NRC trong năm 1998.
plot_words_1998 <- prince_nrc %>%
  filter(year == "1998") %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(10)) %>%
  ungroup()

#Same comments as previous graph
plot_words_1998 %>%
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  geom_point(color = "transparent") +
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.05,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1998 NRC Sentiment") +
  coord_flip()
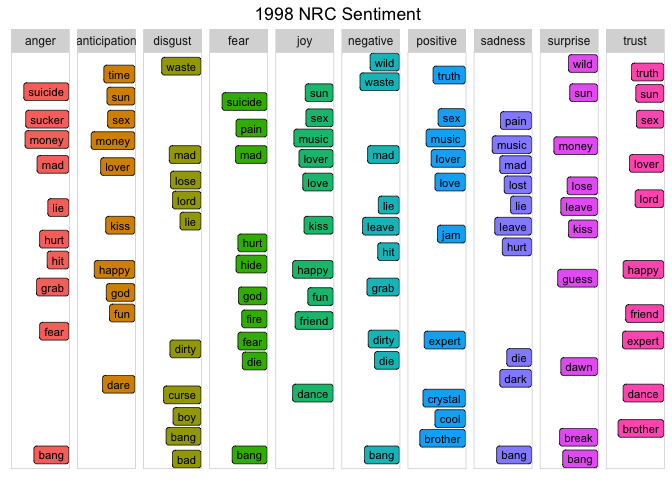
Với mất mát cá nhân và mối đe dọa khủng bố cận kề, những từ như "suicide" (tự sát), "waste" (phí hoài), "mad" (điên/giận), "hurt" (tổn thương), và nhiều từ khác không hiển thị trong biểu đồ này rất phản ánh các sự kiện thực tế. Những từ này mạnh mẽ và mang lại cái nhìn thực sự về cảm xúc của giai đoạn đó.
Một cách hay khác để so sánh cảm xúc giữa các hạng mục là dùng biểu đồ radar, còn gọi là biểu đồ mạng nhện. Bạn có thể tạo kiểu biểu đồ này với gói radarchart. Chúng hữu ích để xem biến nào có giá trị tương đồng hoặc có ngoại lệ nào cho mỗi biến hay không.
Bạn sẽ chia phân tích này thành ba cấp: năm, bảng xếp hạng, và thập niên. (Để tiết kiệm chỗ, tôi chỉ đưa mã cho các năm cụ thể.)
prince_nrc_sub không chứa các cảm xúc tích cực và tiêu cực để các nhóm khác nổi bật hơn. Lần này bạn sẽ tính tổng số từ theo cảm xúc mỗi năm, cũng như tổng cảm xúc cho cả năm và lấy phần trăm ($count of sentiment words per year / total per year * 100$).select().spread() các giá trị năm và tỷ lệ phần trăm (cặp khóa/giá trị) thành nhiều cột để có một hàng cho mỗi cảm xúc và một cột cho mỗi năm. Sau đó dùng chartJSRadar() để tạo widget HTML tương tác. Bạn có thể truyền tham số để hiển thị nhãn tập dữ liệu khi rê chuột. (FYI, đôi khi chữ J và Y trong từ "joy" bị radarchart cắt mất và trông như "iov".)#Get the count of words per sentiment per year
year_sentiment_nrc <- prince_nrc_sub %>%
group_by(year, sentiment) %>%
count(year, sentiment) %>%
select(year, sentiment, sentiment_year_count = n)
#Get the total count of sentiment words per year (not distinct)
total_sentiment_year <- prince_nrc_sub %>%
count(year) %>%
select(year, year_total = n)
#Join the two and create a percent field
year_radar_chart <- year_sentiment_nrc %>%
inner_join(total_sentiment_year, by = "year") %>%
mutate(percent = sentiment_year_count / year_total * 100 ) %>%
filter(year %in% c("1978","1994","1995")) %>%
select(-sentiment_year_count, -year_total) %>%
spread(year, percent) %>%
chartJSRadar(showToolTipLabel = TRUE,
main = "NRC Years Radar")
Bạn sẽ phải cuộn lên xuống để so sánh các biểu đồ vì tôi muốn để chúng ở kích thước đầy đủ. Thật thú vị khi nhận thấy với tập dữ liệu nhỏ như year, bạn có thể thấy độ biến thiên của từng cảm xúc rõ ràng hơn với dạng trực quan này. Bạn cũng có thể để ý rằng trái ngược các bài tập trước, khi dùng tỷ lệ phần trăm, "joy" có điểm cao nhất trên mọi biểu đồ (đặc biệt ở giai đoạn đầu sự nghiệp của Prince năm 1978).
Spotify dùng máy học để tạo gợi ý bài hát cho 140 triệu người dùng hoạt động. Họ chưa dùng nội dung ca từ. Hãy tưởng tượng nếu họ có thể... Vậy giờ, hãy đi sâu hơn nữa vào tâm trạng của các bài hát cụ thể.
Năm 1987, Prince viết bài "Sign O' the Times". Một bài viết trên Billboard của Kenneth Partridge nói rằng:
"Khi đề cập tới AIDS, băng đảng, ma túy, thiên tai, và thậm chí vụ nổ Challenger, Prince vẫn bình thản, tách biệt. 'Sign O' the Times' là một bản cập nhật trạng thái, không phải lời kêu gọi hành động. Giải pháp của anh không phải xuống đường hay gọi cho nghị sĩ của bạn."
Vậy một cỗ máy sẽ diễn giải tâm trạng bài này thế nào? Rất cảm xúc hay chỉ mang tính thông tin? Nó đại diện cho con người Prince hay xã hội nói chung? Vẽ các hạng mục NRC bằng ggplot2.
prince_nrc %>%
  filter(song %in% "sign o the times") %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_minimal() + theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  ggtitle("Sign O' The Times NRC Sentiment") +
  coord_flip()
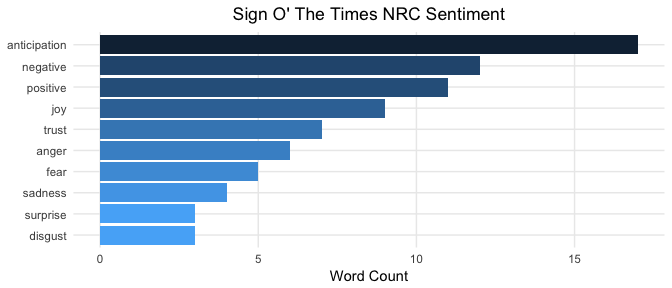
Dù một lần nữa rất chủ quan, kết quả của bạn dường như xác nhận rằng Prince "giữ bình thản và tách biệt", như Partridge đã nói. Điều này có thể diễn giải qua quan sát rằng các từ thuộc anticipation (mong đợi) phổ biến hơn các hạng mục cảm xúc như sadness (buồn), fear (sợ), và anger (giận). Đây là một bài viết cho rằng ba hạng mục này là cảm xúc trong khi anticipation là một cảm nhận. Tác giả Billboard cũng nói bài hát chỉ là một "bản cập nhật trạng thái, gần như không có cảm xúc". Có vẻ như cỗ máy đồng tình. Bạn có diễn giải như vậy không? Tôi biết đây là một hướng dẫn R, nhưng phân tích cảm xúc không thuần kỹ thuật. Người ta nói đó là nơi AI gặp gỡ tâm lý học.
Dùng ggplot2 để tạo một biểu đồ hơi khác, xem các từ cho từng hạng mục.
prince_tidy %>%
  filter(song %in% 'sign o the times') %>%
  distinct(word) %>%
  inner_join(get_sentiments("nrc")) %>%
  ggplot(aes(x = word, fill = sentiment)) +
  facet_grid(~sentiment) +
  geom_bar() + #Create a bar for each word per sentiment
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) + #Place the words on the y-axis
  xlab(NULL) + ylab(NULL) +
  ggtitle("Sign O' The Times Sentiment Words") +
  coord_flip()
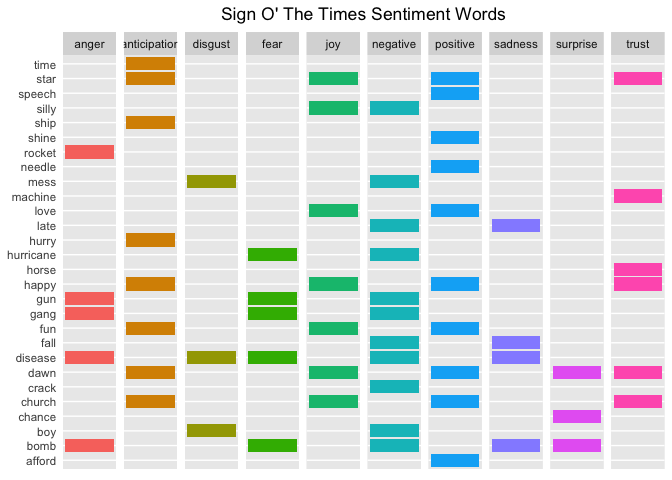
Bạn có ghép được những từ này với các chủ đề nêu trong bài Billboard không? Khá dễ thấy mối liên hệ: Thảm họa Challenger -> "rocket", AIDS -> "disease", Ma túy -> "crack", Thiên tai -> "hurricane", Băng đảng -> "gang", v.v.
Gần như Partridge đã viết một đoạn mã R và tạo biểu đồ này trước khi viết bài!
Xem các hạng mục cảm xúc cho vài bài hát có tiêu đề nổi bật và xem chúng có tương quan không.
prince_nrc_sub %>%
  filter(song %in% c("so blue", "controversy", "raspberry beret",
                     "when doves cry", "the future", "1999")) %>%
  count(song, sentiment, year) %>%
  mutate(sentiment = reorder(sentiment, n), song = reorder(song, n)) %>%
  ggplot(aes(sentiment, n, fill = sentiment)) +
  geom_col() +
  facet_wrap(year ~ song, scales = "free_x", labeller = label_both) +
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) +
  labs(x = NULL, y = NULL) +
  ggtitle("NRC Sentiment Song Analysis") +
  coord_flip()
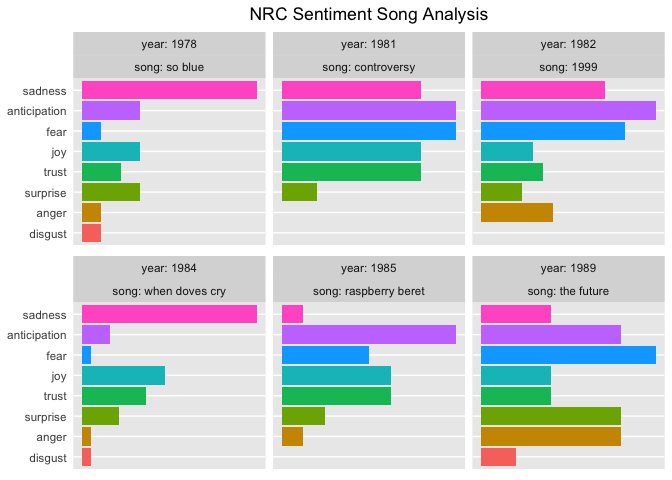
Các cảm xúc NRC cho thấy anticipation và fear cao với một bài về tương lai, và điều tương tự cộng thêm trust cao với một bài về controversy. Những bài mang sắc thái buồn chủ đạo có vẻ cũng khớp với tiêu đề.
Cho đến giờ bạn chỉ xem unigram hay từ đơn. Nhưng nếu "love" là từ phổ biến, thì từ nào đứng trước? Hoặc theo sau? Nhìn từ đơn ra khỏi ngữ cảnh có thể gây hiểu sai. Vậy giờ là lúc xem các bigram hay cặp từ.
Thuận tiện thay, gói tidytext cung cấp khả năng bung cặp từ cũng như từ đơn. Trong trường hợp này, bạn sẽ gọi unnest_tokens() truyền tham số token là ngrams. Vì bạn chỉ xem bigram (hai từ liên tiếp), truyền n = 2. Dùng prince_bigrams để lưu kết quả.
Gói tidyr cho phép tách bigram thành từng từ riêng lẻ bằng hàm separate(). Để loại bỏ stop word và từ không mong muốn, bạn sẽ tách bigram ra và lọc bỏ phần không cần, rồi dùng unite() để ghép cặp từ lại. Cách này giúp dễ hình dung các bigram phổ biến nhất theo thập niên. (Xem Phần Một để giải thích về slice() và row_number())
prince_bigrams <- prince_data %>%
  unnest_tokens(bigram, lyrics, token = "ngrams", n = 2)

bigrams_separated <- prince_bigrams %>%
  separate(bigram, c("word1", "word2"), sep = " ")

bigrams_filtered <- bigrams_separated %>%
  filter(!word1 %in% stop_words$word) %>%
  filter(!word2 %in% stop_words$word) %>%
  filter(!word1 %in% undesirable_words) %>%
  filter(!word2 %in% undesirable_words)

#Because there is so much repetition in music, also filter out the cases where the two words are the same
bigram_decade <- bigrams_filtered %>%
  filter(word1 != word2) %>%
  filter(decade != "NA") %>%
  unite(bigram, word1, word2, sep = " ") %>%
  inner_join(prince_data) %>%
  count(bigram, decade, sort = TRUE) %>%
  group_by(decade) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  arrange(decade, n) %>%
  mutate(row = row_number())
## Joining, by = c("song", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level", "charted")bigram_decade %>%
ggplot(aes(row, n, fill = decade)) +
geom_col(show.legend = FALSE) +
facet_wrap(~decade, scales = "free_y") +
xlab(NULL) + ylab(NULL) +
scale_x_continuous( # This handles replacement of row
breaks = bigram_decade$row, # Notice need to reuse data frame
labels = bigram_decade$bigram) +
theme_lyrics() +
theme(panel.grid.major.x = element_blank()) +
ggtitle("Bigrams Per Decade") +
coord_flip()
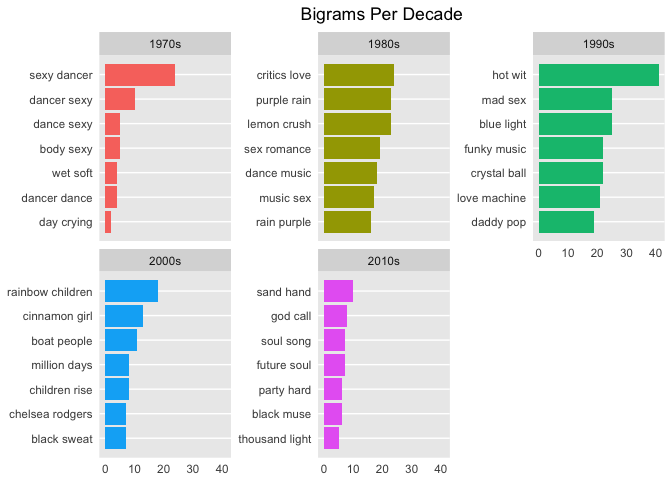
Với bigram, bạn gần như có thể thấy các cụm từ phổ biến chuyển dịch từ tình dục, khiêu vũ và lãng mạn sang tôn giáo và (những) đứa trẻ cầu vồng. Nếu bạn chưa biết, thuật ngữ "rainbow baby" đôi khi được cha mẹ dùng khi họ chuẩn bị đón một đứa con sau khi đã mất thai. Thú vị là tôi không tìm được bài phê bình nào về album Rainbow Children của Prince có nhắc đến điều này.
Vậy bigram ảnh hưởng cảm xúc thế nào? Lần này dùng từ điển AFINN để phân tích cảm xúc trên cặp từ, xem các từ gắn với cảm xúc thường xuyên được đặt trước bởi "not" hoặc các từ phủ định khác ra sao.
AFINN <- get_sentiments("afinn")

not_words <- bigrams_separated %>%
  filter(word1 == "not") %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word2, score, sort = TRUE) %>%
  ungroup()

not_words %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  head(20) %>%
  mutate(word2 = reorder(word2, contribution)) %>%
  ggplot(aes(word2, n * score, fill = n * score > 0)) +
  geom_col(show.legend = FALSE) +
  theme_lyrics() +
  xlab("Words preceded by \"not\"") +
  ylab("Sentiment score * Number of Occurrences") +
  ggtitle("Polar Sentiment of Words Preceded by Not") +
  coord_flip()
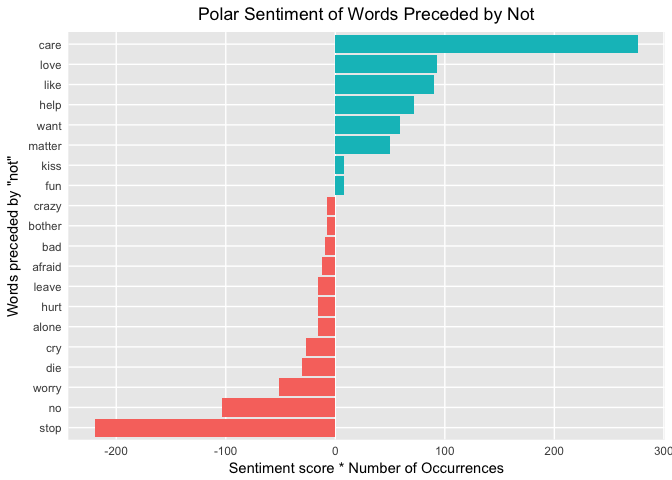
Ở dòng đầu của biểu đồ, care được gán cảm xúc dương tính giả vì "not" bị bỏ qua khi phân tích theo từ đơn. Liệu các bigram dương tính giả có triệt tiêu các bigram âm tính giả?
Lại thêm một câu hỏi tôi không thể trả lời, nhưng là chủ đề hay để đào sâu. Mẹo: bạn cũng có thể truyền tham số "trigrams" và "n = 3" vào unnest_tokens() để xem nhiều từ liên tiếp hơn nữa!
Cũng có những từ phủ định khác cần xét. Lần này bạn sẽ tạo đồ thị mạng với các gói ggraph và igraph. Bạn sẽ sắp các từ thành các nút liên kết với các từ phủ định ở trung tâm. Tạo đối tượng đầu tiên từ tập dữ liệu tidy bằng graph_from_data_frame() rồi dùng ggraph() để vẽ. Bạn có thể làm nổi bật các nút chính bằng geom_edge_density(). Bạn có thể xem ví dụ tương tự chi tiết hơn trong cuốn sách của Julia Silge và David Robinson về Tidy Text Mining.
negation_words <- c("not", "no", "never", "without")

negation_bigrams <- bigrams_separated %>%
  filter(word1 %in% negation_words) %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word1, word2, score, sort = TRUE) %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  group_by(word1) %>%
  slice(seq_len(20)) %>%
  arrange(word1,desc(contribution)) %>%
  ungroup()

bigram_graph <- negation_bigrams %>%
  graph_from_data_frame() #From `igraph`

set.seed(123)

a <- grid::arrow(type = "closed", length = unit(.15, "inches"))

ggraph(bigram_graph, layout = "fr") +
  geom_edge_link(alpha = .25) +
  geom_edge_density(aes(fill = score)) +
  geom_node_point(color = "purple1", size = 1) + #Purple for Prince!
  geom_node_text(aes(label = name),  repel = TRUE) +
  theme_void() + theme(legend.position = "none",
                       plot.title = element_text(hjust = 0.5)) +
  ggtitle("Negation Bigram Network")
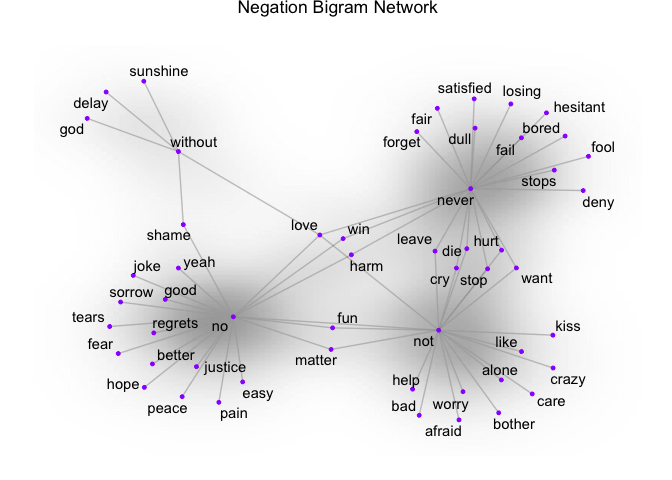
Ở đây, bạn có thể thấy các cặp từ gắn với từ phủ định. Vậy nếu phân tích của bạn dựa trên unigram và "alone" cho kết quả tiêu cực, thì bigram "not alone" như bạn thấy ở trên sẽ có tác dụng ngược lại. Một số từ bắc cầu sang nhiều nút, điều này có thể thấy rõ bằng hình trực quan như thế này: ví dụ, "never hurt" và "not hurt".
Vì giờ bạn đã xem n-gram, hãy xem tương quan giữa các từ. Từ nào tương quan mạnh nhất? Dùng hàm pairwise_count() từ gói widyr để xác định số đếm đồng xuất hiện. Tức là, bạn đếm số lần mỗi cặp từ xuất hiện cùng nhau trong một bài hát. Gói widyr nhận một tập dữ liệu tidy, và tạm thời làm rộng nó trước khi trả về cấu trúc tidy để trực quan hóa và phân tích tiếp.
Để đơn giản, tôi chọn bốn từ thú vị trong ca từ của Prince.
pwc <- prince_tidy %>%
  filter(n() >= 20) %>%  #High counts
  pairwise_count(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  mutate(row = -row_number()) #Descending order

pwc %>%
  ggplot(aes(row, n, fill = item1)) +
  geom_bar(stat = "identity", show.legend = FALSE) +
  facet_wrap(~item1, scales = "free") +
  scale_x_continuous(  #This handles replacement of row
      breaks = pwc$row, #Notice need to reuse data frame
      labels = pwc$item2) +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Counts") +
  coord_flip()
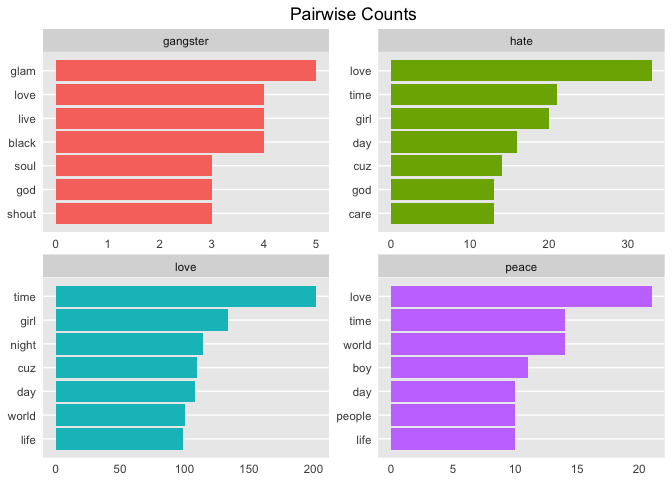
So sánh điều đó với tương quan cặp đôi. Điều này đề cập đến mức độ các từ xuất hiện cùng nhau so với tần suất chúng xuất hiện riêng rẽ. Dùng pairwise_cor() để xác định tương quan giữa các từ dựa trên tần suất chúng xuất hiện trong cùng một bài.
prince_tidy %>%
  group_by(word) %>%
  filter(n() >= 20) %>%
  pairwise_cor(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  top_n(7) %>%
  ungroup() %>%
  mutate(item2 = reorder(item2, correlation)) %>%
  ggplot(aes(item2, correlation, fill = item1)) +
  geom_bar(stat = 'identity', show.legend = FALSE) +
  facet_wrap(~item1, scales = 'free') +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Correlation") +
  coord_flip()
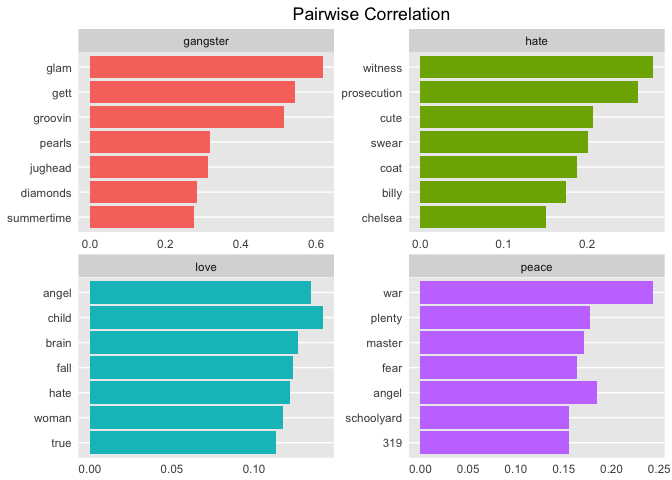
Tôi nghĩ đây là những hiểu biết hấp dẫn về ca từ, chỉ dựa trên bốn từ này thôi! Nhìn những kết quả này bạn có thể bắt đầu thấy các chủ đề hiện lên. Đây là cầu nối tuyệt vời sang hướng dẫn tiếp theo về Mô hình chủ đề!
Trong hướng dẫn này, bạn đã tạo một tập dữ liệu tidy và phân tích thông tin cơ bản như đa dạng từ vựng và số bài hát theo năm phát hành, và bạn đã khảo sát mối quan hệ giữa thập niên phát hành và việc một bài hát có vào bảng xếp hạng hay không. Bạn sau đó khám phá một số từ điển cảm xúc và mức độ chúng khớp với ca từ. Tiếp theo, bạn thực hiện phân tích cảm xúc trên tất cả bài hát trong tập, cảm xúc theo thời gian, cảm xúc ở cấp độ bài hát, và tác động của bigram. Bạn đã làm điều này với nhiều biểu đồ thú vị, mỗi biểu đồ mang đến một góc nhìn khác.
Vậy có thể viết chương trình để xác định tâm trạng trong ca từ không? Có chứ! Mức độ tin cậy của kết quả ra sao? Nó phụ thuộc vào hàng loạt tiêu chí như mức độ xử lý dữ liệu, lựa chọn từ điển, phương pháp phân tích, chất lượng dữ liệu nguồn, v.v. So sánh các sự kiện đời thực, cả cá nhân lẫn xã hội, có thể làm sáng tỏ tâm trạng của bất kỳ ca từ nào. Cảm xúc cực của Prince dường như hơi suy giảm theo thời gian, nhưng nhìn chung, joy có vẻ nổi bật. Các bài vào bảng dường như tích cực hơn so với các bài không vào bảng. Những tuyên bố về dự đoán 11/9 và cái chết của chính anh ta có vẻ rùng rợn khi khớp với ca từ.
Nhưng ca từ rất phức tạp và quá nhiều giả định có thể gây vấn đề. Nếu bạn mang những gì đã học về ca từ sang hướng dẫn tiếp theo, Phần Hai-B về Mô hình chủ đề, bạn sẽ tiến rất xa trong việc khai mở các chủ đề và mô-típ. Có thể thực hiện bao nhiêu NLP trên ca từ vốn thiếu dấu câu hay cấu trúc câu? Thực ra Prince hát về điều gì? Giờ bạn đã hiểu tâm trạng, bạn sẵn sàng hơn để khảo sát các chủ đề có thể có. Và cuối cùng, bạn có thể áp dụng kỹ thuật máy học để dự đoán thập niên hoặc cấp độ bảng xếp hạng của một bài hát không? Hãy cùng tôi khám phá trong vài hướng dẫn tới!
Tôi hy vọng bạn đã thích chuyến hành trình đến giờ. Ở Phần Hai-B chúng ta sẽ party như thể đang là năm 1999!
Tìm hiểu thêm về R
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
