Curso
Análise de Sentimentos em R
4 h
14.1K
Embarque numa jornada sentimental pela vida e obra de Prince, The Artist, na Parte Dois-A de uma série de três tutoriais usando análise de sentimento em R para lançar luz sobre a carreira e a influência social de The Artist. Os três tutoriais cobrem:
Se você quer se aprofundar em análise de sentimento, confira nosso curso Sentiment Analysis in R: The Tidy Way.
Você sabia que Prince previu o 11 de Setembro, no palco, três anos antes? E que talvez tenha previsto a própria morte? Será? Não seria interessante analisar suas letras e tirar suas próprias conclusões? Em 21 de abril de 1985, ele gravou "Sometimes It Snows In April". Ele morreu exatamente 31 anos depois, em 21 de abril de 2016. Veja a escolha de palavras na análise de sentimento dessa canção:
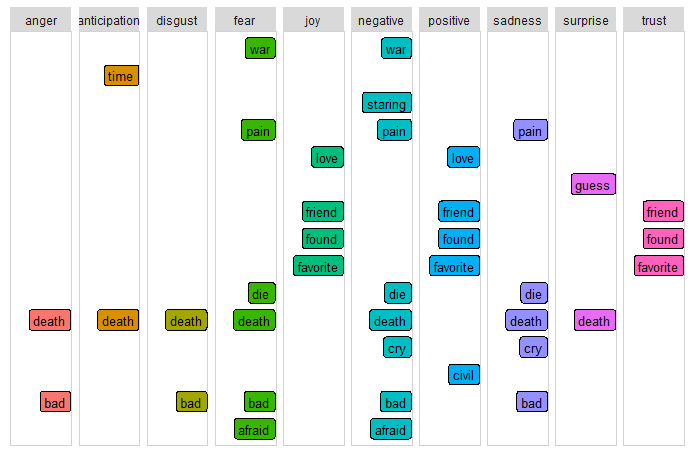
Isso dá um novo sentido a analytics preditivo!
Cada trecho de código é seguido de um insight, geralmente subjetivo. Fique à vontade para ir pulando de seção em seção e tirar suas próprias conclusões! Recomendo ler a introdução a seguir, mas, se quiser ir direto ao código, clique aqui. Se você já entende o conceito por trás de léxicos, pode ir direto para a análise detalhada.
Acabei de resgatar dois gatinhos e um filhote de cachorro, então agora penso em trios. Além disso, a regra de três é um princípio de escrita que sugere que coisas em trios são mais engraçadas, satisfatórias ou eficazes — por isso dividi em três partes. Na Parte Um, você foi apresentado à mineração de texto e à análise exploratória usando um conjunto com centenas de letras do lendário Prince. Na Parte Dois, o foco é análise de sentimento (Dois-A) e modelagem de tópicos (Dois-B) com NLP. A Parte Três fecha com tarefas preditivas usando técnicas de machine learning, respondendo perguntas como: dá para inferir a década de lançamento de uma música? E prever se ela vai entrar na Billboard com base na letra? Ao longo dos tutoriais, você usará diferentes algoritmos de machine learning — destacados em vermelho no gráfico abaixo.
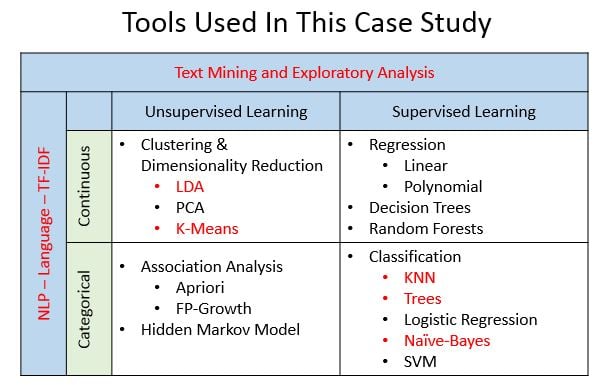
Sim, prometi só três partes, mas dividi a Parte Dois em Dois-A (análise de sentimento) e Dois-B (modelagem de tópicos — em breve), resultando em quatro tutoriais. Há ótimos artigos e cursos sobre o processo por trás da análise de sentimento, então o objetivo da Parte Dois-A é focar em extrair insights — não só em escrever código. Vamos usar as letras do Prince como exemplo, mas você pode aplicar os passos ao seu artista favorito. Espero que a série inteira desperte curiosidade sobre as possibilidades da análise de letras, enquanto você conhece técnicas de Processamento de Linguagem Natural (NLP) e machine learning.
A Parte Dois-A pede noções básicas de dados tidy — especialmente pacotes como dplyr para transformação, ggplot2 para visualização e o %>% operador pipe (do pacote magrittr). Você verá vários passos encadeados com %>% para manter o código compacto e reutilizável.
Como este tutorial também é um estudo de caso, ele traz muitas visualizações além dos gráficos usuais. Por isso, também é necessário saber instalar novos pacotes no seu ambiente. Para focar em insights, incluí código pensado para ser reutilizado com seus dados; explicações detalhadas pedem investigação extra. Links de apoio serão fornecidos para cada pacote, expondo você a novas ferramentas e ao seu uso prático.
Dica: leia a Parte Um antes para ter base para a série e entender o vocabulário denso e diverso das letras do Prince.
Métodos: a análise de sentimento é um tipo de mineração de texto que busca determinar opinião e subjetividade do conteúdo. Em letras, os resultados podem refletir não só as atitudes do artista, mas também influências culturais. Os métodos incluem treinar um conjunto rotulado, criar classificadores por regras e usar dicionários léxicos (léxicos). Aqui, vamos usar a abordagem baseada em léxico, mas vale explorar os demais métodos e seus trade-offs.
Níveis: além dos métodos, há diferentes níveis de análise: documento, frase e palavra. Em letras, o documento pode ser sentimento por década, ano, nível de parada ou música. O nível de frase costuma não ser opção porque pontuação atrapalha rimas e padrões. A análise por palavra revela detalhes e serve de base para práticas mais avançadas em modelagem de tópicos.
Todo projeto de ciência de dados precisa de perguntas. Algumas para ter em mente: dá para programar a identificação do humor de uma letra? Léxicos pré-definidos bastam? Quanto preparo de dados é necessário? É possível relacionar resultados a eventos reais? O sentimento muda com o tempo? Hits são mais positivos do que músicas fora das paradas? Quais palavras se destacam nas letras no ano em que Prince teria previsto o 11/9? Ele previu a própria morte?
Dica: analisar letras é bem diferente — e em geral mais complexo — do que discursos ou livros, o que dificulta extrair insights. Tenha cautela com suposições! Vou propor mais perguntas do que respostas aqui, então prepare-se para pensar fora do paralelogramo quadrilátero!
Para começar a analisar as letras do Prince, carregue as bibliotecas abaixo. Pode parecer muita coisa, mas a maioria é para gráficos. Dado o uso frequente de visuais, é melhor definir um esquema de cores padrão. Criei uma lista com códigos ANSI específicos. A função theme() do ggplot2 permite personalizar gráficos; então, vamos criar também a função theme_lyrics() para ajustar padrões. O pacote knitr gera relatórios dinâmicos em R. Use-o com kableExtra e formattable para tabelas bonitas e coloridas. De novo, crie a função my_kable_styling() para padronizar a saída. Os outros pacotes serão mencionados conforme o uso.
library(dplyr) #Data manipulation (also included in the tidyverse package)
library(tidytext) #Text mining
library(tidyr) #Spread, separate, unite, text mining (also included in the tidyverse package)
library(widyr) #Use for pairwise correlation

#Visualizations!
library(ggplot2) #Visualizations (also included in the tidyverse package)
library(ggrepel) #`geom_label_repel`
library(gridExtra) #`grid.arrange()` for multi-graphs
library(knitr) #Create nicely formatted output tables
library(kableExtra) #Create nicely formatted output tables
library(formattable) #For the color_tile function
library(circlize) #Visualizations - chord diagram
library(memery) #Memes - images with plots
library(magick) #Memes - images with plots (image_read)
library(yarrr)  #Pirate plot
library(radarchart) #Visualizations
library(igraph) #ngram network diagrams
library(ggraph) #ngram network diagrams

#Define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#Customize ggplot2's default theme settings
#This tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #Center the title
        axis.ticks = aticks, #Set axis ticks to on or off
        panel.grid.minor = pgminor, #Turn the minor grid lines on or off
        legend.title = lt, #Turn the legend title on or off
        legend.position = lp) #Turn the legend on or off
}

#Customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}
Como sempre, comece lendo os dados brutos em um data frame. Na Parte Um, você condicionou o dataset original: expandiu contrações, removeu sequências de escape e colocou o texto em minúsculas. Salvou o dataset limpo em CSV para usar aqui. Use read.csv() para criar prince_data e garanta que as letras fiquem como caracteres definindo stringsAsFactors = FALSE. Como você não precisa de numeração de linhas, defina row.names = 1.
Observação: você poderia evitar esses parâmetros lendo em um data frame moderno chamado tibble com read_csv(), mas, por consistência com a Parte Um, usaremos read.csv().
prince_data <- read.csv('prince_new.csv', stringsAsFactors = FALSE, row.names = 1)
Dê uma olhada rápida nos dados:
glimpse(prince_data) #Transposed version of `print()`## Observations: 824
## Variables: 10
## $ lyrics <chr> "all 7 and we will watch them fall they stand in t...
## $ song <chr> "7", "319", "1999", "2020", "3121", "7779311", "u"...
## $ year <int> 1992, NA, 1982, NA, 2006, NA, NA, NA, NA, NA, NA, ...
## $ album <chr> "Symbol", NA, "1999", "Other Songs", "3121", NA, N...
## $ peak <int> 3, NA, 2, NA, 1, NA, NA, NA, NA, NA, NA, NA, NA, N...
## $ us_pop <chr> "7", NA, "12", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ us_rnb <chr> "61", NA, "4", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ decade <chr> "1990s", NA, "1980s", NA, "2000s", NA, NA, NA, NA,...
## $ chart_level <chr> "Top 10", "Uncharted", "Top 10", "Uncharted", "Top...
## $ charted <chr> "Charted", "Uncharted", "Charted", "Uncharted", "C...Você vê que prince_data tem 824 músicas e 10 colunas. Ou seja, cada registro é uma música, literalmente!
prince_tidyAlguns passos finais de limpeza de dados:
Para deixar os dados em formato tidy, use unnest_tokens() do tidytext para criar prince_tidy, que quebra as letras em uma palavra por linha. Depois, use anti_join() e filter() do dplyr para as limpezas restantes. (Veja a Parte Um para a explicação detalhada.)
#Created in the first tutorial
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats", "la", "da", "uh", "ah")

#Create tidy text format: Unnested, Unsummarized, -Undesirables, Stop and Short words
prince_tidy <- prince_data %>%
  unnest_tokens(word, lyrics) %>% #Break the lyrics into individual words
  filter(!word %in% undesirable_words) %>% #Remove undesirables
  filter(!nchar(word) < 3) %>% #Words like "ah" or "oo" used in music
  anti_join(stop_words) #Data provided by the tidytext package
glimpse(prince_tidy) #From `dplyr`, better than `str()`.
 ## Observations: 76,116
## Variables: 10
## $ song        <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ year        <int> 1992, 1992, 1992, 1992, 1992, 1992, 1992, 1992, 19...
## $ album       <chr> "Symbol", "Symbol", "Symbol", "Symbol", "Symbol", ...
## $ peak        <int> 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3,...
## $ us_pop      <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ us_rnb      <chr> "61", "61", "61", "61", "61", "61", "61", "61", "6...
## $ decade      <chr> "1990s", "1990s", "1990s", "1990s", "1990s", "1990...
## $ chart_level <chr> "Top 10", "Top 10", "Top 10", "Top 10", "Top 10", ...
## $ charted     <chr> "Charted", "Charted", "Charted", "Charted", "Chart...
## $ word        <chr> "watch", "fall", "stand", "love", "smoke", "intell...
O novo dataset prince_tidy está tokenizado, com uma palavra por linha junto com a música de origem. Agora você tem um data frame com 76.116 palavras e 10 colunas.
Se você não leu a Parte Um, vale ver alguns gráficos-resumo do conjunto completo. Vamos usar gráficos criativos dos pacotes ggplot2, circlize e yarrr.
Um pirata diria shipshape quando tudo está em ordem, arrumado e limpo. Aqui vai uma visão interessante dos dados limpos mostrando a diversidade lexical — em outras palavras, o vocabulário — das letras ao longo do tempo. O pirate plot é um método para mostrar uma variável contínua (como contagem de palavras) em função de uma categórica (como década), combinando pontos brutos e estatísticas descritivas e inferenciais em um único gráfico. Confira este ótimo post sobre pirateplot() do pacote yarrr.
Crie o data frame word_summary calculando o número de palavras distintas por música. Quanto mais diverso o vocabulário, maior a riqueza da letra. Pensar assim ajuda na análise em nível de palavra. Zere a década para "NONE" onde não há data e renomeie campos com select().
word_summary <- prince_tidy %>%
  mutate(decade = ifelse(is.na(decade),"NONE", decade)) %>%
  group_by(decade, song) %>%
  mutate(word_count = n_distinct(word)) %>%
  select(song, Released = decade, Charted = charted, word_count) %>%
  distinct() %>% #To obtain one record per song
  ungroup()

pirateplot(formula =  word_count ~ Released + Charted, #Formula
   data = word_summary, #Data frame
   xlab = NULL, ylab = "Song Distinct Word Count", #Axis labels
   main = "Lexical Diversity Per Decade", #Plot title
   pal = "google", #Color scheme
   point.o = .2, #Points
   avg.line.o = 1, #Turn on the Average/Mean line
   theme = 0, #Theme
   point.pch = 16, #Point `pch` type
   point.cex = 1.5, #Point size
   jitter.val = .1, #Turn on jitter to see the songs better
   cex.lab = .9, cex.names = .7) #Axis label size
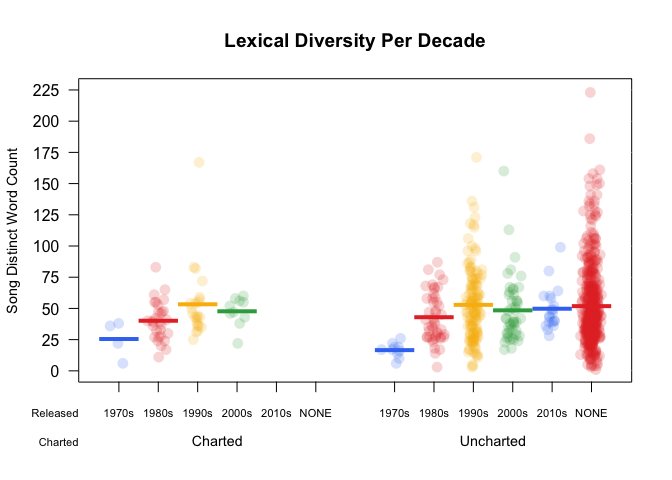
Cada círculo colorido representa uma música. A área vermelha densa com valor "NONE" indica muitas músicas sem data de lançamento. Há uma leve alta no número de palavras únicas por música nas primeiras décadas: a linha sólida mostra a média daquela década. Isso é importante ao analisar sentimento ao longo do tempo. As palavras ficam mais reveladoras ao longo da carreira do Prince.
Vale explorar pirate plots com mais profundidade — aqui só arranhamos a superfície.
Gráficos circulares são uma forma diferente de visualizar relações entre várias categorias (e discos eram redondos!). O gráfico abaixo é um barplot circular com coord_polar() do ggplot2 que mostra o número relativo de músicas por ano. É bastante código para um gráfico simples, mas compensa. Um exemplo semelhante e detalhado está na R Graph Gallery aqui. Assim como nos pirate plots, é só uma introdução ao que plots circulares permitem.
songs_year <- prince_data %>%
  select(song, year) %>%
  group_by(year) %>%
  summarise(song_count = n())

id <- seq_len(nrow(songs_year))
songs_year <- cbind(songs_year, id)
label_data = songs_year
number_of_bar = nrow(label_data) #Calculate the ANGLE of the labels
angle = 90 - 360 * (label_data$id - 0.5) / number_of_bar #Center things
label_data$hjust <- ifelse(angle < -90, 1, 0) #Align label
label_data$angle <- ifelse(angle < -90, angle + 180, angle) #Flip angle
ggplot(songs_year, aes(x = as.factor(id), y = song_count)) +
  geom_bar(stat = "identity", fill = alpha("purple", 0.7)) +
  geom_text(data = label_data, aes(x = id, y = song_count + 10, label = year, hjust = hjust), color = "black", alpha = 0.6, size = 3, angle =  label_data$angle, inherit.aes = FALSE ) +
  coord_polar(start = 0) +
  ylim(-20, 150) + #Size of the circle
  theme_minimal() +
  theme(axis.text = element_blank(),
        axis.title = element_blank(),
        panel.grid = element_blank(),
        plot.margin = unit(rep(-4,4), "in"),
        plot.title = element_text(margin = margin(t = 10, b = -10)))
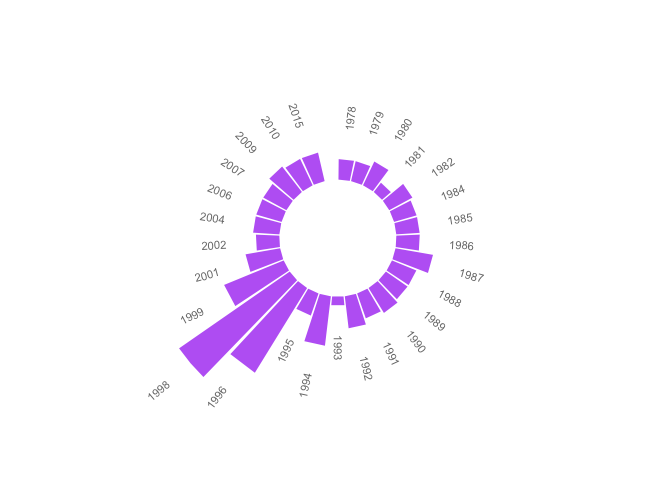
Viu a lacuna no topo? Indica as centenas de músicas sem data de lançamento vistas no pirate plot. Com tantas inéditas, o gráfico perderia utilidade se as incluísse. Os anos ausentes indicam períodos sem lançamentos. Os anos mais prolíficos foram 1996 e 1998.
Quer saber por quê? Continue lendo!
O gráfico a seguir mostra a relação entre a década de lançamento e o fato de ter ou não entrado na Billboard. Usar um chordDiagram() para música parece apropriado! É do belíssimo pacote circlize de Zuguang Gu. O gráfico se divide em duas categorias: paradas (topo) e década (base). As categorias têm lacunas largas entre si e menores entre valores. Comentários no código abaixo podem ser complementados aqui.
decade_chart <-  prince_data %>%
  filter(decade != "NA") %>% #Remove songs without release dates
  count(decade, charted)  #Get SONG count per chart level per decade. Order determines top or bottom.

circos.clear() #Very important - Reset the circular layout parameters!
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "Charted" = "grey", "Uncharted" = "grey") #assign chord colors
# Set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_chart[[1]])) - 1), 15,
                         rep(5, length(unique(decade_chart[[2]])) - 1), 15))

chordDiagram(decade_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Chart and Decade")
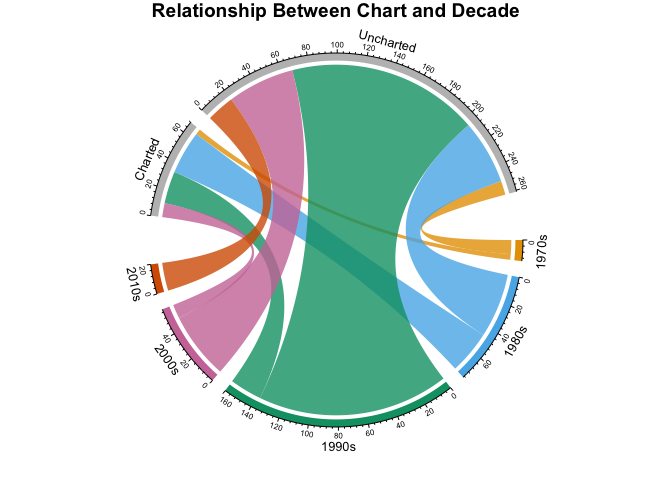
Pode parecer complexo à primeira vista, mas ilustra bem as contagens por década e por nível nas paradas. Prince começou nos anos 1970 com poucos lançamentos, alguns entraram nas paradas. Comparando 1980 com 1990, houve mais lançamentos nos anos 1990, mas mais hits nos anos 1980. Nos anos 2000 foram poucos sucessos comerciais e, nos 2010s, não houve hits.
Nesta seção você vai:
O pacote tidytext inclui o dataset sentiments com vários léxicos distintos — dicionários de palavras com categoria ou valor de sentimento. Ele traz três léxicos de uso geral:
Para examinar os léxicos, crie o data frame new_sentiments. Exclua um léxico financeiro, crie um campo binário (polar) para o AFINN convertendo a pontuação numérica em positive ou negative, e adicione um campo com a contagem de palavras distintas por léxico.
new_sentiments tem uma coluna com as categorias de sentimento; para ver melhor as contagens por léxico e por categoria, use spread() do tidyr para pivotar em colunas. Aproveite knitr e kableExtra na função my_kable_styling() que você criou. Adicione cor com color_tile() e color_bar() do formattable para uma tabela formatada caprichada. Imprima e compare diferenças entre léxicos.
new_sentiments <- sentiments %>% #From the tidytext package
  filter(lexicon != "loughran") %>% #Remove the finance lexicon
  mutate( sentiment = ifelse(lexicon == "AFINN" & score >= 0, "positive",
                              ifelse(lexicon == "AFINN" & score < 0,
                                     "negative", sentiment))) %>%
  group_by(lexicon) %>%
  mutate(words_in_lexicon = n_distinct(word)) %>%
  ungroup()

new_sentiments %>%
  group_by(lexicon, sentiment, words_in_lexicon) %>%
  summarise(distinct_words = n_distinct(word)) %>%
  ungroup() %>%
  spread(sentiment, distinct_words) %>%
  mutate(lexicon = color_tile("lightblue", "lightblue")(lexicon),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon)) %>%
  my_kable_styling(caption = "Word Counts Per Lexicon")
| lexicon | words_in_lexicon | anger | anticipation | disgust | fear | joy | negative | positive | sadness | surprise | trust |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AFINN | 2476 | NA | NA | NA | NA | NA | 1597 | 879 | NA | NA | NA |
| bing | 6785 | NA | NA | NA | NA | NA | 4782 | 2006 | NA | NA | NA |
| nrc | 6468 | 1247 | 839 | 1058 | 1476 | 689 | 3324 | 2312 | 1191 | 534 | 1231 |
A tabela acima dá uma ideia do tamanho e da estrutura de cada léxico.
Para ver qual léxico se aplica melhor às letras, avalie a taxa de correspondência entre palavras em comum no léxico e nas letras. Lembrando: há 76.116 palavras no total e 7.851 distintas em prince_tidy.
Quantas dessas palavras estão nos léxicos?
Use um inner_join() entre prince_tidy e new_sentiments e agrupe por léxico. O NRC tem 10 categorias, e uma palavra pode estar em mais de uma (por exemplo, negativa e triste). Então, use n_distinct() em summarise() para contar as distintas por léxico.
prince_tidy %>%
  mutate(words_in_lyrics = n_distinct(word)) %>%
  inner_join(new_sentiments) %>%
  group_by(lexicon, words_in_lyrics, words_in_lexicon) %>%
  summarise(lex_match_words = n_distinct(word)) %>%
  ungroup() %>%
  mutate(total_match_words = sum(lex_match_words), #Not used but good to have
         match_ratio = lex_match_words / words_in_lyrics) %>%
  select(lexicon, lex_match_words,  words_in_lyrics, match_ratio) %>%
  mutate(lex_match_words = color_bar("lightpink")(lex_match_words),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Lyrics Found In Lexicons")
| lexicon | lex_match_words | words_in_lyrics | match_ratio |
|---|---|---|---|
| AFINN | 770 | 7851 | 0.0980767 |
| bing | 1185 | 7851 | 0.1509362 |
| nrc | 1678 | 7851 | 0.2137307 |
O NRC contém mais palavras distintas das letras do que AFINN ou Bing. Note que a soma das razões é baixa: nenhum léxico tem (nem deve ter) todas as palavras. Muitas são neutras e não têm sentimento associado. Por exemplo, 2000 é tipicamente neutra e, portanto, não aparece nos léxicos. Porém, se você lembrar, muita gente temia que aviões caíssem e computadores parassem naquele ano. Há um medo associado na canção que não é capturado por léxicos comuns.
Alguns motivos para uma palavra não aparecer no léxico:
Veja algumas palavras das letras do Prince que parecem impactar o sentimento. Estão em todos os léxicos?
new_sentiments %>%
  filter(word %in% c("dark", "controversy", "gangster",
                     "discouraged", "race")) %>%
  arrange(word) %>% #sort
  select(-score) %>% #remove this field
  mutate(word = color_tile("lightblue", "lightblue")(word),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Specific Words")
| word | sentiment | lexicon | words_in_lexicon |
|---|---|---|---|
| controversy | negative | nrc | 6468 |
| controversy | negative | bing | 6785 |
| dark | sadness | nrc | 6468 |
| dark | negative | bing | 6785 |
| discouraged | negative | AFINN | 2476 |
| gangster | negative | bing | 6785 |
Controversy e dark aparecem em NRC e Bing, mas gangster só no Bing. Race não aparece e é um tema crucial nas letras de Prince. Mas é facilmente associável a um sentimento? Note que o AFINN é bem menor e contém só uma dessas palavras.
Agora, um exemplo mais complicado. Sexualidade é um tema comum na obra do Prince. Como a análise baseada em léxicos será afetada por diferentes formas de uma palavra? Por exemplo, veja todas as referências ao radical sex nas letras. Compare com Bing e NRC e veja onde há correspondências.
my_word_list <- prince_data %>%
  unnest_tokens(word, lyrics) %>%
  filter(grepl("sex", word)) %>% #Use `grepl()` to find the substring `"sex"`
  count(word) %>%
  select(myword = word, n) %>% #Rename word
  arrange(desc(n))

new_sentiments %>%
  #Right join gets all words in `my_word_list` to show nulls
  right_join(my_word_list, by = c("word" = "myword")) %>%
  filter(word %in% my_word_list$myword) %>%
  mutate(word = color_tile("lightblue", "lightblue")(word),
          instances = color_tile("lightpink", "lightpink")(n),
          lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  select(-score, -n) %>% #Remove these fields
  my_kable_styling(caption = "Dependency on Word Form")
| word | sentiment | lexicon | words_in_lexicon | instances |
|---|---|---|---|---|
| sexy | positive | bing | 6785 | 220 |
| sexy | positive | AFINN | 2476 | 220 |
| sex | anticipation | nrc | 6468 | 185 |
| sex | joy | nrc | 6468 | 185 |
| sex | positive | nrc | 6468 | 185 |
| sex | trust | nrc | 6468 | 185 |
| superfunkycalifragisexy | NA | NA | NA | 19 |
| lovesexy | NA | NA | NA | 16 |
| sexual | NA | NA | NA | 11 |
| sexuality | NA | NA | NA | 11 |
| sexiness | NA | NA | NA | 2 |
| sexually | NA | NA | NA | 2 |
| sexe | NA | NA | NA | 1 |
| sexed | NA | NA | NA | 1 |
| sexier | NA | NA | NA | 1 |
| superfunkycalifraagisexy | NA | NA | NA | 1 |
| superfunkycalifragisexi | NA | NA | NA | 1 |
Note que Prince usa sexy com frequência, mas essa forma não existe no NRC. A palavra sex aparece no NRC, mas não no Bing. E se você olhasse radicais ou raízes — ajudaria? Seu texto pode conter pretérito, plural ou advérbio de um radical, mas isso pode não estar no léxico. Como lidar?
Pode ser que você precise de alguns passos extras. Três técnicas para considerar antes da análise de sentimento:
Um conceito avançado é substituição por sinônimos (pares semanticamente similares) e hipônimos/hiperônimos (pais comuns). São termos mais frequentes que os da letra e que aparecem no léxico, aumentando a taxa de correspondência. Não há espaço aqui para cobrir isso, mas vale muito considerar!
Desafio: pesquise sobre léxicos e como são criados. Já existe algum mais adequado a letras musicais? Se quiser ir além, avalie o que seria necessário para criar seu próprio léxico. Qual a diferença entre análise de sentimento baseada em classificador e baseada em léxico?
Agora que você entende o dataset e os léxicos, pode uni-los para analisar. Passos de alto nível:
Crie datasets de sentimento do Prince para cada léxico com inner_join() em get_sentiments(). Passe o nome do léxico em cada chamada. Neste exercício, use Bing para sentimentos binários e NRC para categóricos. Como palavras podem aparecer em várias categorias no NRC (como Negative/Fear ou Positive/Joy), crie também um subconjunto sem positive e negative para usar depois.
prince_bing <- prince_tidy %>%
  inner_join(get_sentiments("bing"))
prince_nrc <- prince_tidy %>%
  inner_join(get_sentiments("nrc"))
prince_nrc_sub <- prince_tidy %>%
  inner_join(get_sentiments("nrc")) %>%
  filter(!sentiment %in% c("positive", "negative"))
Na análise detalhada, olhe diferentes níveis de texto: todas as músicas, nível de parada, nível de década e nível de palavra. Comece graficando o NRC do conjunto inteiro.
(Só pela diversão, usei os pacotes memery e magick para adicionar imagens (memes) aos gráficos.)
nrc_plot <- prince_nrc %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  #Use `fill = -word_count` to make the larger bars darker
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) + #Turn off the legend
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 15000)) + #Hard code the axis limit
  ggtitle("Prince NRC Sentiment") +
  coord_flip()

img <- "prince_background2.jpg" #Load the background image
lab <- ""  #Turn off the label
#Overlay the plot on the image and create the meme file
meme(img, lab, "meme_nrc.jpg", inset = nrc_plot)
#Read the file back in and display it!
nrc_meme <- image_read("meme_nrc.jpg")
plot(nrc_meme)
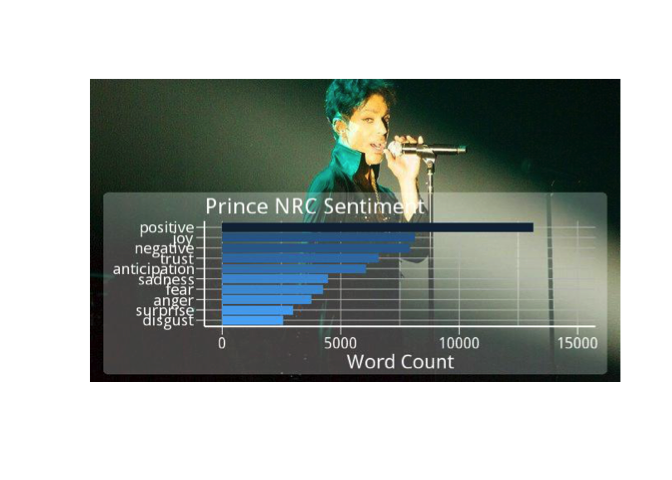
Parece que, nas letras do Prince, o NRC pende fortemente para o positive. Mas todas as palavras de disgust ou anger também estão na categoria negative? Pode valer checar.
Agora veja o sentimento geral pelo Bing. Das 1.185 palavras distintas das letras do Prince presentes no Bing, quantas são positivas e quantas negativas?
bing_plot <- prince_bing %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = sentiment)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 8000)) +
  ggtitle("Prince Bing Sentiment") +
  coord_flip()

img1 <- "prince_background1.jpg"
lab1 <- ""
meme(img1, lab1, "meme_bing.jpg", inset = bing_plot)
x <- image_read("meme_bing.jpg")
plot(x)
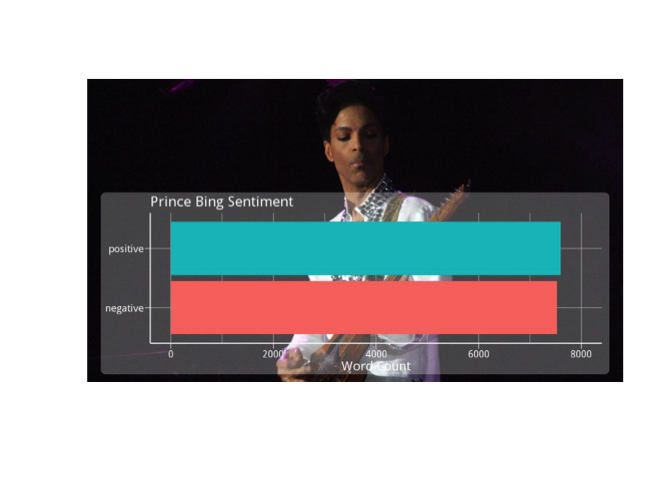
Pode ser que, no Bing, o positive e o negative se equilibrem na obra do Prince? Será que o sentimento geral se anula quando olhamos um conjunto muito grande? Difícil dizer — tente fatiar em partes e ver o que acontece.
Em acústica, há o fenômeno de cancelamento de fase, quando duas ondas iguais estão fora de fase e se anulam, por exemplo, ao gravar uma bateria com dois micros a distâncias diferentes. Resultado: silêncio naquela frequência! Como isso se aplicaria à análise de sentimento em grandes conjuntos? Pense a respeito.
Professor de linguística: "Em inglês, dupla negação vira afirmação. Em russo, dupla negação continua negação. Mas não existe idioma em que dupla afirmação vire negação." Aluno discordando: "Aham, tá."
Aprofunde a análise por nível de parada usando o Bing. Crie um gráfico do sentimento polar por nível. Use spread() para separar as colunas de sentimento e mutate() para criar polarity (positive - negative) e percent_positive ($positive / total * 100$). Para o gráfico de polaridade, adicione geom_hline() com yintercept. Plote lado a lado com grid.arrange().
prince_polarity_chart <- prince_bing %>%
  count(sentiment, chart_level) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

#Polarity by chart
plot1 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, polarity, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = my_colors[3:5]) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity By Chart Level")

#Percent positive by chart
plot2 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, percent_positive, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = c(my_colors[3:5])) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive By Chart Level")

grid.arrange(plot1, plot2, ncol = 2)
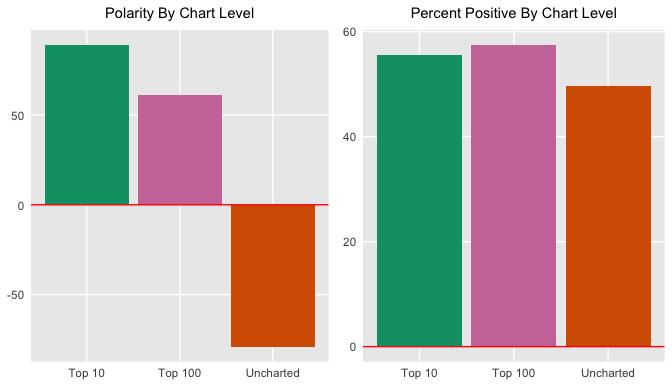
Isso sugere que músicas que entraram nas paradas tendem a ser mais positivas? O que isso diz sobre o que a sociedade quer ouvir? Dá para assumir isso? Olhando o positivo em relação ao total, os hits parecem só ligeiramente mais positivos. Curioso, considerando que o próprio Bing tem mais palavras negativas do que positivas.
Como estamos vendo sentimento polar, vale ver se ele muda com o tempo. Use geom_smooth() com método loess para curva suave e outro geom_smooth() com lm para tendência linear.
prince_polarity_year <- prince_bing %>%
  count(sentiment, year) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, polarity, color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity Over Time")

relative_polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, percent_positive , color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive Over Time")

grid.arrange(polarity_over_time, relative_polarity_over_time, ncol = 2)
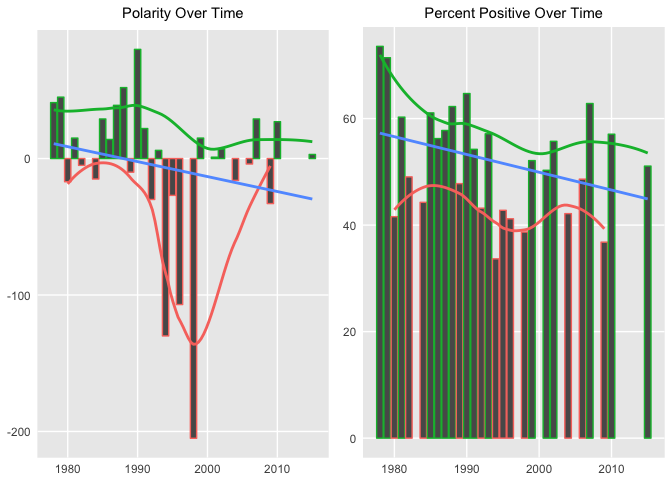
Alguns extremos foram ajustados no segundo gráfico, mas a tendência geral da polaridade ao longo do tempo é negativa em ambos.
Mais uma vez, use o poder do chordDiagram() para examinar relações entre sentimentos do NRC e décadas. As categorias de sentimento aparecem na parte superior do anel e as décadas na inferior.
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "anger" = "grey", "anticipation" = "grey", "disgust" = "grey", "fear" = "grey", "joy" = "grey", "sadness" = "grey", "surprise" = "grey", "trust" = "grey")

decade_mood <-  prince_nrc %>%
  filter(decade != "NA" & !sentiment %in% c("positive", "negative")) %>%
  count(sentiment, decade) %>%
  group_by(decade, sentiment) %>%
  summarise(sentiment_sum = sum(n)) %>%
  ungroup()

circos.clear()
#Set the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_mood[[1]])) - 1), 15,
                         rep(5, length(unique(decade_mood[[2]])) - 1), 15))
chordDiagram(decade_mood, grid.col = grid.col, transparency = .2)
title("Relationship Between Mood and Decade")
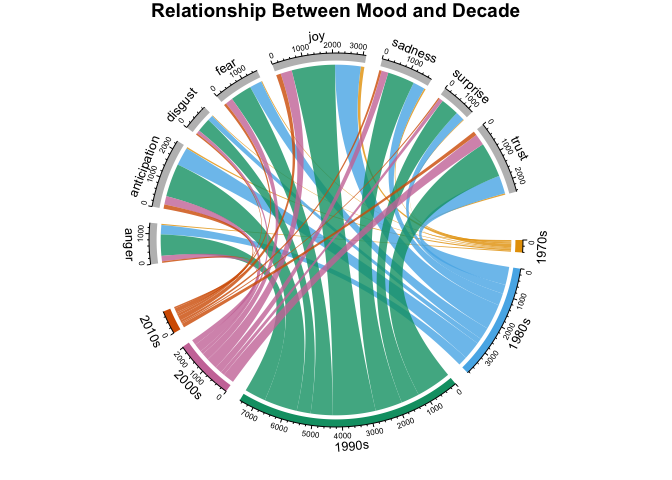
Isso mostra as contagens de palavras por categoria do NRC por década. Muita informação em um gráfico pequeno, mas revela muita relação entre categorias e tempo. Esses diagramas são altamente customizáveis.
Com todos os cursos que você já fez na DataCamp, deve estar doido para aplicar as habilidades no mundo real. Vamos mapear a análise das letras do Prince para algo real ao longo do tempo. Mas mantenha o ceticismo ao simplificar um assunto complexo.
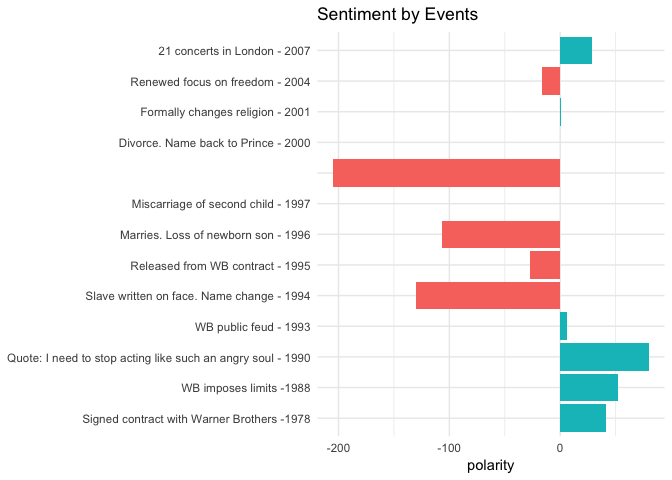
Criei uma lista de eventos da vida do Prince, de fontes como Rolling Stone, Biography.com etc. Selecionei anos bem públicos que casam com músicas com data no dataset. Leia esses eventos de princeEvents.csv. Depois use prince_bing e spread() para criar um escore de polaridade por ano. Faça join com o data frame events e crie um campo de sentimento para colorir o gráfico de barras. Como sempre, use coord_flip() para rótulos longos.
events <- read.csv('princeEvents.csv', stringsAsFactors = FALSE)

year_polarity_bing <- prince_bing %>%
  group_by(year, sentiment) %>%
  count(year, sentiment) %>%
  spread(sentiment, n) %>%
  mutate(polarity = positive - negative,
         ratio = polarity / (positive + negative)) #use polarity ratio in next graph

 events %>%
   #Left join gets event years with no releases
   left_join(year_polarity_bing) %>%
   filter(event != " ") %>% #Account for bad data
   mutate(event = reorder(event, year), #Sort chart by desc year
           sentiment = ifelse(positive > negative,
                              "positive", "negative")) %>%
   ggplot(aes(event, polarity, fill = sentiment)) +
   geom_bar(stat = "identity") +
   theme_minimal() + theme(legend.position = "none") +
   xlab(NULL) +
   ggtitle("Sentiment by Events") +
   coord_flip()
Dica: você encontra o princeEvents.csv aqui.
É fascinante comparar eventos e sentimentos. Embora subjetivo, achei bastante correlacionado. Sim, eu mesmo criei o dataset de eventos — poderia enviesar para bater com as letras. Porém, usei múltiplas fontes por ano para pegar o fato mais comum. Esses resultados devem motivar você a mergulhar na análise em nível de palavra para ver sobre o que Prince cantava.
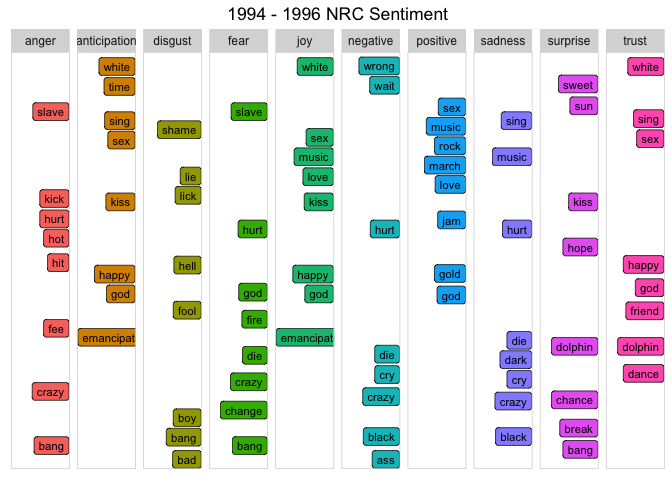
Em 1994, Prince lançou The Black Album numa tentativa de reconquistar o público afro-americano. Como 1994 e os dois anos seguintes se destacam na análise, veja as principais palavras que batem com o NRC nesse período usando geom_label_repel() do ggrepel junto com geom_point(). É um gráfico chato de ajustar — brinque com a configuração do código.
plot_words_94_96 <- prince_nrc %>%
  filter(year %in% c("1994", "1995", "1996")) %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(8)) %>% #consider top_n() from dplyr also
  ungroup()

plot_words_94_96 %>%
  #Set `y = 1` to just plot one variable and use word as the label
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  #You want the words, not the points
  geom_point(color = "transparent") +
  #Make sure the labels don't overlap
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.04,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1994 - 1996 NRC Sentiment") +
  coord_flip()
Em 1994, Prince disse à Rolling Stone:
"Quando você impede um homem de sonhar, ele vira escravo. Era onde eu estava."
Ele apareceu em público com a palavra "slave" escrita no rosto, declarando seu sentimento anticorporação contra a gravadora. Também mudou seu nome para um símbolo. As palavras acima combinam com esses eventos? Note "slave", "emancipation", "black" e "change" no gráfico.
(Não é só sobre Prince. Aplique a qualquer texto! Por exemplo: quais foram as palavras de trust mais ditas por Donald Trump no primeiro ano de mandato?)
O gráfico Sentiment by Events indicou que, entre 1996 e 1998, Prince se casou, perdeu dois filhos e teria previsto o 11/9 no palco. (Procure no YouTube o show de 1998 na Holanda para ouvir!) Usando os mesmos passos, veja as 10 palavras principais em cada categoria do NRC em 1998.
plot_words_1998 <- prince_nrc %>%
  filter(year == "1998") %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(10)) %>%
  ungroup()

#Same comments as previous graph
plot_words_1998 %>%
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  geom_point(color = "transparent") +
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.05,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1998 NRC Sentiment") +
  coord_flip()
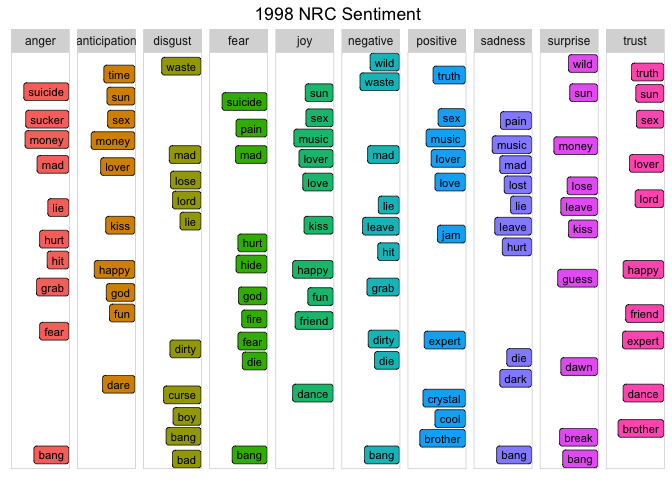
Diante de perdas pessoais e da ameaça de terrorismo, palavras como "suicide", "waste", "mad", "hurt" e muitas outras não mostradas aqui são bem indicativas dos eventos. Essas palavras são poderosas e dão pistas reais do sentimento daquele período.
Outra forma ótima de comparar sentimentos por categoria é o gráfico radar (ou “aranha”). Você pode criá-los com o pacote radarchart. Eles ajudam a ver variáveis com valores semelhantes e outliers.
Vamos dividir a análise em três níveis: ano, parada e década. (Para economizar espaço, vou incluir o código só dos anos.)
prince_nrc_sub, que não tem positive e negative, para destacar as outras categorias. Primeiro, calcule o total de palavras por sentimento por ano e o total anual, e obtenha a porcentagem ($contagem por sentimento / total do ano * 100$).select().spread() para transformar chave/valor de ano e percent em colunas, ficando com uma linha por sentimento e uma coluna por ano. Em seguida, chartJSRadar() gera um widget HTML interativo. Dá para mostrar rótulos no mouseover.#Get the count of words per sentiment per year
year_sentiment_nrc <- prince_nrc_sub %>%
group_by(year, sentiment) %>%
count(year, sentiment) %>%
select(year, sentiment, sentiment_year_count = n)
#Get the total count of sentiment words per year (not distinct)
total_sentiment_year <- prince_nrc_sub %>%
count(year) %>%
select(year, year_total = n)
#Join the two and create a percent field
year_radar_chart <- year_sentiment_nrc %>%
inner_join(total_sentiment_year, by = "year") %>%
mutate(percent = sentiment_year_count / year_total * 100 ) %>%
filter(year %in% c("1978","1994","1995")) %>%
select(-sentiment_year_count, -year_total) %>%
spread(year, percent) %>%
chartJSRadar(showToolTipLabel = TRUE,
main = "NRC Years Radar")
Você vai precisar rolar para comparar os gráficos — deixei em tamanho cheio. Interessante notar que, com um conjunto menor como year, dá para ver melhor a variância por sentimento. Também dá para notar que, em contraste com exercícios anteriores, usando porcentagem, "joy" tem a maior pontuação em todos os gráficos (especialmente no começo da carreira, em 1978).
O Spotify usa machine learning para recomendar músicas aos seus milhões de usuários. Ainda não usa conteúdo lírico. Imagine se usasse... Vamos olhar mais a fundo o humor de músicas específicas.
Em 1987, Prince escreveu "Sign O' the Times". Um artigo da Billboard por Kenneth Partridge diz:
"Ao abordar AIDS, gangues, drogas, desastres naturais e até a explosão do Challenger, Prince se mantém frio e distante. 'Sign O' the Times' é uma atualização de status, não um chamado à ação. A solução dele não é marchar nas ruas ou ligar para seu congressista."
Como uma máquina interpretaria o humor dessa música? É altamente emocional ou mais informativa? Representa Prince como pessoa ou a sociedade em geral? Grafique as categorias do NRC com ggplot2.
prince_nrc %>%
  filter(song %in% "sign o the times") %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_minimal() + theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  ggtitle("Sign O' The Times NRC Sentiment") +
  coord_flip()
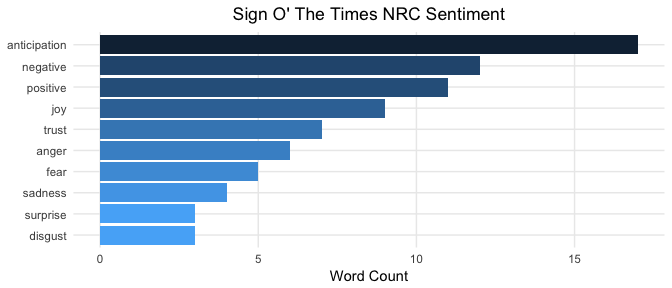
Ainda que subjetivo, o resultado parece confirmar que Prince "se mantém frio e distante", como disse Partridge. Isso pode ser inferido pela prevalência de palavras de anticipation sobre categorias emocionais como sadness, fear e anger. Este artigo diz que essas três são emoções, enquanto anticipation é um sentimento. O autor também disse que a canção é quase uma "atualização de status, quase sem emoção". Parece que a máquina concorda. Você interpreta assim? Embora este seja um tutorial de R, análise de sentimento não é puramente técnica — é onde IA encontra psicologia.
Usando ggplot2 para um gráfico diferente, veja as palavras por categoria.
prince_tidy %>%
  filter(song %in% 'sign o the times') %>%
  distinct(word) %>%
  inner_join(get_sentiments("nrc")) %>%
  ggplot(aes(x = word, fill = sentiment)) +
  facet_grid(~sentiment) +
  geom_bar() + #Create a bar for each word per sentiment
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) + #Place the words on the y-axis
  xlab(NULL) + ylab(NULL) +
  ggtitle("Sign O' The Times Sentiment Words") +
  coord_flip()
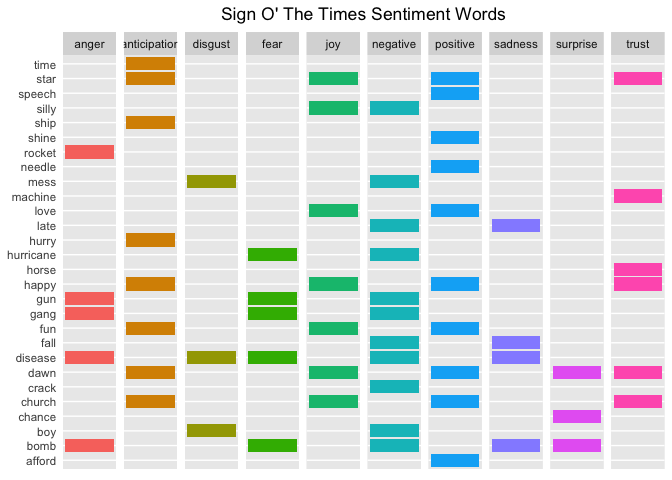
Consegue casar essas palavras com os tópicos do artigo? Fica fácil ver: desastre do Challenger -> "rocket", AIDS -> "disease", drogas -> "crack", desastres naturais -> "hurricane", gangues -> "gang" etc.
Quase dá a impressão de que Partridge rodou um R e fez este gráfico antes de escrever!
Veja as categorias de sentimento de mais algumas músicas com títulos marcantes e avalie a correlação.
prince_nrc_sub %>%
  filter(song %in% c("so blue", "controversy", "raspberry beret",
                     "when doves cry", "the future", "1999")) %>%
  count(song, sentiment, year) %>%
  mutate(sentiment = reorder(sentiment, n), song = reorder(song, n)) %>%
  ggplot(aes(sentiment, n, fill = sentiment)) +
  geom_col() +
  facet_wrap(year ~ song, scales = "free_x", labeller = label_both) +
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) +
  labs(x = NULL, y = NULL) +
  ggtitle("NRC Sentiment Song Analysis") +
  coord_flip()
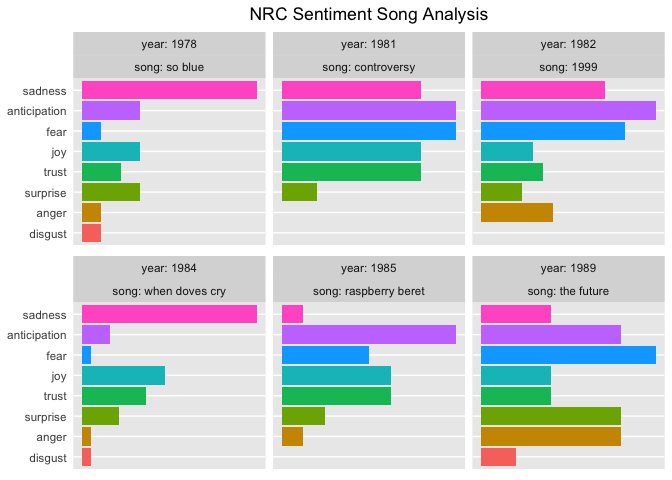
Os sentimentos do NRC mostram alta anticipation e fear numa música sobre o futuro, e isso mais alta trust numa música sobre controversy. As que são predominantemente sad batem com os títulos.
Até agora vimos unigrams (palavras únicas). Mas se "love" é comum, o que a antecede? Ou segue? Palavras soltas fora de contexto podem enganar. Hora de ver bigramas (pares de palavras).
Convenientemente, o tidytext permite desanexar pares de palavras. Chame unnest_tokens() com token = ngrams. Como queremos bigramas, n = 2. Guarde em prince_bigrams.
O tidyr separa bigramas em palavras com separate(). Para remover stopwords e indesejáveis, quebre os bigramas, filtre o que não quer e use unite() para remontar os pares. Assim fica fácil visualizar os bigramas mais comuns por década. (Veja a Parte Um para slice() e row_number())
prince_bigrams <- prince_data %>%
  unnest_tokens(bigram, lyrics, token = "ngrams", n = 2)

bigrams_separated <- prince_bigrams %>%
  separate(bigram, c("word1", "word2"), sep = " ")

bigrams_filtered <- bigrams_separated %>%
  filter(!word1 %in% stop_words$word) %>%
  filter(!word2 %in% stop_words$word) %>%
  filter(!word1 %in% undesirable_words) %>%
  filter(!word2 %in% undesirable_words)

#Because there is so much repetition in music, also filter out the cases where the two words are the same
bigram_decade <- bigrams_filtered %>%
  filter(word1 != word2) %>%
  filter(decade != "NA") %>%
  unite(bigram, word1, word2, sep = " ") %>%
  inner_join(prince_data) %>%
  count(bigram, decade, sort = TRUE) %>%
  group_by(decade) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  arrange(decade, n) %>%
  mutate(row = row_number())
## Joining, by = c("song", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level", "charted")bigram_decade %>%
ggplot(aes(row, n, fill = decade)) +
geom_col(show.legend = FALSE) +
facet_wrap(~decade, scales = "free_y") +
xlab(NULL) + ylab(NULL) +
scale_x_continuous( # This handles replacement of row
breaks = bigram_decade$row, # Notice need to reuse data frame
labels = bigram_decade$bigram) +
theme_lyrics() +
theme(panel.grid.major.x = element_blank()) +
ggtitle("Bigrams Per Decade") +
coord_flip()
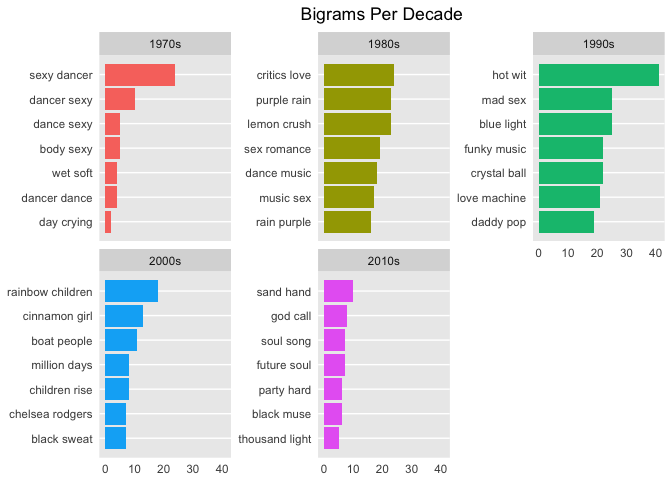
Com bigramas, dá para ver as frases migrarem de sexo, dança e romance para religião e (rainbow) children. Curiosidade: "rainbow baby" é o termo usado por pais que esperam outro filho após perder um bebê por aborto espontâneo. Curiosamente, não encontrei resenha do álbum Rainbow Children do Prince que citasse isso.
E como bigramas afetam o sentimento? Agora use o léxico AFINN para fazer análise em pares, olhando com que frequência palavras com sentimento são precedidas por "not" ou outros termos de negação.
AFINN <- get_sentiments("afinn")

not_words <- bigrams_separated %>%
  filter(word1 == "not") %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word2, score, sort = TRUE) %>%
  ungroup()

not_words %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  head(20) %>%
  mutate(word2 = reorder(word2, contribution)) %>%
  ggplot(aes(word2, n * score, fill = n * score > 0)) +
  geom_col(show.legend = FALSE) +
  theme_lyrics() +
  xlab("Words preceded by \"not\"") +
  ylab("Sentiment score * Number of Occurrences") +
  ggtitle("Polar Sentiment of Words Preceded by Not") +
  coord_flip()
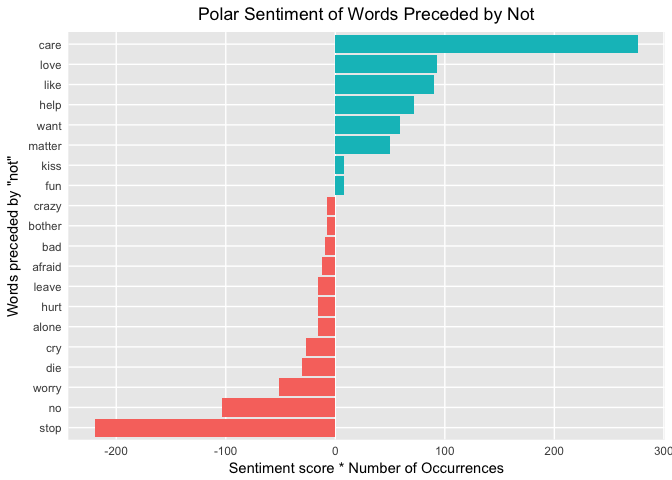
Na primeira linha, care recebe um falso positivo porque o "not" é ignorado na análise de palavra única. Será que bigramas com falsos positivos se anulam com falsos negativos?
Mais uma ótima pergunta para explorar. Dica: você também pode passar "trigrams" e n = 3 a unnest_tokens() para olhar três palavras consecutivas!
Há outras palavras de negação a considerar. Agora crie um grafo de rede com ggraph e igraph. Organize as palavras em nós conectados com os termos de negação no centro. Crie o primeiro objeto a partir do dataset tidy usando graph_from_data_frame() e depois ggraph() para plotar. Dá para destacar nós principais com geom_edge_density(). Veja um exemplo semelhante no livro de Julia Silge e David Robinson sobre Tidy Text Mining.
negation_words <- c("not", "no", "never", "without")

negation_bigrams <- bigrams_separated %>%
  filter(word1 %in% negation_words) %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word1, word2, score, sort = TRUE) %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  group_by(word1) %>%
  slice(seq_len(20)) %>%
  arrange(word1,desc(contribution)) %>%
  ungroup()

bigram_graph <- negation_bigrams %>%
  graph_from_data_frame() #From `igraph`

set.seed(123)

a <- grid::arrow(type = "closed", length = unit(.15, "inches"))

ggraph(bigram_graph, layout = "fr") +
  geom_edge_link(alpha = .25) +
  geom_edge_density(aes(fill = score)) +
  geom_node_point(color = "purple1", size = 1) + #Purple for Prince!
  geom_node_text(aes(label = name),  repel = TRUE) +
  theme_void() + theme(legend.position = "none",
                       plot.title = element_text(hjust = 0.5)) +
  ggtitle("Negation Bigram Network")
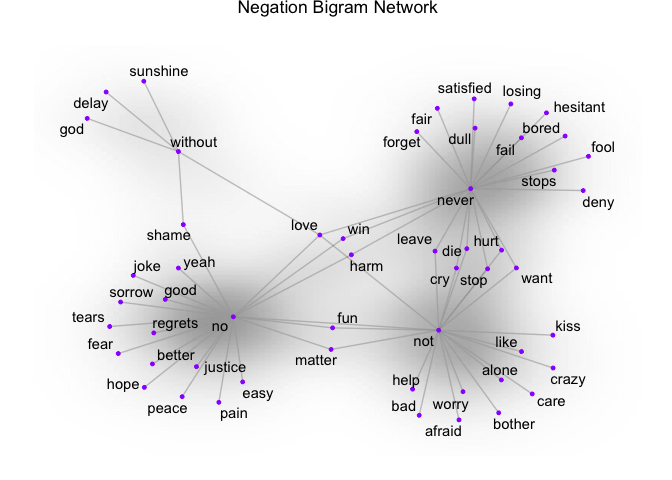
Aqui você vê pares associados a negação. Se sua análise é por unigrams e "alone" sai negativo, o bigrama "not alone" tem efeito inverso. Algumas palavras cruzam múltiplos nós, visíveis aqui: por exemplo, "never hurt" e "not hurt".
Já que vimos n-gramas, veja a correlação entre palavras. Quais são mais correlacionadas? Use pairwise_count() do widyr para coocorrência — quantas vezes pares aparecem juntos numa música. O widyr pega um dataset tidy, alarga temporariamente e retorna ao formato tidy para visualização e análise.
Para simplificar, escolhi quatro palavras interessantes nas letras do Prince.
pwc <- prince_tidy %>%
  filter(n() >= 20) %>%  #High counts
  pairwise_count(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  mutate(row = -row_number()) #Descending order

pwc %>%
  ggplot(aes(row, n, fill = item1)) +
  geom_bar(stat = "identity", show.legend = FALSE) +
  facet_wrap(~item1, scales = "free") +
  scale_x_continuous(  #This handles replacement of row
      breaks = pwc$row, #Notice need to reuse data frame
      labels = pwc$item2) +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Counts") +
  coord_flip()
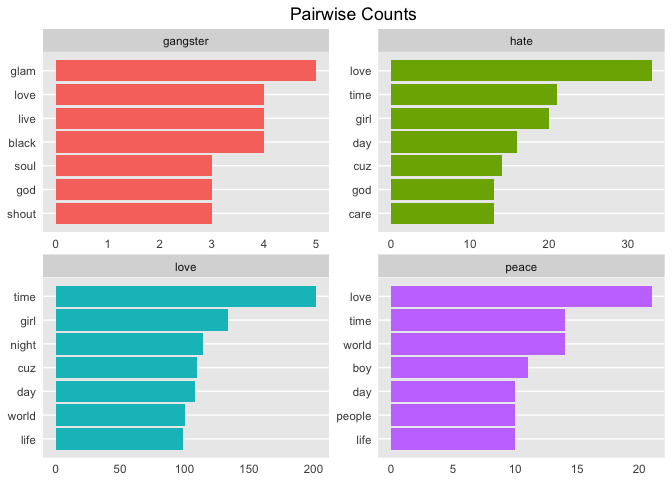
Compare com a correlação pareada — frequência conjunta relativa à frequência separada. Use pairwise_cor() para a correlação entre palavras com base em coocorrência na mesma música.
prince_tidy %>%
  group_by(word) %>%
  filter(n() >= 20) %>%
  pairwise_cor(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  top_n(7) %>%
  ungroup() %>%
  mutate(item2 = reorder(item2, correlation)) %>%
  ggplot(aes(item2, correlation, fill = item1)) +
  geom_bar(stat = 'identity', show.legend = FALSE) +
  facet_wrap(~item1, scales = 'free') +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Correlation") +
  coord_flip()
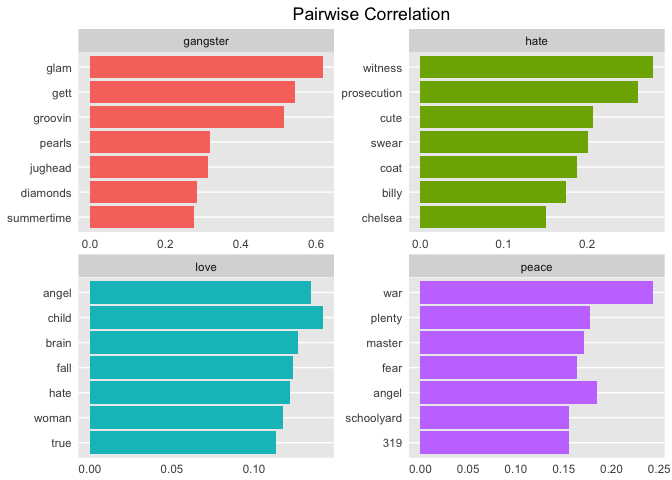
São insights fascinantes com base só nessas quatro palavras! Vendo os resultados, alguns temas começam a surgir — um ótimo gancho para o próximo tutorial sobre modelagem de tópicos!
Neste tutorial, você criou um dataset tidy e analisou informações básicas como diversidade lexical e contagem de músicas por ano, além de examinar a relação entre década de lançamento e presença nas paradas. Depois, explorou léxicos de sentimento e o quão bem batiam com as letras. Em seguida, fez análise de sentimento em todas as músicas, ao longo do tempo, no nível da música e o impacto de bigramas. Tudo isso com uma variedade de gráficos, cada um oferecendo um ângulo diferente.
Então, dá para programar a identificação do humor de letras? Sim! Quão confiáveis são os resultados? Depende de muitos fatores: preparo de dados, escolha de léxico, método de análise, qualidade da fonte etc. Comparar com eventos reais, pessoais e sociais, pode iluminar o humor de qualquer letra. A polaridade do Prince parece ter caído ligeiramente ao longo do tempo, mas, no geral, joy se destaca. Músicas nas paradas parecem mais positivas que as fora. As alegações de prever o 11/9 e a própria morte parecem, de forma assustadora, combinar com suas palavras.
Mas letras são complexas e suposições em excesso dão problema. Se você levar o que aprendeu para a Parte Dois-B, sobre modelagem de tópicos, estará pronto para cavar temas e motivos. Quanta NLP dá para fazer em letras sem pontuação ou estrutura frasal? Sobre o que Prince cantava, afinal? Agora que você entende o humor, está mais preparado para investigar possíveis tópicos. E, por fim, dá para aplicar técnicas de machine learning para prever a década ou o nível nas paradas de uma música? Vem comigo nos próximos tutoriais para descobrir!
Espero que tenha curtido a jornada até aqui. Na Parte Dois-B a gente vai festejar como se fosse 1999!
Aprenda mais sobre R
Curso
Curso
Curso