{count, plural, one {Corso} other {Corsi}}
Sentiment Analysis in R
{hours} ore
14.1K
Fai un viaggio sentimentale nella vita e nei tempi di Prince, The Artist, nella Parte Due-A di una serie di tre tutorial che usa l'analisi del sentiment con R per far luce sulla carriera dell'Artista e sulla sua influenza sulla società. I tre tutorial trattano i seguenti argomenti:
Se vuoi approfondire l'analisi del sentiment, dai un'occhiata al nostro corso Sentiment Analysis in R: The Tidy Way.
Sapevi che Prince predisse l'11/9, sul palco, tre anni prima che accadesse? Potrebbe aver previsto anche la sua stessa morte. È possibile? Non sarebbe interessante esaminare i suoi testi e farti un’idea informata da solo? Il 21 aprile 1985 registrò "Sometimes It Snows In April". Morì esattamente 31 anni dopo, il 21 aprile 2016. Guarda la scelta delle parole nell’analisi del sentiment di questa canzone:
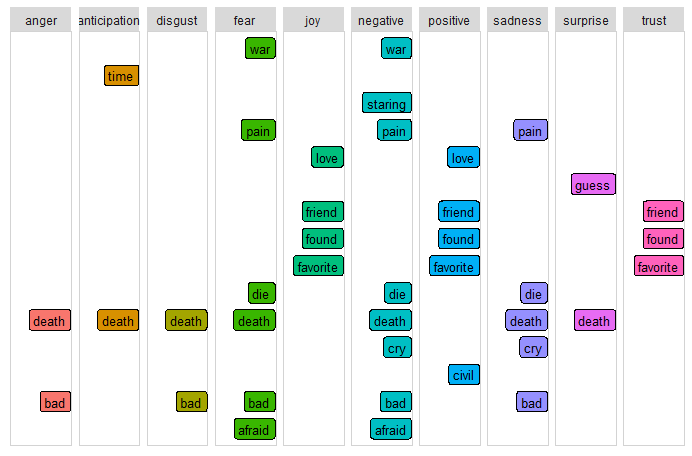
Questo dà un nuovo significato ad Analytics Predittiva!
Ogni blocco di codice è seguito da un insight, in genere di natura soggettiva. Sentiti libero di spostarti tra le sezioni e trarre le tue conclusioni, se preferisci! Ti consiglio di leggere la seguente introduzione, ma se vuoi passare subito al codice, clicca qui. Se conosci già il concetto di lessici, puoi prendere la corsia veloce andando direttamente alla sezione di analisi dettagliata.
Ho appena salvato due gattini e un cucciolo, quindi ormai penso in gruppi di tre. Inoltre, la regola del tre è un principio di scrittura secondo cui le cose in terne sono intrinsecamente più divertenti, più soddisfacenti o più efficaci di altri numeri o cose — ecco perché ho diviso tutto in tre parti... Così, nella Parte Uno hai visto il text mining e l’analisi esplorativa usando un dataset con centinaia di testi di canzoni del leggendario Prince. Nella Parte Due ti concentrerai su analisi del sentiment (Due-A) e topic modeling (Due-B) con l’NLP. La Parte Tre si chiuderà con ulteriori attività di analitica predittiva usando tecniche di machine learning per rispondere a domande come se sia possibile determinare il decennio di uscita di una canzone o, ancora più interessante, prevedere se una canzone entrerà in classifica Billboard in base ai suoi testi. In tutta la serie userai diversi algoritmi di machine learning — ciascuno evidenziato in rosso nel grafico qui sotto.
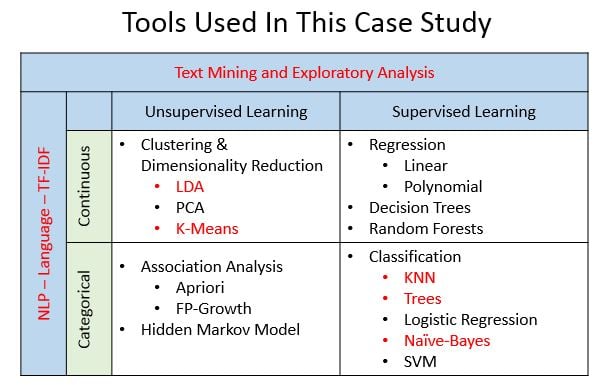
Sì, mi ero limitato a tre parti, ma ho deciso di dividere la Parte Due in Due-A (Analisi del sentiment) e Due-B (Topic Modeling — in arrivo), ottenendo così quattro tutorial distinti. Ci sono tanti ottimi articoli e corsi sul processo alla base dell’analisi del sentiment, quindi l’obiettivo della Parte Due-A è concentrarsi sul trarre insight dall’analisi — non solo sullo scrivere codice. Userai i testi di Prince come esempio, ma puoi applicare i passaggi al tuo artista preferito. Il tuo percorso lungo l’intera serie dovrebbe accendere curiosità sulle opportunità offerte dall’analisi dei testi musicali, mentre ti vengono presentate le tecniche di Natural Language Processing (NLP) e di machine learning.
La Parte Due-A di questa serie richiede una comprensione di base dei dati tidy — in particolare pacchetti come dplyr per la trasformazione dei dati, ggplot2 per le visualizzazioni e l’%>% pipe operator (originariamente dal pacchetto magrittr). Noterai che spesso più passaggi vengono combinati con l’operatore %>% per mantenere il codice compatto e riutilizzabile.
Poiché questo tutorial è anche un caso di studio, è ricco di visualizzazioni oltre ai grafici più comuni. Per questo, un altro prerequisito è saper installare nuovi pacchetti nel tuo ambiente. Per concentrarci sull’estrazione degli insight, ho incluso codice pensato per essere riutilizzato sul tuo dataset; spiegazioni più dettagliate richiederanno però ulteriori approfondimenti da parte tua. Per ogni pacchetto verranno forniti link di supporto. Questo ti esporrà a nuovi strumenti concentrandoti però sul loro impiego.
Suggerimento: leggi prima la Parte Uno per avere le basi della serie e un’idea del vocabolario denso e variegato dei testi di Prince.
Metodi: L’analisi del sentiment è un tipo di text mining che mira a determinare opinione e soggettività del contenuto. Applicata ai testi musicali, i risultati possono rappresentare non solo gli atteggiamenti dell’artista, ma anche rivelare influenze culturali pervasive. Esistono metodi diversi per l’analisi del sentiment, tra cui l’addestramento su un dataset noto, la creazione di classificatori con regole e l’uso di dizionari lessicali predefiniti (lessici). In questo tutorial userai l’approccio basato sui lessici, ma ti incoraggio a esplorare anche gli altri metodi e i relativi compromessi.
Livelli: Così come esistono più metodi, ci sono anche diversi livelli di analisi basati sul testo. In genere vengono identificati come documento, frase e parola. Nei testi musicali, il documento può essere definito come sentiment per decennio, anno, livello di classifica o canzone. Il livello della frase di solito non è un’opzione, perché la punteggiatura può interferire con rime e schemi. L’analisi a livello di parola espone informazioni dettagliate e può fungere da base per pratiche più avanzate di topic modeling.
Ogni progetto di data science ha bisogno di un set di domande da esplorare. Eccone alcune da tenere a mente lungo il tutorial: è possibile scrivere un programma che individui l’umore espresso nei testi? I lessici predefiniti sono sufficienti? Quanta preparazione dei dati è necessaria? Puoi collegare i risultati a eventi reali? Il sentiment cambia nel tempo? Le hit sono più positive o negative rispetto ai brani non entrati in classifica? Quali parole risaltano nei testi nell’anno in cui si dice che Prince abbia previsto l’11/9? Ha previsto la sua stessa morte?
Suggerimento: l’analisi dei testi musicali è molto diversa e in genere più complessa rispetto a discorsi o libri; è difficile trarre insight, quindi ricorda di essere cauto con ogni assunzione! In questo tutorial proporrò più domande che risposte, quindi preparati a pensare fuori dal parallelogramma quadrilatero!
Per iniziare ad analizzare i testi di Prince, carica le librerie qui sotto. Possono sembrare tante all’inizio, ma la maggior parte serve solo per grafici e chart. Dato l’uso frequente di visual, è preferibile definire uno schema colori standard per coerenza. Ho creato una lista con specifici codici colore ANSI. La funzione theme() di ggplot2 consente di personalizzare i singoli grafici, quindi creerai anche una tua funzione, theme_lyrics(), che modifica le impostazioni di default. Il pacchetto knitr è un motore per la generazione dinamica di report con R. Usalo insieme a kableExtra e formattable per creare tabelle di testo gradevoli e colorate. Crea inoltre una tua funzione, my_kable_styling(), per standardizzare l’output risultante di queste librerie. Menzionerò gli altri pacchetti quando verranno utilizzati.
library(dplyr) #Data manipulation (also included in the tidyverse package)
library(tidytext) #Text mining
library(tidyr) #Spread, separate, unite, text mining (also included in the tidyverse package)
library(widyr) #Use for pairwise correlation

#Visualizations!
library(ggplot2) #Visualizations (also included in the tidyverse package)
library(ggrepel) #`geom_label_repel`
library(gridExtra) #`grid.arrange()` for multi-graphs
library(knitr) #Create nicely formatted output tables
library(kableExtra) #Create nicely formatted output tables
library(formattable) #For the color_tile function
library(circlize) #Visualizations - chord diagram
library(memery) #Memes - images with plots
library(magick) #Memes - images with plots (image_read)
library(yarrr)  #Pirate plot
library(radarchart) #Visualizations
library(igraph) #ngram network diagrams
library(ggraph) #ngram network diagrams

#Define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#Customize ggplot2's default theme settings
#This tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #Center the title
        axis.ticks = aticks, #Set axis ticks to on or off
        panel.grid.minor = pgminor, #Turn the minor grid lines on or off
        legend.title = lt, #Turn the legend title on or off
        legend.position = lp) #Turn the legend on or off
}

#Customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}
Come sempre, inizierai leggendo i dati grezzi in un data frame. Nella Parte Uno hai effettuato un po’ di conditioning sul dataset originale, come espansione delle contrazioni, rimozione delle sequenze di escape e conversione del testo in minuscolo. Hai salvato quel dataset pulito in un file CSV da usare in questo tutorial. Usa read.csv() per creare prince_data e ricorda che vuoi i testi come stringhe di caratteri, quindi imposta stringsAsFactors = FALSE. Poiché non ti servono le righe numerate, imposta row.names = 1.
Nota che potresti evitare questi parametri leggendo in un moderno data frame chiamato tibble, usando read_csv(), ma per coerenza con la Parte Uno si usa invece read.csv().
prince_data <- read.csv('prince_new.csv', stringsAsFactors = FALSE, row.names = 1)
Dai una rapida occhiata ai dati:
glimpse(prince_data) #Transposed version of `print()`## Observations: 824
## Variables: 10
## $ lyrics <chr> "all 7 and we will watch them fall they stand in t...
## $ song <chr> "7", "319", "1999", "2020", "3121", "7779311", "u"...
## $ year <int> 1992, NA, 1982, NA, 2006, NA, NA, NA, NA, NA, NA, ...
## $ album <chr> "Symbol", NA, "1999", "Other Songs", "3121", NA, N...
## $ peak <int> 3, NA, 2, NA, 1, NA, NA, NA, NA, NA, NA, NA, NA, N...
## $ us_pop <chr> "7", NA, "12", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ us_rnb <chr> "61", NA, "4", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ decade <chr> "1990s", NA, "1980s", NA, "2000s", NA, NA, NA, NA,...
## $ chart_level <chr> "Top 10", "Uncharted", "Top 10", "Uncharted", "Top...
## $ charted <chr> "Charted", "Uncharted", "Charted", "Uncharted", "C...Puoi vedere che prince_data è un data frame con 824 canzoni e 10 colonne. Questo significa che un record è una canzone, letteralmente!
prince_tidyEcco alcuni passaggi di wrangling rimasti:
Per trasformare i dati grezzi in formato tidy, usa unnest_tokens() di tidytext per creare prince_tidy, che suddivide i testi in parole singole con una parola per riga. Poi puoi usare anti_join() e filter() di dplyr per i passaggi di pulizia rimanenti. (Vedi la Parte Uno per una spiegazione dettagliata.)
#Created in the first tutorial
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats", "la", "da", "uh", "ah")

#Create tidy text format: Unnested, Unsummarized, -Undesirables, Stop and Short words
prince_tidy <- prince_data %>%
  unnest_tokens(word, lyrics) %>% #Break the lyrics into individual words
  filter(!word %in% undesirable_words) %>% #Remove undesirables
  filter(!nchar(word) < 3) %>% #Words like "ah" or "oo" used in music
  anti_join(stop_words) #Data provided by the tidytext package
glimpse(prince_tidy) #From `dplyr`, better than `str()`.
 ## Observations: 76,116
## Variables: 10
## $ song        <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ year        <int> 1992, 1992, 1992, 1992, 1992, 1992, 1992, 1992, 19...
## $ album       <chr> "Symbol", "Symbol", "Symbol", "Symbol", "Symbol", ...
## $ peak        <int> 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3,...
## $ us_pop      <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ us_rnb      <chr> "61", "61", "61", "61", "61", "61", "61", "61", "6...
## $ decade      <chr> "1990s", "1990s", "1990s", "1990s", "1990s", "1990...
## $ chart_level <chr> "Top 10", "Top 10", "Top 10", "Top 10", "Top 10", ...
## $ charted     <chr> "Charted", "Charted", "Charted", "Charted", "Chart...
## $ word        <chr> "watch", "fall", "stand", "love", "smoke", "intell...
Il nuovo dataset, prince_tidy, è ora in formato tokenizzato con una parola per riga insieme alla canzone da cui proviene. Hai ora un data frame con 76.116 parole e 10 colonne.
Se non hai letto la Parte Uno, potresti aver bisogno di dare un’occhiata rapida ad alcuni grafici riepilogativi dell’intero dataset. Lo farai usando grafici creativi dei pacchetti ggplot2, circlize e yarrr.
Un pirata direbbe shipshape quando è tutto a posto, ordinato e pulito. Ecco quindi una vista interessante dei dati puliti e ordinati che mostra la diversità lessicale, ovvero il vocabolario, dei testi nel tempo. Un pirate plot è un metodo avanzato per rappresentare una variabile dipendente continua, come il conteggio parole, in funzione di una variabile indipendente categoriale, come il decennio. Combina punti grezzi, statistiche descrittive e inferenziali in un unico grafico efficace. Dai un’occhiata a questo ottimo blog per maggiori dettagli su pirateplot() del pacchetto yarrr.
Crea il data frame word_summary che calcola il conteggio di parole distinte per canzone. Più i testi sono vari, più ampio è il vocabolario. Pensare ai dati in questo modo ti prepara all’analisi a livello di parola. Reimposta il campo decennio al valore "NONE" per le canzoni senza data di uscita e rinomina quei campi con etichette più pulite usando select().
word_summary <- prince_tidy %>%
  mutate(decade = ifelse(is.na(decade),"NONE", decade)) %>%
  group_by(decade, song) %>%
  mutate(word_count = n_distinct(word)) %>%
  select(song, Released = decade, Charted = charted, word_count) %>%
  distinct() %>% #To obtain one record per song
  ungroup()

pirateplot(formula =  word_count ~ Released + Charted, #Formula
   data = word_summary, #Data frame
   xlab = NULL, ylab = "Song Distinct Word Count", #Axis labels
   main = "Lexical Diversity Per Decade", #Plot title
   pal = "google", #Color scheme
   point.o = .2, #Points
   avg.line.o = 1, #Turn on the Average/Mean line
   theme = 0, #Theme
   point.pch = 16, #Point `pch` type
   point.cex = 1.5, #Point size
   jitter.val = .1, #Turn on jitter to see the songs better
   cex.lab = .9, cex.names = .7) #Axis label size
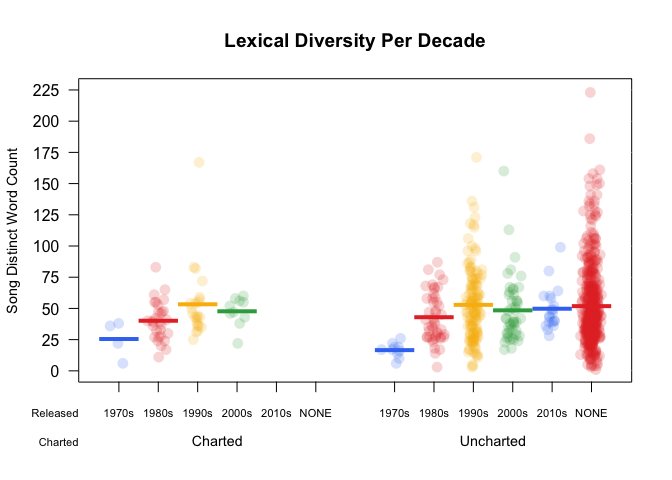
Ogni cerchio colorato in questo pirate plot rappresenta una canzone. L’area rossa densa con il valore "NONE" mostra che un gran numero di brani nel dataset non ha una data di uscita. C’è una lieve tendenza al rialzo nel numero di parole uniche per canzone nei primi decenni: la linea orizzontale continua mostra il numero medio di parole per quel decennio. Questo è importante quando inizi ad analizzare il sentiment nel tempo. Le parole diventano più rivelatrici lungo la carriera di Prince.
Ti invito a esplorare i pirate plot più a fondo: qui abbiamo solo scalfito la superficie!
I grafici circolari sono un modo unico per visualizzare relazioni complesse (o semplici!) tra più categorie. (E poi, i dischi una volta erano rotondi!). Il grafico qui sotto è semplicemente un bar chart circolare che usa coord_polar() di ggplot2 e mostra il numero relativo di canzoni per anno. È un bel po’ di codice per un grafico così semplice, ma ne vale la pena. Un esempio simile è spiegato più nel dettaglio nella R Graph Gallery qui. Come per i pirate plot, questa è solo un’introduzione a ciò che puoi fare con i grafici circolari.
songs_year <- prince_data %>%
  select(song, year) %>%
  group_by(year) %>%
  summarise(song_count = n())

id <- seq_len(nrow(songs_year))
songs_year <- cbind(songs_year, id)
label_data = songs_year
number_of_bar = nrow(label_data) #Calculate the ANGLE of the labels
angle = 90 - 360 * (label_data$id - 0.5) / number_of_bar #Center things
label_data$hjust <- ifelse(angle < -90, 1, 0) #Align label
label_data$angle <- ifelse(angle < -90, angle + 180, angle) #Flip angle
ggplot(songs_year, aes(x = as.factor(id), y = song_count)) +
  geom_bar(stat = "identity", fill = alpha("purple", 0.7)) +
  geom_text(data = label_data, aes(x = id, y = song_count + 10, label = year, hjust = hjust), color = "black", alpha = 0.6, size = 3, angle =  label_data$angle, inherit.aes = FALSE ) +
  coord_polar(start = 0) +
  ylim(-20, 150) + #Size of the circle
  theme_minimal() +
  theme(axis.text = element_blank(),
        axis.title = element_blank(),
        panel.grid = element_blank(),
        plot.margin = unit(rep(-4,4), "in"),
        plot.title = element_text(margin = margin(t = 10, b = -10)))
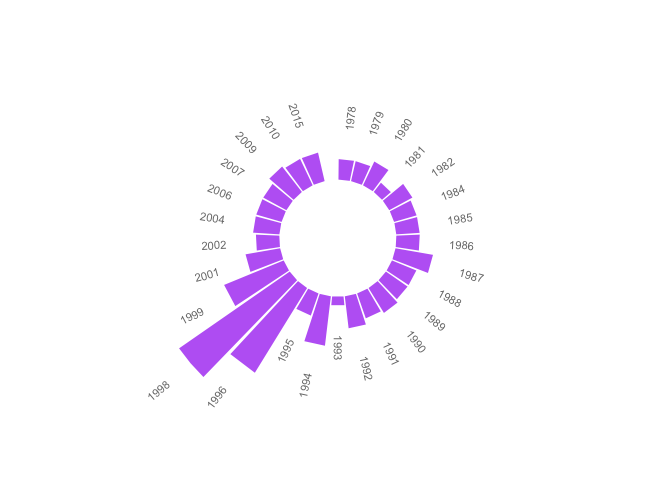
Vedi il vuoto in alto? Indica le centinaia di canzoni senza data di uscita che hai identificato nel pirate plot. Con un numero così alto di brani non datati, il grafico non sarebbe utile se fossero inclusi. Gli anni mancanti indicano quelli in cui non sono stati pubblicati brani. Gli anni più prolifici sono stati il 1996 e il 1998.
Vuoi sapere perché? Continua a leggere!
Il grafico seguente mostra la relazione tra il decennio di uscita di una canzone e il fatto che abbia o meno raggiunto le classifiche Billboard. Usare un chordDiagram() per un’analisi musicale è sembrato semplicemente appropriato! Questo strumento grafico proviene dal bellissimo pacchetto circlize di Zuguang Gu. Il grafico è diviso in due categorie: classifica (in alto) e decennio (in basso). Le due categorie sono separate da ampi spazi, con spazi più piccoli tra i valori. I commenti di alto livello nel codice qui sotto possono essere approfonditi qui.
decade_chart <-  prince_data %>%
  filter(decade != "NA") %>% #Remove songs without release dates
  count(decade, charted)  #Get SONG count per chart level per decade. Order determines top or bottom.

circos.clear() #Very important - Reset the circular layout parameters!
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "Charted" = "grey", "Uncharted" = "grey") #assign chord colors
# Set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_chart[[1]])) - 1), 15,
                         rep(5, length(unique(decade_chart[[2]])) - 1), 15))

chordDiagram(decade_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Chart and Decade")
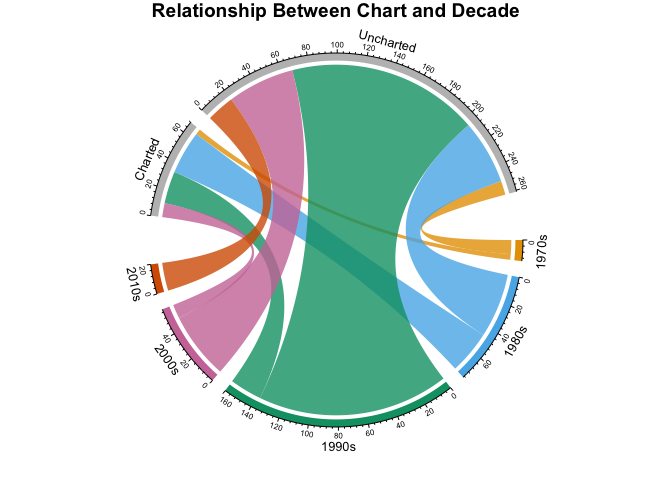
Il grafico circolare sopra può sembrare complesso a prima vista, ma illustra bene i conteggi di brani per decennio e per livello di classifica. Si vede che Prince iniziò la carriera negli anni ’70 con poche pubblicazioni, alcune delle quali entrarono in classifica. Confrontando gli anni ’80 con gli anni ’90, si nota che negli anni ’90 furono pubblicate più canzoni, ma negli anni ’80 entrarono in classifica più brani. Nei 2000 ci sono state poche canzoni di successo commerciale e negli anni 2010 non ci sono state hit.
In questa sezione farai:
Il pacchetto tidytext include un dataset chiamato sentiments che fornisce diversi lessici distinti. Questi lessici sono dizionari di parole con una categoria o un valore di sentiment assegnato. tidytext fornisce tre lessici generali:
Per esaminare i lessici, crea un data frame chiamato new_sentiments. Escludi un lessico finanziario, crea un campo di sentiment binario (detto anche polare) per AFINN convertendo il punteggio numerico in positivo o negativo, e aggiungi un campo con il conteggio di parole distinte per ciascun lessico.
new_sentiments ha una colonna con le diverse categorie di sentiment; per una vista migliore dei conteggi per lessico e per categoria, usa spread() di tidyr per ruotare quelle categorie in campi separati. Sfrutta i pacchetti knitr e kableExtra nella funzione my_kable_styling() che hai creato prima. Aggiungi colore alla tabella usando color_tile() e color_bar() di formattable per creare una tabella ben formattata. Stampa la tabella ed esamina le differenze tra i lessici.
new_sentiments <- sentiments %>% #From the tidytext package
  filter(lexicon != "loughran") %>% #Remove the finance lexicon
  mutate( sentiment = ifelse(lexicon == "AFINN" & score >= 0, "positive",
                              ifelse(lexicon == "AFINN" & score < 0,
                                     "negative", sentiment))) %>%
  group_by(lexicon) %>%
  mutate(words_in_lexicon = n_distinct(word)) %>%
  ungroup()

new_sentiments %>%
  group_by(lexicon, sentiment, words_in_lexicon) %>%
  summarise(distinct_words = n_distinct(word)) %>%
  ungroup() %>%
  spread(sentiment, distinct_words) %>%
  mutate(lexicon = color_tile("lightblue", "lightblue")(lexicon),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon)) %>%
  my_kable_styling(caption = "Word Counts Per Lexicon")
| lexicon | words_in_lexicon | anger | anticipation | disgust | fear | joy | negative | positive | sadness | surprise | trust |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AFINN | 2476 | NA | NA | NA | NA | NA | 1597 | 879 | NA | NA | NA |
| bing | 6785 | NA | NA | NA | NA | NA | 4782 | 2006 | NA | NA | NA |
| nrc | 6468 | 1247 | 839 | 1058 | 1476 | 689 | 3324 | 2312 | 1191 | 534 | 1231 |
La tabella sopra ti dà un’idea della dimensione e della struttura di ciascun lessico.
Per capire quale lessico si adatti meglio ai testi, vorrai guardare al rapporto di match tra le parole in comune tra lessico e testi. Ricorda: in prince_tidy ci sono 76.116 parole totali e 7.851 parole distinte.
Quante di quelle parole compaiono effettivamente nei lessici?
Usa un inner_join() tra prince_tidy e new_sentiments e poi raggruppa per lessico. Il lessico NRC ha 10 categorie diverse e una parola può apparire in più categorie: ad esempio, può essere negativa e triste. Per questo userai n_distinct() in summarise() per ottenere il conteggio di parole distinte per lessico.
prince_tidy %>%
  mutate(words_in_lyrics = n_distinct(word)) %>%
  inner_join(new_sentiments) %>%
  group_by(lexicon, words_in_lyrics, words_in_lexicon) %>%
  summarise(lex_match_words = n_distinct(word)) %>%
  ungroup() %>%
  mutate(total_match_words = sum(lex_match_words), #Not used but good to have
         match_ratio = lex_match_words / words_in_lyrics) %>%
  select(lexicon, lex_match_words,  words_in_lyrics, match_ratio) %>%
  mutate(lex_match_words = color_bar("lightpink")(lex_match_words),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Lyrics Found In Lexicons")
| lexicon | lex_match_words | words_in_lyrics | match_ratio |
|---|---|---|---|
| AFINN | 770 | 7851 | 0.0980767 |
| bing | 1185 | 7851 | 0.1509362 |
| nrc | 1678 | 7851 | 0.2137307 |
Il lessico NRC contiene più parole distinte dei testi rispetto ad AFINN o Bing. Nota che la somma dei rapporti di match è bassa. Nessun lessico può contenere tutte le parole, né dovrebbe. Molte parole sono considerate neutre e non avrebbero un sentiment associato. Per esempio, 2000 è in genere una parola neutra e quindi non esiste nei lessici. Tuttavia, se ricordi, in quell’anno si temeva che gli aerei cadessero dal cielo e che i computer smettessero di funzionare. Quindi c’è una paura associata che esiste nel brano ma non viene catturata dall’analisi del sentiment usando lessici tipici.
Ecco alcuni motivi per cui una parola potrebbe non apparire in un lessico:
Guarda alcune parole specifiche tratte dai testi di Prince che sembrano avere impatto sul sentiment. Ci sono in tutti i lessici?
new_sentiments %>%
  filter(word %in% c("dark", "controversy", "gangster",
                     "discouraged", "race")) %>%
  arrange(word) %>% #sort
  select(-score) %>% #remove this field
  mutate(word = color_tile("lightblue", "lightblue")(word),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Specific Words")
| word | sentiment | lexicon | words_in_lexicon |
|---|---|---|---|
| controversy | negative | nrc | 6468 |
| controversy | negative | bing | 6785 |
| dark | sadness | nrc | 6468 |
| dark | negative | bing | 6785 |
| discouraged | negative | AFINN | 2476 |
| gangster | negative | bing | 6785 |
Controversy e dark compaiono in NRC e Bing, ma gangster solo in Bing. Race non compare affatto ed è un tema cruciale nei testi di Prince. Ma è facilmente associabile a un sentiment? Nota che AFINN è molto più piccolo e contiene solo una di queste parole.
Ora guarda un esempio più complicato. La sessualità è un tema ricorrente nella musica di Prince. In che modo l’analisi del sentiment basata su lessici predefiniti viene influenzata dalle diverse forme di una parola? Ad esempio, ecco tutti i riferimenti alla radice sex nei testi. Confrontali con Bing e NRC e vedi dove ci sono corrispondenze.
my_word_list <- prince_data %>%
  unnest_tokens(word, lyrics) %>%
  filter(grepl("sex", word)) %>% #Use `grepl()` to find the substring `"sex"`
  count(word) %>%
  select(myword = word, n) %>% #Rename word
  arrange(desc(n))

new_sentiments %>%
  #Right join gets all words in `my_word_list` to show nulls
  right_join(my_word_list, by = c("word" = "myword")) %>%
  filter(word %in% my_word_list$myword) %>%
  mutate(word = color_tile("lightblue", "lightblue")(word),
          instances = color_tile("lightpink", "lightpink")(n),
          lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  select(-score, -n) %>% #Remove these fields
  my_kable_styling(caption = "Dependency on Word Form")
| word | sentiment | lexicon | words_in_lexicon | instances |
|---|---|---|---|---|
| sexy | positive | bing | 6785 | 220 |
| sexy | positive | AFINN | 2476 | 220 |
| sex | anticipation | nrc | 6468 | 185 |
| sex | joy | nrc | 6468 | 185 |
| sex | positive | nrc | 6468 | 185 |
| sex | trust | nrc | 6468 | 185 |
| superfunkycalifragisexy | NA | NA | NA | 19 |
| lovesexy | NA | NA | NA | 16 |
| sexual | NA | NA | NA | 11 |
| sexuality | NA | NA | NA | 11 |
| sexiness | NA | NA | NA | 2 |
| sexually | NA | NA | NA | 2 |
| sexe | NA | NA | NA | 1 |
| sexed | NA | NA | NA | 1 |
| sexier | NA | NA | NA | 1 |
| superfunkycalifraagisexy | NA | NA | NA | 1 |
| superfunkycalifragisexi | NA | NA | NA | 1 |
Nota che Prince usa spesso sexy, ma in questa forma non esiste in NRC. La parola sex si trova in NRC ma non in Bing. E se guardassi agli stemi o alle radici delle parole, aiuterebbe? Che dilemma! Il tuo testo può contenere un passato, un plurale o un avverbio di una radice, ma potrebbe non esistere in alcun lessico. Come gestirlo?
Potrebbe essere necessario aggiungere qualche passaggio di preparazione dei dati. Ecco tre tecniche da considerare prima di eseguire l’analisi del sentiment:
Un concetto avanzato nell’analisi del sentiment è quello della sostituzione con sinonimi (pari semanticamente simili) e iperonimi (un genitore comune). Sono parole più frequenti rispetto a quelle presenti nel testo e che compaiono in un lessico, aumentando così la percentuale di match. Non c’è abbastanza spazio in questo tutorial per affrontare ulteriore preparazione dei dati, ma è sicuramente qualcosa da considerare!
Sfida: fai un po’ di ricerca sui lessici e su come vengono creati. Esiste già un lessico più adatto ai testi musicali? Se sei davvero interessato, valuta cosa servirebbe per costruirne uno tuo. Qual è la differenza tra analisi del sentiment basata su classificatori e analisi basata su lessici?
Ora che hai una base sul dataset e sui lessici, puoi applicare queste conoscenze unendoli per l’analisi. Ecco i passaggi a grandi linee:
Inizia creando i dataset di sentiment di Prince per ciascun lessico eseguendo un inner_join() sulla funzione get_sentiments(). Passa il nome del lessico a ogni chiamata. Per questo esercizio, usa Bing per i sentiment binari e NRC per quelli categoriali. Poiché in NRC le parole possono apparire in più categorie, come Negativo/Paura o Positivo/Gioia, crea anche un sottoinsieme senza le categorie positive e negative da usare più avanti.
prince_bing <- prince_tidy %>%
  inner_join(get_sentiments("bing"))
prince_nrc <- prince_tidy %>%
  inner_join(get_sentiments("nrc"))
prince_nrc_sub <- prince_tidy %>%
  inner_join(get_sentiments("nrc")) %>%
  filter(!sentiment %in% c("positive", "negative"))
Nell’analisi dettagliata dei testi, vorrai esaminare diversi livelli di testo, come tutte le canzoni, livello classifica, livello decennio e livello parola. Inizia tracciando l’analisi del sentiment NRC dell’intero dataset.
(Per divertimento, ho usato i pacchetti memery e magick per aggiungere immagini (meme) ai grafici.)
nrc_plot <- prince_nrc %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  #Use `fill = -word_count` to make the larger bars darker
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) + #Turn off the legend
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 15000)) + #Hard code the axis limit
  ggtitle("Prince NRC Sentiment") +
  coord_flip()

img <- "prince_background2.jpg" #Load the background image
lab <- ""  #Turn off the label
#Overlay the plot on the image and create the meme file
meme(img, lab, "meme_nrc.jpg", inset = nrc_plot)
#Read the file back in and display it!
nrc_meme <- image_read("meme_nrc.jpg")
plot(nrc_meme)
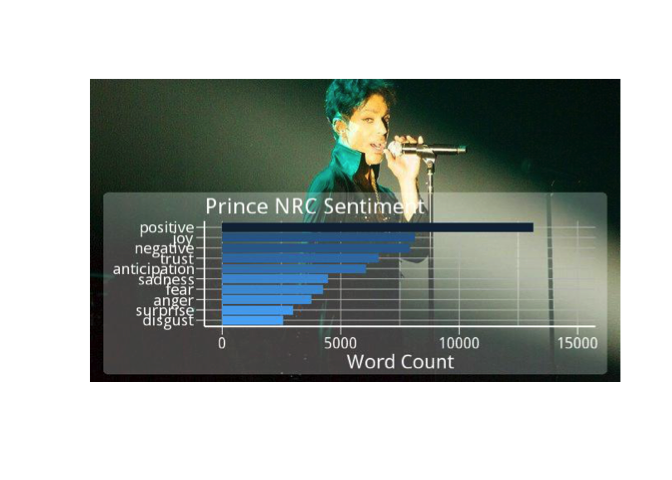
Sembra che, per i testi di Prince, l’NRC propenda nettamente per il positivo. Ma tutte le parole con sentiment di disgusto o rabbia rientrano anche nella categoria negativa? Potrebbe valere la pena verificarlo.
Ora dai un’occhiata al sentiment complessivo di Bing. Delle 1185 parole distinte dei testi di Prince presenti nel lessico Bing, quante sono positive e quante negative?
bing_plot <- prince_bing %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = sentiment)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 8000)) +
  ggtitle("Prince Bing Sentiment") +
  coord_flip()

img1 <- "prince_background1.jpg"
lab1 <- ""
meme(img1, lab1, "meme_bing.jpg", inset = bing_plot)
x <- image_read("meme_bing.jpg")
plot(x)
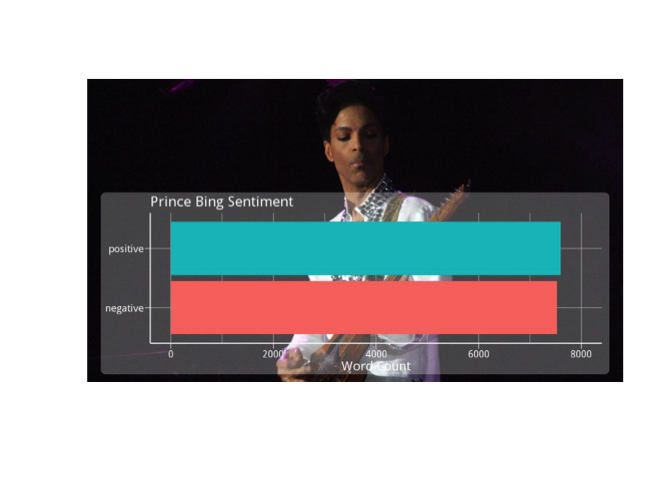
Potrebbe essere che, per Bing, nel repertorio di Prince ci sia un sentiment positivo e negativo in parti uguali? Il sentiment complessivo si annulla quando si guarda a un dataset troppo ampio? Difficile dirlo, ma prova a guardarlo a blocchi e vedi cosa succede.
In acustica esiste qualcosa chiamato cancellazione di fase: quando la frequenza di due istanze della stessa onda è esattamente sfasata, si annullano a vicenda, per esempio quando registri una batteria con due microfoni e il suono impiega più tempo ad arrivare a uno dei due. Il risultato è il silenzio totale a quella frequenza! Come può applicarsi questo alla sentiment analysis su grandi dataset? Pensaci un po’.
Professore di linguistica: "In inglese, una doppia negazione produce un’affermazione. In russo, una doppia negazione resta una negazione. Tuttavia, non esiste lingua in cui due affermazioni possano formare una negazione." Studente in disaccordo: "Yeah, right."
Alza il volume della tua analisi scendendo al livello chart con il lessico Bing. Crea un grafico del sentiment polare per livello chart. Usa spread() per separare i sentiment in colonne e mutate() per creare un campo di polarità (positivo - negativo) e un campo percent_positive ($positive / total sentiment * 100$), per una prospettiva diversa. Per il grafico della polarità, aggiungi un yintercept con geom_hline(). Disporre i grafici affiancati con grid.arrange().
prince_polarity_chart <- prince_bing %>%
  count(sentiment, chart_level) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

#Polarity by chart
plot1 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, polarity, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = my_colors[3:5]) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity By Chart Level")

#Percent positive by chart
plot2 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, percent_positive, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = c(my_colors[3:5])) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive By Chart Level")

grid.arrange(plot1, plot2, ncol = 2)
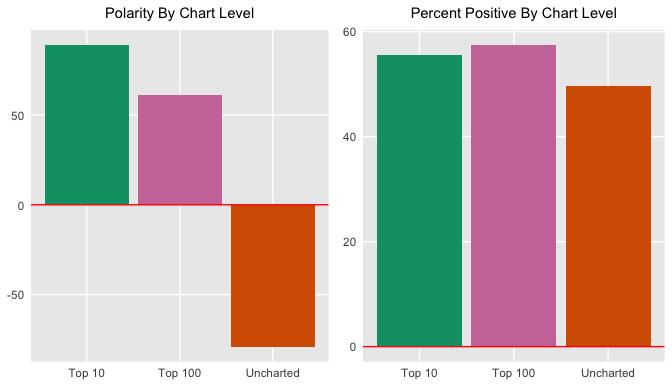
Questo indica che i brani entrati in classifica sono in genere più positivi che negativi? Se sì, cosa ti dice su ciò che la società vuole ascoltare? Possiamo davvero fare queste assunzioni? Guardando al sentiment positivo rispetto al sentiment totale, sembra che i brani in classifica siano solo leggermente più positivi dei negativi. Interessante, considerando che il lessico Bing ha di per sé più parole negative che positive.
Dato che stai guardando il sentiment da una prospettiva polare, potresti voler vedere se meteo cambia nel tempo (humor nerd). Stavolta usa geom_smooth() con il metodo loess per una curva più morbida e un altro geom_smooth() con method = lm per una curva lineare.
prince_polarity_year <- prince_bing %>%
  count(sentiment, year) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, polarity, color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity Over Time")

relative_polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, percent_positive , color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive Over Time")

grid.arrange(polarity_over_time, relative_polarity_over_time, ncol = 2)
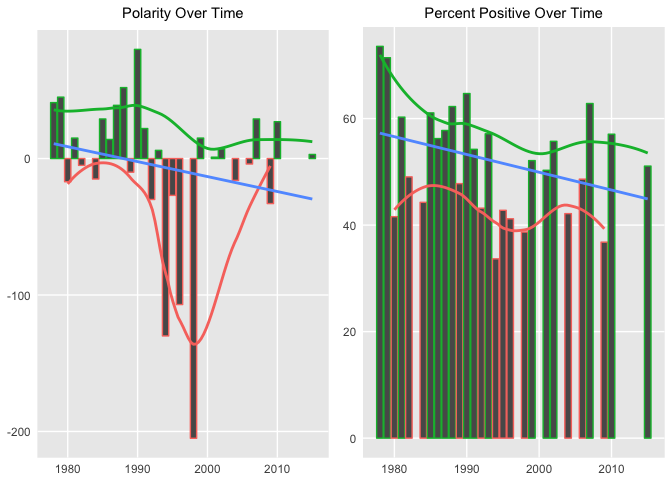
Nel secondo grafico sopra sono stati attenuati alcuni estremi, ma l’andamento complessivo della polarità nel tempo è negativo in entrambi i casi.
Userai di nuovo la potenza di chordDiagram() per esaminare le relazioni tra i sentiment NRC e i decenni. Nota che le categorie di sentiment compaiono nella parte superiore dell’anello e i decenni in quella inferiore.
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "anger" = "grey", "anticipation" = "grey", "disgust" = "grey", "fear" = "grey", "joy" = "grey", "sadness" = "grey", "surprise" = "grey", "trust" = "grey")

decade_mood <-  prince_nrc %>%
  filter(decade != "NA" & !sentiment %in% c("positive", "negative")) %>%
  count(sentiment, decade) %>%
  group_by(decade, sentiment) %>%
  summarise(sentiment_sum = sum(n)) %>%
  ungroup()

circos.clear()
#Set the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_mood[[1]])) - 1), 15,
                         rep(5, length(unique(decade_mood[[2]])) - 1), 15))
chordDiagram(decade_mood, grid.col = grid.col, transparency = .2)
title("Relationship Between Mood and Decade")
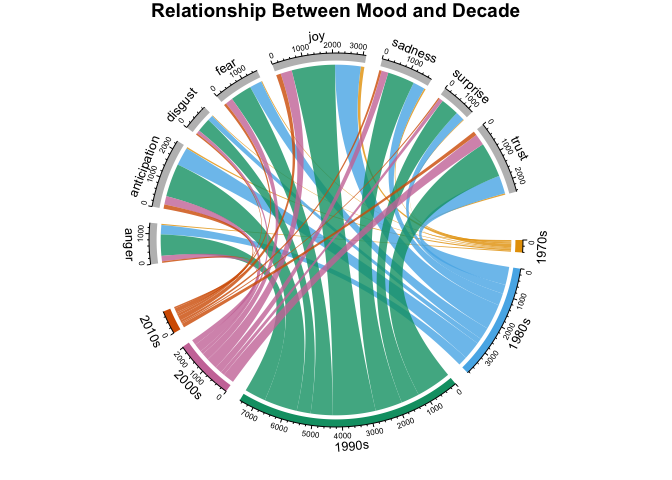
Qui vedi i conteggi di parole per categoria NRC per decennio. È tanto da assimilare in un grafico piccolo, ma fornisce un sacco di informazioni sulle relazioni tra categorie e tempo. Questi diagrammi sono estremamente personalizzabili e possono essere tanto semplici quanto informativi.
Visti tutti i fantastici corsi che hai seguito su DataCamp, probabilmente ti prudono le mani per applicare queste competenze a situazioni reali. Fallo adesso mappando l’analisi dei testi di Prince su qualcosa di reale in un intervallo di tempo. Tuttavia, sii scettico e cauto quando esegui un’analisi semplificata su un tema così complesso.
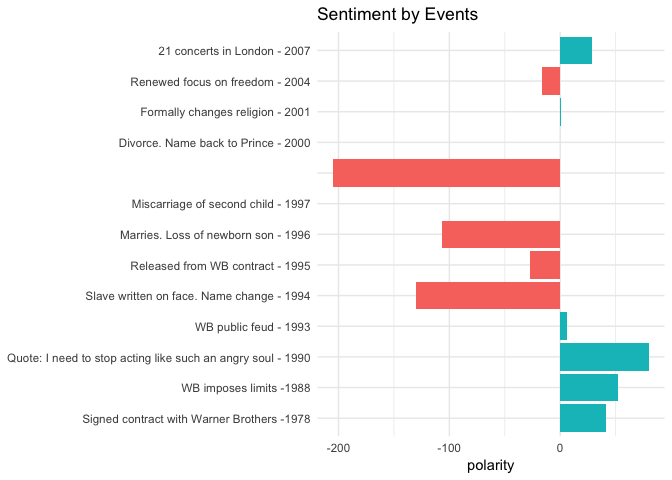
Ho creato un elenco di eventi della vita di Prince, raccolti da fonti popolari come Rolling Stone Magazine, Biography.com, ecc. Ho selezionato anni molto pubblici che corrispondono a canzoni con date di uscita presenti nel nostro dataset. Importa ora quegli eventi da princeEvents.csv. Poi usa prince_bing e spread() per creare un punteggio di polarità per anno. Effettua una join con il data frame events e crea un campo di sentiment per poter colorare il grafico a barre. Come sempre, usa coord_flip() quando mostri etichette testuali lunghe.
events <- read.csv('princeEvents.csv', stringsAsFactors = FALSE)

year_polarity_bing <- prince_bing %>%
  group_by(year, sentiment) %>%
  count(year, sentiment) %>%
  spread(sentiment, n) %>%
  mutate(polarity = positive - negative,
         ratio = polarity / (positive + negative)) #use polarity ratio in next graph

 events %>%
   #Left join gets event years with no releases
   left_join(year_polarity_bing) %>%
   filter(event != " ") %>% #Account for bad data
   mutate(event = reorder(event, year), #Sort chart by desc year
           sentiment = ifelse(positive > negative,
                              "positive", "negative")) %>%
   ggplot(aes(event, polarity, fill = sentiment)) +
   geom_bar(stat = "identity") +
   theme_minimal() + theme(legend.position = "none") +
   xlab(NULL) +
   ggtitle("Sentiment by Events") +
   coord_flip()
Suggerimento: puoi trovare princeEvents.csv qui.
Trovo affascinante confrontare gli eventi con il sentiment. Sebbene soggettivi, li ho trovati molto correlati. È vero, il dataset di eventi l’ho creato io. Avrei potuto facilmente introdurre un bias per farlo combaciare con i testi. Tuttavia, ho usato più fonti per ciascun anno per determinare il fatto più comunemente riportato. Questi risultati dovrebbero motivarti a scavare ancora più a fondo in un’analisi a livello di parola per vedere di cosa cantasse Prince.
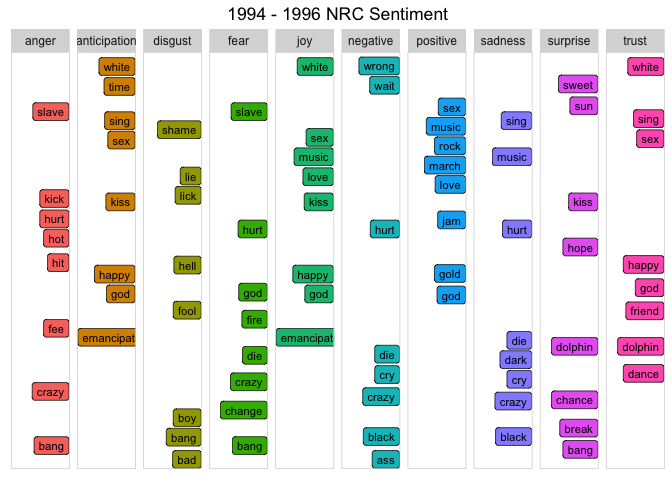
Nel 1994, Prince pubblicò The Black Album nel tentativo di riconquistare il suo pubblico afroamericano. Dato che il 1994 e i due anni successivi spiccano nell’analisi, puoi guardare le parole principali che corrispondono al lessico NRC per questo periodo usando geom_label_repel() dal pacchetto ggrepel insieme a geom_point(). È un grafico insidioso, quindi ti suggerisco di sperimentare con la configurazione del codice qui sotto.
plot_words_94_96 <- prince_nrc %>%
  filter(year %in% c("1994", "1995", "1996")) %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(8)) %>% #consider top_n() from dplyr also
  ungroup()

plot_words_94_96 %>%
  #Set `y = 1` to just plot one variable and use word as the label
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  #You want the words, not the points
  geom_point(color = "transparent") +
  #Make sure the labels don't overlap
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.04,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1994 - 1996 NRC Sentiment") +
  coord_flip()
Nel 1994, Prince dichiarò a Rolling Stone:
"Quando impedisci a un uomo di sognare, lo rendi uno schiavo. È lì che mi trovavo."
Così apparve in pubblico con la parola "slave" scritta in grande sul viso, dichiarando apertamente il suo sentiment anticorporate nei confronti dell’etichetta del momento. Cambiò anche il suo nome in un simbolo. Quanto bene le parole sopra combaciano con questi eventi? Noti le parole "slave", "emancipation", "black" e "change" nel grafico?
(Ricorda, non si tratta solo di Prince. Puoi applicarlo a qualsiasi testo! Per esempio, quali sono state le parole di trust più usate dal presidente Trump nel suo primo anno in carica?)
Il grafico Sentiment per eventi sopra indicava che tra il 1996 e il 1998 Prince si sposò, perse due figli e si disse che sul palco avesse predetto l’11 settembre. (Cerca su YouTube il suo concerto del 1998 nei Paesi Bassi per ascoltare di persona!) Usando gli stessi passaggi del grafico precedente, guarda le 10 parole principali in ciascuna categoria NRC durante il 1998.
plot_words_1998 <- prince_nrc %>%
  filter(year == "1998") %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(10)) %>%
  ungroup()

#Same comments as previous graph
plot_words_1998 %>%
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  geom_point(color = "transparent") +
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.05,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1998 NRC Sentiment") +
  coord_flip()
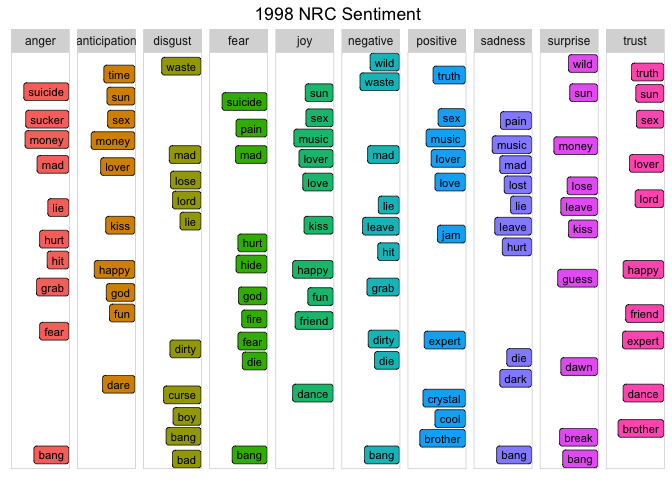
Dato il lutto personale e l’incombente minaccia del terrorismo, parole come "suicide", "waste", "mad", "hurt" e molte altre non catturate in questo grafico sono molto indicative degli eventi reali. Queste parole sono potenti e offrono un vero spaccato del sentiment di quel periodo.
Un altro ottimo modo per confrontare il sentiment tra categorie è usare un grafico radar, noto anche come spider chart. Puoi realizzare questo tipo di grafici con il pacchetto radarchart. Sono utili per vedere quali variabili hanno valori simili o se ci sono outlier per ciascuna variabile.
Scomporrai questa analisi su tre livelli: anno, chart e decennio. (Per risparmiare spazio, includerò solo il codice per gli anni specifici.)
prince_nrc_sub che non contiene i sentiment positivo e negativo, così gli altri risultano più visibili. Stavolta calcolerai prima il conteggio totale delle parole per sentiment per anno, oltre al sentiment totale per l’intero anno, e otterrai una percentuale ($count of sentiment words per year / total per year * 100$).select().spread() i valori di year e percent (coppie chiave/valore) in più colonne, così da avere una riga per ciascun sentiment e una colonna per ciascun anno. Poi usa chartJSRadar() per generare un widget HTML interattivo. Puoi passare un argomento per mostrare le etichette dei dataset al passaggio del mouse. (Per tua informazione, a volte la J e la Y della parola "joy" vengono tagliate da radarchart e sembra "iov".)#Get the count of words per sentiment per year
year_sentiment_nrc <- prince_nrc_sub %>%
group_by(year, sentiment) %>%
count(year, sentiment) %>%
select(year, sentiment, sentiment_year_count = n)
#Get the total count of sentiment words per year (not distinct)
total_sentiment_year <- prince_nrc_sub %>%
count(year) %>%
select(year, year_total = n)
#Join the two and create a percent field
year_radar_chart <- year_sentiment_nrc %>%
inner_join(total_sentiment_year, by = "year") %>%
mutate(percent = sentiment_year_count / year_total * 100 ) %>%
filter(year %in% c("1978","1994","1995")) %>%
select(-sentiment_year_count, -year_total) %>%
spread(year, percent) %>%
chartJSRadar(showToolTipLabel = TRUE,
main = "NRC Years Radar")
Dovrai scorrere su e giù per confrontare questi grafici perché ho voluto lasciarli a grandezza naturale. È interessante notare che, con un dataset più piccolo come year, riesci a vedere più distintamente la varianza di ciascun sentiment con questo tipo di visualizzazione. Potresti anche notare che, a differenza degli esercizi precedenti, usando una percentuale, "joy" ha il punteggio più alto in tutti i grafici (soprattutto all’inizio della carriera di Prince, nel 1978).
Spotify usa il machine learning per creare consigli musicali per i suoi 140 milioni di utenti attivi. Non usa ancora i contenuti testuali dei brani. Immagina se potesse... Ora quindi guarda ancora più a fondo nell’umore di singoli brani.
Nel 1987, Prince scrisse un brano intitolato "Sign O' the Times". Un articolo di Billboard di Kenneth Partridge affermava:
"Mentre affronta temi come AIDS, gang, droga, disastri naturali e persino l’esplosione dello Shuttle Challenger, Prince mantiene un tono freddo e distaccato. 'Sign O' the Times' è un aggiornamento di stato, non una chiamata all’azione. La sua soluzione non è marciare per le strade o chiamare il tuo parlamentare."
Come interpreterebbe l’algoritmo l’umore di questo brano? È molto emozionale o semplicemente informativo? Rappresenta Prince come persona o la società in generale? Grafica le categorie NRC con ggplot2.
prince_nrc %>%
  filter(song %in% "sign o the times") %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_minimal() + theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  ggtitle("Sign O' The Times NRC Sentiment") +
  coord_flip()
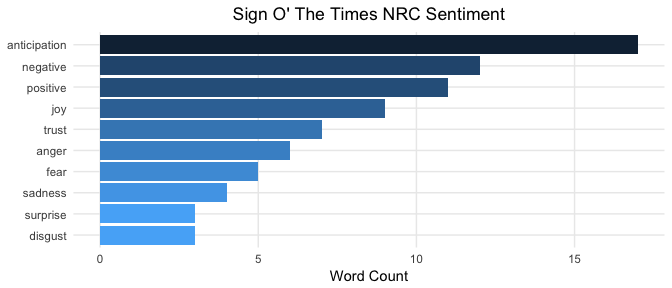
Benché ancora una volta altamente soggettivi, i risultati sembrano confermare che Prince "mantiene un tono freddo e distaccato", come affermato da Partridge. Ciò può essere interpretato osservando che le parole di anticipation sono più presenti di categorie emotive come sadness, fear e anger. Questo articolo afferma che queste tre categorie sono emozioni mentre anticipation è un sentiment. L’autore di Billboard affermava anche che il brano è semplicemente un "aggiornamento di stato, quasi privo di emozione". Sembra che l’algoritmo sia d’accordo. Tu lo interpreti allo stesso modo? So che questo è un tutorial su R, ma la sentiment analysis non è puramente tecnica. Si dice sia il punto in cui l’IA incontra la psicologia.
Usando ggplot2 per creare un grafico leggermente diverso, guarda le parole per ciascuna categoria.
prince_tidy %>%
  filter(song %in% 'sign o the times') %>%
  distinct(word) %>%
  inner_join(get_sentiments("nrc")) %>%
  ggplot(aes(x = word, fill = sentiment)) +
  facet_grid(~sentiment) +
  geom_bar() + #Create a bar for each word per sentiment
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) + #Place the words on the y-axis
  xlab(NULL) + ylab(NULL) +
  ggtitle("Sign O' The Times Sentiment Words") +
  coord_flip()
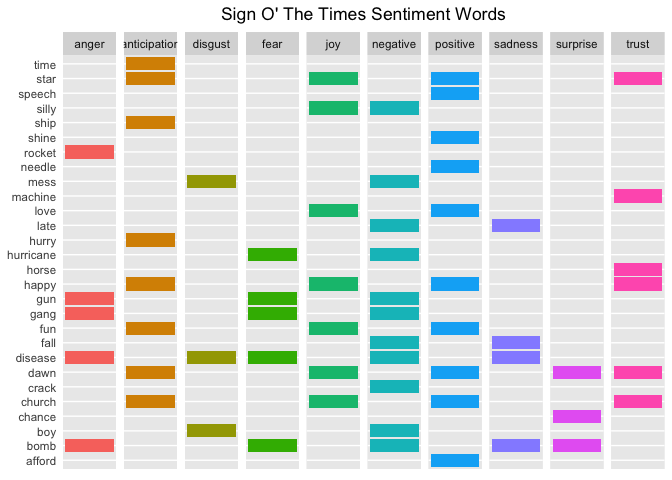
Riesci a far combaciare queste parole con i temi citati nell’articolo di Billboard? È piuttosto facile vedere la connessione: disastro del Challenger -> "rocket", AIDS -> "disease", droga -> "crack", disastri naturali -> "hurricane", gang -> "gang", ecc.
Sembra quasi che Partridge abbia scritto del codice R e creato questo grafico prima di scrivere l’articolo!
Guarda le categorie di sentiment per qualche altro brano dai titoli distintivi e verifica se sembrano correlate.
prince_nrc_sub %>%
  filter(song %in% c("so blue", "controversy", "raspberry beret",
                     "when doves cry", "the future", "1999")) %>%
  count(song, sentiment, year) %>%
  mutate(sentiment = reorder(sentiment, n), song = reorder(song, n)) %>%
  ggplot(aes(sentiment, n, fill = sentiment)) +
  geom_col() +
  facet_wrap(year ~ song, scales = "free_x", labeller = label_both) +
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) +
  labs(x = NULL, y = NULL) +
  ggtitle("NRC Sentiment Song Analysis") +
  coord_flip()
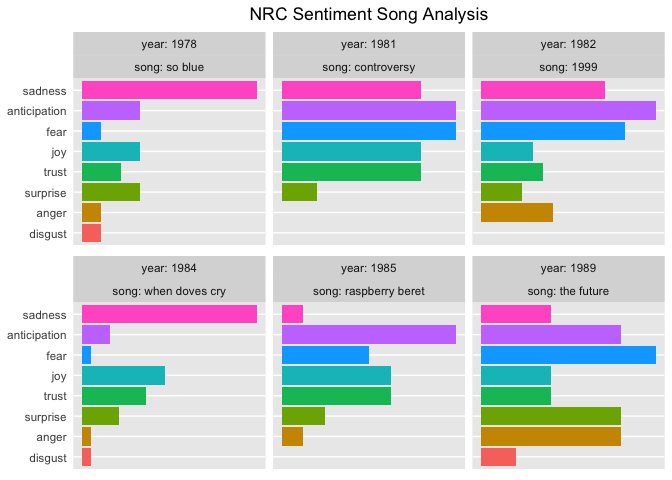
I sentiment NRC mostrano alta anticipation e fear per un brano sul futuro, e le stesse cose più alta trust per un brano su controversy. Anche i brani prevalentemente sad sembrano rispecchiare i loro titoli.
Finora hai guardato solo agli unigrammi o singole parole. Ma se "love" è una parola comune, cosa la precede? O cosa la segue? Guardare parole isolate fuori contesto può essere fuorviante. È il momento di analizzare alcuni bigrammi o coppie di parole.
Comodamente, il pacchetto tidytext permette di "disinnestare" coppie di parole oltre che singole parole. In questo caso, chiamerai unnest_tokens() passando l’argomento token come ngrams. Poiché ti interessano solo i bigrammi (due parole consecutive), passa n = 2. Usa prince_bigrams per salvare i risultati.
Il pacchetto tidyr consente di separare i bigrammi in parole singole con la funzione separate(). Per rimuovere stop word e parole indesiderate, conviene scomporre i bigrammi e filtrare ciò che non vuoi, quindi usare unite() per ricomporre le coppie. Questo rende facile visualizzare i bigrammi più comuni per decennio. (Vedi la Parte Uno per una spiegazione di slice() e row_number())
prince_bigrams <- prince_data %>%
  unnest_tokens(bigram, lyrics, token = "ngrams", n = 2)

bigrams_separated <- prince_bigrams %>%
  separate(bigram, c("word1", "word2"), sep = " ")

bigrams_filtered <- bigrams_separated %>%
  filter(!word1 %in% stop_words$word) %>%
  filter(!word2 %in% stop_words$word) %>%
  filter(!word1 %in% undesirable_words) %>%
  filter(!word2 %in% undesirable_words)

#Because there is so much repetition in music, also filter out the cases where the two words are the same
bigram_decade <- bigrams_filtered %>%
  filter(word1 != word2) %>%
  filter(decade != "NA") %>%
  unite(bigram, word1, word2, sep = " ") %>%
  inner_join(prince_data) %>%
  count(bigram, decade, sort = TRUE) %>%
  group_by(decade) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  arrange(decade, n) %>%
  mutate(row = row_number())
## Joining, by = c("song", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level", "charted")bigram_decade %>%
ggplot(aes(row, n, fill = decade)) +
geom_col(show.legend = FALSE) +
facet_wrap(~decade, scales = "free_y") +
xlab(NULL) + ylab(NULL) +
scale_x_continuous( # This handles replacement of row
breaks = bigram_decade$row, # Notice need to reuse data frame
labels = bigram_decade$bigram) +
theme_lyrics() +
theme(panel.grid.major.x = element_blank()) +
ggtitle("Bigrams Per Decade") +
coord_flip()
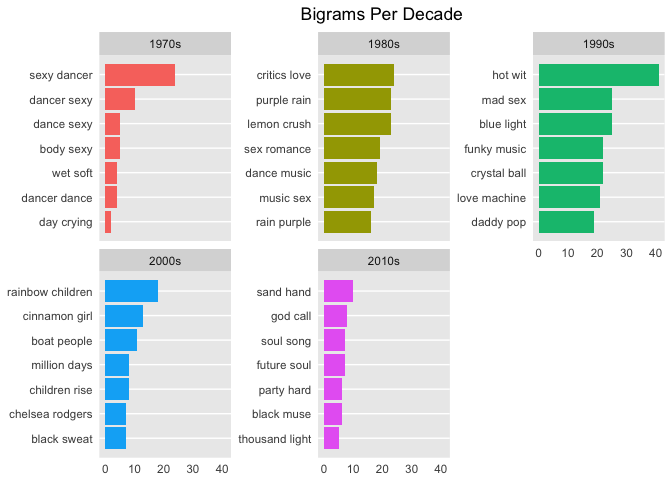
Usando i bigrammi, si può quasi vedere come le frasi comuni passino da sesso, danza e romanticismo a religione e (rainbow) children. Nel caso non lo sapessi, il termine "rainbow baby" è talvolta usato dai genitori che aspettano un altro figlio dopo averne perso uno per aborto spontaneo. Curiosamente, non ho trovato una recensione vera dell’album Rainbow Children di Prince che lo notasse.
Quindi come influiscono i bigrammi sul sentiment? Stavolta usa il lessico AFINN per fare sentiment analysis su coppie di parole, osservando quanto spesso le parole associate al sentiment siano precedute da "not" o altre negazioni.
AFINN <- get_sentiments("afinn")

not_words <- bigrams_separated %>%
  filter(word1 == "not") %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word2, score, sort = TRUE) %>%
  ungroup()

not_words %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  head(20) %>%
  mutate(word2 = reorder(word2, contribution)) %>%
  ggplot(aes(word2, n * score, fill = n * score > 0)) +
  geom_col(show.legend = FALSE) +
  theme_lyrics() +
  xlab("Words preceded by \"not\"") +
  ylab("Sentiment score * Number of Occurrences") +
  ggtitle("Polar Sentiment of Words Preceded by Not") +
  coord_flip()
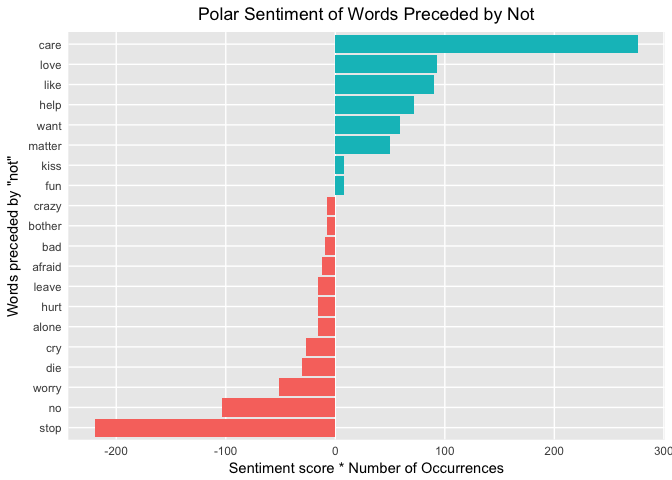
Nella prima riga del grafico, care riceve un sentiment falso positivo perché il "not" viene ignorato nell’analisi a parola singola. I bigrammi falsi positivi annullano i bigrammi falsi negativi?
Un’altra domanda a cui non so rispondere, ma è un ottimo spunto per ulteriori esplorazioni. Suggerimento: puoi anche passare i parametri "trigrams" e "n = 3" a unnest_tokens() per analizzare ancora più parole consecutive!
Ci sono anche altre parole di negazione da considerare. Stavolta creerai un grafo di rete usando i pacchetti ggraph e igraph. Disporrai le parole in nodi connessi con le parole di negazione al centro. Crea il primo oggetto dal dataset tidy usando graph_from_data_frame() e poi usa ggraph() per tracciarlo. Puoi evidenziare i nodi principali con una chiamata a geom_edge_density(). Puoi trovare maggiori dettagli su un esempio simile nel libro di Julia Silge e David Robinson su Tidy Text Mining.
negation_words <- c("not", "no", "never", "without")

negation_bigrams <- bigrams_separated %>%
  filter(word1 %in% negation_words) %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word1, word2, score, sort = TRUE) %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  group_by(word1) %>%
  slice(seq_len(20)) %>%
  arrange(word1,desc(contribution)) %>%
  ungroup()

bigram_graph <- negation_bigrams %>%
  graph_from_data_frame() #From `igraph`

set.seed(123)

a <- grid::arrow(type = "closed", length = unit(.15, "inches"))

ggraph(bigram_graph, layout = "fr") +
  geom_edge_link(alpha = .25) +
  geom_edge_density(aes(fill = score)) +
  geom_node_point(color = "purple1", size = 1) + #Purple for Prince!
  geom_node_text(aes(label = name),  repel = TRUE) +
  theme_void() + theme(legend.position = "none",
                       plot.title = element_text(hjust = 0.5)) +
  ggtitle("Negation Bigram Network")
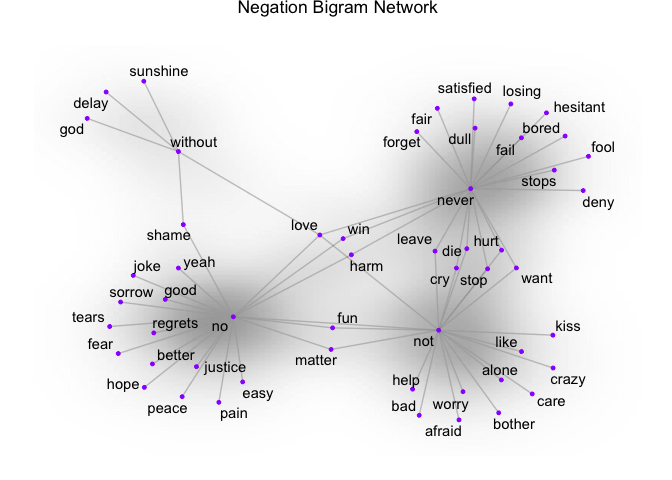
Qui puoi vedere le coppie di parole associate alle negazioni. Quindi, se la tua analisi si basa sugli unigrammi e "alone" risulta negativa, il bigramma "not alone" come vedi sopra avrà un effetto opposto. Alcune parole compaiono in più nodi, cosa che si nota chiaramente in una visualizzazione come questa: per esempio, "never hurt" e "not hurt".
Dato che ora hai visto gli n-grammi, guarda la correlazione tra parole. Quali parole sono più correlate? Usa la funzione pairwise_count() dal pacchetto widyr per identificare i conteggi di co-occorrenza. Cioè, conti quante volte ogni coppia di parole appare insieme all’interno di un brano. Il pacchetto widyr prende un dataset tidy e lo amplia temporaneamente prima di riportarlo a una struttura tidy per la visualizzazione e l’analisi successiva.
Per semplicità, ho scelto quattro parole interessanti nei testi di Prince.
pwc <- prince_tidy %>%
  filter(n() >= 20) %>%  #High counts
  pairwise_count(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  mutate(row = -row_number()) #Descending order

pwc %>%
  ggplot(aes(row, n, fill = item1)) +
  geom_bar(stat = "identity", show.legend = FALSE) +
  facet_wrap(~item1, scales = "free") +
  scale_x_continuous(  #This handles replacement of row
      breaks = pwc$row, #Notice need to reuse data frame
      labels = pwc$item2) +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Counts") +
  coord_flip()
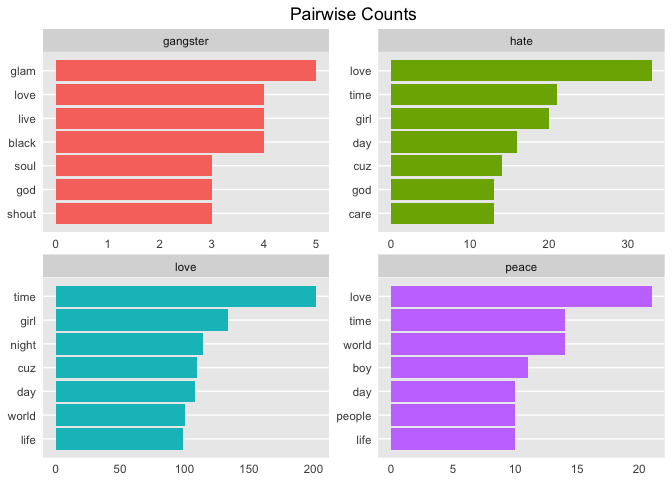
Confrontalo con la correlazione a coppie. Si riferisce a quanto spesso le parole compaiono insieme rispetto a quanto compaiono separatamente. Usa pairwise_cor() per determinare la correlazione tra parole in base a quante volte appaiono nello stesso brano.
prince_tidy %>%
  group_by(word) %>%
  filter(n() >= 20) %>%
  pairwise_cor(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  top_n(7) %>%
  ungroup() %>%
  mutate(item2 = reorder(item2, correlation)) %>%
  ggplot(aes(item2, correlation, fill = item1)) +
  geom_bar(stat = 'identity', show.legend = FALSE) +
  facet_wrap(~item1, scales = 'free') +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Correlation") +
  coord_flip()
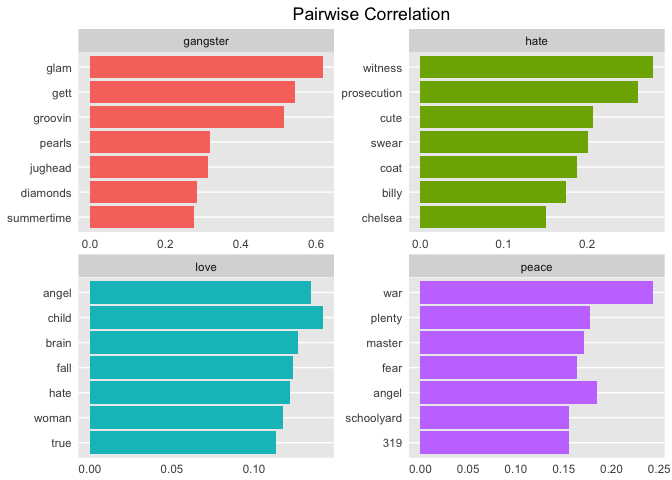
Credo che queste siano intuizioni affascinanti sui testi, basate solo su queste quattro parole! Guardando questi risultati, inizi a vedere emergere alcuni temi. È un ottimo trampolino verso il prossimo tutorial sul Topic Modeling!
In questo tutorial, hai creato un dataset tidy e analizzato informazioni di base come la diversità lessicale e il numero di brani per anno di pubblicazione, e hai esaminato la relazione tra decennio di uscita e ingresso in classifica. Hai poi esplorato alcuni lessici di sentiment e quanto bene si adattassero ai testi. Quindi hai eseguito la sentiment analysis su tutti i brani del dataset, il sentiment nel tempo, il sentiment a livello di brano e l’impatto dei bigrammi. L’hai fatto usando una grande varietà di grafici interessanti, ciascuno con una prospettiva diversa.
Dunque, è possibile scrivere un programma per determinare l’umore dei testi? Sì, lo è! Quanto sono affidabili i risultati? Dipende da un ampio ventaglio di criteri come la quantità di preparazione dei dati, la scelta del lessico, il metodo di analisi, la qualità dei dati di origine e così via. Confrontare eventi reali, sia personali sia sociali, può illuminare l’umore di qualsiasi testo. Il sentiment polare di Prince sembra essere leggermente calato col tempo, eppure nel complesso la gioia pare emergere. I brani entrati in classifica sembrano più positivi di quelli fuori classifica. Le affermazioni di aver predetto l’11 settembre e la sua stessa morte sembrano riecheggiare in modo inquietante nelle sue parole.
Ma i testi sono complessi e troppe assunzioni possono creare problemi. Se porti quanto hai imparato sui testi nel prossimo tutorial, Parte Due-B sul Topic Modeling, sarai ben avviato a scavare temi e motivi ricorrenti. Quanto NLP si può applicare a testi privi di punteggiatura o struttura della frase? Di cosa cantava davvero Prince? Ora che ne hai compreso l’umore, sei più preparato a indagare i possibili argomenti. E infine, puoi applicare tecniche di machine learning per prevedere il decennio o il livello di classifica di un brano? Unisciti a me nei prossimi tutorial per scoprirlo!
Spero che il viaggio fin qui ti sia piaciuto. Nella Parte Due-B faremo festa come se fosse il 1999!
Scopri di più su R
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



