
Last chance! 50% off DataCamp Premium
Sale ends in
Prince, The Artist, के जीवन और दौर की एक भावनात्मक यात्रा पर निकलें। यह तीन-भागीय ट्यूटोरियल श्रृंखला का भाग टू-ए है, जिसमें R की मदद से सेंटिमेंट एनालिसिस कर के The Artist के करियर और सामाजिक प्रभाव को समझने की कोशिश की जाएगी। तीनों ट्यूटोरियल्स में निम्न शामिल हैं:
यदि आप सेंटिमेंट एनालिसिस के बारे में और सीखना चाहते हैं, तो हमारा Sentiment Analysis in R: The Tidy Way कोर्स ज़रूर देखें।
क्या आप जानते हैं कि Prince ने 9/11 की भविष्यवाणी, उसके होने से तीन साल पहले, स्टेज पर कर दी थी? यह भी कहा जाता है कि उन्होंने अपनी मौत की भी भविष्यवाणी की। क्या यह सच हो सकता है? क्या उनके बोलों का विश्लेषण कर, आप खुद कोई ठोस निष्कर्ष निकालना नहीं चाहेंगे? 21 अप्रैल, 1985 को उन्होंने "Sometimes It Snows In April" रिकॉर्ड किया। ठीक 31 साल बाद, 21 अप्रैल, 2016 को उनका निधन हुआ। इस गाने के सेंटिमेंट एनालिसिस में उनके शब्द-चयन पर नज़र डालें:
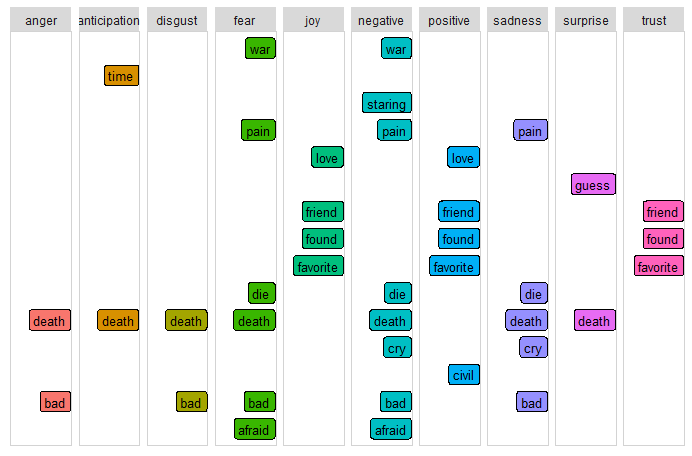
यह प्रेडिक्टिव एनालिटिक्स को एक नया मतलब देता है!
हर कोड के बाद एक इनसाइट दी गई है, जो आम तौर पर व्यक्तिनिष्ठ होती है। आप चाहें तो अपने अनुमान लगाते हुए सेक्शन दर सेक्शन आगे बढ़ सकते हैं! मैं सुझाव दूंगा कि आप नीचे दिए गए परिचय को पढ़ें, पर यदि आप सीधे कोड पर जाना चाहते हैं तो यहाँ क्लिक करें। यदि आप पहले से लेक्सिकॉन के सिद्धांत को समझते हैं, तो सीधे डिटेल्ड एनालिसिस सेक्शन में जा सकते हैं।
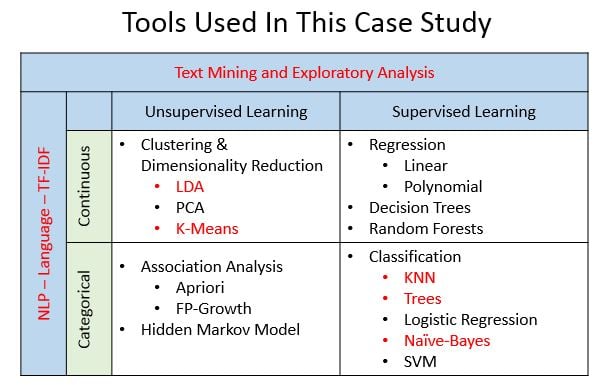
मैंने अभी-अभी दो बिल्ली के बच्चे और एक पप्पी को अपनाया है, तो अब मैं हर बात तीन में सोचता हूँ। ऊपर से, रूल ऑफ थ्री एक लेखन सिद्धांत है जो कहता है कि तीन में आने वाली चीज़ें स्वाभाविक रूप से अधिक मज़ेदार, संतोषजनक, या प्रभावी होती हैं—इसीलिए इसे तीन भागों में बाँटा गया है... तो, भाग वन में, आपने दिग्गज कलाकार Prince के सैकड़ों गीतों के बोलों के डेटासेट पर टेक्स्ट माइनिंग और एक्सप्लोरटरी एनालिसिस सीखा। भाग टू में, आप NLP के साथ सेंटिमेंट एनालिसिस (टू-ए) और टॉपिक मॉडलिंग (टू-बी) पर ध्यान देंगे। भाग थ्री में मशीन लर्निंग तकनीकों के साथ अतिरिक्त प्रेडिक्टिव एनालिटिक्स पर निष्कर्ष निकाला जाएगा—जैसे क्या किसी गाने के बोलों के आधार पर यह तय किया जा सकता है कि वह किस दशक में रिलीज़ हुआ था, या क्या यह बिलबोर्ड चार्ट पर आएगा। इन ट्यूटोरियल्स में आप अलग-अलग मशीन लर्निंग एल्गोरिद्म्स का उपयोग करेंगे—जिन्हें नीचे दिए गए ग्राफिक में लाल रंग से दिखाया गया है।
हाँ, मैंने केवल तीन भागों का वादा किया था, पर मैंने भाग टू को टू-ए (सेंटिमेंट एनालिसिस) और टू-बी (टॉपिक मॉडलिंग - शीघ्र) में बाँट दिया, जिससे चार अलग-अलग ट्यूटोरियल बन गए। सेंटिमेंट एनालिसिस की प्रक्रिया पर कई बेहतरीन लेख और कोर्स उपलब्ध हैं, इसलिए भाग टू-ए का लक्ष्य सिर्फ कोड लिखने के बजाय विश्लेषण से इनसाइट निकालना है। आप Prince के बोलों का उदाहरण लेंगे, पर यही चरण आप अपने पसंदीदा कलाकार पर भी लागू कर सकते हैं। पूरी श्रृंखला के दौरान, आप NLP और मशीन लर्निंग तकनीकों से परिचित होते हुए लिरिकल एनालिसिस की संभावनाओं के प्रति जिज्ञासा भी विकसित करेंगे।
इस श्रृंखला के भाग टू-ए के लिए टाइडी डेटा की बुनियादी समझ आवश्यक है—खासतौर पर dplyr डेटा रूपांतरण के लिए, ggplot2 विज़ुअलाइज़ेशन के लिए, और %>% पाइप ऑपरेटर (मूल रूप से magrittr पैकेज से)। आप देखेंगे कि कई चरणों को %>% ऑपरेटर से जोड़कर कोड को कॉम्पैक्ट और पुन:उपयोग योग्य रखा गया है।
यह ट्यूटोरियल एक केस स्टडी भी है, इसलिए इसमें सामान्य ग्राफ़ और चार्ट्स से आगे बढ़कर कई विज़ुअलाइज़ेशन शामिल हैं। नतीजतन, एक और पूर्वापेक्षा यह है कि आप अपने वातावरण में नए पैकेज इंस्टॉल कर सकें। इनसाइट्स पर ध्यान केंद्रित रखने के लिए, मैंने ऐसा कोड शामिल किया है जिसे आप अपने डेटासेट पर पुन:उपयोग कर सकते हैं, पर विस्तृत व्याख्या के लिए आपको और खोज करनी होगी। हर पैकेज के लिए सहायक लिंक दिए जाएँगे। इससे आप नए टूल्स से रूबरू होंगे और उनके अनुप्रयोग पर फोकस करेंगे।
टिप: श्रृंखला की बुनियाद और Prince के बोलों की घनी और विविध शब्दावली को समझने के लिए पहले भाग वन पढ़ें।
विधियाँ: सेंटिमेंट एनालिसिस टेक्स्ट माइनिंग का एक प्रकार है जिसका उद्देश्य सामग्री की राय और व्यक्तिपरकता का निर्धारण करना है। जब इसे गीतों पर लागू किया जाता है, तो परिणाम न केवल कलाकार के रुख को दर्शा सकते हैं, बल्कि व्यापक सांस्कृतिक प्रभाव भी उजागर कर सकते हैं। सेंटिमेंट एनालिसिस के लिए अलग-अलग तरीके हैं, जिनमें ज्ञात डेटासेट को ट्रेन करना, नियम-आधारित अपने क्लासिफ़ायर्स बनाना, और पूर्वनिर्धारित शब्दकोश (लेक्सिकॉन) का उपयोग करना शामिल है। इस ट्यूटोरियल में, आप लेक्सिकॉन-आधारित विधि का उपयोग करेंगे, पर मैं आपको अन्य विधियाँ और उनके ट्रेड-ऑफ भी देखने के लिए प्रेरित करूँगा।
स्तर: जैसे सेंटिमेंट एनालिसिस के अलग-अलग तरीके होते हैं, वैसे ही टेक्स्ट के आधार पर एनालिसिस के अलग-अलग स्तर भी होते हैं—आम तौर पर डॉक्युमेंट, वाक्य, और शब्द। गीतों में, डॉक्युमेंट को दशक, वर्ष, चार्ट-स्तर, या गाने के आधार पर परिभाषित किया जा सकता है। वाक्य-स्तर आमतौर पर गीतों में संभव नहीं होता क्योंकि विरामचिन्ह तुक और पैटर्न पर असर डाल सकते हैं। शब्द-स्तर का विश्लेषण विस्तृत जानकारी उजागर करता है और टॉपिक मॉडलिंग जैसी उन्नत प्रथाओं के लिए आधार बन सकता है।
हर डेटा साइंस प्रोजेक्ट के लिए कुछ खोज-प्रश्न ज़रूरी होते हैं। इस ट्यूटोरियल के दौरान इन बातों पर विचार करें: क्या ऐसा प्रोग्राम लिखा जा सकता है जो बोलों में व्यक्त मूड का निर्धारण कर सके? क्या पूर्वनिर्धारित लेक्सिकॉन पर्याप्त हैं? कितनी डेटा तैयारी आवश्यक है? क्या आप अपने परिणामों को वास्तविक घटनाओं से जोड़ सकते हैं? क्या समय के साथ सेंटिमेंट बदलता है? क्या हिट गाने बिना चार्ट वाले गानों की तुलना में अधिक सकारात्मक या नकारात्मक होते हैं? 1998 में (जब Prince के बारे में कहा गया कि उन्होंने 9/11 की भविष्यवाणी की) बोलों में कौन से शब्द उभर कर आते हैं? क्या उन्होंने अपनी मौत की भविष्यवाणी की थी?
टिप: लिरिकल एनालिसिस भाषणों या किताबों से बहुत अलग और आमतौर पर अधिक जटिल होता है, जिससे इनसाइट्स पकड़ना कठिन हो सकता है। इसलिए हर अनुमान के प्रति सतर्क रहें! इस ट्यूटोरियल में मैं उत्तरों से अधिक प्रश्न रखूँगा, तो चौकोर समानांतर चतुर्भुज से बाहर सोचने के लिए तैयार रहें!
Prince के बोलों का विश्लेषण शुरू करने के लिए, नीचे दिए गए लाइब्रेरीज़ लोड करें। शुरू में ये अधिक लग सकती हैं, लेकिन ज़्यादातर ग्राफ़ और चार्ट के लिए हैं। विज़ुअल्स का बार-बार उपयोग देखते हुए, सुसंगतता के लिए एक मानक कलर स्कीम बेहतर रहती है। मैंने विशिष्ट ANSI कलर कोड्स की एक सूची बनाई है। ggplot2 का theme() फ़ंक्शन व्यक्तिगत ग्राफ़्स को कस्टमाइज़ करने देता है, तो आप अपना एक फ़ंक्शन theme_lyrics() भी बनाएँगे जो डिफ़ॉल्ट सेटिंग्स में बदलाव करेगा। knitr पैकेज R के साथ डायनेमिक रिपोर्ट जनरेशन का इंजन है। इसे kableExtra और formattable के साथ मिलाकर रंगों वाले आकर्षक टेक्स्ट टेबल बनाएँ। फिर my_kable_styling() नाम का अपना फ़ंक्शन बनाएँ ताकि इन लाइब्रेरीज़ के आउटपुट को मानकीकृत किया जा सके। अन्य पैकेज उनके उपयोग के साथ उल्लेखित होंगे।
library(dplyr) #Data manipulation (also included in the tidyverse package)
library(tidytext) #Text mining
library(tidyr) #Spread, separate, unite, text mining (also included in the tidyverse package)
library(widyr) #Use for pairwise correlation

#Visualizations!
library(ggplot2) #Visualizations (also included in the tidyverse package)
library(ggrepel) #`geom_label_repel`
library(gridExtra) #`grid.arrange()` for multi-graphs
library(knitr) #Create nicely formatted output tables
library(kableExtra) #Create nicely formatted output tables
library(formattable) #For the color_tile function
library(circlize) #Visualizations - chord diagram
library(memery) #Memes - images with plots
library(magick) #Memes - images with plots (image_read)
library(yarrr)  #Pirate plot
library(radarchart) #Visualizations
library(igraph) #ngram network diagrams
library(ggraph) #ngram network diagrams

#Define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#Customize ggplot2's default theme settings
#This tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #Center the title
        axis.ticks = aticks, #Set axis ticks to on or off
        panel.grid.minor = pgminor, #Turn the minor grid lines on or off
        legend.title = lt, #Turn the legend title on or off
        legend.position = lp) #Turn the legend on or off
}

#Customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}
हमेशा की तरह, आप कच्चे डेटा को एक डेटा फ़्रेम में पढ़ने से शुरुआत करेंगे। भाग वन में आपने मूल डेटासेट पर कुछ कंडीशनिंग की थी, जैसे कॉन्ट्रैक्शंस को विस्तार देना, एस्केप सीक्वेंसेज़ हटाना, और टेक्स्ट को लोअरकेस में बदलना। वह साफ़ डेटासेट आपने इस ट्यूटोरियल के लिए CSV में सेव किया था। read.csv() से prince_data बनाएँ और याद रखें कि बोलों को आप कैरेक्टर स्ट्रिंग के रूप में रखना चाहते हैं, इसलिए stringsAsFactors = FALSE सेट करें। चूँकि आपको पंक्तियों की नंबरिंग नहीं चाहिए, row.names = 1 सेट करें।
ध्यान दें कि आप इन पैरामीटर्स से बच सकते हैं यदि इसे tibble नामक आधुनिक डेटा फ़्रेम में read_csv() से पढ़ें, पर भाग वन के साथ सुसंगतता के लिए यहाँ read.csv() का उपयोग किया गया है।
prince_data <- read.csv('prince_new.csv', stringsAsFactors = FALSE, row.names = 1)
डेटा पर एक त्वरित नज़र डालें:
glimpse(prince_data) #Transposed version of `print()`## Observations: 824
## Variables: 10
## $ lyrics <chr> "all 7 and we will watch them fall they stand in t...
## $ song <chr> "7", "319", "1999", "2020", "3121", "7779311", "u"...
## $ year <int> 1992, NA, 1982, NA, 2006, NA, NA, NA, NA, NA, NA, ...
## $ album <chr> "Symbol", NA, "1999", "Other Songs", "3121", NA, N...
## $ peak <int> 3, NA, 2, NA, 1, NA, NA, NA, NA, NA, NA, NA, NA, N...
## $ us_pop <chr> "7", NA, "12", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ us_rnb <chr> "61", NA, "4", NA, "1", NA, NA, NA, NA, NA, NA, NA...
## $ decade <chr> "1990s", NA, "1980s", NA, "2000s", NA, NA, NA, NA,...
## $ chart_level <chr> "Top 10", "Uncharted", "Top 10", "Uncharted", "Top...
## $ charted <chr> "Charted", "Uncharted", "Charted", "Uncharted", "C...आप देख सकते हैं कि prince_data 824 गानों और 10 कॉलम्स का डेटा फ़्रेम है। यानी एक रिकॉर्ड एक गाना है—वास्तव में!
prince_tidyयहाँ कुछ शेष डेटा व्रैंगलिंग चरण दिए गए हैं:
कच्चे डेटा को टाइडी फ़ॉर्मेट में बदलने के लिए, tidytext के unnest_tokens() का उपयोग कर prince_tidy बनाएँ जो बोलों को अलग-अलग शब्दों में बाँट देता है—एक पंक्ति में एक शब्द। फिर शेष सफाई चरणों के लिए dplyr के anti_join() और filter() का प्रयोग करें। (विस्तार के लिए भाग वन देखें।)
#Created in the first tutorial
undesirable_words <- c("prince", "chorus", "repeat", "lyrics",
                       "theres", "bridge", "fe0f", "yeah", "baby",
                       "alright", "wanna", "gonna", "chorus", "verse",
                       "whoa", "gotta", "make", "miscellaneous", "2",
                       "4", "ooh", "uurh", "pheromone", "poompoom", "3121",
                       "matic", " ai ", " ca ", " la ", "hey", " na ",
                       " da ", " uh ", " tin ", "  ll", "transcription",
                       "repeats", "la", "da", "uh", "ah")

#Create tidy text format: Unnested, Unsummarized, -Undesirables, Stop and Short words
prince_tidy <- prince_data %>%
  unnest_tokens(word, lyrics) %>% #Break the lyrics into individual words
  filter(!word %in% undesirable_words) %>% #Remove undesirables
  filter(!nchar(word) < 3) %>% #Words like "ah" or "oo" used in music
  anti_join(stop_words) #Data provided by the tidytext package
glimpse(prince_tidy) #From `dplyr`, better than `str()`.
 ## Observations: 76,116
## Variables: 10
## $ song        <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ year        <int> 1992, 1992, 1992, 1992, 1992, 1992, 1992, 1992, 19...
## $ album       <chr> "Symbol", "Symbol", "Symbol", "Symbol", "Symbol", ...
## $ peak        <int> 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3, 3,...
## $ us_pop      <chr> "7", "7", "7", "7", "7", "7", "7", "7", "7", "7", ...
## $ us_rnb      <chr> "61", "61", "61", "61", "61", "61", "61", "61", "6...
## $ decade      <chr> "1990s", "1990s", "1990s", "1990s", "1990s", "1990...
## $ chart_level <chr> "Top 10", "Top 10", "Top 10", "Top 10", "Top 10", ...
## $ charted     <chr> "Charted", "Charted", "Charted", "Charted", "Chart...
## $ word        <chr> "watch", "fall", "stand", "love", "smoke", "intell...
आपका नया डेटासेट prince_tidy अब टोकनाइज़्ड फ़ॉर्मेट में है—हर पंक्ति में एक शब्द और उस गीत का संदर्भ जिससे वह आया है। अब आपके पास 76116 शब्दों और 10 कॉलम्स का डेटा फ़्रेम है।
यदि आपने भाग वन नहीं पढ़ा है, तो आपको पूर्ण डेटासेट के कुछ सार-संक्षेप ग्राफ़ पर एक त्वरित नज़र डालनी पड़ सकती है। आप यह ggplot2, circlize, और yarrr के रचनात्मक ग्राफ़्स से करेंगे।
जब सब कुछ व्यवस्थित, सलीकेदार और साफ़-सुथरा हो, तो एक पाइरेट shipshape कहेगा। तो यहाँ स्वच्छ और टाइडी डेटा का एक दिलचस्प नज़रिया है जो बोलों की शब्दावली या लेक्सिकल विविधता को समय के साथ दिखाता है। पाइरेट प्लॉट एक उन्नत तरीका है जिसमें किसी सतत आश्रित चर (जैसे शब्द-गणना) को एक श्रेणीबद्ध स्वतंत्र चर (जैसे दशक) के फ़ंक्शन के रूप में प्लॉट किया जाता है। यह कच्चे डेटा-पॉइंट्स, वर्णनात्मक और अनुमानात्मक आँकड़ों को एक प्रभावी प्लॉट में जोड़ता है। yarrr पैकेज के pirateplot() के बारे में अधिक जानने के लिए यह शानदार ब्लॉग देखें।
word_summary डेटा फ़्रेम बनाएँ जो प्रति गीत विशिष्ट शब्द-गणना निकालता है। जितनी अधिक विविधता, उतनी बड़ी शब्दावली। इस सोच से आप शब्द-स्तर विश्लेषण के लिए तैयार होते हैं। जिन गीतों की रिलीज़ तिथि नहीं है, उनके लिए दशक फ़ील्ड को "NONE" सेट करें और select() का उपयोग कर साफ़ लेबल दें।
word_summary <- prince_tidy %>%
  mutate(decade = ifelse(is.na(decade),"NONE", decade)) %>%
  group_by(decade, song) %>%
  mutate(word_count = n_distinct(word)) %>%
  select(song, Released = decade, Charted = charted, word_count) %>%
  distinct() %>% #To obtain one record per song
  ungroup()

pirateplot(formula =  word_count ~ Released + Charted, #Formula
   data = word_summary, #Data frame
   xlab = NULL, ylab = "Song Distinct Word Count", #Axis labels
   main = "Lexical Diversity Per Decade", #Plot title
   pal = "google", #Color scheme
   point.o = .2, #Points
   avg.line.o = 1, #Turn on the Average/Mean line
   theme = 0, #Theme
   point.pch = 16, #Point `pch` type
   point.cex = 1.5, #Point size
   jitter.val = .1, #Turn on jitter to see the songs better
   cex.lab = .9, cex.names = .7) #Axis label size
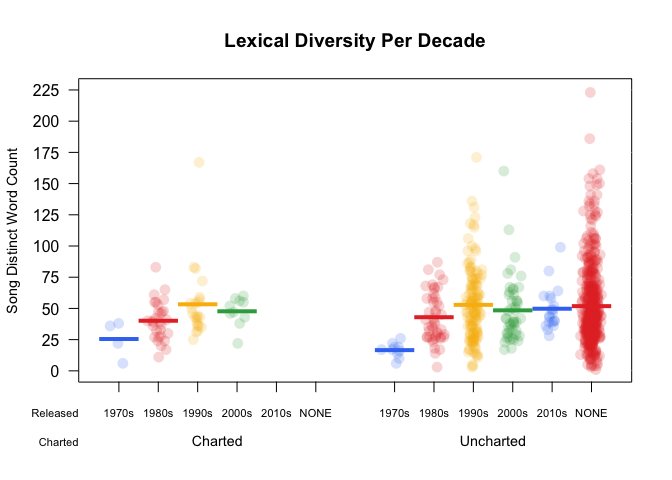
इस पाइरेट प्लॉट में हर रंगीन गोला एक गीत का प्रतिनिधित्व करता है। "NONE" मान के साथ घना लाल क्षेत्र दर्शाता है कि डेटासेट में बड़ी संख्या में गीत हैं जिनकी रिलीज़ तिथि नहीं है। शुरुआती दशकों में प्रति गीत विशिष्ट शब्दों की संख्या में हल्की ऊपर की ओर प्रवृत्ति है: ठोस क्षैतिज रेखा उस दशक के औसत शब्द-गणना को दिखाती है। समय के साथ सेंटिमेंट का विश्लेषण शुरू करते समय यह जानना महत्वपूर्ण है। Prince के करियर के दौरान शब्द और अधिक व्याख्यात्मक होते जाते हैं।
मैं आपको पाइरेट प्लॉट्स को और विस्तार में खोजने की चुनौती दूँगा—यह तो बस शुरुआत है!
वृत्ताकार ग्राफ़ कई श्रेणियों के बीच जटिल (या सरल!) संबंधों को दर्शाने का अनोखा तरीका हैं। (और हाँ, एल्बम भी तो गोल हुआ करते थे!). नीचे दिया ग्राफ़ ggplot2 के coord_polar() का उपयोग करके बना एक सर्कुलर बार चार्ट है जो प्रति वर्ष गीतों की सापेक्ष संख्या दिखाता है। इतने सरल ग्राफ़ के लिए कोड काफ़ी है, पर यह वाकई क़ीमत रखता है। एक समान उदाहरण R Graph Gallery में विस्तार से यहाँ देखें। पाइरेट प्लॉट्स की तरह, यह भी वृत्ताकार प्लॉट्स की संभावनाओं का परिचय भर है।
songs_year <- prince_data %>%
  select(song, year) %>%
  group_by(year) %>%
  summarise(song_count = n())

id <- seq_len(nrow(songs_year))
songs_year <- cbind(songs_year, id)
label_data = songs_year
number_of_bar = nrow(label_data) #Calculate the ANGLE of the labels
angle = 90 - 360 * (label_data$id - 0.5) / number_of_bar #Center things
label_data$hjust <- ifelse(angle < -90, 1, 0) #Align label
label_data$angle <- ifelse(angle < -90, angle + 180, angle) #Flip angle
ggplot(songs_year, aes(x = as.factor(id), y = song_count)) +
  geom_bar(stat = "identity", fill = alpha("purple", 0.7)) +
  geom_text(data = label_data, aes(x = id, y = song_count + 10, label = year, hjust = hjust), color = "black", alpha = 0.6, size = 3, angle =  label_data$angle, inherit.aes = FALSE ) +
  coord_polar(start = 0) +
  ylim(-20, 150) + #Size of the circle
  theme_minimal() +
  theme(axis.text = element_blank(),
        axis.title = element_blank(),
        panel.grid = element_blank(),
        plot.margin = unit(rep(-4,4), "in"),
        plot.title = element_text(margin = margin(t = 10, b = -10)))
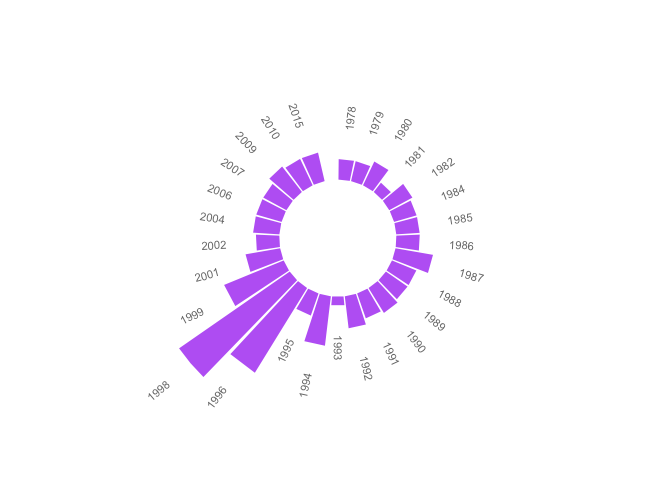
सबसे ऊपर का गैप देख रहे हैं? यह उन सैकड़ों गीतों का संकेतक है जिनकी रिलीज़ तिथियाँ नहीं हैं—जिन्हें आपने पाइरेट प्लॉट में पहचाना था। इतने अधिक बिना-तारीख़ गीतों के साथ, यदि उन्हें शामिल किया जाता तो चार्ट उपयोगी नहीं रहता। गायब वर्ष दर्शाते हैं कि उन वर्षों में कोई गीत रिलीज़ नहीं हुआ। सबसे अधिक उत्पादक वर्ष 1996 और 1998 थे।
जानना चाहते हैं क्यों? पढ़ते रहिए!
निम्न ग्राफ़ दिखाता है कि किसी गीत का रिलीज़ दशक और उसका बिलबोर्ड चार्ट पर आना-न-आना, एक-दूसरे से कैसे संबंधित हैं। chordDiagram() का संगीत विश्लेषण में उपयोग करना बिल्कुल उपयुक्त लगा! यह सुंदर टूल Zuguang Gu के circlize पैकेज से है। ग्राफ़ दो श्रेणियों में बँटा है: चार्टेड (ऊपर) और दशक (नीचे)। दो श्रेणियों को चौड़े गैप्स से, और उनके अंदर के मानों को छोटे गैप्स से अलग किया गया है। नीचे दिए कोड की हाई-लेवल टिप्पणियों को यहाँ और विस्तार दिया गया है।
decade_chart <-  prince_data %>%
  filter(decade != "NA") %>% #Remove songs without release dates
  count(decade, charted)  #Get SONG count per chart level per decade. Order determines top or bottom.

circos.clear() #Very important - Reset the circular layout parameters!
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "Charted" = "grey", "Uncharted" = "grey") #assign chord colors
# Set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_chart[[1]])) - 1), 15,
                         rep(5, length(unique(decade_chart[[2]])) - 1), 15))

chordDiagram(decade_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Chart and Decade")
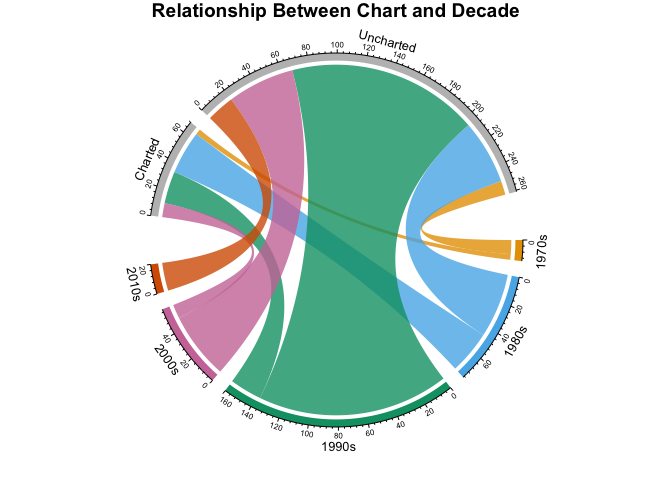
ऊपर दिया वृत्ताकार ग्राफ़ पहली नज़र में जटिल लगे, लेकिन यह दशक और चार्ट-स्तर के अनुसार गीतों की गणना को सुंदर ढंग से दर्शाता है। आप देख सकते हैं कि Prince ने 1970 के दशक में अपने करियर की शुरुआत कुछ ही रिलीज़ के साथ की, जिनमें से कुछ चार्ट पर आए। 1980 के दशक की तुलना में 1990 के दशक में अधिक गीत रिलीज़ हुए, लेकिन 1980 के दशक में अधिक गीत चार्टेड थे। 2000 के दशक में व्यावसायिक रूप से सफल गीत कम थे और 2010 के दशक में कोई हिट गीत नहीं था।
इस सेक्शन में आप:
tidytext पैकेज में sentiments नाम का डेटासेट शामिल है जिसमें कई विशिष्ट लेक्सिकॉन उपलब्ध हैं। ये लेक्सिकॉन ऐसे शब्दकोश हैं जिनमें शब्दों को कोई सेंटिमेंट श्रेणी या मान सौंपा गया है। tidytext तीन जनरल-पर्पज़ लेक्सिकॉन उपलब्ध कराता है:
लेक्सिकॉन की जाँच करने के लिए new_sentiments नाम का डेटा फ़्रेम बनाएँ। फ़ाइनैंशियल लेक्सिकॉन को फ़िल्टर करें, AFINN के लिए न्यूमेरिक स्कोर को positive या negative में बदलकर एक बाइनरी (polar) सेंटिमेंट फ़ील्ड बनाएं, और हर लेक्सिकॉन के विशिष्ट शब्दों की संख्या रखने वाला एक फ़ील्ड जोड़ें।
new_sentiments में अलग-अलग सेंटिमेंट श्रेणियाँ एक ही कॉलम में हैं, इसलिए लेक्सिकॉन-वार, श्रेणी-वार शब्द-गणना को बेहतर देखने के लिए tidyr के spread() से श्रेणियों को अलग फ़ील्ड्स में पिवट करें। पहले बनाए my_kable_styling() फ़ंक्शन में knitr और kableExtra का लाभ लें। formattable की color_tile() और color_bar() से चार्ट में रंग जोड़ें और एक आकर्षक फ़ॉर्मैटेड टेबल बनाएँ। अपनी टेबल प्रिंट करें और हर लेक्सिकॉन के बीच अंतर देखें।
new_sentiments <- sentiments %>% #From the tidytext package
  filter(lexicon != "loughran") %>% #Remove the finance lexicon
  mutate( sentiment = ifelse(lexicon == "AFINN" & score >= 0, "positive",
                              ifelse(lexicon == "AFINN" & score < 0,
                                     "negative", sentiment))) %>%
  group_by(lexicon) %>%
  mutate(words_in_lexicon = n_distinct(word)) %>%
  ungroup()

new_sentiments %>%
  group_by(lexicon, sentiment, words_in_lexicon) %>%
  summarise(distinct_words = n_distinct(word)) %>%
  ungroup() %>%
  spread(sentiment, distinct_words) %>%
  mutate(lexicon = color_tile("lightblue", "lightblue")(lexicon),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon)) %>%
  my_kable_styling(caption = "Word Counts Per Lexicon")
| lexicon | words_in_lexicon | anger | anticipation | disgust | fear | joy | negative | positive | sadness | surprise | trust |
|---|---|---|---|---|---|---|---|---|---|---|---|
| AFINN | 2476 | NA | NA | NA | NA | NA | 1597 | 879 | NA | NA | NA |
| bing | 6785 | NA | NA | NA | NA | NA | 4782 | 2006 | NA | NA | NA |
| nrc | 6468 | 1247 | 839 | 1058 | 1476 | 689 | 3324 | 2312 | 1191 | 534 | 1231 |
ऊपर दी तालिका हर लेक्सिकॉन के आकार और संरचना का अंदाज़ा देती है।
यह जानने के लिए कि कौन सा लेक्सिकॉन बोलों के लिए अधिक उपयुक्त है, आप यह देखना चाहेंगे कि लेक्सिकॉन और बोल—दोनों में सामान्य शब्दों का मैच अनुपात क्या है। याद रहे, prince_tidy में कुल 76116 शब्द और 7851 विशिष्ट शब्द हैं।
तो इनमें से कितने शब्द वास्तव में लेक्सिकॉन में हैं?
prince_tidy और new_sentiments के बीच inner_join() करें और फिर लेक्सिकॉन के आधार पर समूहित करें। NRC में 10 श्रेणियाँ हैं और एक शब्द एक से अधिक श्रेणियों में आ सकता है—जैसे कोई शब्द नकारात्मक और उदास दोनों हो सकता है। इसलिए, प्रति लेक्सिकॉन विशिष्ट शब्द-गणना पाने के लिए summarise() में n_distinct() का प्रयोग करें।
prince_tidy %>%
  mutate(words_in_lyrics = n_distinct(word)) %>%
  inner_join(new_sentiments) %>%
  group_by(lexicon, words_in_lyrics, words_in_lexicon) %>%
  summarise(lex_match_words = n_distinct(word)) %>%
  ungroup() %>%
  mutate(total_match_words = sum(lex_match_words), #Not used but good to have
         match_ratio = lex_match_words / words_in_lyrics) %>%
  select(lexicon, lex_match_words,  words_in_lyrics, match_ratio) %>%
  mutate(lex_match_words = color_bar("lightpink")(lex_match_words),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Lyrics Found In Lexicons")
| lexicon | lex_match_words | words_in_lyrics | match_ratio |
|---|---|---|---|
| AFINN | 770 | 7851 | 0.0980767 |
| bing | 1185 | 7851 | 0.1509362 |
| nrc | 1678 | 7851 | 0.2137307 |
NRC लेक्सिकॉन में Prince के बोलों के अधिक विशिष्ट शब्द मिलते हैं—AFINN या Bing की तुलना में। ध्यान दें कि मैच रेशियो का योग कम है। कोई भी लेक्सिकॉन सभी शब्दों को कवर नहीं कर सकता, न ही करना चाहिए। कई शब्द न्यूट्रल होते हैं और उनके साथ कोई सेंटिमेंट नहीं जुड़ा होता। उदाहरण के लिए, 2000 सामान्यतः न्यूट्रल शब्द है, इसलिए लेक्सिकॉन में नहीं होगा। पर याद कीजिए, उस वर्ष लोगों को डर था कि विमान आसमान से गिर जाएँगे और कंप्यूटर काम करना बंद कर देंगे। यानी गीत में एक भय मौजूद है जो सामान्य लेक्सिकॉन-आधारित सेंटिमेंट एनालिसिस से नहीं पकड़ा जाता।
कुछ कारण जिनसे कोई शब्द लेक्सिकॉन में न हो:
Prince के बोलों के कुछ ऐसे शब्द देखें जो सेंटिमेंट पर प्रभाव डालते प्रतीत होते हैं। क्या ये सभी लेक्सिकॉन में हैं?
new_sentiments %>%
  filter(word %in% c("dark", "controversy", "gangster",
                     "discouraged", "race")) %>%
  arrange(word) %>% #sort
  select(-score) %>% #remove this field
  mutate(word = color_tile("lightblue", "lightblue")(word),
         words_in_lexicon = color_bar("lightpink")(words_in_lexicon),
         lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  my_kable_styling(caption = "Specific Words")
| word | sentiment | lexicon | words_in_lexicon |
|---|---|---|---|
| controversy | negative | nrc | 6468 |
| controversy | negative | bing | 6785 |
| dark | sadness | nrc | 6468 |
| dark | negative | bing | 6785 |
| discouraged | negative | AFINN | 2476 |
| gangster | negative | bing | 6785 |
Controversy और dark NRC और Bing दोनों में मिलते हैं, पर gangster केवल Bing में है। Race बिलकुल नहीं मिलता—जबकि Prince के बोलों में यह महत्वपूर्ण विषय है। पर क्या इसे आसानी से किसी सेंटिमेंट से जोड़ा जा सकता है? ध्यान दें कि AFINN कहीं छोटा है और इन में से केवल एक शब्द रखता है।
अब एक और जटिल उदाहरण देखें। Prince के संगीत में सेक्सुएलिटी एक सामान्य थीम है। जब किसी शब्द के अलग-अलग रूप हों, तो पूर्वनिर्धारित लेक्सिकॉन पर आधारित सेंटिमेंट एनालिसिस पर क्या प्रभाव होगा? उदाहरण के लिए, बोलों में sex मूल वाले सभी संदर्भ देखें। इन्हें Bing और NRC से मिलाकर देखें कि कहाँ मैच हैं।
my_word_list <- prince_data %>%
  unnest_tokens(word, lyrics) %>%
  filter(grepl("sex", word)) %>% #Use `grepl()` to find the substring `"sex"`
  count(word) %>%
  select(myword = word, n) %>% #Rename word
  arrange(desc(n))

new_sentiments %>%
  #Right join gets all words in `my_word_list` to show nulls
  right_join(my_word_list, by = c("word" = "myword")) %>%
  filter(word %in% my_word_list$myword) %>%
  mutate(word = color_tile("lightblue", "lightblue")(word),
          instances = color_tile("lightpink", "lightpink")(n),
          lexicon = color_tile("lightgreen", "lightgreen")(lexicon)) %>%
  select(-score, -n) %>% #Remove these fields
  my_kable_styling(caption = "Dependency on Word Form")
| word | sentiment | lexicon | words_in_lexicon | instances |
|---|---|---|---|---|
| sexy | positive | bing | 6785 | 220 |
| sexy | positive | AFINN | 2476 | 220 |
| sex | anticipation | nrc | 6468 | 185 |
| sex | joy | nrc | 6468 | 185 |
| sex | positive | nrc | 6468 | 185 |
| sex | trust | nrc | 6468 | 185 |
| superfunkycalifragisexy | NA | NA | NA | 19 |
| lovesexy | NA | NA | NA | 16 |
| sexual | NA | NA | NA | 11 |
| sexuality | NA | NA | NA | 11 |
| sexiness | NA | NA | NA | 2 |
| sexually | NA | NA | NA | 2 |
| sexe | NA | NA | NA | 1 |
| sexed | NA | NA | NA | 1 |
| sexier | NA | NA | NA | 1 |
| superfunkycalifraagisexy | NA | NA | NA | 1 |
| superfunkycalifragisexi | NA | NA | NA | 1 |
ध्यान दें कि Prince sexy का खूब उपयोग करते हैं, पर NRC में यह इस रूप में मौजूद नहीं है। sex NRC में मिलता है पर Bing में नहीं। यदि आप शब्दों के स्टेम या रूट देखें, तो क्या मदद मिलेगी? यह एक दुविधा है! आपके टेक्स्ट में रूट शब्द का भूतकाल, बहुवचन, या क्रिया-विशेषण हो सकता है, पर वह किसी लेक्सिकॉन में न हो। इसे कैसे संभालें?
संभव है कि आपको कुछ और डेटा तैयारी करनी पड़े। सेंटिमेंट एनालिसिस से पहले विचार करने योग्य तीन तकनीकें:
सेंटिमेंट एनालिसिस में एक उन्नत अवधारणा पर्यायवाची (अर्थ-समरूप साथी) और हाइपरनिम (सामान्य अभिभावक) प्रतिस्थापन की है। ये ऐसे शब्द होते हैं जो लिरिक में प्रयुक्त संबंधित शब्द से अधिक प्रचलित होते हैं और वास्तव में किसी लेक्सिकॉन में मिलते भी हैं, जिससे मैच प्रतिशत बढ़ता है। इस ट्यूटोरियल में अतिरिक्त डेटा तैयारी पर चर्चा के लिए जगह नहीं है, पर इस पर ज़रूर विचार करें!
चुनौती: लेक्सिकॉन और उनके निर्माण पर थोड़ा रिसर्च करें। क्या कोई ऐसा लेक्सिकॉन पहले से मौजूद है जो संगीत के बोलों के लिए अधिक उपयुक्त हो? यदि आप वाकई रुचि रखते हैं, तो सोचें कि अपना लेक्सिकॉन बनाने में क्या लगेगा। क्लासिफ़ायर-आधारित सेंटिमेंट एनालिसिस और लेक्सिकॉन-आधारित सेंटिमेंट एनालिसिस में क्या अंतर है?
अब जब आपके पास डेटासेट और लेक्सिकॉन का बुनियादी समझ है, तो उन्हें जोड़कर विश्लेषण करें। उच्च-स्तरीय चरण इस प्रकार हैं:
get_sentiments() पर inner_join() करके हर लेक्सिकॉन के लिए Prince के सेंटिमेंट डेटासेट बनाएँ। हर कॉल में लेक्सिकॉन का नाम पास करें। इस अभ्यास में बाइनरी सेंटिमेंट के लिए Bing और श्रेणीबद्ध सेंटिमेंट के लिए NRC लें। क्योंकि NRC में शब्द कई श्रेणियों (जैसे Negative/Fear या Positive/Joy) में आ सकते हैं, तो आगे उपयोग के लिए positive और negative के बिना एक सबसेट भी बनाएं।
prince_bing <- prince_tidy %>%
  inner_join(get_sentiments("bing"))
prince_nrc <- prince_tidy %>%
  inner_join(get_sentiments("nrc"))
prince_nrc_sub <- prince_tidy %>%
  inner_join(get_sentiments("nrc")) %>%
  filter(!sentiment %in% c("positive", "negative"))
बोलों के विस्तृत विश्लेषण में, आप टेक्स्ट के अलग-अलग स्तरों—जैसे सभी गीत, चार्ट-स्तर, दशक-स्तर और शब्द-स्तर—को देखना चाहेंगे। सबसे पहले पूरे डेटासेट के NRC सेंटिमेंट का ग्राफ़ बनाएँ।
(बस मज़े के लिए, मैंने ग्राफ़्स में इमेजेज़ (मीम्स) जोड़ने के लिए memery और magick पैकेज का उपयोग किया।)
nrc_plot <- prince_nrc %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  #Use `fill = -word_count` to make the larger bars darker
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) + #Turn off the legend
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 15000)) + #Hard code the axis limit
  ggtitle("Prince NRC Sentiment") +
  coord_flip()

img <- "prince_background2.jpg" #Load the background image
lab <- ""  #Turn off the label
#Overlay the plot on the image and create the meme file
meme(img, lab, "meme_nrc.jpg", inset = nrc_plot)
#Read the file back in and display it!
nrc_meme <- image_read("meme_nrc.jpg")
plot(nrc_meme)
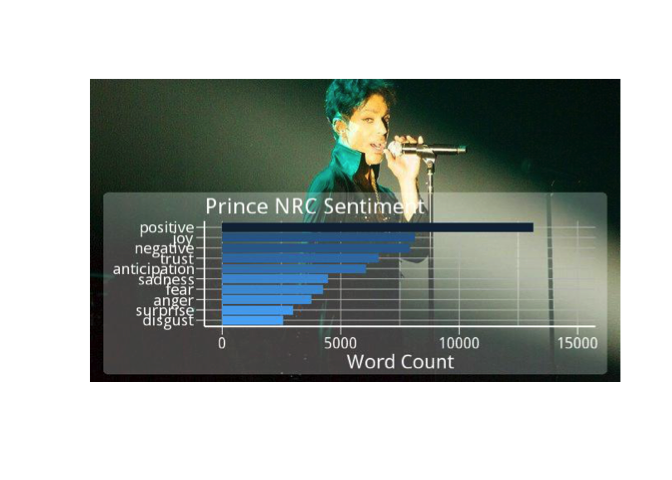
ऐसा प्रतीत होता है कि Prince के बोलों के लिए NRC positive को अधिक तरजीह देता है। पर क्या disgust या anger वाले सभी शब्द negative श्रेणी में भी आते हैं? इसे जाँचना उचित होगा।
अब Bing का समग्र सेंटिमेंट देखें। Prince के बोलों से Bing लेक्सिकॉन में आने वाले 1185 विशिष्ट शब्दों में से कितने positive और कितने negative हैं?
bing_plot <- prince_bing %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = sentiment)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  scale_y_continuous(limits = c(0, 8000)) +
  ggtitle("Prince Bing Sentiment") +
  coord_flip()

img1 <- "prince_background1.jpg"
lab1 <- ""
meme(img1, lab1, "meme_bing.jpg", inset = bing_plot)
x <- image_read("meme_bing.jpg")
plot(x)
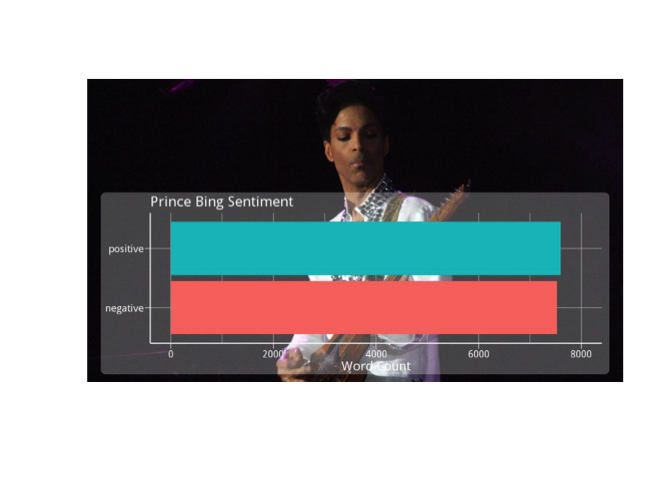
क्या ऐसा हो सकता है कि Bing के लिए Prince के संगीत में positive और negative लगभग बराबर दिख रहे हों? क्या बहुत बड़े डेटासेट को देखने पर समग्र सेंटिमेंट आपस में कट जाता है? कहना कठिन है—इसे छोटे हिस्सों में देख कर देखें।
ध्वनिविज्ञान में फेज़ कैंसलेशन नामक चीज़ है जिसमें एक ही वेव की दो आवृत्तियाँ बिल्कुल उलट-फेज़ में होकर एक-दूसरे को रद्द कर देती हैं—जैसे जब आप ड्रम को दो माइक्स से रिकॉर्ड करें और आवाज़ एक माइक तक दूसरे से देर से पहुँचे। उस आवृत्ति पर नतीजा—पूर्ण सन्नाटा! बड़े डेटासेट के सेंटिमेंट एनालिसिस पर इसका क्या असर हो सकता है? सोचिए।
भाषाविज्ञान के प्रोफेसर: "अंग्रेज़ी में, डबल निगेटिव पॉज़िटिव बनता है। रूसी में, डबल निगेटिव अभी भी निगेटिव रहता है। लेकिन कोई ऐसी भाषा नहीं है जिसमें डबल पॉज़िटिव निगेटिव बना दे।" असहमत छात्र: "Yeah, right."
Bing लेक्सिकॉन का उपयोग करते हुए विश्लेषण को चार्ट-स्तर तक ब्रेकडाउन करें। प्रति चार्ट-स्तर पोलर सेंटिमेंट का ग्राफ़ बनाएँ। spread() से सेंटिमेंट्स को कॉलम्स में बाँटें और mutate() से polarity (positive - negative) फ़ील्ड और percent_positive फ़ील्ड ($positive / total sentiment * 100$) बनाएँ, एक अलग परिप्रेक्ष्य के लिए। पोलैरिटी ग्राफ़ में geom_hline() से yintercept जोड़ें। grid.arrange() से दोनों ग्राफ़ साथ रखें।
prince_polarity_chart <- prince_bing %>%
  count(sentiment, chart_level) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

#Polarity by chart
plot1 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, polarity, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = my_colors[3:5]) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity By Chart Level")

#Percent positive by chart
plot2 <- prince_polarity_chart %>%
  ggplot( aes(chart_level, percent_positive, fill = chart_level)) +
  geom_col() +
  scale_fill_manual(values = c(my_colors[3:5])) +
  geom_hline(yintercept = 0, color = "red") +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive By Chart Level")

grid.arrange(plot1, plot2, ncol = 2)
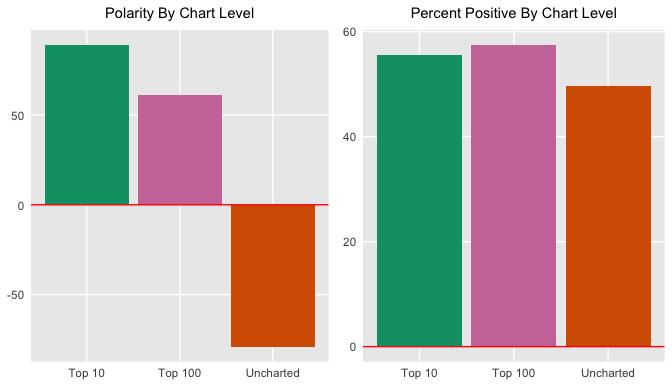
क्या इसका मतलब है कि चार्टेड गाने आमतौर पर नकारात्मक से अधिक सकारात्मक होते हैं? यदि हाँ, तो यह समाज की पसंद के बारे में क्या बताता है? क्या आप ऐसे अनुमान लगा सकते हैं? कुल सेंटिमेंट की तुलना में सकारात्मक सेंटिमेंट को देखते हुए लगता है कि चार्टेड गाने मामूली रूप से अधिक सकारात्मक हैं। यह दिलचस्प है, जबकि Bing लेक्सिकॉन में स्वयं नेगेटिव शब्द पॉज़िटिव से अधिक हैं।
जब आप पोलर परिप्रेक्ष्य से सेंटिमेंट देख रहे हैं, तो यह देखना चाहेंगे कि समय के साथ यह बदलता है या नहीं (गीक ह्यूमर)। इस बार स्मूद कर्व के लिए loess विधि के साथ geom_smooth() और लाइनियर स्मूथ के लिए method = lm के साथ एक और geom_smooth() उपयोग करें।
prince_polarity_year <- prince_bing %>%
  count(sentiment, year) %>%
  spread(sentiment, n, fill = 0) %>%
  mutate(polarity = positive - negative,
    percent_positive = positive / (positive + negative) * 100)

polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, polarity, color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Polarity Over Time")

relative_polarity_over_time <- prince_polarity_year %>%
  ggplot(aes(year, percent_positive , color = ifelse(polarity >= 0,my_colors[5],my_colors[4]))) +
  geom_col() +
  geom_smooth(method = "loess", se = FALSE) +
  geom_smooth(method = "lm", se = FALSE, aes(color = my_colors[1])) +
  theme_lyrics() + theme(plot.title = element_text(size = 11)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Percent Positive Over Time")

grid.arrange(polarity_over_time, relative_polarity_over_time, ncol = 2)
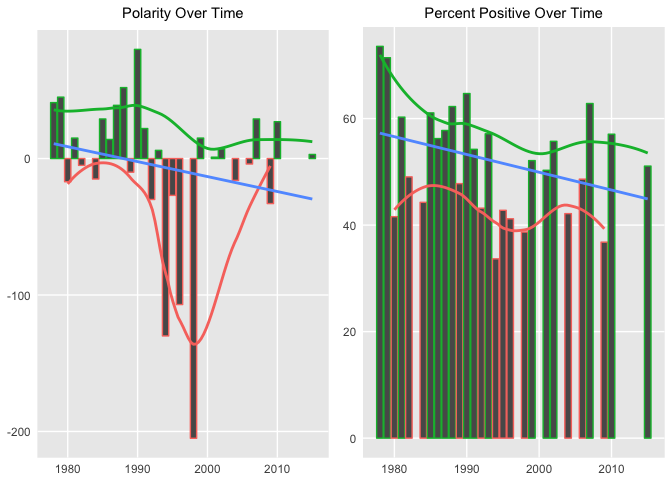
ऊपर दूसरे ग्राफ़ में कुछ चरम मान समायोजित किए गए हैं, लेकिन दोनों ही मामलों में समय के साथ समग्र पोलैरिटी ट्रेंड नकारात्मक दिखता है।
आप फिर से chordDiagram() की ताक़त से NRC सेंटिमेंट्स और दशकों के बीच संबंधों की जाँच करेंगे। ध्यान दें कि सेंटिमेंट श्रेणियाँ रिंग के ऊपरी हिस्से में और दशक निचले हिस्से में दिखते हैं।
grid.col = c("1970s" = my_colors[1], "1980s" = my_colors[2], "1990s" = my_colors[3], "2000s" = my_colors[4], "2010s" = my_colors[5], "anger" = "grey", "anticipation" = "grey", "disgust" = "grey", "fear" = "grey", "joy" = "grey", "sadness" = "grey", "surprise" = "grey", "trust" = "grey")

decade_mood <-  prince_nrc %>%
  filter(decade != "NA" & !sentiment %in% c("positive", "negative")) %>%
  count(sentiment, decade) %>%
  group_by(decade, sentiment) %>%
  summarise(sentiment_sum = sum(n)) %>%
  ungroup()

circos.clear()
#Set the gap size
circos.par(gap.after = c(rep(5, length(unique(decade_mood[[1]])) - 1), 15,
                         rep(5, length(unique(decade_mood[[2]])) - 1), 15))
chordDiagram(decade_mood, grid.col = grid.col, transparency = .2)
title("Relationship Between Mood and Decade")
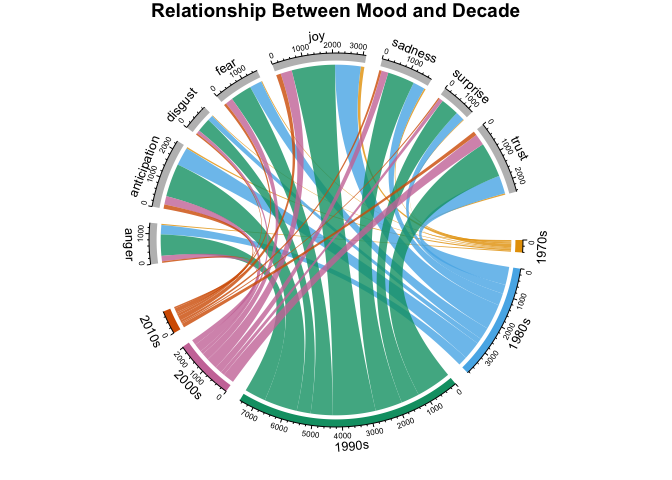
यह ग्राफ़ प्रति दशक प्रति NRC श्रेणी के शब्दों की गणना दिखाता है। छोटे आकार में यह बहुत कुछ एक साथ दिखाता है, पर श्रेणियों और समय के बीच संबंधों पर बहुत जानकारी देता है। ऐसे डायग्राम अत्यधिक अनुकूलन योग्य हैं—आप इन्हें सरल भी रख सकते हैं या सूचनात्मक भी।
DataCamp के इतने उत्कृष्ट कोर्स करने के बाद, आप शायद अपने कौशल को वास्तविक दुनिया में आज़माने के लिए उत्सुक होंगे। तो अब Prince के बोलों के विश्लेषण का वास्तविक और समय आधारित संदर्भ में मानचित्र बनाइए। हालाँकि, इतने जटिल विषय पर सरलीकृत विश्लेषण करते समय संदेहशील और सतर्क रहें।
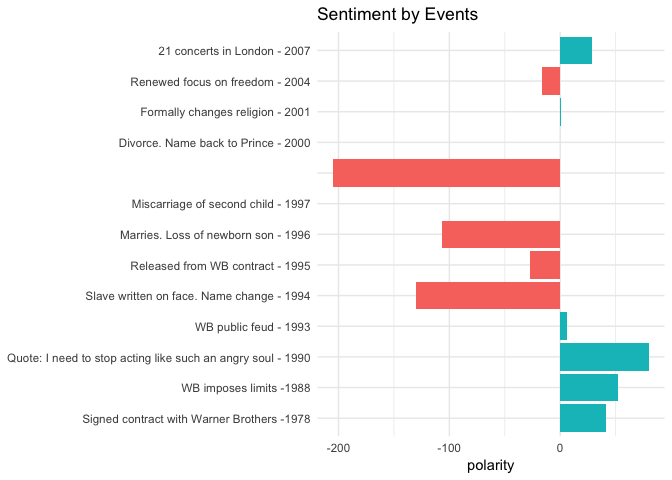
मैंने Prince के जीवन की घटनाओं की सूची बनाई है, जो Rolling Stone Magazine, Biography.com आदि जैसे लोकप्रिय स्रोतों से ली गई हैं। मैंने हमारे डेटासेट में रिलीज़-तिथि वाले गीतों से मेल खाते, अत्यधिक सार्वजनिक वर्षों को चुना। अभी princeEvents.csv से वे घटनाएँ पढ़ें। फिर prince_bing और spread() से प्रति वर्ष पोलैरिटी स्कोर बनाएँ। events डेटा फ़्रेम पर जॉइन करें और एक सेंटिमेंट फ़ील्ड बनाएँ ताकि बार चार्ट में रंग भर सकें। बड़े टेक्स्ट लेबल दिखाते समय हमेशा की तरह coord_flip() का उपयोग करें।
events <- read.csv('princeEvents.csv', stringsAsFactors = FALSE)

year_polarity_bing <- prince_bing %>%
  group_by(year, sentiment) %>%
  count(year, sentiment) %>%
  spread(sentiment, n) %>%
  mutate(polarity = positive - negative,
         ratio = polarity / (positive + negative)) #use polarity ratio in next graph

 events %>%
   #Left join gets event years with no releases
   left_join(year_polarity_bing) %>%
   filter(event != " ") %>% #Account for bad data
   mutate(event = reorder(event, year), #Sort chart by desc year
           sentiment = ifelse(positive > negative,
                              "positive", "negative")) %>%
   ggplot(aes(event, polarity, fill = sentiment)) +
   geom_bar(stat = "identity") +
   theme_minimal() + theme(legend.position = "none") +
   xlab(NULL) +
   ggtitle("Sentiment by Events") +
   coord_flip()
टिप: आप princeEvents.csv यहाँ पा सकते हैं।
घटनाओं के साथ सेंटिमेंट की तुलना करना मुझे बहुत रोचक लगा। यद्यपि यह व्यक्तिनिष्ठ है, मुझे ये काफ़ी सहसंबद्ध लगे। मान लिया जाए, इवेंट डेटासेट मैंने स्वयं तैयार किया। मैं इसे बोलों से मेल खाने के लिए आसानी से पक्षपाती बना सकता था। फिर भी, मैंने हर वर्ष के लिए कई स्रोतों का उपयोग कर सबसे सामान्य तथ्य चुने। ये परिणाम आपको शब्द-स्तर के विश्लेषण में और गहराई से जाने को प्रेरित करने चाहिए—देखने के लिए कि Prince वास्तव में किस बारे में गा रहे थे।
1994 में, Prince ने अपनी अफ्रीकी-अमेरिकी ऑडियंस को फिर से जोड़ने के प्रयास के रूप में The Black Album रिलीज़ किया। चूँकि 1994 और उसके बाद के दो वर्ष विश्लेषण में उभरते हैं, आप इस अवधि के लिए NRC लेक्सिकॉन से मेल खाते शीर्ष शब्दों को ggrepel के geom_label_repel() और geom_point() के साथ देख सकते हैं। यह एक पेचीदा ग्राफ़ है, इसलिए नीचे दिए कोड के साथ खेलें।
plot_words_94_96 <- prince_nrc %>%
  filter(year %in% c("1994", "1995", "1996")) %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(8)) %>% #consider top_n() from dplyr also
  ungroup()

plot_words_94_96 %>%
  #Set `y = 1` to just plot one variable and use word as the label
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  #You want the words, not the points
  geom_point(color = "transparent") +
  #Make sure the labels don't overlap
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.04,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1994 - 1996 NRC Sentiment") +
  coord_flip()
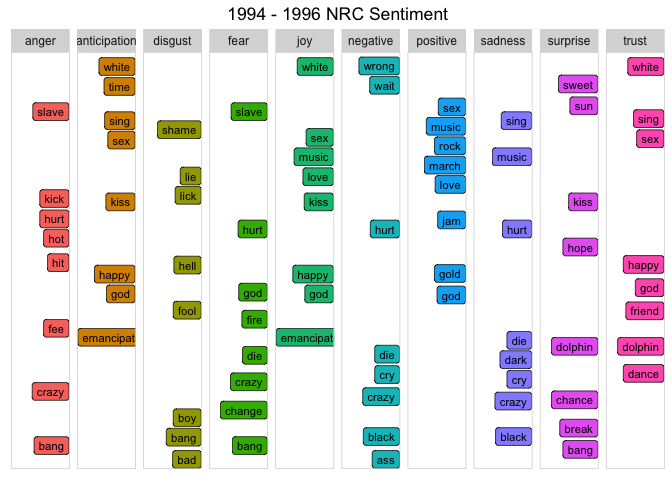
1994 में, Prince ने Rolling Stone मैगज़ीन से कहा,
"When you stop a man from dreaming, he becomes a slave. That's where I was."
तो वे पब्लिक में अपने चेहरे पर "slave" शब्द स्पष्ट रूप से लिखकर दिखाई दिए—अपने वर्तमान म्यूज़िक लेबल के खिलाफ़ एंटी-कॉरपोरेट भावनाएँ खुलकर जताते हुए। उन्होंने अपना नाम भी एक सिंबल में बदल लिया। ऊपर दिए शब्द इन घटनाओं से कितने मेल खाते हैं? ग्राफ़ में "slave", "emancipation", "black" और "change" पर ध्यान दें।
(याद रखें, यह सिर्फ़ Prince के बारे में नहीं है। आप इसे किसी भी टेक्स्ट पर लागू कर सकते हैं! उदाहरण के लिए, अपने कार्यकाल के पहले वर्ष में राष्ट्रपति ट्रंप द्वारा बोले गए सबसे अधिक trust सेंटिमेंट वाले शब्द कौन से थे?)
ऊपर दिए Sentiment By Events चार्ट ने दिखाया कि 1996 से 1998 के बीच Prince ने शादी की, दो बच्चों को खोया, और कहा जाता है कि उन्होंने स्टेज पर 9/11 की भविष्यवाणी की। (नीदरलैंड्स में 1998 के उनके कॉन्सर्ट को YouTube पर खोजें और खुद सुनें!) पिछले ग्राफ़ जैसे ही चरणों का उपयोग करते हुए, 1998 में हर NRC श्रेणी के शीर्ष 10 शब्द देखें।
plot_words_1998 <- prince_nrc %>%
  filter(year == "1998") %>%
  group_by(sentiment) %>%
  count(word, sort = TRUE) %>%
  arrange(desc(n)) %>%
  slice(seq_len(10)) %>%
  ungroup()

#Same comments as previous graph
plot_words_1998 %>%
  ggplot(aes(word, 1, label = word, fill = sentiment )) +
  geom_point(color = "transparent") +
  geom_label_repel(force = 1,nudge_y = .5,
                   direction = "y",
                   box.padding = 0.05,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~sentiment) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.x = element_text(size = 6),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("1998 NRC Sentiment") +
  coord_flip()
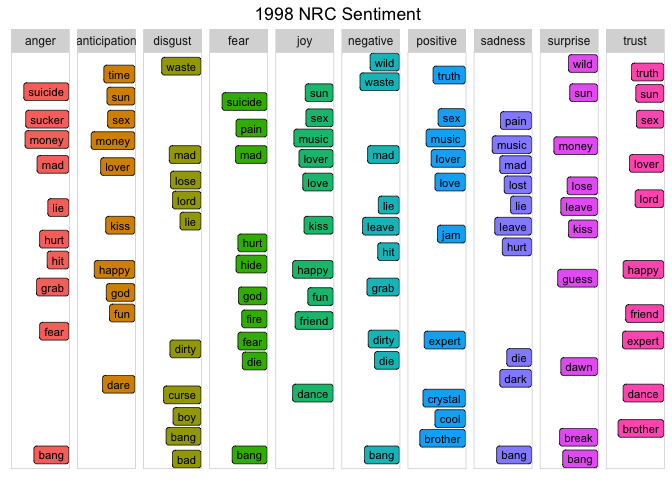
निजी क्षति और आतंकवाद के आसन्न ख़तरे को देखते हुए, "suicide", "waste", "mad", "hurt" जैसे शब्द—और कई अन्य जो इस ग्राफ़ में नहीं हैं—उस समय की वास्तविक घटनाओं के अत्यंत संकेतक हैं। ये शब्द शक्तिशाली हैं और उस अवधि के सेंटिमेंट पर वास्तविक इनसाइट देते हैं।
श्रेणियों के बीच सेंटिमेंट की तुलना करने का एक और अच्छा तरीका रडार चार्ट (या स्पाइडर चार्ट) है। आप radarchart पैकेज से ऐसे चार्ट बना सकते हैं। ये इस बात को देखने में काम आते हैं कि किन वेरिएबल्स के मान समान हैं या किनमें आउट्लायर्स हैं।
आप इस विश्लेषण को तीन स्तरों में बाँटेंगे: वर्ष, चार्ट, और दशक। (स्पेस बचाने के लिए, मैं केवल वर्षों का कोड शामिल कर रहा/रही हूँ।)
prince_nrc_sub डेटासेट का उपयोग करें जिसमें positive और negative नहीं हैं ताकि अन्य श्रेणियाँ अधिक स्पष्ट दिखें। इस बार आप पहले प्रति वर्ष सेंटिमेंट-वार शब्दों की कुल गणना और पूरे वर्ष की कुल सेंटिमेंट गणना निकालेंगे, और प्रतिशत प्राप्त करेंगे ($प्रति वर्ष सेंटिमेंट शब्द-गणना / वर्ष का कुल * 100$)।select() से अनावश्यक फ़ील्ड हटाएँ।spread() कर कई कॉलम्स में फैलाना होगा ताकि प्रत्येक सेंटिमेंट के लिए एक पंक्ति और प्रत्येक वर्ष के लिए एक कॉलम हो। फिर chartJSRadar() से इंटरेक्टिव HTML विजेट बनाएँ। आप होवर पर डेटासेट लेबल दिखाने का आर्गुमेंट पास कर सकते हैं। (ध्यान दें, कभी-कभी radarchart में "joy" के J और Y कट जाते हैं और यह "iov" जैसा दिख सकता है।)#Get the count of words per sentiment per year
year_sentiment_nrc <- prince_nrc_sub %>%
group_by(year, sentiment) %>%
count(year, sentiment) %>%
select(year, sentiment, sentiment_year_count = n)
#Get the total count of sentiment words per year (not distinct)
total_sentiment_year <- prince_nrc_sub %>%
count(year) %>%
select(year, year_total = n)
#Join the two and create a percent field
year_radar_chart <- year_sentiment_nrc %>%
inner_join(total_sentiment_year, by = "year") %>%
mutate(percent = sentiment_year_count / year_total * 100 ) %>%
filter(year %in% c("1978","1994","1995")) %>%
select(-sentiment_year_count, -year_total) %>%
spread(year, percent) %>%
chartJSRadar(showToolTipLabel = TRUE,
main = "NRC Years Radar")
मैंने इन्हें फुल साइज में छोड़ा है, इसलिए तुलना करने के लिए आपको ऊपर-नीचे स्क्रॉल करना होगा। दिलचस्प बात यह है कि year जैसे छोटे डेटासेट में आप इस विज़ुअलाइज़ेशन से हर सेंटिमेंट में विचरण अधिक स्पष्ट देख सकते हैं। आप यह भी देख सकते हैं कि पहले के अभ्यासों के विपरीत, प्रतिशत का उपयोग करते हुए, सभी चार्ट्स पर "joy" सबसे ऊँचा स्कोर रखता है (खासकर 1978 में Prince के करियर की शुरुआत में)।
Spotify अपने 140 मिलियन सक्रिय उपयोगकर्ताओं के लिए सिफ़ारिशें बनाने में मशीन लर्निंग का उपयोग करता है—यह अभी बोलों का उपयोग नहीं करता। कल्पना कीजिए, अगर यह कर सके... अब कुछ विशिष्ट गीतों के मूड में और गहराई से उतरें।
1987 में, Prince ने "Sign O' the Times" लिखा। Kenneth Partridge के एक Billboard लेख में लिखा था:
"As he tackles the topics of AIDS, gangs, drugs, natural disasters, and even the Challenger explosion, Prince plays it cool and detached. 'Sign O' the Times' is a status update, not a call to action. His solution isn't marching in the streets or phoning your congressman."
तो एक मशीन इस गीत के मूड को कैसे समझेगी? क्या यह अत्यधिक भावुक है या सिर्फ़ सूचनात्मक? क्या यह Prince के व्यक्ति या समग्र समाज का प्रतिनिधित्व करता है? ggplot2 से NRC श्रेणियों का ग्राफ़ बनाएँ।
prince_nrc %>%
  filter(song %in% "sign o the times") %>%
  group_by(sentiment) %>%
  summarise(word_count = n()) %>%
  ungroup() %>%
  mutate(sentiment = reorder(sentiment, word_count)) %>%
  ggplot(aes(sentiment, word_count, fill = -word_count)) +
  geom_col() +
  guides(fill = FALSE) +
  theme_minimal() + theme_lyrics() +
  labs(x = NULL, y = "Word Count") +
  ggtitle("Sign O' The Times NRC Sentiment") +
  coord_flip()
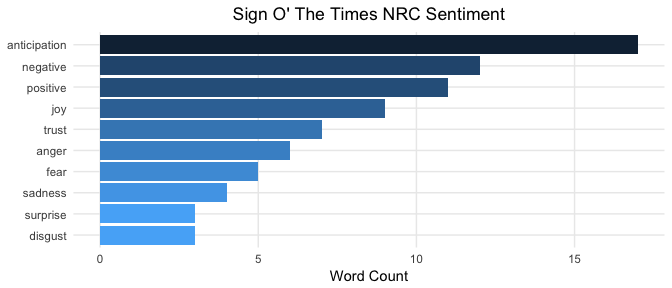
यद्यपि यह फिर से बहुत व्यक्तिनिष्ठ है, आपके परिणाम Partridge के कथन की पुष्टि करते दिखते हैं कि Prince "कूल और डिटैच्ड" रहते हैं। यह इस अवलोकन से व्याख्यायित हो सकता है कि anticipation शब्द, sadness, fear, और anger जैसी भावनात्मक श्रेणियों की तुलना में अधिक प्रचलित हैं। यह लेख बताता है कि ये तीन श्रेणियाँ emotions हैं जबकि anticipation एक sentiment है। Billboard लेखक ने यह भी कहा कि गीत महज़ एक "स्टेटस अपडेट" है, लगभग भावनाओं से रहित। लगता है मशीन भी सहमत है। क्या आप भी ऐसा ही समझते हैं? जानता/जानती हूँ यह R ट्यूटोरियल है, पर सेंटिमेंट एनालिसिस केवल तकनीकी नहीं—इसे वह जगह कहा गया है जहाँ AI मनोविज्ञान से मिलता है।
ggplot2 से थोड़ा अलग चार्ट बनाकर, हर श्रेणी के शब्द देखें।
prince_tidy %>%
  filter(song %in% 'sign o the times') %>%
  distinct(word) %>%
  inner_join(get_sentiments("nrc")) %>%
  ggplot(aes(x = word, fill = sentiment)) +
  facet_grid(~sentiment) +
  geom_bar() + #Create a bar for each word per sentiment
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) + #Place the words on the y-axis
  xlab(NULL) + ylab(NULL) +
  ggtitle("Sign O' The Times Sentiment Words") +
  coord_flip()
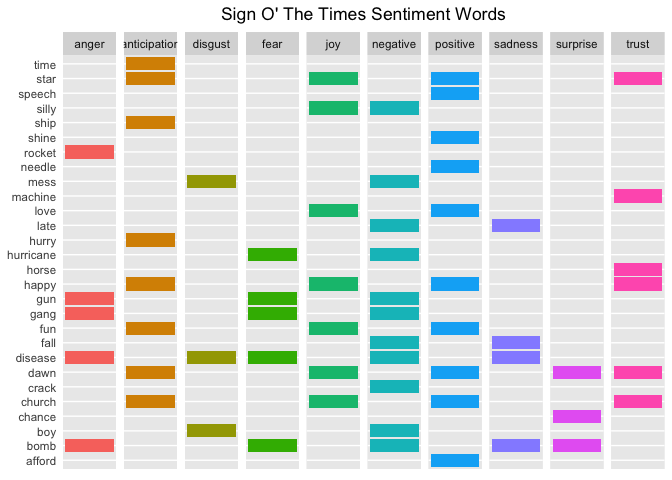
क्या आप इन शब्दों का Billboard लेख में उल्लिखित विषयों से मिलान कर सकते हैं? कनेक्शन साफ़ दिखता है: Challenger आपदा -> "rocket", AIDS -> "disease", Drugs -> "crack", प्राकृतिक आपदाएँ -> "hurricane", गैंग्स -> "gang" आदि।
लगभग ऐसा लगता है मानो Partridge ने लेख लिखने से पहले कुछ R कोड चलाकर यह चार्ट बना लिया हो!
कुछ और विशिष्ट शीर्षक वाले गीतों की सेंटिमेंट श्रेणियाँ देखें और जाँचें कि क्या वे सहसंबद्ध प्रतीत होते हैं।
prince_nrc_sub %>%
  filter(song %in% c("so blue", "controversy", "raspberry beret",
                     "when doves cry", "the future", "1999")) %>%
  count(song, sentiment, year) %>%
  mutate(sentiment = reorder(sentiment, n), song = reorder(song, n)) %>%
  ggplot(aes(sentiment, n, fill = sentiment)) +
  geom_col() +
  facet_wrap(year ~ song, scales = "free_x", labeller = label_both) +
  theme_lyrics() +
  theme(panel.grid.major.x = element_blank(),
        axis.text.x = element_blank()) +
  labs(x = NULL, y = NULL) +
  ggtitle("NRC Sentiment Song Analysis") +
  coord_flip()
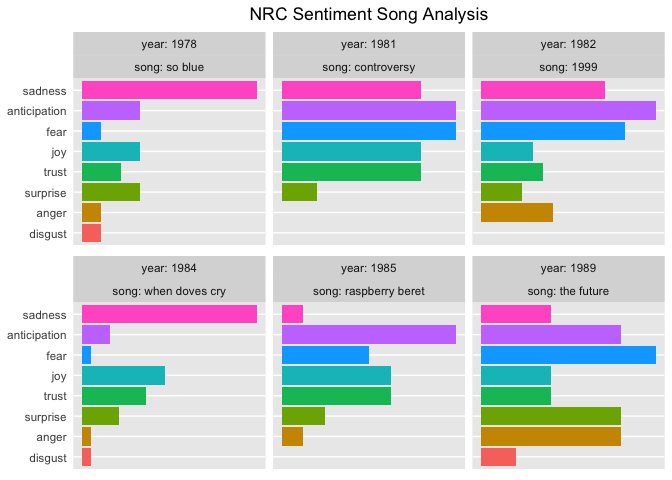
NRC सेंटिमेंट्स the future पर बने गीत में उच्च anticipation और fear दिखाते हैं, और controversy पर उच्च trust भी। जो गीत प्रबल रूप से sad हैं, वे अपने शीर्षकों से मेल खाते दिखते हैं।
अब तक आपने केवल यूनिग्राम या एकल शब्द देखे हैं। पर यदि "love" सामान्य शब्द है, तो उसके पहले क्या आता है? या बाद में? संदर्भ से बाहर एकल शब्द भ्रामक हो सकते हैं। अब बाइग्राम्स या शब्द-युग्म देखें।
सुविधाजनक रूप से, tidytext पैकेज एकल शब्दों के साथ-साथ शब्द-युग्मों को भी अननेस्ट कर सकता है। इस मामले में, आप unnest_tokens() में token आर्गुमेंट के रूप में ngrams पास करेंगे। क्योंकि आप केवल बाइग्राम (दो लगातार शब्द) देख रहे हैं, n = 2 पास करें। परिणामों को prince_bigrams में रखें।
tidyr पैकेज separate() से बाइग्राम्स को अलग-अलग शब्दों में बाँट सकता है। स्टॉप वर्ड्स और अनचाहे शब्दों को हटाने के लिए, बाइग्राम्स को अलग करें, फ़िल्टर करें, फिर unite() से शब्द-युग्मों को वापस जोड़ें। इससे प्रति दशक सबसे आम बाइग्राम्स को विज़ुअलाइज़ करना आसान हो जाता है। (भाग वन में slice() और row_number() की व्याख्या देखें)
prince_bigrams <- prince_data %>%
  unnest_tokens(bigram, lyrics, token = "ngrams", n = 2)

bigrams_separated <- prince_bigrams %>%
  separate(bigram, c("word1", "word2"), sep = " ")

bigrams_filtered <- bigrams_separated %>%
  filter(!word1 %in% stop_words$word) %>%
  filter(!word2 %in% stop_words$word) %>%
  filter(!word1 %in% undesirable_words) %>%
  filter(!word2 %in% undesirable_words)

#Because there is so much repetition in music, also filter out the cases where the two words are the same
bigram_decade <- bigrams_filtered %>%
  filter(word1 != word2) %>%
  filter(decade != "NA") %>%
  unite(bigram, word1, word2, sep = " ") %>%
  inner_join(prince_data) %>%
  count(bigram, decade, sort = TRUE) %>%
  group_by(decade) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  arrange(decade, n) %>%
  mutate(row = row_number())
## Joining, by = c("song", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level", "charted")bigram_decade %>%
ggplot(aes(row, n, fill = decade)) +
geom_col(show.legend = FALSE) +
facet_wrap(~decade, scales = "free_y") +
xlab(NULL) + ylab(NULL) +
scale_x_continuous( # This handles replacement of row
breaks = bigram_decade$row, # Notice need to reuse data frame
labels = bigram_decade$bigram) +
theme_lyrics() +
theme(panel.grid.major.x = element_blank()) +
ggtitle("Bigrams Per Decade") +
coord_flip()
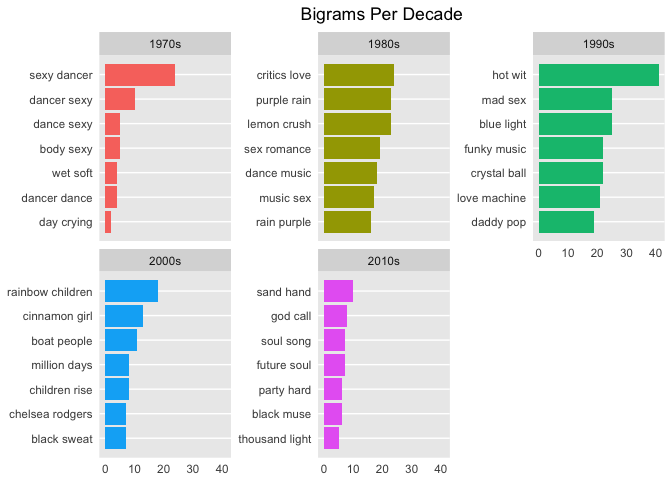
बाइग्राम्स का उपयोग करते हुए, आप लगभग देख सकते हैं कि सामान्य वाक्यांश सेक्स, डांस और रोमांस से धर्म और (रैनबो) चिल्ड्रन की ओर शिफ्ट होते हैं। यदि आप नहीं जानते, तो "रेनबो बेबी" शब्द का उपयोग कभी-कभी उन माता-पिता द्वारा किया जाता है जो गर्भपात से बच्चे को खोने के बाद दोबारा संतान की उम्मीद कर रहे होते हैं। दिलचस्प है कि Prince के Rainbow Children एल्बम की किसी वास्तविक समीक्षा में मुझे इसका ज़िक्र नहीं मिला।
तो बाइग्राम्स सेंटिमेंट को कैसे प्रभावित करते हैं? इस बार AFINN लेक्सिकॉन का उपयोग करके शब्द-युग्मों पर सेंटिमेंट एनालिसिस करें—देखें कि सेंटिमेंट-संबंधी शब्दों से पहले "not" या अन्य निगेशन शब्द कितनी बार आते हैं।
AFINN <- get_sentiments("afinn")

not_words <- bigrams_separated %>%
  filter(word1 == "not") %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word2, score, sort = TRUE) %>%
  ungroup()

not_words %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  head(20) %>%
  mutate(word2 = reorder(word2, contribution)) %>%
  ggplot(aes(word2, n * score, fill = n * score > 0)) +
  geom_col(show.legend = FALSE) +
  theme_lyrics() +
  xlab("Words preceded by \"not\"") +
  ylab("Sentiment score * Number of Occurrences") +
  ggtitle("Polar Sentiment of Words Preceded by Not") +
  coord_flip()
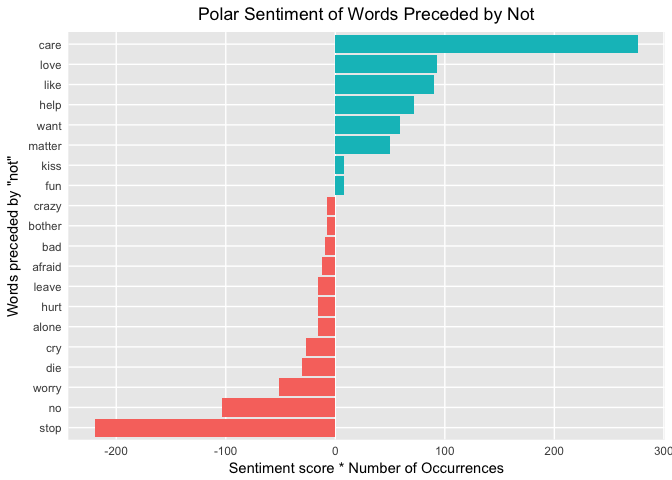
ग्राफ़ की पहली पंक्ति में, care को फ़ॉल्स पॉज़िटिव सेंटिमेंट मिलता है क्योंकि सिंगल-वर्ड एनालिसिस में "not" को नज़रअंदाज़ कर दिया जाता है। क्या फ़ॉल्स पॉज़िटिव बाइग्राम्स, फ़ॉल्स नेगेटिव बाइग्राम्स को रद्द करते हैं?
एक और प्रश्न जिसका मैं उत्तर नहीं दे सकता/सकती—पर आगे की खोज के लिए अच्छा विषय है। टिप: आप unnest_tokens() में "trigrams" और "n = 3" भी पास कर सकते हैं—और अधिक लगातार शब्दों को देखने के लिए!
अन्य निगेशन शब्दों पर भी विचार करें। इस बार आप ggraph और igraph पैकेज से एक नेटवर्क ग्राफ़ बनाएँगे। शब्दों को जुड़े नोड्स में व्यवस्थित करें—केंद्र में निगेशन शब्द हों। graph_from_data_frame() से टाइडी डेटासेट से पहला ऑब्जेक्ट बनाएँ और फिर ggraph() से प्लॉट करें। geom_edge_density() से मुख्य नोड्स को हाइलाइट कर सकते हैं। Julia Silge और David Robinson की Tidy Text Mining किताब में इसी तरह के उदाहरण का विवरण है।
negation_words <- c("not", "no", "never", "without")

negation_bigrams <- bigrams_separated %>%
  filter(word1 %in% negation_words) %>%
  inner_join(AFINN, by = c(word2 = "word")) %>%
  count(word1, word2, score, sort = TRUE) %>%
  mutate(contribution = n * score) %>%
  arrange(desc(abs(contribution))) %>%
  group_by(word1) %>%
  slice(seq_len(20)) %>%
  arrange(word1,desc(contribution)) %>%
  ungroup()

bigram_graph <- negation_bigrams %>%
  graph_from_data_frame() #From `igraph`

set.seed(123)

a <- grid::arrow(type = "closed", length = unit(.15, "inches"))

ggraph(bigram_graph, layout = "fr") +
  geom_edge_link(alpha = .25) +
  geom_edge_density(aes(fill = score)) +
  geom_node_point(color = "purple1", size = 1) + #Purple for Prince!
  geom_node_text(aes(label = name),  repel = TRUE) +
  theme_void() + theme(legend.position = "none",
                       plot.title = element_text(hjust = 0.5)) +
  ggtitle("Negation Bigram Network")
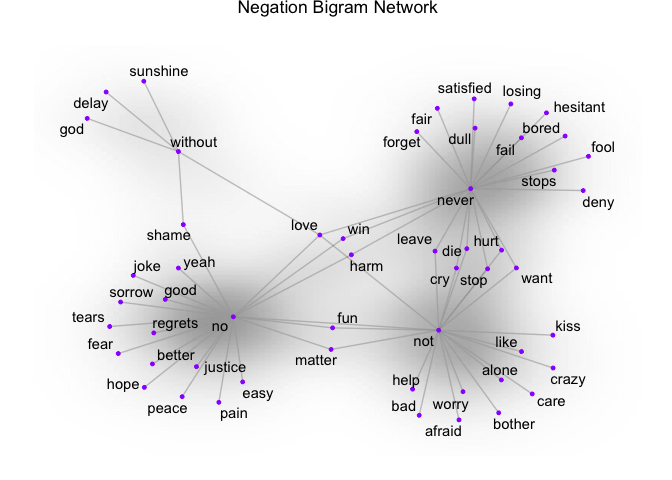
यहाँ आप निगेशन शब्दों से जुड़े शब्द-युग्म देख सकते हैं। इसलिए यदि आपका विश्लेषण यूनिग्राम्स पर आधारित है और "alone" नकारात्मक आता है, तो "not alone" जैसा बाइग्राम उल्टा प्रभाव डालेगा। कुछ शब्द कई नोड्स में क्रॉसओवर करते हैं—जैसे "never hurt" और "not hurt"—जो इस तरह के विज़ुअल में आसानी से दिखते हैं।
अब जब आपने n-grams देख लिए हैं, तो शब्दों के बीच कोरिलेशन देखें। कौन से शब्द सबसे अधिक संबद्ध हैं? widyr पैकेज के pairwise_count() से सह-अवस्थिति (co-occurrence) की गणना करें—यानी किसी गीत के भीतर शब्द-युग्म कितनी बार साथ आते हैं। widyr एक टाइडी डेटासेट लेता है, उसे अस्थायी रूप से वाइड करता है और फिर विज़ुअलाइज़ेशन व आगे के विश्लेषण के लिए टाइडी संरचना में लौटा देता है।
सरल रखने के लिए, मैंने Prince के बोलों के चार दिलचस्प शब्द चुने हैं।
pwc <- prince_tidy %>%
  filter(n() >= 20) %>%  #High counts
  pairwise_count(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  slice(seq_len(7)) %>%
  ungroup() %>%
  mutate(row = -row_number()) #Descending order

pwc %>%
  ggplot(aes(row, n, fill = item1)) +
  geom_bar(stat = "identity", show.legend = FALSE) +
  facet_wrap(~item1, scales = "free") +
  scale_x_continuous(  #This handles replacement of row
      breaks = pwc$row, #Notice need to reuse data frame
      labels = pwc[item2]) +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Counts") +
  coord_flip()
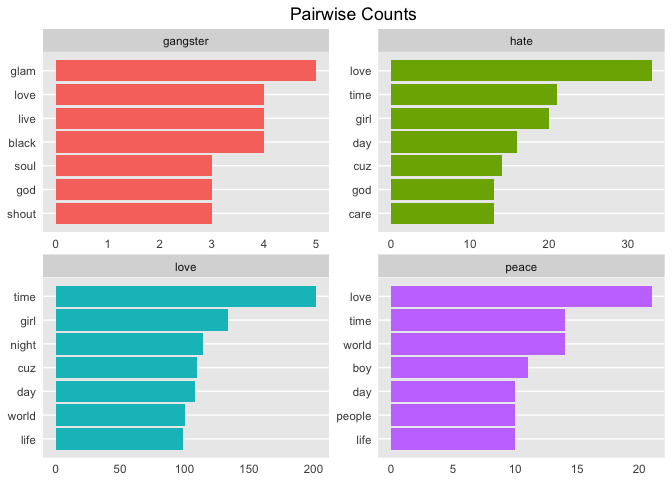
अब पेयरवाइज़ कोरिलेशन से तुलना करें। इसका मतलब है कि शब्द अलग-अलग की तुलना में साथ में कितनी बार आते हैं। pairwise_cor() से यह देखें कि एक ही गीत में साथ आने के आधार पर शब्दों के बीच सहसंबंध क्या है।
prince_tidy %>%
  group_by(word) %>%
  filter(n() >= 20) %>%
  pairwise_cor(word, song, sort = TRUE) %>%
  filter(item1 %in% c("love", "peace", "gangster", "hate")) %>%
  group_by(item1) %>%
  top_n(7) %>%
  ungroup() %>%
  mutate(item2 = reorder(item2, correlation)) %>%
  ggplot(aes(item2, correlation, fill = item1)) +
  geom_bar(stat = 'identity', show.legend = FALSE) +
  facet_wrap(~item1, scales = 'free') +
  theme_lyrics() + theme(panel.grid.major.x = element_blank()) +
  xlab(NULL) + ylab(NULL) +
  ggtitle("Pairwise Correlation") +
  coord_flip()
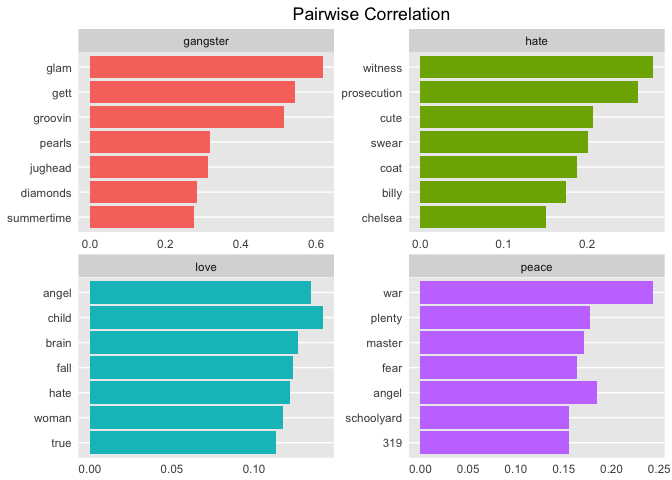
सिर्फ़ इन चार शब्दों के आधार पर भी ये इनसाइट्स दिलचस्प हैं! इन नतीजों को देखकर कुछ थीम्स उभरती दिखती हैं। यही अगले ट्यूटोरियल—टॉपिक मॉडलिंग—की ओर बढ़ने का बढ़िया माध्यम है!
इस ट्यूटोरियल में, आपने एक टाइडी डेटासेट बनाया और बुनियादी जानकारी—जैसे लेक्सिकल विविधता और प्रति रिलीज़ वर्ष गीत-गणना—का विश्लेषण किया, और रिलीज़ दशक तथा गीत के चार्ट पर आने के बीच संबंध देखा। फिर आपने कुछ सेंटिमेंट लेक्सिकॉन और उनके बोलों से मेल खाने की क्षमता का पता लगाया। इसके बाद, आपने पूरे डेटासेट, समय के साथ, गीत-स्तर, और बाइग्राम्स के प्रभाव पर सेंटिमेंट एनालिसिस किया। आपने अलग-अलग रोचक ग्राफ़्स का उपयोग किया—हर एक ने अलग परिप्रेक्ष्य दिया।
तो क्या बोलों में मूड निर्धारित करने के लिए प्रोग्राम लिखा जा सकता है? जी हाँ! आपके परिणाम कितने भरोसेमंद हैं? यह कई बातों पर निर्भर करता है—डेटा तैयारी की मात्रा, लेक्सिकॉन का चुनाव, विश्लेषण की विधि, स्रोत डेटा की गुणवत्ता, आदि। वास्तविक जीवन की घटनाओं—निजी और सामाजिक—की तुलना किसी भी लिरिक के मूड को उजागर कर सकती है। Prince का पोलर सेंटिमेंट समय के साथ थोड़ा गिरता दिखा, फिर भी समग्र रूप से joy उभरता है। चार्टेड गाने बिना-चार्ट गानों से अधिक सकारात्मक लगते हैं। 9/11 और उनकी अपनी मृत्यु की भविष्यवाणी के दावे उनके शब्दों से अजीब तरह मेल खाते हैं।
पर गीत जटिल होते हैं और बहुत अधिक अनुमानों से समस्या हो सकती है। यदि आप बोलों के बारे में सीखी बातों को अगले ट्यूटोरियल—भाग टू-बी, टॉपिक मॉडलिंग—में ले जाएँगे, तो आप थीम्स और मोटिफ़्स की खोज के रास्ते पर आगे बढ़ जाएँगे। कितनी NLP ऐसे बोलों पर की जा सकती है जिनमें विरामचिन्ह या वाक्य संरचना नहीं दिखती? Prince वास्तव में किस बारे में गा रहे थे? अब जब आप मूड समझते हैं, तो संभावित विषयों की पड़ताल के लिए आप बेहतर तैयार हैं। और अंत में, क्या आप मशीन लर्निंग तकनीकों से किसी गीत का दशक या चार्ट स्तर भविष्यवाणी कर सकते हैं? अगले ट्यूटोरियल्स में मेरे साथ आइए और पता लगाइए!
आशा है अब तक की यह यात्रा आपको पसंद आई होगी। भाग टू-बी में हम 1999 की तरह पार्टी करेंगे!
R के बारे में और जानें
कोर्स
कोर्स
कोर्स