Kursus
Python Tingkat Menengah
4 jam
1.4M
Fungsi aktivasi adalah tulang punggung jaringan saraf. Komponen penting ini memperkenalkan non-linearitas dan memungkinkan jaringan mempelajari pola yang kompleks. Fungsi aktivasi softmax sangat penting, terutama saat menangani masalah klasifikasi multi-kelas.
Meskipun alternatif seperti Sigmoid dan ReLU memiliki kasus penggunaan khusus, softmax lebih baik dalam menangani situasi ketika keluaran harus diinterpretasikan sebagai probabilitas pada kelas-kelas yang saling eksklusif.
Fungsi aktivasi softmax mengubah seluruh vektor angka menjadi distribusi probabilitas. Karakteristik unik ini menjadikannya sangat penting untuk tugas yang memerlukan klasifikasi masukan ke dalam salah satu dari beberapa kategori yang mungkin.
Dari sistem pengenalan gambar yang mengidentifikasi ribuan kategori objek hingga model pemrosesan bahasa alami yang memprediksi kata berikutnya dalam sebuah kalimat, softmax menyediakan landasan matematis untuk membuat keputusan di antara banyak kemungkinan.
Dalam artikel ini, kita akan melihat apa itu fungsi aktivasi softmax, bagaimana cara kerjanya secara matematis, dan kapan Anda sebaiknya menggunakannya dalam arsitektur jaringan saraf Anda. Kita juga akan melihat implementasi praktisnya di Python.
Fungsi aktivasi Softmax adalah fungsi matematis yang mengubah vektor keluaran mentah model, yang dikenal sebagai logit, menjadi distribusi probabilitas. Sederhananya, fungsi ini mengambil sekumpulan angka dan mengonversinya menjadi probabilitas yang jumlahnya 1.
Tidak seperti beberapa fungsi aktivasi yang beroperasi pada nilai individual secara independen, softmax bekerja pada seluruh vektor nilai, mengubahnya secara kolektif menjadi distribusi probabilitas di mana semua elemen jumlahnya tepat 1.
Dalam konteks jaringan saraf, softmax biasanya diterapkan pada lapisan terakhir dari jaringan yang dirancang untuk klasifikasi multi-kelas. Ketika kita memiliki beberapa kategori yang mungkin dan membutuhkan model untuk menunjukkan probabilitas masing-masing kategori, fungsi aktivasi softmax adalah pilihan standar.
Keluaran mentah dari lapisan terakhir jaringan saraf sering disebut "logit." Nilai-nilai ini dapat berkisar dari negatif tak hingga hingga positif tak hingga dan tidak memiliki interpretasi probabilistik langsung. Fungsi aktivasi softmax mengubah logit ini menjadi bentuk yang lebih mudah diinterpretasikan dengan cara:
Transformasi ini penting karena memungkinkan kita menafsirkan keluaran jaringan sebagai distribusi probabilitas. Misalnya, jika jaringan saraf mengklasifikasikan gambar ke dalam tiga kategori (kucing, anjing, burung), keluaran softmax mungkin [0.7, 0.2, 0.1], menunjukkan probabilitas 70% untuk kucing, 20% untuk anjing, dan 10% untuk burung.
Fungsi aktivasi softmax memainkan peran penting dalam menciptakan distribusi probabilitas yang valid karena:
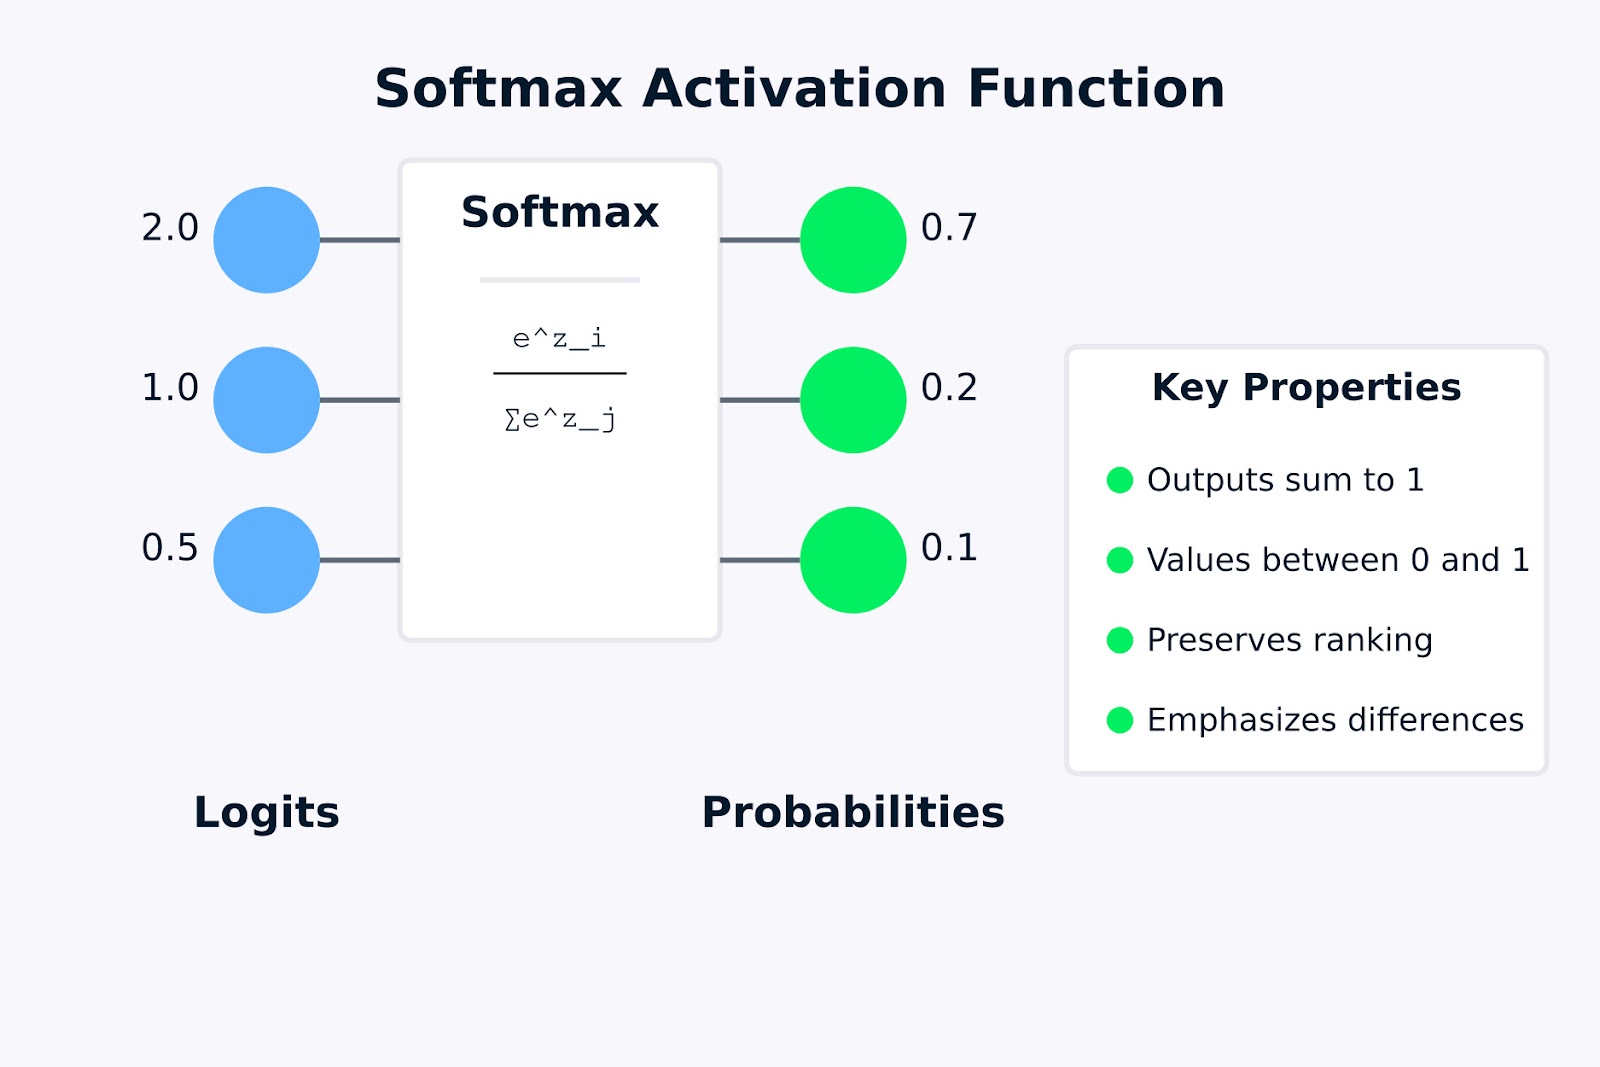
Fungsi Aktivasi Softmax
Visualisasi di atas menunjukkan bagaimana fungsi aktivasi softmax mengubah logit mentah (nilai masukan 2.0, 1.0, dan 0.5) menjadi distribusi probabilitas (0.7, 0.2, dan 0.1). Rumus di dalam kotak softmax merepresentasikan bagaimana setiap probabilitas keluaran dihitung dengan mengambil eksponensial dari nilai masukan dan membaginya dengan jumlah seluruh eksponensial.
Sifat-sifat kunci yang disorot di sebelah kanan menunjukkan mengapa softmax berguna untuk masalah klasifikasi multi-kelas. Pada bagian berikutnya, kita akan melihat rumus matematisnya dan bagaimana cara kerjanya.
Sekarang kita memahami apa itu fungsi aktivasi softmax, mari kita lihat perumusannya secara matematis dan bagaimana ia mengubah masukan menjadi distribusi probabilitas.
Rumus fungsi aktivasi softmax dapat dinyatakan secara matematis sebagai:
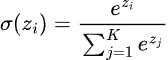
Di mana:
Fungsi aktivasi softmax mengikuti langkah-langkah berikut untuk mengubah vektor masukan menjadi distribusi probabilitas:
Mari terapkan rumus fungsi aktivasi softmax pada contoh sederhana untuk melihat bagaimana fungsinya dalam praktik.
Misalkan kita memiliki jaringan saraf dengan tiga neuron keluaran untuk masalah klasifikasi tiga kelas (misalnya, mengidentifikasi apakah sebuah gambar berisi kucing, anjing, atau burung). Setelah perhitungan terakhir, jaringan menghasilkan logit berikut: z = [2.0, 1.0, 0.5].
Untuk mengonversi logit ini menjadi probabilitas menggunakan fungsi softmax:
Distribusi probabilitas hasil [0.628, 0.231, 0.140] berjumlah 1, dengan probabilitas tertinggi diberikan pada kelas yang sesuai dengan nilai logit tertinggi. Contoh ini menunjukkan bagaimana fungsi aktivasi softmax mempertahankan peringkat nilai masukan sambil mengubahnya menjadi distribusi probabilitas yang valid.
Perhatikan bagaimana nilai masukan asli (2.0, 1.0, 0.5) mempertahankan peringkat relatifnya pada probabilitas keluaran, tetapi perbedaannya menjadi lebih ditonjolkan. Sifat ini membuat softmax sangat berguna dalam tugas klasifikasi ketika kita ingin mengidentifikasi kelas yang paling mungkin dengan keyakinan.
Pada bagian berikutnya, kita akan melihat berbagai cara untuk mengimplementasikan fungsi aktivasi softmax menggunakan Python.
Sekarang kita memahami teori di balik fungsi aktivasi softmax, mari kita lihat cara mengimplementasikannya di Python. Kita akan mulai dengan menulis fungsi softmax dari nol menggunakan NumPy, lalu melihat cara menggunakannya dengan kerangka kerja deep learning populer seperti TensorFlow/Keras dan PyTorch.
Sebelum masuk ke kerangka kerja, penting untuk memahami cara mengimplementasikan fungsi aktivasi softmax dari nol. Ini membantu membangun intuisi tentang apa yang terjadi di balik layar.
import numpy as np

def softmax(x):
    """
    Compute softmax values for each set of scores in x.

    Args:
        x: Input array of shape (batch_size, num_classes) or (num_classes,)

    Returns:
        Softmax probabilities of same shape as input
    """
    # For numerical stability, subtract the maximum value from each input vector
    # This prevents overflow when calculating exp(x)
    shifted_x = x - np.max(x, axis=-1, keepdims=True)

    # Calculate exp(x) for each element
    exp_x = np.exp(shifted_x)

    # Calculate the sum of exp(x) for normalization
    sum_exp_x = np.sum(exp_x, axis=-1, keepdims=True)

    # Normalize to get probabilities
    probabilities = exp_x / sum_exp_x

    return probabilities
Implementasi ini mengikuti rumus fungsi aktivasi softmax secara tepat, dengan satu tambahan penting: kita mengurangkan nilai maksimum dari setiap vektor masukan sebelum melakukan pemangkatan.
Operasi "pergeseran" ini tidak mengubah hasil matematis, tetapi membantu mencegah overflow numerik, yang dapat terjadi saat menghitung eksponensial dari angka besar.
Mari uji implementasi kita dengan contoh sederhana:
# Sample logits from a neural network (batch of 2 examples, 3 classes each)
logits = np.array([
    [2.0, 1.0, 0.5],  # First example
    [3.0, 2.0, 1.0]   # Second example
])

probabilities = softmax(logits)
print("Logits:\n", logits)
print("\nSoftmax probabilities:\n", probabilities)
print("\nSum of probabilities (should be 1 for each example):", np.sum(probabilities, axis=1))
Keluaran:
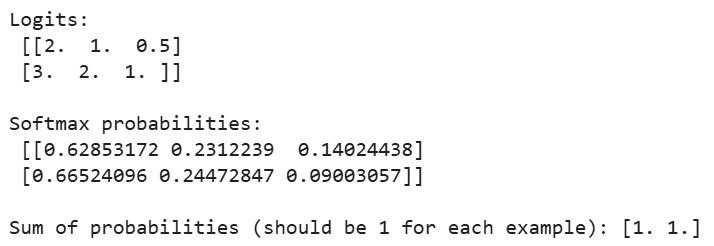
Saat kita menjalankan kode di atas, kita akan melihat bahwa jumlah probabilitas untuk setiap contoh sama dengan 1, mengonfirmasi bahwa implementasi softmax kita menghasilkan distribusi probabilitas yang valid. Untuk contoh pertama, probabilitas terbesar sesuai dengan logit terbesar (2.0), dan begitu juga untuk contoh kedua.
TensorFlow dan Keras memudahkan penggunaan fungsi aktivasi softmax dalam jaringan saraf Anda. Mari membangun pengklasifikasi sederhana untuk dataset MNIST langkah demi langkah.
Pertama, mari impor pustaka yang diperlukan dan muat datasetnya:
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Flatten, Softmax
from tensorflow.keras.datasets import mnist
import matplotlib.pyplot as plt
import numpy as np

# Load and preprocess the MNIST dataset
(x_train, y_train), (x_test, y_test) = mnist.load_data()

# Normalize pixel values to be between 0 and 1
x_train, x_test = x_train / 255.0, x_test / 255.0

# One-hot encode the labels
y_train_one_hot = tf.keras.utils.to_categorical(y_train, 10)
y_test_one_hot = tf.keras.utils.to_categorical(y_test, 10)
Dataset MNIST berisi gambar skala abu-abu 28x28 piksel dari digit tulisan tangan (0-9). Kita menormalkan nilai piksel agar berada antara 0 dan 1 untuk dinamika pelatihan yang lebih baik, dan kita mengonversi label kelas ke one-hot encoding, yang merupakan format yang disukai untuk keluaran softmax.
Sekarang, mari buat model jaringan saraf dengan lapisan keluaran softmax:
# Method 1: Using softmax as the activation function in the final layer
model1 = Sequential([
    Flatten(input_shape=(28, 28)),  # Convert 28x28 images to 784-length vectors
    Dense(128, activation='relu'),   # Hidden layer with ReLU activation
    Dense(10, activation='softmax')  # Output layer with softmax activation
])

# Method 2: Using a separate Softmax layer
model2 = Sequential([
    Flatten(input_shape=(28, 28)),
    Dense(128, activation='relu'),
    Dense(10),  # Linear output (logits)
    Softmax()   # Separate softmax layer
])
Di sini, kita mendemonstrasikan dua cara setara untuk memasukkan fungsi aktivasi softmax dalam jaringan saraf:
Kedua pendekatan menghasilkan hasil yang identik, tetapi metode kedua membuat pemisahan antara logit dan probabilitas menjadi lebih eksplisit, yang dapat berguna dalam skenario tertentu.
Selanjutnya, mari kompilasi dan latih modelnya:
# Compile the model
model1.compile(
    optimizer='adam',
    loss='categorical_crossentropy',  # This loss works well with softmax
    metrics=['accuracy']
)

# Print model summary
print("Model with softmax activation:")
model1.summary()

# Train the model
print("\nTraining the model...")
history = model1.fit(
    x_train, y_train_one_hot,
    epochs=5,
    batch_size=128,
    validation_split=0.1,
    verbose=1
)Keluaran:
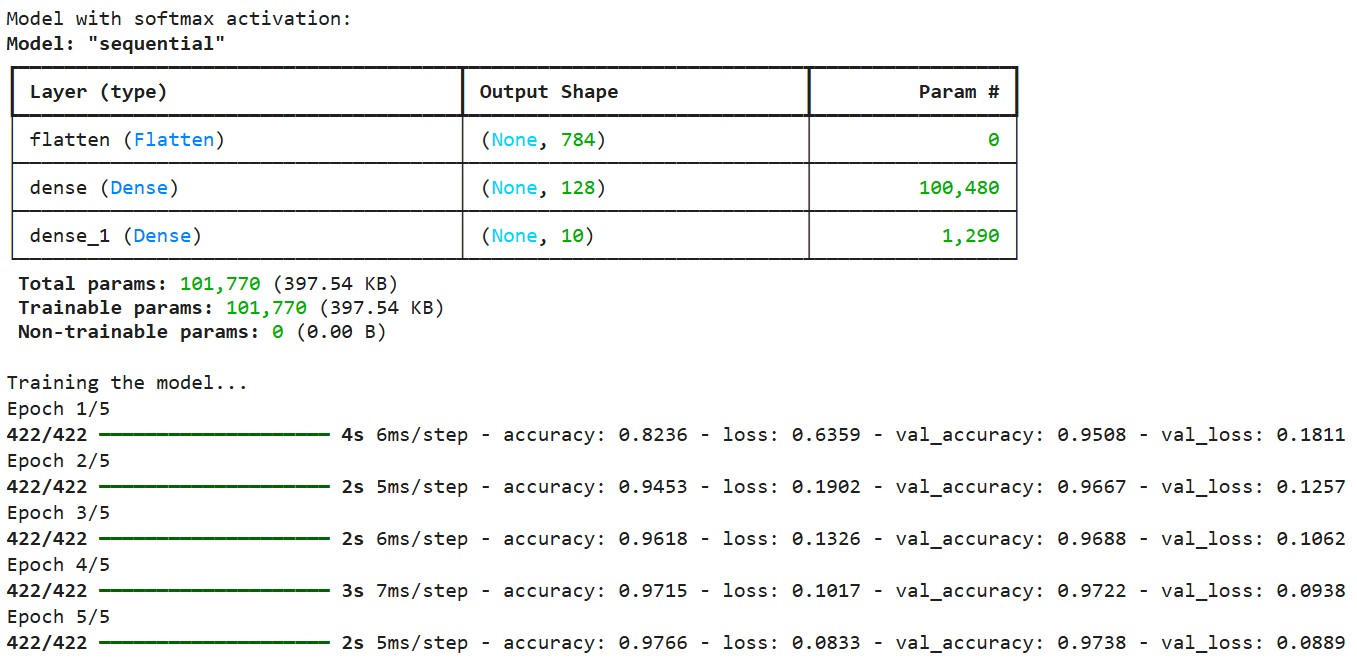 Kita mengompilasi model menggunakan fungsi loss cross-entropy kategorikal, yang dirancang untuk bekerja dengan keluaran softmax. Fungsi loss ini mengukur perbedaan antara distribusi probabilitas yang diprediksi dan label one-hot yang benar. Kita menggunakan optimizer Adam, yang menyesuaikan laju pembelajaran secara adaptif selama pelatihan.
Setelah pelatihan, kita dapat menggunakan model untuk membuat prediksi dan memvisualisasikan hasilnya:
# Let's check predictions on a sample
sample_idx = 42
sample_image = x_test[sample_idx]
true_label = y_test[sample_idx]

# Get model predictions (probabilities across all classes)
predictions = model1.predict(sample_image[np.newaxis, ...])

# Visualize the results
plt.figure(figsize=(10, 4))

# Plot the image
plt.subplot(1, 2, 1)
plt.imshow(sample_image, cmap='gray')
plt.title(f"True label: {true_label}")
plt.axis('off')

# Plot the probability distribution
plt.subplot(1, 2, 2)
plt.bar(range(10), predictions[0])
plt.xticks(range(10))
plt.xlabel('Digit')
plt.ylabel('Probability')
plt.title('Softmax Probabilities')
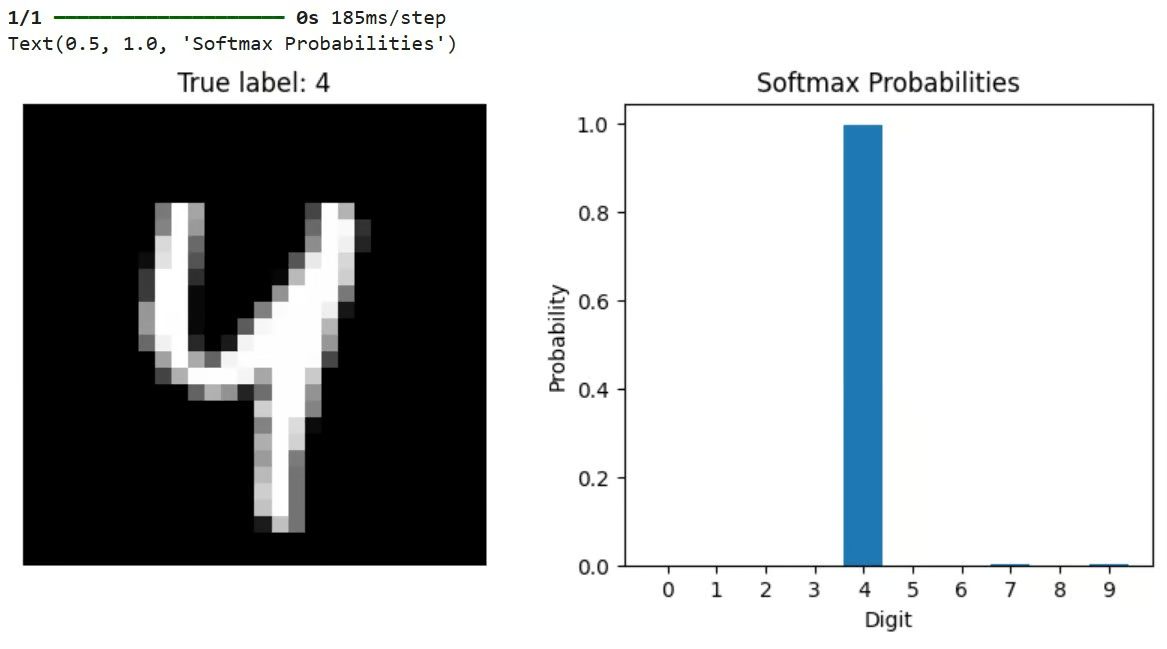
Kode ini memilih sebuah gambar uji, melewatkannya melalui model yang telah dilatih, dan memvisualisasikan baik gambar maupun distribusi probabilitas dari keluaran softmax. Batang tertinggi pada plot probabilitas merepresentasikan prediksi model.
Keluaran:
TensorFlow juga menyediakan fungsi bawaan untuk menerapkan softmax secara langsung:
# Demonstrate using a custom softmax function in TensorFlow
def custom_softmax(logits):
    """Custom implementation of softmax in TensorFlow"""
    exp_logits = tf.exp(logits - tf.reduce_max(logits, axis=-1, keepdims=True))
    return exp_logits / tf.reduce_sum(exp_logits, axis=-1, keepdims=True)

# Example usage of custom softmax
logits = tf.constant([[2.0, 1.0, 0.5], [3.0, 2.0, 1.0]])
custom_probs = custom_softmax(logits)
tf_probs = tf.nn.softmax(logits)

print("\nCustom softmax:", custom_probs.numpy())
print("TensorFlow softmax:", tf_probs.numpy())Keluaran:
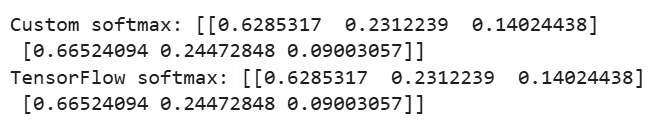
Contoh ini membandingkan implementasi kustom softmax dengan fungsi bawaan TensorFlow tf.nn.softmax(). Keduanya seharusnya menghasilkan hasil yang identik. Implementasi kustom juga menyertakan trik stabilitas numerik dengan mengurangkan nilai maksimum sebelum pemangkatan.
Sekarang, mari implementasikan model serupa menggunakan PyTorch dan dataset CIFAR-10. Kita akan mulai dengan mengimpor pustaka dan menyiapkan data, seperti di bawah ini:
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms
import matplotlib.pyplot as plt
import numpy as np

# Set the device
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(f"Using device: {device}")

# Load and preprocess the CIFAR-10 dataset
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))  # Normalize RGB channels
])

# Load a small subset of the CIFAR-10 dataset for demonstration
trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64,
                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,
                                       download=True, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=64,
                                         shuffle=False, num_workers=2)

# Define the class names for CIFAR-10
classes = ('plane', 'car', 'bird', 'cat', 'deer',
           'dog', 'frog', 'horse', 'ship', 'truck')
Kode di atas menyiapkan PyTorch untuk menggunakan akselerasi GPU jika tersedia, memuat dataset CIFAR-10 (yang berisi gambar berwarna 32x32 dalam 10 kelas), dan menyiapkan pemuat data untuk pelatihan dan pengujian.
Selanjutnya, mari definisikan sebuah jaringan saraf konvolusional sederhana seperti berikut:
# Define a simple convolutional neural network
class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        # Convolutional layers
        self.conv1 = nn.Conv2d(3, 16, 3, padding=1)
        self.conv2 = nn.Conv2d(16, 32, 3, padding=1)
        self.pool = nn.MaxPool2d(2, 2)

        # Fully connected layers
        self.fc1 = nn.Linear(32 * 8 * 8, 128)
        self.fc2 = nn.Linear(128, 10)  # 10 classes in CIFAR-10

        # Activation functions
        self.relu = nn.ReLU()

        # Note: We don't define softmax here as it will be applied with the loss function

    def forward(self, x):
        # Convolutional layers with ReLU and pooling
        x = self.pool(self.relu(self.conv1(x)))  # -> 16x16x16
        x = self.pool(self.relu(self.conv2(x)))  # -> 8x8x32

        # Flatten the output
        x = x.view(-1, 32 * 8 * 8)

        # Fully connected layers
        x = self.relu(self.fc1(x))
        x = self.fc2(x)  # Raw logits output

        # Note: No softmax here, as PyTorch's CrossEntropyLoss applies it internally
        return x
CNN ini memproses gambar RGB 32x32 melalui lapisan konvolusional, menerapkan aktivasi ReLU dan pooling, dan diakhiri dengan lapisan fully connected. Perlu dicatat, model tidak menyertakan lapisan softmax dalam forward pass. Sebagai gantinya, model menghasilkan logit mentah.
Ini adalah pola umum di PyTorch karena fungsi CrossEntropyLoss yang digunakan selama pelatihan secara internal menerapkan softmax sebelum menghitung loss, yang lebih stabil secara numerik.
Mari juga lihat cara memasukkan softmax secara eksplisit jika diperlukan:
# Applying softmax within the model
class ModelWithSoftmax(nn.Module):
    def __init__(self):
        super(ModelWithSoftmax, self).__init__()
        self.features = SimpleCNN()
        self.softmax = nn.Softmax(dim=1)

    def forward(self, x):
        logits = self.features(x)
        probabilities = self.softmax(logits)
        return probabilities
Kita mendefinisikan dua varian model: SimpleCNN menghasilkan logit mentah, sementara ModelWithSoftmax secara eksplisit menerapkan softmax untuk menghasilkan probabilitas. Untuk pelatihan, kita menggunakan SimpleCNN dengan CrossEntropyLoss, yang merupakan pendekatan standar di PyTorch.
Mari kita definisikan fungsi pelatihan:
# Create the model and move it to the device
model = SimpleCNN().to(device)
# Define loss function and optimizer
criterion = nn.CrossEntropyLoss()  # Combines LogSoftmax and NLLLoss
optimizer = optim.SGD(model.parameters(), lr=0.001, momentum=0.9)
# Train the model (only a few epochs for demonstration)
def train_model(epochs=2):
    for epoch in range(epochs):
        running_loss = 0.0
        for i, data in enumerate(trainloader, 0):
            inputs, labels = data[0].to(device), data[1].to(device)

            # Zero the parameter gradients
            optimizer.zero_grad()

            # Forward + backward + optimize
            outputs = model(inputs)  # These are logits (pre-softmax)
            loss = criterion(outputs, labels)
            loss.backward()
            optimizer.step()

            running_loss += loss.item()
            if i % 100 == 99:
                print(f'[{epoch + 1}, {i + 1}] loss: {running_loss / 100:.3f}')
                running_loss = 0.0

    print('Finished Training')
Terakhir, mari buat fungsi untuk memvisualisasikan prediksi model:
# Function to display predictions with softmax probabilities
def show_prediction_example():
    # Get a batch of test images
    dataiter = iter(testloader)
    images, labels = next(dataiter)

    # Select a single image
    img = images[0].to(device)
    label = labels[0]

    # Get the model's prediction (logits)
    with torch.no_grad():
        logits = model(img.unsqueeze(0))

    # Apply softmax to get probabilities
    probabilities = torch.nn.functional.softmax(logits, dim=1)

    # Plot the image and probabilities
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4))

    # Show the image
    img_np = img.cpu().numpy()
    img_np = np.transpose(img_np, (1, 2, 0))
    # Denormalize the image for display
    img_np = img_np * 0.5 + 0.5
    ax1.imshow(img_np)
    ax1.set_title(f"True label: {classes[label]}")
    ax1.axis('off')

    # Show the probabilities
    probs = probabilities[0].cpu().numpy()
    ax2.bar(range(10), probs)
    ax2.set_xticks(range(10))
    ax2.set_xticklabels(classes, rotation=45)
    ax2.set_xlabel('Class')
    ax2.set_ylabel('Probability')
    ax2.set_title('Softmax Probabilities')

    plt.tight_layout()
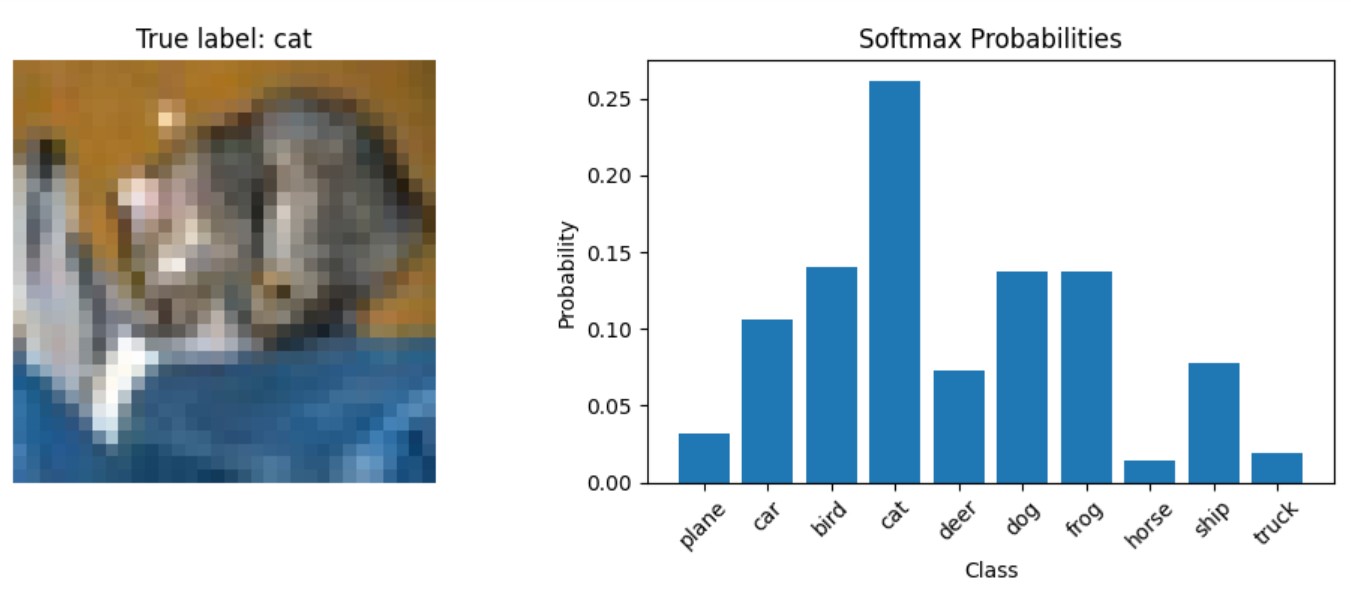
Fungsi ini mendemonstrasikan cara mendapatkan probabilitas softmax dari model yang telah dilatih saat inferensi. Gambar dilewatkan melalui model untuk mendapatkan logit, softmax diterapkan secara manual menggunakan torch.nn.functional.softmax(), lalu memvisualisasikan gambar dan distribusi probabilitas yang dihasilkan.
Sekarang, mari latih modelnya:
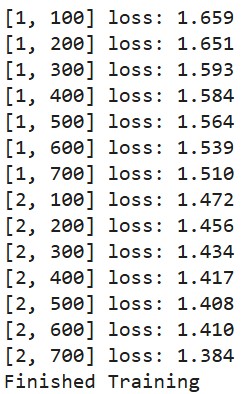
train_model()Keluaran:
Mari prediksi dan lihat bagaimana probabilitasnya muncul untuk sebuah gambar uji:
show_prediction_example()Keluaran:
Pada bagian berikutnya, kita akan melihat skenario spesifik di mana softmax adalah pilihan optimal, menelaah kapan fungsi aktivasi softmax harus digunakan, dan membahas penerapan di dunia nyata dalam berbagai model deep learning.
Memahami kapan menggunakan fungsi aktivasi softmax penting untuk merancang jaringan saraf yang efektif. Fungsi aktivasi softmax menemukan aplikasi utamanya pada lapisan keluaran jaringan saraf yang dirancang untuk tugas klasifikasi.
Softmax adalah pilihan standar ketika model kita perlu mengklasifikasikan masukan ke dalam salah satu dari beberapa kategori yang saling eksklusif. Contoh umum meliputi:
Ketika kita membutuhkan model untuk menghasilkan probabilitas, bukan hanya prediksi kelas, softmax menyediakan interpretasi probabilistik atas keyakinan model di seluruh kelas yang mungkin.
Dalam reinforcement learning dan masalah pengambilan keputusan berurutan, softmax dapat digunakan untuk mengonversi nilai aksi menjadi distribusi probabilitas untuk pemilihan aksi.
Arsitektur modern berbasis transformer menggunakan softmax untuk mendistribusikan atensi ke berbagai bagian dari urutan masukan.
Landasan matematis yang kuat dan interpretasi probabilistik yang intuitif membuat fungsi aktivasi softmax sangat cocok untuk masalah klasifikasi di mana kelas-kelas saling eksklusif.
Beberapa arsitektur deep learning menggunakan fungsi aktivasi softmax.
Jaringan klasifikasi gambar seperti ResNet, VGG, dan Inception semuanya menggunakan softmax pada lapisan terakhirnya untuk mengklasifikasikan gambar ke dalam ribuan kategori. Misalnya, model yang dilatih pada ImageNet biasanya memiliki lapisan softmax dengan 1000 unit yang sesuai dengan 1000 kategori objek.
Dalam pemodelan bahasa, model berbasis RNN menggunakan softmax untuk memprediksi kata berikutnya dalam sebuah urutan dari kosakata yang mungkin berisi puluhan ribu kata.
Arsitektur NLP modern seperti BERT, GPT, dan T5 menggunakan softmax di beberapa komponen:
Variational Autoencoders (VAE) dan beberapa Generative Adversarial Networks (GAN) menggunakan softmax pada komponen diskriminatornya atau untuk pemodelan variabel laten kategorikal.
Pada bagian berikutnya, kita akan melihat perbedaan antara fungsi aktivasi softmax dan fungsi aktivasi sigmoid.
Fungsi sigmoid, yang didefinisikan sebagai σ(x) = 1/(1+e^(-x)), mengubah satu bilangan real menjadi nilai antara 0 dan 1. Sebaliknya, fungsi aktivasi softmax beroperasi pada vektor angka, mengonversinya menjadi distribusi probabilitas.
Berikut perbedaan mendasar antara kedua fungsi aktivasi ini:
Menariknya, fungsi sigmoid sebenarnya adalah kasus khusus dari fungsi aktivasi softmax ketika hanya ada dua kelas. Inilah mengapa sigmoid sering disebut "binary softmax."
Memilih fungsi aktivasi yang tepat sangat penting untuk memastikan jaringan saraf menghasilkan prediksi yang bermakna, dan keputusan antara softmax dan sigmoid bergantung pada sifat tugas klasifikasi.
Gunakan sigmoid ketika:
Gunakan softmax ketika:
Misalnya, pada jaringan saraf yang mengklasifikasikan gambar digit tulisan tangan (0-9), fungsi aktivasi softmax cocok untuk lapisan keluaran karena setiap gambar merepresentasikan tepat satu digit. Di sisi lain, untuk jaringan yang mendeteksi beberapa objek dalam sebuah gambar (misalnya, "mengandung orang", "mengandung mobil", "mengandung pohon"), aktivasi sigmoid lebih sesuai karena beberapa objek dapat muncul secara bersamaan.
Berikut tabel referensi cepat yang membandingkan fungsi aktivasi softmax vs sigmoid:
|
Fitur |
Sigmoid |
Softmax |
|
Masukan |
Skalar tunggal |
Vektor nilai |
|
Rentang Keluaran |
Antara 0 dan 1 |
Antara 0 dan 1, berjumlah 1 |
|
Kasus Penggunaan |
Klasifikasi biner |
Klasifikasi multi-kelas |
|
Interpretasi Keluaran |
Probabilitas independen |
Distribusi probabilitas |
|
Keluaran Berganda |
Dapat sama-sama tinggi atau sama-sama rendah |
Dibatasi untuk berjumlah 1 |
|
Gradien |
Dapat mengalami vanishing gradient |
Lebih tidak rentan terhadap masalah vanishing gradient |
|
Efisiensi Pelatihan |
Dapat dilatih dengan loss binary cross-entropy |
Dilatih dengan loss categorical cross-entropy |
Memahami perbedaan antara fungsi aktivasi ini sangat penting untuk merancang jaringan saraf yang efektif. Sementara fungsi aktivasi softmax adalah pilihan utama untuk masalah klasifikasi multi-kelas, sigmoid tetap berharga untuk klasifikasi biner dan masalah yang memerlukan probabilitas independen.
Pada bagian berikutnya, kita akan melihat masalah umum yang muncul dan pertimbangan yang perlu dibuat saat bekerja dengan fungsi aktivasi softmax.
Saat bekerja dengan fungsi aktivasi softmax dalam model deep learning Anda, beberapa tantangan dapat memengaruhi kinerja dan keandalan model. Memahami masalah ini dan mengetahui cara mengatasinya akan membantu Anda membangun model yang lebih andal.
Stabilitas numerik adalah perhatian penting saat menggunakan fungsi aktivasi softmax. Operasi eksponensial dalam rumus fungsi aktivasi softmax dapat menyebabkan overflow atau underflow numerik jika tidak ditangani dengan benar.
Misalnya, saat menangani nilai masukan yang sangat besar (seperti 1000 atau lebih tinggi), fungsi eksponensial menghasilkan angka yang sangat besar yang dapat melebihi nilai floating-point maksimum yang dapat direpresentasikan dalam sistem Anda. Ini menyebabkan kesalahan overflow, menghasilkan nilai "infinity" yang membuat operasi pembagian terakhir menghasilkan hasil yang tidak terdefinisi (NaN - Not a Number).
Solusi standar, seperti disebutkan pada bagian implementasi, adalah mengurangkan nilai maksimum dari semua masukan sebelum menerapkan fungsi eksponensial. Pergeseran ini tidak mengubah proporsi relatif setelah normalisasi tetapi menjaga nilai berada dalam rentang yang dapat dikelola.
Kerangka kerja deep learning modern menangani masalah ini secara internal, tetapi penting untuk memahami masalahnya saat mengimplementasikan operasi kustom atau men-debug perilaku yang tidak terduga.
Masalah umum lain dengan fungsi aktivasi softmax adalah jaringan saraf cenderung menjadi terlalu percaya diri pada prediksinya, bahkan ketika salah. Kepercayaan berlebihan ini terjadi karena:
Dalam praktiknya, ini berarti model mungkin memberikan probabilitas 99% pada prediksi yang ternyata salah. Hal ini dapat menjadi masalah pada aplikasi kritis di mana estimasi ketidakpastian yang andal sangat penting. Misalnya, sistem diagnosis medis yang terlalu percaya diri dalam prediksi yang salah dapat mengarah pada keputusan perawatan yang tidak tepat.
Kesenjangan antara keyakinan model (dari probabilitas softmax) dan akurasi aktualnya dikenal sebagai error kalibrasi. Model yang terkalibrasi dengan baik menghasilkan skor keyakinan yang sesuai dengan tingkat akurasinya—jika model memprediksi kejadian dengan keyakinan 80%, kejadian tersebut seharusnya terjadi kira-kira 80% dari waktu.
Untungnya, beberapa teknik dapat membantu mengatasi masalah ini dengan fungsi aktivasi softmax:
Temperature scaling memperkenalkan parameter T yang mengontrol "kelembutan" distribusi probabilitas. Dengan membagi logit dengan parameter suhu ini sebelum menerapkan softmax, Anda dapat menyesuaikan seberapa runcing atau seragam distribusi yang dihasilkan.
Suhu yang lebih tinggi (T > 1) menghasilkan distribusi probabilitas yang lebih lembut dengan nilai yang tidak terlalu ekstrem, yang dapat membantu mengurangi kepercayaan berlebihan. Suhu yang lebih rendah (T < 1) membuat distribusi lebih runcing ke arah nilai tertinggi. Temperature scaling umumnya digunakan sebagai teknik pasca-pemrosesan setelah pelatihan untuk mengalibrasi keyakinan model tanpa memengaruhi peringkat kelas model.
Label smoothing menggantikan vektor target one-hot yang keras dengan distribusi yang sedikit dihaluskan. Alih-alih melatih model untuk menghasilkan nol dan satu yang tepat, label smoothing mendorong model untuk sedikit kurang yakin dengan menargetkan nilai seperti 0.9 untuk kelas yang benar dan 0.025 untuk kelas yang salah (dalam masalah 4 kelas).
Dengan melatih menggunakan label yang dihaluskan ini, model belajar untuk kurang yakin dalam prediksinya, yang meningkatkan generalisasi dan membuat model lebih tangguh terhadap noise pada label. Teknik ini telah menjadi praktik standar pada banyak model klasifikasi gambar yang mutakhir.
Menggunakan dropout selama pelatihan dan tetap menyalakannya saat inferensi (teknik yang disebut Monte Carlo dropout) memungkinkan Anda mengambil beberapa sampel prediksi untuk masukan yang sama dan memperkirakan ketidakpastian. Jika model menghasilkan prediksi yang konsisten di banyak forward pass dengan pola dropout yang berbeda, kemungkinan model lebih yakin terhadap prediksinya.
Demikian pula, metode ansambel menggabungkan prediksi dari beberapa model untuk meningkatkan kinerja dan memberikan perkiraan ketidakpastian yang lebih baik. Ketidaksepakatan antara model dalam ansambel dapat berfungsi sebagai ukuran ketidakpastian.
Platt scaling dan metode kalibrasi lainnya dapat diterapkan setelah pelatihan untuk memastikan bahwa skor keyakinan dari softmax benar-benar sesuai dengan probabilitas sebenarnya. Metode ini biasanya menggunakan set validasi untuk mempelajari parameter yang memetakan keluaran model asli ke probabilitas yang terkalibrasi dengan baik.
Misalnya, pendekatan temperature scaling sederhana (seperti disebutkan sebelumnya) dapat dioptimalkan pada data validasi untuk meminimalkan error kalibrasi. Pendekatan yang lebih kompleks mencakup isotonic regression dan Bayesian binning.
Penelitian terbaru telah mengidentifikasi keterbatasan mendasar dari fungsi softmax yang dikenal sebagai "softmax bottleneck." Ini merujuk pada fakta bahwa ke-ekspresifan model bahasa berbasis softmax dibatasi oleh rank matriks bobot pada lapisan terakhir. Dalam konteks bahasa alami dengan dependensi yang kompleks, hal ini dapat mencegah model menangkap distribusi kondisional yang mendasarinya secara penuh.
Arsitektur tingkat lanjut seperti Mixture of Softmaxes (MoS) telah diusulkan untuk mengatasi keterbatasan ini dengan menggunakan kombinasi berbobot dari beberapa distribusi softmax.
Dengan menyadari masalah umum ini dan menerapkan solusi yang tepat, Anda dapat meningkatkan keandalan dan kinerja model yang menggunakan fungsi aktivasi softmax untuk tugas klasifikasi.
Fungsi aktivasi softmax adalah komponen penting dari jaringan saraf untuk masalah klasifikasi multi-kelas, yang mengubah logit mentah menjadi distribusi probabilitas yang dapat diinterpretasikan. Kita telah mengeksplorasi landasan matematisnya, implementasinya di Python, perbandingannya dengan sigmoid, kasus penggunaan praktis, dan teknik untuk mengatasi tantangan umum seperti ketidakstabilan numerik dan kepercayaan berlebihan.
Siap memperdalam pemahaman Anda tentang jaringan saraf?
Kursus Teratas DataCamp
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




